

2026 年 8 月 26 日,阿里通义千问团队在 ModelScope、Hugging Face 同步开源了 Qwen3.8-Flash-Next。它并非一次常规的旗舰迭代,而是团队公开表示的"Qwen4 架构的实验性预览版"——继 Qwen3-Next 为 Qwen3.5~3.8 系列探路(混合 Gated DeltaNet + Gated Attention)之后,这一次团队把下一代架构又提前搬到了台面上,供社区在正式的 Qwen4 家族发布前先行验证。
目录
- 模型总体架构
- 核心技术详解
- 2.1 Gated DeltaNet:给线性注意力装上"精准记忆"
- 2.2 QSA(Qwen Sparse Attention):从 Gated Attention 到块级稀疏检索
- 2.3 Gated Residual:细粒度门控残差流
- 2.4 N-gram Embedding:用查表换算力的参数扩容新轴
- 2.5 MTP:为投机解码而生的多 token 预测头
- 2.6 训练配方:Muon + AdamW 的分工与"去 warmup"策略
- Benchmark 一览
- 小结
一、模型总体架构
Qwen3.8-Flash-Next 是一个因果语言模型 + 视觉编码器的多模态 MoE 模型,定位是"实验性架构预览"而非旗舰能力担当。它的参数构成比较特殊:
| 维度 | 取值 |
|---|---|
| 主干参数量 | 125B(激活 6B) |
| 额外 N-gram 嵌入参数 | 51B |
| MTP(多 token 预测)参数 | 4B |
| 参数总量(BF16 权重) | 约 180B |
| 隐藏维度 | 2560 |
| 词表大小 | 248,320(padded) |
| 层数 | 48 层 |
| 层级排布 | 12 ×〔3 ×(Gated DeltaNet → MoE) → 1 ×(QSA → MoE)〕 |
| MoE 专家数 | 512(10 路由 + 1 共享,专家中间维 640) |
| 原生上下文 | 262,144 tokens(YaRN 可扩展至 1,000,000) |
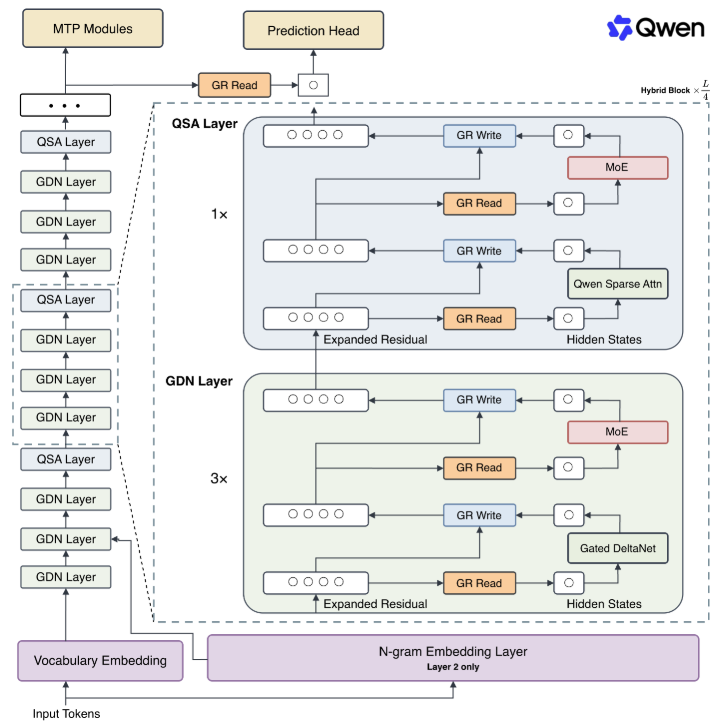
可以看到,官方把整个 48 层网络拆成 12 个重复单元,每个单元内部是 “3 段 Gated DeltaNet + 1 段 Qwen Sparse Attention(QSA)”,每段后面都紧跟一层 MoE FFN。换句话说,绝大多数层(3/4)使用线性复杂度的 Gated DeltaNet 来"压缩"历史信息,只有 1/4 的层使用 稀疏 Attention(QSA) 做一次精确的长程检索——这是典型的"线性注意力为主、稀疏/全局注意力为辅"的混合设计思路,目的是在拉长上下文(262K~1M tokens)的同时把推理成本摊薄。
在这条主干之外,官方还引入了三个"旁路"设计:
- N-gram Embedding:一个独立于 MoE 的 51B 参数查表模块,在第 2 层注入,靠 bigram/trigram 哈希索引,为模型增加"记忆容量"而几乎不增加计算量;
- Gated Residual:贯穿全部层的门控残差流,用读/写两种门控替代了传统的"直接相加"残差连接;
- MTP(Multi-Token Prediction):网络末端挂载的 1 层、4B 参数的多步预测头,用于投机解码加速。
整体架构示意如下(图中给出的是"重复单元"内部结构以及嵌入/输出旁路的关系,并非逐层展开的 48 层全貌):
下面逐一拆解这些组件背后的技术原理。
二、核心技术详解
2.1 Gated DeltaNet:给线性注意力装上"精准记忆"
Qwen3.8-Flash-Next 每个重复单元里 3/4 的层都用 Gated DeltaNet(GDN)承担"历史压缩"的角色(48 个 V head、16 个 QK head,head dim 128)。这一机制来自 NVIDIA 与 MIT 合作的论文《Gated Delta Networks: Improving Mamba2 with Delta Rule》,其出发点是解决线性 Transformer(如 Mamba2、DeltaNet)在检索类任务和长上下文任务上表现受限的问题。
论文观察到两种线性注意力改进思路其实是互补的:
- 门控(Gating):像 Mamba2 那样引入数据相关的遗忘门,让模型能够"快速清空"不再有用的记忆;
- Delta Rule:像 DeltaNet 那样对记忆做"定向修正",而不是简单地叠加新信息。
二者结合得到的 Gated Delta Rule,其状态更新可以写成:
S_t = α_t · S_{t-1} + β_t · k_t · (v_t − α_t · S_{t-1}^T · k_t)^T
    = α_t · (I − β_t · k_t · k_t^T) · S_{t-1} + β_t · k_t · v_t^T
其中 S_t 是循环状态(可以理解为线性注意力的"记忆矩阵"),α_t ∈ (0,1) 是数据相关的遗忘门(对应 Mamba2 的门控项),β_t 是 delta rule 的写入强度。可以看到,公式的核心是把新的 value 修正为 v_t − α_t·S_{t-1}^T·k_t,即"新值减去当前记忆已经预测出的值"——这正是 delta rule "只修正误差、不重复写入"的思想。
这种递推形式如果逐 token 串行计算会很慢,论文的另一项贡献是给出了一套基于 WY 表示(WY representation) 的分块并行算法(chunkwise algorithm),把原本难以并行的 Householder 型状态转移矩阵累乘,转化为分块矩阵运算,从而在现代 GPU 上高效训练。
在效果上,Gated DeltaNet 在语言建模、常识推理、上下文检索、长度外推、长文本理解等多个维度全面超过了单独的 Mamba2 或 DeltaNet;论文同时验证了把 Gated DeltaNet 与滑窗注意力/Mamba2 做混合架构可以同时提升训练效率与任务表现——这也正是 Qwen3-Next 系列以及本次 Qwen3.8-Flash-Next 选择"线性注意力为主 + 少量全局/稀疏注意力"混合路线的理论基础。
2.2 QSA(Qwen Sparse Attention):从 Gated Attention 到块级稀疏检索
如果说 Gated DeltaNet 负责"廉价地压缩历史",那么每个重复单元里唯一的一层 QSA(Qwen Sparse Attention) 负责的就是"精确地做一次长程检索"(24 个 Q head、2 个 KV head,head dim 256,RoPE 维度 64)。相比上一代 Qwen3-Next 用的是 Gated DeltaNet + Gated Attention 的组合,这一代把 Gated Attention 换成了 QSA——但 QSA 本身仍然继承了 Gated Attention 论文里验证过的门控思路,只是把稀疏化做到了更粗的"块"粒度上。这里有两条技术线索值得展开。
(1) Gated Attention 提供的"非线性 + 稀疏化"增益
Qwen 团队自己的论文《Gated Attention for Large Language Models: Non-linearity, Sparsity, and Attention-Sink-Free》(该文获得了 NeurIPS 2025 最佳论文)做了一件很朴素但影响很大的实验:在标准的 Scaled Dot-Product Attention(SDPA)输出之后,加一个逐 head 的、输入相关的 sigmoid 门控 σ(X·W_θ),直接作用在 SDPA 的输出上(即输出投影 W_O 之前)。团队在 30 种门控变体、15B MoE 与 1.7B dense 模型、3.5 万亿 token 的训练数据上做了系统对比,发现这个改动能稳定带来性能提升。
论文把效果归因于两点:
- 打破线性瓶颈:标准注意力里
X·W_V·AttentionMatrix·W_O本质上是两个线性投影的复合,可以被数学上等价合并成一个低秩线性映射,表达能力受限;在 SDPA 输出后插入一个非线性 sigmoid 门,相当于在这个低秩映射中间强行加入了非线性,提升了表达能力; - query 相关的稀疏化:sigmoid 门控是逐元素、依输入 query 变化的,相当于对注意力输出做了一次"按需过滤",某些通道会被压制到接近 0。
更意外的发现是:这种稀疏门控天然缓解了"attention sink"现象(即模型倾向于把大量注意力权重堆到序列开头几个无意义的 token 上)和"massive activation"问题,而不需要像此前一些工作那样人为引入"sink token"之类的启发式技巧,从而显著提升了长上下文外推能力,同时也提高了大规模 MoE 训练的稳定性,允许使用更大的学习率。
(2) 从"逐 token 稀疏"到"块级稀疏"
标准的稀疏注意力(例如 DeepSeek Sparse Attention, DSA)通常靠一个轻量的"lightning indexer"给每个 query 挑出 top-k 个最相关的 token,把核心注意力计算复杂度从 O(L²) 降到 O(L·k)。QSA 的做法是把选择粒度从"单个 token"提升到"micro-block"(微块):indexer 结构是一个 MQA 形式(4 个 query head,1 个共享 key head,indexer head dim 128),在给定预算(512 个块或 2048 个 token)内选出最相关的若干块参与精确注意力计算。官方给出的结论是,这种块级选择方式能显著降低长上下文场景下的推理延迟——考虑到智能体(agentic)场景下长上下文正在成为主流负载,这一项优化的收益会被进一步放大。
(3) indexer 本身的开销:一个值得关注的优化方向
值得注意的是,块级/token 级选择虽然把"核心注意力"计算量降了下来,但indexer 本身的打分过程仍然是 O(L²) 的,而且如果在每一层都独立跑一遍 indexer,累积开销并不小。这正是清华大学与 Z.ai 团队在论文《IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse》中指出并试图解决的问题:他们观察到,相邻层的 top-k 选择结果高度相关(cross-layer redundancy),于是提出把网络层划分为少数"Full 层"(独立运行 indexer)和大多数"Shared 层"(直接复用最近的 Full 层给出的 top-k 索引)。论文给出了两种配置方式——不需要更新权重、基于校准集贪心搜索的 Training-free 版本,以及用多层蒸馏损失让保留下来的 indexer 去拟合"它所服务的所有层的平均注意力分布"的 Training-aware 版本。在一个 30B 规模的 DSA 模型上,这一思路可以砍掉 75% 的 indexer 计算量,换来最高 1.82× 的 prefill 加速和 1.48× 的 decode 加速,而质量几乎不受影响。
需要说明的是,Qwen3.8-Flash-Next 的官方模型卡并未明确说明 QSA 的 indexer 是否采用了与 IndexCache 完全一致的跨层复用方案;但从设计动机上看,"indexer 复杂度独立于核心注意力、且跨层高度冗余"是块级/token 级稀疏注意力共同面临的问题,IndexCache 这类跨层索引复用技术代表了这一问题当前最直接的优化路径,也是理解 QSA 为何能在保持检索精度的同时把长文本延迟压下来的重要背景知识。
2.3 Gated Residual:细粒度门控残差流
传统 Transformer 的残差连接是"直接相加":x_{l+1} = x_l + f(x_l),配合 LayerNorm/RMSNorm 让深层网络的训练变得可行。Qwen3.8-Flash-Next 引入的 Gated Residual 在此基础上做了进一步细化,官方给出的参数是:4 个分支(branch),bottleneck rank 320。
其设计思路是把残差流"加宽"成多个并行分支,并对每个分支的读、写分别加门控:
- 逐元素的、数据相关的读门(read gate):在子层读取残差流之前,先用一个低秩(rank 320)投影计算出一个逐通道的 sigmoid 门控值,决定该子层能从残差流里"读取"多少信息,而不是无差别地全盘接收;
- 每个分支一个标量的写门(write gate):子层计算完成后,用一个标量门控决定这次计算结果以多大的强度写回对应的残差分支。
这种"读门 + 写门"的组合,本质上是把信息在层间的流动从"全有或全无的直通",变成了一个可学习的、按需调节的阀门系统:模型可以让某些分支在某些层里几乎不参与计算(门控趋近于 0,退化为恒等映射,保持了标准残差连接的训练稳定性),也可以在需要的时候让信息更充分地流动。由于门控函数本身的参数量经过低秩(320)压缩,这一机制带来的推理开销很小,符合官方所说的"在保持训练稳定性和低推理开销的同时,获得更细粒度的跨层表达能力"。
2.4 N-gram Embedding:用查表换算力的参数扩容新轴
Qwen3.8-Flash-Next 里比较少见的一个设计是 N-gram Embedding:一张独立于主干和 MoE 的 51B 参数嵌入表,包含 2000 万条 bigram/trigram 索引项,在网络第 2 层注入。
它想解决的问题是:MoE 是当前主流的参数扩容手段,但每激活一个专家仍然要付出一次 FFN 前向计算的代价;而嵌入查表(embedding lookup)本质上是纯粹的内存读取操作,不需要参与矩阵乘法计算,因此可以视为一条与 MoE 平行、但计算成本几乎为零的参数扩容轴。用短 n-gram(二元组/三元组)对输入做哈希索引,为每个 n-gram 分配一段可学习的向量,相当于给模型额外提供了一份"局部搭配记忆",且这种查表结构天然适合卸载(offload)到显存受限的加速卡之外(比如主机内存),因为访问是稀疏、并行、无需常驻在加速卡高带宽显存里的。这也是官方模型卡里特别强调"51B 参数的 N-gram 嵌入可以异步卸载到主机内存"(目前仅在 NVIDIA 设备上支持)的原因——它让"参数总量"和"实际显存占用/激活计算量"进一步解耦。
2.5 MTP:为投机解码而生的多 token 预测头
Qwen3.8-Flash-Next 在主干之外还挂载了一个 1 层、4B 参数的 MTP(Multi-Token Prediction)模块,用多步训练目标(即训练时同时监督未来若干个 token 的预测)。这与 DeepSeek-V3 等模型中的 MTP 思路一致:训练阶段让模型学会"一次预测多个未来 token",推理阶段则可以把 MTP 头输出的候选序列作为投机解码(speculative decoding)的草稿(draft),由主干模型一次性验证多个 token,从而减少解码阶段的串行前向次数、提升吞吐。
2.6 训练配方:Muon + AdamW 的分工与"去 warmup"策略
架构之外,官方特别强调了训练配方上的两个改动:为不同权重类别分别选用 Muon 和 AdamW 优化器,以及取消传统的 batch size warmup、直接以目标 batch size 起步。
Muon 优化器(全称 MomentUm Orthogonalized by Newton-Schulz)出自 Keller Jordan 等人的工作《Muon: An Optimizer for Hidden Layers in Neural Networks》,是专门为神经网络隐藏层里的二维权重矩阵设计的优化器。它的更新规则可以概括为三步:
M_t = μ·M_{t-1} + ∇L(W_{t-1})              # 动量累积
O_t = NewtonSchulz(M_t)                     # 用 Newton-Schulz 迭代正交化动量
W_t = W_{t-1} − η_t·O_t                     # 用正交化后的更新量更新参数
其中最关键的一步是正交化(orthogonalization):目标是找到一个矩阵 O,使其在 Frobenius 范数意义下最接近动量矩阵 M,同时满足 OᵀO = I(即 O 的所有奇异值都被"拉平"到 1)。直接求解需要做 SVD,代价太高;Muon 用固定次数(一般 5 次左右)的 Newton-Schulz 迭代来近似这个正交投影,迭代形式大致是:
X_k = a·X_{k-1} + b·(X_{k-1}X_{k-1}ᵀ)·X_{k-1} + c·(X_{k-1}X_{k-1}ᵀ)²·X_{k-1}
系数 (a, b, c) 经过专门设计,使得动量矩阵的奇异值在迭代后收敛到 1 附近,而不需要真正计算 SVD。这样做的直观效果是:更新方向不再由动量矩阵里少数几个"最大"的奇异值方向主导,而是让所有方向都获得大致相等的更新强度,从而改善了优化轨迹的"条件数",使模型能够在更大的学习率下依然保持稳定收敛,同时加快收敛速度。需要注意的是,Muon 通常只用于隐藏层的二维权重矩阵,而标量参数、偏置、词嵌入层和输出(unembedding)层仍然沿用 AdamW ——Qwen3.8-Flash-Next 的训练配方正是遵循了这一分工原则,把 Muon 和 AdamW 分别应用到"特定的权重类别"上,以在收敛速度和训练稳定性之间取得平衡。
在此基础上,官方还提到"经过重新拟合的 scaling law 指导,取消了传统的 batch size warmup,直接从目标 batch size 开始训练",这样做的收益是大幅减少了总的优化器步数,配合 Muon 对大学习率的容忍度,官方给出的结果是:相比上一代 Qwen3.7-Plus,Qwen3.8-Flash-Next 的训练与推理成本都大幅降低——训练成本约为其 1/9,但在编程、办公类任务上反而表现更强。这也呼应了官方博客里反复强调的定位:“不只是能堆多大规模,更是能多高效地堆规模”。
三、Benchmark 一览
官方给出的对比对象包括 Qwen3.8-27B、Qwen3.7-Plus、DeepSeek-V4-Flash-0731 以及 Claude-Opus-4.6 (Max),这里摘录几项有代表性的分数(均为官方自测,评测框架、harness 等细节请以模型卡为准):
| 能力维度 | 基准 | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus |
|---|---|---|---|---|
| 智能体编程 | DeepSWE 1.1 | 58.7 | 42.2 | 16.5 |
| 智能体编程 | SWE-bench Pro | 62.5 | 61.7 | 55.8 |
| 长程办公智能体 | CoWorkBench | 73.9 | 70.7 | 65.1 |
| 专业任务 | JobBench | 55.7 | 33.4 | 27.6 |
| 科学推理 | GPQA Diamond | 91.7 | 89.2 | 90.3 |
| 竞赛编程 | LiveCodeBench v6 | 91.9 | 90.3 | 89.6 |
对照参数规模——Qwen3.8-Flash-Next 是 125B 总参数 / 6B 激活,而 Qwen3.7-Plus 是 397B 总参数 / 17B 激活——这组对比的核心信息其实不在于某一项分数的高低,而在于"效率曲线"本身:用远小的激活参数量,在多数智能体与编程类基准上追平甚至反超了上一代规模大得多的模型。这也是这次架构升级最想传达的信号。
四、小结
Qwen3.8-Flash-Next 不是一次面向榜单的旗舰发布,而是通义千问团队按照 Qwen3-Next 的惯例,把下一代(Qwen4)架构提前开源出来供社区检验。从技术组成上看,它是四类改动的叠加:
- 注意力混合方式的迭代:用 QSA(继承 Gated Attention 的门控思想 + 块级稀疏检索)替换了上一代的 Gated Attention,与 Gated DeltaNet 按 3:1 的比例混合;
- 残差连接的细化:Gated Residual 用读写两种门控替代了直接相加;
- 参数扩容轴的拓展:N-gram Embedding 提供了一条几乎不占计算量的参数扩容路径;
- 训练配方的优化:Muon + AdamW 分工,配合去 warmup 策略大幅压缩训练成本。
这些改动共同指向同一个目标——在上下文越拉越长、智能体任务越来越依赖长程推理的背景下,用更少的激活参数和更低的训练/推理成本,尽量逼近甚至超越更大规模模型的能力。至于这套架构是否会原样构成 Qwen4 的最终形态,官方的态度也很坦诚:"Next"这个后缀本身就意味着这只是一次实验性预览,具体走向还要看后续正式发布。
参考资料
- Qwen/Qwen3.8-Flash-Next · Hugging Face:https://huggingface.co/Qwen/Qwen3.8-Flash-Next
- Qwen3.8-Flash-Next 官方博客:https://qwen.ai/blog?id=qwen3.8-flash-next
- QwenLM/Qwen3.8-Flash-Next · GitHub:https://github.com/QwenLM/Qwen3.8-Flash-Next
- Yang, S., Kautz, J., Hatamizadeh, A. Gated Delta Networks: Improving Mamba2 with Delta Rule. arXiv:2412.06464
- Qiu, Z. et al. (Qwen Team). Gated Attention for Large Language Models: Non-linearity, Sparsity, and Attention-Sink-Free. arXiv:2505.06708(NeurIPS 2025 Best Paper)
- Bai, Y., Dong, Q., et al. IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse. arXiv:2603.12201
- Jordan, K. et al. Muon: An Optimizer for Hidden Layers in Neural Networks. https://kellerjordan.github.io/posts/muon/
- Unite.AI, Qwen3.8-Flash-Next Previews Qwen4 Architecture With 6B Active Parameters,2026-08-26
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/qq_51994713/article/details/164115474

