

你有没有过这样的经历:周一早晨刚坐下,面对桌上堆成山的采购合同、海外发票和法律文书,还没开始喝口水,心里就一阵发慌。眼睛盯着密密麻麻的文字,手指在键盘上机械地敲击,不仅腰酸背痛,还生怕看错一个数字导致后续麻烦不断。
如果告诉你,有一种技术能像资深律师一样,“扫”一眼文档就能自动把关键信息填进表格,而且准确率极高,你信吗?这不是科幻电影,而是一种结合了OCR与大模型技术的文档抽取系统。今天,我们就来聊聊这个能让打工人从繁琐录入中彻底解脱的“神器”。
它的脑子是怎么转的?—— “眼睛”+“大脑”的黄金组合
很多人可能会问:现在不是有成熟的OCR(光学字符识别)了吗?扫描一下不就能变成文字吗?为什么要再搞一个更复杂的系统?
这里有个关键的痛点:OCR能把字认出来,但它不懂字的意思。
这就好比你请了一个视力极好的抄写员,他能一字不差地把报纸上的字抄下来,但你让他从中找出“签约金额”或“付款截止日期”,他可能一脸茫然——因为他只认识字,不认识逻辑。
文档抽取系统采用了“OCR + 大语言模型(LLM)”的双引擎架构。我们可以把这个过程比喻成一场“翻译官与法律顾问”的接力赛。
第一步:OCR —— 练就“鹰眼”,精准还原文档原貌
首先,文档通过高精度的OCR引擎进行图像预处理和字符识别。这一步就像给AI戴上高清眼镜。
- 难点攻克:现实中的文档千奇百怪。有的发票印章盖住了金额,有的手写体歪歪扭扭,有的是多栏式排版的海外单据。
- 技术细节:文档抽取系统不仅识别文字,还能理解版面结构。它能分辨出哪块是表头,哪块是正文,哪块是签名区。即使背景杂乱、字迹潦草,它也能通过深度学习模型,还原出最接近真实情况的文本内容,并将每个字符与它在图片中的位置坐标精确对应。
通俗来说:这一步解决了“看得清”的问题,把纸质/电子图中的像素变成了带坐标信息的文字串。
第二步:大模型 —— 拥有“律师脑”,理解语义而非死记硬背
拿到纯文本后,才是真正的重头戏。这里引入了大语言模型(Large Language Model, LLM)。
传统的规则匹配系统需要程序员预先写好成千上万条If-Then规则(比如“如果‘Total Amount’后面跟着数字,那就是总金额”),一旦格式稍微变一点就失效。而大模型不同,它是经过海量数据训练出来的“通用专家”。
- 语境理解:它不仅看单个词,而是看整段话的上下文。比如在一份英文合同中,它知道“In consideration of...”后面的金额才是对价金额;在一张中文报销单里,它知道抬头处的“价税合计”和小计栏的区别。
- 泛化能力:这是最关键的黑科技所在。你不需要为每种新模板都去改代码。只要大模型理解了“什么是发票”、“什么是合同条款”,面对从未见过的全新格式,它依然能通过推理提取出正确信息。
通俗来说:这一步解决了“看得懂”的问题。大模型像一个经验丰富的老会计,扫一眼文档,就能心领神会地指出:“这儿,就是你要的数字。”
第三步:人机协同 —— 少量样本,快速定制
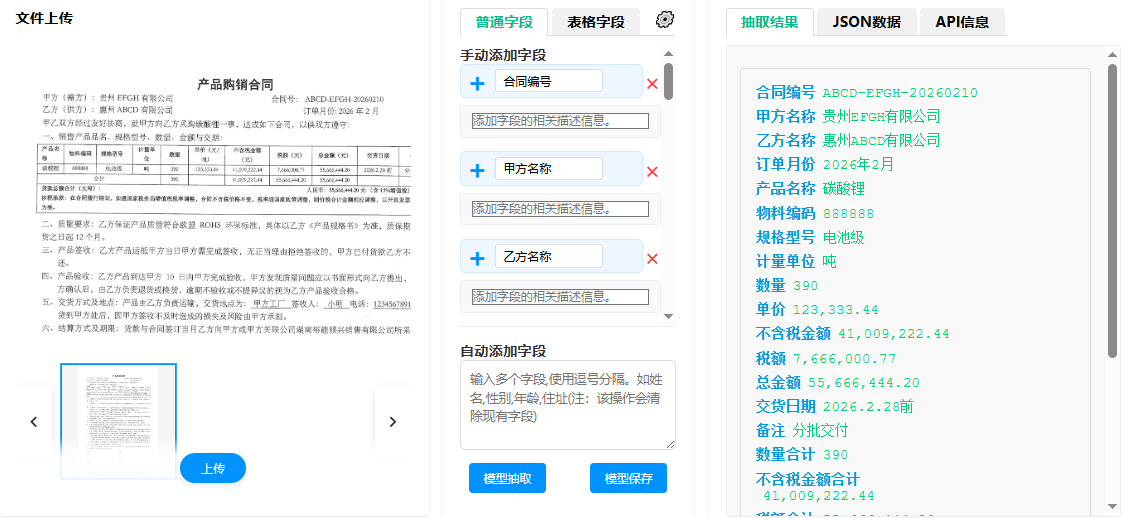
有了强大的“眼睛”和“大脑”,用户操作变得极其简单。
- 上传样本:你只需提供几张典型的原始文档(比如3-5张不同类型的合同样本)。
- 标注字段:你在界面上框选,或者直接用自然语言告诉系统:“我需要提取‘甲方名称’、‘合同生效日’、‘违约金比例’等字段。”
- 自动生成配置:系统会自动分析这些样本的结构规律,结合大模型的语义理解,生成一套专属的数据抽取模型。
- 批量处理:之后上传大批量新文档,系统即可自动运行,输出Excel或API接口形式的结构化数据。
这种“少样本学习”能力,极大地降低了使用门槛。以前搞个智能系统要组建专业算法团队,现在业务人员自己就能搞定。
它有什么绝活?功能亮点一览
相较于传统OCR工具或简单的脚本程序,文档抽取系统具备以下显著优势:
全能选手,通吃各类复杂文档
- 无论是结构清晰的内部报表,还是非标准化的海外发票(德文、日文、阿拉伯文混杂)、带有红章水印的合同、甚至是指纹斑驳的法律判决书,它都能应对自如。特别是针对多语言混排和手写体,其准确率远超普通工具。
自定义字段,灵活适配所有业务
- 没有固定抽取模板,完全贴合企业个性化需求。用户可根据自身业务场景,自由添加、修改、删除抽取字段,无论是通用的基础信息,还是行业专属的专业字段,都能自主配置,适配法务、财务、行政、外贸等不同岗位的办公需求。
高精度低误差,告别人工失误
- 依托OCR高精度识别+大模型语义纠错双重保障,系统可自动修正识别错别字、字段错乱、信息遗漏等问题,复杂文档抽取准确率远超人工录入。杜绝人工抄录的错填、漏填、看错数据等问题,保障每一条结构化数据精准有效。
少样本快速适配新文档
- 不用海量标注数据。只需少量样例,就可以训练模型识别新类型单据,企业可以快速上线,降低定制成本。
谁在用?哪些场景受益最大?
金融与银行业
- 信贷审核:自动从企业的财务报表、流水账单中提取营收、负债等关键指标,缩短审批周期。
- 保险理赔:快速识别医疗发票、事故证明,减少骗保风险,加速赔付流程。
法律与政务
- 案件卷宗整理:从成千上万页的起诉书、证据材料中,自动抓取时间线、当事人姓名、涉案金额,构建案件知识图谱。
- 政策合规比对:快速读取最新发布的法律文书,标记变更条款。
供应链与贸易
- 跨境结算:处理全球各地的增值税发票、形式发票(Proforma Invoice),解决多语种、多国格式不一的痛点。
- 订单管理:从邮件附件的PDF订单中自动抓取SKU、数量、单价,同步至ERP系统。
企业内部管理
- 人事档案:自动提取简历中的学历、工作年限、证书信息。
- 研发资料:从专利申请书和技术报告中提取技术参数,建立企业知识库。
结语:让机器做机器擅长的事,让人做人擅长的事
在过去,大量宝贵的人力资源被耗费在重复、枯燥的“搬运”工作中——从一个PDF搬到Excel,从一个系统复制到另一个系统。这不仅效率低下,更容易出错,也挫伤了员工的创造力。
文档抽取系统,本质上是将“非结构化数据”转化为“结构化资产”的桥梁。它不像是一个冰冷的软件,更像是一位不知疲倦、记忆力超群且精通多国语言的超级助理。当OCR赋予了机器看清世界的眼睛,当大模型赋予了机器理解世界的思维,我们终于可以从繁琐的信息劳动中解脱出来,去思考更有价值的战略和创新问题。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/dlf283870550/article/details/165338054

