

谷电零点一到,系统就崩?充电桩高并发架构:从丢单到99.99%可用的四层防线
一、问题本质:你扛的不是高并发,是"零点一秒的洪水"
做充电桩运营的人,都有一个共同的噩梦——零点。
谷电时段一到,电价腰斩。几十辆重卡、上百台网约车,像听到发令枪一样,同时扫码、同时鉴权、同时发起充电。
一秒之内,请求量翻十倍。
然后呢?页面转圈,启充失败,枪插好了系统说设备离线。最要命的是充完电,订单没了。司机堵着站长骂,运营半夜爬起来对账,技术通宵查日志。
很多人的第一反应是:加服务器。
但我想告诉你一个扎心的真相:90%的高峰崩溃,不是算力不够,是架构从根上就错了。
你面对的根本不是普通的高并发。普通高并发是车流慢慢变大,你拓宽马路就行。而充电高峰是零点一秒的洪水——水不是慢慢涨的,是一瞬间拍过来的。
一条直来直去的调用链,没有任何缓冲,洪水一来,先冲垮数据库,再拖死服务,最后整个系统雪崩。
你看到的卡顿、启充失败、丢单,本质上是三个病:
- 没分层:流量一竿子捅到底,底层先死;
- 全同步:所有请求挤在一起,一堵全堵;
- 连接乱:海量设备长连接没人管,接入层自己就是瓶颈。
不解决这三个病,加再多服务器,也是往漏水的桶里倒水。
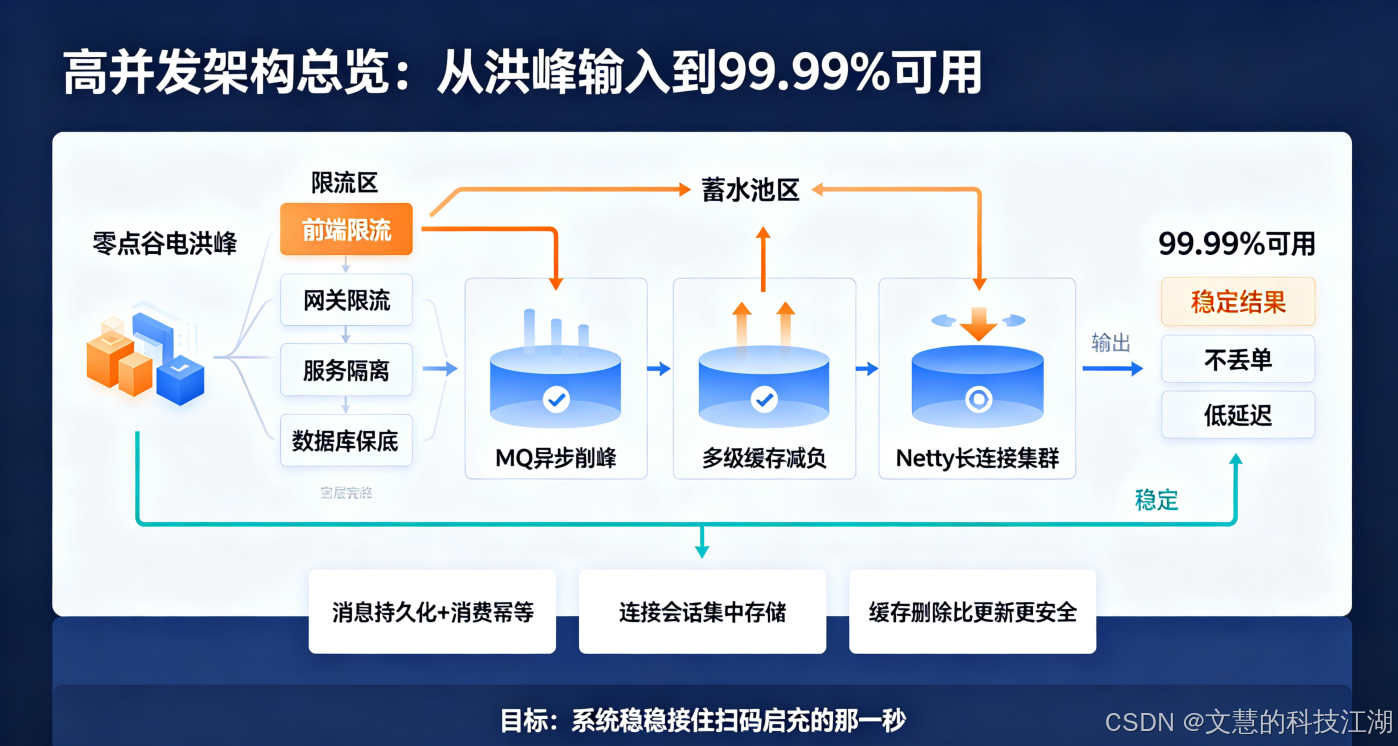
二、大白话解法:四道闸门 + 三个蓄水池,洪水来了也不怕
道理讲完了,怎么做?用大白话说,就两件事:修闸门、挖池子。
四道闸门:把洪水一层层截住
想象一下,你家楼下突然来了一万个人要进小区。如果只有一道门,肯定挤爆。但如果有四道门,每道门都筛一遍人,情况就完全不同了。
第一道门:前端。 用户重复点、疯狂刷,这些都是无效流量。按钮点一下就置灰,重复请求直接拦在手机里。别小看这一步,至少挡住20%的垃圾流量,而且零成本。
第二道门:网关。 所有请求的必经之路。在这里设个总闸,超过承载量的,直接告诉用户"高峰请稍候",不让往里冲。就像高速收费站,入口发卡控制总量,路面永远不堵死。
第三道门:服务。 到了业务层,要做隔离。充电、订单、支付是核心业务,单独一个池子;用户信息、消息推送是非核心,另一个池子。高峰来了,非核心直接降级,资源全部留给核心。就像医院急诊,重症先进,普通号往后排。
第四道门:数据库。 这是最后一道底线。连接池卡死上限,慢SQL当场拦截,绝不让一条烂SQL拖垮整个库。前面三道门再稳,数据库没设防,照样崩。
四道闸门,层层卸力。再大的洪水,到最后一层也变成了涓涓细流。
三个蓄水池:把尖峰削成平原
光截住不够,还得有地方存。三个"蓄水池",把瞬间洪峰消化掉。
第一个池子:消息队列。 订单创建、启充指令,别同步硬扛,先丢进队列里排队。系统按自己的速度慢慢消费。再尖的峰,进了队列也变成平的。而且消息持久化,服务重启也不丢单——这就解决了最要命的丢单问题。
第二个池子:多级缓存。 系统里90%的请求是读:查电价、查桩状态、查余额。这些数据每次都查数据库,库再强也扛不住。最热的数据放本地缓存,次热的放Redis,最后才查库。绝大多数请求在缓存层就返回了,数据库压力直接降一个数量级。
第三个池子:Netty长连接集群。 充电桩是24小时在线的,要实时上报状态、接收指令。用HTTP短连接,几千台设备就能把系统拖死。用Netty做高性能长连接,再集群化部署,设备连接分散到多台机器上。几万台设备同时在线,也稳如泰山。
四道闸门 + 三个蓄水池,洪水来了,先截、再蓄、最后平稳消化。系统不崩、不卡、不丢单,就这么简单。
三、技术方案:落地的时候,每个细节都不能含糊
道理好懂,落地才是真功夫。下面把关键技术点拆开讲。
3.1 四层限流架构:每一层的算法和策略都不同
| 层级 | 限流手段 | 核心策略 | 作用 |
|---|---|---|---|
| 前端 | 按钮置灰 + 本地频率控制 | 防重复提交、防无效重试 | 挡掉20%+无效流量 |
| 网关 | 令牌桶算法(Sentinel/Redis) | 按业务、按站点设阈值,超限快速失败 | 守住总入口,保护后端 |
| 服务 | 线程池隔离 + 信号量控制 | 核心/非核心业务隔离,非核心可降级 | 防止局部故障蔓延 |
| 数据库 | 连接池上限 + 慢SQL拦截 | 限制最大连接数,超时自动熔断 | 守住最后底线 |
关键原则:每一层的限流阈值,必须比下一层的承载量小。 这样才能保证流量永远不会击穿到下一层。如果网关限1万,数据库只能扛5000,那等于没限。
3.2 消息队列异步解耦:核心链路全异步化
充电核心链路改造前:
用户扫码 → 鉴权 → 创建订单 → 下发启充指令 → 设备响应 → 返回结果
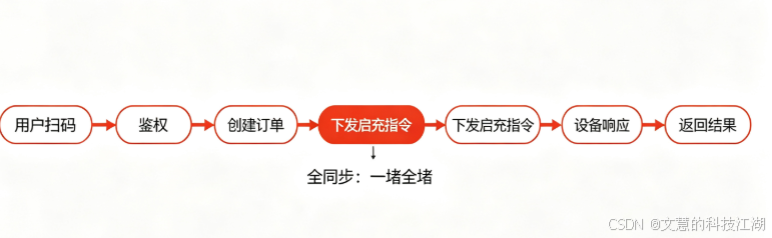
全同步,任何一步慢了,整个请求就超时。
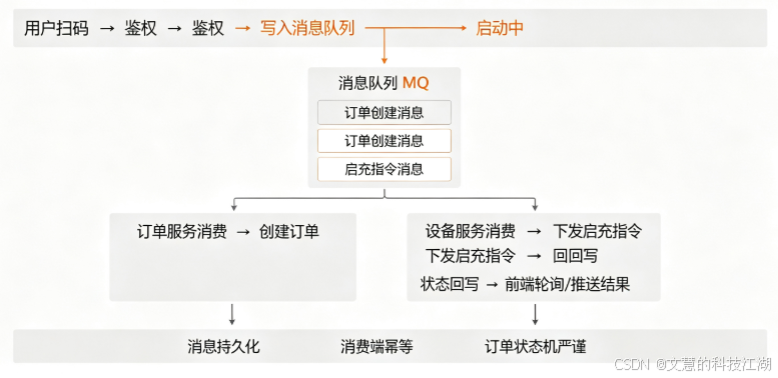
改造后:
用户扫码 → 鉴权 → [写入消息队列] → 立即返回"启动中"
                          ↓
                    订单服务消费 → 创建订单
                          ↓
                    设备服务消费 → 下发启充指令
                          ↓
                    状态回写 → 前端轮询/推送结果
几个关键点:
- 消息必须持久化,用RocketMQ或Kafka,确保不丢消息;
- 消费端要做幂等,防止重复消费导致重复下单;
- 关键操作要落库确认,订单状态机要严谨,不能出现"中间态"卡死。
3.3 Netty长连接集群:海量设备接入方案
设备接入层的架构要点:
- Netty服务集群化部署,前面挂负载均衡(建议四层LB,支持TCP长连接分发);
- 连接会话状态集中存储(Redis),任何一台节点宕机,设备重连后会话不丢;
- 心跳机制:设备30秒发一次心跳,90秒无心跳判定离线,清理连接;
- 指令下发走长连接,延迟控制在毫秒级,不用轮询。
一个Netty节点,合理配置下可以轻松扛10万+长连接。集群部署后,横向扩展即可。
3.4 多级缓存架构:读请求的三级跳
请求 → Caffeine本地缓存(命中即返回,微秒级)
     → Redis分布式缓存(命中返回,毫秒级)
     → 数据库(兜底,同时回写缓存)
注意事项:
- 缓存一致性:电价、桩状态等数据变更时,要主动删缓存,而不是更新缓存(删比更安全);
- 缓存穿透:查询不存在的数据,用布隆过滤器或缓存空值防穿透;
- 缓存雪崩:过期时间加随机偏移,避免大量key同时过期。
四、商业价值:技术的尽头,是真金白银
讲完技术,必须算一笔账。很多技术人觉得,做高可用就是为了"不崩"。但在充电运营这个赛道,高峰不崩,就是你最硬的护城河。
99.99%的可用率,意味着什么?
对车队客户来说,这是成本红线。 重卡、物流车队,谷电时段就是利润空间。竞品系统崩了,充不上电,车趴窝一晚上,损失的是真金白银。而你的系统稳,车队就会用脚投票,长期绑定你。ToB生意,稳定性就是最好的销售。
对运营来说,这是成本下降。 不丢单,就不用通宵对账;不崩,就不用全员救火;投诉少了,客服压力小了。这些省下来的人力,都是纯利润。
对口碑来说,这是复利效应。 充电行业圈子很小,一个车队用得好,会介绍十个车队。反过来,一次高峰崩掉,口碑要半年才能修复。
我常说一句话:平时好用不算本事,别人都崩的时候你不崩,才是竞争力。
很多系统,日常99.9%的时间都没问题。但用户记住的,永远是那0.1%崩掉的时刻。信任就是在那几次高峰里,一点点消耗完的。
反过来,别人扛不住的时候你扛住了,这就是你拉开差距的机会。
最后
总结一下这篇文章的核心:
面对谷电高峰的脉冲式流量,别上来就加服务器。先想清楚——你要修的是四道闸门,还是挖三个蓄水池。
- 四道闸门:前端→网关→服务→数据库,层层限流,层层防护;
- 三个蓄水池:消息队列削峰、多级缓存减负、Netty集群稳连接;
- 最终目标:99.99%可用率,不崩、不卡、不丢单。
技术的价值,从来不是堆砌了多少组件,而是在用户最需要的那一刻——零点的谷电,凌晨的车队,司机扫码的那一秒——系统稳稳地接住了。
充电桩"嘀"的一声启动,订单稳稳生成,流水一笔不丢。
这,就是架构的力量。
你在做高并发系统时,踩过最印象深刻的坑是什么?评论区聊聊
转载自 CSDN-专业IT技术社区

