

基于 WorkBuddy 搭配 Hy4 Preview 打造「苏轼《定风波》三维诗词页」:Three.js + Web Speech API 从 AI 建模到网页朗读的完整实践
摘要:本文记录了在 WorkBuddy + Hy4 Preview 环境下完成的一个有趣的跨界实践——用腾讯混元生 3D 生成苏轼的三维人像,再用 Three.js 把它搬进网页,最后调用浏览器原生的 Web Speech API,让东坡先生"亲口"念出《定风波》。全文围绕模型生成 → 结构校验 → 场景搭建 → 加载容错 → 竖排排版 → 语音同步六个环节展开,重点复盘了"内联模型解析失败"这一真实踩坑的完整排查过程,并给出可复用的排查思路与最终方案。所有代码均可直接运行。
开发环境:WorkBuddy(Windows 客户端)+ Hy4 Preview
关键词:Three.js、Web Speech API、GLTFLoader、混元生3D、GLB、竖排排版、语音合成
阅读建议:如果你只关心"怎么让网页朗读中文并高亮",可直接跳到第五章;如果你正在被"GLB 模型加载失败"折磨,第三章的排查思路会更有价值。
效果预览
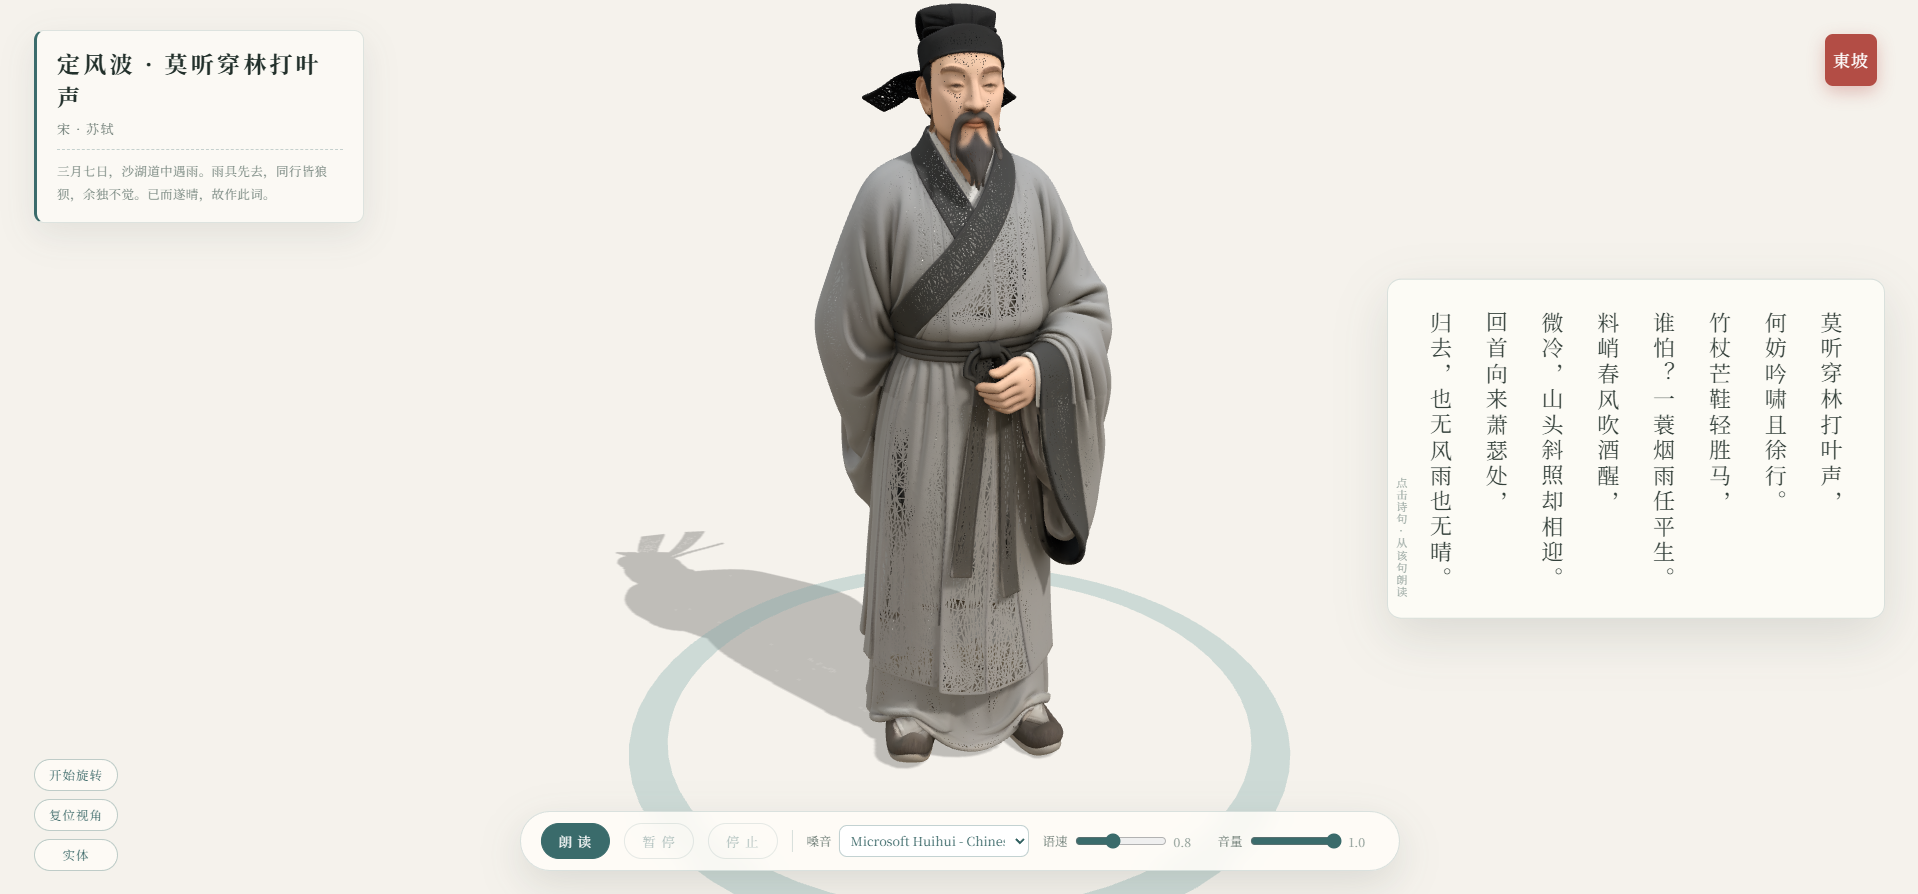
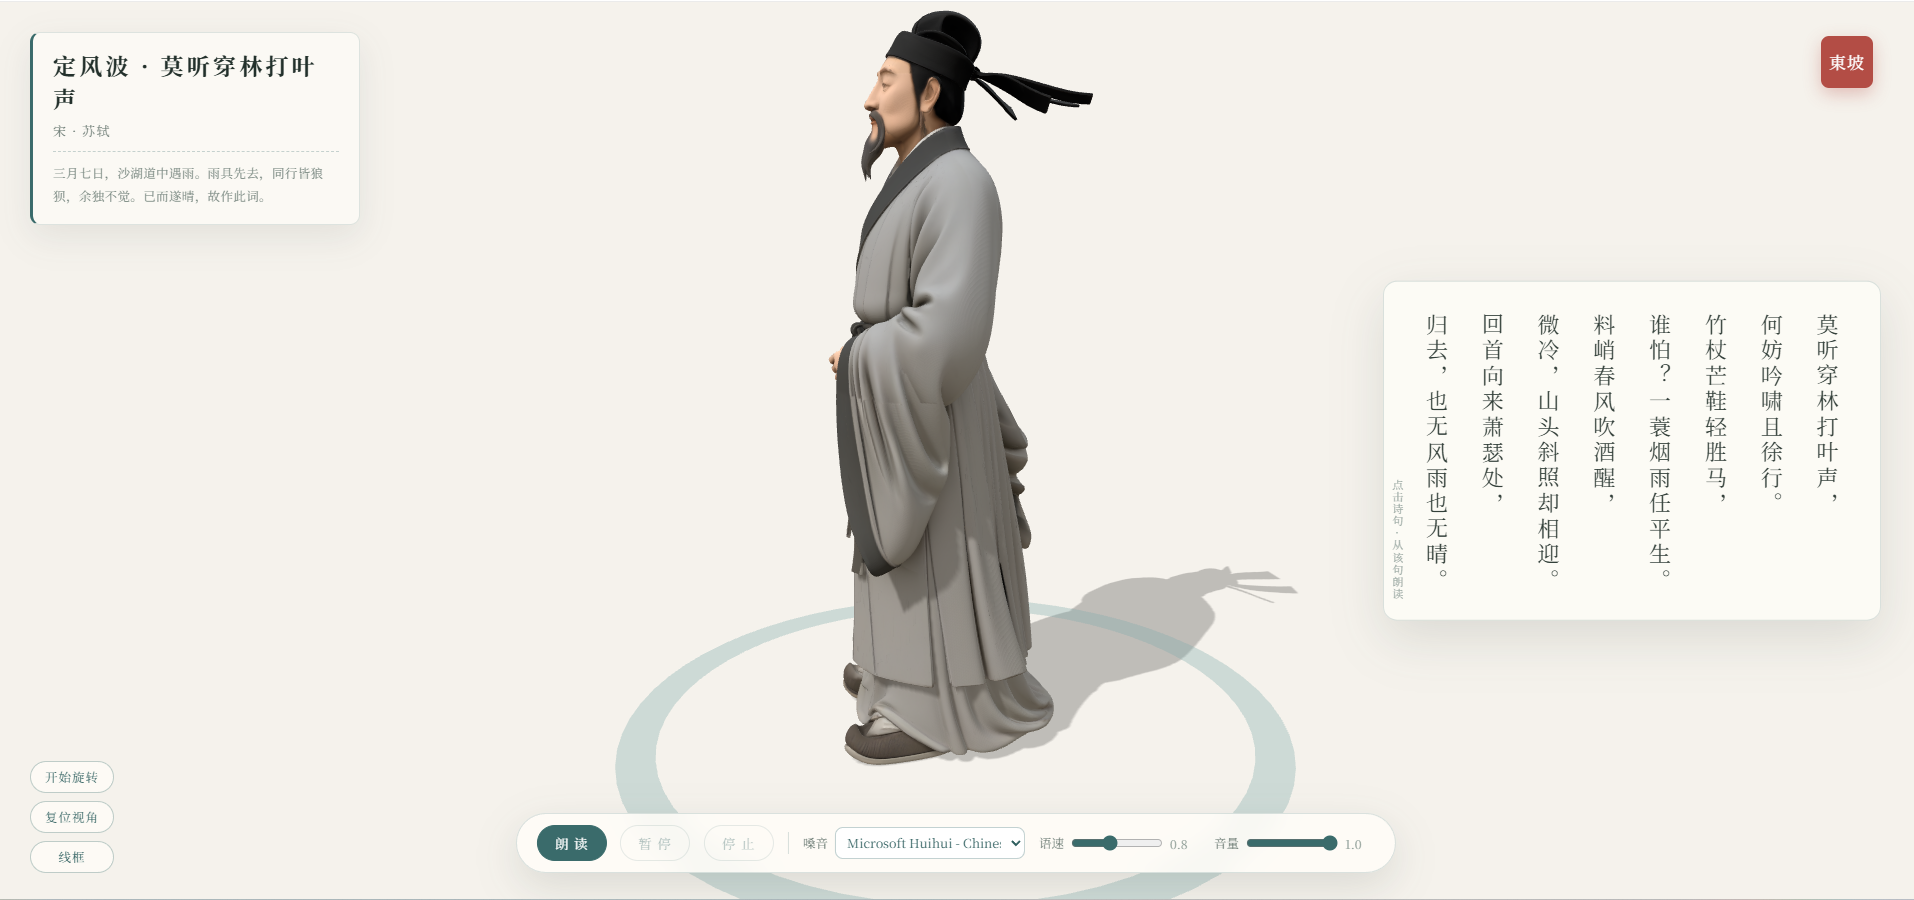
先看看最终做成了什么样:一个浅色水墨风的页面,左侧是缓缓旋转的苏轼三维立像,右侧竖排展示《定风波》全文,底部是语音控制条。点击"朗读",页面会用中文逐句念出这首词,当前朗读的句子会实时高亮成红色。
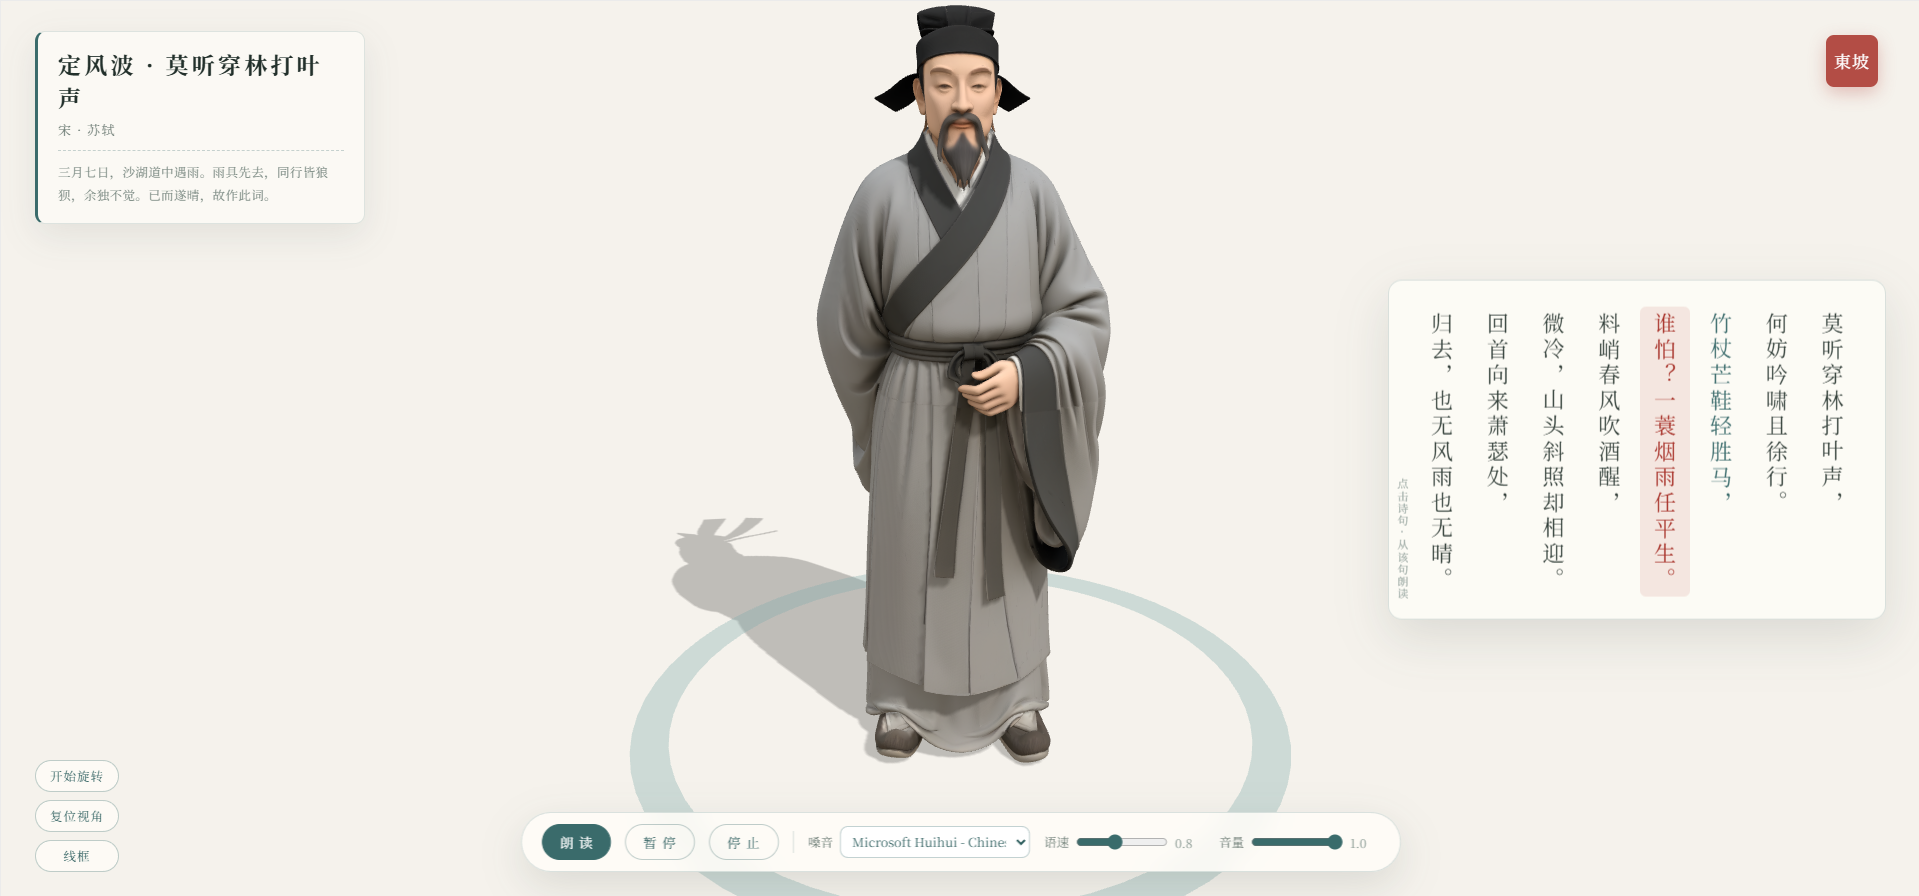
在线交互能力一览:
| 交互 | 操作方式 |
|---|---|
| 旋转人像 | 鼠标左键拖拽 |
| 缩放 | 滚轮 |
| 平移 | 鼠标右键拖拽 |
| 朗读全词 | 点击"朗读"按钮 / 空格键 |
| 从指定句朗读 | 直接点击该诗句 |
| 暂停 / 继续 | 点击"暂停" / 空格键 |
| 停止 | 点击"停止" / Esc 键 |
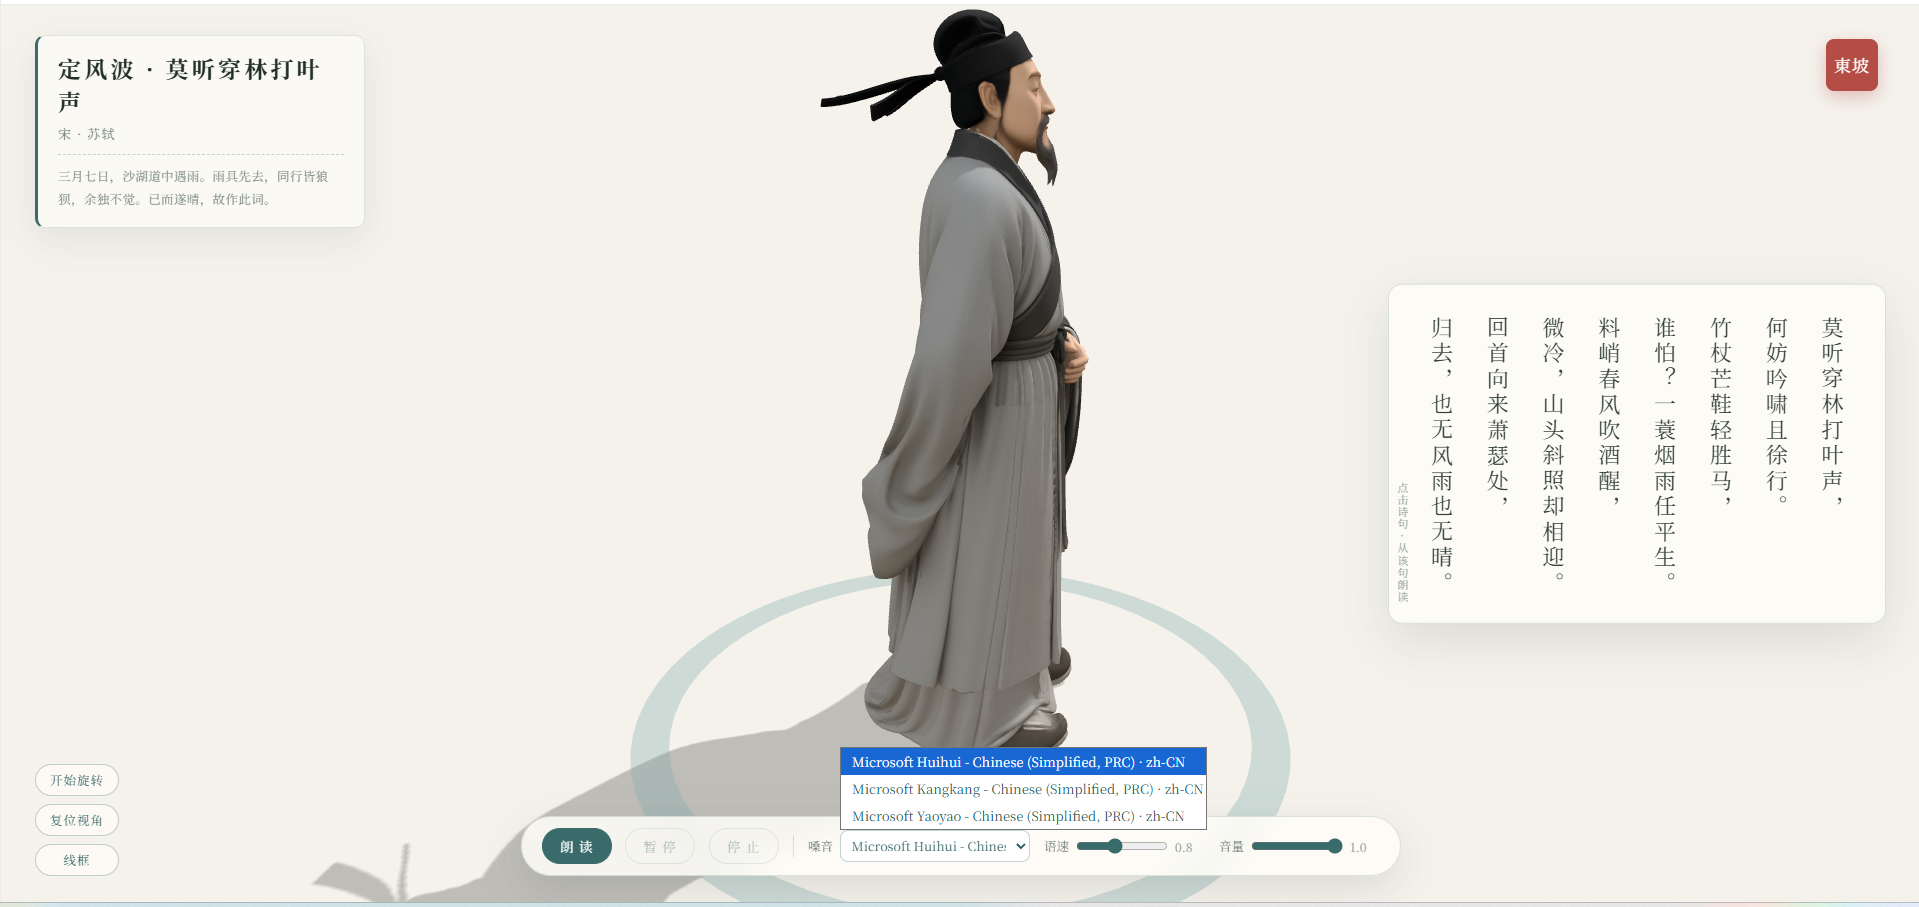
| 换音色 / 调速 | 底部下拉框与滑块 |
| 手动载入模型 | 点击选择文件,或把 glb 拖进页面 |
本文大纲
| 章节 | 主题 | 核心内容 |
|---|---|---|
| 一 | 技术选型与整体架构 | 为什么是 Three.js + 原生 Web Speech,整体模块划分 |
| 二 | 三维人像:从 AI 建模到 GLB 校验 | 混元生 3D 调用、GLB 二进制结构解析、扩展检查 |
| 三 | 踩坑实录:51MB 内联模型的解析失败 | base64 内联的陷阱、Node 环境复现、fetch 方案改造 |
| 四 | 词文呈现:竖排排版与响应式 | writing-mode 实战、视觉风格、移动端适配 |
| 五 | 让东坡开口:语音朗读与高亮同步 | speechSynthesis 逐句调度、中文嗓音筛选、GC 坑 |
| 六 | 完整源码、运行与扩展 | 项目结构、启动方式、换诗词/换人物的改造点 |
一、技术选型与整体架构
1.1 需求拆解
最初的需求只有一句话:"做一个网页,展示苏轼的 3D 形象,配上他的代表作《定风波》,还能朗读出来。"拆开看是三件事:
- 三维内容从哪来 —— 手头没有任何苏轼的 3D 模型资产;
- 怎么在网页里展示 —— 需要 WebGL 渲染与交互控制;
- 怎么"发音" —— 不引入后端 TTS 服务的前提下,最轻量的方案是什么。
1.2 选型决策
| 需求 | 候选方案 | 最终选择 | 理由 |
|---|---|---|---|
| 3D 模型来源 | 手工建模 / 素材站下载 / AI 生成 | 腾讯混元生 3D | 一句话出模,自带 PBR 纹理,无需美术基础 |
| 渲染引擎 | Babylon.js / Three.js | Three.js r128 | 生态最成熟,GLTFLoader 与 OrbitControls 开箱即用 |
| 语音合成 | 云端 TTS API / 原生 Web Speech | Web Speech API | 零后端、零密钥、零费用,前端一个 API 搞定 |
| 交付形态 | 多文件工程 / 单文件 HTML | 单文件 HTML | 双击即开,便于传播 |
这里有个值得说明的取舍:为什么不用云端 TTS。阿里云、腾讯云的语音合成效果确实更自然,但意味着要引入密钥管理、后端代理、跨域与计费。而 Web Speech API 虽然音色依赖用户操作系统自带的语音包(Windows 上通常是 Microsoft Huihui / Yaoyao),但零依赖、零成本,对一个展示型页面完全够用。
关于开发环境:本文的全部工作——从调用混元生 3D 生成模型、编写 Three.js 与语音代码,到第三章那场"解析失败"的排查——均在 WorkBuddy(Windows 客户端)+ Hy4 Preview 中通过对话完成。工具在这里的价值不在于替代思考,而在于把"假设 → 验证 → 修正"的循环压缩得足够短。
1.3 架构分层
整个页面按"数据—呈现—交互"三层组织,最终通过构建脚本合并为单文件:
┌─────────────────────────────────────────────┐
│  数据层    POEM[] 词文数组(展示/朗读共用)      │
├─────────────────────────────────────────────┤
│  呈现层    Three.js 场景  +  竖排 DOM 词文      │
├─────────────────────────────────────────────┤
│  交互层    OrbitControls  +  speechSynthesis  │
└─────────────────────────────────────────────┘
              ↓  build_poem.py 内联合并
         dingfengbo.html(751 KB,离线可用)
关键设计是词文只有一份数据源。词句既要渲染成 DOM,又要送给语音引擎,如果各写一份,改一个标点就会不同步。所以统一用 POEM 数组,DOM 由它生成,朗读也按它的下标推进:
var POEM = [
  "莫听穿林打叶声,",
  "何妨吟啸且徐行。",
  "竹杖芒鞋轻胜马,",
  "谁怕?一蓑烟雨任平生。",
  "料峭春风吹酒醒,",
  "微冷,山头斜照却相迎。",
  "回首向来萧瑟处,",
  "归去,也无风雨也无晴。"
];
二、三维人像:从 AI 建模到 GLB 校验
2.1 用混元生 3D 生成苏轼像
模型通过腾讯云 ai3d 接口生成,核心参数如下:
- 模型版本:3.1(高精度)
- 开启 PBR:生成自带金属度/粗糙度的物理材质
- 面数:30 万
- 耗时:约 3 分 35 秒
提示词是效果的关键。实践发现,描述越具体,出模越稳,尤其是"完整人体比例"“站立姿态”"纯色简洁背景"这类约束对生成质量影响很大:
中国古代北宋大文豪苏轼的写实风格全身立像,头戴黑色东坡巾,面容清癯、长须飘然,
神态儒雅从容,身穿宋代文人宽袖交领长袍,腰间束带,双手拢袖自然垂于身前,
双脚着布鞋,完整人体比例,站立姿态,精细的布料与皮肤纹理,
纯色简洁背景,适合三维展示
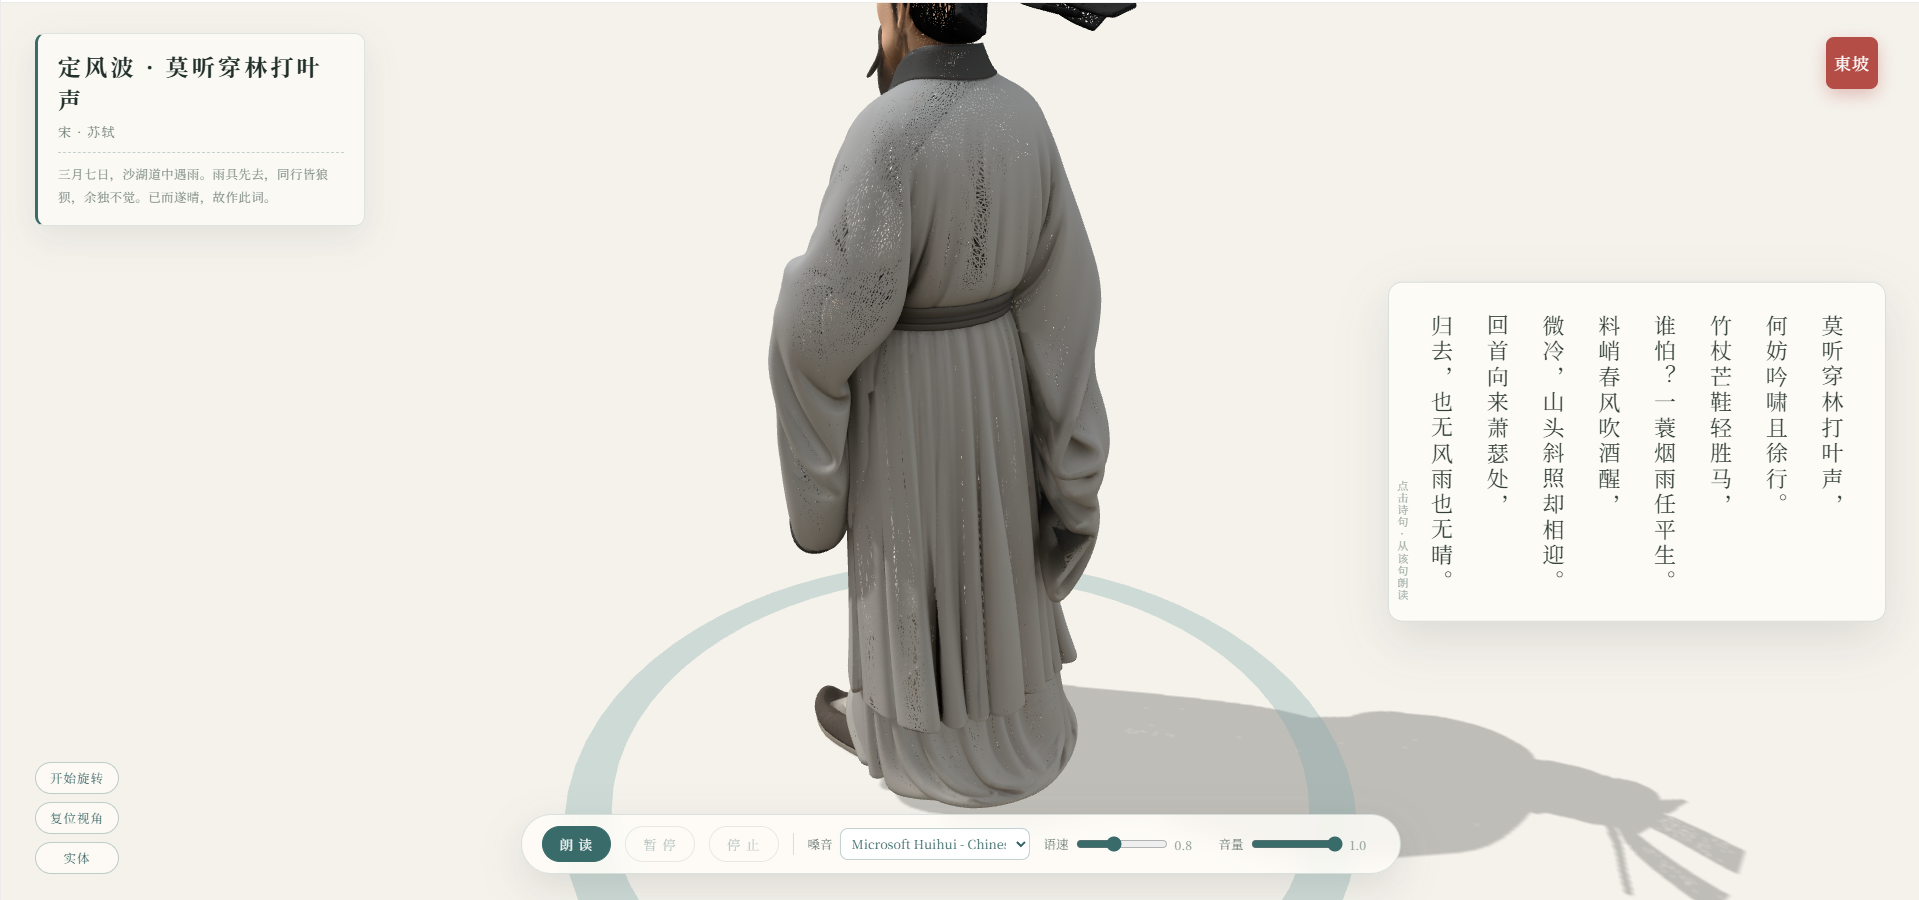
生成完成后务必第一时间把模型下载到本地——云端的 COS 链接通常只有 24 小时有效期。最终拿到 models/sushi.glb。
2.2 GLB 结构校验:先确认文件没坏
在怀疑任何加载代码之前,先验证文件本身。GLB 是二进制容器,结构非常规整:12 字节文件头 + 若干 chunk。
import struct, json

data = open("models/sushi.glb", "rb").read()

# 1) 校验文件头
magic, ver, length = struct.unpack("<4sII", data[:12])
print("magic:", magic, "version:", ver, "declared:", length, "actual:", len(data))

# 2) 遍历所有 chunk
off = 12
while off < len(data):
    clen, ctype = struct.unpack("<II", data[off:off+8])
    off += 8
    body = data[off:off+clen]
    off += clen
    print("chunk:", {0x4E4F534A: "JSON", 0x004E4942: "BIN"}[ctype], "len =", clen)

# 3) 检查是否使用了 Draco 压缩等扩展
meta = json.loads(body_json)
print("extensionsUsed    :", meta.get("extensionsUsed"))
print("extensionsRequired:", meta.get("extensionsRequired"))
健康的输出应该是这样的:
magic: b'glTF' version: 2 declared: 37756220 actual: 37756220
chunk: JSON len = 12345
chunk: BIN  len = 37743000
extensionsUsed    : ['KHR_materials_specular']
extensionsRequired: None
三个要点:
- **magic 必须是
b'glTF'**,否则文件根本不是 GLB(可能是下载成了 HTML 错误页); - declared 与 actual 长度必须一致,不一致说明下载被截断;
- 检查
extensionsRequired里有没有KHR_draco_mesh_compression。如果有,GLTFLoader 必须额外挂载DRACOLoader并指定解码器路径,否则会直接报解析失败——这是最常见的"模型加载不出来"原因之一。
本例幸运地没有用 Draco,纹理也是内嵌 PNG,属于最省心的情形。
2.3 搭建 Three.js 场景
场景部分追求"展厅感":柔和的环境光打出整体亮度,一盏主光投射柔和阴影,再补一盏冷色轮廓光把人物从背景里"抠"出来。
var scene = new THREE.Scene();
scene.background = new THREE.Color(0xf5f2ec);   // 宣纸底色

var camera = new THREE.PerspectiveCamera(45, innerWidth / innerHeight, 0.01, 100);
camera.position.set(0, 1.15, 4.3);

var renderer = new THREE.WebGLRenderer({ antialias: true });
renderer.setPixelRatio(Math.min(devicePixelRatio, 2));
renderer.setSize(innerWidth, innerHeight);
renderer.outputEncoding = THREE.sRGBEncoding;      // 关键:否则 PBR 贴图会发灰
renderer.shadowMap.enabled = true;
renderer.shadowMap.type = THREE.PCFSoftShadowMap;
document.body.appendChild(renderer.domElement);

var controls = new THREE.OrbitControls(camera, renderer.domElement);
controls.enableDamping = true;   controls.dampingFactor = 0.08;
controls.target.set(0, 1.0, 0);
controls.autoRotate = true;      controls.autoRotateSpeed = 1.0;
controls.minDistance = 1.5;      controls.maxDistance = 12;

// 三点布光:环境光 + 主光(投影)+ 冷色轮廓光
scene.add(new THREE.HemisphereLight(0xffffff, 0xbfae93, 0.85));
var key = new THREE.DirectionalLight(0xffffff, 1.05);
key.position.set(3, 6, 4);
key.castShadow = true;
key.shadow.mapSize.set(2048, 2048);
key.shadow.bias = -0.0004;                          // 消除阴影痤疮
scene.add(key);
var rim = new THREE.DirectionalLight(0x9fb9c9, 0.35);
rim.position.set(-4, 3, -3);
scene.add(rim);
几个容易忽略的细节:
outputEncoding = sRGBEncoding是 PBR 材质色彩正确的前提,漏掉会导致模型整体发灰、发闷;shadow.bias必须给一个小的负值,否则模型表面会出现条纹状的"阴影痤疮";shadow.camera的left/right/top/bottom要覆盖模型包围盒,否则阴影会被裁掉。
2.4 自动构图:让任意模型都居中且大小合适
AI 生成的模型尺寸是未知的,硬编码相机距离必然会翻车。正确做法是算出包围盒,再归一化缩放并居中:
function frameModel(obj) {
  obj.traverse(function (o) {
    if (o.isMesh) { o.castShadow = true; o.receiveShadow = true; }
  });

  var box    = new THREE.Box3().setFromObject(obj);
  var size   = box.getSize(new THREE.Vector3());
  var center = box.getCenter(new THREE.Vector3());

  var maxDim = Math.max(size.x, size.y, size.z) || 1;
  var scale  = 2.4 / maxDim;              // 统一归一到 2.4 个单位高
  obj.scale.setScalar(scale);

  // 先把几何中心移到原点,再抬高,使脚底落在 y = 0 的地面上
  obj.position.sub(center.multiplyScalar(scale));
  obj.position.y += (size.y * scale) / 2;

  scene.add(obj);
}
这段逻辑的核心在于顺序:先缩放、再平移中心、最后抬升。写反了模型会"陷进地里"或者悬空。
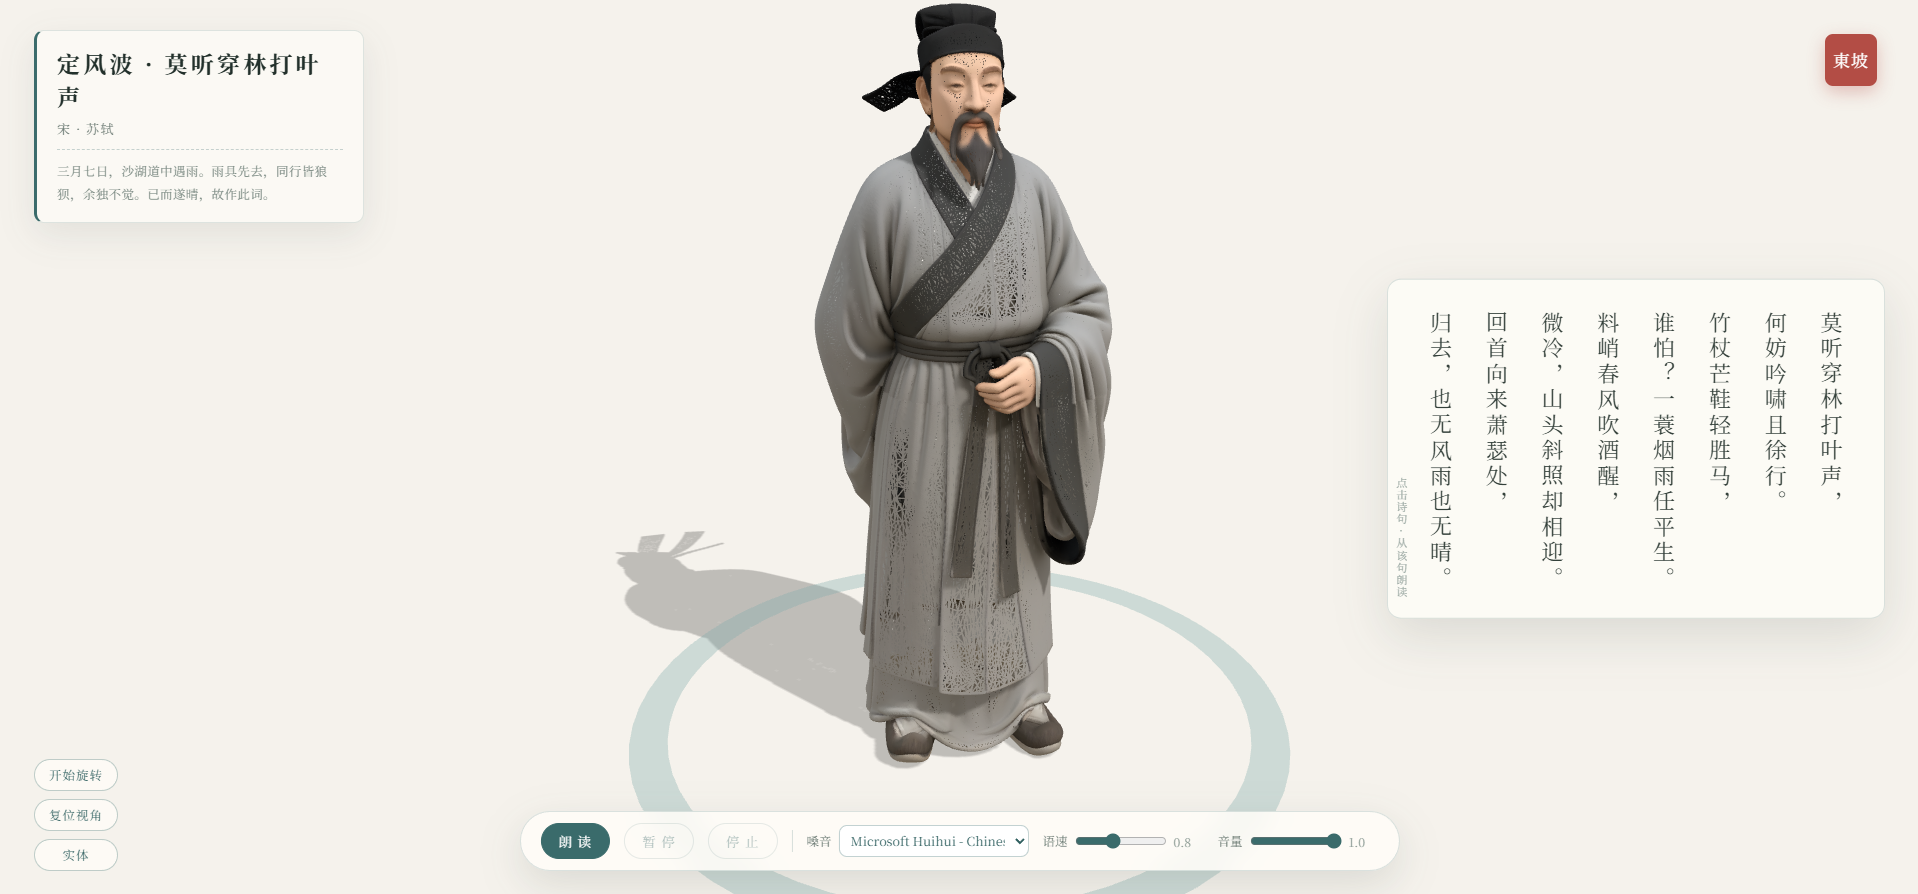
三、踩坑实录:内联模型的解析失败之谜
这一章是整个项目最有价值的部分,也是我踩得最狠的一个坑。
3.1 起因:追求"真正的单文件"
最初的思路很朴素:既然要"双击就能打开",那就把 GLB 以 base64 编码直接内联进 HTML。于是生成了一个HTML 文件(37.7 MB 的 GLB 编码后膨胀约 33%)。
结果浏览器无情报错:
模型解析失败
3.2 第一层排查:文件真的完整吗?
遇到"解析失败",第一反应是文件坏了。于是做了两件事:
① 校验 base64 能否无损还原
import re, base64, hashlib

html = open("sushi.html", "rb").read().decode("utf-8", "ignore")
b64  = re.search(r'const GLB_B64\s*=\s*"([^"]+)"', html).group(1)
data = base64.b64decode(b64)
orig = open("models/sushi.glb", "rb").read()

print("decoded bytes :", len(data))
print("orig bytes    :", len(orig))
print("identical     :", data == orig)
print("sha256 (dec)  :", hashlib.sha256(data).hexdigest()[:16])
print("sha256 (orig) :", hashlib.sha256(orig).hexdigest()[:16])
输出 identical: True,两个 sha256 完全一致。文件毫无问题。
② 用 Node 复现真实报错
既然文件没坏,就让同版本的 GLTFLoader 在 Node 里跑一遍,把真实异常抓出来:
const fs = require('fs');
global.THREE = require('three');
require('three/examples/js/loaders/GLTFLoader.js');

const data = fs.readFileSync('models/sushi.glb');
const ab   = data.buffer.slice(data.byteOffset, data.byteOffset + data.byteLength);

new THREE.GLTFLoader().parse(ab, '',
  (gltf) => console.log('PARSE OK, children =', gltf.scene.children.length),
  (err)  => console.error('PARSE ERROR >>>', err && err.message)
);
结果是 PARSE OK——几何和材质都成功解析了!
结论:模型格式与 r128 完全兼容,问题不在文件,而在浏览器端"51MB 巨型内联脚本 + atob"这条加载路径。超大内联脚本在解析成 JS 字符串时,会撞上浏览器的内存与字符串长度上限,最终触发 parse 的失败回调。
3.3 第二层排查:一个"假阳性"的干扰
排查过程中还遇到一个很有迷惑性的干扰,值得单独记一笔。我用一个命令检查 HTML 里是否还有未替换的占位符:
grep -c "__THREE__\|__APP__\|__GLTF__\|__ORBIT__" sushi.html
# 输出:1
看起来"还有一个占位符没替换"。但实际上这是误报:three.min.js 是压缩后的单行代码,整段挤在 HTML 的第 80 行;而它源码内部本身就含有 __THREE__ 这个字符串(UMD 全局名判断)。grep -c 统计的是匹配的行数,不是匹配次数,所以只要这一行里有这个串,结果就是 1。
教训:用 grep -c 做完整性校验时,要注意它数的是行而非次数;压缩后的单行文件会让这类检查彻底失真。正确的做法是校验"裸露占位符"这种带上下文的模式:
grep -c "<script>__THREE__</script>" sushi.html # 这才是真正想查的
3.4 最终方案:放弃内联,改用 fetch
方向很明确——别把 37MB 塞进 HTML。改造后的方案:
| 对比项 | base64 内联(失败) | fetch 加载(采用) |
|---|---|---|
| HTML 体积 | 51 MB | 751 KB |
| 首屏解析压力 | 极大,易触发内存上限 | 正常 |
| 双击打开 | 可用 | 受限于 file:// 安全策略 |
| 模型加载 | 同步可用 | 需 HTTP 服务,或手动选择文件 |
配套地,为了兼顾"双击打开"的场景,加了多候选路径尝试 + 文件选择器 + 拖拽加载三重兜底:
// 多候选路径依次尝试,兼容不同的静态托管方式
var CANDIDATES = ['models/sushi.glb', './models/sushi.glb',
                  '../models/sushi.glb', 'sushi.glb'];

function tryFetch(i) {
  i = i || 0;
  if (i >= CANDIDATES.length) {
    loaderEl.classList.add('hide');
    showErr('未能自动加载模型。请选择 sushi.glb,或把 glb 拖拽到页面中。');
    return;
  }
  loaderEl.classList.remove('hide');
  fetch(CANDIDATES[i])
    .then(function (r) {
      if (!r.ok) throw new Error('HTTP ' + r.status);
      return r.arrayBuffer();
    })
    .then(loadModel)
    .catch(function (err) {
      console.warn('fetch 失败:' + CANDIDATES[i], err);
      tryFetch(i + 1);                 // 换下一个候选路径
    });
}

// 兜底一:文件选择器
fileInput.addEventListener('change', function () {
  readFile(this.files && this.files[0]);
});

// 兜底二:拖拽 glb 到页面
addEventListener('dragover', function (e) { e.preventDefault(); });
addEventListener('drop', function (e) {
  e.preventDefault();
  var f = e.dataTransfer && e.dataTransfer.files && e.dataTransfer.files[0];
  if (f) readFile(f);
});

function readFile(f) {
  if (!f) return;
  var fr = new FileReader();
  fr.onload  = function () { loadModel(fr.result); };
  fr.onerror = function () { showErr('读取文件失败,请重试。'); };
  fr.readAsArrayBuffer(f);
}
3.5 附赠一个坑:本地服务返回 502
改造完成后,用 python -m http.server 8088 起服务,curl 却一直返回 502,而端口确实在监听。
排查发现是环境代理在作祟:
env | grep -i proxy
# http_proxy=http://127.0.0.1:63845
# https_proxy=http://127.0.0.1:63845
代理把 localhost 请求也拦了。绕过即可:
curl --noproxy '*' http://127.0.0.1:8088/dingfengbo.html
# dingfengbo HTTP=200 BYTES=751108
如果你在容器/公司网络里遇到本地服务莫名 502,先查代理环境变量,能省下大量时间。
四、词文呈现:竖排排版与响应式布局
4.1 一行 CSS 实现古籍竖排
古典诗词用竖排才有味道。CSS 的 writing-mode 让这件事变得异常简单:
#poemLines {
  writing-mode: vertical-rl;    /* 从右向左竖排 */
  text-orientation: mixed;      /* CJK  upright,拉丁字母旋转 */
  max-height: 58vh;
}

.line {
  display: block;
  margin: 0 6px;                /* 竖排下,块级方向是水平的,左右 margin 即行间距 */
  font-size: 22px;
  line-height: 1.9;
  letter-spacing: .16em;
  color: #33403a;
  cursor: pointer;
  transition: color .25s, background .25s;
}

.line:hover  { color: #3a6b6b; }
.line.active { color: #a8322a; background: rgba(168, 50, 42, .10); }
重点理解:在 vertical-rl 下,块级元素的排列方向变成了从右到左,所以分隔相邻"行"(视觉上的列)要用左右 margin,而不是上下 margin。这一点非常反直觉,写错了间距会完全不对。
4.2 视觉风格:浅色水墨
配色上走"宣纸 + 青瓷 + 朱印"的路线,克制且耐看:
| 元素 | 色值 | 用途 |
|---|---|---|
| 宣纸底 | #f5f2ec | 页面与场景背景 |
| 青瓷 | #3a6b6b | 主色调、按钮、强调 |
| 墨色 | #33403a | 正文词文 |
| 朱砂 | #a8322a | 朗读高亮、印章 |
背景再铺一层超大号的装饰文字(低透明度),增加层次但不抢戏:
#deco span {
  position: absolute;
  font-weight: 700;
  white-space: nowrap;
  letter-spacing: .12em;
}
#deco .d1 { top: 4%;  left: -3%; font-size: 20vh; color: rgba(58,107,107,.05); }
#deco .d2 { bottom: 2%; right: -4%; font-size: 15vh; color: rgba(58,107,107,.045); }
对应的 HTML 结构:
<div id="deco">
  <span class="d1">一蓑烟雨任平生</span>
  <span class="d2">也无风雨也无晴</span>
</div>
4.3 响应式:竖排在小屏上必须让位
竖排在手机上会挤成一团,所以窄屏下切换回横排并移到底部:
@media (max-width: 980px) {
  #poemCard  { right: 12px; left: 12px; top: auto; bottom: 96px; transform: none; }
  #poemLines { writing-mode: horizontal-tb; max-height: none; }
  .line      { font-size: 15px; margin: 3px 0; letter-spacing: .08em; }
  #seal, #view3d { display: none; }        /* 小屏隐藏装饰与三维按钮 */
  #bar       { bottom: 12px; gap: 9px; border-radius: 16px; }
}
五、让东坡先生开口:Web Speech API 逐句朗读与高亮同步
5.1 核心思路:逐句调度而非整段朗读
最直觉的做法是把整首词塞进一个 utterance 一次读完,但这样无法做逐句高亮——onboundary 事件在中文上的支持非常不稳定,很多浏览器根本不触发。
可靠的方案是拆句调度:每一句一个 utterance,靠 onend 驱动下一句,顺便切换高亮。
var synth = window.speechSynthesis;
var supported = !!synth && typeof window.SpeechSynthesisUtterance === 'function';
var idx = 0, playing = false, isPaused = false, curUtter = null;

function startAt(i) {
  if (!supported) {
    alert('当前浏览器不支持 Web Speech 语音合成,建议改用 Chrome / Edge。');
    return;
  }
  synth.cancel();                 // 先清空队列,避免叠加
  idx = i; playing = true; isPaused = false;
  updateBtns();
  speakLine();
}

function speakLine() {
  if (!playing) return;
  if (idx >= POEM.length) { stopAll(); return; }

  highlight(idx);                 // 高亮当前句

  var u = new SpeechSynthesisUtterance(POEM[idx]);
  u.lang   = 'zh-CN';
  u.rate   = rate;
  u.volume = vol;
  u.pitch  = 1.0;

  var v = currentVoice();
  if (v) u.voice = v;

  curUtter = u;                   // ★ 关键:持有引用,防止被 GC 中断

  u.onend = function () {
    if (!playing) return;
    idx++; speakLine();           // 读下一句
  };
  u.onerror = function () {
    if (!playing) return;
    idx++; speakLine();           // 单句出错不要中断整首
  };

  synth.speak(u);
}
三个必须注意的点:
curUtter = u不能省。utterance 若没有外部引用,Chrome 下可能在朗读过程中被垃圾回收,导致读到一半突然静音。这是 Web Speech 最经典的坑之一。onerror里要继续推进。个别句子(如含生僻字)可能触发错误,若在这里中断,整首词就卡住了。startAt里先synth.cancel()。否则连续点击会排队叠加,出现"两句话同时念"的重叠。
5.2 中文嗓音筛选
speechSynthesis.getVoices() 返回系统里所有语音包,需要筛出中文的;而且这个方法是异步的——页面刚加载时常常返回空数组,必须监听 voiceschanged:
function zhVoices() {
  var vs = (supported ? synth.getVoices() : []) || [];
  return vs.filter(function (v) {
    return /^zh|^cmn|Chinese|中文|普通话/i.test((v.lang || '') + ' ' + (v.name || ''));
  });
}

function currentVoice() {
  if (!supported) return null;
  var vs = synth.getVoices() || [];
  if (voiceURI) {
    var m = vs.filter(function (v) { return v.voiceURI === voiceURI; })[0];
    if (m) return m;
  }
  var zh = zhVoices();
  // 优先 zh-CN,其次任意一个中文嗓音
  return zh.filter(function (v) { return /zh[-_]CN|cmn[-_]Hans[-_]CN/i.test(v.lang || ''); })[0]
      || zh[0] || null;
}

// 异步加载:初始调用一次 + 监听变更
if (supported) {
  populateVoices();
  synth.onvoiceschanged = populateVoices;
}
Windows 上常见的中文嗓音是 Microsoft Huihui / Yaoyao / Kangkang(zh-CN)。如果想让用户自由切换,把 zhVoices() 的结果渲染进 <select> 即可,切换时重新调用 startAt(idx) 就能"立刻用新嗓音重读当前句"。
5.3 高亮与交互联动
高亮逻辑很简单,但配合点击跳转和窄屏滚动会更好用:
function highlight(i) {
  lineEls.forEach(function (el, k) {
    if (k === i) {
      el.classList.add('active');
      // 窄屏横排时,自动把当前句滚进可视区
      if (el.scrollIntoView) el.scrollIntoView({ block: 'nearest', inline: 'nearest' });
    } else {
      el.classList.remove('active');
    }
  });
}
DOM 由 POEM 生成时顺手绑定点击,实现点哪句从哪句读:
POEM.forEach(function (txt, i) {
  var d = document.createElement('div');
  d.className = 'line';
  d.textContent = txt;
  d.title = '点击从该句开始朗读';
  d.addEventListener('click', function () { startAt(i); });
  box.appendChild(d);
  lineEls.push(d);
});
暂停/继续/停止用原生 API 即可,注意同步按钮状态:
function togglePause() {
  if (!playing) return;
  if (isPaused) { synth.resume(); isPaused = false; }
  else          { synth.pause();  isPaused = true;  }
  updateBtns();
}

function stopAll() {
  playing = false; isPaused = false;
  if (supported) synth.cancel();
  clearHL();
  updateBtns();
}
最后加个键盘快捷键,体验会好很多:
document.addEventListener('keydown', function (e) {
  var t = e.target || {};
  if (/INPUT|SELECT|TEXTAREA/.test(t.tagName || '')) return;  // 别抢表单的键
  if (e.code === 'Space')  { e.preventDefault(); if (!playing) startAt(0); else togglePause(); }
  if (e.code === 'Escape') { stopAll(); }
});
六、完整源码、本地运行与扩展方向
6.1 项目结构
sushi-3d/
├─ dingfengbo.html        # 最终成品:单文件页面(751 KB,离线可用)
├─ build_poem.py          # 构建脚本:把 Three.js 内联进 HTML
├─ models/
│  └─ sushi.glb           # 混元生3D 生成的苏轼人像(37.7 MB)
├─ assets/
│  └─ preview.png         # 模型预览图
├─ vendor/
│  ├─ three.min.js        # Three.js r128
│  ├─ OrbitControls.js    # 轨道控制
│  └─ GLTFLoader.js       # GLB 加载器
└─ index.html             # 早期服务器版页面
6.2 为什么要一个构建脚本
页面要"离线可用",就不能从 CDN 加载 Three.js;但把 600 KB 的库手工粘进 HTML 又无法维护。于是用 Python 做一次简单的占位符替换:
import os

BASE   = os.path.dirname(os.path.abspath(__file__))
VENDOR = os.path.join(BASE, "vendor")

def read(p):
    with open(os.path.join(VENDOR, p), "r", encoding="utf-8") as f:
        return f.read()

three_js = read("three.min.js")
orbit_js = read("OrbitControls.js")
gltf_js  = read("GLTFLoader.js")

out = (HTML.replace("__THREE__", three_js)
           .replace("__ORBIT__", orbit_js)
           .replace("__GLTF__",  gltf_js))

with open(os.path.join(BASE, "dingfengbo.html"), "w", encoding="utf-8") as f:
    f.write(out)
改代码时只改 build_poem.py 里的模板,重跑一次即可,比手工维护单文件靠谱得多。
6.3 本地运行
因为要 fetch 模型文件,必须通过 HTTP 服务打开(直接双击会被 file:// 安全策略拦截,此时页面会提示手动选择 glb):
cd sushi-3d
python -m http.server 8088
然后浏览器访问 http://localhost:8088/dingfengbo.html。
6.4 扩展方向
这个骨架很容易改成别的主题:
| 想做什么 | 改哪里 |
|---|---|
| 换一首词 | 只改 POEM 数组与标题区 HTML,其余无需动 |
| 换一个历史人物 | 重新生成 glb 放进 models/,改 CANDIDATES 里的文件名 |
| 加译文/注释 | 在 POEM 里加字段,渲染时多输出一行小字 |
| 换音色为云端 TTS | 把 speakLine 换成调用后端接口,其余调度逻辑完全复用 |
| 加背景音乐 | 用 <audio> 配合 startAt 一起触发 |
| 导出视频 | 用 renderer.domElement.captureStream() + MediaRecorder |
结语
回顾整个实践,真正花时间的不是写代码,而是第三章那个"解析失败"的排查。它给了一个很实用的教训:
当"解析失败"发生时,先证明文件没坏,再怀疑代码;先剥离环境差异,再下结论。
具体到这里沉淀下来的三条经验:
- 大文件不要内联进 HTML。base64 会让体积膨胀 33%,并撞上浏览器的字符串与内存上限。用
fetch加载,再配文件选择器/拖拽做兜底,才是正解。 - 校验文件完整性要用"带上下文"的模式。
grep -c数的是行不是次数,压缩后的单行文件会让这类检查彻底失真。 - Web Speech 的 utterance 必须持有引用,否则 GC 会在朗读中途把它收走,表现为"读到一半突然没声"。
技术本身都不复杂,难的是把"看起来应该能行"的方案,变成"真的能跑"的东西。希望这篇记录能让你在做类似的 3D + 语音网页时,少走几个小时弯路。
参考资料
- Three.js 官方文档
- MDN - Web Speech API
- MDN - SpeechSynthesisUtterance
- glTF 2.0 规范
- MDN - writing-mode
- 腾讯云混元生 3D
如果这篇对你有帮助,欢迎点赞收藏。有任何问题或更好的实现思路,欢迎在评论区交流。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/yelangkingwuzuhu/article/details/164758086

