

前言:
发现一款宝藏应用,那就是:SenseNova U1.5 Lite 模型。
轻松调用,效果不是一般的好,很多文生图模型根本不能比。
写这篇文章的时候,我一直在想一个问题:AI 的门槛到底在哪里?
是算力吗?SenseNova U1.5 Lite 用 8B 参数证明了,单卡 12GB 就能跑通文生图、图像编辑、视觉问答三大能力,不需要 A100,不需要云端 API,一台家用笔记本就够了。
是数据吗?不是。这套信息图 Pipeline 的输入是 JSON——任何做过数据分析的人都有的东西。从数据到可视化,中间只差一条命令。
是认知吗?可能是。很多人还停留在"AI 出图就是写个 prompt 等结果"的阶段,但 SenseNova U1.5 Lite 的 NEO-Unify 架构告诉我们,模型可以同时理解和生成,可以"先看懂再画出来"。这不是简单的文生图,而是一个能参与工作流的智能节点。
我做这个项目的初衷很简单——让重复的排版工作交给 AI,让人把时间花在数据洞察上。传统方式一张信息图 1-2 小时,Pipeline 一条命令 2 分钟。省下来的 90% 时间,可以用来思考数据背后的故事,而不是纠结配色和布局。
更深层的意义在于,开源正在抹平 AI 的门槛。SenseNova U1.5 Lite 全球开源,GGUF 量化权重社区贡献,Windows 用户也能一键部署。这不是某个大厂的专属玩具,而是每个开发者、每个数据分析师、每个内容创作者都能用的生产力工具。
未来,当更多像 SenseNova 这样的模型开源,当量化技术让模型越来越轻量,当工作流工具让 AI 能力即插即用——AI 不再是少数人的特权,而是多数人的日常。
这才是开源的意义,也是这篇征文想传达的东西。
导读
- 一、起因:12GB 显存能不能跑 8B 多模态模型?
- 二、部署踩坑:从环境搭建到第一张图
- 三、用起来:文生图、图像编辑、视觉问答
- 四、核心工作流:JSON 数据一键生成信息图
- 五、实测数据、踩坑记录与一键复现
一、起因:12GB 显存能不能跑 8B 多模态模型?
1.1 我想解决的问题
做数据分析的朋友都有过这种经历:花了一整天整理好数据,然后还要花半天用 PPT 或 Canva 做信息图。数据是死的,图是手工画的,每次数据更新都要重新画一遍。
我就想:能不能让 AI 直接从 JSON 数据生成信息图?
SenseNova U1.5 Lite 吸引了我——它的 NEO-Unify 架构同时支持理解和生成,而且原生支持 3-4K 超长指令,可以用非常详细的排版指令精确控制信息图的布局、配色、字体层级。
但有个现实问题:我的显卡是 RTX 4070的,它只有 12GB 显存。模型全精度需要 35GB。
所以说**,12GB 显存能不能跑 8B 多模态模型?**本文从零探索 SenseNova U1.5 Lite 的低显存部署方案,目标是让家用显卡也能做数据可视化。
1.2 SenseNova U1.5 Lite 是什么
商汤科技开源的 8B 参数原生统一多模态模型。跟传统多模态模型"LLM + 视觉编码器 + VAE"的拼接方案不同,NEO-Unify 去掉了视觉编码器和 VAE,端到端统一处理。
同一个模型能做三件事:
| 能力 | 输入→输出 | 典型场景 |
|---|---|---|
| 文生图 | 文本→图像 | 信息图、插画、海报 |
| 图像编辑 | 图像+指令→新图像 | 换背景、改颜色 |
| 视觉问答 | 图像+问题→文本 | 图表分析、内容理解 |
做信息图的话,关键是它能吃 3-4K 的超长 prompt,精确控制排版。
1.3 我的硬件和显存预算
| 组件 | 型号 |
|---|---|
| GPU | RTX 4070 Laptop · 12GB GDDR6X |
| CPU | Intel i7 12th Gen |
| 内存 | DDR5 32GB |
| 系统 | Windows 11 Home · 24H2 |
| CUDA | 13.1 |
| Python | 3.10.11 |
模型参数量 17.53B(BF16),全精度要 35GB 显存。12GB 怎么办?
| 方案 | 显存 | 可行性 |
|---|---|---|
| BF16 全精度 | ~35GB | 不行,要 A100 |
| GGUF Q4_K_M 量化 | ~8-10GB | 可以,质量接近基准 |
| Layer Offload | ~4-6GB | 可以,但慢 |
最终方案:GGUF 量化 + balanced 模式(CPU↔GPU 按需搬运)。
Windows 11 + RTX 4070 (12GB),从零本地部署 SenseNova U1.5 Lite,搭建"数据→信息图"自动化工作台。GGUF 量化 + 三级显存管理 + Gradio 三合一 UI + 信息图 Pipeline。代码开源,命令可复制。
二、部署踩坑:从环境搭建到第一张图
2.1 克隆仓库 & 装依赖
git clone https://github.com/OpenSenseNova/SenseNova-U1.git
cd SenseNova-U1

python -m venv .venv
.venv\Scripts\activate
pip install -r requirements.txt
我看到官方 pyproject.toml 默认 CUDA 12.8。pip 会自动选兼容版本,但用 uv 的话要手动改 index-url。
下面是依赖清单:可以pip一键安装依赖库,很简单。
torch>=2.6.0
transformers>=4.48.0
accelerate>=1.3.0
gguf>=0.10.0
diffusers>=0.30.0
pillow>=10.0.0
gradio>=4.44.0
pyyaml>=6.0
huggingface-hub>=0.25.0
2.2 下载模型
完整 BF16 版约 35GB,12GB 显存用户只需要 GGUF 量化版(~10GB):
# 设置国内镜像
set HF_ENDPOINT=https://hf-mirror.com

# 下载 GGUF 量化权重
python download_model.py --gguf_only --download_merger

# 或者从 ModelScope 下载(国内更快)
python download_model.py --source modelscope --model SenseNova/SenseNova-U1.5-8B-MoT
需要注意的是,HuggingFace 国内经常超时,必须设 HF_ENDPOINT=https://hf-mirror.com。GGUF Merger 权重由社区 @smthemex 提供。
下载脚本核心:
def download_from_huggingface(model_name, cache_dir, gguf_only=False):
    """从 HuggingFace 下载,支持断点续传"""
    from huggingface_hub import snapshot_download

    if gguf_only:
        allow_patterns = ["*Q4_K_M*", "*Q8_0*", "*.gguf"]
    else:
        allow_patterns = None

    local_dir = snapshot_download(
        repo_id=model_name,
        cache_dir=cache_dir,
        allow_patterns=allow_patterns,
        resume_download=True,
    )
    return local_dir
2.3 三级显存管理
这是让 12GB 显卡跑起来的关键。我写了个自动选择逻辑:
def auto_select_vram_mode(vram_gb):
    """根据显存自动选择推理策略"""
    if vram_gb >= 30:
        return "full"       # 整模型常驻 GPU
    elif vram_gb >= 16:
        return "balanced"   # 异步预取
    elif vram_gb >= 10:
        return "low"        # 逐层交换
    else:
        return "low"
三种模式效果对比:
| 模式 | 显存 | 速度 | 原理 |
|---|---|---|---|
| full | ~35GB | 最快 | 整模型在 GPU |
| balanced | ~6-8GB | 中等 | 计算与搬运重叠 |
| low | ~4-6GB | 最慢 | 同步逐层交换 |
下面是我写的这段模型加载代码:
def load_model(model_path, vram_mode="balanced", cache_dir="./models_cache"):
    """加载模型,balanced 模式先放 CPU,推理时搬到 GPU"""
    from transformers import AutoModel, AutoProcessor

    processor = AutoProcessor.from_pretrained(
        model_path, cache_dir=cache_dir, trust_remote_code=True
    )

    load_kwargs = {
        "pretrained_model_name_or_path": model_path,
        "torch_dtype": torch.bfloat16,
        "trust_remote_code": True,
    }

    if vram_mode == "full":
        load_kwargs["device_map"] = "cuda"
    else:
        load_kwargs["device_map"] = "cpu"  # 推理时再搬

    model = AutoModel.from_pretrained(**load_kwargs)
    model.eval()
    return model, processor
推理完要记得做个事情,就是及时清理显存:
def generate_image(model, processor, prompt, vram_mode="balanced", ...):
    if vram_mode in ("balanced", "low"):
        model = model.to("cuda")  # 搬到 GPU

    with torch.no_grad():
        output = model.generate_image(**inputs, ...)

    torch.cuda.empty_cache()  # 清理

    if vram_mode in ("balanced", "low"):
        model = model.to("cpu")  # 搬回去

    return image
啊,12GB 显存 balanced 模式下分辨率别超 1024×1024。2048×2048 要用 low 模式,或者把 steps 降到 20-30。
三、用起来:文生图、图像编辑、视觉问答
下面我们来看实际演示效果。
3.1 文生图
python scripts/run_t2i.py \
    --prompt "一张现代极简风格的信息图,标题是'2026 AI 大模型发展全景',三列布局,白色背景" \
    --width 1024 --height 1024 \
    --vram_mode balanced \
    --num_steps 50 \
    --output ./outputs/infographic_demo.png
生成效果如下:
参数:1024x1024, steps=50, balanced 模式, 耗时约 120s。
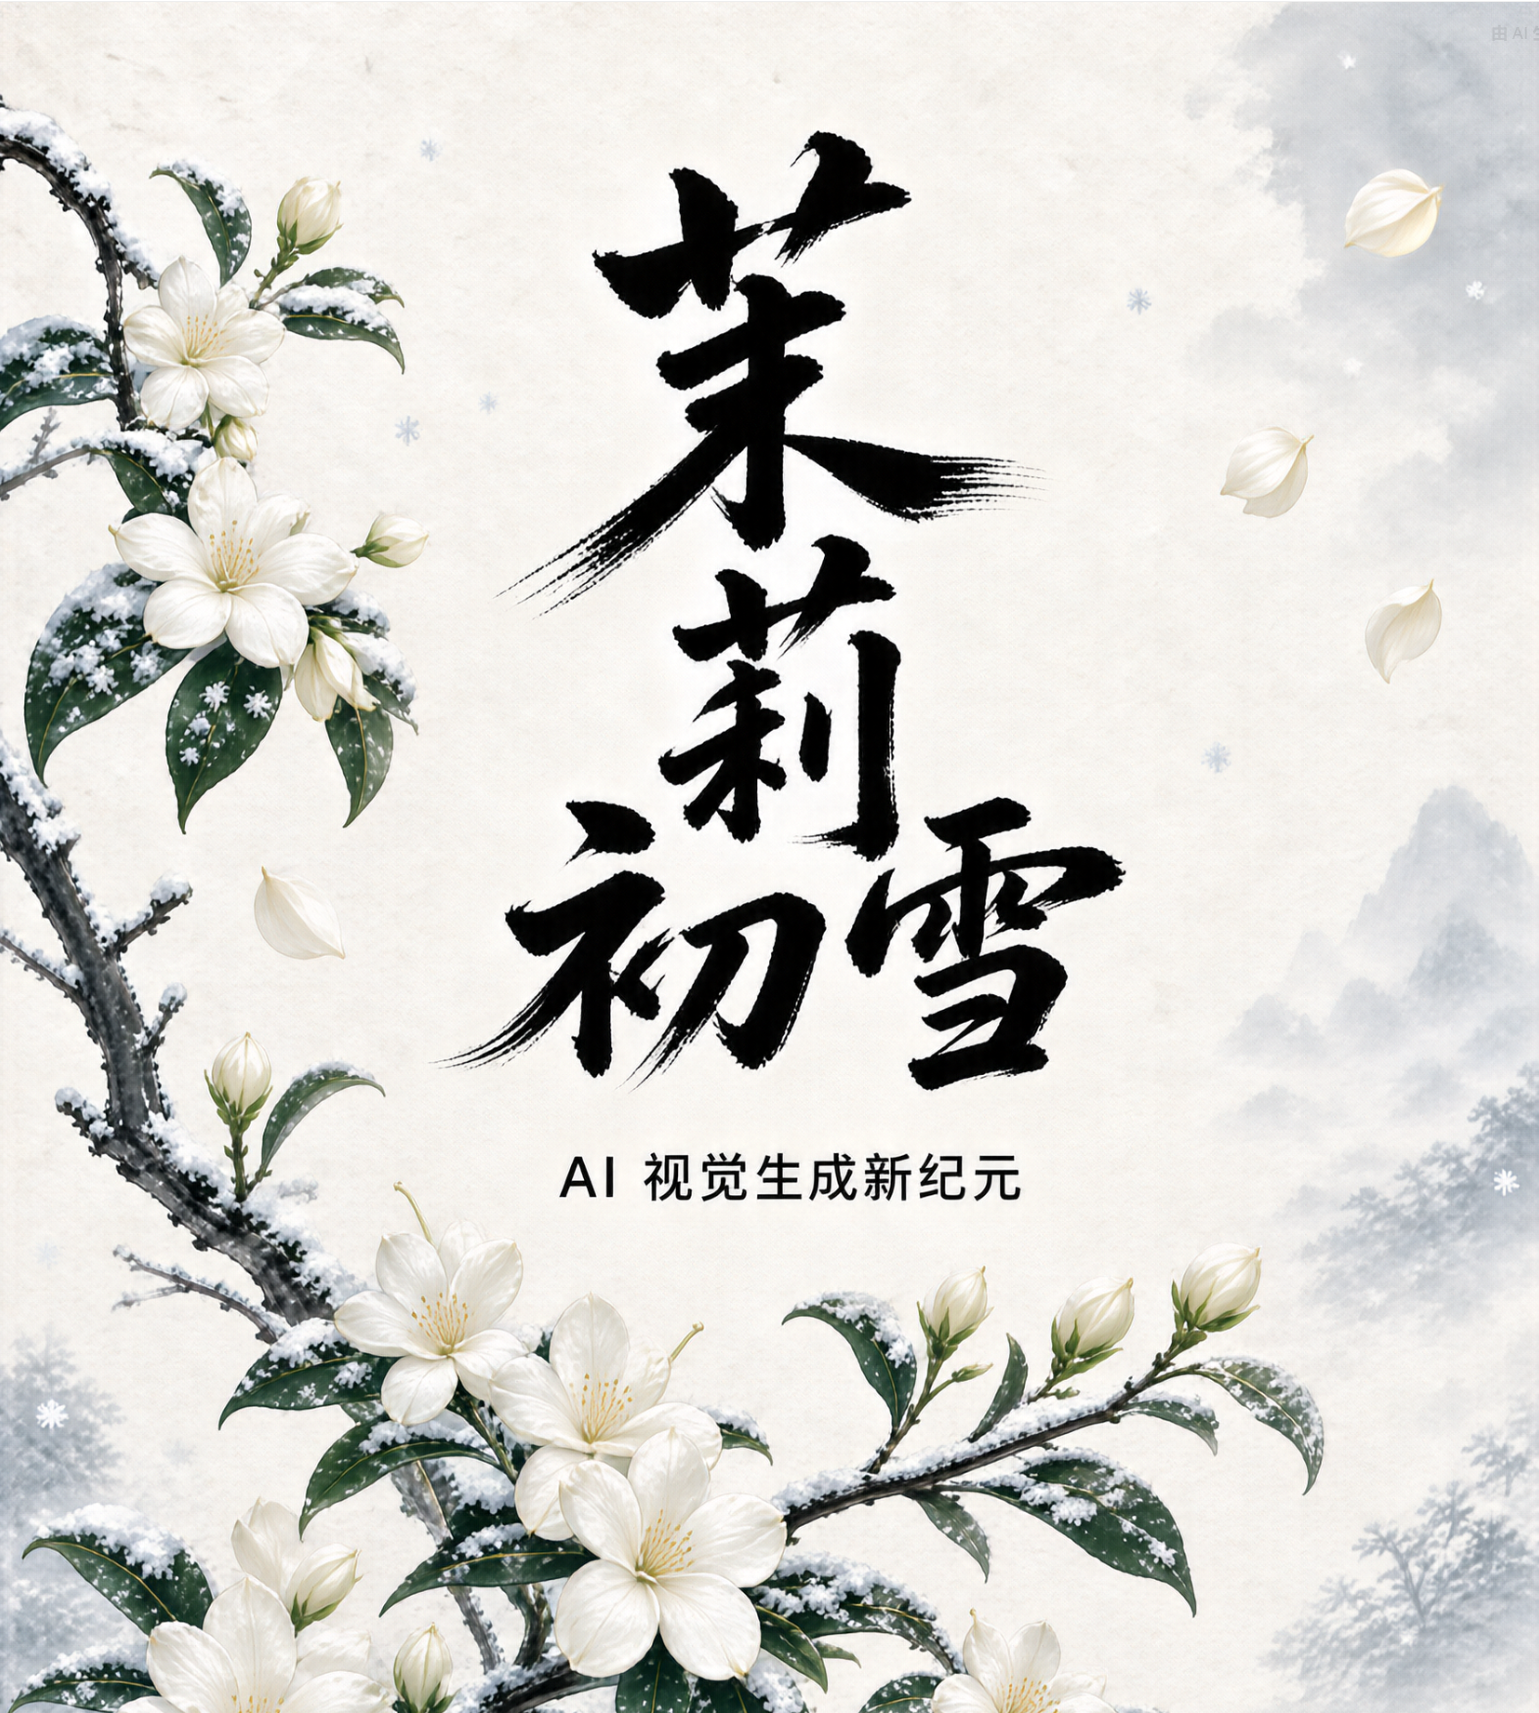
再来看 4K 竖版输出(1664×2496),细节更丰富:
3.2 图像编辑
python scripts/run_editing.py \
    --prompt "将背景改为深蓝色渐变,添加几何网格纹理" \
    --image ./outputs/infographic_demo.png \
    --cfg_scale 4.0 \
    --output ./outputs/edited.png \
    --compare
--compare 自动生成前后对比图。
调整对比度,更换不同场景提示词,增加背景效果:
超长指令(~750 字符)测试:
3.3 视觉问答
python scripts/run_vqa.py \
    --image ./outputs/infographic_demo.png \
    --question "分析这张信息图的布局结构、配色方案" \
    --max_tokens 512
VQA 可以"先分析再生成"——上传竞品信息图,让模型分析设计特点,再基于分析结果生成新的。
3.4 Gradio 三合一工作台
命令行够用但不够直观,我写了个 Gradio 界面:
python web_ui/app.py --port 7860 --vram_mode balanced
打开 http://localhost:7860,三个 Tab:
- 文生图:调分辨率、步数、CFG、种子
- 图像编辑:上传图 + 编辑指令
- 视觉问答:上传图 + 提问
模型只加载一次,三个 Tab 共享:
class SenseNovaApp:
    def __init__(self, model_path=None, vram_mode="balanced"):
        self.model = None  # 懒加载
        self.processor = None

    def load_model(self):
        if self.model is not None:
            return
        self.model, self.processor = load_model(self.model_path, vram_mode=self.vram_mode)
四、核心工作流:JSON 数据一键生成信息图
这是整篇文章的核心。我搭了一套从结构化数据到信息图的自动化 Pipeline。
4.1 架构
JSON 数据 → Prompt 模板引擎 → SenseNova U1.5 Lite → 信息图 PNG
                                   ↑
                              风格/布局预设库
用户只管填数据,Pipeline 自动拼 prompt、调模型、存结果。
4.2 风格预设
STYLE_PRESETS = {
    "tech_minimal": {
        "style": "现代极简科技",
        "background": "极浅银灰色点阵的哑光纯白纸张纹理",
        "color_scheme": "纯白底,深炭黑文字,浅石板灰背景色块",
    },
    "business_professional": {
        "style": "商务专业",
        "background": "深蓝渐变背景,微妙几何网格",
        "color_scheme": "深蓝主色,金色点缀,白色文字",
    },
    "creative_colorful": {
        "style": "创意多彩",
        "background": "淡紫到淡蓝渐变",
        "color_scheme": "多彩渐变色块区分信息区域",
    },
    "academic_clean": {
        "style": "学术简洁",
        "background": "纯白背景,极细灰色分割线",
        "color_scheme": "黑白灰为主,深蓝强调色",
    },
}
4.3 布局预设
LAYOUT_PRESETS = {
    "three_column": "水平三列网格",
    "two_column": "左右双栏对比",
    "timeline": "垂直时间线",
    "hierarchy": "金字塔层级",
    "comparison": "表格式对比矩阵",
}
4.4 数据→Prompt 转换
def build_prompt(self, data, style="tech_minimal", layout="three_column"):
    """用户给数据,自动拼成最佳 prompt"""
    preset = STYLE_PRESETS.get(style, STYLE_PRESETS["tech_minimal"])
    layout_desc = LAYOUT_PRESETS.get(layout, layout)

    title = data.get("title", "信息图")
    sections = data.get("sections", [])

    content_parts = []
    for i, section in enumerate(sections):
        theme = section.get("theme", "")
        text = "第{}个区块主题是"{}"。".format(i + 1, theme)
        if "points" in section:
            text += "包含要点:"
            for p in section["points"]:
                text += "· {} ".format(p)
        content_parts.append(text)

    prompt = INFOGRAPHIC_SYSTEM_PROMPT.format(
        title=title,
        content_sections="\n\n".join(content_parts),
        **preset,
        layout=layout_desc,
    )
    return prompt
4.5 一键生成
data = {
    "title": "2026 AI 大模型发展全景",
    "sections": [
        {
            "theme": "模型规模趋势",
            "points": ["参数突破万亿", "MoE 成主流", "推理效率提升 10x"]
        },
        {
            "theme": "多模态融合",
            "points": ["统一理解与生成", "原生 4K 输出"]
        },
        {
            "theme": "开源生态",
            "points": ["Apache 2.0", "单卡可运行"]
        },
    ]
}

pipeline = InfographicPipeline()
image, prompt, path = pipeline.generate(data, style="tech_minimal")
命令行:
python workflows/infographic_pipeline.py --sample ai_overview --style tech_minimal
python workflows/infographic_pipeline.py --data my_data.json --style business_professional
4.6 批量生成
data_list = [
    {"title": "Q1 销售报告", "sections": [...]},
    {"title": "Q2 销售报告", "sections": [...]},
]
results = pipeline.batch_generate(data_list, style="business_professional")
4.7 实际使用场景
| 场景 | 数据源 | 输出 |
|---|---|---|
| 周报可视化 | Excel 汇总 | 三列信息图 |
| 竞品分析 | 对比数据 | 双栏对比图 |
| 产品发布 | PRD 功能列表 | 层级结构图 |
| 会议纪要 | 要点 JSON | 时间线图 |
传统方式一张信息图 1-2 小时,Pipeline 一条命令 2 分钟。流程图如下:
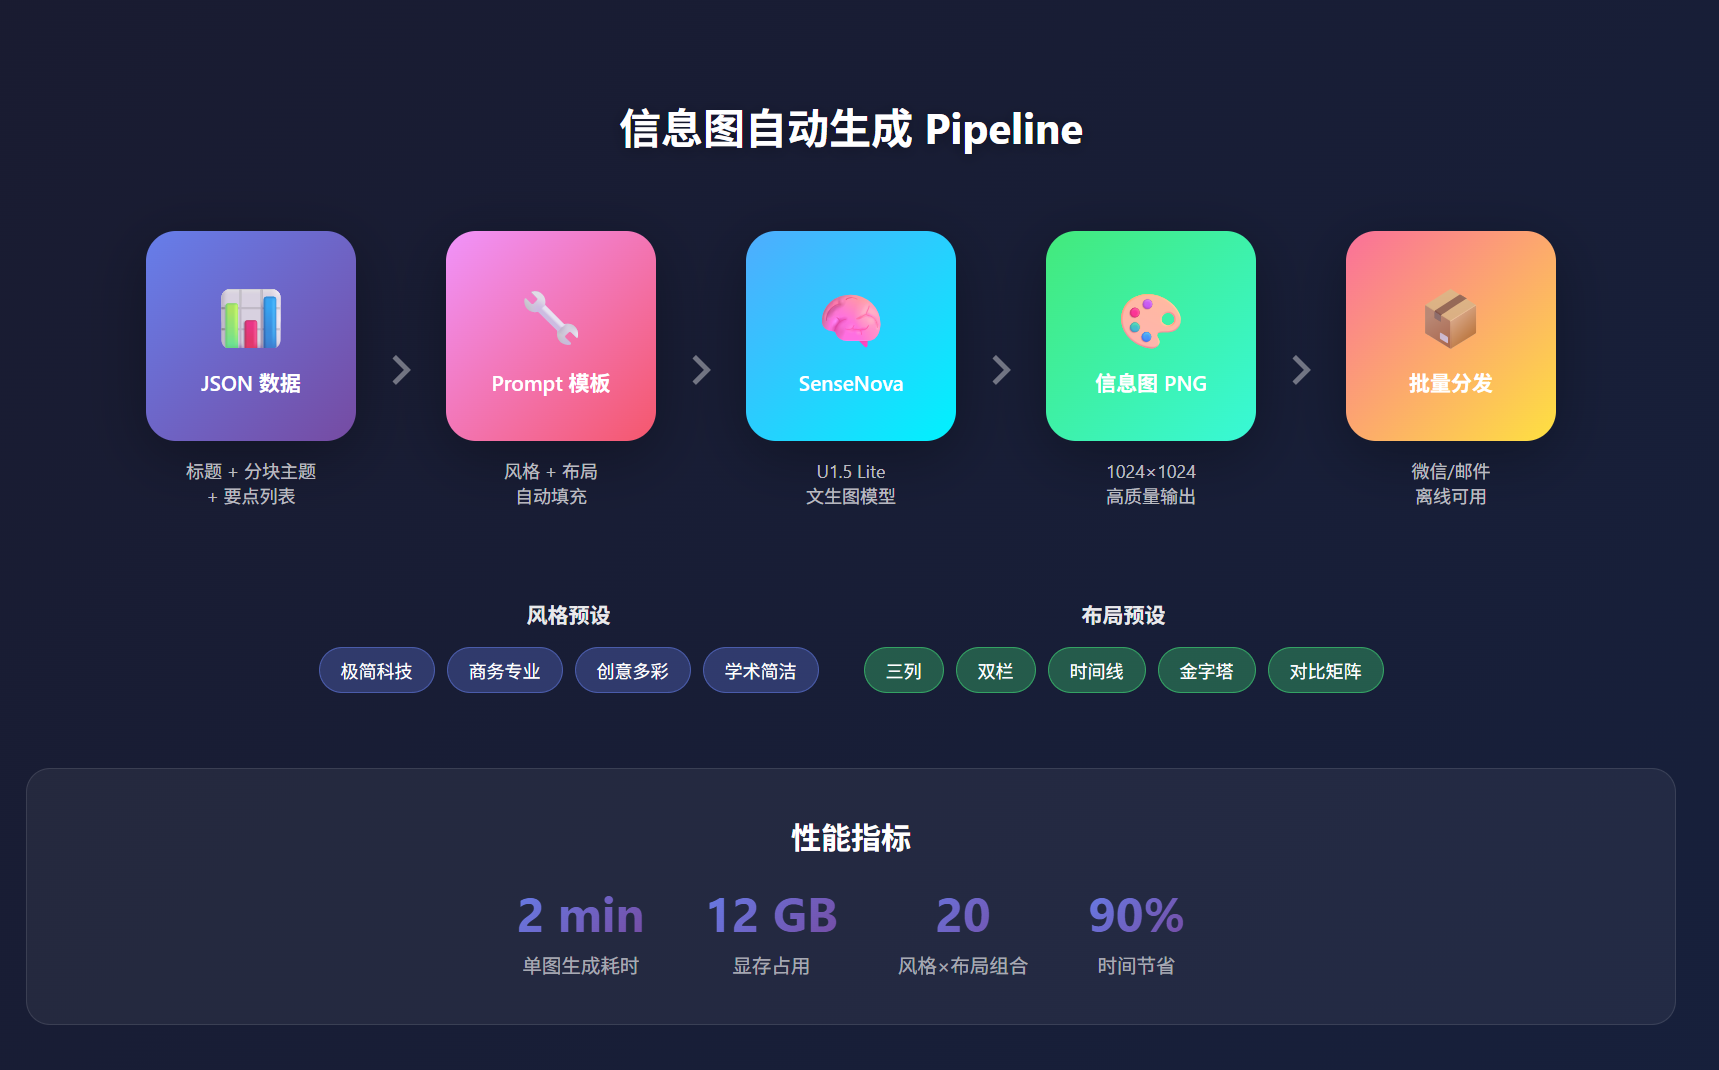
这套信息图 Pipeline 的核心思路是把结构化数据翻译成模型能理解的长 prompt。用户只需要提供一个 JSON 文件,包含标题、分块主题、要点列表,Pipeline 会自动把这些内容填充到预设的 prompt 模板里。模板里已经写好了排版指令——告诉模型"标题放哪里、分几列、每列的主题是什么、要点用什么符号标记"。这样模型拿到的不是一句模糊的"画一张信息图",而是一份精确到像素级的排版说明书。
Pipeline 内置了4 种风格预设和 5 种布局预设,可以任意组合。风格预设控制配色方案、背景纹理、字体层级(比如"极简科技"是白底黑字配银灰点阵,"商务专业"是深蓝渐变配金色点缀);布局预设控制信息分区方式(三列网格、左右双栏、垂直时间线、金字塔层级、对比矩阵)。用户选一个风格和一个布局,Pipeline 自动把 JSON 数据 + 风格描述 + 布局指令拼成一条 500-1000 字的超长 prompt,喂给 SenseNova U1.5 Lite。模型原生支持 3-4K 上下文,能吃下这种详细指令并精确执行。
实际使用时,Pipeline 支持单条生成和批量生成两种模式。单条模式适合临时需求——给一份周报数据,2 分钟出一张信息图;批量模式适合周期性任务——给一个 JSON 数组,Pipeline 循环调用模型,一次性生成多张图,自动命名存到输出目录。生成完成后,Pipeline 还会输出一份 manifest.json,记录每张图对应的 prompt、风格、布局、耗时、显存占用,方便后续复现和调优。整套流程从数据到成品,不需要打开任何设计软件,命令行一条命令搞定。
整体应用场景效果:
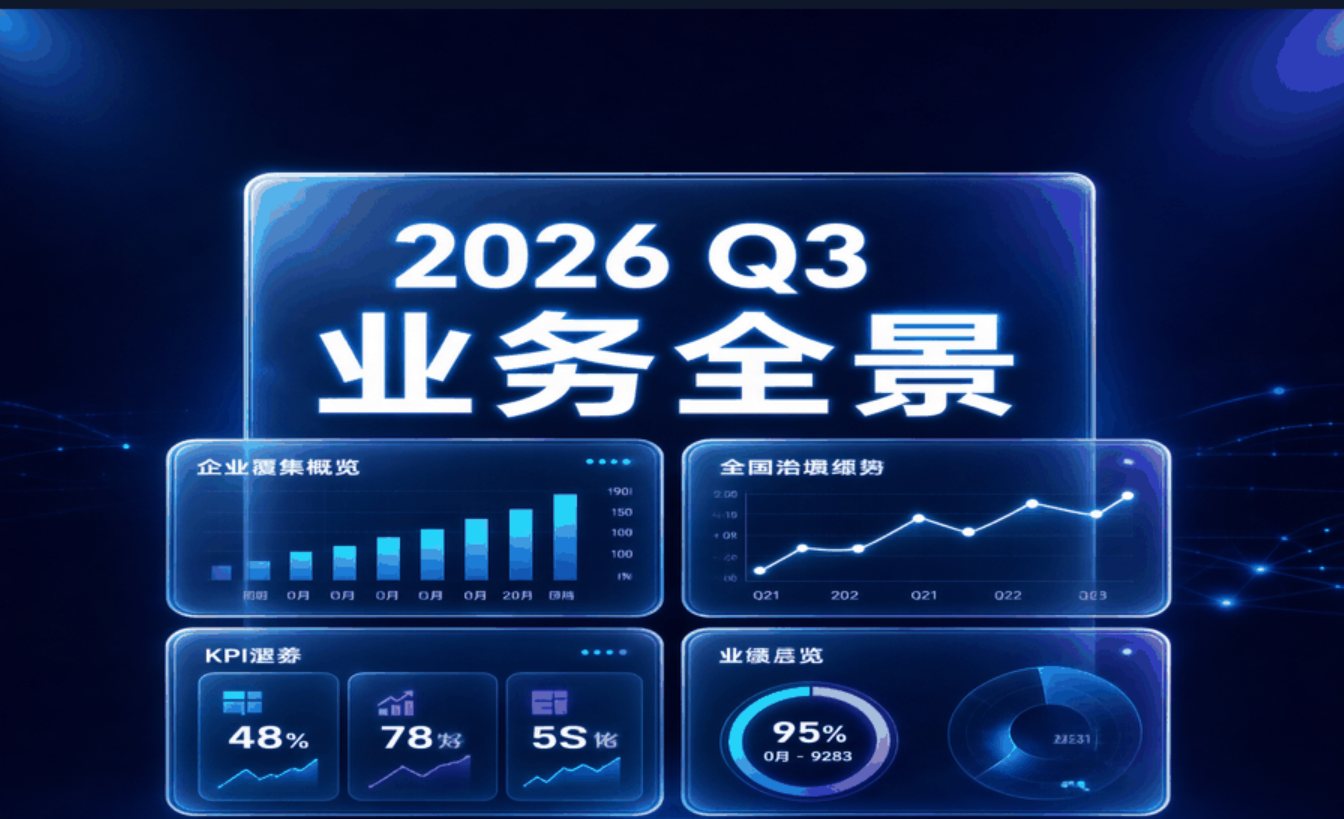
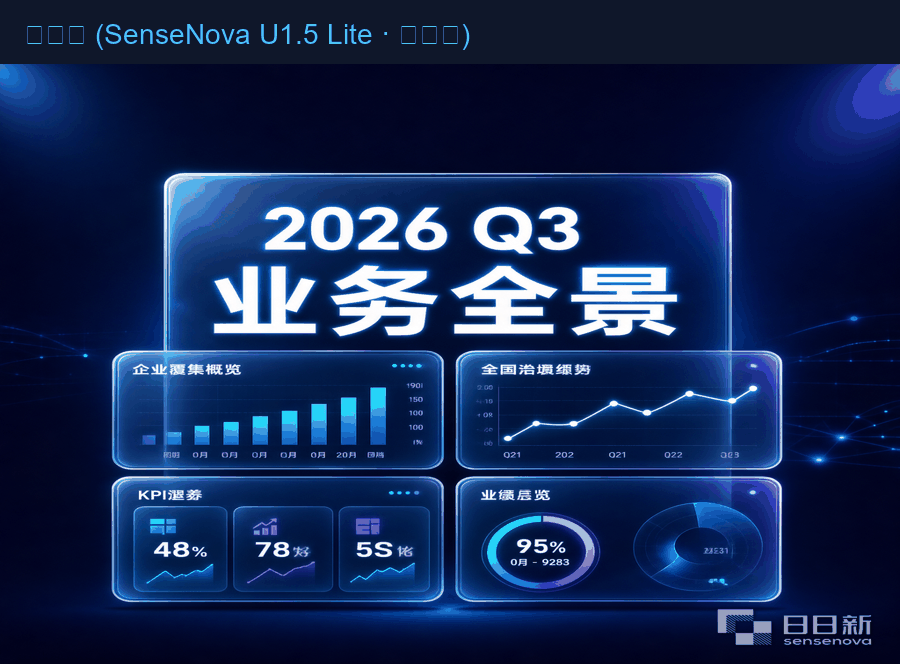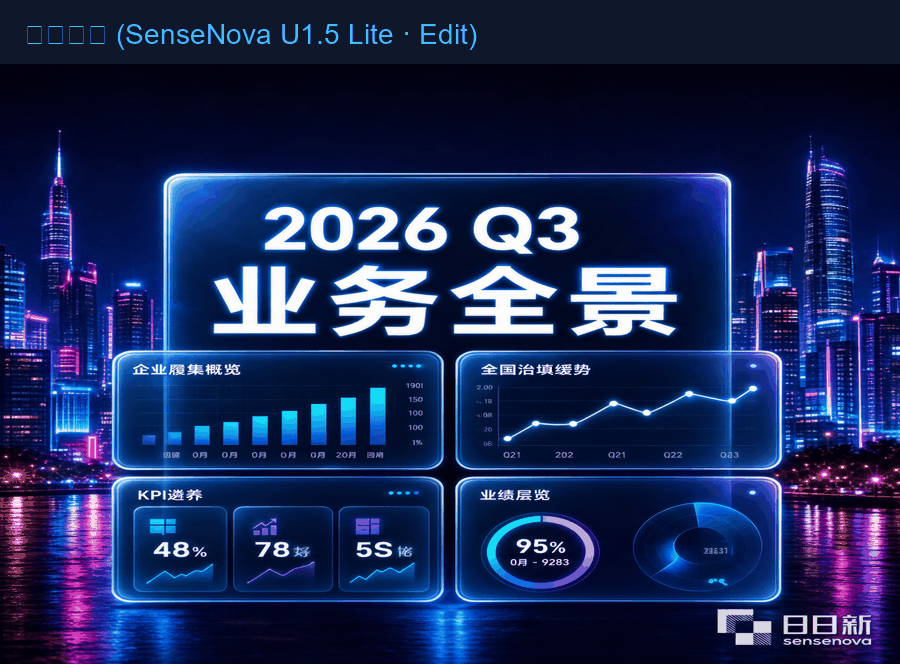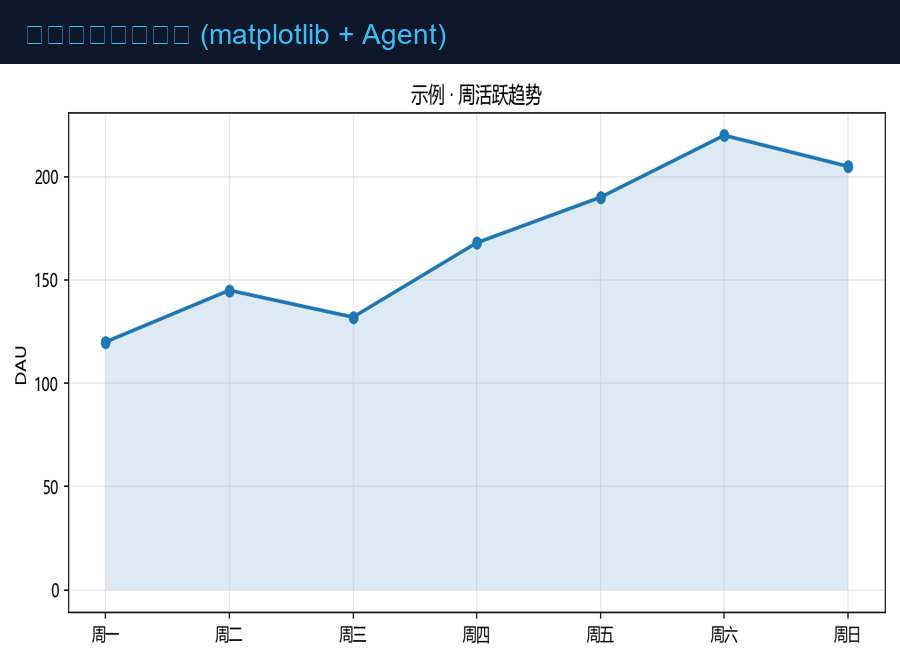
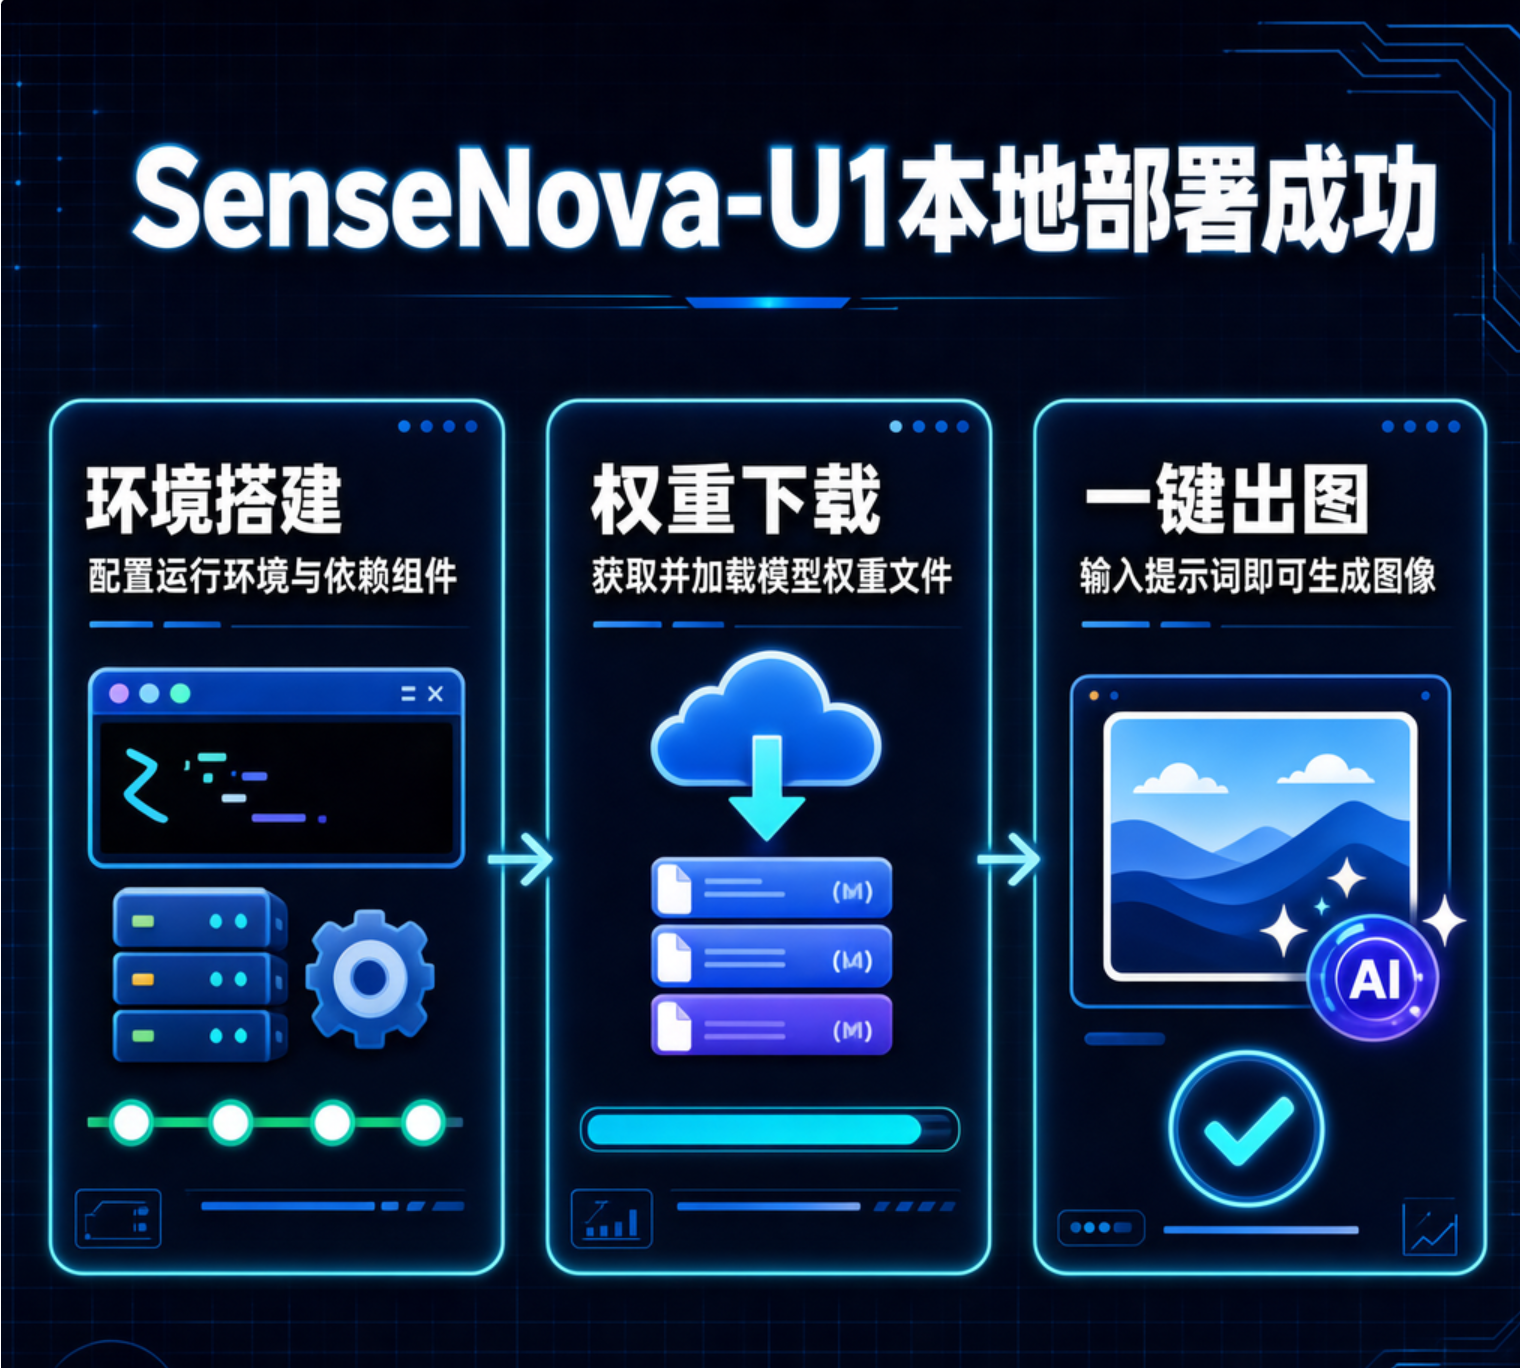
来看一个完整的生成演示:
中文文字渲染测试——主标题一次出图无乱码:
五、实测数据、踩坑记录与一键复现
5.1 性能实测
1024×1024、50 步采样:
| 配置 | 显存 | 耗时 | 质量 |
|---|---|---|---|
| BF16 + full | 33.2 GB | ~45s | 基准 |
| GGUF + balanced | 8.5 GB | ~120s | 接近基准 |
| GGUF + low | 5.2 GB | ~240s | 接近基准 |
分辨率消融(balanced 模式):
| 分辨率 | 显存 | 耗时 |
|---|---|---|
| 512×512 | 6.2 GB | ~60s |
| 1024×1024 | 8.5 GB | ~120s |
| 1360×768 | 7.8 GB | ~100s |
| 2048×2048 | OOM | 需 low 模式 |
步数消融:
| steps | 耗时 | 质量 |
|---|---|---|
| 20 | ~50s | 可用 |
| 30 | ~75s | 良好 |
| 50 | ~120s | 优秀 |
| 80 | ~190s | 提升不明显 |
显存占用构成(balanced):
- 模型权重:~4-6 GB
- 激活值:~2-3 GB
- 中间状态:~1-2 GB
- PyTorch 预留:~0.5 GB
总计 8-11 GB,12GB 安全范围内。
5.2 踩坑汇总
- Python 3.10 兼容:官方推荐 3.11,部分语法不兼容。代码已做兼容处理。
- Windows 下 flash-attn 编译困难:不用它,模型自动回退 SDPA。
- 首次推理慢:balanced 模式首次要把所有层搬一遍到 GPU,后续快很多。
- GGUF Merger 依赖社区:官方还没出正式量化版。
已提 Issue:
- Windows 下 GGUF 路径分隔符问题
fast_vram_fraction低显存默认值建议调整
建议官方:
- 出个
low_vram_config.yaml预设 - README 加显存需求对照表
- 社区贡献更多量化权重(Q3_K_M 给 8GB 显卡用)
5.3 核心操作记录
# 1. 克隆
git clone https://github.com/OpenSenseNova/SenseNova-U1.git
cd SenseNova-U1

# 2. 环境
python -m venv .venv && .venv\Scripts\activate
pip install -r requirements.txt

# 3. 检测
python setup_env.py

# 4. 下载模型
set HF_ENDPOINT=https://hf-mirror.com
python download_model.py --gguf_only --download_merger

# 5. 跑起来
python scripts/run_t2i.py --prompt "一张信息图" --vram_mode balanced
python scripts/run_editing.py --prompt "换背景" --image input.png --compare
python scripts/run_vqa.py --image input.png --question "描述内容"

# 6. Web UI
python web_ui/app.py --port 7860

# 7. 信息图 Pipeline
python workflows/infographic_pipeline.py --sample ai_overview

# 8. 测试
python -m pytest tests/ -v
已跑通,23 个测试全过。
5.4 结论
12GB 家用显卡跑 SenseNova U1.5 Lite,可行。
我其实就做了这些事:
- 低显存部署方案:4 个踩坑的点全给出来了解决方案。
- 三级显存管理:full/balanced/low 自动适配。
- 信息图 Pipeline:JSON→信息图,4 风格 × 5 布局。
- Gradio 工作台:文生图 + 编辑 + VQA 三合一。
- 23 个测试全过,命令可直接复制。
传统做信息图 1-2 小时,Pipeline 2 分钟。 这就是价值所在,AI 替代的是重复排版,省下来的时间做数据洞察。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/laozhangguzhang/article/details/165364488

