

目录
前言
在前面的文章中,我们围绕网络库的核心链路,从零完成了一个完整的多线程 Reactor 服务器框架:从负责数据缓冲的 Buffer,到管理套接字生命周期的 Socket;从事件驱动的 Channel 与 Poller,到串联一切的 EventLoop;再到连接管理的 Acceptor、Connection,以及支撑多线程并发的 LoopThreadPool,最终通过 TcpServer 将所有组件整合为一个可运行的服务器。
但我们的最终目标,是实现一个支持 HTTP 协议的高并发服务器。
HTTP(HyperText Transfer Protocol,超文本传输协议)是工作在应用层的请求-响应协议:客户端根据需求向服务器发送请求,服务器处理完毕后返回响应,一次通信即告完成。值得注意的是,HTTP 本质上运行在 TCP 之上,这意味着 HTTP 服务器就是一个 TCP 服务器,只不过在应用层需要按照 HTTP 格式组织与解析数据,以明确客户端意图并完成业务处理。
因此,实现 HTTP 服务器可以概括为四个步骤:
- 搭建 TCP 服务器,接收客户端请求;
- 按照 HTTP 协议格式解析请求数据,明确客户端目的;
- 根据请求目的提供对应服务;
- 将响应结果按 HTTP 协议格式组织并回传给客户端。
一个带有协议支持的高性能 Reactor 服务器可以划分为两大模块:
-
SERVER 模块:实现 Reactor 模型的 TCP 服务器;
-
协议模块:为 Reactor 服务器提供应用层协议支持。
此前的代码正是对 SERVER 模块的实现,已基本完成。接下来,我们将进入协议模块,为当前的 Reactor 服务器赋予 HTTP 协议处理能力。
在之前的实现中,我们的注意力集中在网络通信这一核心主题上,力求把 Reactor 模型的每一环都讲清楚。但当你真正动手去写、去测试、去完善这个网络库时,很快会意识到一个现实问题:支撑业务运转的,从来不只是那些光鲜的核心模块。
你会在日志系统里反复编写 time()、localtime()、strftime() 的样板代码;你会在解析配置或 HTTP 报文时,无数次调用 find()、substr() 来处理字符串;你会在读取静态资源文件时,面对路径拼接、文件存在性判断、二进制读取等琐碎操作;你还会在调试时,需要格式化输出十六进制内存、获取线程 ID、进行大小端转换……
这些代码不直接参与网络 IO,却像基础设施一样无处不在。如果任由它们散落在各个业务文件的角落,代码很快会充斥大量重复、臃肿、难以维护的噪音。
这正是 Util(工具类) 登场的意义。
与前面那些"主角"不同,Util 模块不会出现在架构图的中心,它更像是整个项目的基础设施(Infrastructure)。它不解决"如何收发数据"的问题,而是解决"如何优雅地处理字符串"、“如何安全地操作文件”、"如何高效地进行编解码"等问题。它的设计哲学也与众不同:Util 不是凭空设计出来的,而是从代码复用中提炼出来的——当你发现同样的逻辑写了第三遍时,它就是下一个 Util 接口。
在本节中,我们将为网络库补齐这块基础设施,从实际痛点出发,逐步设计和实现几个最常用、最不可或缺的工具接口:字符串分割、文件读写、URL 编解码、HTTP 状态码与 MIME 查询、文件属性判断,以及资源路径安全校验。它们将成为支撑上层业务最坚实的底座。
下面是实现 HTTP 服务器的整体流程:
一、Util 的设计理念
在实际工程中,很少有接口是凭空想出来的。标准库也好,第三方库也罢,其函数设计往往经历了多轮需求迭代:痛点先行,提取在后。
当你把一段代码反复写了多次,就应该注意到它的高度复用性。此时,将其封装为一个独立的函数接口,不仅能消除重复,还能通过命名自解释其功能,让代码从“指令堆砌”变成“积木拼装”。
对于那些功能常规、泛用性强、不依附于特定业务对象的辅助接口——就像工具箱里的扳手与螺丝刀——我们可以把它们集中收纳在一个类中,这便是 Util(工具类)。顾名思义,其内部没有业务状态,只有各种静态方法,充当项目的通用工具箱。
二、Util 类的简单设计
在正式动手实现之前,有必要先对 Util 模块的定位与设计边界做一个清晰的交代。毕竟,工具类往往是新手最容易“用力过猛”的地方——要么一上来就设计得过于庞大,恨不得把所有能想到的辅助功能全塞进去;要么过于简陋,导致后续业务代码里到处充斥着重复的逻辑。我们需要在这两者之间找到一个务实的平衡点。
2.1 YAGNI 原则下的 Util 设计
首先要明确的是,本节实现的 Util 类并不追求大而全。我们不会去封装一个能媲美 Boost 或 Abseil 的通用工具库,也不会按照严格的正交性原则把字符串、文件、网络、时间等维度拆分成独立的命名空间模块。原因很简单:我们的目标是为当前这个高并发网络服务器项目提供“刚好够用”的基础设施,而不是编写一个可复用的标准库扩展。
在软件工程中有一条著名的 YAGNI 原则(You Aren’t Gonna Need It)——不要为你当前不需要的功能提前买单。对于一个基础的高并发服务器来说,我们真正频繁遇到的痛点其实非常集中:读取静态资源文件、解析 HTTP 请求路径、处理 URL 编码、判断文件类型等。这些需求加起来,一只手就能数得过来。如果我们为了“架构优雅”而强行拆分成 StringUtil、FileUtil、HttpUtil、TimeUtil 等多个子模块,虽然理论上更规范,但对于当前这个体量的项目而言,反而会增加不必要的头文件管理和认知负担。因此,我们采用一种集中式的、扁平化的组织方式:一个 Util 类,若干静态方法,仅此而已。
当然,这种“大杂烩”式的做法在大型生产项目中并不推荐。它更像是一个教学项目与原型系统中的务实选择——先用最短的代码路径解决问题,等到业务复杂度真正膨胀、工具函数突破二十个、横跨多个领域时,再按照正交性原则进行拆分才是更合理的重构时机。现在,我们优先保证的是可用性与简洁性。
2.2、使用 class + static
现代 C++ 更推崇命名空间 + 自由函数的方式来组织工具(例如 StringUtil::Split(...) 作为一个自由函数存在,而非封装在类中)。那为什么不直接采用这种更现代的做法呢?
这里存在一个教学与工程实践的权衡。对于熟悉面向对象编程的开发者来说,class Util 配合 static 方法的形式在视觉上更为直观:所有的工具能力都挂载在一个明确的类型之下,通过 Util::xxx() 调用时,IDE 的自动补全和代码提示也更加友好。更重要的是,这种写法与项目里其他核心类(如 Buffer、Socket、Connection)的风格保持了一致,降低了阅读和理解的心智负担。
但我们必须为此设置一条不可逾越的红线:
使用
class + static方式设计 Util 时,该类绝对不允许拥有任何成员变量,所有接口必须是静态方法。
一旦 Util 类里出现了非静态成员变量,它就不再是一个工具集合,而变成了一个隐式的状态容器。这意味着你每次调用 Util::xxx() 时,背后可能隐藏着对某个共享状态的读写,从而引入线程安全问题、单测困难、以及跨模块的隐式耦合。静态方法保证了每个函数都是自包含的——输入参数确定,输出结果就确定,不依赖任何外部上下文。这是 Util 类能够被称为“工具”而非“服务”的底线。
换句话说,我们的 Util 类本质上只是一个**“函数的命名容器”**。它借用了类的语法外壳来组织代码,但内核必须保持纯粹的功能性。如果你发现某个工具函数需要维护配置状态、缓存结果、或者依赖业务对象的上下文,那它就不该属于 Util,而应该被提升为一个独立的业务组件。
2.3、Util 需要实现的几个功能
基于上述定位,我们提炼出当前服务器最迫切需要的10个工具接口。这 10 个功能覆盖了文件 IO、字符串处理、HTTP 协议辅助、文件系统元信息查询四个维度,已经足以支撑一个基础 Web 服务器的完整运转:
- 字符串分割(
Split)
将需要被分割的字符串按照传入的某个标记字符进行分割,将分割后得到的各个子串放到 arry 中,最终返回子串的数量 - 读取文件内容(
ReadFile)
服务器需要提供静态资源服务(如 HTML、CSS、图片)。该接口负责将磁盘文件一次性读入内存缓冲区,避免在业务代码里重复编写ifstream的打开、定位、读取、关闭等样板代码。 - 向文件写入数据(
WriteFile)
用于日志落盘、临时缓存或上传文件的持久化。提供原子化的写入能力,屏蔽文件打开模式和错误处理的细节。 - URL 编码(
UrlEncode)
HTTP 请求中,URL 路径和查询参数可能包含空格、中文、特殊符号等。RFC3986 规定这些字符必须编码为%HH格式。该接口确保服务器生成的重定向链接、表单回显等数据在协议层面合法。 - URL 解码(
UrlDecode)
与编码对应,用于解析客户端提交的请求 URI。例如将%20还原为空格,将%2F还原为/,是路由匹配和参数提取的前置步骤。 - 响应状态码描述信息获取(
StatusDesc)
构造 HTTP 响应报文时,状态行需要包含状态码对应的文本描述(如200 OK、404 Not Found)。通过查表方式快速获取标准描述,避免在业务层硬编码字符串。 - 根据文件后缀名获取 MIME 类型(
ExtMime)
HTTP 响应头中的Content-Type字段决定了浏览器如何渲染返回体。通过文件扩展名(.html、.css、.png)映射到对应的 MIME 类型,是静态资源服务的关键一环。 - 判断文件是否为目录(
IsDirectory)
在提供目录浏览服务或进行路径安全校验时,需要区分目标路径是文件夹还是普通文件。基于stat系统调用封装,屏蔽平台差异。 - 判断文件是否为普通文件(
IsRegular)
防止服务器误将设备文件、管道、符号链接等非常规文件作为资源返回给客户端,避免安全风险和不可预期的读取行为。 - HTTP 请求资源路径有效性判断(
ValidPath)
安全防御的核心接口。通过解析路径中的..和.,计算目录层级深度,确保客户端无法通过构造特殊 URI(如/../../etc/passwd)逃出服务器的资源根目录,实现最基本的沙箱隔离。
这 10 个接口看似零散,实则构成了一个最小可用的工具闭环:文件读写解决数据从哪里来、到哪里去的问题;URL 编解码解决 HTTP 协议层面的字符安全;状态码与 MIME 解决响应报文的语义正确性;文件属性与路径校验则解决资源访问的安全边界。对于实现一个基础的高并发服务器而言,这套组合已经完全够用。后续如果业务扩展(例如需要 JSON 解析、正则匹配、时间格式化等),再按需追加即可,无需在一开始就过度设计。
最后需要强调 Util 的边界感。以下类型的代码,即便看起来像是"辅助功能",也绝对不该出现在 Util 类中:
-
依赖业务上下文的函数:例如
GetCurrentConnectionCount()或ParseHttpRequest(),它们依赖Connection或HttpRequest对象,属于业务逻辑而非工具。 -
需要初始化和生命周期的模块:例如数据库连接池、线程池、配置管理器,这些带有状态和资源管理职责的组件,应该作为独立的服务类存在。
-
与特定领域强耦合的算法:例如自定义的业务协议解析、加密解密流程,应该放在对应的协议模块中。
Util 应该是一个可以被直接复制到另一个无关项目中依然能编译通过的代码集合。守住这条边界,它才能长期保持干净和可用。
接下来,我们将逐一实现上述几个接口,并在实现过程中展示如何规避常见的陷阱(如路径遍历攻击、空字符串死循环、二进制读取的换行符转换等)。
这 10 个接口的职责划分如下图所示:
三、Util 类的实现
此前实现的 Buffer、Socket 等类都包含在 server.hpp 中。为了防止重复包含,记得使用 #ifndef 管理。
我们在 server.hpp 同路径下创建一个新目录 http/,并在其中新建头文件 http.hpp,用于存放 HTTP 协议相关的代码。
3.1 分割字符串 Split
该接口接收三个参数:待分割的原字符串 src、分隔符 sep、以及存放结果的 arry 数组。其中 arry 是输出型参数,使用指针传递。
实现逻辑很清晰:从起始位置开始不断查找分隔符,找到后将片段截取出来,调整偏移量后继续查找,直到遍历完毕。
需要注意的是各种边界情况:传入空分隔符、以分隔符开头或结尾、连续出现多个分隔符等。建议实现后自行构造用例测试,确保没有遗漏。
// 字符串分割函数
    static size_t Split(const std::string& src, const std::string sep, std::vector<std::string> *arry)
    {
        if (sep.empty() || arry == nullptr) // 如果传入的sep是一个"",或者传进来的指针是个空指针,就直接返回0,表示啥也没干就走了
        {
            return 0;
        }

        size_t offset = 0; // 这是我们的查找的起始位置

        while (offset < src.size()) // 不管怎么说下标都不可能大于等于数量
        {
            // 从offset开始向后查找,到第一个sep处停下,find返回的是sep的下标
            size_t pos = src.find(sep, offset);
            if (pos == std::string::npos) // 没找到,把从起始位置开始的剩下字符全部充当子串
            {
                arry->push_back(src.substr(offset));
                return arry->size();
            }
            if (offset == pos) // 这说明是,,,这种情况,,为sep,所以第一次找到之后,offset会跑到下标1去,此时从1开始查找到的第一个sep的下标就是本身1
            {
                offset += sep.size();
                continue;
            }
            // 除此之外都是正常情况

            arry->push_back(src.substr(offset, pos - offset));
            offset = pos + sep.size();
        }
        return arry->size();
    }
3.2 读取文件 ReadFile
文件读写是非常常见的操作。如果不是经常使用,可能会对某些接口感到陌生,建议直接查阅相关文档。
读取文件需要外界传入完整路径,结果存入 string 输出参数。读取流使用 ifstream,并以 binary 模式打开,确保原样读取文件内容,不做任何换行符转换。
ifstream 是 C++ 标准库中用于文件输入(读取文件)的类,全称是 Input File Stream(输入文件流)。它继承自 istream,第一个参数是文件路径,第二个是打开模式:
| 参数 | 含义 |
|---|---|
std::ios::in | 打开文件用于读取(ifstream 默认,可以省略) |
std::ios::binary | 以二进制方式打开 |
std::ios::ate | 打开后立即定位到文件末尾 |
| 组合使用 | 用 | 连接,如 std::ios::in | std::ios::binary |
由于事先不知道文件大小,我们先通过 seekg 将读写位置跳转到文件末尾,再用 tellg 获取偏移量,从而得到文件大小。随后将位置重置到开头,调用 read 一次性读取全部内容。 |
 // 读取文件的所有内容,将读取的内容放到一个Buffer中
    static bool ReadFile(const std::string &filename, std::string *buf)
    {
        std::ifstream ifs(filename, std::ios::binary); // 找到文件后以二进制方式打开
        if (ifs.is_open() == false)
        {
            printf("OPEN %s FILE FAILED!!", filename.c_str());
            return false;
        }

        size_t fsize = 0;      // 存储文件的大小
        ifs.seekg(0, ifs.end); // 跳转到文件末尾
        fsize = ifs.tellg();   // 获取当前读写位置相对于起始位置的偏移量,从末尾偏移刚好就是文件大小

        ifs.seekg(0, ifs.beg); // 再跳转到开头
        buf->resize(fsize);    // 调整空间大小,预留出足够空间
        ifs.read(buf->data(), fsize);//这里要使用c++17及以上编译才行,如果是c++11还是建议ifs.read(&(*buf)[0], fsize);
        if (ifs.fail())
        {
            printf("READ %s FILE FAILED!!", filename.c_str());
            ifs.close();
            return false;
        }
        ifs.close();
        return true;
    }
这里 ifs 提供的各类接口(seekg、tellg、read 等),多使用几次就能熟练掌握。读取时调用 buf->data() 而非 c_str(),因为 data() 返回的指针可用于写入(C++11 起 std::string 保证连续存储)。
关于获取 buf 的首地址,根据不同的 C++ 编译版本可以选择不同的写法。
文件读取失败的常见原因与排查建议
在实际运行中,ReadFile 返回 false 的情况并不少见。下面列出最常见的几类原因,并给出对应的排查思路与错误处理策略:
| 常见原因 | 现象 | 排查建议 | 错误处理策略 |
|---|---|---|---|
| 路径不存在 | is_open() 返回 false,日志打印 OPEN ... FILE FAILED | 检查传入的 filename 是否为绝对路径,确认文件确实存在于该路径下;可用 ls -l 或 stat 命令验证 | 返回 false 并记录日志;在 HTTP 层映射为 404 Not Found |
| 权限不足 | 文件存在但 is_open() 失败,或 read() 后 fail() 置位 | 用 ls -l 查看文件权限,确认运行服务器的用户对文件拥有读权限;检查父目录是否具备 x(执行)权限 | 返回 false 并记录日志;在 HTTP 层映射为 403 Forbidden |
| 文件被占用 | 文件被其他进程以独占方式打开(如 Windows 下),或读取过程中被截断 | 用 lsof(Linux)或资源监视器(Windows)查看占用进程;确认没有其他线程在并发写入同一文件 | 返回 false 并记录日志;可考虑重试一次,仍失败则返回 503 Service Unavailable |
| 路径是目录 | is_open() 可能成功,但 read() 失败或读取到异常内容 | 读取前先用 IsDirectory 判断目标是否为目录,若是则直接拒绝 | 返回 false 并记录日志;在 HTTP 层映射为 403 Forbidden |
| 文件过大 | buf->resize(fsize) 抛出异常或内存不足 | 检查文件大小是否超出可用内存;对大文件可考虑分块读取或改用流式传输 | 捕获异常并返回 false;在 HTTP 层映射为 500 Internal Server Error |
错误处理的核心原则:ReadFile 作为工具函数,只负责“尽力读取并返回成败”,不应当在内部决定返回给客户端的 HTTP 状态码。正确的做法是——工具函数返回 false 并打印日志,由上层业务根据失败场景(路径不存在、权限不足、文件被占用等)自行决定映射为 404、403 还是 500。这样既保持了 Util 类的纯粹性,也让错误处理策略与具体业务解耦。
3.3 写入文件 WriteFile
写入文件操作与从文件中读取是差不多的原理,唯一的区别就是我们使用的是 ofstream,并且,我们要求写入的时候并不是追写,而是覆盖的方式:
// 向文件写入数据
    static bool WriteFile(const std::string &filename, const std::string &buf)
    {
        std::ofstream ofs(filename, std::ios::binary | std::ios::trunc); // 表示二进制写入并覆盖
        if (ofs.is_open() == false)                                      // 如果打开文件流失败
        {
            printf("OPEN %s FILE FAILED!!", filename.c_str());
            return false;
        }
        ofs.write(buf.c_str(), buf.size()); // 写入的时候是const char*无所谓
        if (ofs.good() == false)
        {
            ERR_LOG("WRITE %s FILE FAILED!", filename.c_str());
            ofs.close();
            return false;
        }
        ofs.close();
        return true;
    }
3.4 URL编码
URL(Uniform Resource Locator)在设计上只允许使用有限的字符集。根据 RFC3986 标准,URL 中不经过编码就能直接出现的字符只有:
- 英文字母:
A-Z a-z - 数字:
0-9 - 极少数特殊符号:
-_.~
问题来了:如果 URL 里出现了"不允许"的字符怎么办?
比如你想通过 GET 请求搜索 "C++ 教程":
GET /search?q=C++ 教程 HTTP/1.0
这行请求在协议层面是非法且危险的,因为 URL 中包含了:
- 空格 —— URL 中不允许出现空格;
+号 —— 在 query string 中有特殊含义(通常代表空格);- 中文字符 —— 超出 ASCII 范围,不同编码环境下解析结果不一致。
如果不处理,服务器、浏览器、代理网关对这条 URL 的解析会产生歧义,甚至直接报错。此时就需要进行 URL 编码:处理非 ASCII 字符,消除歧义,区分"数据"与"定界符"。
编码规则如下:
- 将特殊字符的 ASCII 值转换为两个十六进制字符,前缀
%,例如C++→C%2B%2B; - RFC3986 规定
.-_~以及字母、数字属于绝对不编码字符; - W3C 标准规定,查询字符串中的空格可以编码为
+(解码时反向处理)。
函数参数为一个 string,外加一个 bool 控制是否启用 W3C 的空格转 + 规则:
// URL编码,避免URL中资源路径与查询字符串中的特殊字符与HTTP请求中特殊字符产生歧义
    // 编码格式:将特殊字符的ascii值,转换为两个16进制字符,前缀%   C++ -> C%2B%2B
    //   不编码的特殊字符: RFC3986文档规定 . - _ ~ 字母,数字属于绝对不编码字符
    // RFC3986文档规定,编码格式 %HH
    // W3C标准中规定,查询字符串中的空格,需要编码为+, 解码则是+转空格
    static std::string UrlEncode(const std::string &url, bool convert_plus_to_space)
    {
        std::string res; // 返回字符串
        for (auto &c : url)
        {
            //当 URL 包含中文时,c 的值可能是 -28(即 0xE4),传给 isalnum 属于未定义行为(C 标准库要求传入 unsigned char 值或 EOF)。
            unsigned char uc = static_cast<unsigned char>(c);
            if (c == '.' || c == '-' || c == '_' || c == '~' || isalnum(uc))
            {
                res += c;
                continue;
            }
            if (c == ' ' && convert_plus_to_space)
            {
                res += '+';
                continue;
            }
            // 剩下的字符都是需要编码成为 %HH 格式
            char tmp[4] = {0};
            // snprintf 与 printf比较类似,都是格式化字符串,只不过一个是打印,一个是放到一块空间中
            snprintf(tmp, 4, "%%%02X", uc); //%%转义为%,%02X表示以16进制形式,保留2位,如果有空位以0填充
            res += tmp;
        }
        return res;
    }
3.5 URL解码
解码是编码的逆过程,发生在服务器接收请求后、处理业务前。
它主要用来还原用户的原始输入。
当服务器收到:
GET /search?q=C%2B%2B+%E6%95%99%E7%A8%8B HTTP/1.0
我们就必须先解码,才能知道用户真正想搜的是 "C++ 教程",而不是一串百分号。
解码完成之后,获得的 URL 就可以用来进行路由匹配与路径校验。
一个 ValidPath 工具函数判断路径是否合法,必须在解码之后才能判断。因为攻击者可能用编码绕过检查:
原始攻击路径:/../../etc/passwd
编码后:/%2e%2e/%2e%2e/%2e%2e/etc/passwd
如果先校验再解码,编码后的路径看起来可能“合法”,解码后却逃出根目录。所以安全校验必须在解码之后进行。
我们解码的逻辑也很简单,基本上只要遇见了 % 符号,就代表我们需要去解码了,当然,要判断 % 后两个字符是否存在。
// URL 解码过程中的辅助函数,作用是把单个十六进制字符转换成对应的整数值。
    static char HEXTOI(char c) // 即把a,A转化为10这些
    {
        if (c >= '0' && c <= '9')
        {
            return c - '0';
        }
        else if (c >= 'a' && c <= 'f')
        {
            return c - 'a' + 10;
        }
        else if (c >= 'A' && c <= 'F')
        {
            return c - 'A' + 10;
        }
        return -1;
    }
    // URL解码
    static std::string UrlDecode(const std::string &url, bool convert_space_to_plus)
    {
        // 遇到了%,则将紧随其后的2个字符,转换为数字,第一个数字左移4位,然后加上第二个数字  + -> 2b  %2b->2 << 4 + 11
        std::string res;

        for (int i = 0; i < url.size(); ++i)
        {
            if (url[i] == '+' && convert_space_to_plus)
            {
                res += ' ';
                continue;
            }
            if (url[i] == '%' && (i + 2) < url.size())
            {
                char v1 = HEXTOI(url[i + 1]);
                char v2 = HEXTOI(url[i + 2]);
                char v = (v1 << 4) + v2; // 等价于v1*16+v2
                res += v;
                i += 2;
                continue;
            }
            res += url[i];
        }
        return res;
    }
这里编写了辅助函数 HEXTOI,用于将单个十六进制字符转换为对应的整数值。由于这一逻辑在解码过程中被反复使用,提取为独立函数可以避免代码臃肿,也让意图更加清晰。
URL 解码与安全校验的完整流程如下:
3.6 响应状态码与文件 MIME 的信息获取
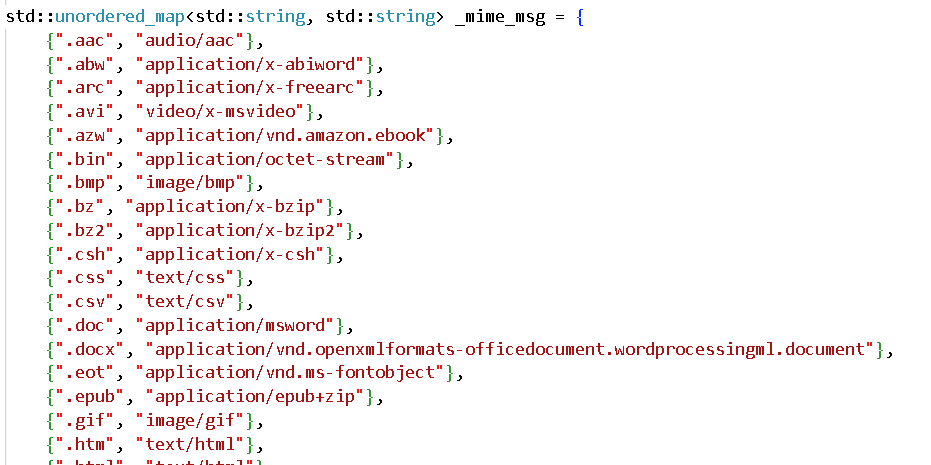
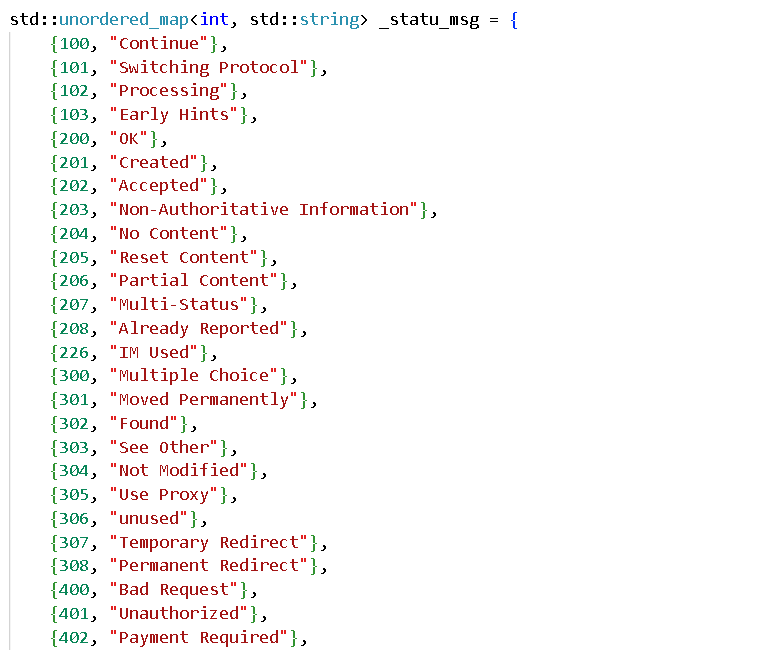
响应状态码的描述信息获取与文件的 MIME 获取是两个函数,但是具体实现都差不多,所以这里就一起说了。对于文件的 MIME,我们的想法就是从后向前,通过 . 来截取子串,随后将这个后缀进行一个查找操作。而对于相应状态码的描述信息,就直接通过状态码来查找就行了。
但是从哪里查找呢,这里可以是一个哈希表,关于一个文件后缀名对应的 MIME 信息,以及一个状态码的描述信息,都是可以在官方文档中查到的。
我们可以创建两个哈希表,初始化的时候放入这些信息。
// 响应状态码的描述信息获取
    static std::string StatuDesc(int statu)
    {
        auto it = _statu_msg.find(statu);
        if (it != _statu_msg.end()) // 找到了
        {
            return it->second;
        }
        return "Unknown";
    }
    // 根据文件后缀名获取文件 MIME
    static std::string ExtMime(const std::string &filename)
    {
        size_t pos = filename.find_last_of('.');

        if (pos == std::string::npos)
        {
            return "application/octet-stream";
        }

        std::string ext = filename.substr(pos);
        auto it = _mime_msg.find(ext);
        if (it == _mime_msg.end())
        {
            return "application/octet-stream";
        }
        return it->second;
    }
在类的外面定义两个哈希表,并将这些信息传进去(未截全):
3.7 判断一个文件的属性
在 HTTP 协议的使用中,我们经常会检查一个文件的属性,比如检查一个文件是文件夹,还是一个普通文件,这里就一起说了。
主要的方法就是通过 stat 函数获取该文件的属性,随后通过 stat 结构体来判断。
struct stat 是 Linux / Unix 中用来描述一个文件或目录属性信息的结构体。
它通常和 stat()、fstat()、lstat() 这些系统调用一起使用。
struct stat 就是一张“文件信息表”,里面保存了文件的大小、权限、类型、时间、inode 等信息。
// 判断一个文件是否是一个目录
    static bool IsDirectory(const std::string &filename)
    {
        struct stat st;
        int ret = stat(filename.c_str(), &st); // 把属性存到st中
        if (ret < 0)
        {
            return false;
        }
        return S_ISDIR(st.st_mode); // 是否是文件夹
    }
    // 判断一个文件是否是一个普通文件
    static bool IsRegular(const std::string &filename)
    {
        struct stat st;
        int ret = stat(filename.c_str(), &st);
        if (ret < 0)
        {
            return false;
        }
        return S_ISREG(st.st_mode); // 是否是普通文件
    }
3.8 HTTP 请求的资源路径有效性判断
路径合法性校验是安全防御的关键。我们将问题转化为目录层级是否越过根目录。
HTTP 请求的资源路径可能包含 . 和 ..,其中真正危险的是 ..,因为它代表“返回上一级目录”。因此,判断路径是否安全,本质上就是判断:不断执行 .. 之后,是否走出了服务器规定的资源根目录。
我们不需要操作真实文件系统,而是进行纯逻辑判断。用一个 level 变量模拟目录层级变化:初始为 0,遇到普通目录加 1,遇到 .. 减 1,一旦 level 变为负数,说明路径已逃逸出根目录,直接拒绝。
// http请求的资源路径有效性判断
    static bool ValidPath(const std::string &path)
    {
        // 思想:按照/进行路径分割,根据有多少子目录,计算目录深度,有多少层,深度不能小于0
        std::vector<std::string> subdir;
        Split(path, "/", &subdir);
        int level = 0;
        for (auto &dir : subdir)
        {
            if (dir == ".")
            {
                continue;
            }

            if (dir == "..")
            {
                level--; // 任意一层走出相对根目录,就认为有问题
                if (level < 0)
                    return false;
                continue;
            }
            level++;
        }
        return true;
    }
ValidPath 的路径校验逻辑如下:
3.9 Util 使用场景速查表
为了方便大家快速回顾与查阅,这里将 Util 类中的 10 个工具接口整理成一张速查表,列出每个接口的名称、功能描述以及典型调用场景:
| 接口 | 功能描述 | 典型调用场景 |
|---|---|---|
Split | 按指定分隔符分割字符串,将子串存入数组并返回数量 | 解析 HTTP 请求行,按空格或 / 拆分出方法、路径与版本 |
ReadFile | 以二进制模式将磁盘文件一次性读入内存缓冲区 | 读取静态资源(HTML、CSS、图片)并作为响应体返回 |
WriteFile | 以覆盖方式将数据写入文件 | 日志落盘、临时缓存、上传文件的持久化 |
UrlEncode | 将 URL 中的特殊字符编码为 %HH 格式 | 生成重定向链接、表单回显,确保 URL 在协议层面合法 |
UrlDecode | 将 %HH 还原为原始字符,+ 还原为空格 | 解析客户端提交的请求 URI,还原用户真实输入 |
StatusDesc | 根据状态码查表获取对应的文本描述 | 构造响应状态行,如 200 OK、404 Not Found |
ExtMime | 根据文件后缀名映射到对应的 MIME 类型 | 设置响应头 Content-Type,决定浏览器渲染方式 |
IsDirectory | 判断目标路径是否为目录 | 目录浏览服务、路径安全校验前的类型区分 |
IsRegular | 判断目标路径是否为普通文件 | 防止将设备文件、管道、符号链接等作为资源返回 |
ValidPath | 校验请求路径是否越出资源根目录 | 安全防御,拦截 /../../etc/passwd 等路径遍历攻击 |
这张表可以作为日常开发时的快速索引:当你在业务代码中遇到字符串处理、文件读写、URL 编解码或路径安全校验等需求时,直接对照上表找到对应的工具接口即可,无需重复造轮子。
结语
至此,我们完成了 Util 工具类的全部设计与实现。
回顾整个过程,Util 没有引入任何复杂的底层机制,它不负责网络 I/O,不直接操作套接字,也不参与事件循环。它所做的事情,是把散落在业务代码中的高频重复逻辑——字符串分割、文件读写、URL 编解码、MIME 查询、路径安全校验——提炼为一组纯粹、无状态、可复用的静态接口。这些接口像螺丝刀与扳手一样,不引人注目,却支撑起了整个上层建筑的运转。
在实现过程中,我们也展示了工具类设计中的几个关键意识:防御性编程(空分隔符、非法编码、路径遍历的防护)、边界感(什么该放进 Util,什么不该放)、以及务实的 YAGNI 精神(不为不需要的功能提前买单)。
希望能够对大家有所帮助!
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/htw250056/article/details/165294792

