

文章目录
D26 | RAG 评估与可观测性:让 AI 问答又准又稳
系列:《60 天 AI 全栈转型:传统开发者的大模型工程师之路》(S2 模块 2 · AI 编程实战项目 ③)
作者:刘一说(haohaizi_liu)| 15 年开发管理经验
配套代码:https://gitcode.com/road-emblem/60-days-ai-stack
写在前面
D9-D13 我们把 RAG 从概念到代码完整搭了一遍。
D24-D25 我们搭了 FastAPI 全栈应用 + 多模型路由 + A/B 测试。
但有一个核心问题没解决:怎么知道你的 RAG 好不好?
RAG 是 AI 应用里最难评估的环节:
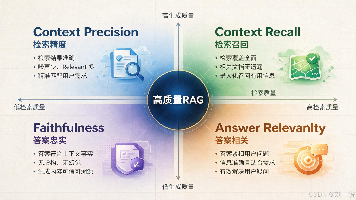
- 检索质量难评——召回的 10 个文档里有几个是真正相关的?
- 生成质量难评——LLM 生成的答案有没有幻觉?是不是答非所问?
- 端到端难评——用户问"刘一说怎么看 MCP",系统会不会胡说?
- 优化方向难找——准确率从 70% 提到 80%,到底改检索还是改 Prompt?
这一篇我们系统解决 RAG 的"质量黑盒"问题。
读完你会
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/haohaizi_liu/article/details/164731687

