

卷积神经网络从入门到迁移学习实战:从MNIST手写数字到食物分类
CNN原理 + 经典网络演进 + ResNet迁移学习 | 配图详解 + 代码注解
目录
基础篇
实战篇
基础篇
1. 为什么需要卷积神经网络——全连接网络的痛点
上一篇我们用全连接神经网络(MLP)实现了MNIST手写数字识别,准确率达到97%左右。但全连接网络处理图像有两个致命问题:
痛点一:参数量爆炸
一张普通的RGB图片(224×224×3),如果用全连接层处理:
- 输入神经元数:224 × 224 × 3 = 150,528
- 假设第1层隐藏层有1024个神经元
- 权重参数:150,528 × 1024 ≈ 1.5亿个参数
224×224×3 图片          全连接层1(1024)
┌──────────┐          ┌──────────┐
│          │          │  ●  ●  ●  │
│          │─────────→│  ●  ●  ●  │
│  15万     │  1.5亿  │  ●  ●  ●  │
│  个像素   │  个权重  │  1024个   │
│          │          │  神经元   │
└──────────┘          └──────────┘
仅仅一层就需要1.5亿参数!网络再深一点,参数就爆炸了。训练极慢,还容易过拟合。
痛点二:丢失空间信息
全连接网络把图片展平成一维向量,像素之间的空间关系(比如哪些像素相邻、哪些构成边缘)完全丢失了。
原始图片(二维)             展平后(一维)
┌──────────┐
│●●●○○○○○○│          ●●●○○○○○○●●●○○○○○○...
│●●●○○○○○○│          ↑丢失了"左边是三个连续黑点"的空间信息
│●●●○○○○○│
│○○○○○○○○○│
│○○○○○○○○○│
└──────────┘
卷积神经网络的两大优势
CNN用卷积层替代了全连接层,完美解决了这两个问题:
| 优势 | 原理 | 效果 |
|---|---|---|
| 参数共享 | 同一个卷积核在整张图上滑动,权重只需要一套 | 参数从1.5亿降到几千 |
| 局部连接 | 每个神经元只看图像的一小片区域(感受野) | 保留空间信息,提取局部特征 |
💡 通俗理解: 全连接层像是一个人"一次性看完整张图再做判断";卷积层像是"拿着放大镜一点点扫过整张图,先找边缘、再找纹理、最后拼出整体"。
2. 卷积操作详解——从内积运算到特征提取
什么是卷积?
卷积(Convolution) 就是用一个小矩阵(称为卷积核 / 滤波器 / Kernel)在图像上滑动,每到一个位置就做对应元素相乘再求和(内积运算),得到输出特征图的一个像素值。
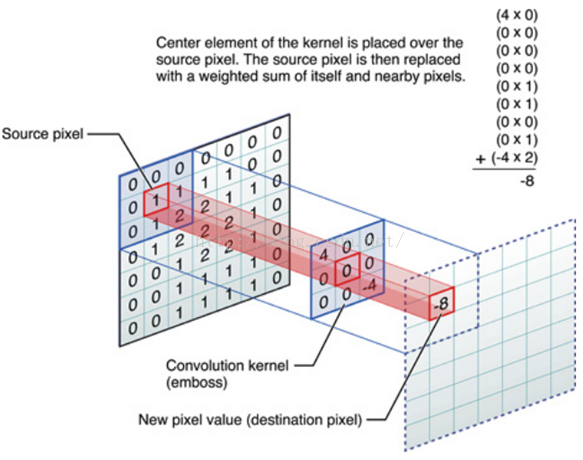
卷积操作的3D示意图:卷积核在原图上滑动,逐点做加权求和
  输入图像(5×5)        卷积核(3×3)        输出特征图(3×3)
  ┌─────────┐
  │ 1 0 1 0 1│      ┌─────┐
  │ 0 1 0 1 0│      │ 1 0 1│       ┌───────┐
  │ 1 0 1 0 1│  *   │ 0 1 0│  =    │ ? ? ? │
  │ 0 1 0 1 0│      │ 1 0 1│       │ ? ? ? │
  │ 1 0 1 0 1│      └─────┘       │ ? ? ? │
  └─────────┘                     └───────┘
计算过程(左上角第一个位置):
输出 [ 0 , 0 ] = 1 × 1 + 0 × 0 + 1 × 1 + 0 × 0 + 1 × 1 + 0 × 0 + 1 × 1 + 0 × 0 + 1 × 1 = 1 + 0 + 1 + 0 + 1 + 0 + 1 + 0 + 1 = 5 \begin{align*} \text{输出}[0,0] &= 1×1 + 0×0 + 1×1 \\ &+ 0×0 + 1×1 + 0×0 \\ &+ 1×1 + 0×0 + 1×1 \\ &= 1 + 0 + 1 + 0 + 1 + 0 + 1 + 0 + 1 \\ &= \mathbf{5} \end{align*} 输出[0,0]=1×1+0×0+1×1+0×0+1×1+0×0+1×1+0×0+1×1=1+0+1+0+1+0+1+0+1=5
不同卷积核提取不同特征
卷积核的数值不是随便设的——不同的卷积核能提取不同的视觉特征:
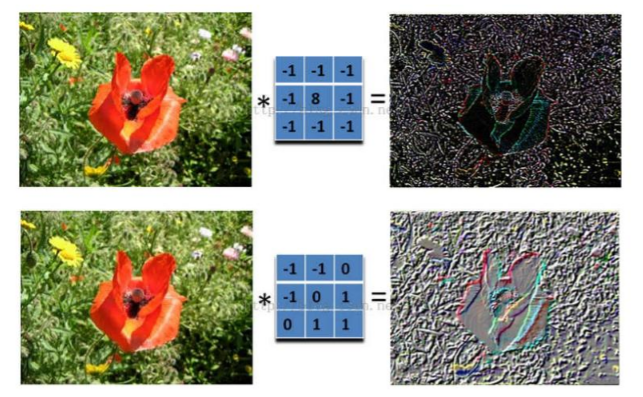
不同卷积核提取不同特征:边缘检测、浮雕效果等
| 卷积核类型 | 作用 |
|---|---|
| 边缘检测核 | 提取图像边缘(像素值突变的地方) |
| 模糊核 | 平滑图像,减少噪声 |
| 锐化核 | 增强边缘,让图像更清晰 |
| 浮雕核 | 产生立体浮雕效果 |
💡 关键洞察: 在CNN中,卷积核的数值不是人工设定的,而是通过训练自动学习的! 网络自己学会"什么样的卷积核能最好地提取特征来完成分类任务"。浅层学边缘,中层学纹理,深层学物体部件。
Conv2d参数详解
PyTorch中卷积层的API是 nn.Conv2d:
nn.Conv2d(
    in_channels=3,     # 👈 输入通道数:RGB图=3,灰度图=1
    out_channels=16,   # 👈 输出通道数:用多少个卷积核,就输出多少个通道
    kernel_size=3,     # 👈 卷积核大小:3表示3×3
    stride=1,          # 👈 步长:卷积核每次滑动几格
    padding=0          # 👈 填充:在图像周围补几圈0
)
输出尺寸计算公式
卷积后特征图的尺寸计算公式:
H o u t = H i n − K + 2 P S + 1 H_{out} = \frac{H_{in} - K + 2P}{S} + 1 Hout=SHin−K+2P+1
W o u t = W i n − K + 2 P S + 1 W_{out} = \frac{W_{in} - K + 2P}{S} + 1 Wout=SWin−K+2P+1
其中:
- H_in / W_in:输入高度/宽度
- K:kernel_size(卷积核大小)
- P:padding(填充)
- S:stride(步长)
例子: 输入28×28,卷积核3×3,步长1,填充0
H o u t = 28 − 3 + 2 × 0 1 + 1 = 26 H_{out} = \frac{28 - 3 + 2×0}{1} + 1 = 26 Hout=128−3+2×0+1=26
输出特征图大小:26×26
padding的作用
为什么需要padding?主要有两个原因:
- 保持尺寸 — 不padding的话,每次卷积图片都会缩小。如果网络很深,图片会缩得很小。
- 保留边缘信息 — 边缘像素只被计算一次,padding后边缘像素也能被充分利用。
【无padding:边缘信息少】      【有padding=1:边缘信息充分利用】
  ┌─────────┐                ┌─────────────┐
  │●●●●●●●●●│                │0 0 0 0 0 0 0│
  │●●●●●●●●●│                │0 ●●●●●●● 0│
  │●●●●●●●●●│                │0 ●●●●●●● 0│
  │●●●●●●●●●│                │0 ●●●●●●● 0│
  └─────────┘                │0 0 0 0 0 0 0│
                              └─────────────┘
3. 池化层、感受野与全连接层
池化层:降采样的利器
卷积提取了特征,但特征图还是很大。池化层(Pooling) 用来缩小特征图尺寸,减少参数量,同时保留最重要的信息。
最常用的是 Max Pooling(最大池化):取窗口内的最大值。
  输入特征图(4×4)         Max Pooling 2×2, stride=2       输出(2×2)
  ┌─────────┐                                 ┌───────┐
  │ 1 3 2 1 │                                 │  4  3 │
  │ 2 4 1 0 │   ┌───┐  取窗口内最大值          │       │
  │ 0 1 3 2 │   │2×2│  ───────────────→       │  3  5 │
  │ 1 2 5 3 │   └───┘                          │       │
  └─────────┘                                 └───────┘
| 池化类型 | 操作 | 特点 |
|---|---|---|
| Max Pooling | 取窗口内最大值 | 保留最强的特征响应,最常用 |
| Average Pooling | 取窗口内平均值 | 更平滑,保留整体信息 |
| AdaptiveAvgPool | 自适应平均池化 | 输出尺寸固定,与输入尺寸无关 |
💡 池化层没有可学习的参数,它只是一个固定的降采样操作。通常放在卷积层之后,用来逐步缩小空间尺寸、增加通道数。
感受野:层层放大的视野
感受野(Receptive Field) 指的是输出特征图上的一个像素,能看到输入图像上多大的区域。
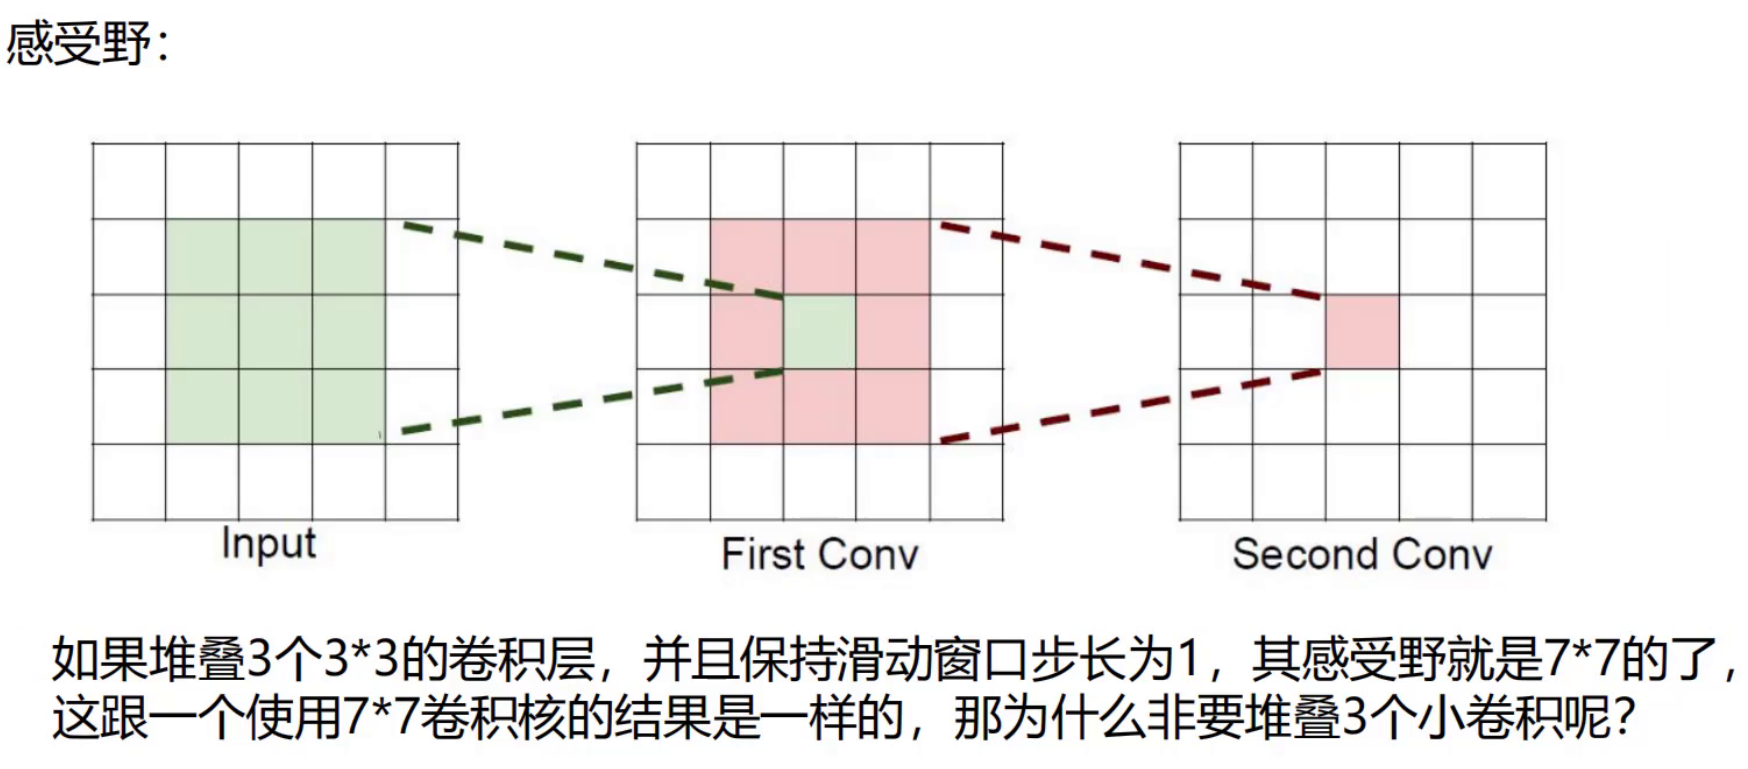
感受野示意图:2层3×3卷积后,输出的一个像素能看到输入的5×5区域
第1层卷积(3×3核):感受野 = 3×3    只能看到一小片
       ↓
第2层卷积(3×3核):感受野 = 5×5    看到更大的区域
       ↓
第3层卷积(3×3核):感受野 = 7×7    看到更大的区域
| 网络深度 | 卷积核配置 | 感受野大小 | 参数量 |
|---|---|---|---|
| 1层 7×7 卷积 | 1个7×7核 | 7×7 | 49 |
| 3层 3×3 卷积 | 3个3×3核 | 7×7 | 27(更少!) |
💡 为什么用多个小卷积核替代一个大卷积核?
- 相同感受野下,3个3×3 比 1个7×7 参数量更少(27 < 49)
- 多个小卷积核中间有激活函数,非线性更强,表达能力更好
- 这就是VGGNet的核心设计思想:堆叠3×3小卷积核
全连接层:从特征到分类
经过多层卷积和池化后,我们得到了一张"高级特征图"。最后需要通过全连接层把这些特征映射到最终的分类结果。
流程:卷积层提取特征 → 池化层降维 → Flatten展平 → 全连接层分类
卷积+池化提取特征          Flatten展平        全连接层         输出(分类)
┌──────────────┐      ┌──────────┐     ┌─────────┐     ┌──────┐
│  ●  ●  ●  ●  │      │ ●●●●●●●●│     │  ● ● ●  │     │  ●   │
│  ●  ●  ●  ●  │ ──→  │ ●●●●●●●●│ ──→ │  ● ● ●  │ ──→ │  ●   │
│  ●  ●  ●  ●  │      │ ●●●●●●●│     │  ● ● ●  │     │ ...  │
│  ●  ●  ●  ●  │      └──────────┘     └─────────┘     └──────┘
└──────────────┘       一维向量          隐藏层          类别数
  (高维特征图)         (C×H×W)         (如512)         (如20类)
一个典型的CNN整体结构:
输入图片 → [Conv → ReLU → Pool] × N → Flatten → [Linear → ReLU] × M → 输出
           ← 卷积部分:提取特征 →       ← 全连接部分:分类 →
实战篇
4. 用CNN实现MNIST手写数字识别
理论讲完了,我们用CNN来做MNIST手写数字识别,和之前的全连接网络比一比谁更准。
网络结构设计
  输入(1×28×28)
       │
  Conv1: 1→16, 3×3, stride=1      输出: 16×26×26
       │
  ReLU
       │
  MaxPool: 2×2, stride=2          输出: 16×13×13
       │
  Conv2: 16→32, 3×3, stride=1     输出: 32×11×11
       │
  ReLU
       │
  MaxPool: 2×2, stride=2          输出: 32×5×5 = 800
       │
  Flatten                           输出: 800
       │
  Linear: 800 → 128                输出: 128
       │
  ReLU
       │
  Linear: 128 → 10                 输出: 10 (10个数字)
完整代码
import torch
from torch import nn
from torch.utils.data import DataLoader
from torchvision import datasets
from torchvision.transforms import ToTensor

# === 1. 数据集 ===
training_data = datasets.MNIST(root='data', train=True, download=True, transform=ToTensor())
test_data = datasets.MNIST(root='data', train=False, download=True, transform=ToTensor())

train_dataloader = DataLoader(training_data, batch_size=64, shuffle=True)
test_dataloader = DataLoader(test_data, batch_size=64)

# === 2. 设备选择 ===
device = "cuda" if torch.cuda.is_available() else \
         "mps" if torch.backends.mps.is_available() else "cpu"
print(f"Using: {device} device")

# === 3. CNN模型定义 ===
class CNN(nn.Module):
    def __init__(self):
        super().__init__()
        # 👈 卷积部分:用Sequential容器把多层按顺序打包
        self.conv_layers = nn.Sequential(
            # 第1个卷积块:Conv + ReLU + MaxPool
            nn.Conv2d(1, 16, kernel_size=3, stride=1),  # 👈 输入1通道(灰度图),输出16通道
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2),     # 👈 2×2最大池化,尺寸减半

            # 第2个卷积块:Conv + ReLU + MaxPool
            nn.Conv2d(16, 32, kernel_size=3, stride=1), # 👈 输入16通道,输出32通道
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2),
        )

        # 全连接部分
        self.fc_layers = nn.Sequential(
            nn.Linear(32 * 5 * 5, 128),  # 👈 32通道×5×5尺寸 = 800维
            nn.ReLU(),
            nn.Linear(128, 10)            # 👈 输出10类
        )

    def forward(self, x):
        x = self.conv_layers(x)          # 👈 经过卷积层提取特征 [64,1,28,28]→[64,32,5,5]
        x = x.view(x.size(0), -1)        # 👈 展平:[64,32,5,5]→[64,800]
                                         # x.size(0)是batch_size,-1表示自动计算剩余维度
        x = self.fc_layers(x)            # 👈 全连接层分类 [64,800]→[64,10]
        return x

model = CNN().to(device)
print(model)

# === 4. 损失函数和优化器 ===
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)

# === 5. 训练函数 ===
def train(dataloader, model, loss_fn, optimizer):
    model.train()
    for batch, (X, y) in enumerate(dataloader):
        X, y = X.to(device), y.to(device)

        pred = model(X)                    # 前向传播
        loss = loss_fn(pred, y)            # 计算损失

        optimizer.zero_grad()              # 梯度清零
        loss.backward()                    # 反向传播
        optimizer.step()                   # 更新参数

        if batch % 100 == 0:
            print(f"Batch {batch}: loss = {loss.item():.6f}")

# === 6. 测试函数 ===
def test(dataloader, model, loss_fn):
    size = len(dataloader.dataset)
    num_batches = len(dataloader)
    model.eval()
    test_loss, correct = 0, 0

    with torch.no_grad():
        for X, y in dataloader:
            X, y = X.to(device), y.to(device)
            pred = model(X)
            test_loss += loss_fn(pred, y).item()
            correct += (pred.argmax(1) == y).type(torch.float).sum().item()

    test_loss /= num_batches
    correct /= size
    print(f"Test: Accuracy = {(100*correct):.2f}%, Avg loss = {test_loss:.6f}\n")

# === 7. 训练10轮 ===
epochs = 10
for t in range(epochs):
    print(f"Epoch {t+1}\n-------------------------------")
    train(train_dataloader, model, loss_fn, optimizer)
    test(test_dataloader, model, loss_fn)
print("Done!")
💡 CNN vs 全连接网络对比:
- 全连接网络准确率约 97.5%
- CNN准确率约 99%+
- CNN参数更少,效果更好——这就是卷积的威力!
5. 经典CNN网络演进——从LeNet到ResNet
CNN的发展经历了几代经典网络,每一代都在解决上一代的问题。CNN的核心优势之一就是不变性——物体即使平移、旋转、缩放、光照变化,也能正确识别:
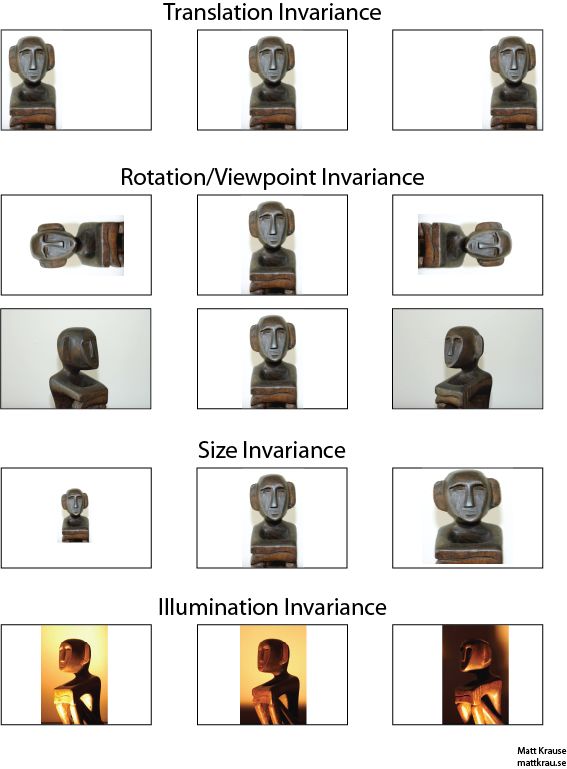
图像的各种不变性:平移、旋转、尺度、光照
数据增强正是在模拟这些变化,让CNN学会"不管怎么变,都认得出来"。
LeNet (1998)  →  AlexNet (2012)  →  VGGNet (2014)  →  ResNet (2015)  →  DenseNet
    ↓               ↓                 ↓                 ↓
  5层网络        8层网络           16~19层            152层
  手写数字       ImageNet冠军       小卷积核堆叠       残差连接
                 里程碑
| 网络 | 年份 | 核心创新 | 深度 | 意义 |
|---|---|---|---|---|
| LeNet | 1998 | 卷积+池化的经典结构 | 5层 | CNN的开山之作,用于手写数字 |
| AlexNet | 2012 | ReLU、Dropout、GPU加速 | 8层 | 深度学习崛起的里程碑,ImageNet冠军 |
| VGGNet | 2014 | 全部用3×3小卷积核堆叠 | 16/19层 | 证明"深"比"宽"更重要 |
| ResNet | 2015 | 残差连接(shortcut) | 152层 | 解决深度网络退化问题,跨时代 |
| DenseNet | 2017 | 密集连接,特征复用 | 121/169层 | 进一步强化特征流动 |
ResNet有不同深度的版本,从18层到152层都有:
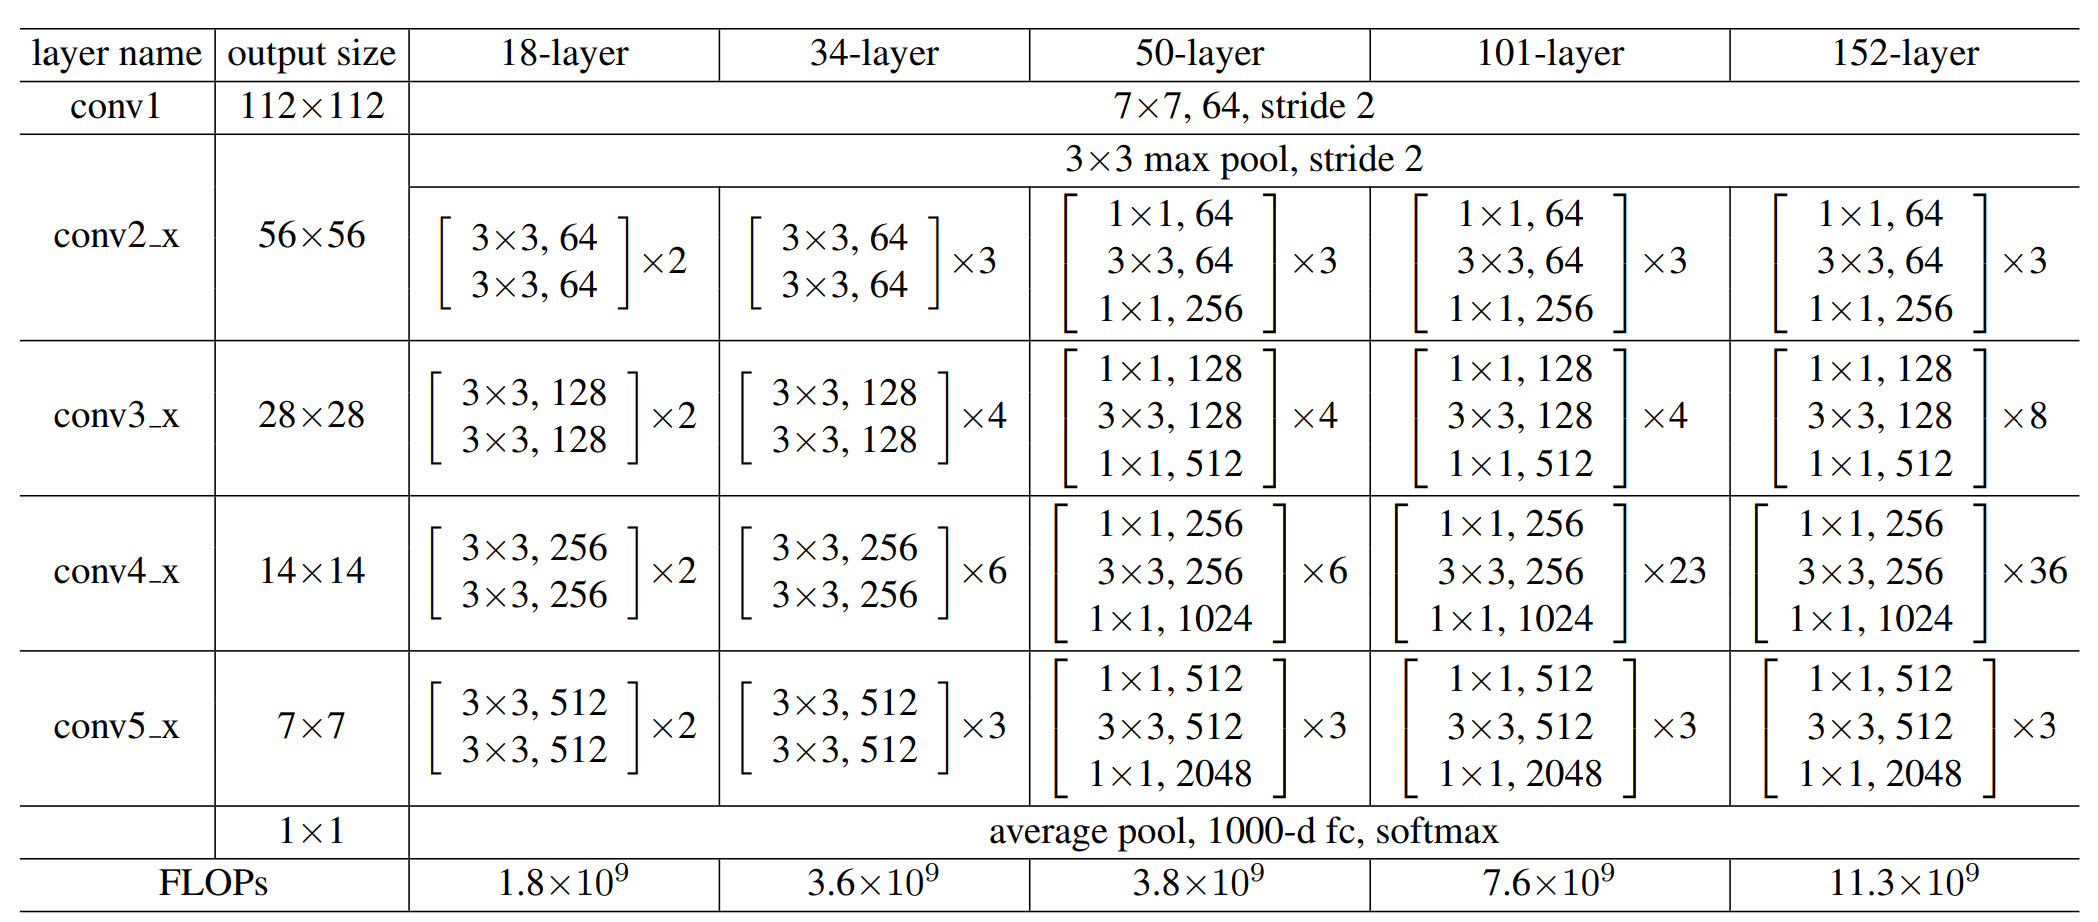
ResNet各版本配置:18/34/50/101/152层的结构对比表
18层和34层用的是基础残差块,50层以上用的是"瓶颈"结构(1×1+3×3+1×1),进一步减少参数量。
演进规律: 网络越来越深 → 但越深越难训练 → 用新结构(残差、密集连接)解决深层训练问题
6. ResNet残差结构与迁移学习原理
深度网络的退化问题
按理说,网络越深,表达能力越强,效果应该越好。但实际发现:网络太深时,准确率反而下降了——这就是退化问题(Degradation)。
  准确率
    │
    │        ● (20层: 92%)
    │     ╱
    │   ╱
    │ ╱                      ● (56层: 88%?? ← 退化了!)
    │● (5层: 80%)          ╱
    │                   ╱
    └──────────────────────────────→ 网络深度
为什么会退化?不是过拟合(训练误差也升高了),而是网络太深了,参数反而学不好。
ResNet的解决方案:残差连接
ResNet提出了残差连接(Residual Connection / Shortcut):让输入"抄近路"直接加到输出上。
普通层:                    残差块(Residual Block):
  x ──→ [Conv+BN+ReLU] ──→ F(x)     x ──→ [Conv+BN+ReLU] ──→ F(x)
                                          │                    │
                                          └────────── + ──────┘
                                                     │
                                                     ↓
                                                  F(x) + x  ← 残差连接!
残差块的公式:
y = F ( x ) + x y = F(x) + x y=F(x)+x
💡 为什么残差连接有效?
原来网络要学习的是
H(x)(从x到y的完整映射),现在学习的是F(x) = H(x) - x(残差,即"还差多少")。学习残差比学习完整映射容易得多——如果某一层不需要做任何改变,让F(x)=0就行(权重初始化为0就好了),直接走shortcut。网络可以自由选择"哪些层有用,哪些层直接跳过"。
Batch Normalization
ResNet中还有一个重要组件:Batch Normalization(批归一化)。
作用:在每一层的输出上做归一化(均值为0,方差为1),让数据分布更稳定。
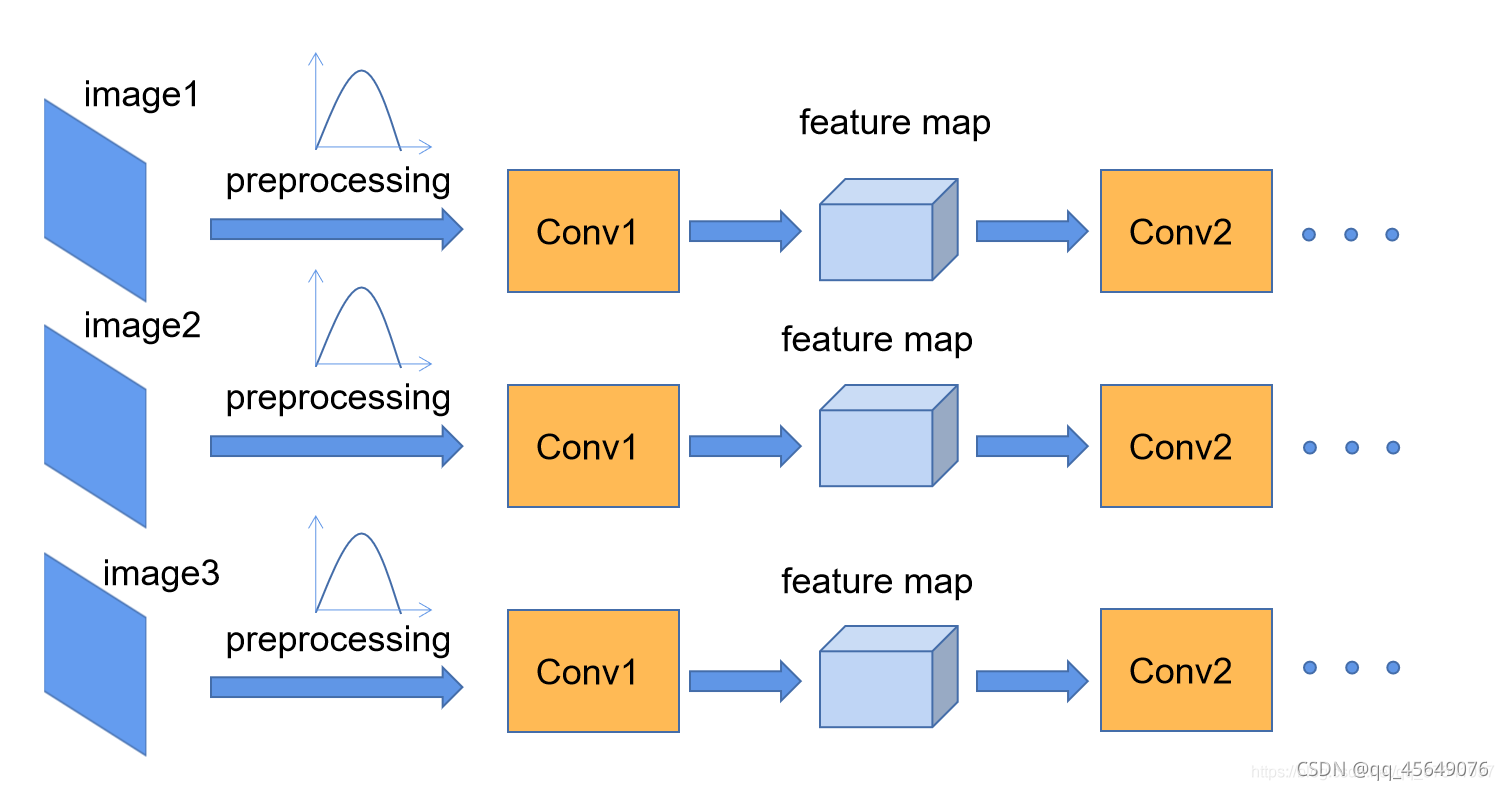
Batch Normalization示意图:对每个batch的数据做归一化,稳定数据分布
好处:
- 加速训练收敛
- 允许使用更大的学习率
- 减少对初始化的依赖
- 有一定的正则化效果
# 一个标准的残差块结构
class ResidualBlock(nn.Module):
    def __init__(self, in_channels, out_channels, stride=1):
        super().__init__()
        self.conv1 = nn.Conv2d(in_channels, out_channels, 3, stride, padding=1, bias=False)
        self.bn1 = nn.BatchNorm2d(out_channels)   # 👈 批归一化1
        self.relu = nn.ReLU(inplace=True)
        self.conv2 = nn.Conv2d(out_channels, out_channels, 3, padding=1, bias=False)
        self.bn2 = nn.BatchNorm2d(out_channels)   # 👈 批归一化2

        # shortcut连接:如果通道数变了,需要用1×1卷积调整
        self.shortcut = nn.Sequential()
        if stride != 1 or in_channels != out_channels:
            self.shortcut = nn.Sequential(
                nn.Conv2d(in_channels, out_channels, 1, stride, bias=False),
                nn.BatchNorm2d(out_channels)
            )

    def forward(self, x):
        out = self.conv1(x)
        out = self.bn1(out)
        out = self.relu(out)
        out = self.conv2(out)
        out = self.bn2(out)
        out += self.shortcut(x)    # 👈 残差连接:F(x) + x
        out = self.relu(out)
        return out
迁移学习:站在巨人的肩膀上
迁移学习(Transfer Learning) 就是把在大数据集上训练好的模型,用到自己的小数据集上。
为什么可以迁移?因为CNN的浅层学到的是通用特征(边缘、纹理、颜色),这些特征对各种图像任务都适用。
ImageNet大数据集(1400万张,1000类)   →   你的小数据集(几千张,20类)
         ↓                                    ↓
  训练好的ResNet18模型          →        拿过来微调
         ↓                                    ↓
  浅层:边缘、纹理(通用)        →        浅层特征直接用(冻结)
  深层:物体部件(较通用)        →        深层微调或替换
  分类层:1000类(专用)          →        替换成你的分类数
迁移学习的5个步骤:
- 加载预训练模型(如ResNet18,在ImageNet上训练好)
- 冻结预训练参数(浅层不动,节省计算+防止过拟合)
- 替换最后一层(全连接层换成你自己的类别数)
- 训练新层(只训练新增的全连接层)
- 可选:全模型微调(解冻全部层,用很小的学习率整体微调)
💡 什么时候用迁移学习?
- 数据集很小 → 强烈推荐用迁移学习(自己训不起来)
- 数据集中等 → 迁移学习 + 微调效果最好
- 数据集非常大 → 可以从头训练,但迁移学习仍然更快更好
7. ResNet18迁移学习实战:20类食物分类
理论讲完了,我们用ResNet18做一个20类食物分类任务,体验迁移学习的威力。
数据集介绍
20类食物,包含厨余垃圾和可回收物两大类别:
| 大类 | 具体食物 |
|---|---|
| 厨余垃圾 | 哈密瓜、圣女果、巴旦木、板栗、汉堡、火龙果、炸鸡、瓜子、生肉、白萝卜、胡萝卜、草莓、菠萝、薯条、蛋、蛋挞、青菜、骨肉相连、鸡翅 |
| 可回收物 | 八宝粥 |
训练集放在 train/ 文件夹,测试集放在 test/ 文件夹,每类一个子文件夹。
完整代码
import torch
from torch import nn
from torch.utils.data import DataLoader, Dataset
from torchvision import transforms, models
from torchvision.models import ResNet18_Weights
from PIL import Image
import os

# === 1. 超参数 ===
batch_size = 32
lr = 0.001
epochs = 20
num_classes = 20
device = "cuda" if torch.cuda.is_available() else "cpu"
print(f"Using: {device}")

# === 2. 数据增强与预处理 ===
train_transform = transforms.Compose([
    transforms.RandomResizedCrop(224),      # 随机裁剪到224×224
    transforms.RandomHorizontalFlip(),       # 随机水平翻转
    transforms.ToTensor(),
    transforms.Normalize(                    # 用ImageNet的均值和标准差
        mean=[0.485, 0.456, 0.406],
        std=[0.229, 0.224, 0.225]
    )
])

test_transform = transforms.Compose([
    transforms.Resize(256),
    transforms.CenterCrop(224),               # 测试集用中心裁剪
    transforms.ToTensor(),
    transforms.Normalize(
        mean=[0.485, 0.456, 0.406],
        std=[0.229, 0.224, 0.225]
    )
])

# === 3. 自定义Dataset ===
class FoodDataset(Dataset):
    def __init__(self, txt_path, transform=None):
        self.transform = transform
        self.imgs = []                        # 存储 (图片路径, 标签) 对

        with open(txt_path, 'r') as f:
            for line in f:
                line = line.strip()
                if not line:
                    continue
                path, label = line.split()
                self.imgs.append((path, int(label)))

    def __len__(self):
        return len(self.imgs)                # 👈 返回数据集大小

    def __getitem__(self, idx):
        path, label = self.imgs[idx]
        img = Image.open(path).convert('RGB')  # 👈 读取图片并转RGB
        if self.transform:
            img = self.transform(img)          # 👈 应用数据增强
        return img, label

# 生成标签文件的脚本(首次运行时用)
def generate_txt(data_dir, output_txt):
    class_names = sorted(os.listdir(data_dir))  # 👈 按名称排序,保证标签一致
    class_to_idx = {name: i for i, name in enumerate(class_names)}

    with open(output_txt, 'w') as f:
        for class_name in class_names:
            class_dir = os.path.join(data_dir, class_name)
            label = class_to_idx[class_name]
            for img_name in os.listdir(class_dir):
                img_path = os.path.join(class_dir, img_name)
                f.write(f"{img_path} {label}\n")
    print(f"Generated {output_txt}: {len(os.listdir(class_dir))*len(class_names)} images")

# === 4. 数据加载 ===
train_dataset = FoodDataset('train.txt', transform=train_transform)
test_dataset = FoodDataset('test.txt', transform=test_transform)

train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=batch_size)

# === 5. 加载预训练的ResNet18 ===
resnet_model = models.resnet18(weights=ResNet18_Weights.DEFAULT)
# 👈 加载在ImageNet上预训练好的ResNet18权重

# === 6. 冻结预训练参数 ===
for param in resnet_model.parameters():
    param.requires_grad = False              # 👈 冻结所有参数,不计算梯度

# === 7. 替换全连接层 ===
in_features = resnet_model.fc.in_features    # 👈 获取原全连接层的输入维度(512)
resnet_model.fc = nn.Linear(in_features, num_classes)  # 👈 替换成20类输出
# 新的全连接层参数默认 requires_grad=True,会被训练

model = resnet_model.to(device)

# 只更新需要梯度的参数(即新替换的全连接层)
params_to_update = [p for p in model.parameters() if p.requires_grad]
print(f"Parameters to train: {len(params_to_update)} groups")

# === 8. 损失函数和优化器 ===
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(params_to_update, lr=lr)

# 学习率调度器:每7个epoch学习率乘以0.1
scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=7, gamma=0.1)

# === 9. 训练和测试 ===
best_acc = 0.0

for epoch in range(epochs):
    # ---- 训练 ----
    model.train()
    train_loss = 0.0
    train_correct = 0
    train_total = 0

    for inputs, labels in train_loader:
        inputs, labels = inputs.to(device), labels.to(device)

        outputs = model(inputs)
        loss = loss_fn(outputs, labels)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        train_loss += loss.item() * inputs.size(0)
        _, predicted = outputs.max(1)
        train_total += labels.size(0)
        train_correct += predicted.eq(labels).sum().item()

    scheduler.step()  # 👈 更新学习率

    train_loss /= train_total
    train_acc = 100.0 * train_correct / train_total

    # ---- 测试 ----
    model.eval()
    test_loss = 0.0
    test_correct = 0
    test_total = 0

    with torch.no_grad():
        for inputs, labels in test_loader:
            inputs, labels = inputs.to(device), labels.to(device)
            outputs = model(inputs)
            loss = loss_fn(outputs, labels)

            test_loss += loss.item() * inputs.size(0)
            _, predicted = outputs.max(1)
            test_total += labels.size(0)
            test_correct += predicted.eq(labels).sum().item()

    test_loss /= test_total
    test_acc = 100.0 * test_correct / test_total

    # 保存最优模型
    if test_acc > best_acc:
        best_acc = test_acc
        torch.save(model.state_dict(), 'best_food.pth')

    print(f"Epoch [{epoch+1}/{epochs}] "
          f"Train Loss: {train_loss:.4f} Acc: {train_acc:.2f}% | "
          f"Test Loss: {test_loss:.4f} Acc: {test_acc:.2f}% | "
          f"Best: {best_acc:.2f}%")

print(f"\nTraining complete! Best test accuracy: {best_acc:.2f}%")
代码关键要点
| 要点 | 代码 | 说明 |
|---|---|---|
| 加载预训练模型 | models.resnet18(weights=ResNet18_Weights.DEFAULT) | 自动下载预训练权重 |
| 冻结参数 | param.requires_grad = False | 不更新预训练层的权重 |
| 替换全连接层 | resnet_model.fc = nn.Linear(512, 20) | 输出维度改为自己的类别数 |
| 只训新参数 | params_to_update 筛选 | 只把需要更新的参数传给优化器 |
| 学习率调度 | StepLR(step_size=7, gamma=0.1) | 每7轮学习率乘0.1 |
| 保存最优 | if test_acc > best_acc: torch.save(...) | 只保存测试准确率最高的模型 |
💡 迁移学习的优势:
- 训练快:只训最后一层,几分钟就能收敛
- 效果好:预训练模型已经学会了通用视觉特征
- 数据少也能训:哪怕每类只有几十张图也能有不错的效果
总结
CNN核心知识点
| 概念 | 核心要点 | 一句话记忆 |
|---|---|---|
| 卷积层 | 卷积核滑动+内积,参数共享 | 拿放大镜扫图,提取局部特征 |
| 池化层 | MaxPool取最大值,降采样 | 缩小尺寸,保留最强响应 |
| 感受野 | 输出像素能看到的输入区域 | 越深看得越广 |
| 小卷积核 | 3个3×3 > 1个7×7 | 参数量少,非线性强 |
| 残差连接 | F(x) + x,shortcut抄近路 | 解决深度网络退化问题 |
| BatchNorm | 批归一化,稳定分布 | 加速收敛,允许大学习率 |
| 迁移学习 | 预训练模型拿来用 | 站在巨人肩膀上,小数据也能训 |
代码模板速查
| 任务 | 核心代码 |
|---|---|
| 卷积层 | nn.Conv2d(in, out, kernel_size, stride, padding) |
| 池化层 | nn.MaxPool2d(kernel_size, stride) |
| 展平 | x.view(x.size(0), -1) |
| 加载ResNet | models.resnet18(weights=ResNet18_Weights.DEFAULT) |
| 冻结参数 | for p in model.parameters(): p.requires_grad = False |
| 替换fc层 | model.fc = nn.Linear(in_features, num_classes) |
| 保存最优 | if acc > best: torch.save(model.state_dict(), path) |
从基础CNN到ResNet迁移学习,我们完成了卷积神经网络的完整学习路径。下一篇将讲解CNN训练中的数据增强与模型优化技巧,教你如何把模型准确率再往上提几个百分点。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2301_80420058/article/details/165490179

