

在数据驱动决策的时代,掌握数据分析能力已经不再是数据科学家的专属技能,而是每一位程序员、产品经理、运营人员都应该具备的基础素养。Python 凭借其丰富的生态系统,成为了数据分析领域的首选语言。而在 Python 数据分析的工具箱中,有三个库你一定绕不开——NumPy、Pandas 和 Matplotlib,它们被誉为数据分析的"三剑客"。
今天这篇文章,我们就来系统地梳理这三个核心库的核心用法,帮助你从零开始建立数据分析的知识体系。无论你是刚入门的新手,还是想查漏补缺的实践者,都能在这篇文章中找到有价值的内容。
一、NumPy:高效数值计算的基石
NumPy(Numerical Python)是 Python 科学计算的基础库。它提供了高性能的多维数组对象 ndarray,以及大量用于操作这些数组的函数。可以说,没有 NumPy,就没有 Python 数据分析的繁荣生态。
1.1 为什么需要 NumPy
原生的 Python 列表虽然灵活,但在处理大规模数值计算时效率很低。NumPy 的核心优势在于:
-
内存高效:同类型数据连续存储,比 Python list 占用更少内存
-
计算速度快:底层用 C 语言实现,向量化操作避免了 Python 循环的开销
-
功能丰富:内置线性代数、傅里叶变换、随机数生成等高级功能
1.2 数组的创建
NumPy 的核心是 ndarray 对象。创建数组最直接的方式是将 Python 列表传入 np.array()。
一维数组:
import numpy as np

list1 = [1, 2, 3]
array = np.array(list1)

print(type(array))  # <class 'numpy.ndarray'>
print(array)        # [1 2 3]
二维数组:
list2 = [[1, 2, 3], [3, 4, 5]]
array2 = np.array(list2)

print(type(array2))  # <class 'numpy.ndarray'>
print(array2)
# [[1 2 3]
#  [3 4 5]]
除了从列表转换,NumPy 还提供了多种便捷的数组创建方法:
|
方法 |
作用 |
示例 |
|---|---|---|
|
|
创建全 0 数组 |
|
|
|
创建全 1 数组 |
|
|
|
创建序列数组 |
|
|
|
创建等分数组 |
|
|
|
创建随机整数数组 |
|
|
|
标准正态分布随机数组 |
|
这里特别提一下 arange 和 linspace 的区别:arange 是按步长生成,不保证包含终点;linspace 是按数量等分,一定会包含起点和终点。在需要精确控制端点时,linspace 往往更可靠。
1.3 索引与切片
掌握数组的索引和切片,是操作数据的第一步。NumPy 的索引语法非常优雅,采用 数组[行索引, 列索引] 的格式。
arr = np.array([[1, 2, 3, 4],
                [5, 6, 7, 8],
                [9, 10, 11, 12]])

# 取单个元素
print(arr[0, 0])      # 1 —— 第一行第一列

# 取整行
print(arr[-1])        # [9 10 11 12] —— 最后一行
print(arr[-1, :])     # 同上,写法更完整

# 取整列
print(arr[:, 1])      # [2 6 10] —— 所有行的第二列
print(arr[:, -1])     # [4 8 12] —— 所有行的最后一列
切片操作的语法是 数组[行起始:结束:步长, 列起始:结束:步长],和 Python 列表切片规则一致,但支持多维同时切片:
print(arr[:2])          # 前两行
print(arr[:2, :2])      # 前两行前两列 → [[1 2] [5 6]]
print(arr[::2, ::2])    # 行和列都隔一个取 → [[1 3] [9 11]]
1.4 Bool 索引
除了按位置取值,NumPy 还支持布尔索引——用一个布尔数组作为"筛子",筛选出满足条件的元素。这是数据分析中最常用的操作之一。
bool_arr = arr > 5
print(bool_arr)
# [[False False False False]
#  [False  True  True  True]
#  [ True  True  True  True]]

print(arr[bool_arr])  # [ 6  7  8  9 10 11 12]

# 也可以直接简写
print(arr[arr < 3])   # [1 2]
布尔索引的强大之处在于,可以组合多个条件进行复杂筛选。比如 arr[(arr > 3) & (arr < 10)] 就能选出大于 3 且小于 10 的所有元素。注意这里要用 & 和 | 而不是 Python 的 and / or,因为我们需要的是逐元素的逻辑运算。
1.5 形状操作
数据分析中经常需要调整数据的维度和形状。NumPy 提供了丰富的形状操作方法:
arr = np.arange(12)  # [0 1 2 ... 11]

# reshape:返回新数组,不修改原数组
arr2 = arr.reshape((2, 6))
print(arr2)
# [[ 0  1  2  3  4  5]
#  [ 6  7  8  9 10 11]]
print(arr.shape)  # (12,) —— 原数组不变

# resize:直接修改原数组,无返回值
arr.resize(3, 4)
print(arr)
# [[ 0  1  2  3]
#  [ 4  5  6  7]
#  [ 8  9 10 11]]

# 转置:行列互换
print(arr.T.shape)  # (4, 3)

# 展平:降低维度为一维
print(arr.flatten())  # [0 1 2 ... 11]
这里有一个容易踩的坑:reshape 不会修改原数组,而 resize 会。另外,无论哪种方式,都要求变形前后元素总数一致,否则会报 ValueError。
1.6 数组运算与广播
NumPy 的数组运算支持逐元素的加减乘除,也支持矩阵乘法:
matrix_a = np.array([[1, 2], [3, 4]])
matrix_b = np.array([[5, 6], [7, 8]])

# 矩阵乘法(点积)
print(matrix_a.dot(matrix_b))
# [[19 22]
#  [43 50]]
而广播(Broadcasting)是 NumPy 中一个极其重要但也容易让人困惑的概念。简单来说,当两个数组形状不同时,NumPy 会尝试将它们"对齐",使得运算可以进行。
标量广播 最好理解——一个数和一个数组相加,相当于这个数和数组中每个元素相加:
a = np.array([[1, 2, 3], [4, 5, 6], [7, 8, 9]])
d = 2
print(a + d)
# [[ 3  4  5]
#  [ 6  7  8]
#  [ 9 10 11]]
数组广播 发生在两个数组维度不完全匹配,但行或列至少有一个方向可以"对齐"的时候:
b = np.array([10, 20, 30])  # 形状 (3,)
c = np.array([[1], [2], [3]])  # 形状 (3, 1)

print(a + b)  # b 的每一行与 a 的对应行相加
# [[11 22 33]
#  [14 25 36]
#  [17 28 39]]

print(a + c)  # c 的每一列与 a 的对应列相加
# [[ 2  3  4]
#  [ 6  7  8]
#  [10 11 12]]
广播虽然方便,但也不是万能的。当两个数组的形状在任何维度上都不匹配时,就会报错:
e = np.ones((4, 4))
print(e + b)  # ValueError:(4,4) 和 (3,) 无法广播
理解广播的关键在于记住一个原则:从右往左对齐维度,长度为 1 的维度可以被扩展,不相等且都不为 1 的维度会报错。
1.7 统计运算
NumPy 内置了丰富的统计函数,可以方便地计算总和、均值、标准差等指标:
arr = np.array([[1, 2, 3], [4, 5, 6], [7, 8, 9]])

print("总和:", np.sum(arr))          # 45
print("列方向总和:", np.sum(arr, axis=0))  # [12 15 18]
print("行方向总和:", np.sum(arr, axis=1))  # [ 6 15 24]

print("平均值:", np.mean(arr))       # 5.0
print("标准差:", np.std(arr))        # 2.581988897471611
print("方差:", np.var(arr))          # 6.666666666666667
print("最小值:", np.min(arr))        # 1
print("最大值:", np.max(arr))        # 9
print("最小值索引:", np.argmin(arr)) # 0
print("最大值索引:", np.argmax(arr)) # 8
这里的 axis 参数是一个重点。axis=0 表示沿着行的方向运算(即对每一列计算),axis=1 表示沿着列的方向运算(即对每一行计算)。这个规则在 Pandas 中也是通用的,理解了它,后续学习 Pandas 时会轻松很多。
二、Pandas:结构化数据分析的利器
如果说 NumPy 是基础,那么 Pandas 就是 Python 数据分析的"瑞士军刀"。Pandas 构建在 NumPy 之上,提供了两种核心数据结构:Series(一维)和 DataFrame(二维),以及大量用于数据清洗、转换、聚合的工具。
2.1 Series 对象
Series 可以理解为"带索引的一维数组"。它和 NumPy 数组的区别在于,Series 拥有自定义的索引标签。
从列表创建:
import pandas as pd

s1 = pd.Series([1, 2, 3])
# 0    1
# 1    2
# 2    3
# dtype: int64

# 自定义索引
s3 = pd.Series([1, 2, 3, 4], index=['a', 'b', 'c', 'd'])
# a    1
# b    2
# c    3
# d    4
# dtype: int64
从字典创建:
s2 = pd.Series({'a': 1, 'b': 2, 'c': 3})
# a    1
# b    2
# c    3
# dtype: int64
字典的键自动变成索引,值变成数据。需要注意的是,Series 创建后不建议随意修改索引名,否则可能导致数据全部变为 NaN。
2.2 DataFrame 对象
DataFrame 是 Pandas 中最核心的数据结构,你可以把它想象成一张 Excel 表格——有行、有列、有表头。
从字典创建:
data = {
    "姓名": ["张三", "李四", "王五", "赵六"],
    "年龄": [25, 30, 35, 28],
    "城市": ["北京", "上海", "广州", "深圳"],
    "工资": [5000, 7000, 6000, 8000]
}
df = pd.DataFrame(data)
print(df)
#    姓名  年龄  城市    工资
# 0  张三  25  北京  5000
# 1  李四  30  上海  7000
# 2  王五  35  广州  6000
# 3  赵六  28  深圳  8000
从字典创建时,每个键对应一列,键名就是列名。
从列表创建:
data2 = [
    ["张三", 25, "北京", 5000],
    ["李四", 30, "上海", 7000],
    ["王五", 35, "广州", 6000],
    ["赵六", 28, "深圳", 8000]
]
df2 = pd.DataFrame(data2, columns=["姓名", "年龄", "城市", "工资"])
从列表创建时,每个子列表代表一行数据,需要通过 columns 参数指定列名。
2.3 数据查看与基本信息
拿到一个新数据集后,第一步通常是快速了解数据的全貌:
print(df.shape)       # (4, 4) —— 行数和列数
print(df.dtypes)      # 每列的数据类型
print(df.columns)     # 所有列名
print(df.index)       # 行索引信息

print(df.head(3))     # 查看前 3 行
print(df.tail(3))     # 查看后 3 行
print(df.describe())  # 数值列的统计摘要
describe() 是一个非常实用的方法,它会一次性输出数值列的计数、均值、标准差、最小值、四分位数和最大值,让你对数据的分布有一个快速的认知:
             年龄          工资
count   4.000000     4.000000
mean   29.500000  6500.000000
std     4.283173  1290.994449
min    25.000000  5000.000000
25%    27.250000  5750.000000
50%    29.500000  6500.000000
75%    31.250000  7250.000000
max    35.000000  8000.000000
2.4 数据获取
Pandas 提供了多种获取数据的方式,最常用的有三种:
直接用列名取列:
print(df["姓名"])          # 取一列,返回 Series
print(df[["姓名", "年龄"]]) # 取多列,返回 DataFrame
loc 按标签索引:
# 行标签为 0,列标签为"姓名"
print(df.loc[0, "姓名"])   # 张三

# 取多行多列
print(df.loc[[0, 1], ["姓名", "工资"]])
iloc 按位置索引:
# 第 0 行第 0 列
print(df.iloc[0, 0])      # 张三

# 前两行前两列
print(df.iloc[:2, :2])
简单来说,loc 用的是"名字"(索引标签和列名),iloc 用的是"位置"(从 0 开始的整数)。在实际使用中,loc 更常用也更安全,因为它不依赖于列的顺序。
2.5 条件筛选
数据分析中最常见的操作就是按条件筛选数据。Pandas 的条件筛选和 NumPy 的布尔索引思路一致,但表达能力更强:
# 单条件筛选
print(df[df["年龄"] > 28])

# 多条件筛选
print(df[(df["年龄"] > 28) & (df["工资"] >= 7000)])

# 使用 query 方法(更接近 SQL 语法)
print(df.query("年龄 > 28 and 工资 >= 7000"))
query 方法在条件复杂时特别好用,代码更简洁易读,而且执行效率通常也更高。
2.6 排序
排序也是日常分析中的高频操作:
# 按工资降序排序
print(df.sort_values("工资", ascending=False))

# 按多列排序:部门升序,工资降序
print(df.sort_values(["部门", "工资"], ascending=[True, False]))
多列排序时,会先按第一列排序,第一列相同的再按第二列排序,依此类推。
2.7 缺失值处理
真实世界的数据往往是"脏"的,缺失值无处不在。Pandas 提供了完整的缺失值处理方案:
检测缺失值:
print(df.isnull())    # 返回布尔 DataFrame,缺失为 True
print(df.notnull())   # 反之
删除缺失值:
df.dropna()           # 删除包含任何缺失值的行
df.dropna(how="all")  # 只删除全部为缺失值的行
df.dropna(subset=["A", "B"], how="all")  # 关注特定列
填充缺失值:
df.fillna(0)               # 用固定值填充
df.fillna(df.mean())       # 用均值填充
df.fillna(method="ffill")  # 用前一个值填充(前向填充)
删除还是填充,没有标准答案,取决于缺失值的比例和业务含义。如果缺失比例很低且随机,直接删除通常没问题;如果缺失有规律,或者比例较高,就需要考虑填充甚至特征工程了。
2.8 数据透视与分组聚合
数据分析的核心价值在于从不同维度洞察数据。groupby 和 pivot_table 是实现这一目标的利器。
groupby 分组:
# 按部门分组,计算工资总和
print(df.groupby("部门")["工资"].sum())

# 多维度分组,同时计算多个统计量
print(df.groupby(["部门", "城市"])["工资"].aggregate(["sum", "mean"]))
pivot_table 数据透视表:
# 基本透视表
print(df.pivot_table(index="部门", values="工资", aggfunc="sum"))

# 多维度 + 多指标
print(df.pivot_table(
    index=["部门", "城市"],
    values="工资",
    aggfunc=["sum", "mean"]
))
如果你熟悉 Excel 的数据透视表,对 pivot_table 一定会感到亲切。index 对应行标签,columns 对应列标签,values 对应值,aggfunc 对应汇总方式。掌握了分组和透视表,就掌握了数据分析的核心方法论。
三、Matplotlib:让数据开口说话
数据可视化是数据分析流程中不可或缺的一环。一图胜千言,好的图表能让数据中的规律和异常一目了然。Matplotlib 是 Python 中最基础也是最灵活的绘图库。
3.1 中文显示问题
使用 Matplotlib 时,第一个需要解决的就是中文显示问题。默认配置下,中文会显示为方框,需要手动设置字体:
import matplotlib.pyplot as plt

plt.rcParams["font.sans-serif"] = ["SimHei"]  # 设置中文字体
plt.rcParams["axes.unicode_minus"] = False    # 解决负号显示问题
这两行代码几乎是所有中文绘图的标配,建议放在绘图代码的最前面。
3.2 折线图入门
我们从最简单的折线图开始,感受 Matplotlib 的基本用法:
import numpy as np

arr1 = np.array([1, 2, 3, 4])
arr2 = [4, 5, 6, 6]

fig, ax = plt.subplots()
ax.plot(arr1, arr2)
ax.set(xlabel="横轴", ylabel="纵轴", title="测试折线图")
ax.grid()
plt.show()
这段代码展示了 Matplotlib 的标准绘图流程:创建画布和坐标轴 → 调用绘图方法 → 设置标签和标题 → 显示图表。这种"面向对象"的写法虽然比 plt.plot() 稍长,但代码结构更清晰,在绘制复杂图表时优势明显。
3.3 学习建议
Matplotlib 的功能非常强大,支持折线图、柱状图、散点图、饼图、热力图、箱线图等几十种图表类型,还可以自定义颜色、图例、标注、子图布局等。
但实话实说,对于初学者而言,不必一开始就深入钻研 Matplotlib 的所有细节。原因有三:
第一,Matplotlib 的 API 比较底层,要画出美观的图表需要大量的参数配置,学习曲线较陡。第二,现在有很多基于 Matplotlib 封装的高级库(如 Seaborn、Plotly),用更少的代码就能画出更好看的图。第三,AI 时代,完全可以借助 AI 工具快速生成图表代码,把精力放在理解数据和分析逻辑上。
我的建议是:掌握基本的绘图流程和核心概念,了解常见图表的适用场景,具体的代码细节在需要的时候查文档或问 AI 即可。数据分析的核心是"分析",而不是"画图"。
四、三剑客的协同作战
单独看每个库各有所长,但真正的威力在于它们的配合。一个典型的数据分析流程是这样的:
-
数据获取:用 Pandas 读取 CSV、Excel 或数据库中的数据
-
数据清洗:用 Pandas 处理缺失值、重复值、异常值
-
数值计算:必要时转换为 NumPy 数组进行高性能计算
-
数据聚合:用 Pandas 的 groupby 和透视表做多维分析
-
可视化呈现:用 Matplotlib(或 Seaborn)将结果可视化
举个简单的例子,假设我们有一份销售数据:
# 1. 读取数据(Pandas)
df = pd.read_csv("sales.csv")

# 2. 清洗数据(Pandas)
df = df.dropna(subset=["销售额"])

# 3. 计算同比增长率(NumPy 向量化运算)
df["同比增长率"] = (df["本年销售额"] - df["上年销售额"]) / df["上年销售额"] * 100

# 4. 按地区汇总(Pandas)
region_sales = df.groupby("地区")["销售额"].sum().sort_values(ascending=False)

# 5. 绘制柱状图(Matplotlib)
fig, ax = plt.subplots(figsize=(10, 6))
region_sales.plot(kind="bar", ax=ax)
ax.set_title("各地区销售额对比")
ax.set_ylabel("销售额(万元)")
plt.xticks(rotation=45)
plt.tight_layout()
plt.show()
在这个流程中,Pandas 承担了大部分工作,NumPy 在需要数值计算时提供支持,Matplotlib 负责最后的呈现。三者各司其职又无缝衔接,构成了 Python 数据分析的黄金组合。
五、学习路径与心得
聊完了技术本身,最后分享几点学习心得,希望能帮你少走一些弯路。
第一,动手实践远比看教程重要。 数据分析是一门实践性极强的技能,看十遍教程不如亲手写一遍代码。找一份感兴趣的数据集(Kaggle 上有很多),尝试用学到的方法去分析它,遇到问题再去查资料,这样的学习效率最高。
第二,理解原理比死记 API 更有价值。 NumPy、Pandas 的函数和参数非常多,没人能全部记住。重要的是理解核心概念——比如广播机制、axis 方向、分组聚合的逻辑。理解了原理,具体的函数名和参数随时可以查文档。
第三,善用 AI 工具,但不要依赖。 AI 时代,写代码的方式已经发生了很大变化。你可以用 AI 快速生成代码模板、解释报错信息、优化性能。但前提是你得能看懂代码、判断对错,否则 AI 生成的东西你也用不好。工具是放大器,不是替代品。
第四,从业务出发,而不是从技术出发。 数据分析的终极目的是解决业务问题。技术只是手段,理解业务背景、提出正确的问题、给出有价值的洞察,这些能力比掌握多少个函数重要得多。拿到数据后先别急着写代码,想一想:我要回答什么问题?数据能帮我吗?
最后
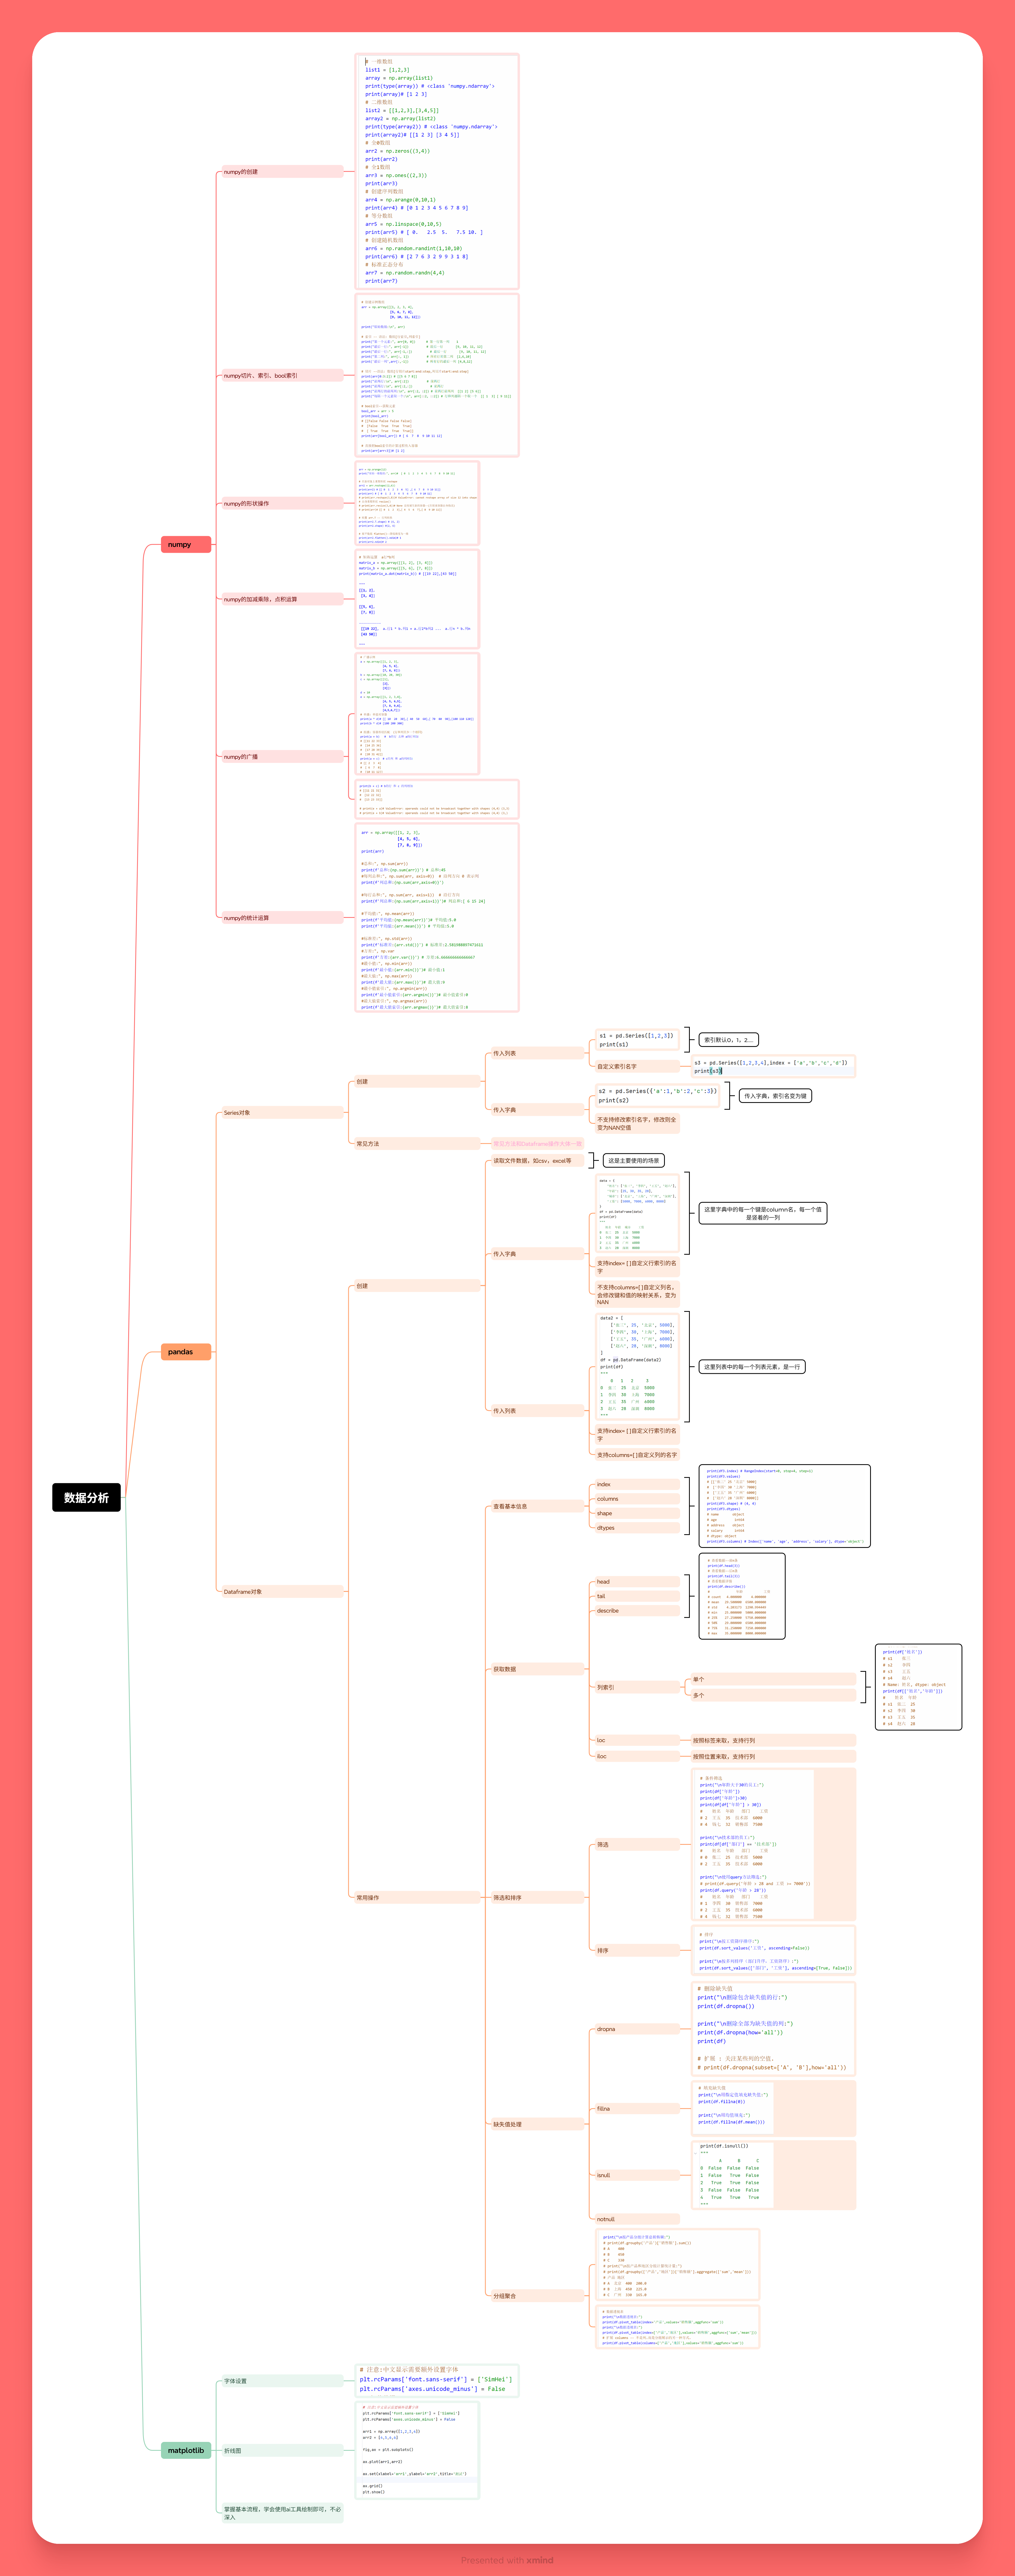
NumPy、Pandas、Matplotlib 这"三剑客",构成了 Python 数据分析的基础设施。NumPy 提供了高效的数值计算能力,Pandas 让结构化数据的处理变得简单优雅,Matplotlib 则让数据可视化成为可能。
当然,数据分析的世界远不止这些。数据获取、特征工程、机器学习、数据挖掘……每一个方向都有广阔的天地。但打好基础永远是第一步。把这三个库的核心用法吃透,你就拥有了进一步探索的底气。
希望这篇文章能为你的数据分析学习之路提供一份清晰的地图。路漫漫其修远兮,吾将上下而求索。与君共勉。
如果你觉得这篇文章对你有帮助,欢迎点赞收藏,也欢迎在评论区交流你的学习心得。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/wiwiwiwiooo/article/details/165006635

