

参考:https://github.com/steineggerlab/foldseek-interface-analysis
算法本身在 Foldseek 主程序
foldseek参考:https://github.com/steineggerlab/foldseek
核心方法概述
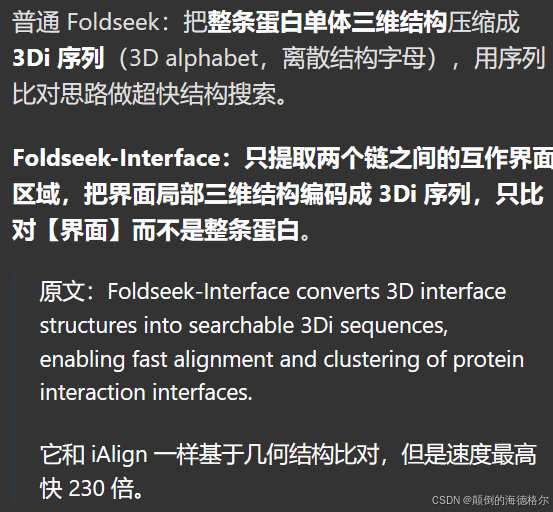
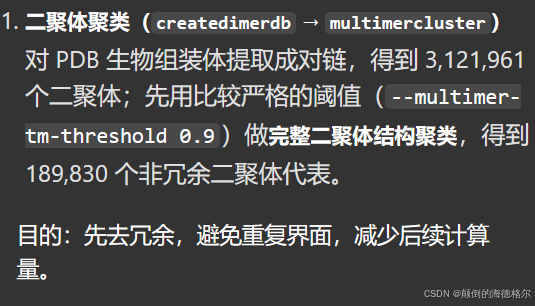
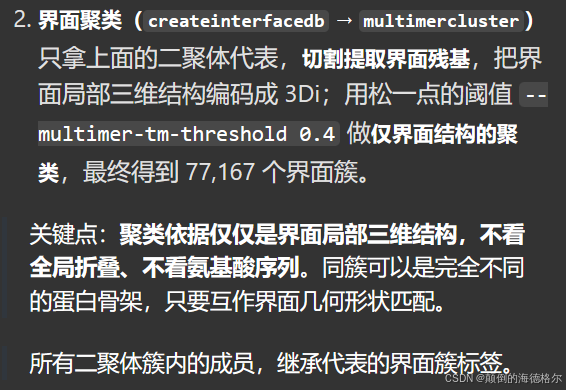
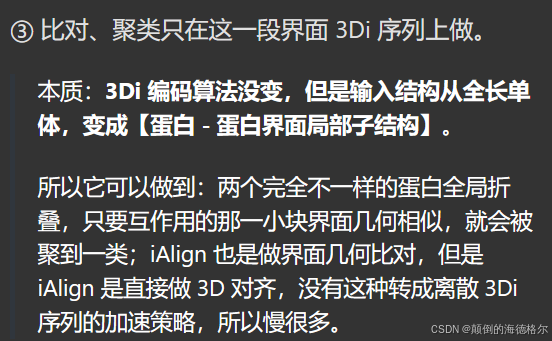
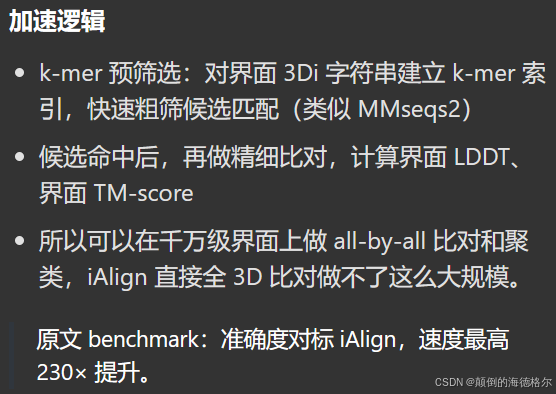
Foldseek-Interface 把蛋白三维相互作用界面转成可检索的3Di序列,实现蛋白界面快速比对与聚类:精度对标 iAlign,但速度最高快230倍。作者对PDB全部生物组装体做聚类:312万二聚体 → 189k非冗余二聚体代表 → 77167个蛋白界面簇,是首个仅依据界面三维结构聚类的实验蛋白界面数据集。整套计算耗时约6天。
配套开放资源:网页检索服务器、界面簇浏览器、Zenodo数据集、预印本。
跑基准测试、处理 PDB 组装体、调用 Foldseek 接口模块做二聚体 + 界面聚类、后注释
仓库目录分工
- scripts/:SLURM调度脚本,跑Foldseek、iAlign、MMseqs2,负责建库、聚类、NMR处理、物种溯源等批量任务。
- benchmarking/:构建基准数据集、评估精度,生成图1与配套附表。
- 自建两类基准:有序-有序结构域互作DDI、无序-有序短基序互作DMI;
- 批量全比对:Foldseek-Interface 和 iAlign 做对照;扫描LDDT/TM-score阈值;用AUC、调整兰德指数ARI评估聚类效果。
- annotations/:批量从外部数据库抓取注释,合并到界面簇表格:无序区域、二级结构、Pfam、CATH、GO、UniProt映射、物种、PDB提交时间等。
- analysis/:下游科学分析,生成图2–4及补充图表:
- 界面二级结构统计、方差分析;
- 结构/功能多样性:部分簇包含多套CATH结构域配对;
- 病原体模拟互作:筛选同时含人-人、人-病原体界面的候选簇;
- HumanPPI(AlphaFold/RoseTTAFold2预测复合物)聚类,找到1780个没有PDB已知匹配、推测全新的蛋白界面;
- ColabFold/AlphaFold-Multimer预测评估,DockQ打分;
- ChimeraX可视化脚本。
核心Pipeline(4大阶段)
- Benchmark基准测试:构建DDI、DMI两套真值数据集,调参、对比iAlign,确定最优阈值(界面multimercluster用
--multimer-tm-threshold 0.4)。 - PDB大规模聚类(两步聚类)
- 第一步:二聚体水平聚类,严格阈值,得到189,830非冗余二聚体代表;
- 第二步:提取界面、在界面层面聚类,得到77167界面簇;
- 额外处理NMR多构象模型,检验聚类稳定性。
- 注释整合:把结构、无序、二级结构、Pfam、CATH、GO、物种等信息全部合并到界面簇表。
- 下游分析:统计、多样性分析、病原体模拟、HumanPPI新界面挖掘、AlphaFold预测验证、可视化。
软件依赖清单
- Foldseek(带界面模块:createdimerdb / createinterfacedb / multimercluster)
- MMseqs2,iAlign(基准对照),ColabFold
- Python:pandas、scipy、sklearn、statsmodels、biopython、gemmi等
- R:clusterProfiler、ggplot2(GO富集)
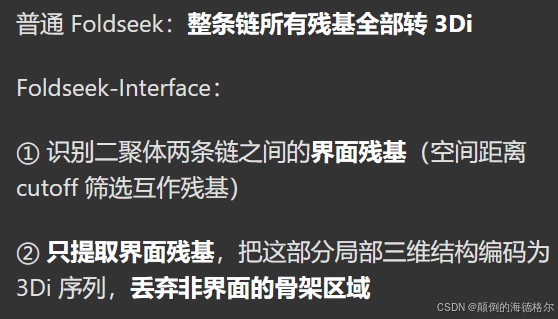
Foldseek-inference 思路
二阶段聚类:先二聚体聚类,再界面聚类
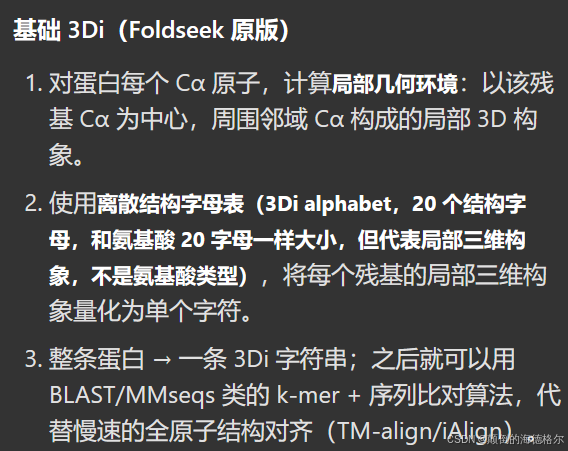
3Di 序列转换的算法原理
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_62528784/article/details/165089273

