

记录牧安平台从 0 到 1 的开发过程,一个待业在家的网安老兵边做边想。
这一期说点丢人的事情——不是平台挂,是自己把生产库删了。
2026-08-31,在云盒上用 WinSCP 维护华为云的 L2环境(线上demo),手一滑在 /opt/Shepherd_l2 目录下误删了几个文件,然后就爽了。
「区域配置信息都丢了」
「agent 注册信息也没了」
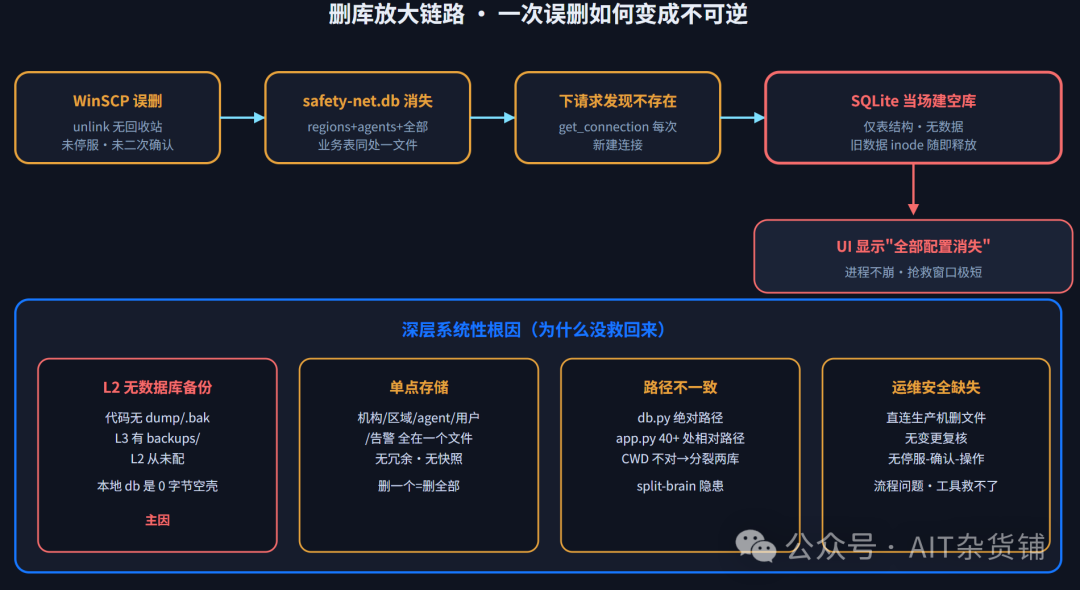
一查代码,根因很钝:区域(regions 表)和 agent 注册(agents 表)都在同一个 safety-net.db 里。丢了这个 SQLite 文件,进程下一个请求发现路径没了,当场给你重建一个空库——所以 UI 表现为"全部配置凭空消失",但服务不崩、进程还活着。
这一期把这次事故从头到尾捋一遍:怎么没的、为什么没救回来、我又怎么把同类事故系统性堵死。做 MSS 的人自己把客户平台的配置库删了还没备份,这事我必须写下来,事故是因,改进才是果。
一、事故概述:一次误删,放大成不可逆
本质就一句话:safety-net.db 单文件被删,库内全部业务数据清空。
|
数据类别 |
存储表 |
是否受影响 |
|---|---|---|
|
机构信息 | customers |
是(同文件,推断一并清空) |
|
区域信息 | regions | 是(用户已确认) |
|
agent 注册信息 | agents | 是(已确认),含 agent_token/agent_token_secret 等凭据 |
|
用户/告警/扫描 | users
/ |
是(同文件) |
代码没坏,丢的是数据。云上数据恢复很繁琐——估计我是搞不定了。
所以这篇的重点是根因复盘 + 防再发,不是数据找回。
二、为什么删完"全空"且难救
这里有个机制上的坑,值得所有用 SQLite 的人注意。(版本功能定完了会改成对接其它数据库)
放大原因 1 · 连接机制把损失坐实了。db.get_connection()(db.py:40)每次请求都 sqlite3.connect(DB_FILE) 新建连接。文件被 rm 后,下一个请求发现路径不存在 → SQLite 当场新建一个空的 safety-net.db(只有表结构、没数据)。UI 显示"全空",但进程不崩;旧数据的 inode 在连接关闭后立刻释放,能抢救的窗口极短。
放大原因 2 · 无进程内存兜底。 核心配置不在进程内存常驻,删文件即意味着数据没法经 /proc/<pid>/fd 长期存活恢复。
合起来:误删 → 空库顶上 → UI 全空 → 旧数据瞬间释放。等我发现,已经没救了。
深层是系统性缺陷:
三、已落地的改进:把"同类事故"系统性堵死
先说方案:
当机构、区域、agent注册、日志外发等信息在web填写之后 落库的同时 也落到后台的一个文件中(要加密存储)当数据库文件损坏 可以在后台手动导这个文件进去恢复这些信息
再往下的内容让硅基自己看吧,碳基看起来有点费脑子。
3.1 核心配置加密备份 Vault(防再发主方案)
- •新增
vault.py:AES-256-GCM 加密;密钥优先级
SHEPHERD_VAULT_KEY环境变量 → 兜底backup_vault/vault.key(0600,首次自动生成);原子写(临时文件→fsync→os.replace)。 - •新增
restore_vault.py:CLI(
--mode upsert|replace)+ 可复用的do_restore()。解密 → 按原主键 upsert 回customers/regions/agents/user_customers→ 修正sqlite_sequence→ 还原日志外发配置。 - •落库即快照
:
create/update/delete_customer、create/update/delete_region六个函数 commit 后自动snapshot_vault();agent 注册/状态/删除 handler、日志外发配置落盘处同步触发;并加 5 分钟定时快照线程兜底防漏钩。 - •手动恢复入口
:CLI
python3 restore_vault.py;管理端点POST /api/admin/vault/restore(admin 鉴权 + 审计)。 - •失败不阻断主业务
:vault 快照/初始化任何异常均静默告警,绝不抛入业务请求。
3.2 顺手根治了路径不一致
Shepherd_l2_app.py 40+ 处 sqlite3.connect('safety-net.db') 全部统一为 sqlite3.connect(db.DB_FILE),split-brain 隐患消除。
3.3 验证结果(独立临时目录,未污染真实库)
|
验证项 |
结果 |
|---|---|
|
写入机构/区域/agent/日志外发 → 快照生成且可独立解密,四类齐全 |
✅ |
|
模拟 |
✅ |
|
篡改 vault 任一字节 → 恢复报 |
✅ |
|
四个改动文件 |
✅ |
四、三层防护,删库也不怕了
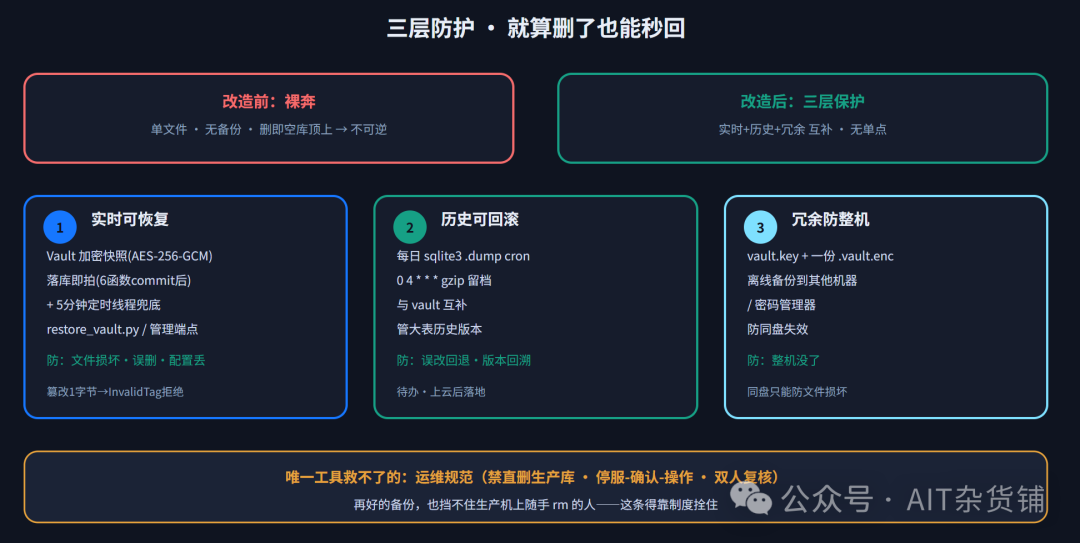
这次改造的目标不是"别误删"(那是流程的事),而是"就算删了,也能秒回"。最终形成三层保护:
|
层 |
手段 |
防什么 |
|---|---|---|
|
实时可恢复 |
Vault 加密快照,落库即拍(含 5 分钟兜底线程) |
文件损坏、误删、配置丢失 |
|
历史可回滚 |
待补的每日 |
大表历史版本、误改回退 |
|
冗余防整机 |
密钥 + 一份 |
整机没了(同盘只能防文件损坏) |
Vault 管敏感配置实时可恢复,cron 管大表历史回滚,离线密钥管整机丢失——三道互补,没有单点了。
五、还得人工兜底的:运维规范
改进里有一项工具救不了,只能靠制度:
- 禁止 WinSCP / 直连生产机删除文件;
- 变更前"停服 → 确认 → 操作 → 校验";
- 引入变更复核(双人)。
删文件前没停服、没二次确认,这是流程问题。再好的备份,也挡不住一个在生产机上随手 rm 的人。这条得靠规矩拴住。
其余待办:上云部署(sftp 推 vault 相关文件 + pip install cryptography + 重启自动生成密钥并开始快照)、每日 dump cron、密钥离线备份、上云后做一次 rm → restore 恢复演练。
六、说句实话
根因链条很清楚:无备份(主因)叠加"每次请求新建连接、删库即空库顶上"的机制,把一次可恢复的误删,放大成了不可逆的丢失。
给自己这次的改进打个及格:数据虽放弃找回,同类事故已经被系统性堵住——落库即加密快照 + 手动恢复 + 路径统一 + 待补的每日 dump,三层保护成型。唯一还得靠人兜底的,是运维那点规矩。
转载自 CSDN-专业IT技术社区

