

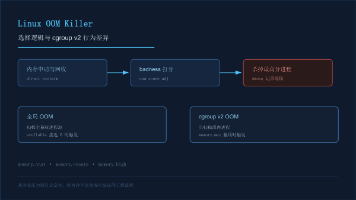
Linux 内存不足时 OOM Killer 的选择逻辑与 cgroup 限制下的行为差异
1. 从一次线上被杀事件说起
先看一个很常见的场景。某台 8 核 16GB 的服务器上跑着一个 Java 服务和一个日志处理进程。凌晨两点,告警系统发出“服务不可用”,登录机器一看,Java 进程不见了,dmesg 里有一行 Out of memory: Killed process 12345 (java)。运维第一反应往往是“内存泄漏了”,于是加内存、重启,问题暂时消失,但几天后又出现。
这里真正需要回答的是三个问题:内存到底被谁用完了?内核在什么时刻决定要杀进程?为什么被杀的是 Java,而不是旁边那个看起来更占内存的日志进程?如果这台机器上还开启了 cgroup v2 限制,比如给服务设置了 memory.max,那这次的凶案现场会完全不同:进程可能不是被全局 OOM Killer 杀的,而是被 cgroup 级别的 OOM 处理杀的,日志位置、可见性、可干预手段都不一样。
大部分讲 OOM 的资料一上来就抛出 oom_score、badness、memory cgroup 这些名词,读者记不住,也不清楚它们之间谁先谁后。这篇文章反过来:先给一个能复述的整体流程,再用具体的分数计算、内存统计和日志字段把它填满。读完你应当能独立完成一次 OOM 定位,并知道全局 OOM 与 cgroup OOM 在选人逻辑上的关键差别。
2. 一句话模型与全局框架
先用一句话概括:内存分配先尝试回收,回收不动才触发 OOM;触发后内核给每个候选进程算一个“可杀分数”,分数最高的被杀;而在 cgroup v2 里,这个流程被压缩到某个控制组内部,先杀组内、不一定杀全局最优。
把整体过程拆成四个角色和一条主链路:
- 申请者:发起
malloc、mmap、page fault 的进程或内核路径,它只是要内存,不关心后果。 - 回收者:内核的页回收逻辑,先丢可丢弃的页缓存,再写回脏页,必要时换出匿名页到 swap。
- 上限:全局物理内存加 swap 构成系统总上限;cgroup v2 的
memory.max构成某个控制组的上限。 - 裁决者:OOM Killer,在回收失败后按打分选择牺牲者。
一次内存申请完整的走向可以画成下面这样:
进程申请内存
   |
   v
有空闲页? --是--> 直接分配,结束
   |否
   v
触发直接回收 (direct reclaim)
   |
   +--> 能回收出足够页? --是--> 分配成功,进程短暂卡顿
   |
   +--> 回收失败 / 回收代价过高
            |
            v
      判断超限的是全局还是 cgroup
            |
      +-----+----------------------+
      |                            |
      v                            v
  全局 OOM                     cgroup v2 OOM
  扫描全系统进程               只扫描该 cgroup 内进程
  按 badness 打分              按组内 badness 打分
  杀分最高者                   杀分最高者,可能带上子组
这张图里最容易被忽略的是“回收失败”这一步。很多人的直觉是“内存用到 100% 就杀进程”,实际内核会先拼命回收,包括丢掉文件页缓存、压缩内存、换出到 swap。只有当回收也救不回来,或者回收本身已经让系统失去响应,OOM Killer 才会出手。所以看到 OOM 日志之前,通常已经经历了一段明显的卡顿和 swap 压力。
3. 内存是怎么一步步被“逼到墙角”的
3.1 物理内存的几块账
理解 OOM 前要先知道内存都花在哪。用 free -h 看最直观:
$ free -h
              total        used        free      shared  buff/cache   available
Mem:           15Gi       9.6Gi       412Mi       380Mi       5.8Gi       5.1Gi
Swap:         2.0Gi       1.7Gi       300Mi
这块输出里,used 高不一定是坏事,buff/cache 是可以被回收的文件缓存。真正决定“还有多少余量”的是 available。当 available 接近 0,Swap 又被用得差不多,系统就进入了回收压力很大、随时可能 OOM 的状态。
需要分清三种内存,它们的回收难度依次上升:
| 内存类型 | 典型来源 | 是否容易回收 | 回收代价 |
|---|---|---|---|
| 文件页缓存 | 读写文件、程序二进制 | 容易 | 低,直接丢弃或延迟写回 |
| 匿名页 | 进程堆、栈、malloc 的内存 | 困难 | 高,必须有 swap 才能换出 |
| 内核内存 | slab、页表、网络缓冲 | 视类型而定 | 部分不可回收 |
OOM 往往发生在匿名页过多、swap 又不足的场景。文件缓存再多,内核也能丢掉;匿名页没有 swap 就只能一直占着,直到把系统推过临界点。
3.2 回收压力从哪里看
/proc/vmstat 里有几个直接反映回收痛苦的计数器:
$ grep -E 'pgscan|pgsteal|allocstall|pswpout|pswpin' /proc/vmstat
pgpgin            48213
pswpin             1842
pswpout           92017
pgscan_direct    210934
pgsteal_direct   198233
allocstall       12041
逐项读法如下。pgscan_direct 是进程自己被迫进入直接回收时扫描的页数,数值持续增长说明分配路径频繁被阻塞。pgsteal_direct 是从中成功回收的页数。allocstall 表示分配因为回收而停顿的次数,这个值明显上涨基本等于“系统已经在挨打了”。pswpout 是换出到 swap 的页数,匿名页换出伴随磁盘 I/O,会让延迟进一步恶化。
当 allocstall 高、pswpout 高、available 低同时出现,即使还没有 OOM 日志,也应该主动介入,而不是等它自己杀进程。
3.3 swap 到底帮不帮忙
swap 的作用是给匿名页一个临时去处,从而延长系统存活时间。但它不是免费内存,换出换入都要走磁盘。对延迟敏感的在线服务,大量 swap 换入换出往往比直接 OOM 更难受:请求延迟从几毫秒涨到几百毫秒,还可能触发超时雪崩。
这里有一个重要取舍:
- 完全不配 swap:匿名页无法换出,回收手段变少,OOM 来得更快更干脆,但延迟相对稳定。
- 配少量 swap:能吸收突发内存尖峰,给运维争取响应时间;但换出量大时数据库、JVM 这类进程延迟会明显抖动。
常见的生产做法是给系统盘配 1 到 2 倍内存的 swap 只用于应急,或者干脆关闭 swap 并把内存限制交给 cgroup 精确控制。
4. OOM 打分:内核怎么挑人
4.1 badness 分数的组成
OOM Killer 不是随机杀,也不是简单杀“最大”的,而是给每个进程算一个分数,再乘上调整系数。简化后的逻辑是:进程占用内存越多,分数越高;oom_score_adj 可以人为加减分。核心公式可以近似理解为:
badness 与 进程占用的内存规模 正相关
最终分数 = f(badness) + oom_score_adj 的影响
进程内存占比越大、oom_score_adj 越高,越容易被杀
实际查看当前进程分数,可以读 /proc/<pid>/oom_score:
$ cat /proc/$(pgrep -f 'java.*app.jar' | head -1)/oom_score
834
这个数字是内核当前算出来的打分,范围大致在 0 到 1000。数字越大越危险。旁边还有 /proc/<pid>/oom_score_adj,范围是 -1000 到 1000,用来在分数基础上做人工偏移。
4.2 oom_score_adj 的方向容易搞反
oom_score_adj 的语义是“在最终分数上叠加多少”。因此:
- 设为正数,提高被杀概率,比如把可牺牲的批处理任务设为 500。
- 设为负数,降低被杀概率,比如把数据库主进程设为 -800。
- 设为 -1000,等价于“尽量不杀”,但不是绝对豁免,系统完全无路可走时仍可能被杀。
可以用下面这个完整示例验证效果。目标是在一台测试机上创建一个持续吃内存的进程,并对比调整 oom_score_adj 前后的分数。前置条件是有一台允许 OOM 的测试机,至少 4GB 内存,并且你有 root 权限。
# 示例一:观察 oom_score 与 oom_score_adj 的关系
# 创建一个持续申请匿名内存的进程
python3 -c "
import time
buf = []
for i in range(200000):
    buf.append(bytearray(1024 * 1024))
    time.sleep(0.05)
" &
PID=$!

# 查看默认分数
cat /proc/$PID/oom_score
cat /proc/$PID/oom_score_adj
关键步骤说明:进程占用内存增长后,oom_score 会随着它在系统内存中的占比上升而变大;oom_score_adj 默认是 0。接下来做一次调整,把它变成“优先被杀”:
echo 800 > /proc/$PID/oom_score_adj
cat /proc/$PID/oom_score
cat /proc/$PID/oom_score_adj
预期结果:oom_score_adj 变为 800,oom_score 明显抬高。如果再把 oom_score_adj 设为 -800,分数应显著下降。容易改错的地方是权限:非 root 进程只能把自己的 oom_score_adj 往高调、往低调的幅度也有限制,跨进程修改通常需要 root。
需要特别区分两个东西:oom_score 是只读的打分结果,oom_score_adj 是你可以写的调整量。很多人误以为改 oom_score 就能改变命运,实际上改的是后者。
4.3 systemd 场景下怎么设
直接写 /proc 只在进程存活期间有效,重启就没了。生产上更推荐用 systemd 单元固定下来。下面是一个完整的服务单元示例,目标是把核心接口服务保护起来,把可牺牲的离线任务标成优先被杀。
# /etc/systemd/system/order-api.service
[Unit]
Description=Order API Service
After=network.target

[Service]
Type=simple
User=appuser
ExecStart=/usr/bin/java -Xmx2g -jar /opt/app/order-api.jar
Restart=on-failure
RestartSec=3
# 降低被杀概率,最小值 -1000
OOMScoreAdjust=-700
LimitNOFILE=65535

[Install]
WantedBy=multi-user.target
对应地,给离线报表任务写一个相反倾向的单元:
# /etc/systemd/system/report-batch.service
[Service]
Type=oneshot
ExecStart=/opt/app/report.sh
# 提高被杀概率,允许被优先牺牲
OOMScoreAdjust=600
执行 systemctl daemon-reload 后重启服务,systemctl show order-api -p OOMScoreAdjust 可以确认值已经生效。这个配置的工程价值在于:把“谁更重要”这件事从事故现场的临时判断,变成部署阶段就固化的策略。适用场景是多服务混部;边界是它只影响被打分的偏移,不能阻止真正无路可走时的全局 OOM。
5. cgroup v2 下 OOM 的边界被改了
5.1 从全局到局部的关键切换
在没有 cgroup 限制的机器上,OOM Killer 面对的是全系统进程池。而在 cgroup v2 里,每个控制组可以有独立的 memory.max。当某个组的匿名内存加文件内存触到 memory.max,内核会优先在这个组内回收、组内 OOM,而不是直接拉全局进程下水。
这意味着两件事变了。第一,被杀进程通常属于“触限的那个组”,全局上可能还有很多空闲内存。第二,如果组内没有可杀的进程,或者组本身设了 memory.oom.group,行为可能升级为杀掉整组。
把这两种路径并排看:
全局 OOM 路径
  系统 available 接近 0
      |
      v
  扫描所有进程 -> 计算 badness -> 杀全局最高分

cgroup v2 OOM 路径
  某个 cgroup 用量触及 memory.max
      |
      v
  先在该组内回收
      |
      v
  回收失败则扫描该组内进程 -> 杀组内最高分
      |
      v
  若设置 memory.oom.group=1,则整组一起杀
对多租户或容器化环境,这带来的直接好处是故障隔离:一个失控的容器不会立刻拖垮整台宿主机。但坏处也明显:某个容器反复被 cgroup OOM,宿主机监控若只看全局内存,会完全发现不了。
5.2 memory.max 的读写法
cgroup v2 统一挂载在 /sys/fs/cgroup 下。下面这段命令展示一个完整流程:创建控制组、设置上限、观察 OOM 行为。前置环境是已启用 cgroup v2 的 Linux(可用 mount | grep cgroup2 确认),需要 root。
# 示例二:用 cgroup v2 限制一个进程的内存
# 确认是 cgroup v2
mount | grep cgroup2

# 创建控制组
mkdir -p /sys/fs/cgroup/demo

# 设置内存上限 200MB
echo 200M > /sys/fs/cgroup/demo/memory.max

# 允许 swap 与内存合计 0,即不允许用 swap(按需调整)
echo 0 > /sys/fs/cgroup/demo/memory.swap.max

# 把当前 shell 放进该组
echo $$ > /sys/fs/cgroup/demo/cgroup.procs

# 在该组内启动一个吃内存的进程
python3 -c "
buf = []
for i in range(1000):
    buf.append(bytearray(1024 * 1024))
" &
关键步骤说明:写 cgroup.procs 会把整个 shell 及其后续子进程迁入该组,因此后续启动的 Python 会受 200MB 限制。预期结果是进程在内存逼近上限后被组内 OOM 杀掉,而不是拖垮整机。容易改错的地方有两处:一是 memory.max 的值要写清楚单位,200M 和 200 含义完全不同;二是如果把当前 shell 放进去,注意别把关键操作也一起限制进去。
想恢复时,把进程移回根组即可:
echo $$ > /sys/fs/cgroup/cgroup.procs
rmdir /sys/fs/cgroup/demo
5.3 常用控制项对照
cgroup v2 的 memory 控制器项比较多,关键几个如下:
| 文件 | 作用 | 工程上的典型用法 |
|---|---|---|
| memory.max | 硬上限,超过触发回收/ OOM | 容器内存限额、服务隔离 |
| memory.high | 软上限,超过只限速不强杀 | 先限速削峰,避免直接 OOM |
| memory.current | 当前用量 | 监控面板核心指标 |
| memory.stat | 分类统计明细 | 定位是匿名页还是文件页占多 |
| memory.swap.max | 该组可用 swap 上限 | 决定匿名页能否换出 |
| memory.oom.group | 是否整组同杀 | 强绑定进程组的原子性需求 |
设计取舍在于:memory.max 简单直接但容易一刀切;memory.high 更温和,先让进程变慢而不是直接死,适合在线服务削峰。生产上常见组合是两者都设,memory.high 略低于 memory.max,给回收留出反应时间。
6. memory.stat 怎么读
6.1 核心字段含义
要判断一个 cgroup 为什么到上限,直接看 memory.stat。它不是“当前用了多少”那么简单,而是告诉你钱花在哪一类内存上。下面抽取关键字段:
$ cat /sys/fs/cgroup/demo/memory.stat
anon 178257920
file 10485760
kernel 33554432
slab 18874368
sock 4096
file_dirty 0
pgscan 18234
pgsteal 15120
pgmajfault 4211
读法要点:anon 是匿名页,通常是进程堆栈,增长快且难回收;file 是文件页缓存,可回收;kernel 和 slab 是内核占用;pgscan/pgsteal 反映该组内回收扫描和成功回收的页数,持续增长说明组内一直在做回收。
下面这张表把“现象”和“该看哪个字段”对应起来:
| 现象 | 优先看的字段 | 说明 |
|---|---|---|
| 内存缓慢上涨不降 | anon 持续增长 | 可能是应用层泄漏 |
| 大量读写文件后内存高 | file 占比大 | 通常是缓存,可回收 |
| 回收频繁但降不下来 | pgscan 高而 pgsteal 低 | 匿名页多,回收效率差 |
| 缺页中断高伴随延迟 | pgmajfault 增长 | 可能在反复换入匿名页 |
6.2 用 memory.stat 区分两类“内存高”
看一个实际判断过程。某服务 memory.current 长期贴着 memory.max,运维怀疑泄漏。第一步对比 anon 和 file:如果 file 占大头,多半是缓存,问题不大;如果 anon 占大头且只涨不降,才更可能是真正的常驻增长。
第二步看 pgscan 和 pgsteal。若 pgscan 很大但 pgsteal 很小,说明内核一直在努力回收却收效甚微,典型的匿名页过多、swap 不足。此时即使还没 OOM,服务延迟也已经被拖坏了。
第三步看 pgmajfault。这个值持续增长意味着进程在反复触发需要磁盘 I/O 的缺页,往往和 swap 换入相关。把它和宿主机的 pswpin 一起看,就能判断 swap 压力是否已经传导到业务。
7. 完整走一遍:从申请到被杀
现在把前面所有零件串起来,模拟一个完整生命周期。假设宿主机 16GB,某 cgroup 限额 1GB,服务在组内运行。
时间线
T0  服务常驻 anon=200MB,运行平稳
T1  突发请求涌入,anon 涨到 900MB,接近 memory.max=1GB
T2  继续分配 -> 组内直接回收 -> pgscan 上升,pgsteal 有限
T3  memory.current 触顶,组内回收失败
T4  cgroup v2 OOM 触发,扫描组内进程
T5  计算组内 badness,叠加各自 oom_score_adj
T6  杀掉组内最高分进程,dmesg 与 cgroup 事件记录
T7  若 memory.oom.group=1,整组进程一起被杀
每一步对应可观测信号如下:T2 阶段可以在 memory.stat 看到 pgscan 增长;T3 阶段 memory.current 贴近 memory.max;T4 之后 dmesg 出现 Memory cgroup out of memory;T6 之后 /sys/fs/cgroup/<组>/memory.events 里的 oom 计数加一。
这就是为什么排障时不能只看一个数字。只看 memory.current 会错过回收压力,只看 dmesg 会错过前期征兆,只有把时序拉出来才能判断是“突发尖峰”还是“持续泄漏”。
8. OOM 日志定位:谁动的手,为什么是它
8.1 全局 OOM 日志
全局 OOM 的现场在 dmesg 或 /var/log/messages(不同发行版位置不同)。典型片段如下:
Out of memory: Killed process 12345 (java) total-vm:8451234kB, anon-rss:6543210kB, file-rss:1024kB, shmem-rss:0kB
读这段日志要抓四个信息:进程号和名字、总虚拟内存、匿名 RSS、文件 RSS。这里 anon-rss 远大于 file-rss,说明它是靠匿名内存占满系统的,和前面“匿名页难回收”的判断一致。
在杀进程之前,内核通常会打印一段 Tasks state,列出各进程的 pid、oom_score_adj、total_vm、rss,并标记其中一个为 [pid] *,星号就是被选中的那个。把这份清单和进程的实际用途对照,就能解释“为什么杀它”。
8.2 cgroup OOM 日志
cgroup v2 的日志措辞不同,通常会带组路径:
Memory cgroup out of memory: Killed process 23456 (python3) total-vm:1200000kB, anon-rss:1024000kB
看到 Memory cgroup out of memory 就要立刻明白:这是组内限额触发的,跟宿主机整体内存没关系。定位时把组路径找出来,去对应目录读 memory.events 和 memory.stat:
$ cat /sys/fs/cgroup/demo/memory.events
low 0
high 12
max 40
oom 3
oom_kill 3
max 表示触及硬上限的次数,oom 表示触发 OOM 的次数,oom_kill 表示真的杀了进程的次数。如果 max 一直在涨但 oom_kill 不涨,说明 memory.high 在起作用,进程被限速但还没死;如果 oom_kill 也在涨,那就是反复被杀,必须处理根因而不是简单重启。
8.3 一个可复现的定位实例
下面这个完整示例把 cgroup OOM 和日志、事件文件串起来。前置环境是 cgroup v2 测试机、root 权限、Python3。
# 示例三:制造一次 cgroup OOM 并完成定位
mkdir -p /sys/fs/cgroup/oomdemo
echo 150M > /sys/fs/cgroup/oomdemo/memory.max
echo 0 > /sys/fs/cgroup/oomdemo/memory.swap.max
echo $$ > /sys/fs/cgroup/oomdemo/cgroup.procs

# 申请超过上限的内存
python3 -c "
buf = []
for i in range(400):
    buf.append(bytearray(1024 * 1024))
print('allocated', len(buf))
"

echo "--- events ---"
cat /sys/fs/cgroup/oomdemo/memory.events
echo "--- stat ---"
cat /sys/fs/cgroup/oomdemo/memory.stat
echo "--- dmesg ---"
dmesg | tail -20
执行后分三步定位。第一步看命令是否被信号杀死,通常在申请到 150MB 左右就终止。第二步看 memory.events,oom_kill 至少为 1,证明组内 OOM 确实发生。第三步看 dmesg,找到 Memory cgroup out of memory 那几行,对照被杀的 python3。边界与注意点:memory.swap.max=0 会让回收手段更少、更早触发 OOM;生产上不应随意设 0,否则瞬时尖峰没有缓冲。
9. 常见误区
误区一:内存用到 100% 就一定会 OOM。 实际上文件页缓存可以被回收,free 里的 used 高很多时候只是缓存。真正危险的是 available 接近 0 且匿名页多、swap 不足。
误区二:oom_score_adj=-1000 表示绝对不会被杀。 它只是把偏移拉到最低,在极端全局 OOM 下仍可能被杀。它是优先级,不是豁免权。
误区三:cgroup OOM 就是全局 OOM。 两者触发条件、扫描范围、日志关键词都不同。cgroup OOM 发生时宿主机可能还有大量空闲内存,只看全局指标会漏判。
误区四:改大 memory.max 就能解决问题。 如果根因是泄漏,放宽上限只是把爆炸时间推后,还会让组内其他进程一起受害。先看 memory.stat 里 anon 是否持续增长。
误区五:加了 swap 就不会 OOM。 swap 只是延长存活时间,大量换出换入会严重拖慢延迟,在线服务可能先被超时打垮。
10. 生产实践建议
在部署阶段就固化优先级:核心服务用 OOMScoreAdjust 设置为负值降低被杀概率;离线任务、可重跑任务设为正值优先牺牲。systemd 单元比运行时改 /proc 更可靠。
容器化环境下,优先用 cgroup v2 的 memory.max 做硬隔离,并用 memory.high 做软限速。两者配合可以在真正 OOM 之前让进程先变慢,给流量调度争取时间。
监控层面至少采集四类指标:memory.current 与 memory.max 的比值、memory.stat 里的 anon、memory.events 里的 oom_kill 增长速率、宿主机 allocstall 与 pswpout。只盯全局内存使用率是发现不了 cgroup 局部故障的。
对延迟敏感的服务,swap 策略要明确:要么关掉并接受更快更干脆的 OOM,要么保留少量应急 swap 但设好 memory.swap.max,避免匿名页被大规模换出。
最后,OOM 不是根因,是结果。每次 OOM 后都应该回答“是哪类内存涨上去的、涨了多久、有没有回收压力”,再决定是调参、扩内存还是修代码。
11. 排障清单
| 步骤 | 目的 | 关键命令或文件 | 判断标准 |
|---|---|---|---|
| 1 | 确认内存整体状态 | free -h | available 是否接近 0 |
| 2 | 看回收压力 | grep allocstall /proc/vmstat | 是否持续增长 |
| 3 | 看 swap 压力 | grep pswpout /proc/vmstat | 换出是否频繁 |
| 4 | 看是否 cgroup OOM | dmesg 搜 Memory cgroup | 有则聚焦对应组 |
| 5 | 看组内分类用量 | memory.stat | anon 是否持续增长 |
| 6 | 看组内事件计数 | memory.events | oom_kill 是否在涨 |
| 7 | 看候选优先级 | /proc/<pid>/oom_score_adj | 是否设置了合理偏移 |
| 8 | 复盘根因 | 应用日志加内存曲线 | 是泄漏还是突发尖峰 |
使用顺序建议从 1 到 5 快速扫一遍,先分清“全局还是 cgroup”,再决定深挖方向。顺序反了容易在错误的方向上花时间。
12. 面试/复盘问题
- 为什么内核不在内存用满的第一时间就杀进程,而是先做回收?
oom_score和oom_score_adj分别是什么,哪个可写?- 全局 OOM 与 cgroup v2 OOM 的扫描范围有什么本质区别?
memory.high和memory.max的行为差异是什么,生产中怎么组合使用?memory.stat里anon和file都很大时,如何判断哪个更危险?pgscan很高但pgsteal很低说明什么问题?- 为什么给服务设置
oom_score_adj=-1000仍不能保证绝对安全?
这些问题能答清楚,基本就掌握了从触发条件到选择逻辑再到定位方法的整条链路。
13. 总结
把全文收成一张决策图:
发现服务异常退出
   |
   v
查 dmesg 是否有 OOM 记录
   |
   +-- 无 --> 不是 OOM,转向其他方向
   |
   +-- 有 --> 看关键词
              |
      +-------+----------------+
      |                        |
      v                        v
 "Out of memory"          "Memory cgroup out of memory"
  全局 OOM                  组内 OOM
      |                        |
      v                        v
 看全系统 available         看对应组 memory.max
 看各进程 oom_score_adj      看 memory.stat / events
      |                        |
      +-----------+------------+
                  v
        判断匿名页增长还是突发尖峰
                  |
                  v
        调参 / 扩内存 / 修代码
核心结论有三条。第一,OOM 是回收失败后的兜底手段,判断危险不能只看内存使用率,要看 available、回收压力和 swap。第二,选人逻辑是打分加人工偏移,oom_score_adj 是部署阶段就能固化的优先级策略。第三,cgroup v2 把 OOM 的边界缩到控制组内部,排障时必须先分清是全局还是组内,再看 memory.max、memory.stat 和 memory.events。掌握这三条,再遇到凌晨的 OOM 告警,你就能从猜测切换到有据可依的定位流程。
14. 参考资料
- Linux 内核文档:Control Group v2,
Documentation/admin-guide/cgroup-v2.rst - Linux 内核源码:
mm/oom_kill.c,OOM 打分与选择逻辑 - Linux 内核源码:
mm/memcontrol.c,cgroup 内存控制器与 OOM 处理 man 5 proc,/proc/<pid>/oom_score与oom_score_adj说明man 5 systemd.exec,OOMScoreAdjust配置项man 1 free、man 5 proc中关于内存统计字段的说明
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/qq_29029209/article/details/165287957

