

Hello,大家好,我是 Ivan。
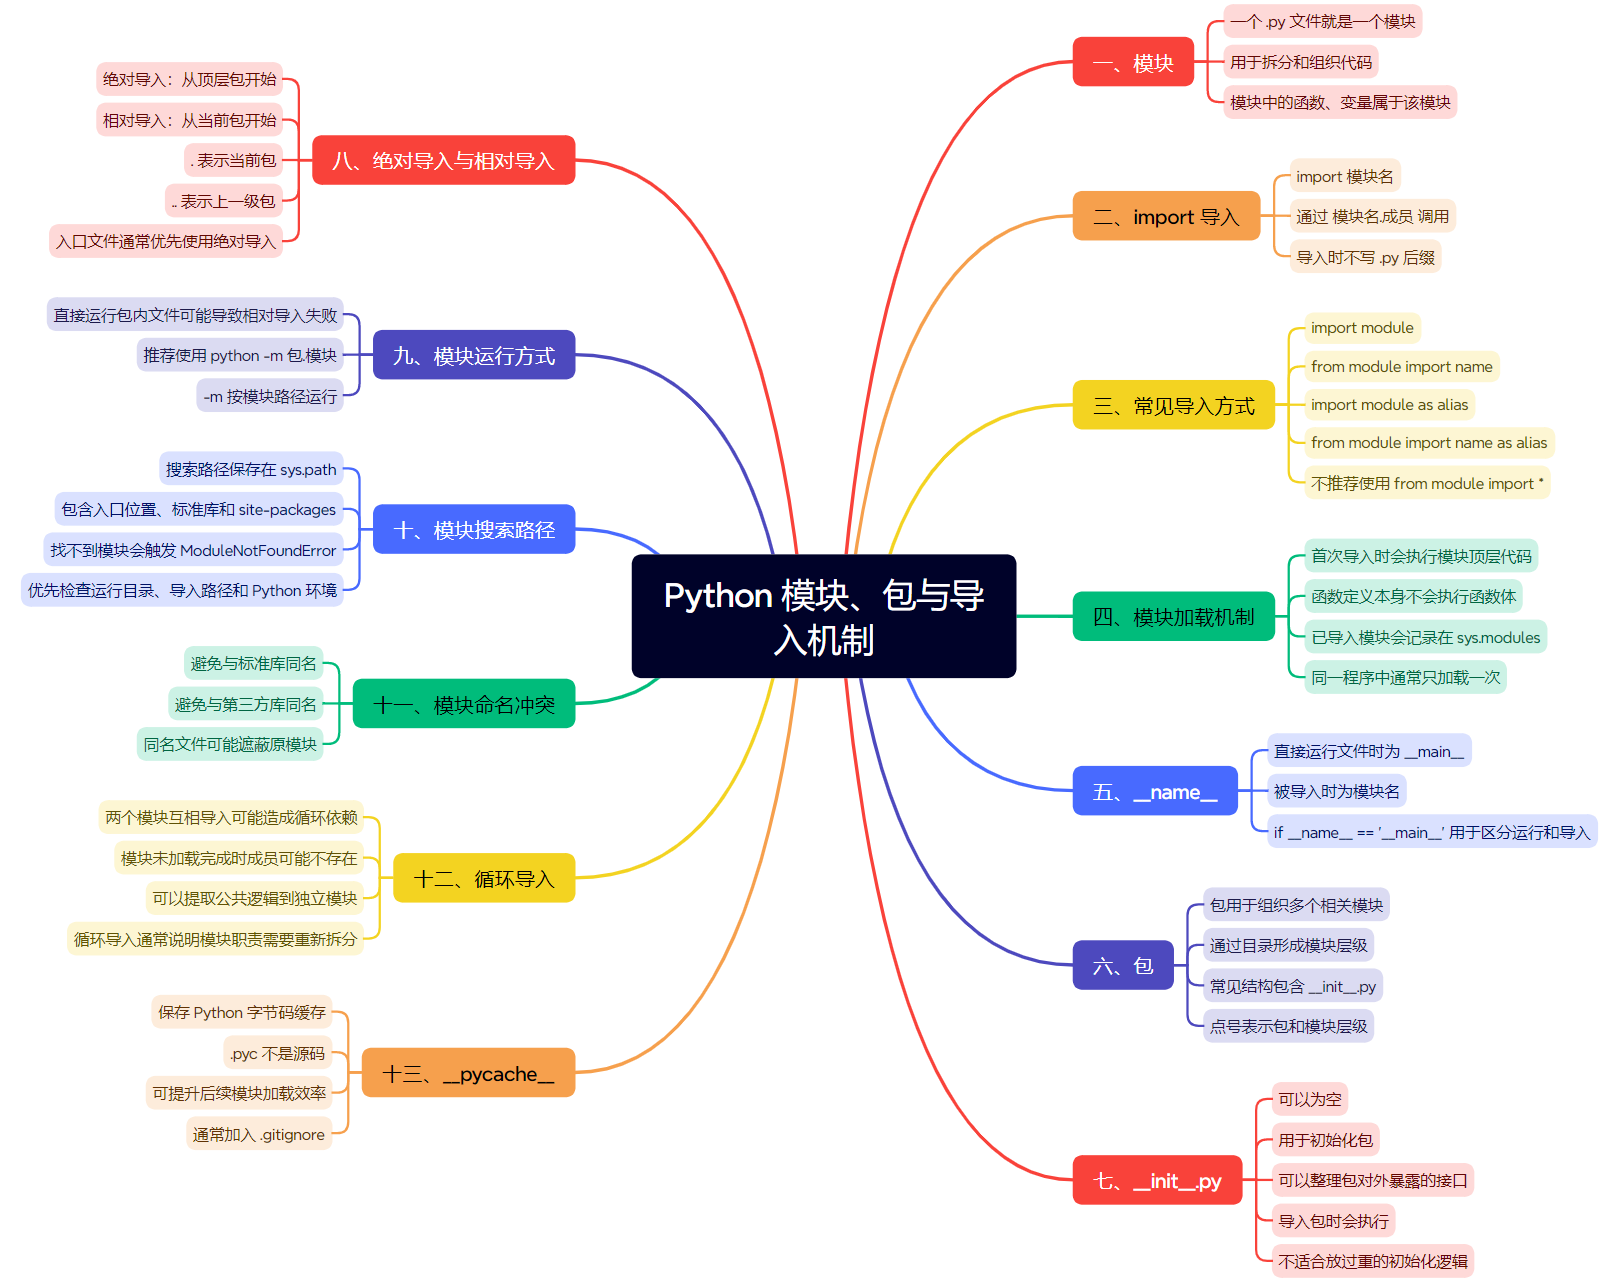
前面几章的案例都不算长,所有代码写在一个文件里也能看明白。但是到了实际的项目开发中,代码不可能一直堆在 main.py 里面。用户处理、订单计算、配置读取全写在一起,文件很快就会变得又长又乱,后面想改一个功能,还得在几百行代码里来回找。先给大家放一下本章的思维导图:
思维导图
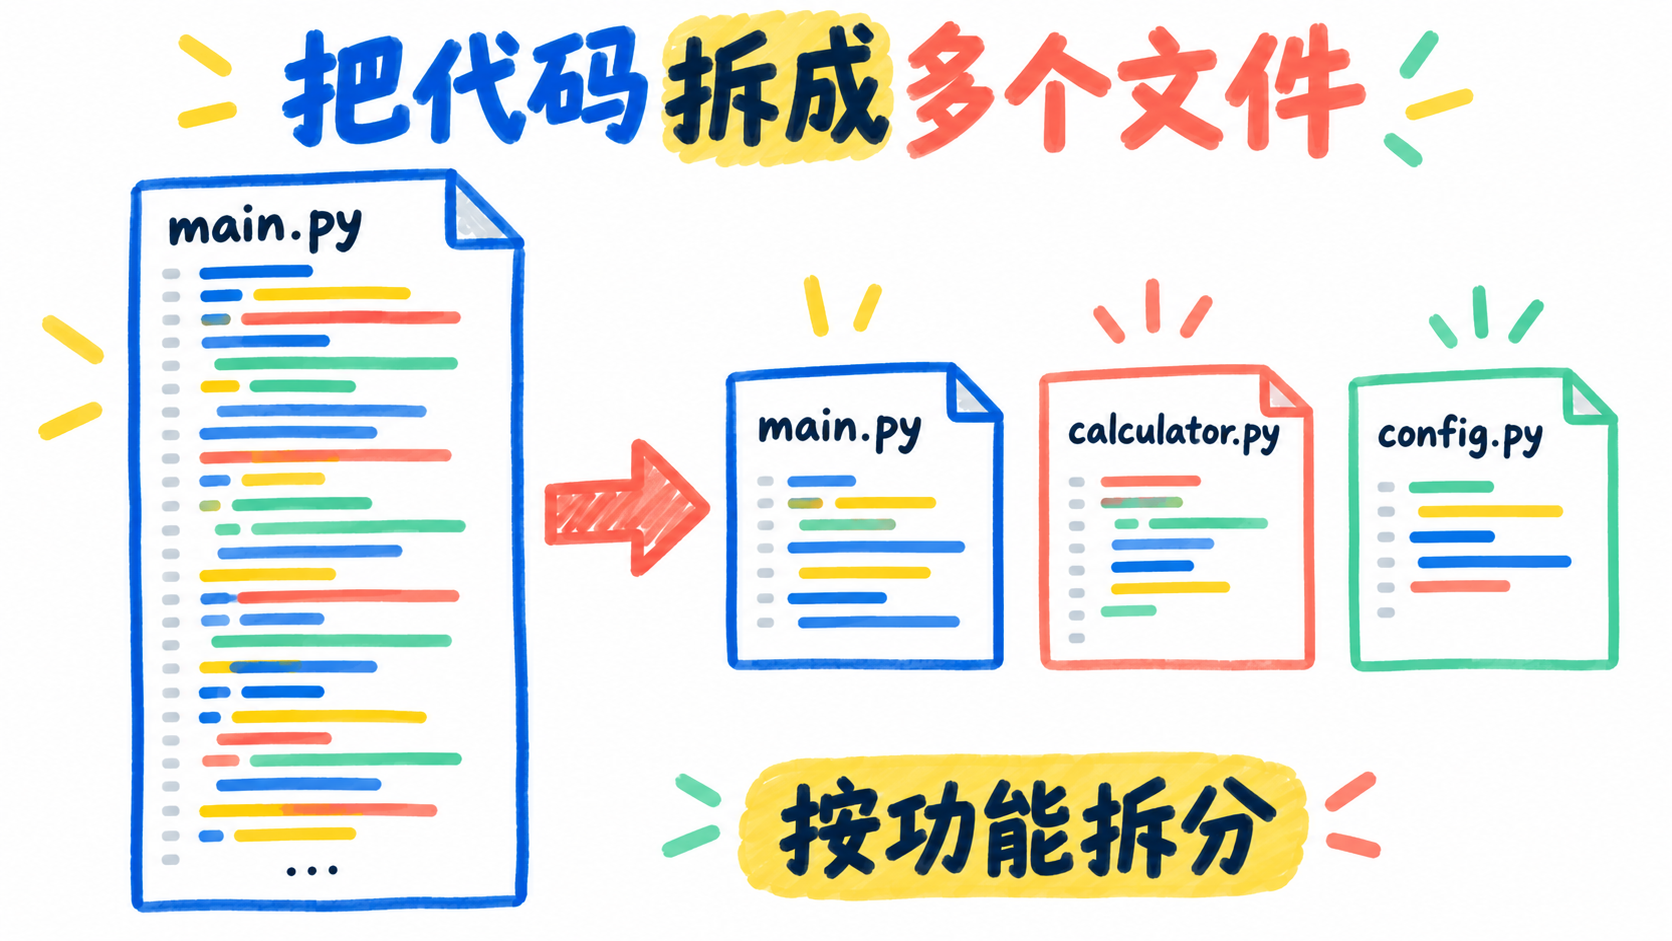
遇到这种情况,我们就要把代码拆成不同的文件,再按照功能放进对应的目录。我们今天要讲的模块和包,就是用来处理这件事的。下面我们通过一个简单的商品项目,把模块、包和导入机制依次写一遍。
一、先把计算代码拆出去
假设现在有一个 main.py,里面写了商品价格计算:
def add(a, b):
    return a + b

def calculate_discount(price, discount):
    return price * discount

print(add(10, 20))
print(calculate_discount(100, 0.8))
代码少的时候看不出什么问题。等计算规则越来越多,main.py 还要处理用户输入和订单数据,这些函数继续放在一起就不太方便了。
我们新建一个 calculator.py,把计算函数放进去:
def add(a, b):
    return a + b

def calculate_discount(price, discount):
    return price * discount
现在的目录是:
project/
├─ main.py
└─ calculator.py
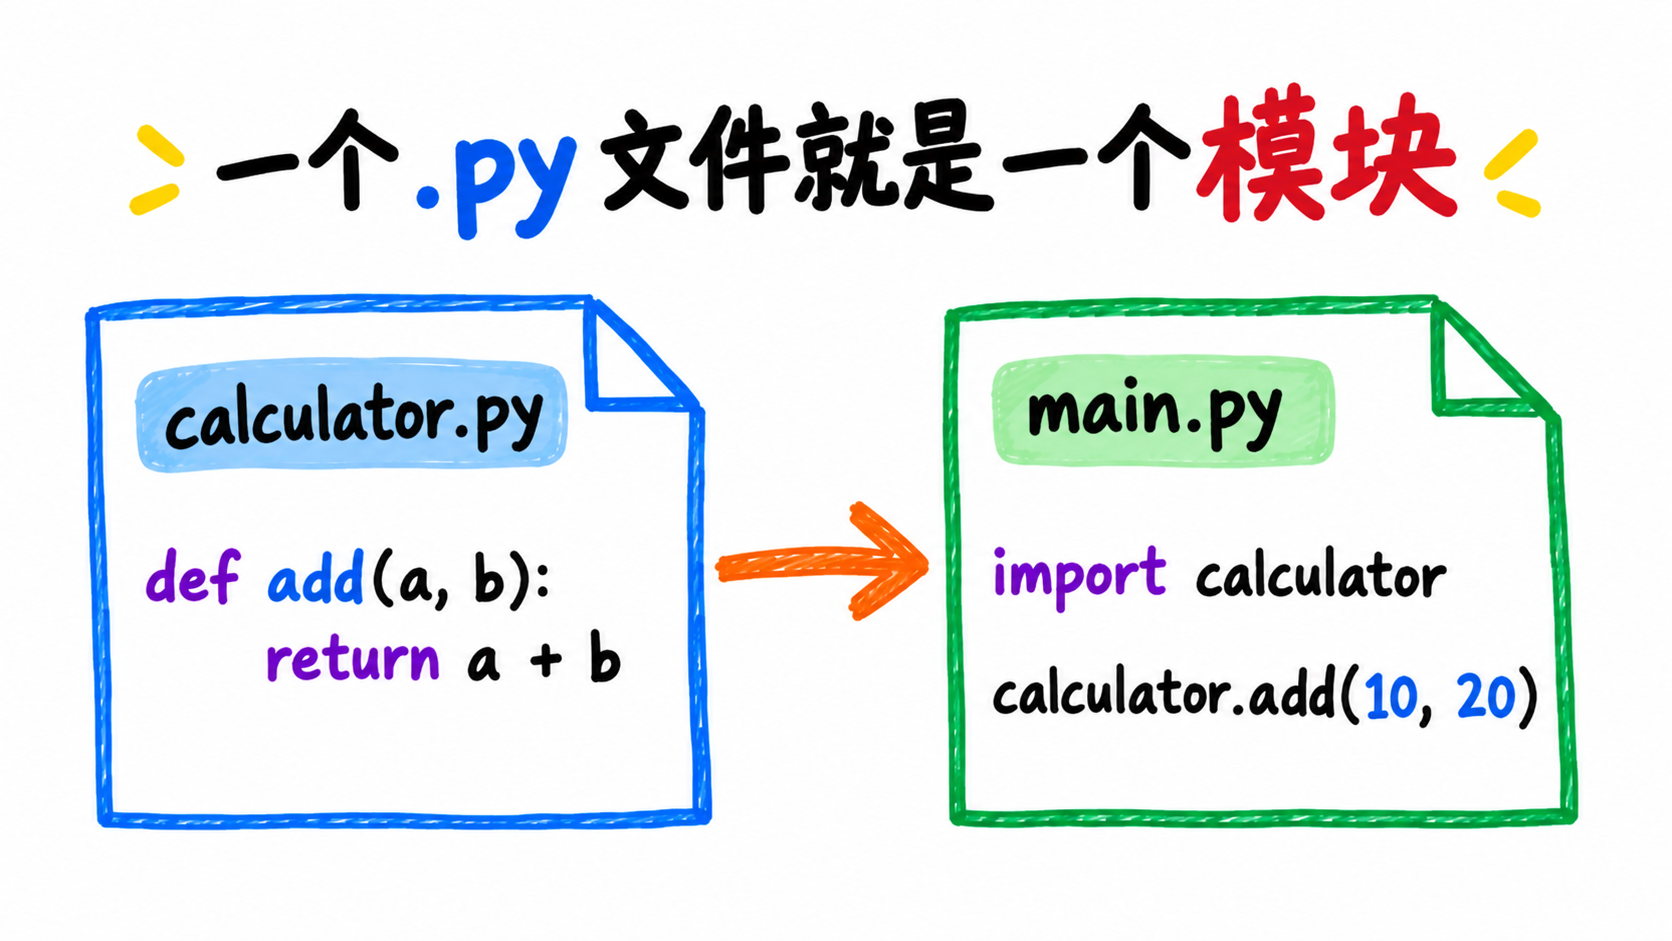
一个 .py 文件就是一个 Python 模块。calculator.py 的模块名是 calculator,文件里的函数和变量都属于这个模块。
二、使用 import 导入模块
回到 main.py,可以使用 import 导入刚才的模块:
import calculator

total = calculator.add(10, 20)
price = calculator.calculate_discount(100, 0.8)

print(total)
print(price)
调用函数时要写成 calculator.add(),前面的 calculator 表示函数来自哪个模块。项目里出现同名函数时,这种写法也比较容易分清来源。
模块名后面不用写 .py:
# 正确
import calculator

# 错误
import calculator.py
Python 会根据模块名查找对应文件,不需要把文件扩展名放进导入语句。
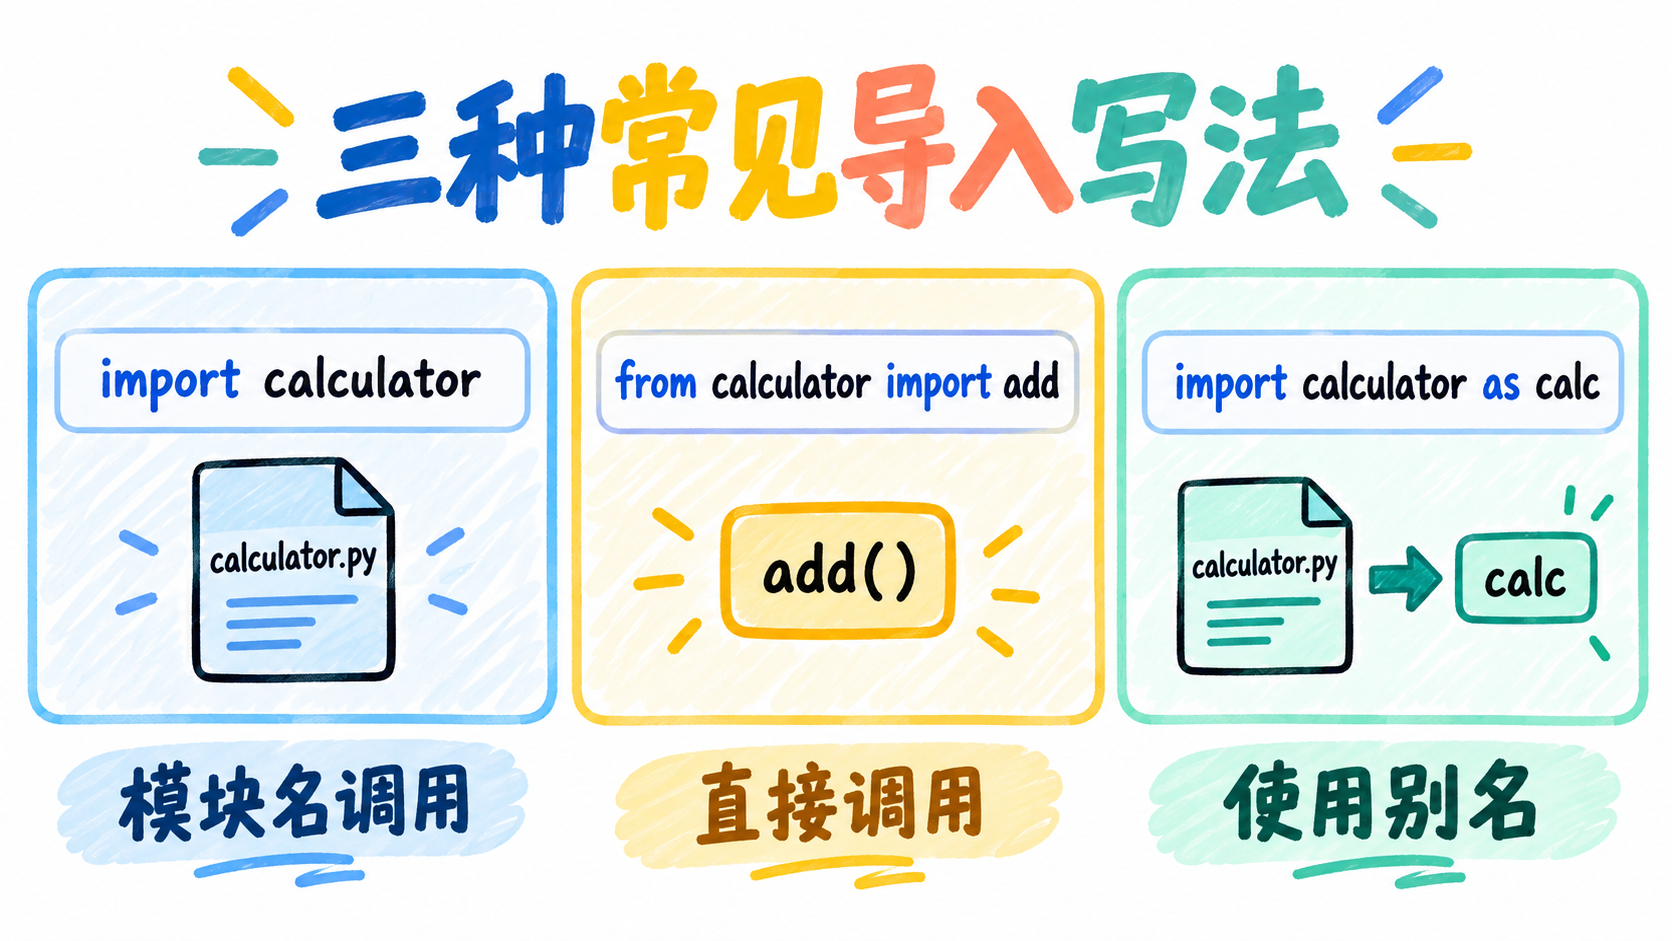
三、几种常见的导入写法
如果只需要模块里的某个函数,可以直接导入它:
from calculator import add

print(add(10, 20))
这样调用时不用再写 calculator.add()。不过,当前文件里如果也有一个 add,原来的名字就可能被覆盖。
模块名太长时,可以设置别名:
import calculator as calc

print(calc.add(10, 20))
函数也可以使用别名:
from calculator import calculate_discount as discount

print(discount(100, 0.8))
有些代码会写成:
from calculator import *
这种写法会一次导入很多名字,代码稍微多一点,就很难看出某个函数到底来自哪里。自己写项目时,最好明确写出模块名或者需要导入的函数名。
四、导入模块时,文件也会执行
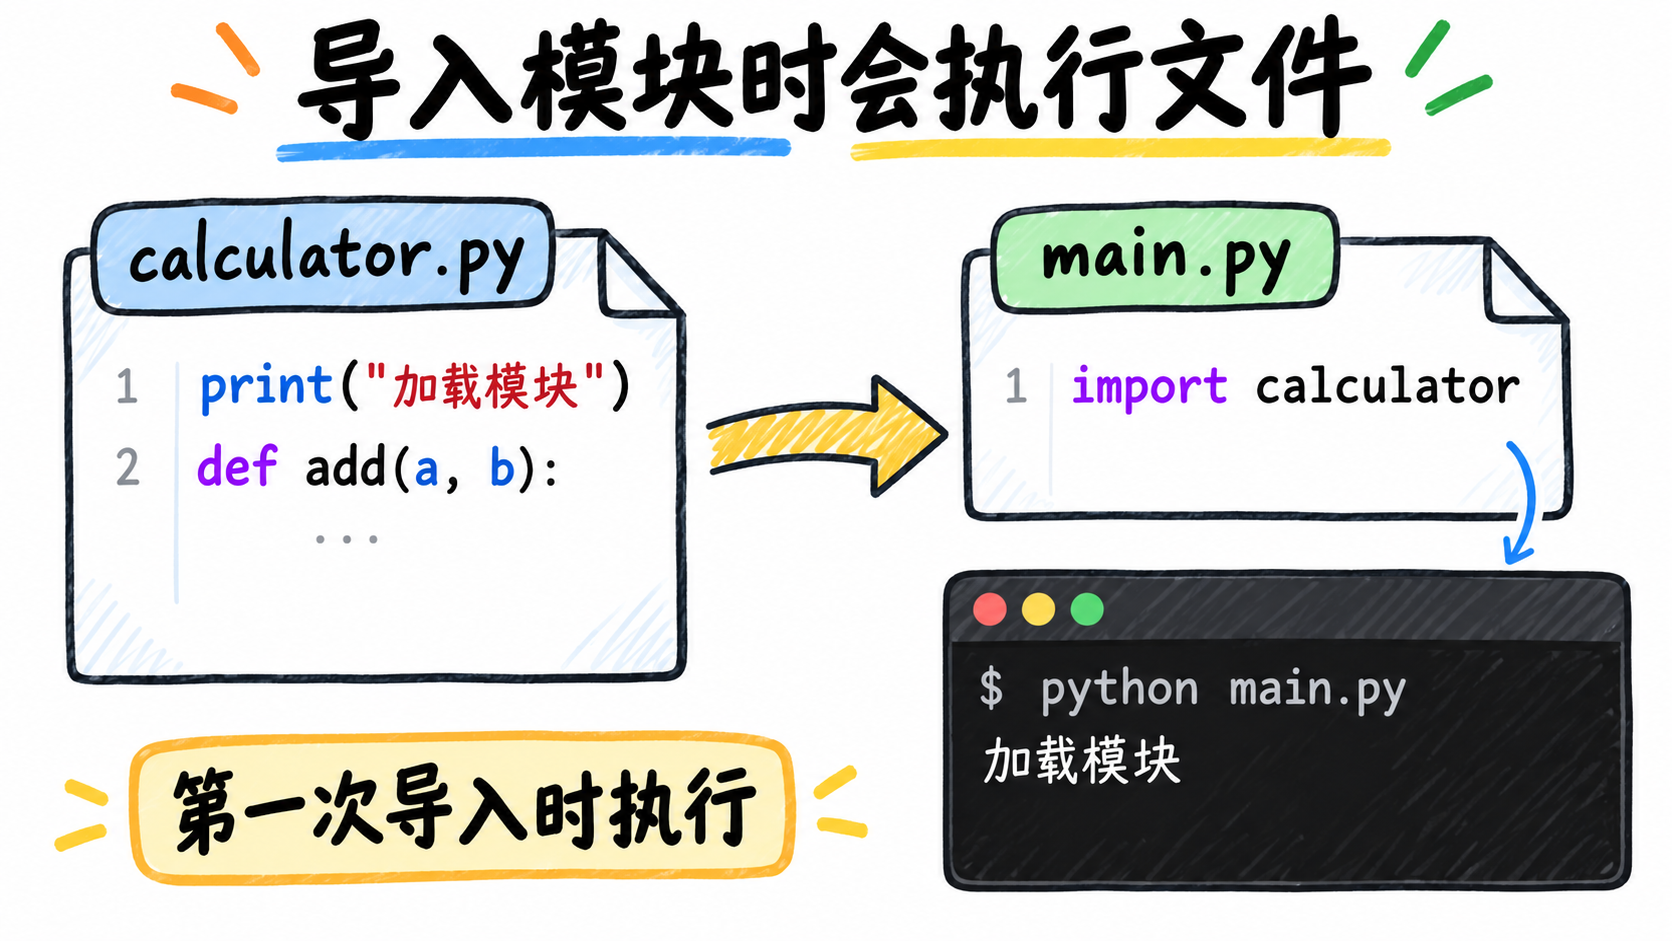
很多刚接触模块的同学会以为,import 只是把函数拿过来。实际上,Python 第一次导入模块时,会从上到下执行这个文件。
在 calculator.py 里加一行输出:
print("calculator 模块开始加载")

def add(a, b):
    return a + b
再运行 main.py:
import calculator

print(calculator.add(10, 20))
终端会先输出:
calculator 模块开始加载
30
定义函数本身不会执行函数体,但是模块最外层的 print()、文件读取和网络请求都会在导入时运行。模块里不适合随意放这些操作,不然别的文件只是想导入一个函数,也会把它们一起执行。
同一个模块在一次程序运行中通常只加载一次。Python 会把已经导入的模块记录在 sys.modules 中,后面再次执行 import calculator,不会把整个文件重新跑一遍。
五、name 有什么用
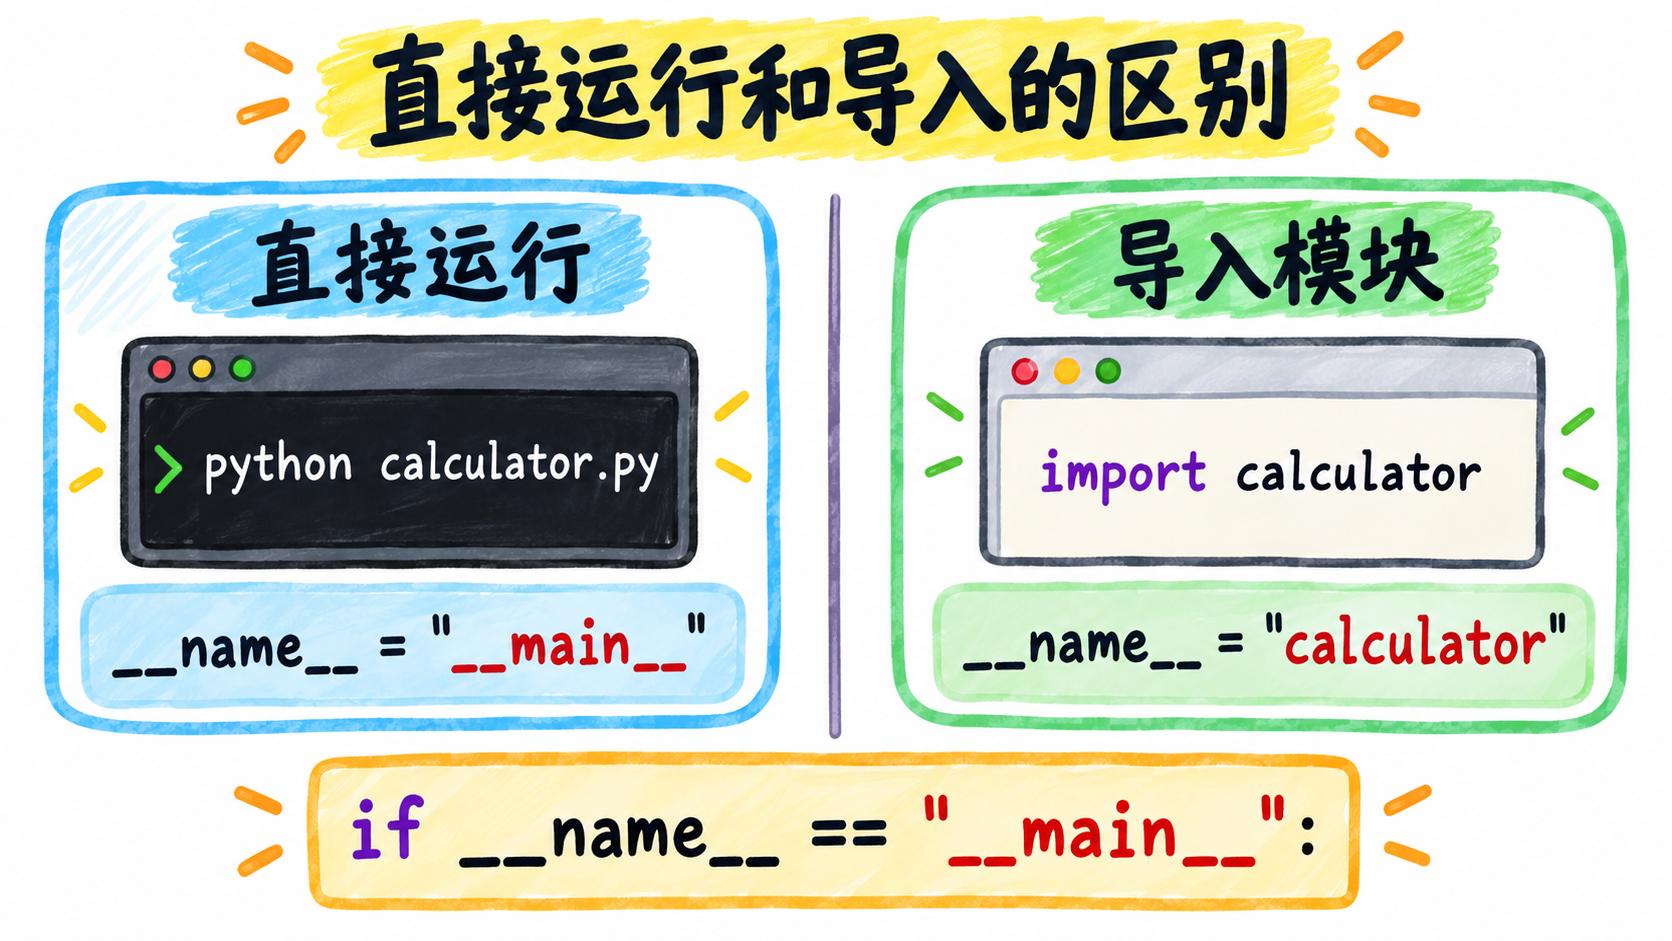
Python 文件有一个内置变量 __name__。直接运行文件时,它的值是 "__main__";文件被其他模块导入时,它的值是模块名。
可以在 calculator.py 里测试:
print(__name__)
直接运行:
python calculator.py
输出:
__main__
从 main.py 导入它:
import calculator
这时 calculator.py 中的 __name__ 是 "calculator"。
我们经常看到下面这段代码:
if __name__ == "__main__":
    print(add(10, 20))
放在判断里的代码,只会在当前文件被直接运行时执行。其他文件导入 calculator 时,测试代码不会跟着运行。平时想在模块末尾放几个简单测试,可以使用这种写法隔开。
六、代码多了以后要使用包
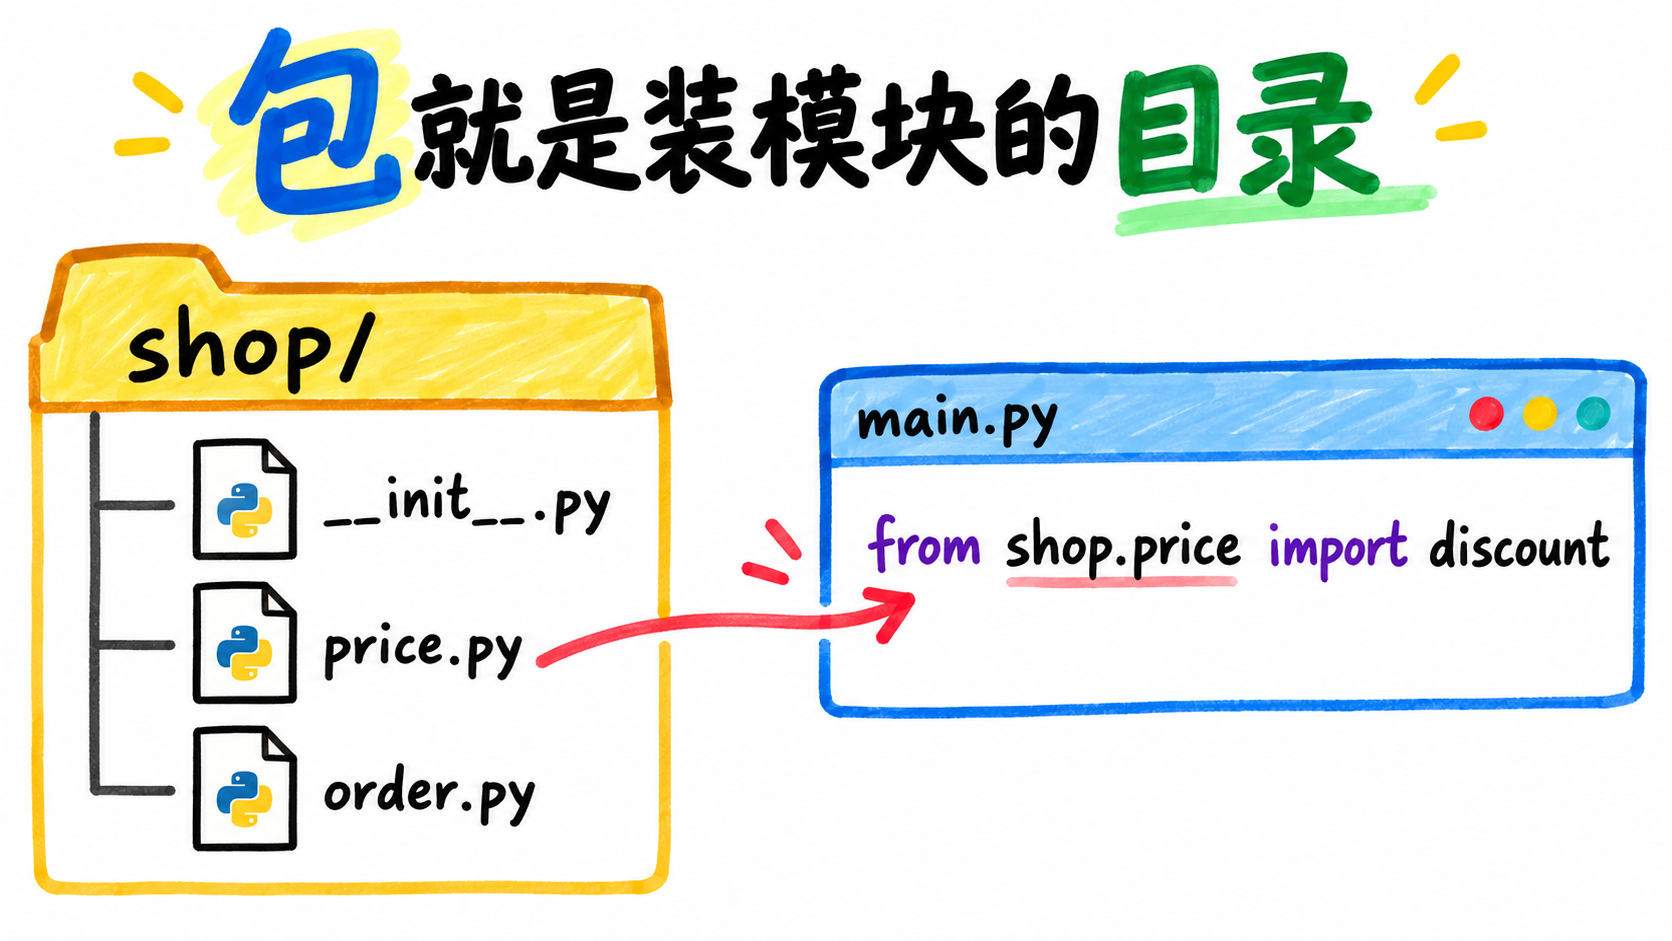
模块继续增加以后,所有 .py 文件平铺在项目根目录里也会变乱。这时可以用目录把一组相关模块放在一起,这个目录就叫作包。
我们把商品相关代码整理成下面这样:
project/
├─ main.py
└─ shop/
   ├─ __init__.py
   ├─ price.py
   └─ order.py
price.py 处理价格,order.py 处理订单。以前写 import calculator,现在可以从包中导入:
from shop.price import calculate_discount

print(calculate_discount(100, 0.8))
点号表示目录和模块之间的层级。shop.price 对应 shop/price.py。
现代 Python 支持没有 __init__.py 的命名空间包,不过普通项目里还是建议保留这个文件。它能清楚说明当前目录是一个包,也能放一些包初始化代码。
七、init.py 可以写什么
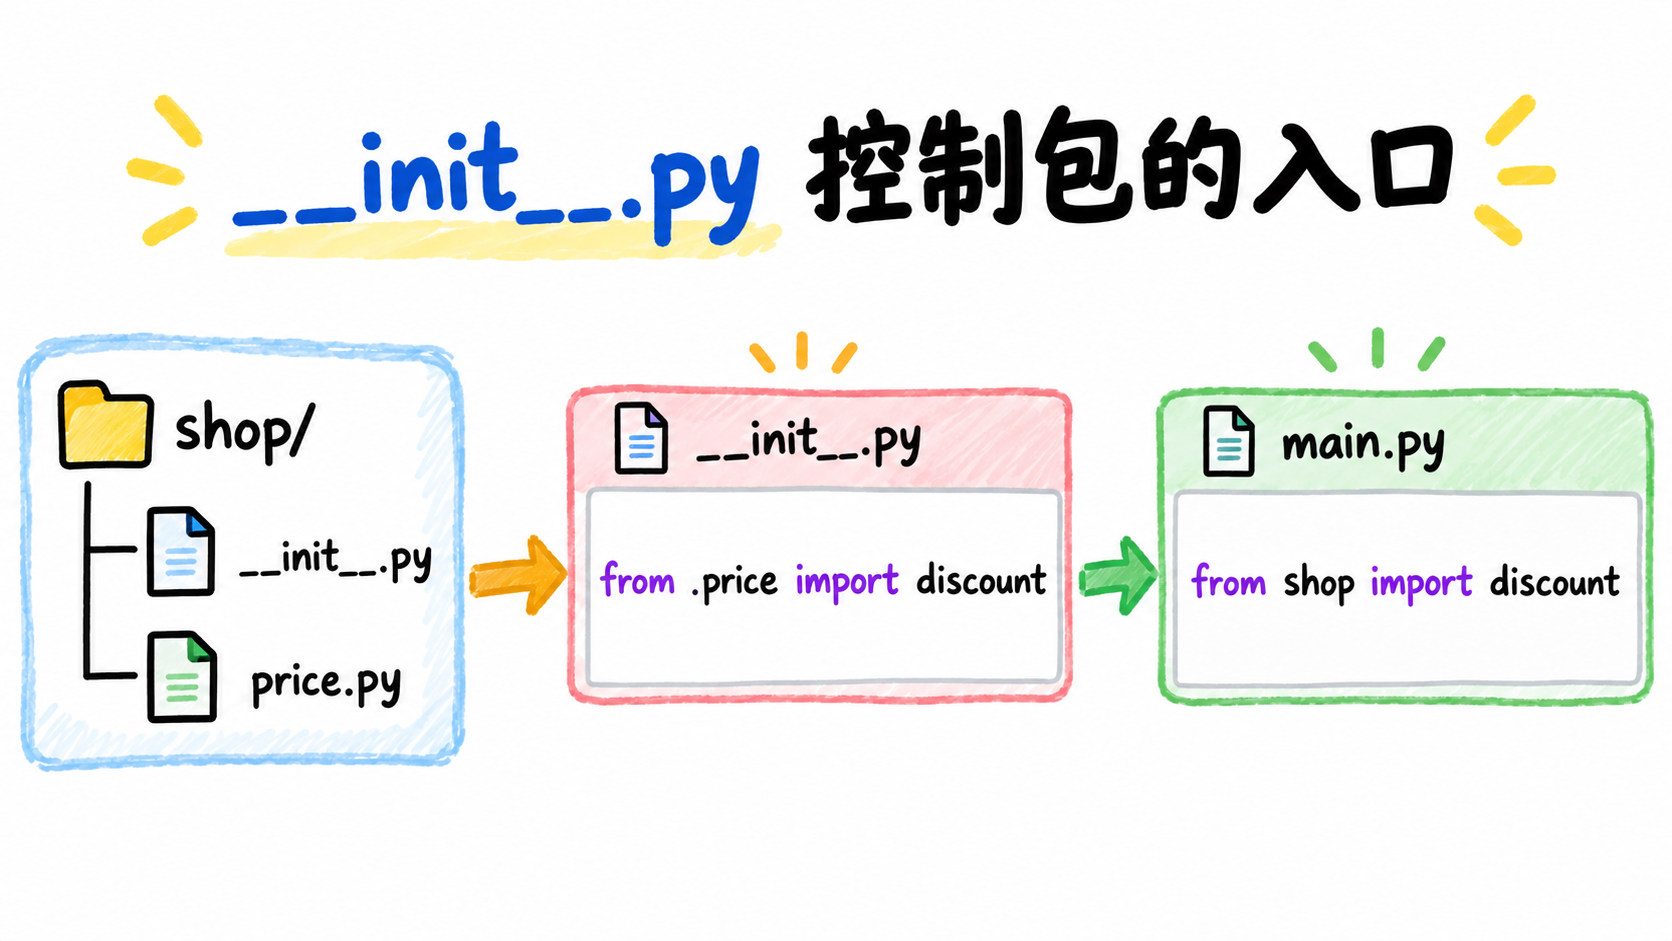
__init__.py 可以是空文件。只想让 shop 成为一个普通包时,留空就够了。
它也可以整理包对外提供的名字。比如 shop/price.py 中有:
def calculate_discount(price, discount):
    return price * discount
在 shop/__init__.py 中写:
from .price import calculate_discount
外部就可以直接从 shop 导入:
from shop import calculate_discount

print(calculate_discount(100, 0.8))
这里的点号表示当前包。原来完整路径是 shop.price.calculate_discount,经过 __init__.py 整理以后,调用者只需要知道 shop.calculate_discount。
__init__.py 也会在包第一次导入时执行,所以不要在里面放很重的处理逻辑。导入一个包就连接数据库或者读取大量文件,程序启动会变慢,排查问题也比较麻烦。
八、绝对导入和相对导入
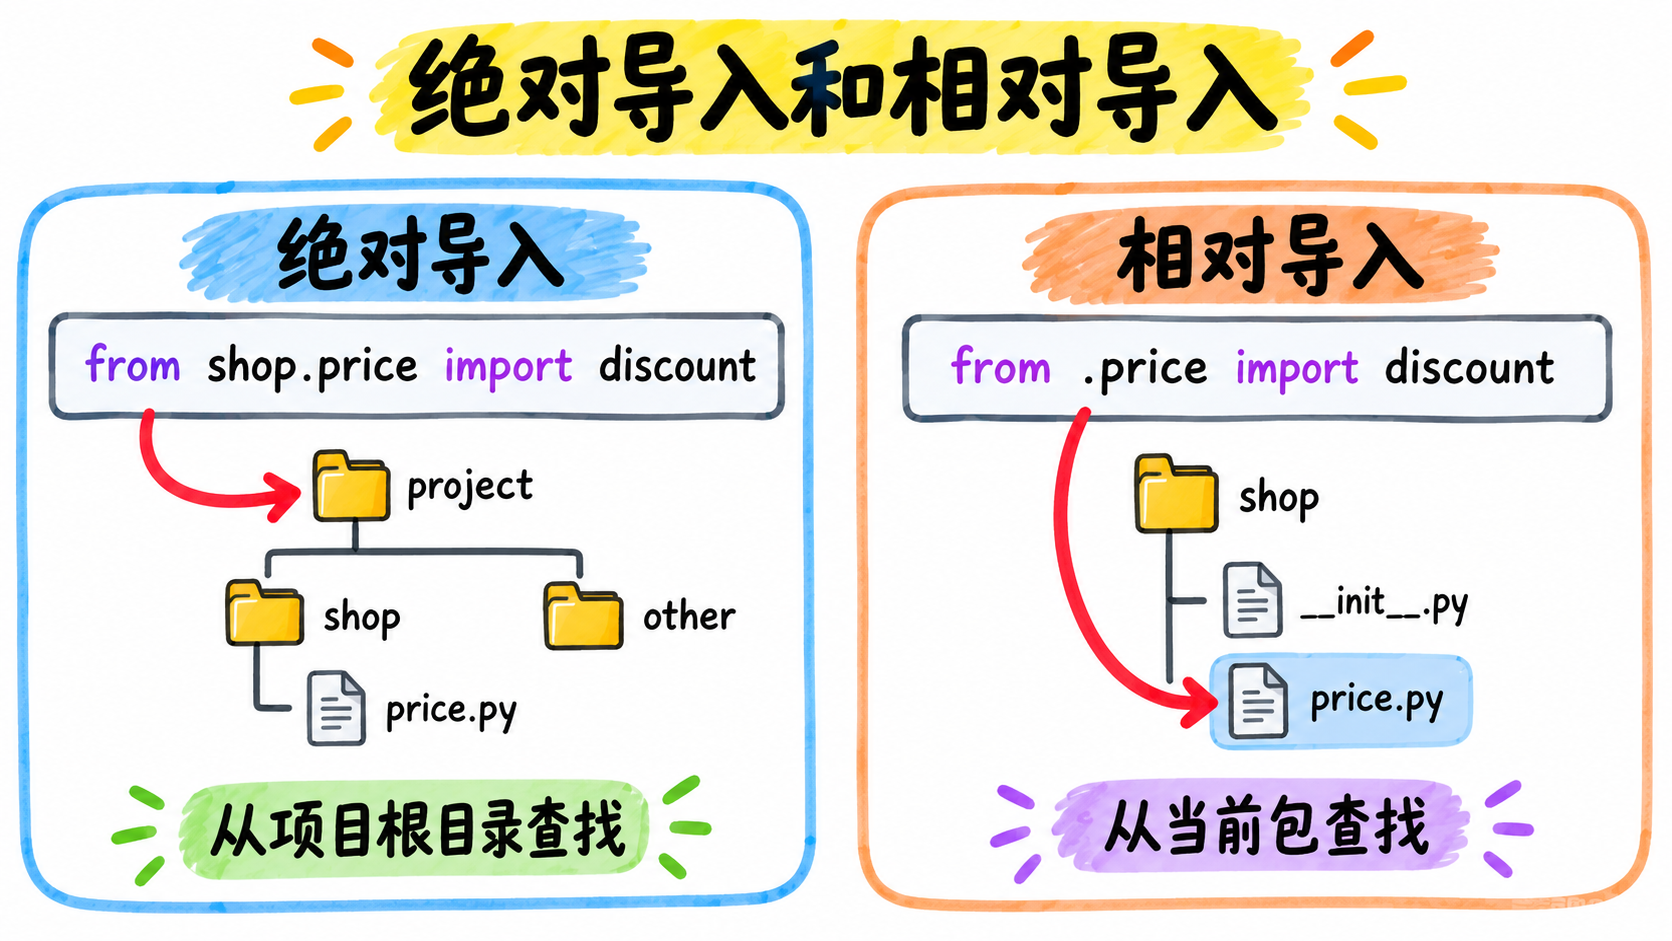
包里面的模块也会互相调用。假设 shop/order.py 需要使用 price.py 中的函数,可以写绝对导入:
from shop.price import calculate_discount
也可以写相对导入:
from .price import calculate_discount
绝对导入从项目的顶层包开始写,路径比较完整。相对导入从当前包开始,前面的一个点表示当前目录,两个点表示上一级包:
from .price import calculate_discount
from ..config import settings
相对导入只适合包内部。项目入口文件通常使用绝对导入,这样文件来自哪里更容易看出来。
九、为什么包里的文件直接运行会报错
在 shop/order.py 中写了相对导入:
from .price import calculate_discount
如果进入 shop 目录,直接运行:
python order.py
可能会看到:
ImportError: attempted relative import with no known parent package
因为直接运行 order.py 时,Python 把它当成一个独立脚本,并不知道它属于 shop 包。
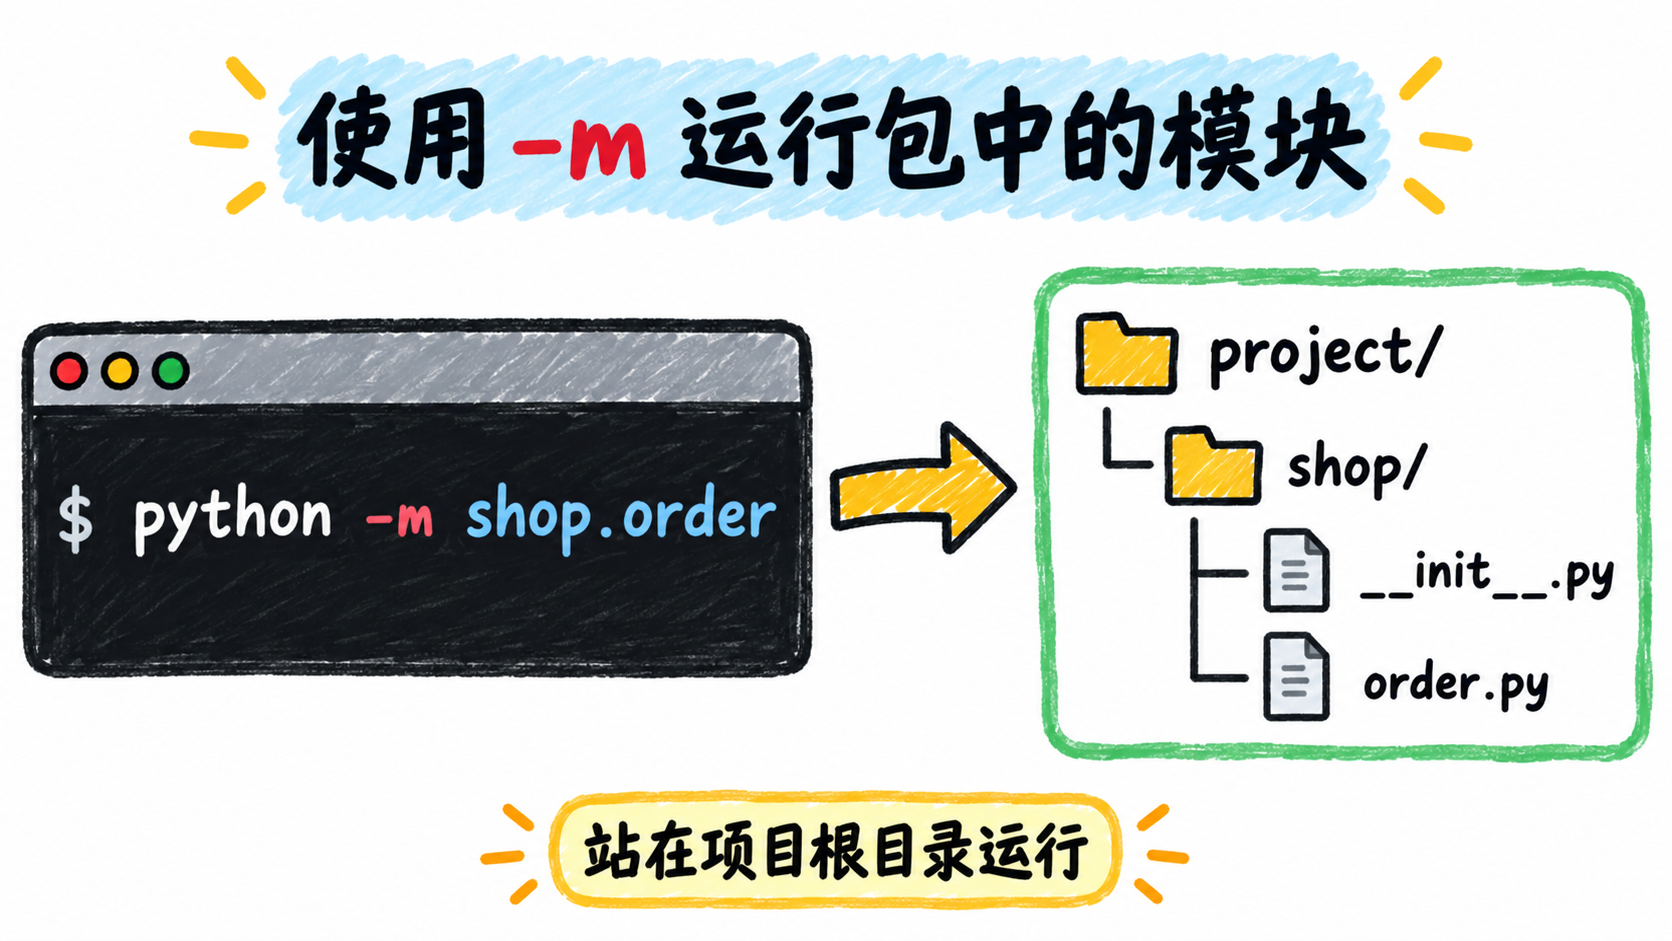
应该站在项目根目录运行:
python -m shop.order
-m 表示按照模块路径运行。Python 能识别 shop.order 的包关系,相对导入也能正常工作。
十、Python 到哪里查找模块
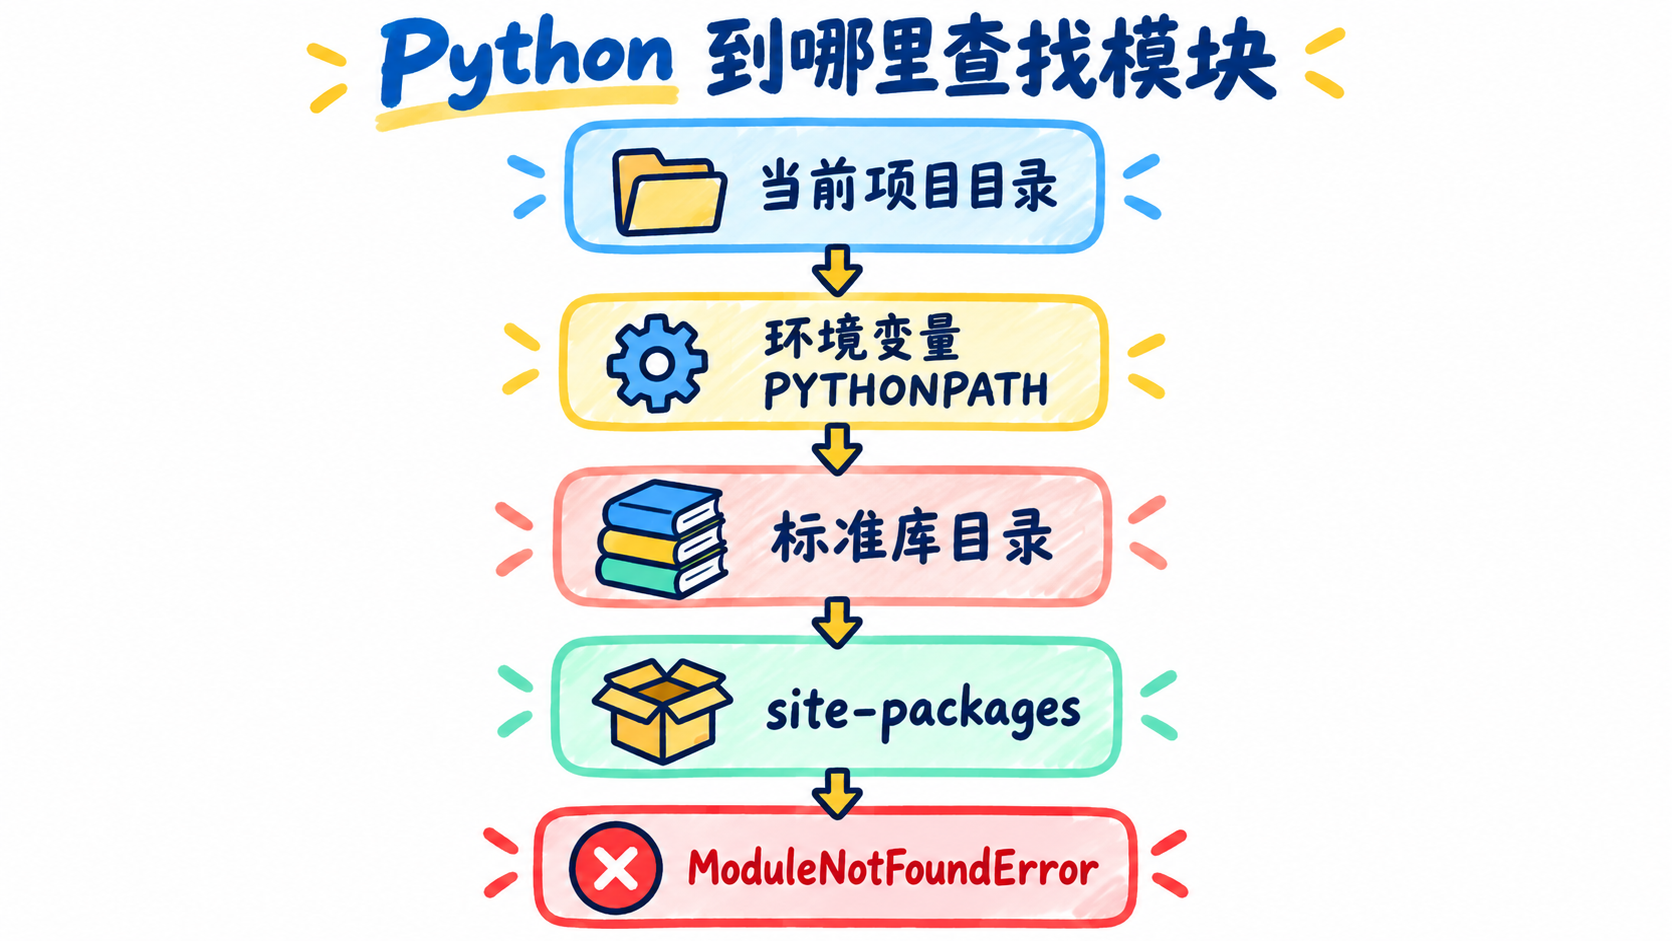
执行 import calculator 时,Python 会按照模块搜索路径去找文件。这些路径保存在 sys.path 中:
import sys

for path in sys.path:
    print(path)
输出内容会受到运行方式、Python 安装位置和虚拟环境影响。一般会包含程序入口所在位置、Python 标准库目录,以及当前环境的 site-packages。
找不到模块时,会出现:
ModuleNotFoundError: No module named 'calculator'
这时候不要急着在代码里到处加 sys.path.append()。先检查终端目前位于哪个目录,再看文件名和导入路径是不是对应。如果导入的是第三方库,还要确认它安装在当前正在使用的 Python 环境中。
有些同学会把自己的文件命名为 random.py、json.py 或 requests.py。这些名字可能遮住标准库或第三方模块,导入时就会加载到自己的文件。遇到很奇怪的属性错误时,也要检查项目里有没有同名文件。
十一、什么是循环导入
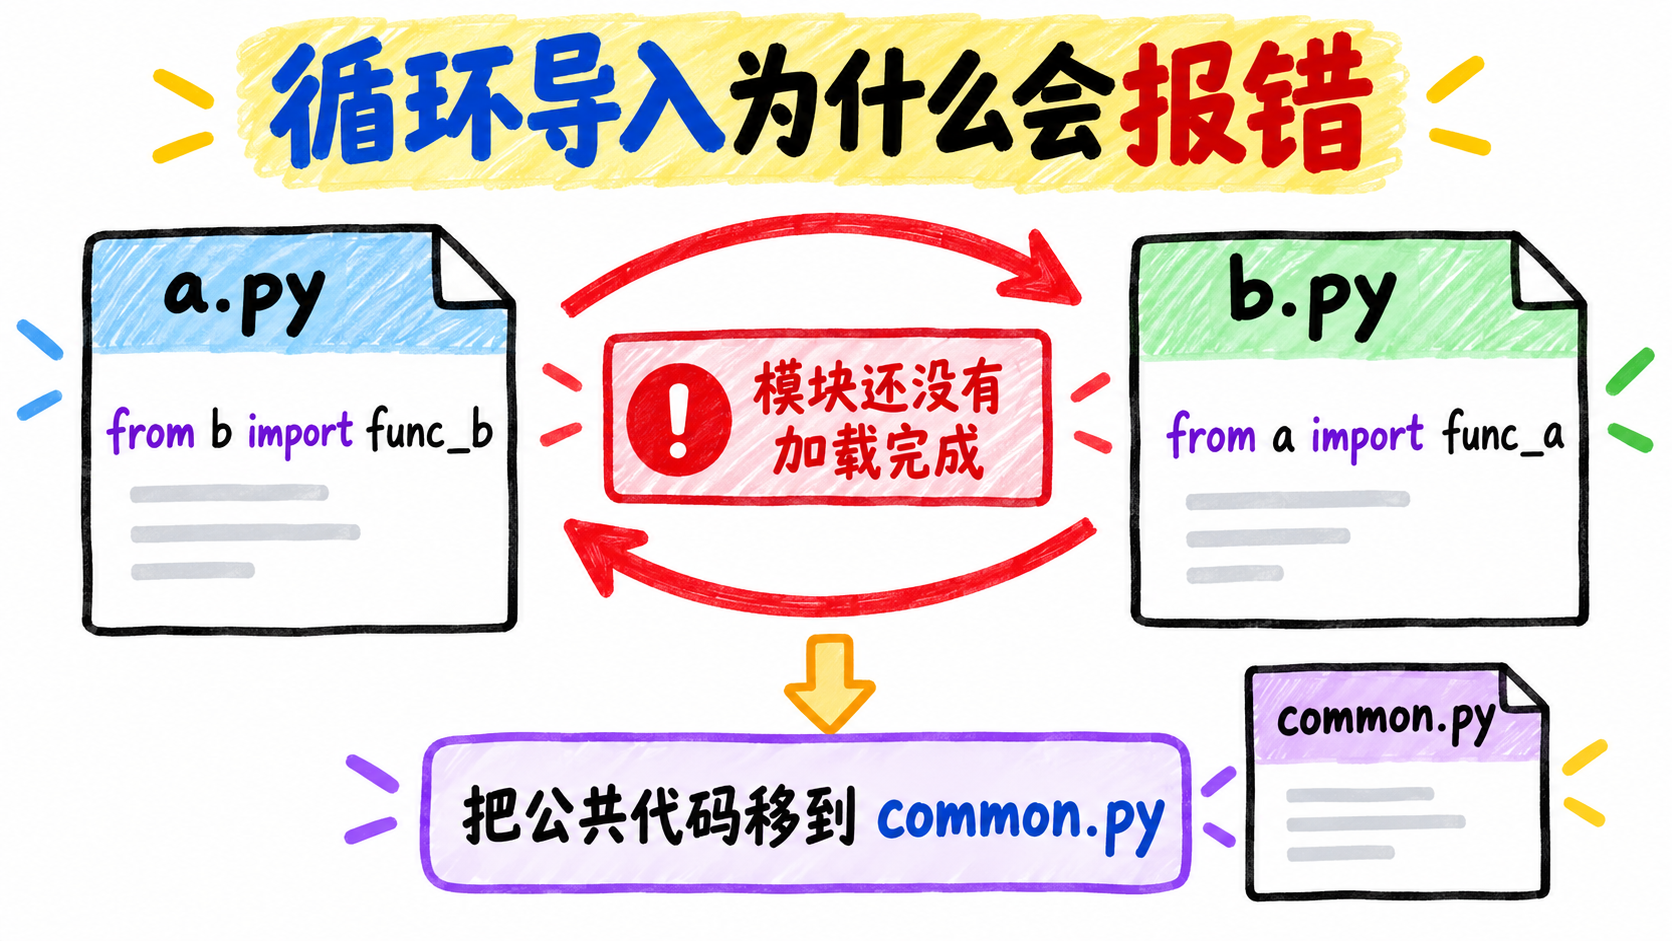
假设 a.py 导入 b.py:
# a.py
from b import func_b

def func_a():
    print("A")
b.py 又导入 a.py:
# b.py
from a import func_a

def func_b():
    print("B")
运行 a.py 时,Python 开始加载 b.py。但是 b.py 又回来找 a.py,此时 a.py 还没有执行完成,func_a 可能还没创建出来,于是就会出现循环导入错误。
比较常见的处理方式,是把两个模块都会用到的函数放进单独的 common.py:
project/
├─ a.py
├─ b.py
└─ common.py
然后让 a.py 和 b.py 都去导入 common.py。如果两个模块必须反复引用对方,通常也说明它们之间的职责没有拆清楚。
十二、pycache 是什么
运行项目以后,目录里可能会出现 __pycache__:
__pycache__/
└─ calculator.cpython-313.pyc
这里保存的是 Python 生成的字节码缓存。下次导入模块时,如果源码没有变化,Python 可以直接使用缓存,不需要重新完成全部编译过程。
这个目录不用自己编辑,也不要把里面的 .pyc 当成源码。使用 Git 管理项目时,一般会在 .gitignore 中忽略它:
__pycache__/
*.pyc
我们已经把一个文件拆成了模块,又把多个模块整理成了包。以后项目代码变多时,可以先按照功能划分文件,再根据业务关系放进对应的包里。导入报错时,重点检查当前运行位置、模块路径和包结构,通常比直接修改 sys.path 更容易找到问题。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2401_83830408/article/details/165740813

