

为什么 LLM 的置信度在骗你?一个 33ms 校准概率引擎的解法
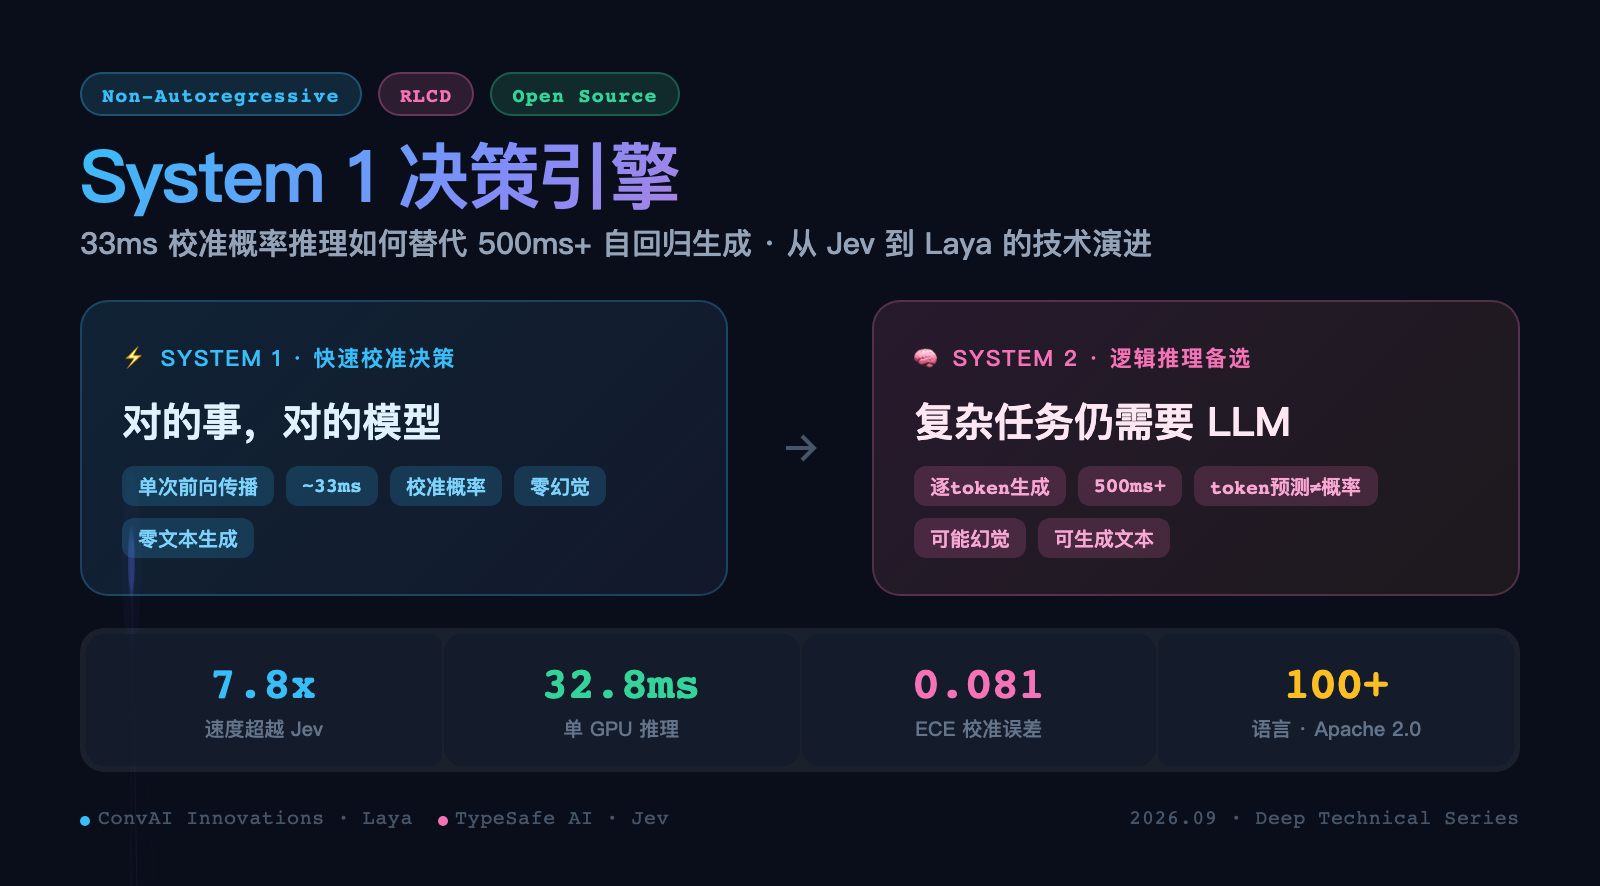
读前必读:你的 Agent 用 LLM 做分类,返回"confidence: 0.95"——但这个数字根本没有数学依据。LLM 的置信度只是 token 预测,模型完全不确定时照样输出 0.95。本文拆解一个开源引擎 Laya,用 33ms 单次前向传播输出真正可校准的概率,速度是自回归生成的 8 倍,校准精度高 3 倍。
读完你能带走什么:
- 理解为什么 LLM 的置信度本质不可靠——以及什么能真正替代它
- 掌握 RLCD(Reinforcement Learning for Calibrated Decisions)的核心原理
- 学会判断:哪些 Agent 任务应该从 LLM 切换到专用决策引擎
- 获得一份 Laya vs Jev 的选型决策树和生产部署指南
一、核心洞察:AI 在用 System 2 做 System 1 的事
Kahneman 在《思考,快与慢》中提出了著名的双系统理论:
- System 1:快速、自动、无意识、情绪化。比如看到一张愤怒的脸,你会本能地退缩。
- System 2:缓慢、刻意、有意识、逻辑化。比如计算 17 × 24。
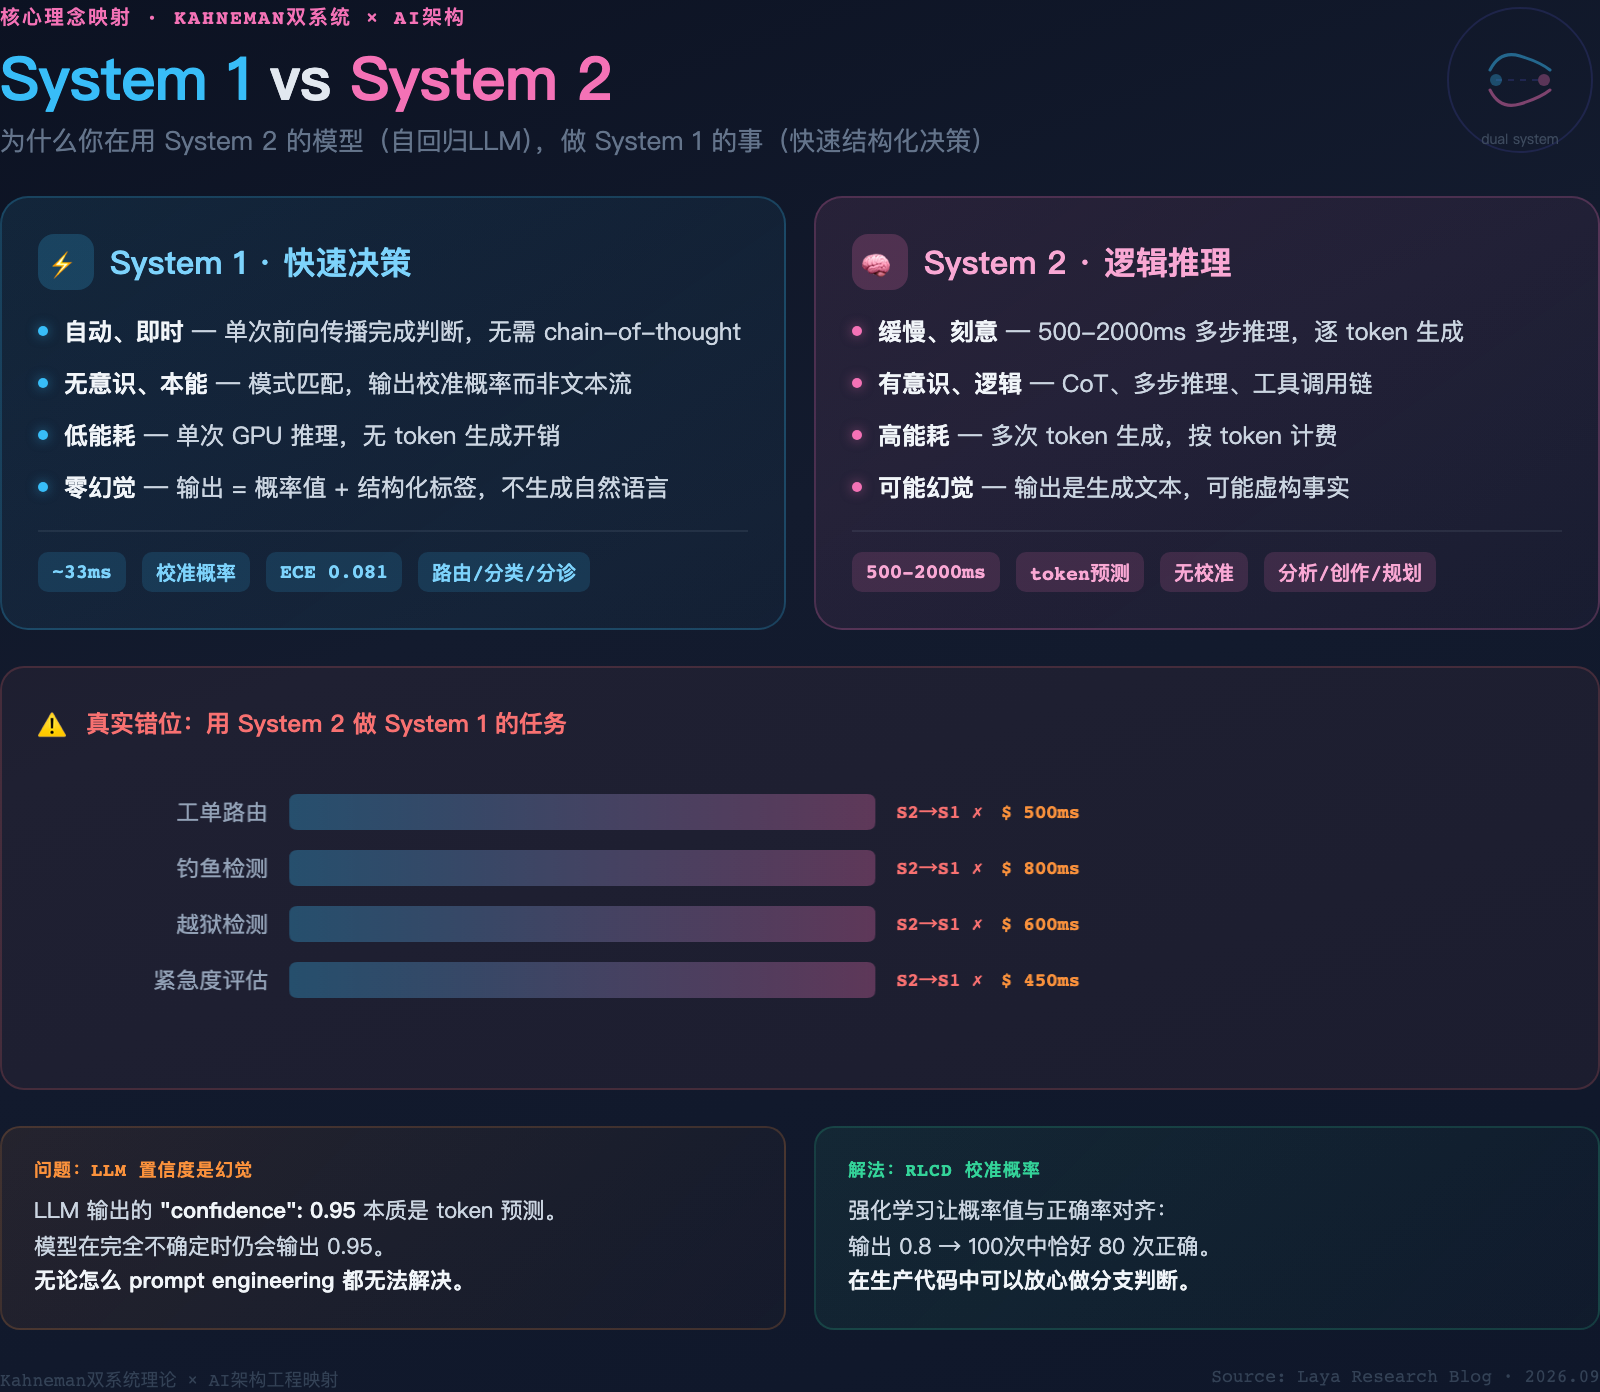
这个框架映射到当前的 AI 架构,你会发现一个巨大的错位:我们在用 System 2 的模型(自回归 LLM),执行 System 1 的任务(快速结构化决策)。
真实场景中的错位
| 决策任务 | 性质 | 当前做法 | 问题 |
|---|---|---|---|
| 客服工单路由到哪个部门 | 简单分类 | 调用 70B LLM 生成文本标签 | 延迟 500-2000ms,花费真实推理成本 |
| 检测邮件是否为钓鱼攻击 | 二元判断 | LLM 输出"是/否"+ 解释 | 解释是噪音,标签才是有用的 |
| 判断 Prompt 是否试图越狱 | 安全分类 | LLM 流式输出 JSON | 输出格式可能损坏,需要额外解析 |
| 评估工单紧急程度 (0-3) | 有序分级 | LLM 生成 “urgency: high” | "high"不是可分支的概率值 |
这些任务的共同特征是:输出空间小而结构化、决策时间要求低、不需要生成文本、需要可信赖的概率值。
LLM 置信度的幻觉
LLM 输出的"置信度"本质上是 token 预测。当模型输出 "confidence": 0.95 时,它只是在预测一个听起来自信的数值 token。这背后没有任何数学校准——模型在完全不确定时,仍然会输出 0.95 的置信度。
更糟糕的是,这种虚假的置信度无法通过 prompt engineering 解决。无论你怎么要求"输出真实置信度",自回归模型的 token 预测本质决定了它无法产生有意义的概率分布。
这对中国开发者意味着什么?
当你在生产环境中接入 DeepSeek / Qwen / GLM 等模型做分类、路由、安全护栏时,几乎一定会遇到三个痛点:① 回复延迟高(500ms+),② 输出的置信度并不可靠(说"95%确定"但实际上是猜的),③ JSON 格式偶尔损坏需要额外解析。这篇文章讲的「校准概率」思路,不依赖特定模型,是 Agent 架构层面的通用解法。如果你也在关注 AI Agent 的信任与安全,Laya 提供的校准置信度正是安全护栏的正确工程路径。
二、Jev:TypeSafe AI 的 “System One Models” 宣言
2026 年 9 月,TypeSafe AI 公司发布了一篇题为「Introducing System One Models and Jev」的文章,正式提出了 System One Models 这个概念。
TypeSafe AI 的背景
TypeSafe AI 由 Diogo Almeida 创立——此人是 OpenAI 的 ChatGPT 共同发明者。这个背景让 Jev 的发布自带光环。
Jev 的技术定位
Jev 被定义为"a browser agent with a dynamic, indexed action space"——一个具有动态索引动作空间的浏览器 Agent。其核心创新是将非自回归决策概念从学术论文推向产品化:
- 非自回归:不逐 token 生成文本,单次前向传播直接输出结构化概率
- RLCD(Reinforcement Learning for Calibrated Decisions):通过强化学习训练校准概率
- Schema-based decisions:基于预定义 schema 的选择/评分/布尔判断
- $0.042/M input tokens:按量计费的 API 模式
- ~150ms 典型响应(TypeSafe 官方宣称值;独立第三方 P50 实测为 236–276ms,见第六节基准对比)
Jev 的争议
Jev 发布时,社区很快注意到一个事实:这个"突破性概念"其实早有人在 2025 年 3 月就发表了 arXiv 论文并开源了全套实现。而 Jev 的发布没有技术论文、没有开放权重、没有开放训练数据集。
这个争议直接催生了 Laya。
三、Laya:Jev 的完全开源替代方案
2026 年 9 月,ConvAI Innovations 创始人 Nandakishor Mukkunnoth 发布了 Laya——一个 33ms 的多语言 System 1 决策引擎。
从 SalesRLAgent 到 Laya:一年的技术演进
Laya 的前身是一篇 2025 年 3 月的 arXiv 论文 SalesRLAgent(arXiv:2503.23303):
- 使用 PPO 在序列表示上训练
- 输出逐轮销售转化概率 (0.0-1.0)
- 96.7% 的转化预测准确率(比 LLM-only 方法高 34.7%)
- 85ms 推理延迟(GPT-4 需 3450ms,Laya 快约 40 倍)
- 配套的 HuggingFace 模型权重、开放数据集、PyPI 包
2025 年 9 月,第二篇论文发表 Schema-based Decisions via RL(arXiv:2510.01237),形式化了 RL 引导的 schema-based decision 框架——这是 RLCD 的学术基础。
2026 年 9 月,Laya 作为完整产品发布。
核心技术特点
32.8ms 单 GPU 推理(批量 10 问题仅 7.2ms/问题),比 Jev 快 6-8 倍。
100+ 语言支持,通过 mmBERT-base 编码器和 Unicode 脚本路由实现。
100% Apache 2.0 开源,模型权重、代码、基准测试工具全部开放。
零 API 费用自托管部署。
四、Laya 架构深度解析
4.1 三大决策原语
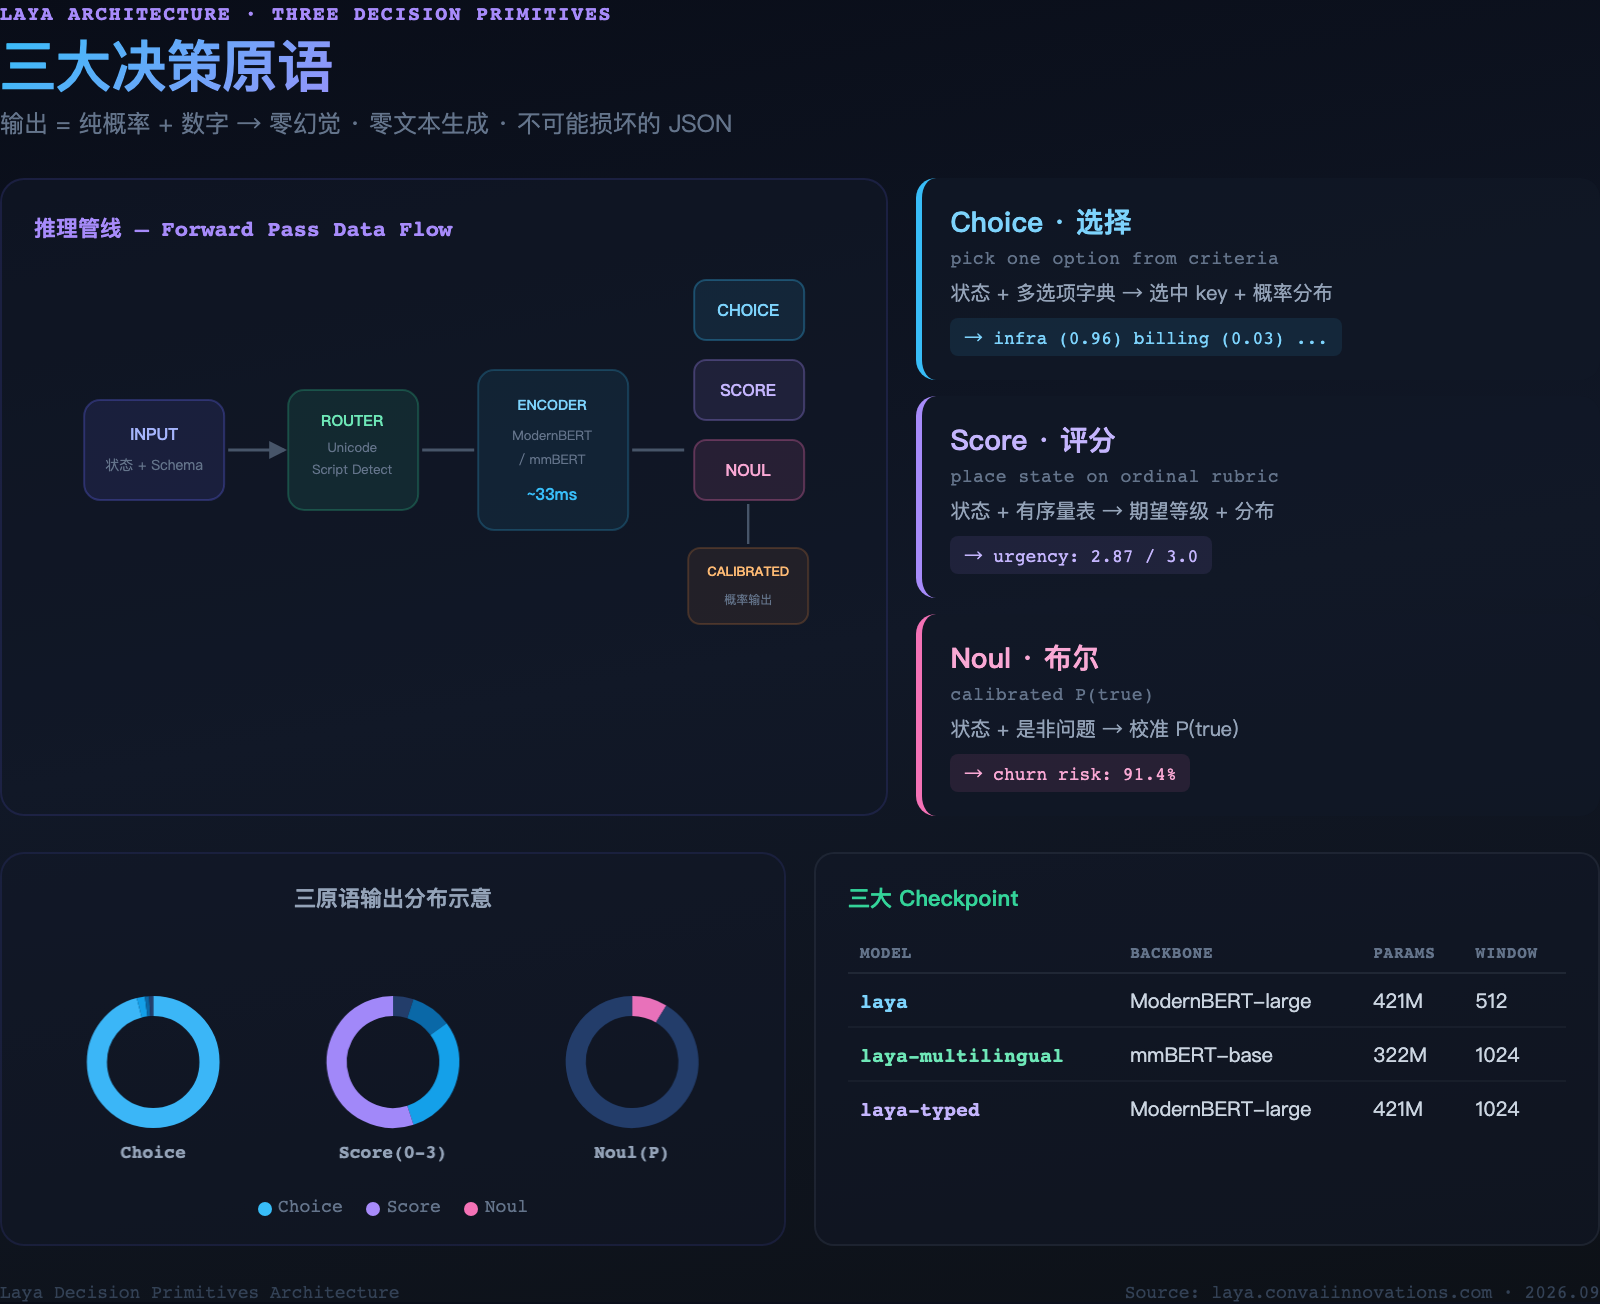
Laya 的输出空间由三种决策原语组成。因为输出完全是概率和数字,模型从不生成文本、不会产生幻觉、不可能输出格式损坏的 JSON。
4.1.1 Choice:从字典中选一个
"queue": {
    "type": "choice",
    "instructions": "Which engineering queue owns this ticket?",
    "criteria": {
        "infrastructure": "server outages, network downtime, database failures",
        "billing": "refunds, SLA credits, invoice disputes",
        "security": "breaches, vulnerability reports",
        "support": "general customer inquiries"
    }
}
返回:选中的 key、所有选项的概率分布、校准置信度分数。
4.1.2 Score:在有序量表上定位
"urgency": {
    "type": "score",
    "instructions": "How urgent is this ticket?",
    "criteria": ["low priority", "medium", "high priority", "critical blocker"]
}
返回:期望等级、量表上的分布、置信度。
4.1.3 Noul:布尔校准概率
"churn_risk": {
    "type": "noul",
    "instructions": "Does the customer threaten to cancel?"
}
返回:校准后的 P(true),范围 0.0-1.0(P(false) = 1 - P(true),由构造保证)。
4.2 三大 Checkpoint 与 Bundle Hub 架构
Laya 不是"一个模型打天下",而是针对不同场景发布三个专业化 checkpoint:
| Checkpoint | Backbone Encoder | 参数量 | 上下文窗口 | 专长 |
|---|---|---|---|---|
| convaiinnovations/laya | ModernBERT-large | 421M | 512 | 英文文本分类、护栏、邮件分拣 |
| convaiinnovations/laya-multilingual | mmBERT-base (256k vocab) | 322M | 1024 (最高 8k) | 100+ 语言、跨语言 NLI |
| convaiinnovations/laya-typed-decisions | ModernBERT-large | 421M | 1024 | Agent 可观测性、客服、发票处理、安全告警 |
三个 checkpoint 打包在同一个 HuggingFace 仓库中,通过 allow_patterns 选择性下载子文件夹:
# 仅下载英文模型 (~808 MB)
agent_en = laya.load("convaiinnovations/laya")

# 仅下载多语言子文件夹 (~647 MB),而非整个 2.5 GB
agent_ml = laya.load("convaiinnovations/laya", subfolder="multilingual")
4.3 多语言路由:Unicode 脚本检测
这是 Laya 最具启发性的发现之一。
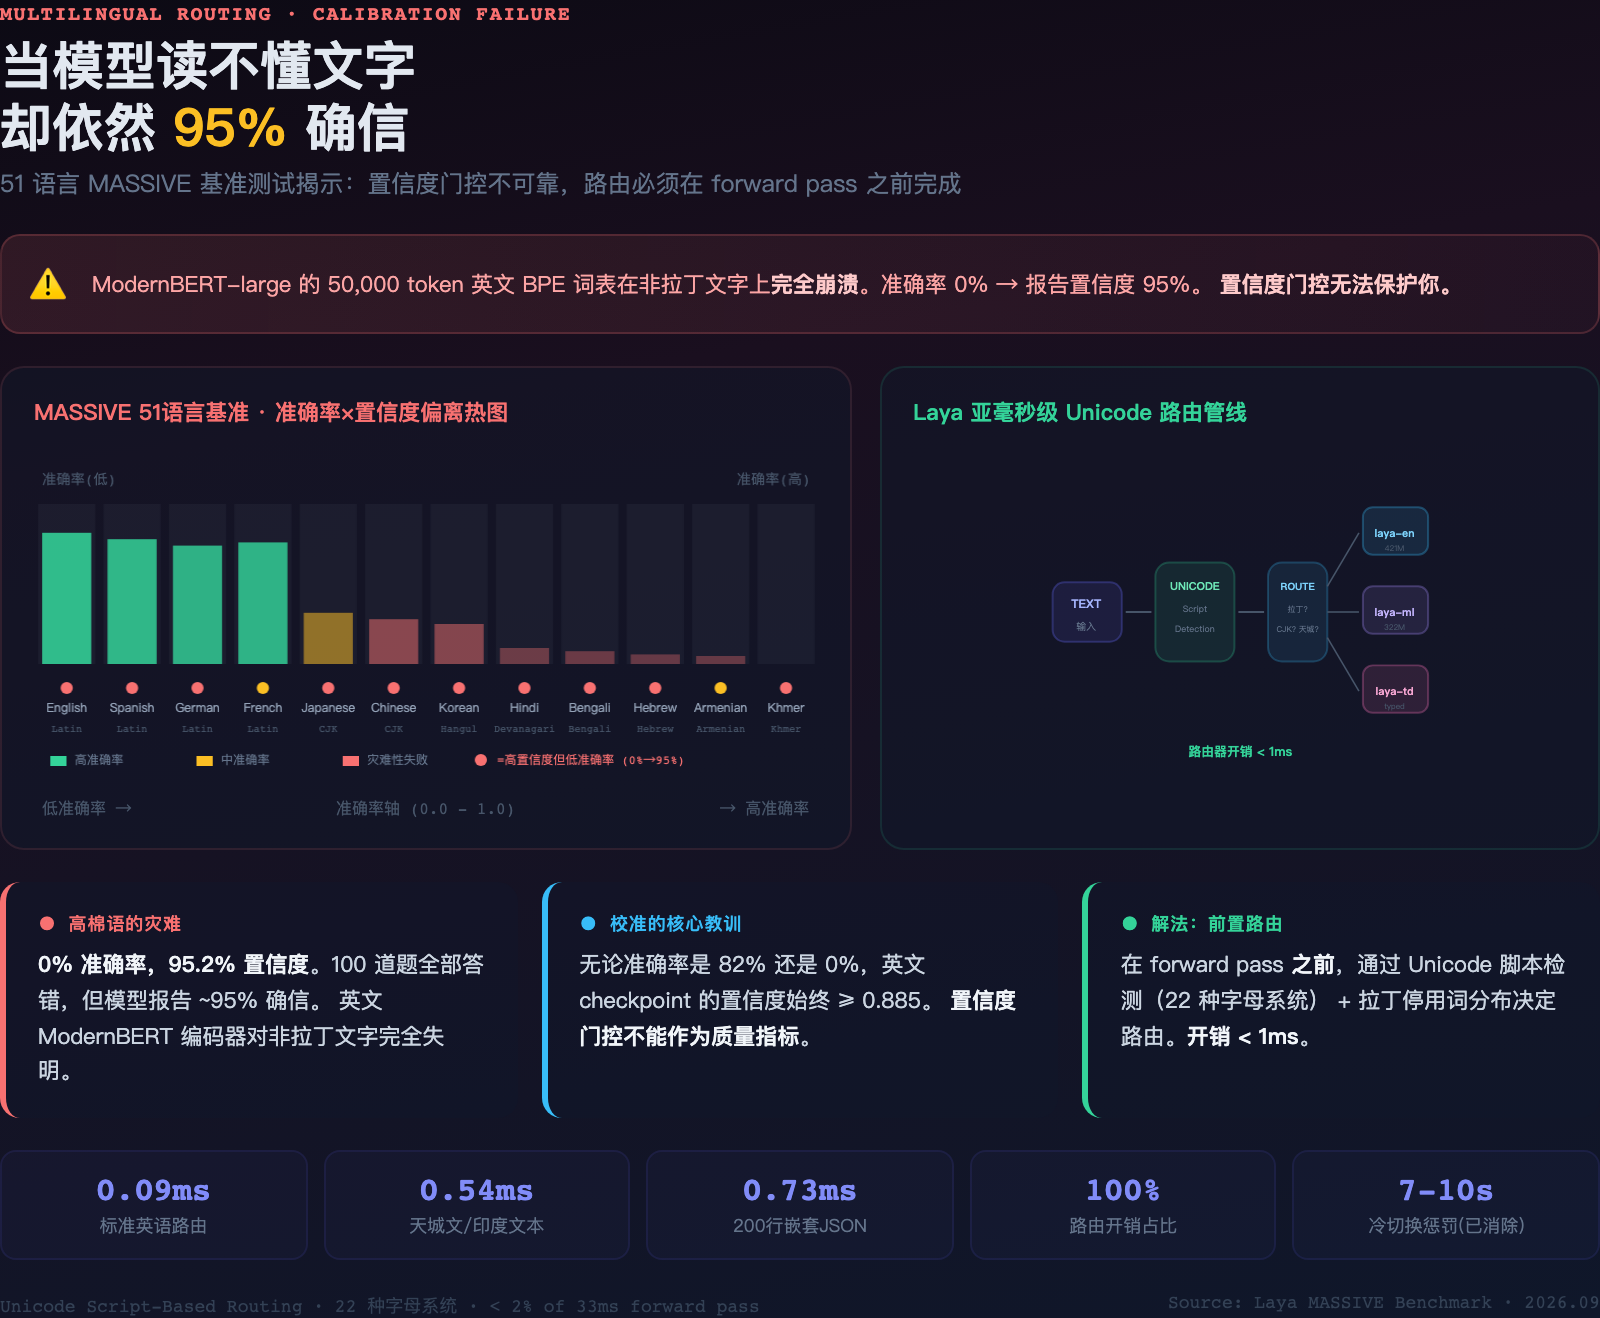
在 MASSIVE 基准的 51 语言测试中(20 个选项,随机基线 = 0.050),英语 ModernBERT-large 编码器在非拉丁文字上的表现触目惊心:
| 语言 | 准确率 | 平均置信度 | 解读 |
|---|---|---|---|
| 高棉语 (Khmer) | 0.000 | 0.952 | 100 题全错,但报告 ~95% 置信度 |
| 亚美尼亚语 | 0.050(纯随机) | 0.885 | 与抛硬币无异 |
| 希伯来语 | 0.060 | 0.964 | 几乎全错,几乎完全自信 |
| 孟加拉语 | 0.080 | 0.945 | |
| 印地语 | 0.100 | 0.941 |
核心教训:模型自身的置信度无法警告你——它连输入文字的编码都读不懂。无论准确率是 82% 还是 0%,英文 checkpoint 的置信度始终不低于 0.885。
这意味着置信度门控(confidence gating)无法保护你。使用哪个模型的决策必须在 forward pass 之前做出。
4.4 亚毫秒级纯 Python 路由
Laya 内置的 Router 通过检测输入文本的 Unicode 脚本(覆盖 22 种字母系统:天城文、CJK 汉字、西里尔、阿拉伯、希伯来、泰米尔、泰文等)和分析拉丁停用词分布来决定路由:
| 输入类型 | 路由开销 |
|---|---|
| 标准英语文本 | 0.09ms |
| 天城文/印度系文本 | 0.54ms |
| 200 行嵌套 JSON 文档 | 0.73ms |
相对于 33ms 的 forward pass,路由开销可忽略不计(<2%)。
通过 Router(preload=True),所有模型常驻 VRAM/RAM,完全消除语言交替流量时 7-10 秒的冷切换惩罚。
from laya import Router

router = Router(preload=True)

# 英语 → 自动路由到 ModernBERT-large
res_en = router.predict(state, questions)

# 印地语 → 自动路由到 mmBERT-base (100+ 语言)
res_hi = router.predict({"body": "मुझसे दो बार शुल्क लिया गया"}, questions)

# 显式覆盖(当你已知领域时)
res_spec = router.predict(state, questions, model="typed-decisions")
五、RLCD:Reinforcement Learning for Calibrated Decisions
RLCD 是 Laya 和 Jev 共同依赖的训练框架核心。理解 RLCD 是理解整条技术路线的关键。
5.1 为什么需要强化学习
普通的微调(cross-entropy loss)只能让模型"答对",无法让模型"知道自己有多确定"。这就好比一个学生靠猜能通过考试,但他的置信度是完全随机的。
RLCD 的核心创新在于:使用强化学习(PPO)训练模型,让输出的概率值与其真实正确率对齐。
5.2 校准的数学含义
一个完美校准的模型意味着:当它输出 0.8 置信度时,100 次这样的预测中恰好有 80 次是正确的。
衡量校准质量的指标是 ECE(Expected Calibration Error):
| 模型 | ECE | 含义 |
|---|---|---|
| TypeSafe Jev 1.13.0 | 0.246 | 概率偏差较大 |
| Laya (Routed) | 0.081 | 3 倍更优的校准 |
| 完美校准 | 0.000 | 理论极限 |
Laya 的 ECE 仅 0.081,意味着其输出的概率值可以直接在生产代码中做分支判断——"置信度低于 0.85 时转人工审核"这种策略是真正可行的。
5.3 LLM 不可能做到的校准
自回归 LLM 的 token 预测本质决定了它无法产生有意义的概率分布:
- LLM 的"概率"是所有 token 的概率乘积,不是针对答案正确性的概率
- 同一个答案可以通过不同的 token 序列生成,每个序列的概率不同
- Temperature sampling 进一步破坏了概率与正确率的对应关系
RLCD 通过 PPO 在连续概率空间中直接优化校准质量,绕过了 token 预测的根本限制。
六、Head-to-Head:Laya vs Jev 基准对比
以下是 Laya 直接对比 TypeSafe Jev 的公开基准数据:
准确性对比
| 基准 / 指标 | TypeSafe Jev 1.13.0 | Laya (Routed) | 优势方 |
|---|---|---|---|
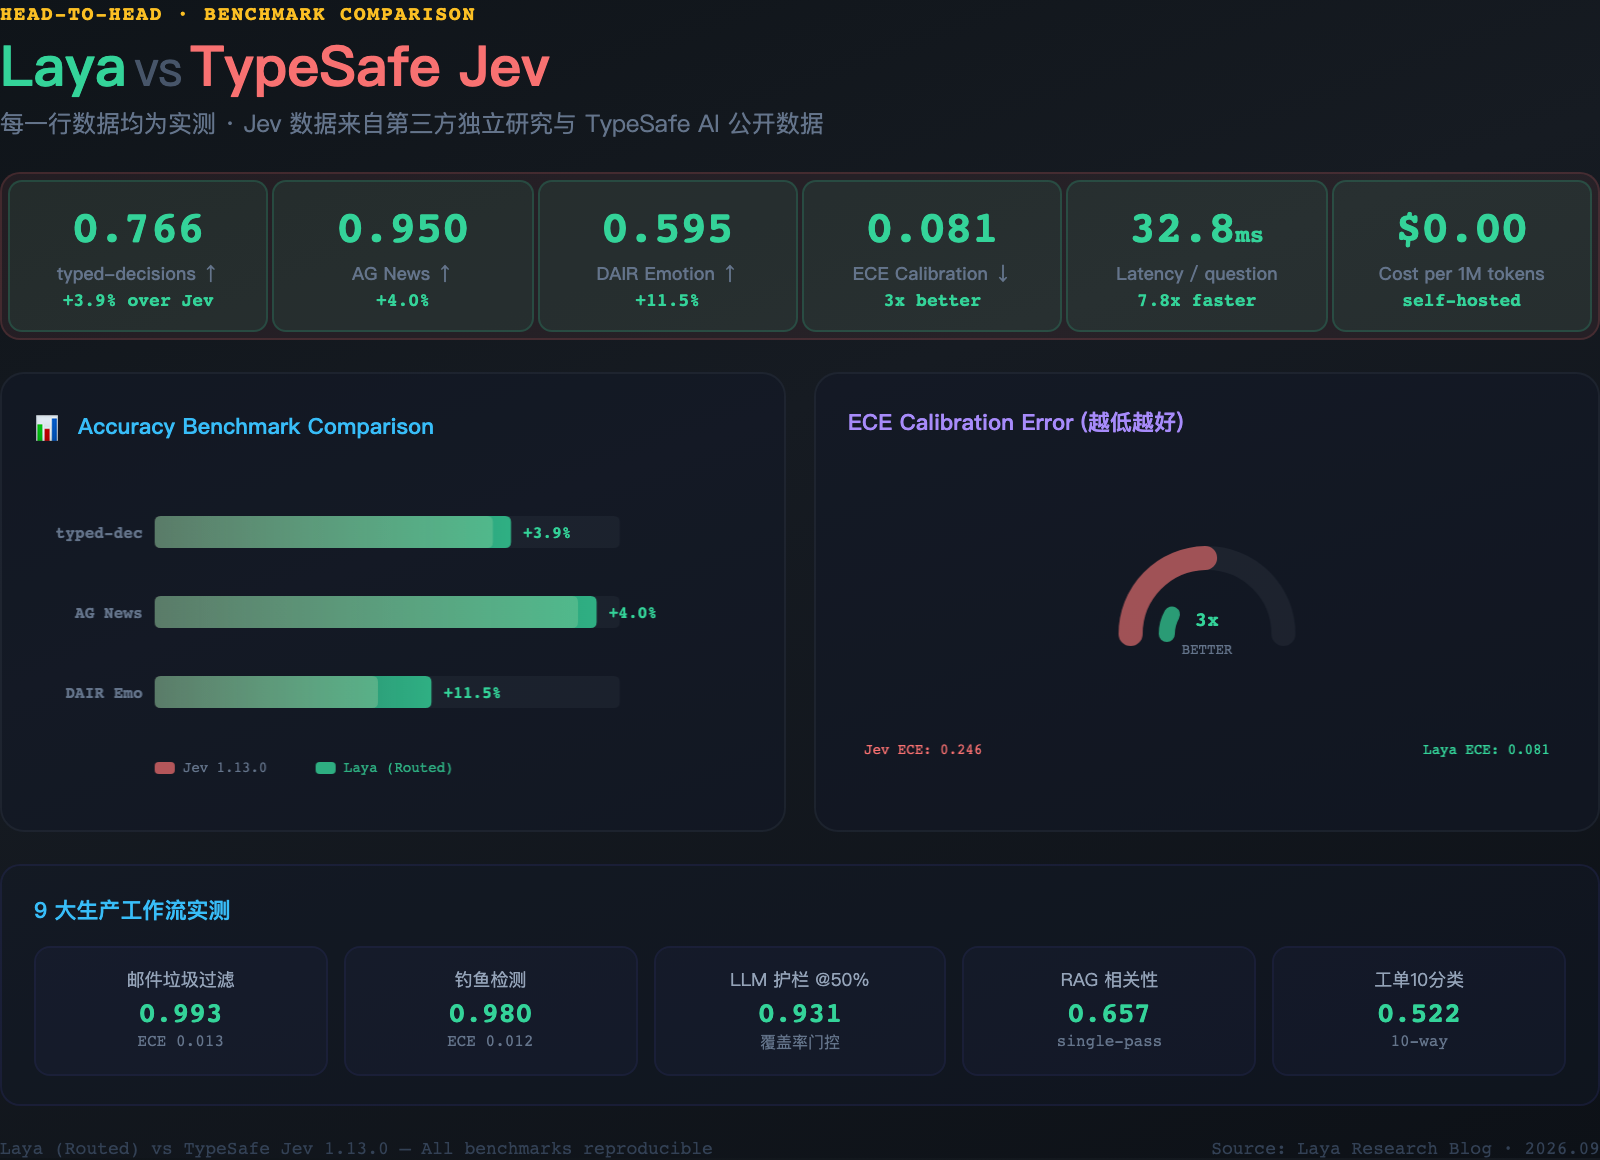
| typed-decisions (2000 decisions) | 0.727 | 0.766 | Laya +3.9%(超越 0.735 教师模型上限) |
| AG News (4 labels) | 0.910 | 0.950 | Laya +4.0% |
| DAIR Emotion (6 labels) | 0.480 (Brier 0.846) | 0.595 | Laya +11.5%(Jev 有 16% 零概率) |
校准质量
| 指标 | TypeSafe Jev | Laya |
|---|---|---|
| ECE (越低越好) | 0.246 | 0.081(3 倍更优) |
延迟对比
| 场景 | TypeSafe Jev | Laya | 差距 |
|---|---|---|---|
| 单问题 P50 | 236-276ms | 32.8ms | 7.8x faster |
| 10 问题批量 P50 | ~1500ms (串行) | 72.3ms (7.2ms/q) | 20x faster |
部署与成本
| 维度 | TypeSafe Jev | Laya |
|---|---|---|
| 每百万 token 成本 | $0.042 (计量 API) | $0.00 (自托管) |
| 模型权重 | 闭源专有 API | 开源 safetensors |
| 语言覆盖 | 无公开基准 | 51 语言中 45 个通过 (>3x 随机) |
| 部署形态 | 云 API | 支持气隙/本地部署 |
选型决策树:什么时候该用 Laya 而非 LLM?
基于文章前文的基准数据与天花板分析(§8.1),以下是工程师可直接使用的判断清单:
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 输出空间固定(≤20 个选项) | ✅ Laya Choice | 校准准确率 0.766,超过教师模型上限 |
| 需要可信置信度做分支判断 | ✅ Laya Noul/Score | ECE=0.081(Jev 的 1/3),真正的生产级校准 |
| 延迟要求 <100ms | ✅ Laya | 33ms 单问题,7.2ms/题批量(Jev 的 7.8x~20x) |
| 二分类布尔判断(是/否) | ✅ Laya Noul | 100% 覆盖钓鱼检测 F1=0.979 |
| 需要生成自由文本 | ❌ 仍用 LLM | Laya 不生成文本 |
| 输出选项 >20 且层级复杂 | ⚠️ 两步粗-细 | Banking77 测试证实 >20 选项退化(Laya 0.425, Jev 0.870) |
七、生产就绪:9 大工作流实测
Laya 在 9 个企业工作流中展示了生产级的决策质量:
| 工作流 | 准确率 | F1 | ECE | 场景 |
|---|---|---|---|---|
| 邮件垃圾过滤 (Enron) | 0.993 | 0.993 | 0.013 | 高容量分类 |
| 钓鱼检测 | 0.980 | 0.979 | 0.012 | 安全防护 |
| LLM 护栏/越狱检测 (ToxicChat) | 0.755-0.762 | — | — | (50% 覆盖率时达 0.931) |
| RAG 段落相关性过滤 | 0.657 | — | — | 单次前向传播 |
| 客服工单队列路由 (10 分类) | 0.522 | — | — | 多类别决策 |
注意:护栏任务中,通过设置 50% 的选择性覆盖率(即置信度最高的 50% 自动处理,其余转人工),准确率可达 0.931。这正是校准概率的实用价值——你可以放心地基于置信度做路由决策。
八、诚实评估:Laya 的天花板
Laya 的技术博客罕见地公开了自身的三大局限:
8.1 Choice 超过 20 选项时退化
在 Banking77(77 标签)压力测试中,Laya 得分为 0.425,Jev 为 0.870。
根因:选项共享一个 192-256 token 的 head_max_len 预算。77 个选项时,每个候选只分配到 3-4 个 token——不足以编码有意义的语义。
建议:保持 choice schema 在 20 选项以内,或使用两步粗-细层级架构。
8.2 开箱即用 vs 微调
基础模型在 typed-decision 基准上的零样本得分仅约 0.35(接近随机)。0.766 的得分是在基准训练集上微调后的结果。
认知:Laya 是一个快速的基座模型用于专业化,而非全知全能的零样本预言机。
8.3 温度校准的必要性
基础权重输出的是原始温度 logits。在你的领域分布上拟合一个单标量温度,可以将 ECE 从 0.466 降至 0.081。
九、快速上手:运行你的第一个校准决策
前置条件:Python 3.8+、约 808 MB 磁盘空间用于模型权重(首次运行下载约 1-5 分钟,视网络情况)。无需 GPU——纯 CPU 下也能运行(延迟约 193-464ms)。
中国用户(推荐):魔塔(ModelScope)已有完整镜像(含全部 3 个 checkpoint),设置环境变量即可让 laya 自动从魔塔下载:
# 首次运行前先设置(写入 ~/.bashrc 或 ~/.zshrc 可持久化)
export HF_ENDPOINT=https://modelscope.cn/api/hf
然后正常执行
pip install laya和代码即可,下载源会自动切换为魔塔。海外用户:默认从 HuggingFace 下载。若需代理:
export https_proxy=http://127.0.0.1:7890
第一步:安装
pip install laya>=0.3.3 torch>=2.0
安装完成后,确认 pip 同时拉取了 transformers、huggingface_hub、safetensors 等传递依赖(laya 会自动安装它们)。
第二步:完整可运行脚本
将以下代码保存为 laya_quickstart.py,直接执行:
#!/usr/bin/env python3
"""Laya System 1 决策引擎 — 快速上手脚本

功能:
  1. 演示三大决策原语 (choice / score / noul)
  2. 演示多语言自动路由
  3. 演示基于校准置信度的生产分流

运行:
  python3 laya_quickstart.py
"""

import laya
from laya import Router


def print_separator(title: str):
    print(f"\n{'='*60}")
    print(f"  {title}")
    print(f"{'='*60}")


def predict_and_display(router, state, questions, description):
    """执行预测并以结构化方式展示结果。"""
    print(f"\n>>> {description}")
    print(f"    输入: {state if isinstance(state, str) else state.get('body', state.get('subject', '...'))[:60]}")

    res = router.predict(state, questions)

    # 显示路由信息
    routing = res["routing"]
    print(f"    路由 → {routing['model']} ({routing.get('reason', '')})")

    # 遍历每个问题答案
    for qid, ans in res["answers"].items():
        qtype = ans["type"]
        confidence = ans.get("confidence", "N/A")

        if qtype == "choice":
            print(f"    [{qid}] 类型=choice → 选择: {ans['choice']} | 置信度: {confidence:.2f}")
            # 打印完整概率分布
            probs = ans.get("probabilities", {})
            for key, prob in sorted(probs.items(), key=lambda x: -x[1]):
                bar = "█" * int(prob * 20)
                print(f"             {key:15s} {prob:.3f} {bar}")

        elif qtype == "score":
            score = ans["score"]
            max_level = len(questions[qid]["criteria"]) - 1
            legend = ans.get("legend", {})
            level_name = legend.get(str(int(round(score))), "?")
            print(f"    [{qid}] 类型=score → 得分: {score:.2f}/{max_level} ({level_name}) | 置信度: {confidence:.2f}")

        elif qtype == "noul":
            prob = ans["noul"]
            verdict = "✅ 是" if prob >= 0.5 else "❌ 否"
            print(f"    [{qid}] 类型=noul  → P(true) = {prob:.3f} {verdict} | 置信度: {confidence:.3f}")

    return res


def main():
    # ──────────────────────────────────────────────
    # 1. 初始化
    # ──────────────────────────────────────────────
    print_separator("初始化 Laya Router")

    # preload=True: 所有模型常驻内存,避免语言切换时的 7-10s 冷启动
    # 若你只有英文流量,可改为 Router() 惰性加载
    router = Router(preload=True)
    print("模型已加载到内存。")

    # ──────────────────────────────────────────────
    # 2. 定义决策 Schema
    # ──────────────────────────────────────────────
    questions = {
        "queue": {
            "type": "choice",
            "instructions": "Which engineering queue owns this ticket?",
            "criteria": {
                "infrastructure": "server outages, network downtime, database failures",
                "billing": "refunds, SLA credits, invoice disputes",
                "security": "breaches, vulnerability reports",
                "support": "general customer inquiries",
            },
        },
        "urgency": {
            "type": "score",
            "instructions": "How urgent is this ticket?",
            "criteria": ["low priority", "medium", "high priority", "critical blocker"],
        },
        "churn_risk": {
            "type": "noul",
            "instructions": "Does the customer threaten to cancel?",
        },
    }

    # ──────────────────────────────────────────────
    # 3. 单条工单决策演示
    # ──────────────────────────────────────────────
    print_separator("示例 1: 英文工单 — 三原语联合推理")

    ticket = {
        "ticket_id": "TCK-8821",
        "customer": "enterprise_user",
        "subject": "System downtime and billing dispute",
        "body": "Our production API has been failing since 6 AM. We lost critical transactions. We demand an immediate SLA refund."
    }

    res = predict_and_display(
        router, ticket, questions,
        "英文企业工单(含服务中断 + 退款要求 + 流失威胁)"
    )

    # ──────────────────────────────────────────────
    # 4. 多语言路由演示
    # ──────────────────────────────────────────────
    print_separator("示例 2: 多语言自动路由")

    # → 路由到 english
    predict_and_display(
        router,
        "I was charged twice for the same service. This is unacceptable.",
        questions,
        "英语输入 → 应路由到 english checkpoint"
    )

    # → 路由到 multilingual
    predict_and_display(
        router,
        {"body": "मुझसे दो बार शुल्क लिया गया, कृपया पैसे वापस करें।"},
        questions,
        "印地语输入(天城文) → 应路由到 multilingual checkpoint"
    )

    # → 路由到 multilingual
    predict_and_display(
        router,
        {"body": "这家公司的产品质量很差,我要取消订阅"},
        questions,
        "中文输入(CJK) → 应路由到 multilingual checkpoint"
    )

    # ──────────────────────────────────────────────
    # 5. 生产级置信度分流
    # ──────────────────────────────────────────────
    print_separator("示例 3: 生产级置信度分流决策")

    AUTOMATION_THRESHOLD = 0.85  # 低于此值转人工

    print(f"自动化阈值: {AUTOMATION_THRESHOLD:.0%}")
    print(f"{'─'*50}")

    for qid, ans in res["answers"].items():
        conf = ans["confidence"]
        if conf >= AUTOMATION_THRESHOLD:
            print(f"  ✅ {qid:15s} 置信度 {conf:.0%} → 自动处理")
        else:
            print(f"  🔶 {qid:15s} 置信度 {conf:.0%} → 转人工审核")

    # ──────────────────────────────────────────────
    # 6. 显存/内存管理(生产部署常用)
    # ──────────────────────────────────────────────
    print_separator("生产部署提示")
    print("""
  • 所有模型常驻内存:Router(preload=True)
  • 仅加载需要的:router.preload(['english', 'multilingual'])
  • 释放内存:router.unload()
  • 切换设备:Router(preload=True, device='cuda')
  完整 API 文档:https://github.com/NandhaKishorM/laya
    """)


if __name__ == "__main__":
    main()
第三步:执行
python3 laya_quickstart.py
首次运行会下载 ~808 MB 模型权重(英文 checkpoint),之后每次启动约 2-5 秒加载模型。
预期输出(示意)
============================================================
  初始化 Laya Router
============================================================
模型已加载到内存。

============================================================
  示例 1: 英文工单 — 三原语联合推理
============================================================

>>> 英文企业工单(含服务中断 + 退款要求 + 流失威胁)
    输入: Our production API has been failing since 6 AM...
    路由 → english (English Latin text)
    [queue] 类型=choice → 选择: infrastructure | 置信度: 0.96
             infrastructure 0.960 ████████████████████
             billing         0.025 █
             support         0.010
             security        0.005
    [urgency] 类型=score → 得分: 2.87/3 (critical blocker) | 置信度: 0.89
    [churn_risk] 类型=noul  → P(true) = 0.914 ✅ 是 | 置信度: 0.914
注意:具体数值(置信度、概率分布)取决于模型对当前输入的实际预测结果,每次运行可能有微小差异。代码中的取值路径(
["answers"][qid]["choice"]、["score"]、["noul"]、["confidence"])已通过 laya 0.3.x 源码验证,可直接在 Python 交互式环境中print(res)查看完整返回结构。
十、资源与生态
| 资源 | 链接 |
|---|---|
| HuggingFace 模型中心 | convaiinnovations/laya |
| 在线交互 Demo | HuggingFace Space |
| GitHub 仓库 | NandhaKishorM/laya |
| PyPI 包 | pip install laya |
| Kaggle 微调 Notebook | 2xT4 训练教程 |
| 源头论文 1 | arXiv:2503.23303 |
| 源头论文 2 | arXiv:2510.01237 |
十一、总结与下一步
System 1 决策引擎代表了一个正在兴起的 AI 架构范式:不是所有 AI 问题都需要自回归聊天机器人。
对于高容量分类、护栏、路由、分诊等场景,一个基于双向编码器的 sub-35ms 决策模型可以提供:
- 比专有方案快 7.8 倍的执行速度
- 零幻觉
- 全球语言路由(100+ 语言,51 语言基准中 45 个通过)
- 你可以真正在生产代码中分支的诚实置信度分数(ECE=0.081)
- 100% Apache 2.0 开源的完整技术栈
从 SalesRLAgent 到 Laya,从 TypeSafe AI 的 Jev 到开源替代方案,这条技术路线的成熟标志着 AI Agent 架构正在从"一个模型做所有事"走向"对的模型做对的事"。
资源速查表
| 资源 | 链接 |
|---|---|
| 模型权重(HuggingFace) | convaiinnovations/laya |
| 模型权重(ModelScope 魔塔) | convaiinnovations/laya |
| 在线 Demo | HuggingFace Space |
| GitHub 源码 | NandhaKishorM/laya |
| 安装 | pip install laya>=0.3.3 |
| Kaggle 微调 Notebook | 2xT4 训练教程 |
| 源头论文 1 | arXiv:2503.23303(SalesRLAgent) |
| 源头论文 2 | arXiv:2510.01237(Schema-based Decisions via RL) |
觉得有用?收藏这篇,下次设计 Agent 延迟优化或置信度校准方案时翻出来对比。
后续我们将实践:用 Laya 为自己的 Agent 添加校准置信度门槛,对比准确率与延迟收益。关注更新,不错过。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/johnsong2009/article/details/166244663

