

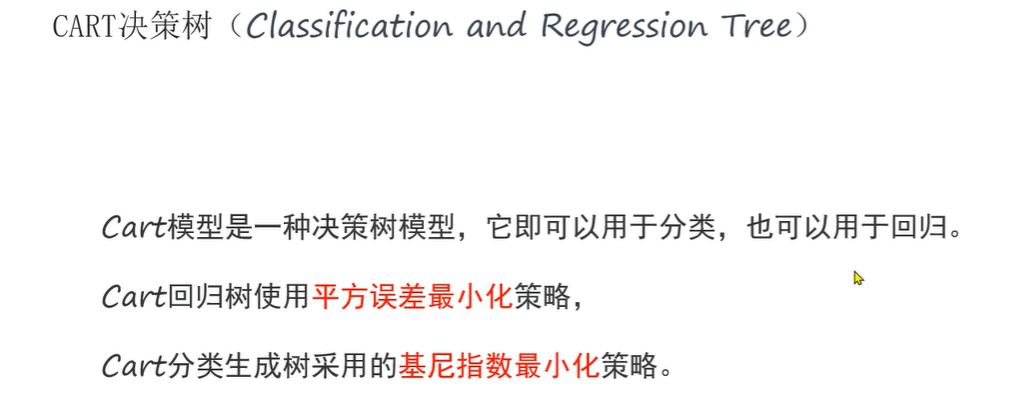
基尼值 等于 1 减去 每个类别概率的平方和
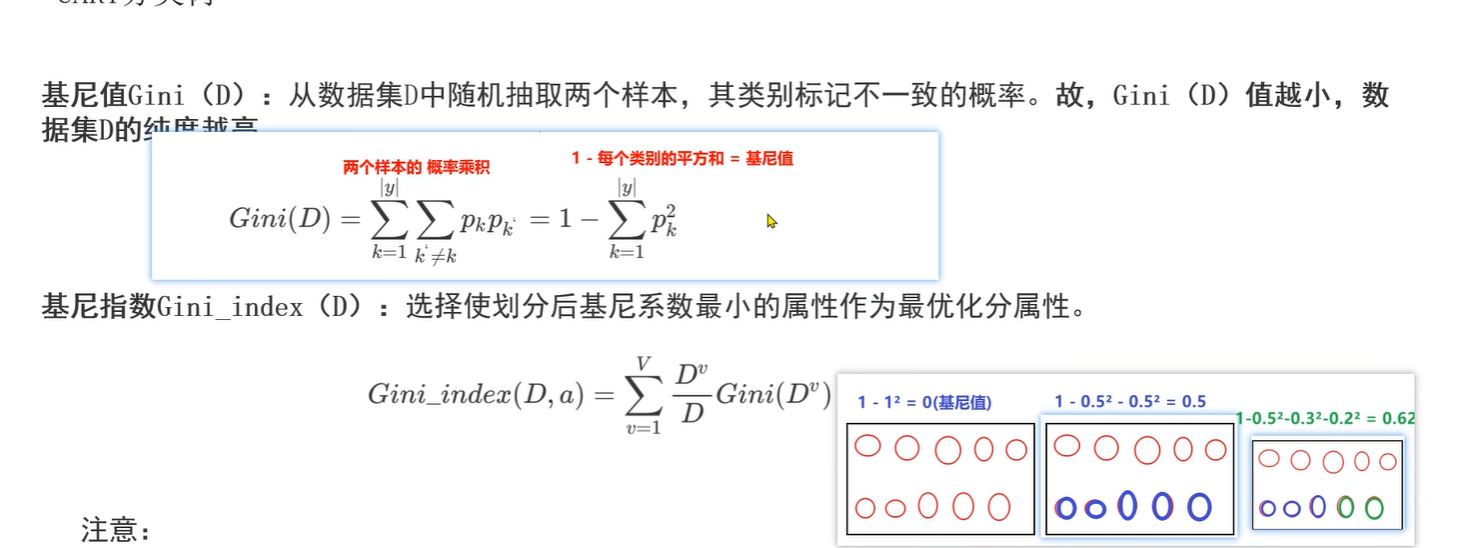
CART决策树分类树前置知识:
基尼值 等于 1 减去 每个类别对应各自标签概率的平方和(特征是分类的)
(这是算法二分,算法是算法,模型归类是模型归类.决策树分类器:可以处理数据是 分类的)
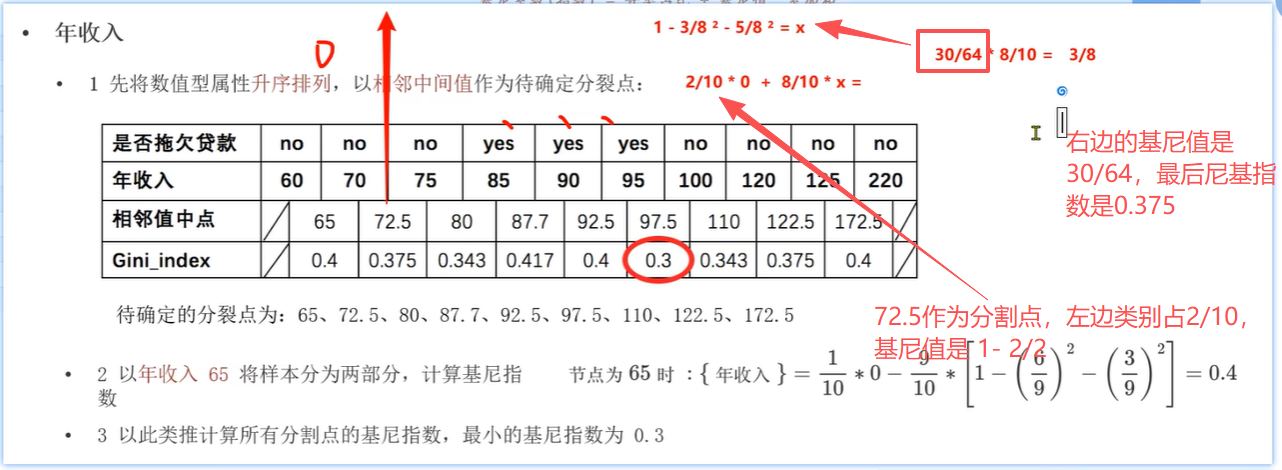
CART决策树回归树前置知识:
但是特征列不是分类,有线性,下面这个分二分算基尼指数就有意思
(这是算法二分,算法是算法,模型归类是模型归类.决策树回归器:可以处理数据是 回归的)
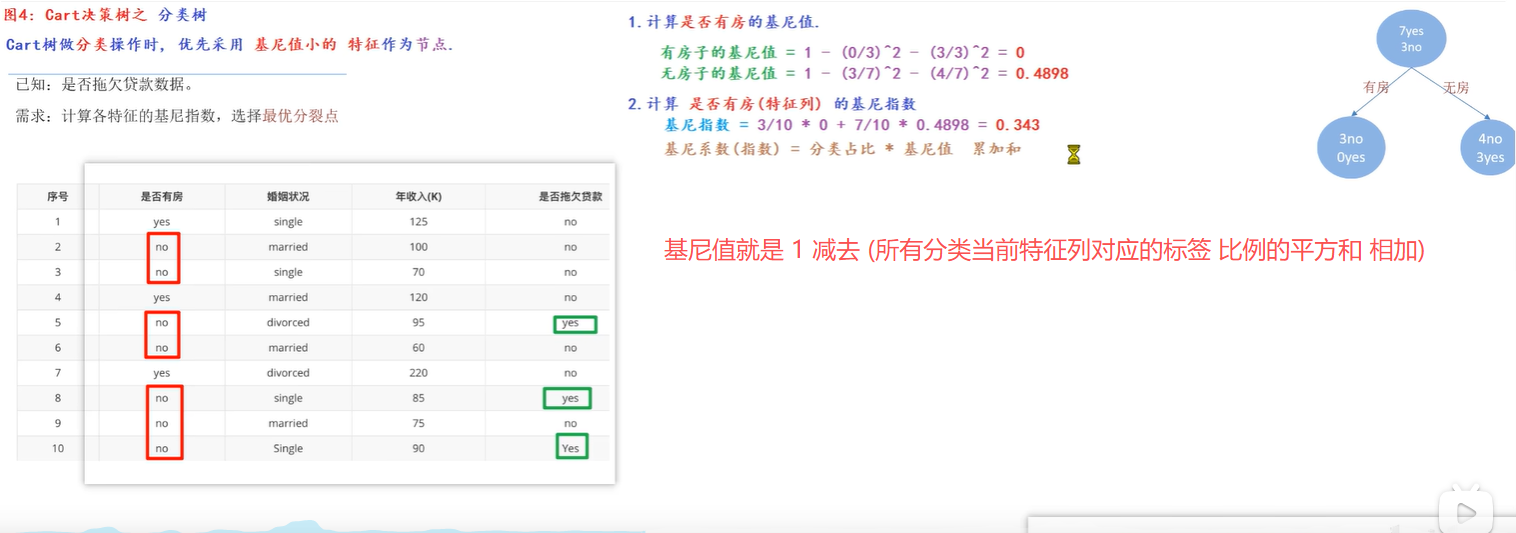
cart决策树的分类树
分别做各个特征的尼基系数,选择第一个特征做最有分裂点
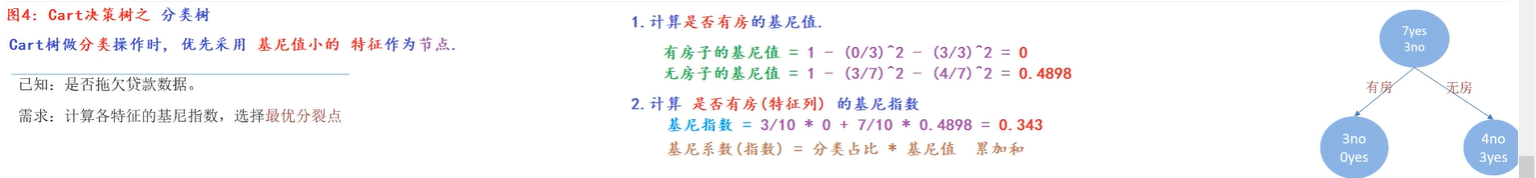
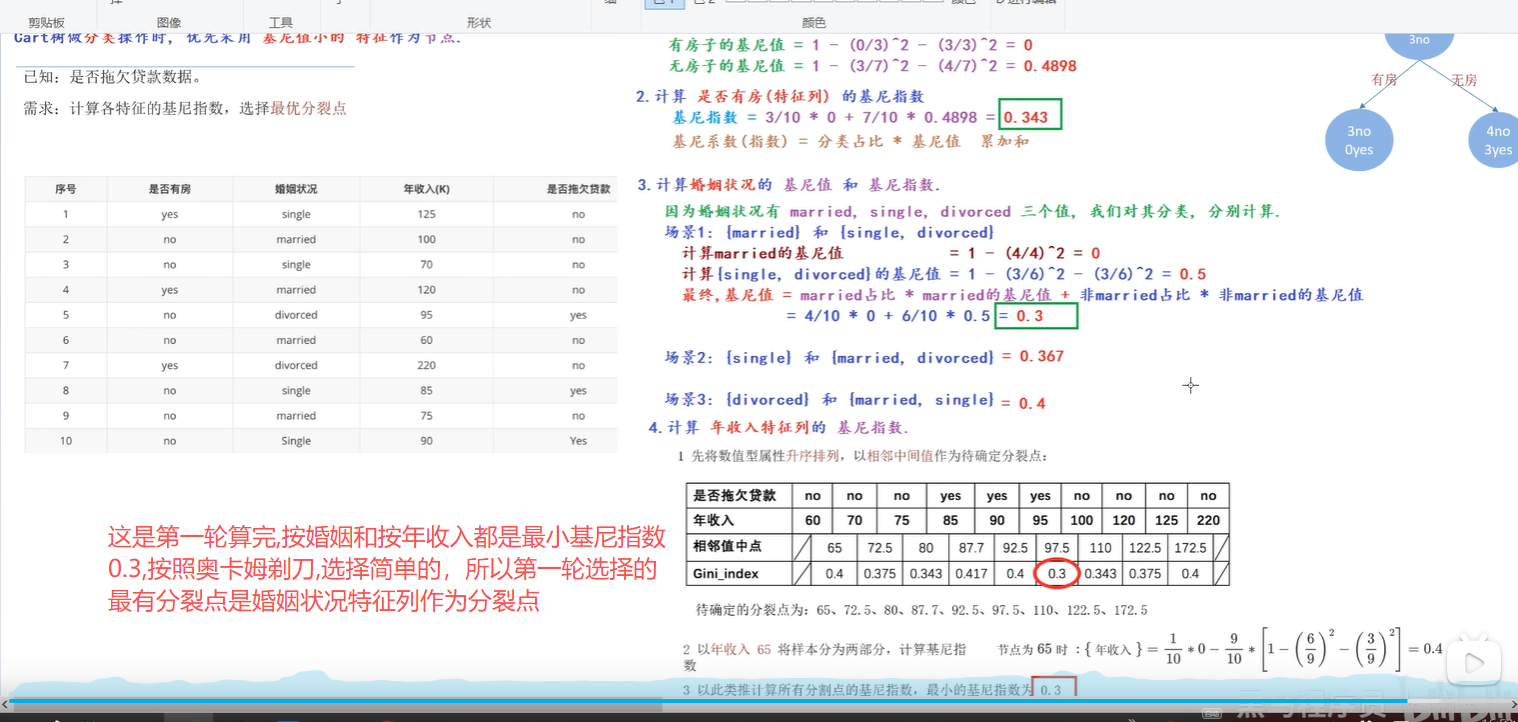
关于这个cart决策树的分类树 疑问一: 为啥选择婚姻要二分,不可以三分
这跟 CART 计算“纯度”的方式有关(就是本质算法问题)
- 如果是三分类:它的基尼指数计算公式是 =1−∑pi2,= 1 - \sum p_i^2 ,=1−∑pi2,这是针对多分类的
- CART 的二分类:它把多分类问题强制转化为二分类问题来计算基尼指数。比如:把 {married} 看作“正类”,把 {single, divorced} 看作“负类”,然后套用二分类的公式 1−p12−p22。1 - p_1^2 - p_2^2。1−p12−p22。
关于这个cart决策树的分类树 疑问一: 以婚姻特征项切分后,在单身和离异节点还可以再以婚姻特征切分吗
在被分出来的 {single, divorced} 这个数据子集里,完全可以继续用“婚姻”和“年收入”等特征,去计算谁是最小基尼系数,然后选最优的继续切。
- 在 CART 的默认规则里,同一个特征在同一条路径上,通常不会被重复使用来切分同一个节点。(
因为一旦在某个节点用“婚姻状况”切过,这个特征在该路径的后续节点里,往往已经“信息耗尽”,再切收益不大) - 但如果条件允许(比如允许特征复用),你是可以用“婚姻”再切一次,把 single 和 divorced 分开的。
举列子:
假设第一层切分后,我们拿到了这个子集:
子集:{single, divorced} 的人
特征:婚姻状况、年收入、是否拖欠贷款
算法会做的是:
- 遍历所有可用特征:婚姻状况、年收入、是否拖欠贷款。
- 对每个特征,穷举所有可能的二分组合,计算基尼指数
- 选基尼指数最小的那个特征和切分点,作为当前节点的分裂依据。
所以,“婚姻状况”确实会重新参与竞争,和“年收入”等特征一起比。
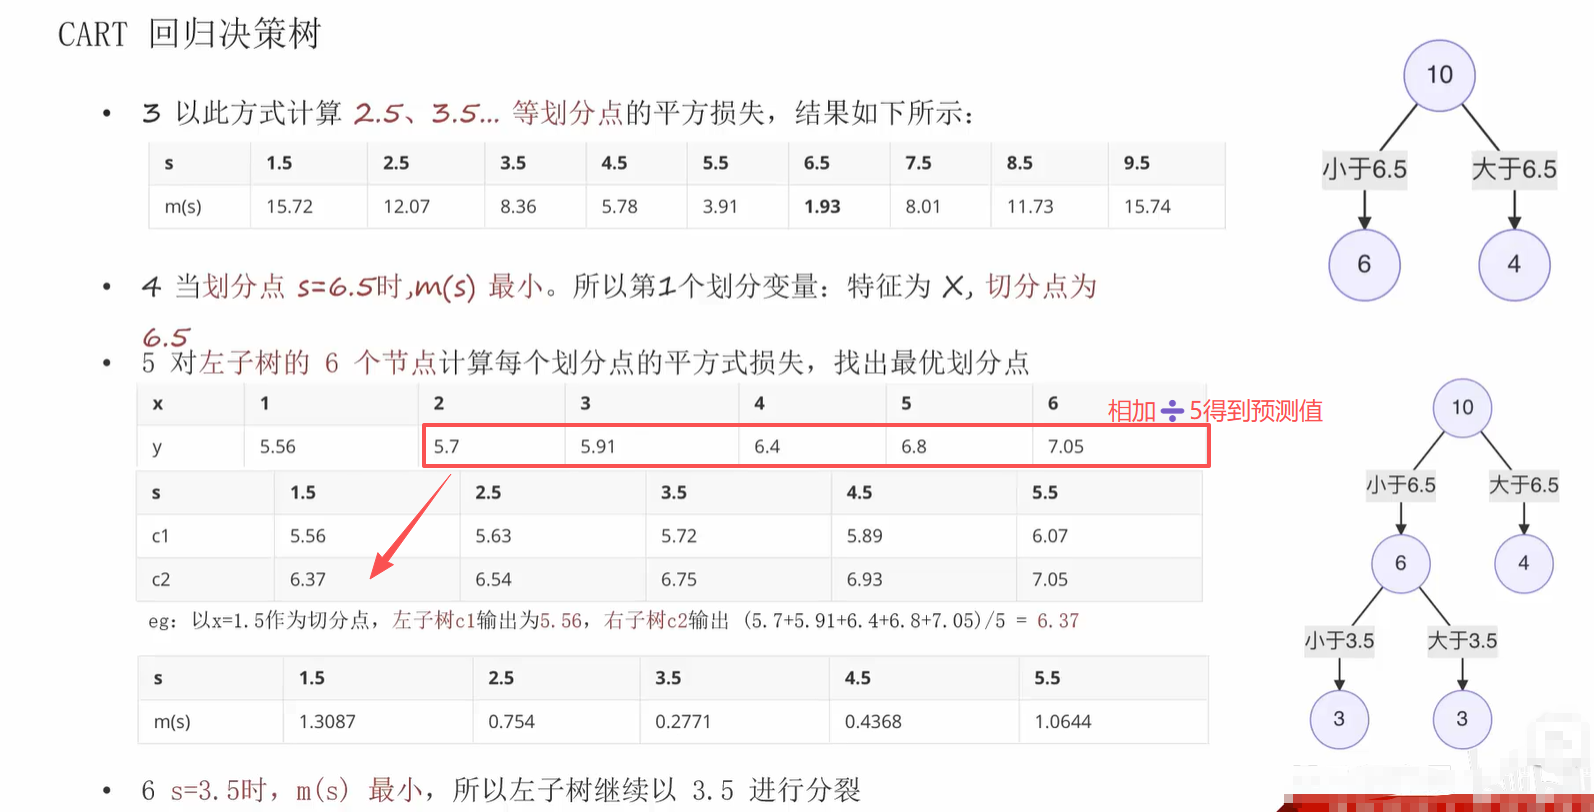
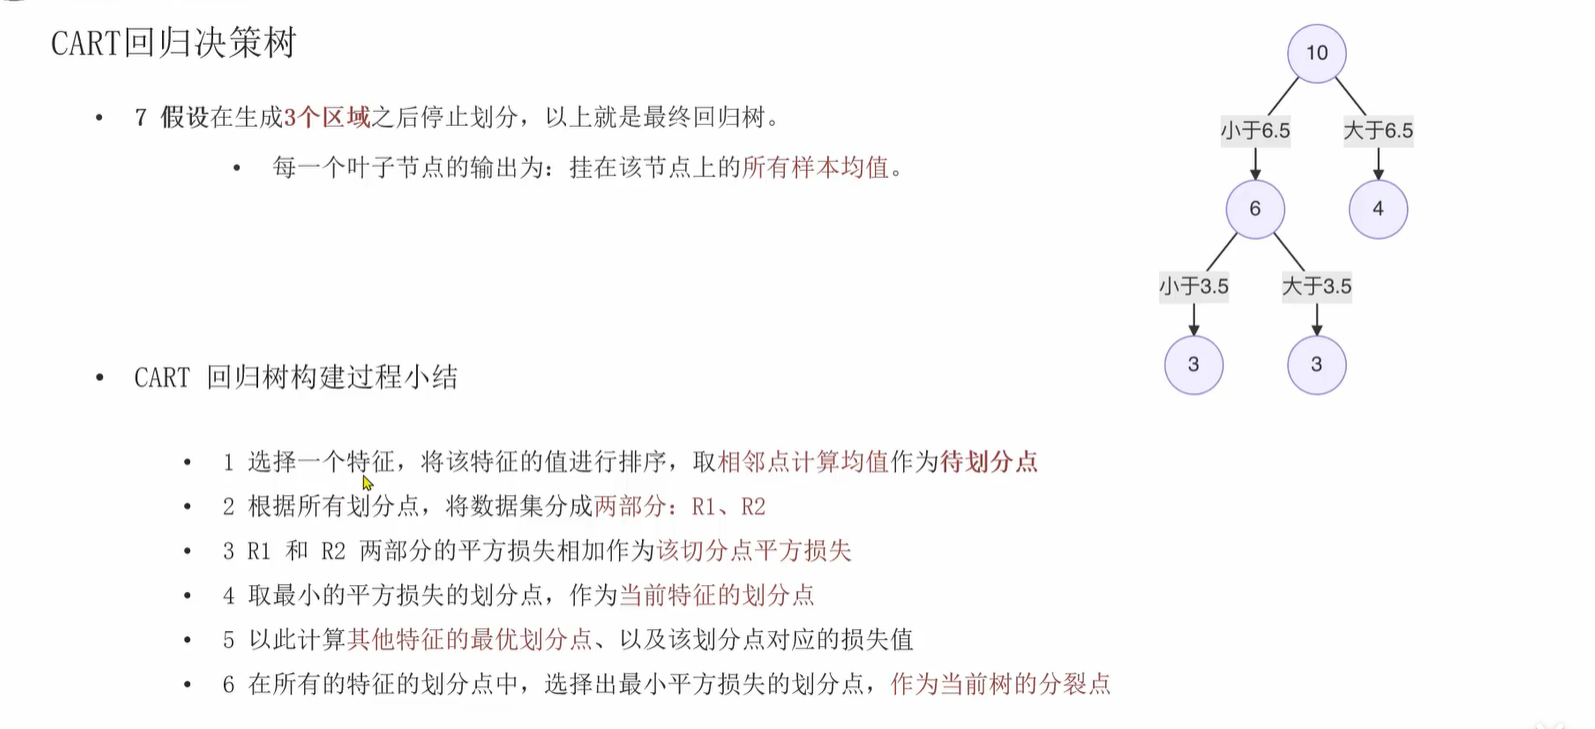
cart决策树的回归树
分别求出划分点左右两侧真实值的平均值作为预测值,然后让左右两侧各自真实值和真实值相减的平方相加(最小二乘)
找到最优划分点:就是损失函数最小值
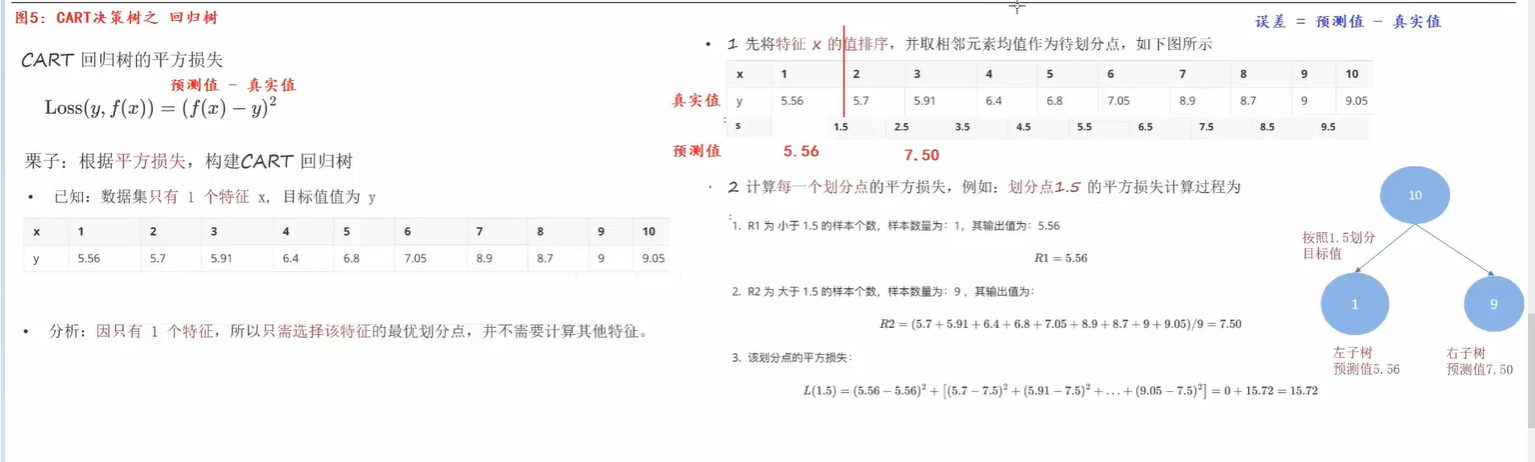
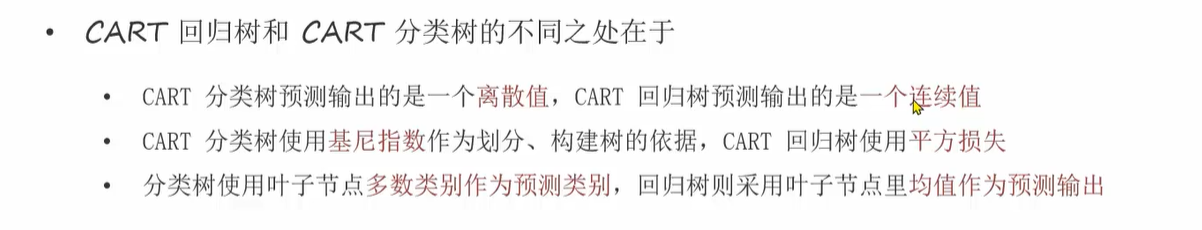
CART决策树 的回归树和分类树区别:
根本还是去划分点方式不同,因为处理数据不同,所以最后选择的划分依据算法不同,一个是基尼指数,一个是平方损失
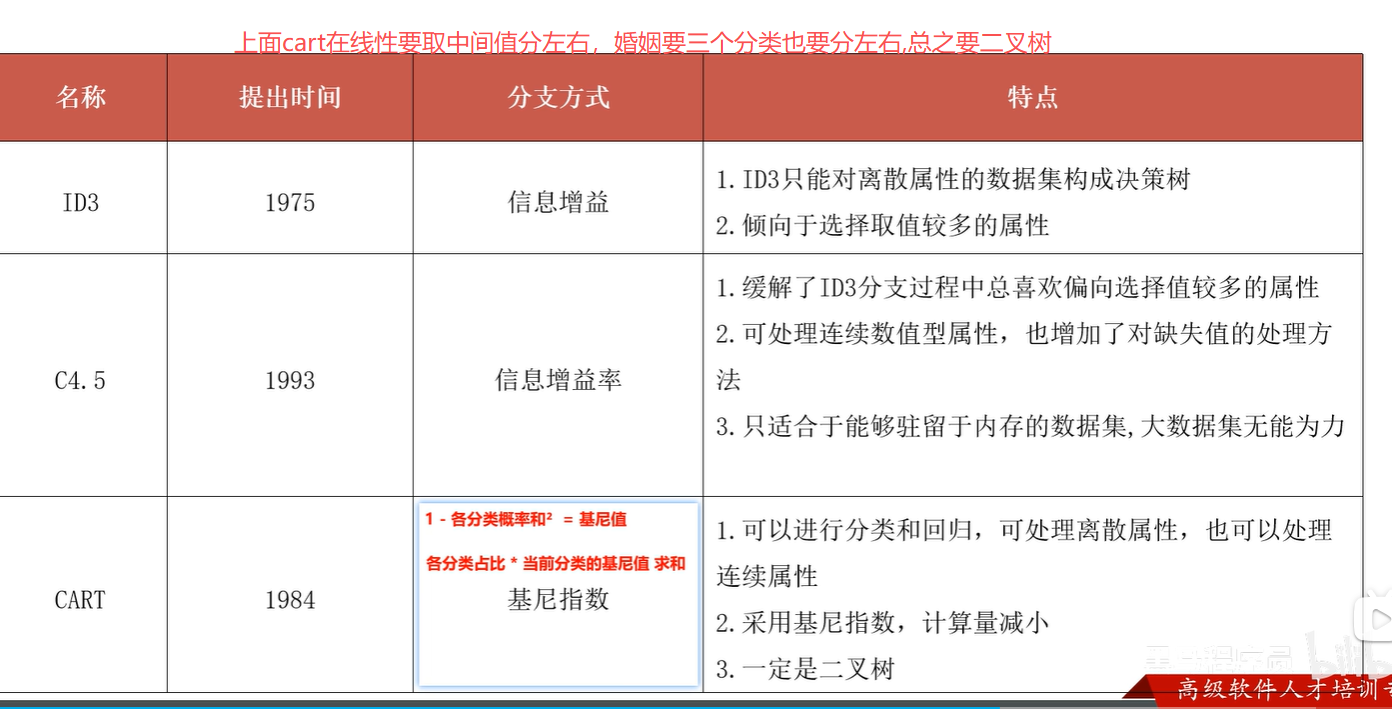
决策树总结
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/tellmewhoisi/article/details/164836064

