

基础不牢,地动山摇。
前面我们吃透了:
ArrayList(数组)、LinkedList(链表)
今天搞定 Java集合天花板:HashMap
它是工作使用率最高、面试提问最多、底层结构最复杂的集合。
今天我们从以下几个问题切入:
哈希冲突是什么?
为什么容量是2的幂?
什么时候转红黑树?
HashMap为什么线程不安全?
ConcurrentHashMap 怎么保证线程安全?
一起来学习一下,今天这篇零基础大白话 + 完整底层逻辑 + 面试闭环。
一、HashMap 是干嘛的?(通俗理解)
HashMap = 哈希表 + 键值对存储
特点:
- 根据 key 直接取值,查询速度极快 O(1)
- key 唯一、value可重复
- 无序存储
- 线程不安全
生活比喻:
ArrayList 是排队列表
HashMap 是档案柜,通过档案编号(hash值)直接找到对应文件,不用挨个翻。
二、JDK1.8 HashMap 底层结构(必考)
JDK8 的 HashMap 结构:
数组 table
  |
  +-- index 0 -> Node -> Node -> Node
  +-- index 1 -> null
  +-- index 2 -> TreeNode / TreeBin 红黑树
  +-- index 3 -> Node
核心成员:
transient Node<K,V>[] table;
transient int size;
int threshold;
final float loadFactor;
默认值:
static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // 16
static final int MAXIMUM_CAPACITY = 1 << 30;
static final float DEFAULT_LOAD_FACTOR = 0.75f;
static final int TREEIFY_THRESHOLD = 8;
static final int UNTREEIFY_THRESHOLD = 6;
static final int MIN_TREEIFY_CAPACITY = 64;
底层公式:数组 + 链表 + 红黑树
- 主体:哈希数组(桶)
- 冲突少:数组位置挂链表
- 冲突多:链表长度≥8 & 数组长度≥64 → 转为红黑树
树化目的:链表查询太慢,树化后大幅提升查询效率。
三、什么是哈希冲突?
hash算法:key → 算出一个hash值 → 定位数组下标
不同的 key 算出了同一个数组下标,就是哈希冲突。
解决方式(JDK1.8):
- 冲突少:链表挂载(尾插法)
- 冲突多:升级红黑树
四、核心面试考点:为什么容量必须是 2 的幂?
死记答案:为了让哈希分布更均匀,减少冲突
底层原理:
HashMap 定位下标公式:hash & (length - 1)
只有长度是2的幂,length-1 二进制才是全1,与运算结果分布均匀。
不是2的幂,会大量扎堆冲突、浪费空间。
五、扩容机制(高频面试)
1. 默认参数
- 默认初始容量:16
- 负载因子:0.75
- 扩容阈值:16 * 0.75 = 12
元素数量达到阈值,自动扩容 2倍
2. 为什么负载因子是0.75?
平衡 空间利用率 & 哈希冲突概率
太大:冲突多、效率低
太小:频繁扩容、浪费空间
六、树化、退树条件(必背)
✅ 链表转红黑树(树化)
if (binCount >= TREEIFY_THRESHOLD - 1) // 链表长度达到 8
    treeifyBin(tab, hash);
但 treeifyBin 里还有条件:
if (tab == null || (n = tab.length) < MIN_TREEIFY_CAPACITY)
    resize();
else
    真正树化;
也就是说:
- 链表长度 >= 8。
- 并且 table.length >= 64。
- 才转红黑树。
否则优先扩容,因为扩容后冲突可能被分散。
总结:链表长度 >=8 并且 数组容量 >=64
✅ 红黑树退化为链表(退树)
扩容拆分时,如果树节点数量 <= 6:
if (lc <= UNTREEIFY_THRESHOLD)
    tab[index] = loHead.untreeify(map);
为什么是 8 和 6?
- 理想随机哈希下,链表长度分布近似泊松分布。
- 负载因子 0.75 时,链表长度达到 8 的概率极低,约 0.00000006。
- 6 和 8 之间留缓冲,避免频繁树化、退化。
重点:数组太小不树化,优先扩容,不优先树化。
七、致命问题:HashMap 为什么线程不安全?
HashMap 不是线程安全的,主要问题:
- put 丢失
两个线程同时 put 到同一个空桶,后写覆盖先写。 - size 不准
++size不是原子操作。 - 扩容数据错乱
多线程同时 resize,可能互相覆盖。 - JDK7 死循环
JDK7 扩容使用头插法,多线程并发扩容可能形成环形链表,get 时死循环。
JDK8 改成尾插 + 高低位拆分,修复了成环问题,但仍然不是线程安全。
结论:并发场景绝对不能用 HashMap
八、线程安全解决方案:ConcurrentHashMap
面试三连问:线程安全用什么?为什么?原理是什么?
1. 为什么不用 HashTable?
HashTable 全局锁,所有操作抢同一把锁,并发性能极差,基本废弃。
2. ConcurrentHashMap 核心结构
核心字段:
transient volatile Node<K,V>[] table;
private transient volatile Node<K,V>[] nextTable;
private transient volatile long baseCount;
private transient volatile int sizeCtl;
private transient volatile int transferIndex;
private transient volatile CounterCell[] counterCells;
特殊 hash:
static final int MOVED     = -1; // ForwardingNode
static final int TREEBIN   = -2; // TreeBin
static final int RESERVED  = -3; // ReservationNode
static final int HASH_BITS = 0x7fffffff;
TreeBin 的 hash 是 TREEBIN = -2。
它内部维护红黑树和读写锁:
- 读操作可以并发。
- 写操作需要锁。
- 如果读锁竞争激烈,可能退化为链表查找。
这保证了树结构在并发下的安全。
CHM 的 spread:
static final int spread(int h) {
    return (h ^ (h >>> 16)) & HASH_BITS;
}
& HASH_BITS 是为了保证 hash 非负,因为负数 hash 被特殊节点占用。
3.ConcurrentHashMap 多线程协助扩容
这是 CHM 最精彩的部分。
核心字段:
transient volatile Node<K,V>[] nextTable;
private transient volatile int transferIndex;
private transient volatile int sizeCtl;
扩容流程:
-
新表
nextTable大小是旧表两倍。 -
transferIndex从旧表长度开始,向前分配任务。 -
每个线程通过 CAS 领取一段桶区间,步长
stride。 -
迁移桶:
- 空桶:放
ForwardingNode。 - 已迁移:跳过。
- 非空:
synchronized(f)锁住桶头,拆分链表或树。
- 空桶:放
-
迁移完的旧桶设置为
ForwardingNode,旧表读请求遇到它就去新表查。 -
所有线程迁移完后,
table = nextTable,nextTable = null,sizeCtl设为新阈值。
ForwardingNode 的作用:
- 标记该桶已经迁移。
- 提供
find方法,让 get 能去新表查。 - 让其他 put 线程发现
MOVED后调用helpTransfer一起扩容。
所以 CHM 扩容不是单线程阻塞,而是多线程协助。
4. ConcurrentHashMap(put局部锁,get无锁)
put关键点:
- key/value 都不能为 null。
- 如果 table 为空,
initTable()初始化,CAS 修改sizeCtl保证只有一个线程初始化。 - 如果目标桶为空,CAS 插入新节点,无锁。
- 如果桶头是
ForwardingNode,说明正在扩容,当前线程去帮忙扩容。 - 如果桶非空,
synchronized(f)锁住桶头节点。 - 锁内再次检查
tabAt(tab, i) == f,防止锁期间桶头被替换。 - 链表或红黑树插入。
- 插入后
addCount更新计数,并判断是否需要扩容。
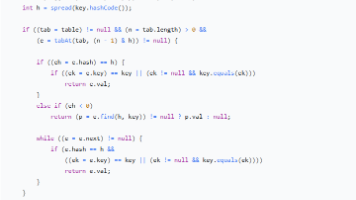
get无锁原因:
table是 volatile。Node.val和Node.next是 volatile。tabAt使用Unsafe.getObjectVolatile。- 遇到
ForwardingNode,调用find去nextTable查。 - 遇到
TreeBin,走树查找,内部有读写状态保证并发安全。
所以 get 不需要加锁,属于无锁读。
5. ConcurrentHashMap 核心优势
分段锁 + CAS + Synchronized
JDK1.8 优化:
- 不再锁整个数组
- 只锁 当前冲突的桶位置
- 不同桶并发操作互不影响
- 读操作无锁、写操作局部锁
并发性能吊打 HashTable,是并发Map首选
6.ConcurrentHashMap 如何闭环解决:
1. 初始化:sizeCtl CAS 保证单线程初始化
2. 空桶写入:CAS 插入,无锁
3. 非空桶写入:synchronized 锁桶头,锁粒度小
4. 读操作:volatile + Unsafe,无锁读
5. 扩容:ForwardingNode + transferIndex + helpTransfer,多线程协助
6. 计数:baseCount + CounterCell,分散热点
7. 树化:TreeBin 内部读写锁,保证红黑树并发安全
8. 迭代:弱一致性,不抛 CME
九、终极选型总结
- 单线程、普通业务 → HashMap(速度最快)
- 多线程、并发场景 → ConcurrentHashMap
- 绝对不要用 HashTable
十、本期集合大闭环(全部串起来)
到此,Java 常用集合体系完全闭环:
✅ ArrayList:数组、查询快、增删慢、单线程首选
✅ LinkedList:链表、增删快、查询慢
✅ HashSet:去重,底层就是 HashMap
✅ HashMap:数组+链表+红黑树、单线程极速、不安全
✅ ConcurrentHashMap:并发安全、高性能、多线程首选
专栏总结
-
HashMap 底层:数组+链表+红黑树
-
树化条件:链表≥8、数组≥64;退树≤6
-
初始16、负载因子0.75、扩容2倍、容量2的幂
-
HashMap 线程不安全,并发丢数据
-
并发场景用 ConcurrentHashMap,局部锁+CAS高性能
-
集合没有最好,只有最合适,场景优先
欢迎点赞收藏关注,下一期继续更新:红黑树原理,新手最容易忽略的异常知识点。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_42617033/article/details/166351464

