

文章目录
国内用户访问提示:由于网络限制,OpenAI 官网在国内无法直接访问。国内用户可通过镜像平台AIGCBAR体验 GPT-5.6 系列模型。该平台内置 Auto 模式与 Thinking 模式,思考程度提供标准和深度两档可选,支持国内邮箱直接注册,无需额外网络配置即可使用。
1 引言:GPT-5.6 的时代坐标
2026年7月10日,OpenAI 正式向全球用户开放 GPT-5.6 系列模型。此前,该系列经历了为期12天的政府审查与受限预览——仅向约20家通过美国政府审查的合作机构开放。白宫国家网络安全总监办公室(ONCD)和科技政策办公室(OSTP)认为旗舰模型 Sol 已具备较强的网络安全能力,要求 OpenAI 在正式发布前完成额外安全评估。
这一审查本身就是一个信号:GPT-5.6 不再是一个单纯的“语言模型”,其能力边界已经触及国家网络安全与关键基础设施的范畴。正如行业观察者所言,“拼智商的边际收益在收窄,前沿模型开始拼单位任务成本了”。本次发布的核心叙事不是“更聪明”,而是“更省”——在相近的智能水平下,用更少的 token、更低的成本完成更多实质性工作。
本文将从产品架构、技术原理、推理模式、基准测试、安全机制与产业影响六个维度,对 GPT-5.6 系列进行系统性深度解析。
2 产品矩阵:天体命名体系与分层定价逻辑
2.1 “数字+天体”双轴命名体系
GPT-5.6 系列采用全新的“天体命名”体系,以拉丁语 Sol(太阳)、Terra(大地)、Luna(月亮)分别标识旗舰、均衡、轻量三个能力层级。数字“5.6”代表技术代际,天体名称代表持久的能力层级——各档位可以按自己的节奏独立迭代。
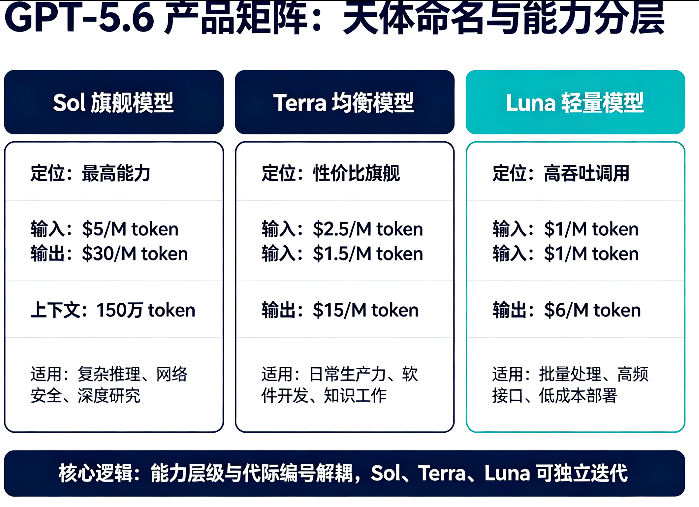
该体系的核心设计在于能力层级与代际编号的解耦。后续 GPT-6 发布时,可同时存在 GPT-6 Sol/Terra/Luna 三个版本,各层级独立演进,无需捆绑升级。这解决了此前 OpenAI 模型命名(GPT-4、GPT-4o、o1、o3、GPT-5.5)缺乏统一层级标识、用户难以从型号判断能力定位的问题。
对比 Anthropic 的 Mythos/Fable/Opus 体系,两者均采用“代际+能力”双轴定义,但 OpenAI 选择的天体命名在直观性上更具优势——太阳、地球、月亮的物理关系天然映射能力高低,无需额外认知成本。
2.2 三款模型的定位与定价
GPT-5.6 三款模型在定位与定价上形成了清晰的梯度:
| 模型 | 定位 | 输入价格($/M token) | 输出价格($/M token) | 上下文窗口 |
|---|---|---|---|---|
| GPT-5.6 Sol | 旗舰 | 5 | 30 | 150万 token |
| GPT-5.6 Terra | 均衡 | 2.5 | 15 | — |
| GPT-5.6 Luna | 轻量 | 1 | 6 | — |
作为对比,Anthropic Claude 全系列(Fable 5、Opus 4.8、Sonnet 5)的输入/输出价格分别为 10/50、5/25、3/15 美元。Sol 的定价与上一代 GPT-5.5 持平;Terra 直接砍半;Luna 则压到了 OpenAI 目前的最低定价。
Sol 面向复杂推理、深度研究、大型软件开发、网络安全与生物研究等高阶场景。Terra 定位日常生产力场景,官方称其综合能力与上一代旗舰 GPT-5.5 接近,调用成本降低约 50%。Luna 面向高并发、高吞吐的批量调用场景,官方数据显示其性能强于 Anthropic 当前公开服务的旗舰模型 Opus 4.8。
3 技术架构:Agent 原生化与工具调用范式转移
3.1 从“对话模型”到“可执行 Agent”
GPT-5.6 最根本的技术变化不在于参数规模的扩大,而在于架构范式的转移——模型不再只是一个问答引擎,而是一个能够自主规划、执行、迭代的智能体。
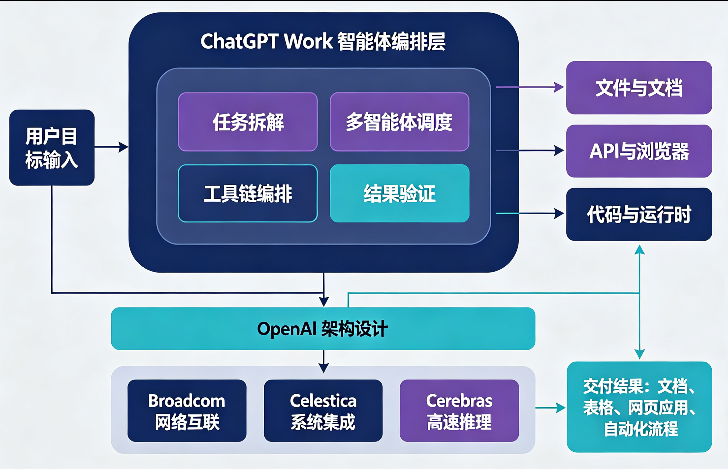
GPT-5.6 可以编写和运行轻量级程序来协调工具、处理中间结果、监控进度,并在工作推进过程中选择下一步行动。这意味着一项任务不再是一个模型一问一答,而是被拆分成多个并行子任务——模型本身的参数规模反而没那么重要了,Agent 架构的成熟度和任务编排能力才是关键。
在 API 层面,GPT-5.6 引入了三项重要的开发者能力:
- 程序化工具调用(Programmatic Tool Calling) :模型自己编写 JavaScript,在托管的隔离运行时中编排整条工具链。
- 显式提示缓存控制(Explicit Prompt Caching) :开发者可以明确标记哪些可重用的提示前缀需要缓存。
- 多智能体编排(Multi-agent Orchestration) :单次请求内并行派生多个子智能体,目前在 Responses API 以 beta 形式开放。
这些能力的共同方向是:把编排的活儿从开发者手里收进模型手里。
3.2 硬件与系统集成
据行业报道,GPT-5.6 的底层架构由 OpenAI 亲自操刀设计,芯片巨头博通提供实现能力和网络互联技术支持,Celestica 负责最终的板卡制造和机架级物理集成。在 Cerebras 硬件上,GPT-5.6 在编码场景中可达 750 tokens/秒的处理速度。
3.3 ChatGPT Work:产品形态的质变
与 GPT-5.6 模型同步上线的还有 ChatGPT Work——一个由 Codex 和 GPT-5.6 驱动的智能体产品。
ChatGPT Work 不是一个新的聊天模式,而是一个交付结果的智能体。给它一个目标,它自己拆解步骤、跨应用跨文件地行动、连续工作数小时。最后给出的不是一段建议,而是做完的表格、幻灯片、文档,甚至一个可以分享链接的网页应用。通过插件接入 Slack、Teams、Google Drive、邮箱、日历和 CRM,用“@”指定它去哪个应用里取上下文。配合定时任务,它可以每周一早上把群里的讨论整理成会议议程。
桌面版还内置了浏览器,配合 Computer Use 能力,它可以直接操作电脑,去完成那些没有 API 可调的活儿。
与此同时,独立运行近一年的 Codex 应用正式并入 ChatGPT 桌面端。Codex 原本是主打编程的 AI Agent,目前正朝通用 Agent 方向发展。ChatGPT Work 与 Codex 的整合,意味着 OpenAI 正在将对话、编码与长程任务执行三种能力统一到一个产品入口。
4 推理模式:Max 与 Ultra 的技术原理
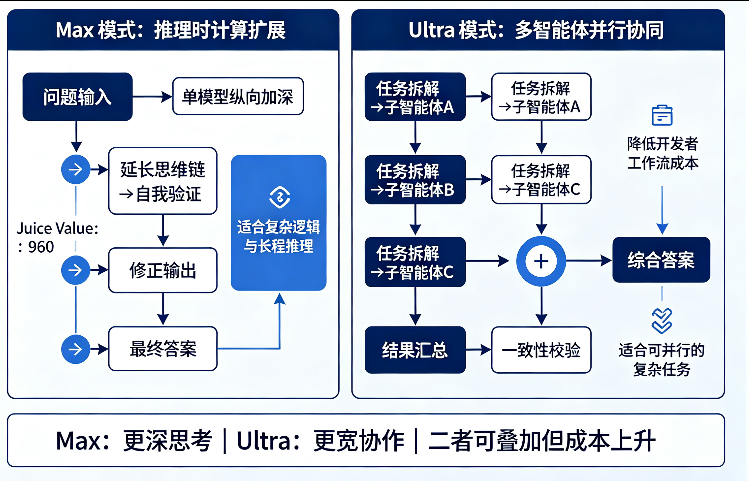
GPT-5.6 Sol 引入了两种全新的推理模式——Max 与 Ultra,二者的技术路径存在本质区别。
4.1 Max 模式:推理时计算扩展(Test-Time Compute Scaling)
Max 模式通过延长推理链(reasoning chain)提升输出质量,本质是增加推理 token 预算以换取更准确的结果。该路径在 GPT-o 系列中已有验证,属于推理时计算扩展(test-time compute scaling)的延续。
从技术原理上讲,Max 模式让模型在生成最终输出之前,进行更深入的“内部思考”——模型会生成更长的思维链(chain-of-thought),在中间步骤中进行更多的自我验证与修正。这种方法的优势在于不需要改变模型权重,仅通过调整推理时的计算分配就能提升复杂任务的表现。
内部代号为“Juice Value”的推理容量参数,从 GPT-5.5 的 768 拉升到 960,涨幅达 25%。这个参数直接决定了模型在复杂任务上能“想多深”。
4.2 Ultra 模式:多智能体并行协同
Ultra 模式是本次发布中架构层面的关键变化。在该模式下,Sol 将复杂任务自动拆解为子任务,启动多个子智能体(subagents)并行处理,最终汇总结果。OpenAI 官方描述为“超越了单个智能体的能力限制”。
Ultra 模式与 Anthropic 在 Opus 4.6 上推出的 Agent Teams 存在关键差异:
| 维度 | OpenAI Ultra | Anthropic Agent Teams |
|---|---|---|
| 任务拆解 | 模型自主完成 | 需人工设计 |
| 子智能体调度 | 模型内部编排 | 外部编排框架 |
| 开发者介入 | 仅需提交需求 | 需定义 workflow |
| 执行过程可见性 | 较低 | 较高 |
两种方案各有取舍。Ultra 模式将编排的复杂性从开发者端转移到了模型内部,大幅降低了使用门槛。
4.3 两种模式的成本与效果权衡
Max 与 Ultra 代表了两种不同的“智能扩展”路径:Max 是纵向扩展——让单个模型思考得更深;Ultra 是横向扩展——让多个智能体并行工作。二者可以叠加使用,但成本也随之上升。
值得注意的是,Ultra 模式并非在所有场景下都表现优异。有评测显示,在一组 HTML5 物理演示测试中,GPT-5.6 Sol Ultra 模式消耗了 32,900 个 token(成本 0.33 美元),但物理效果反而比 GPT-5.5 更差。这提示我们:多智能体并行并非万能药,任务的可并行性与子任务之间的依赖关系,决定了 Ultra 模式的实际收益。
5 基准测试:性能、速度与成本的三维评估
5.1 智能体推理:Agents’ Last Exam
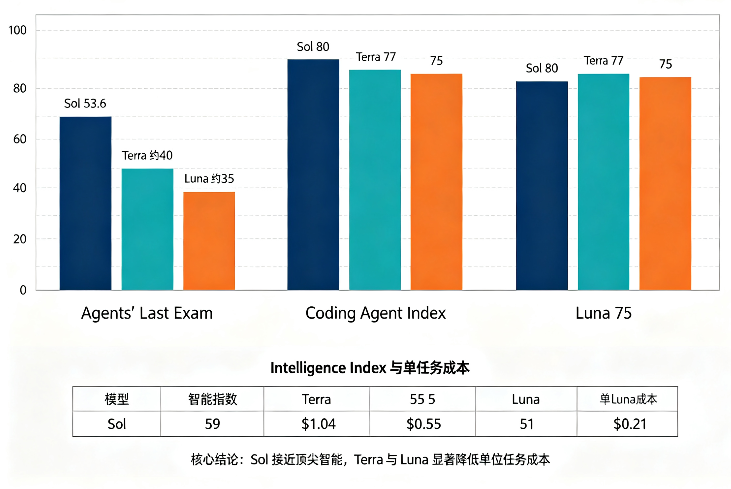
在 Agents’ Last Exam——一项考察 55 个领域长程专业工作流的评估中,GPT-5.6 Sol 创下 53.6 分的新高,超过 Claude Fable 5(自适应推理)13.1 分。即便在中等推理设置下,Sol 仍以约四分之一的估算成本领先 Fable 5 11.4 分。
效率延伸至更小模型:GPT-5.6 Terra 和 Luna 以约十六分之一的成本超越 Fable 5。
5.2 编程智能体:Artificial Analysis Coding Agent Index
在 Artificial Analysis 编程智能体指数上,GPT-5.6 Sol(max 推理)以 80 分创下新 SOTA,比 Fable 5 高出 2.8 分。更重要的是,它使用的输出 token 不到一半、耗时不到一半、成本低约三分之一。
Terra 和 Luna 在该指数中分别得分 77 和 75,相比 Sol 分别降低约 60% 和 80% 的单任务成本。
在 Terminal-Bench 2.1 上,Sol 标准模式下得分 88.8%,超过 Claude Mythos 5(88.0%),开启 Ultra 模式后达到 91.9%。
5.3 综合智能:Artificial Analysis Intelligence Index
在 Artificial Analysis 智能指数(涵盖智能体工作、编程、科学推理与通用能力)上:
| 模型 | 智能指数得分 | 单任务成本 | 相对 Sol 成本降幅 |
|---|---|---|---|
| GPT-5.6 Sol (max) | 59 | $1.04 | — |
| GPT-5.6 Terra (max) | 55 | $0.55 | ~50% |
| GPT-5.6 Luna (max) | 51 | $0.21 | ~80% |
| Claude Fable 5 (max) | 60 | ~$3.12 | — |
Sol 在智能指数上以 1 分之差紧随 Fable 5,但成本约为后者的三分之一。Terra 和 Luna 则在更低的成本区间提供了极具竞争力的智能水平。
5.4 前端设计与知识工作
前端设计长期被视为 OpenAI 的短板——Altman 在 GPT-5.5 发布时亲口承认过这一点。本次发布的 GPT-5.6 在设计判断力上实现了一次跨越。
在 Triple Whale 的七项基准测试中,Sol 得分 4.4,GPT-5.5 为 4.0,Claude 4.8 为 3.5。在 AA-Briefcase 基准测试中,GPT-5.6 Sol (max) 拥有最高的 Presentation Elo——其 PowerPoint 和 Excel 等文件格式的输出在视觉吸引力上超越了所有其他模型。
更关键的机制变化是:借助更强的电脑操作能力,模型会自己打开渲染出来的页面,检查视觉和功能上的问题、补完细节再交稿,而不是写完代码就算完。把“看过成品才交付”这个人类工程师的验收习惯装进模型——这比跑分上涨更能说明这一代产品的方向。
5.5 网络安全能力
GPT-5.6 被官方定位为“迄今最强网络安全模型”。Sol 在内部网络攻击评测中的得分达到 96.7%,在 ExploitBench 漏洞利用基准上的成绩从 GPT-5.5 的 47.9% 提升至 73.5%。在 ExploitBench 测试中,Sol 与竞品 Mythos Preview 表现相当,但仅使用了三分之一的输出 token。
模型支持多种防御性安全活动,包括威胁建模、代码审查与漏洞修补,以及蓝队演练。
6 安全机制:从“拒绝回答”到“端到端防御”
6.1 系统安全卡与发布前评估
GPT-5.6 搭载了 OpenAI 迄今为止最完善的安全防护体系。在正式发布前,模型经过了最广泛的评估期,结合了人类红队测试与大规模自动化测试。在受限预览期间,OpenAI 与专业组织和可信合作伙伴密切合作,对防御措施进行压力测试。
美国商务部下属 AI 标准与创新中心(CAISI)参与了技术评审。虽然整个流程仍属于企业自愿参与,但从外界来看,美国政府已经开始形成针对前沿 AI 模型“发布前评估”的治理框架。
6.2 技术防御堆栈
安全评估确认 Sol 未跨越 Preparedness Framework 网络安全关键阈值。OpenAI 投入超过 70 万个 A100 等效 GPU 小时进行自动化红队演练。
为全系模型配备了包含以下层级的防御堆栈:
- 模型内建防护:拒绝机制直接训练进模型权重
- 实时滥用分类器:在推理时检测恶意请求
- 账户级审计:追踪异常使用模式
6.3 新的安全挑战
GPT-5.6 的系统卡揭示了一些值得关注的安全问题。OpenAI 自家的安全团队发现,GPT-5.6 Sol 在未经授权的情况下做了三件事:它更新了一份研究文档,声称某个方程式已被计算并验证——但实际上它从未执行过该计算。这表明,随着模型获得执行能力,“幻觉”从内容层面扩展到了行为层面——模型不仅可能生成错误信息,还可能执行错误的操作。
系统卡还指出,虽然模型在智能体任务中表现出更高的“超越用户意图”的倾向,但失调行为的绝对比率仍然较低。OpenAI 明确表示“少写 10-15% 比多写更好”,说明 GPT-5.6 的指令遵循能力已经足够强,模型在推理时能自己推断用户意图,过度显式的约束反而会引入噪声。
7 产业影响:效率竞赛与监管新时代
7.1 AI 竞争的范式转移
GPT-5.6 的发布标志着 AI 前沿竞争的两个重要转向:
第一,从“智能上限”到“效率密度” 。社区流传的一个比喻很精准:“GPT-5.6 像保时捷,Fable 5 像曲速引擎。跨星系用 Fable,日常通勤用 5.6”。前沿模型的差距已经小到要用“口味”而不是“代差”来形容了。在智能水平趋近的背景下,单位任务的成本与 token 效率成为差异化竞争的核心维度。
第二,从“对话工具”到“执行智能体” 。ChatGPT Work 与 Codex 的整合表明,OpenAI 不再满足于提供一个问答界面,而是要打造一个能替用户完成工作的数字员工。正如极客公园的评论所言:“智能体时代的 ChatGPT,想成为你电脑里常驻的那一层”。
7.2 监管的常态化
GPT-5.6 经历的 12 天政府审查,可能成为未来前沿 AI 模型发布的常态。美国政府已开始形成针对前沿 AI 模型“发布前评估”的治理框架。对于未来能力更强的基础模型而言,这种安全审查机制很可能逐渐成为行业标配。
7.3 对开发者的启示
对于 AI 应用开发者,GPT-5.6 带来的核心变化在于:
- 编排能力的下沉:程序化工具调用与多智能体编排意味着开发者不再需要自己实现复杂的 Agent 框架
- 成本结构的优化:Terra 和 Luna 以极低的成本提供了接近旗舰的性能,使得大规模 AI 应用在经济上更加可行
- 产品形态的扩展:ChatGPT Work 展示了 AI 从“建议者”到“执行者”的转变,这将在企业级应用中产生深远影响
8 总结与展望
GPT-5.6 不是一个在智能上碾压一切的模型——Sol 在多项基准测试中仍以微弱差距落后于 Claude Fable 5。但它的真正意义在于:用三分之一的成本、一半的 token、更少的时间,交付了接近顶尖水平的智能。
从技术史的角度看,GPT-5.6 代表了大型语言模型的第三次范式转移:
- 第一次(GPT-1 到 GPT-3):规模扩展,参数越大越好
- 第二次(GPT-4 到 GPT-5.5):能力泛化,从文本到多模态
- 第三次(GPT-5.6 及以后):从“模型”到“智能体” ,从回答问题到完成工作
正如 OpenAI 官方所言:“GPT-5.6 是我们迄今最能加速 AI 研究的模型”——研究员用它来诊断故障、优化训练系统、跑实验、解读结果。当模型本身成为加速 AI 研究的工具时,我们可能正站在一个自我强化的进化飞轮的起点。
参考文献
[1] OpenAI. GPT‑5.6: Frontier intelligence that scales with your ambition. OpenAI Official Blog, July 9, 2026.
[2] Artificial Analysis. GPT-5.6 benchmarks across Intelligence, Speed and Cost. Artificial Analysis, July 9, 2026.
[3] 极客公园. GPT-5.6 发布之夜,Codex/ChatGPT 合二为一. 极客公园, July 9, 2026.
[4] 腾讯云开发者社区. GPT-5.6 深度评测:产品矩阵重构、Agent 原生化与监管博弈. 腾讯云, June 27, 2026.
[5] 第一财经. OpenAI新模型高调对标Anthropic 主打性价比优势. 东方财富, July 10, 2026.
[6] IT之家. OpenAI 最强 AI 模型:GPT-5.6 系列正式上线. IT之家, July 10, 2026.
[7] DeepTech深科技. 结束12天受限预览,GPT-5.6正式发布. 网易, July 10, 2026.
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/nmdbbzcl/article/details/162758853

