

一、空手开箱
编辑丢来一个任务:试试火山新出的 AI MediaKit Skill,写篇实测。
我第一反应是翻硬盘找素材——想找段画质差的老视频,或者带硬字幕的片源。翻了一圈,一无所获。
索性直接用官方 demo。后来想想这反而是件好事:空着手也能跑通全流程,恰好说明上手门槛低。
于是我打开 Claude Code,把字幕擦除 demo 视频的链接贴进输入框,敲了一句话:
“把这个视频里的字幕擦掉。”
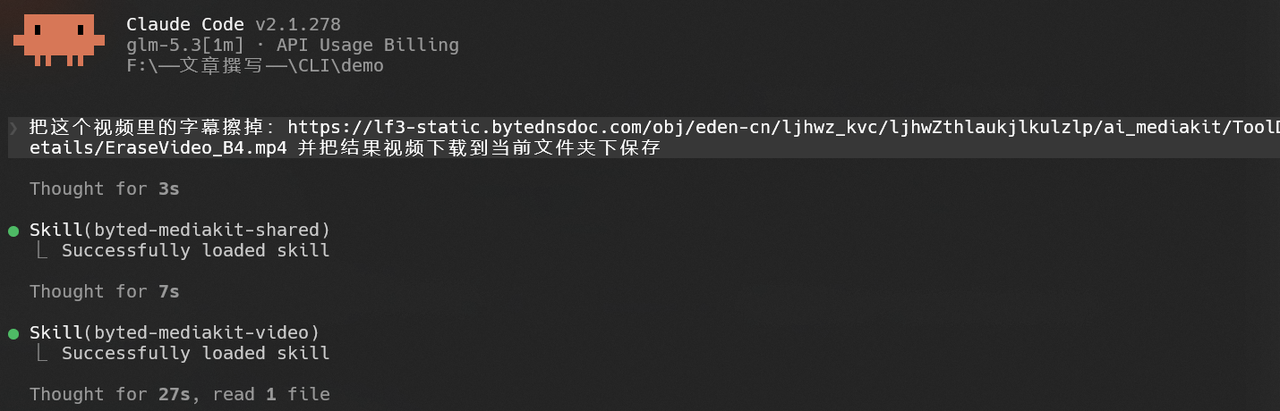
就这一句。接下来发生的事,就是这篇要讲的。
先说为什么要折腾这个。干视频活的人,多半被几样东西折磨过:
FFmpeg。 免费、强大,但把两段视频拼起来,就得写这么一段:
ffmpeg -i a.mp4 -i b.mp4 -filter_complex \
"[0:v]scale=1280:720,setsar=1[v0];[1:v]scale=1280:720,setsar=1[v1];\
[v0][0:a][v1][1:a]concat=n=2:v=1:a=1[v][a]" \
-map "[v]" -map "[a]" out.mp4
这还只是拼接。查半天手册,拼出来,换个需求再查半天。更麻烦的是,字幕擦除、画质修复这类活它压根做不了——它是处理工具,不是理解工具。
专业软件。 PR、达芬奇当然能干,但学习成本摆在那。而且"就剪个 10 秒片头"这种小事,等软件启动完,手动都剪完了,配置要求也是一道门槛。
在线工具。 能用,但排队、限速、隐私顾虑,而且没法批量——十个视频挨个上传下载,效率很低。
如果这些活,说一句话就有人替你干了呢?
二、AI MediaKit Skill 是什么
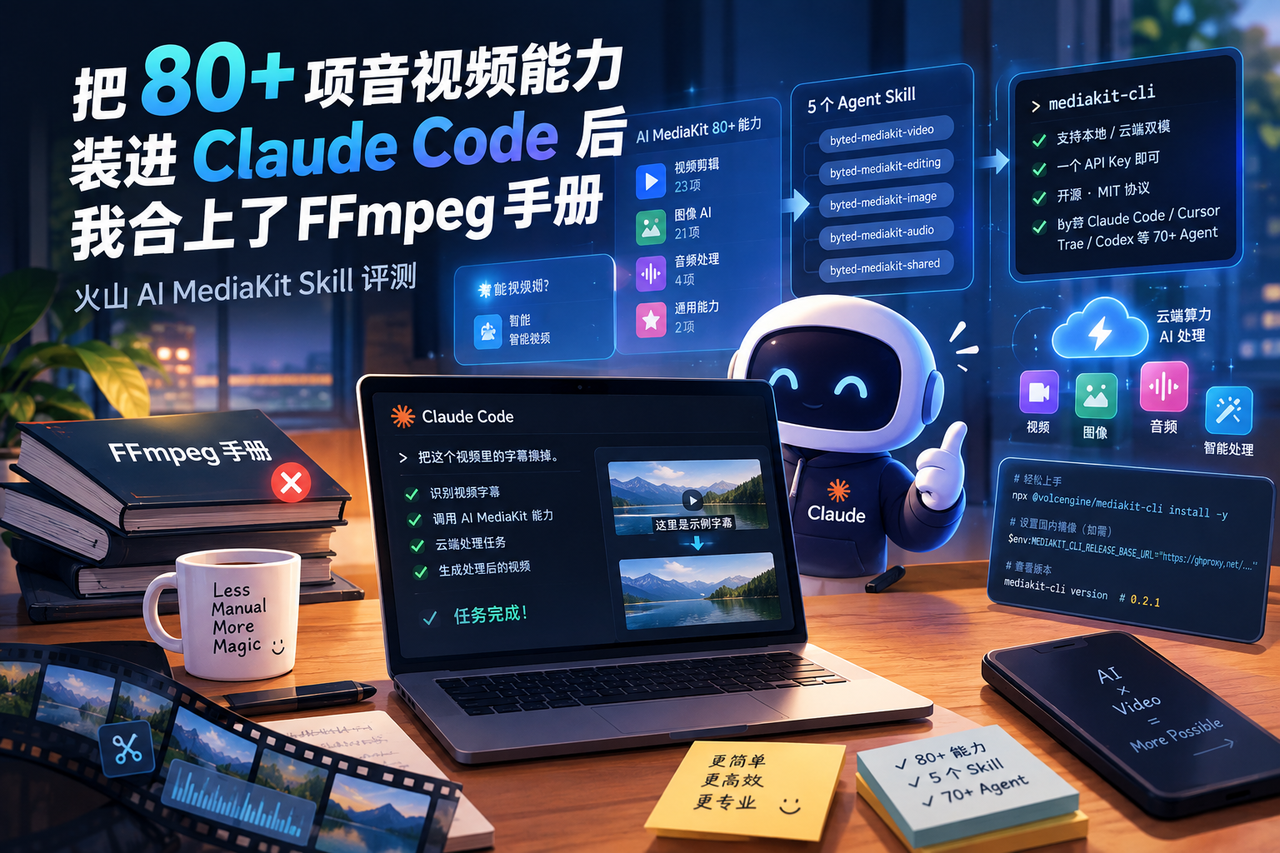
AI MediaKit 是火山引擎"智能处理"产品线下的能力集合,背后是字节系视频业务的算法沉淀——抖音那套亿级日处理量磨出来的画质增强、字幕擦除、高光识别,现在产品化对外开放了。
它的产品形态是个三层结构,从里到外:
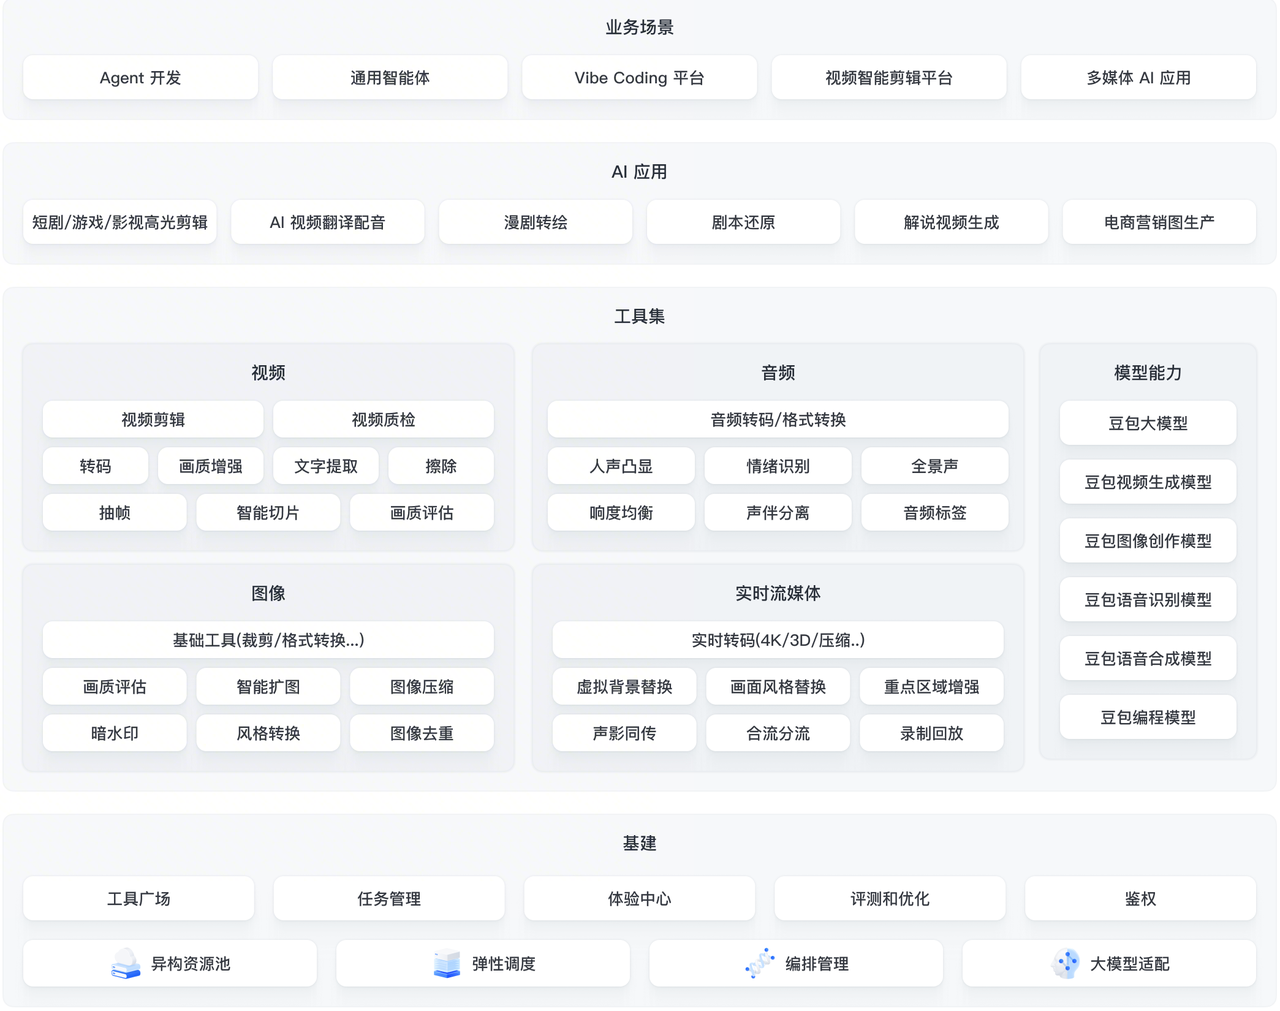
最里面,80 项原子能力,横跨视频、图像、音频三个模态:
| 领域 | 数量 | 代表能力 |
|---|---|---|
| 剪辑 | 23 | 裁剪、拼接、加字幕、调速、混音、提取音频 |
| 智能视频 | 30 | 画质增强、字幕擦除、高光智剪、抠图、剧情分析、ASR |
| 图像 AI | 21 | 背景移除、画质增强、擦除修复、OCR、智能裁剪 |
| 音频 | 4 | 人声分离、端点识别、转码、元信息 |
| 通用 | 2 | 异步任务查询、远程文件拉取 |
中间层,mediakit-cli。 每个能力封装成一条终端命令,MIT 协议开源在 GitHub 上。比如 mediakit-cli --cloud video erase-video-subtitle,就是标准版字幕擦除。
最外层,5 个 Agent Skill。 CLI 按 Claude Code 的 Skill 规范打包成 byted-mediakit-video / editing / image / audio / shared 五个技能,装进 Agent 之后,用自然语言直接差遣。
这个设计的效果是:你面对的不再是一款软件,而是一个能听懂自然语言的执行层。CLI 是它的手,Skill 是它的耳朵。
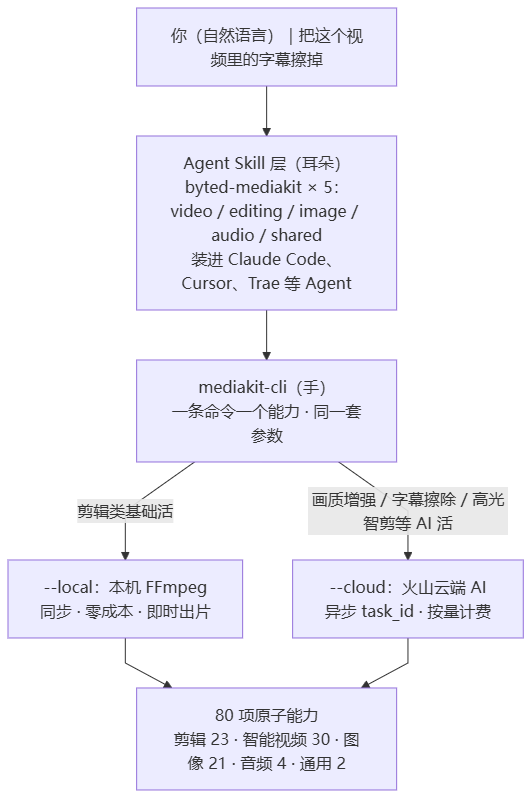
有两个设计值得单独说说。
双模架构。 同一个命令面,--local 走本机 FFmpeg,同步执行、零成本、即时出片;--cloud 走云端算力,处理 FFmpeg 做不了的活。关键是两边共用同一套参数设计,从 local 切到 cloud,理论上零改造。
鉴权极简。 一个 API Key 完事。被 OAuth / STS / IAM 那套流程折腾过的读者应该懂这意味着什么:控制台建个 Key,设进环境变量就能跑。(有个小机制第三步会细说:Key 只走环境变量,不落配置文件。)
三、上手实录:从安装到唤醒
完整流程记录如下,数字都是真实的。
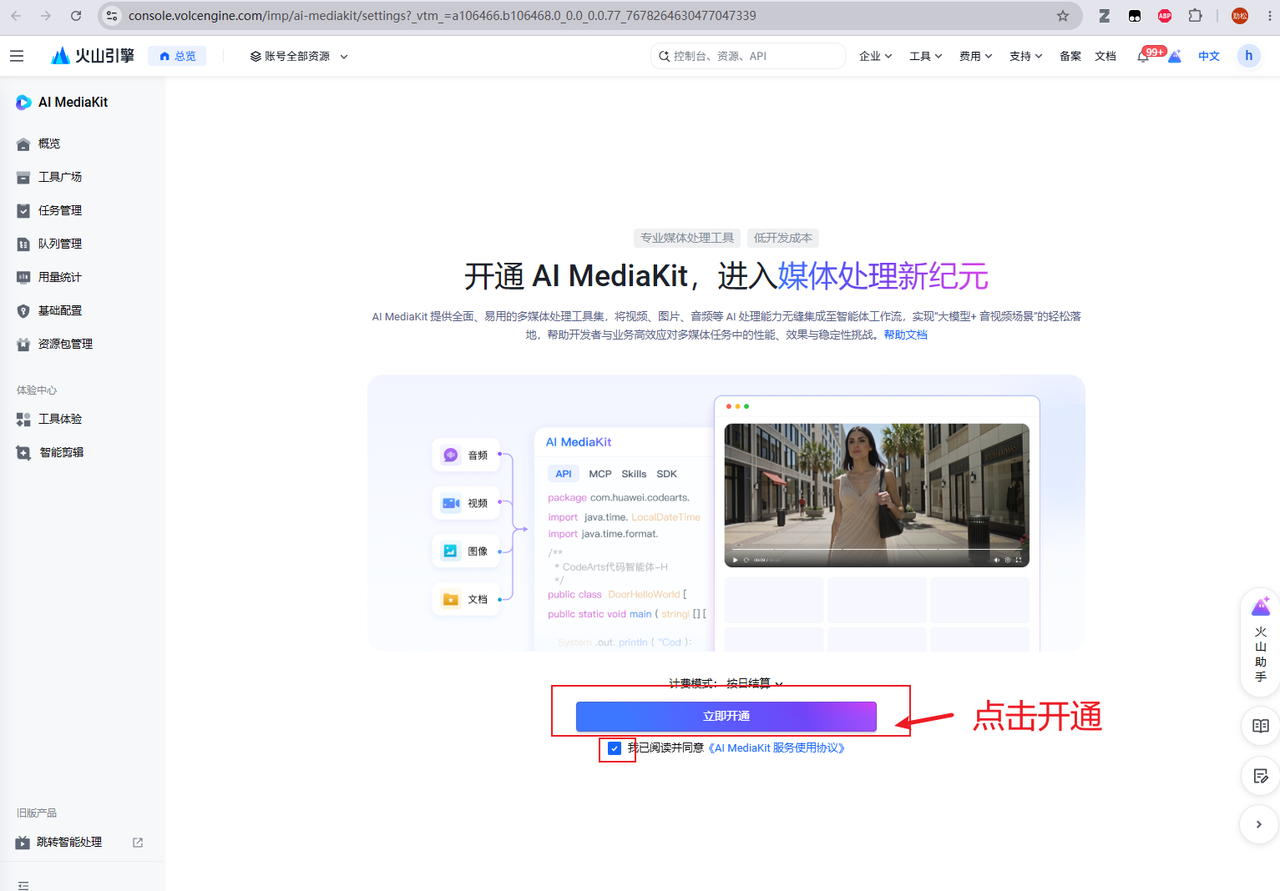
第一步,开通服务。
-
云端能力需要先到火山引擎控制台的 AI MediaKit 设置页(
imp/ai-mediakit/settings)开通。
-
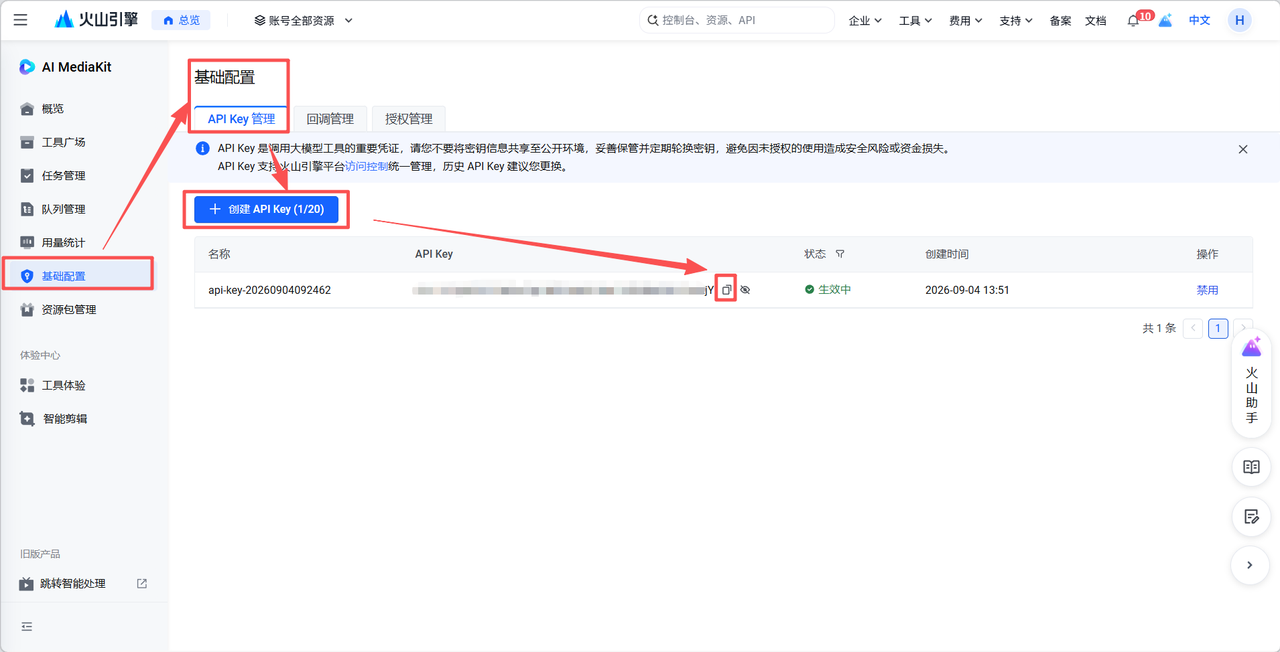
然后点击左侧基础配置,点击创建API Key,然后将API Key复制下来备用
第二步,安装。
## 官方一键命令(Node.js 18+):
npx @volcengine/mediakit-cli install -y
唯一要注意的是网络:它要从 GitHub Releases 拉取平台二进制,国内直连容易超时,而且 npx 会把报错吞掉——表现就是静默失败,回到提示符,啥也没有(如下):
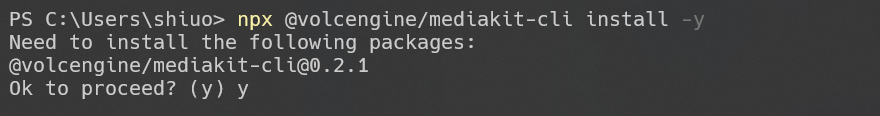
(如果你也有上述情况)就国内环境先设官方镜像变量,再跑安装:
$env:MEDIAKIT_CLI_RELEASE_BASE_URL = "https://ghproxy.net/https://github.com/volcengine/mediakit-cli/releases/download"
npx @volcengine/mediakit-cli install -y
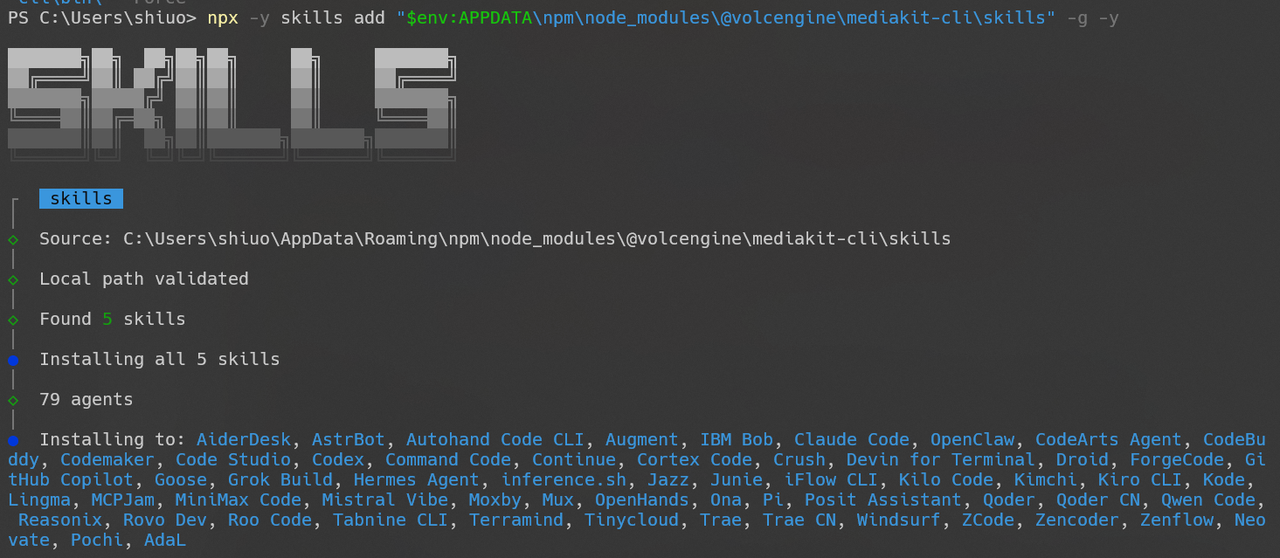
装完跑一句 mediakit-cli version,输出 0.2.1 就是成了。skills 那步的输出值得一看:5 个 skill 一次装进 79 个 Agent 平台,Claude Code、Cursor、Trae、Codex 全生效。

另外本地模式依赖 FFmpeg(≥5.1),后面 doctor 会检查,没装的话
--local那批能力用不了。
第三步,配置。
这步有个机制要先说清,不然容易白忙:CLI 的 Key 只认
MEDIAKIT_API_KEY环境变量——init 不收 Key 参数,也不把 Key 写进配置文件(init --help原文:“Authentication is never accepted as a flag or persisted in config”)。init 负责的只是执行模式这些杂项。
##标准姿势:
$env:MEDIAKIT_API_KEY = "<你的Key>"
mediakit-cli init
选默认模式(建议云端优先):
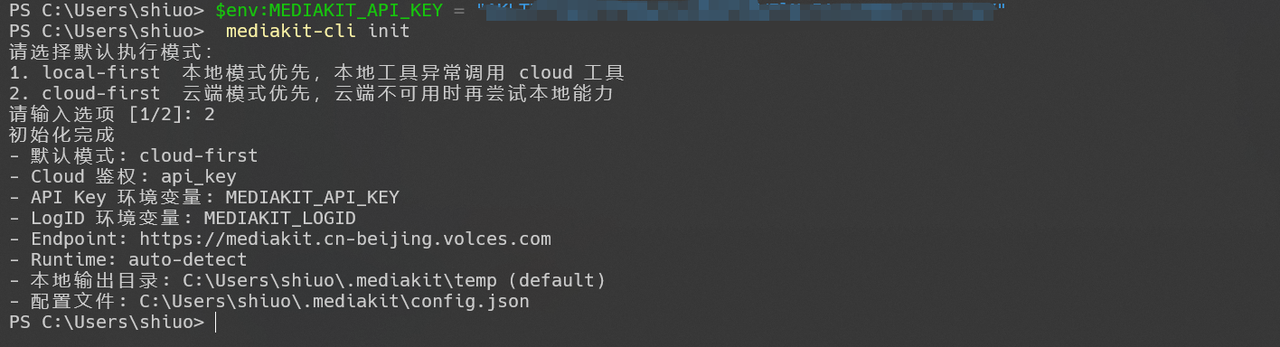
但注意:$env: 设的变量只活在当前终端,新开的 Claude Code 会话拿不到,doctor 会报 cloud_ready: false(实测踩过)。最省心的做法是把 Key 写进 PowerShell 配置文件,一劳永逸:
notepad $PROFILE    # 没有这个文件就新建,加入下面一行
$env:MEDIAKIT_API_KEY = "<你的Key>"
保存后重开终端(Claude Code 也从新终端启动),以后每个会话都自动带 Key。
第四步,自检。
mediakit-cli doctor,检查云端连通性、本地依赖,哪里有问题会直接提示。
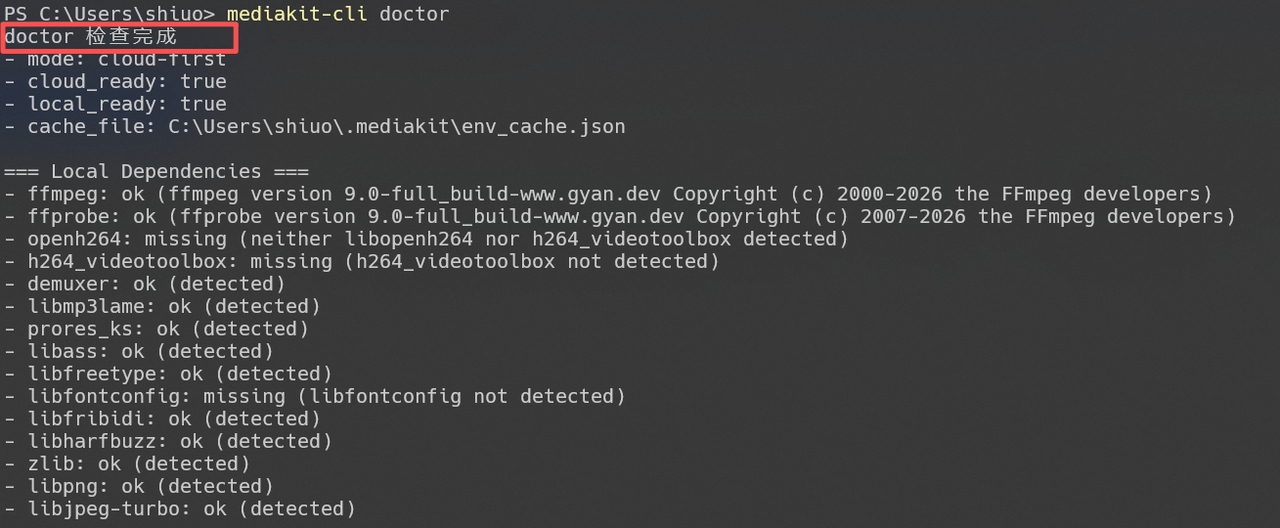
第五步,验证唤醒。
打开 Claude Code,问一句"你能做哪些音视频处理"。看着 byted-mediakit-* 一族能力在对话里出现,就能确认:它确实接进工作流了。
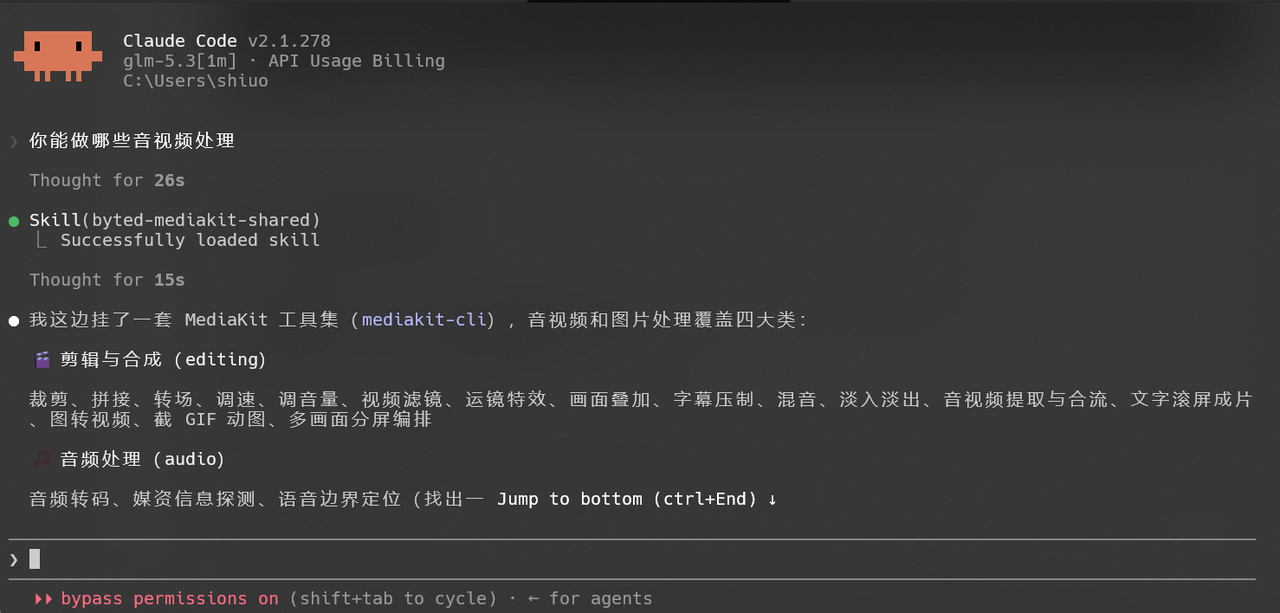
顺带一提,它不绑死 Claude Code,Cursor、Trae、Codex 都能装。我这篇全程用 Claude Code。
懒人速通版——赶时间的读者直接抄这四行(镜像 → 安装 → Key → 模式),跑完
mediakit-cli version验证即用;不过第一次建议还是照着上面五步走一遍,知道每步在干嘛,卡住了也知道去哪查:$env:MEDIAKIT_CLI_RELEASE_BASE_URL = "https://ghproxy.net/https://github.com/volcengine/mediakit-cli/releases/download" npx @volcengine/mediakit-cli install -y $env:MEDIAKIT_API_KEY = "<你的Key>" mediakit-cli init --mode cloud-first --yes
四、核心场景实测
三个场景的记录结构统一:我说了什么 → Agent 怎么干的 → 等了多久 → 效果如何 → 值不值。
4.1 画质增强:480p 老视频提到 1080p
素材是官方 demo:一段 480p 视频,3.87MB。
我说的是:“把这个视频增强到 1080p:https://vod-ai-test.tos-cn-beijing.volces.com/demo/demo_480p.mp4并把结果视频下载到当前文件夹下保存”
Agent 先弹了个选择题:用哪种增强方式?standard、professional、极速、生成式四档,连算法数量和计费差异都标在菜单里——参数被翻译成了人话。我选了推荐的 standard。
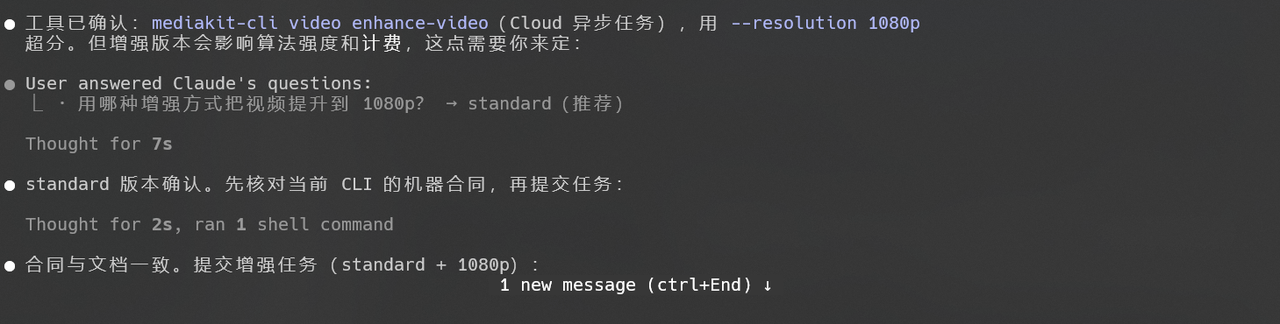
随后它调用云端画质增强(video enhance-video)提交任务,拿到 task_id 就开始自动轮询。云端任务是异步的,提交不等于出结果,得等它算完。这一单从提交到拿到结果视频我用了3 分 45 秒。
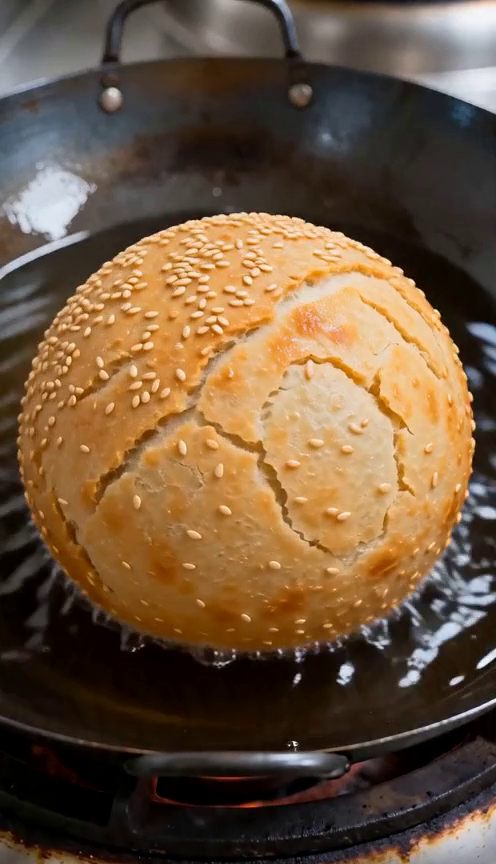
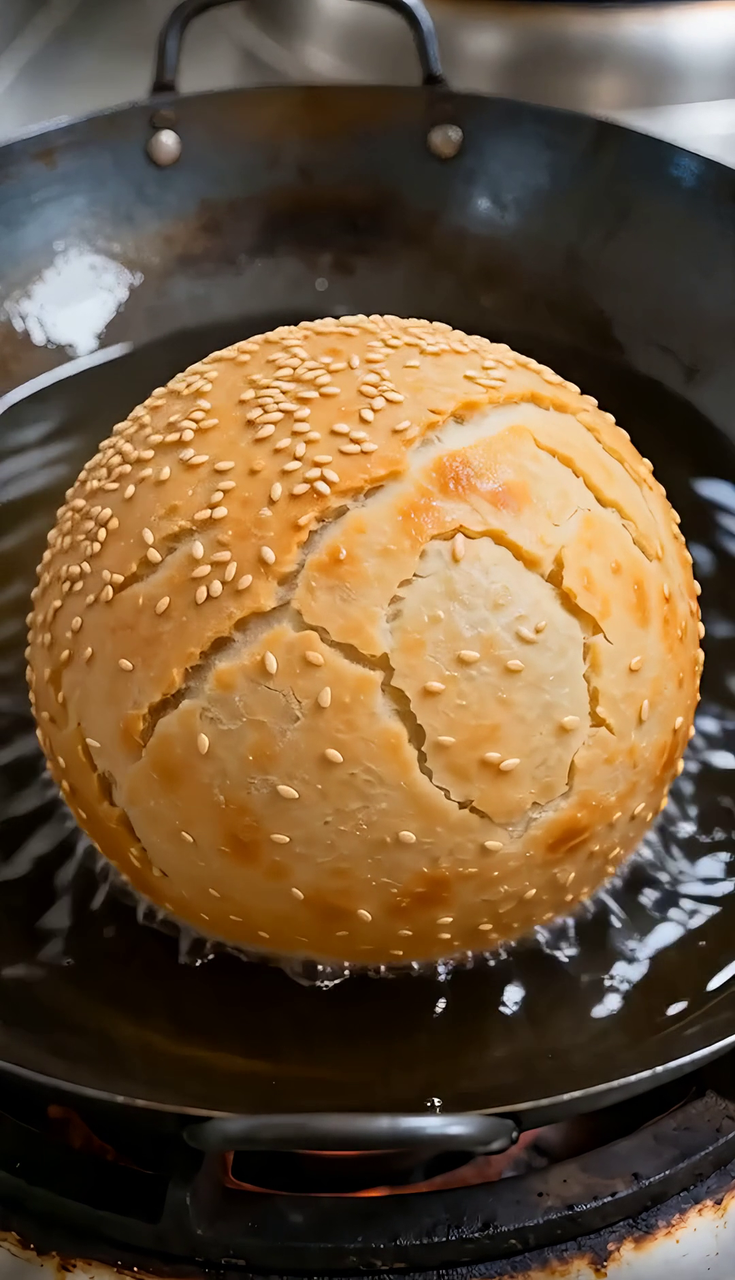
产出硬指标:分辨率 496×864 → 1080×1880(宽边拉到 1080),码率 2.0 → 7.1 Mbps,文件 3.87MB → 13.7MB——体积翻了 3.4 倍,多出来的都是信息量。
效果直接看同帧对比——每组左=原片、右=增强后。
- 原视频 vs 增强后(分别是8.5s / 14.5s)
 |  |
 |  |
整段看下来和帧对比的结论一致:纹理密集处提升立竿见影——食材颗粒、油光边缘,判若两版素材;色彩没有跑偏,也没有过度锐化的白边、涂抹感这类 AI 增强的常见副作用。要挑毛病的话:它救的是清晰度,救不了构图和抖动——素材拍得多糙,增强后还是多糙,只是更清楚的糙。
- 值不值,我的结论是:单看这一单,3 分 45 秒的等待换一个 15 秒的视频,谈不上惊艳;但这活儿的正确打开方式从来不是单件——批量挂机、无人值守才是它的主场,睡前丢一文件夹低清素材,早上收一摞 1080p。为这个场景,值。
- 最后说说档位。这能力一共四档:standard 默认档,兼顾速度与画质;professional 内置 30 余种深度算法,走影视级制作,计费更高;极速版速度优先,适合大批量预处理;生成式上扩散大模型补细节,主打修复压缩损伤和老化素材。选择思路:standard 够用就用 standard,素材损伤重再上生成式,批量赶时间走极速版。
4.2 字幕擦除:硬字幕一键去除
素材还是官方 demo:12.3MB 的竖屏短剧片段,39 秒,画面带硬字幕。用的就是开头图1 那句话。
这一步有个选择题:标准版(erase-video-subtitle)还是精细化版(erase-video-subtitle-pro)。
官方定位说得很直白:
- 标准版 0.4 元/分钟,高效经济,适合纯色、简单背景的快速处理;
- 精细化版 1 元/分钟,高帧率 OCR 加 AIGC 图像修复重建背景纹理,主打无痕,复杂纹理场景效果更好,还支持手动框选区域,可以拿来擦水印、台标。
我两档都跑了——先标准版,出结果后补一句让精细化版再擦一遍。各自耗时:标准版从提交到成品落盘全程 4 分 18 秒(云端处理约 3 分半+下载 86MB 约 54 秒);精细化版全程 6 分 35 秒(云端处理约 5 分半+下载约 1 分钟)——39 秒的素材,两档分别花了约 6.6 倍和 10 倍的素材时长(纯云端处理约 5.4 倍 / 8.5 倍,落在官方文档 5~9 倍的 RTF 参考区间内,符合预期)。
产出硬指标:原片 12.3MB,两档结果 90.3 / 95.4MB——码率从 2.5 拉到 18~19 Mbps,体积暴涨约 7 倍。直接分发要有体积预期,好在自家就有视频转码,一句话能压回去。
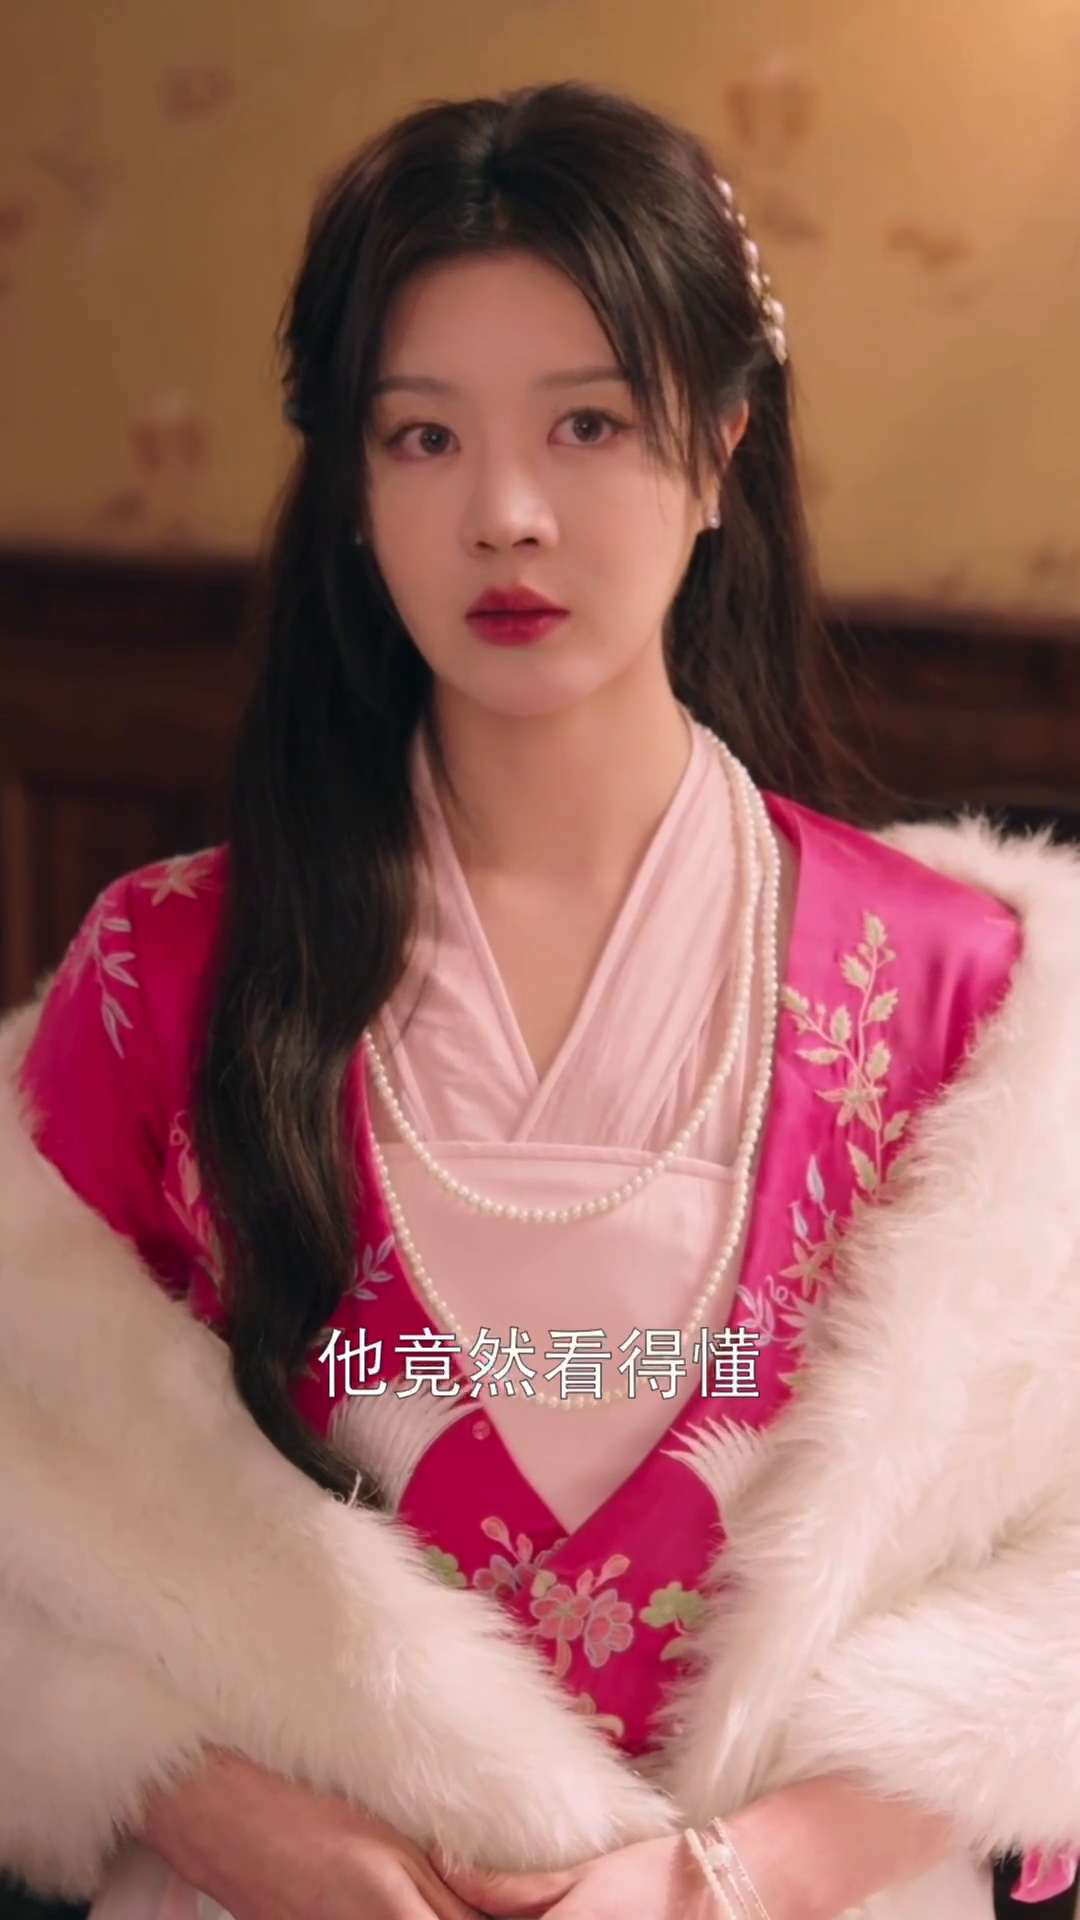
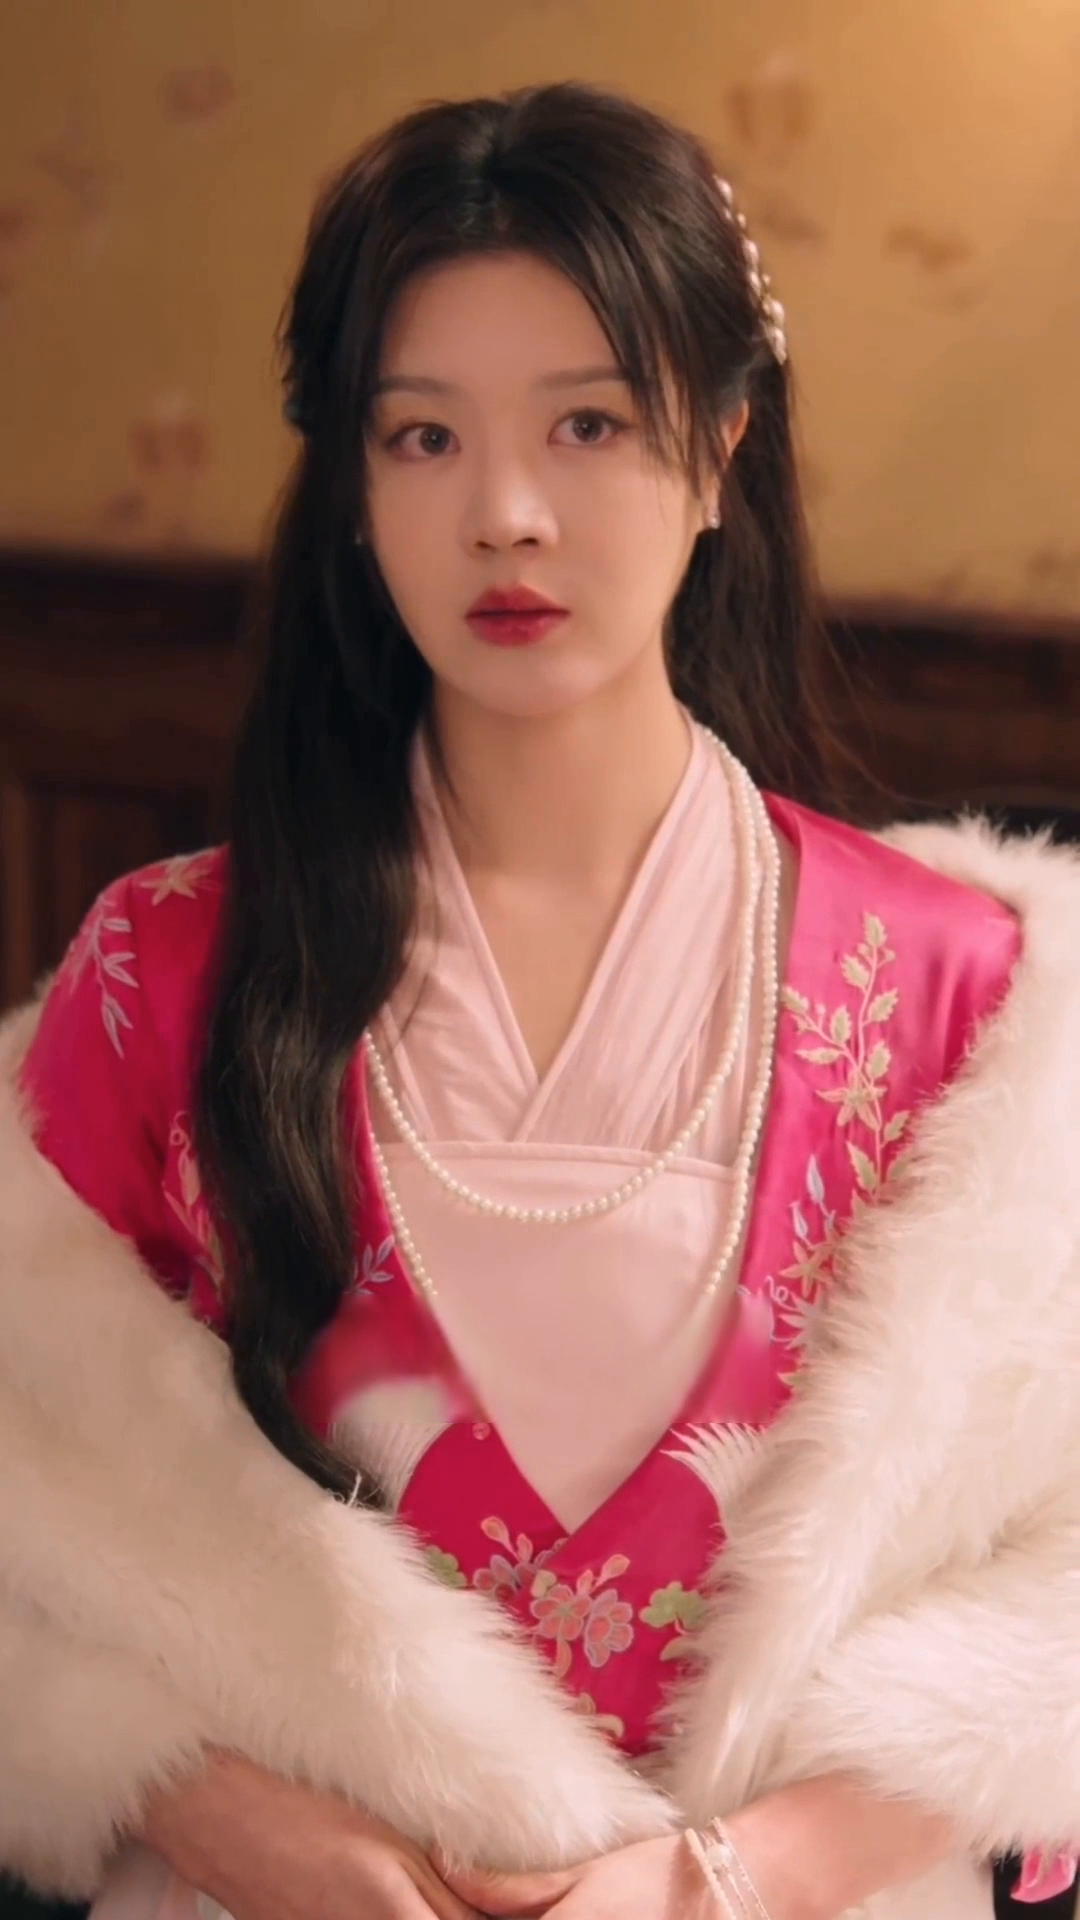
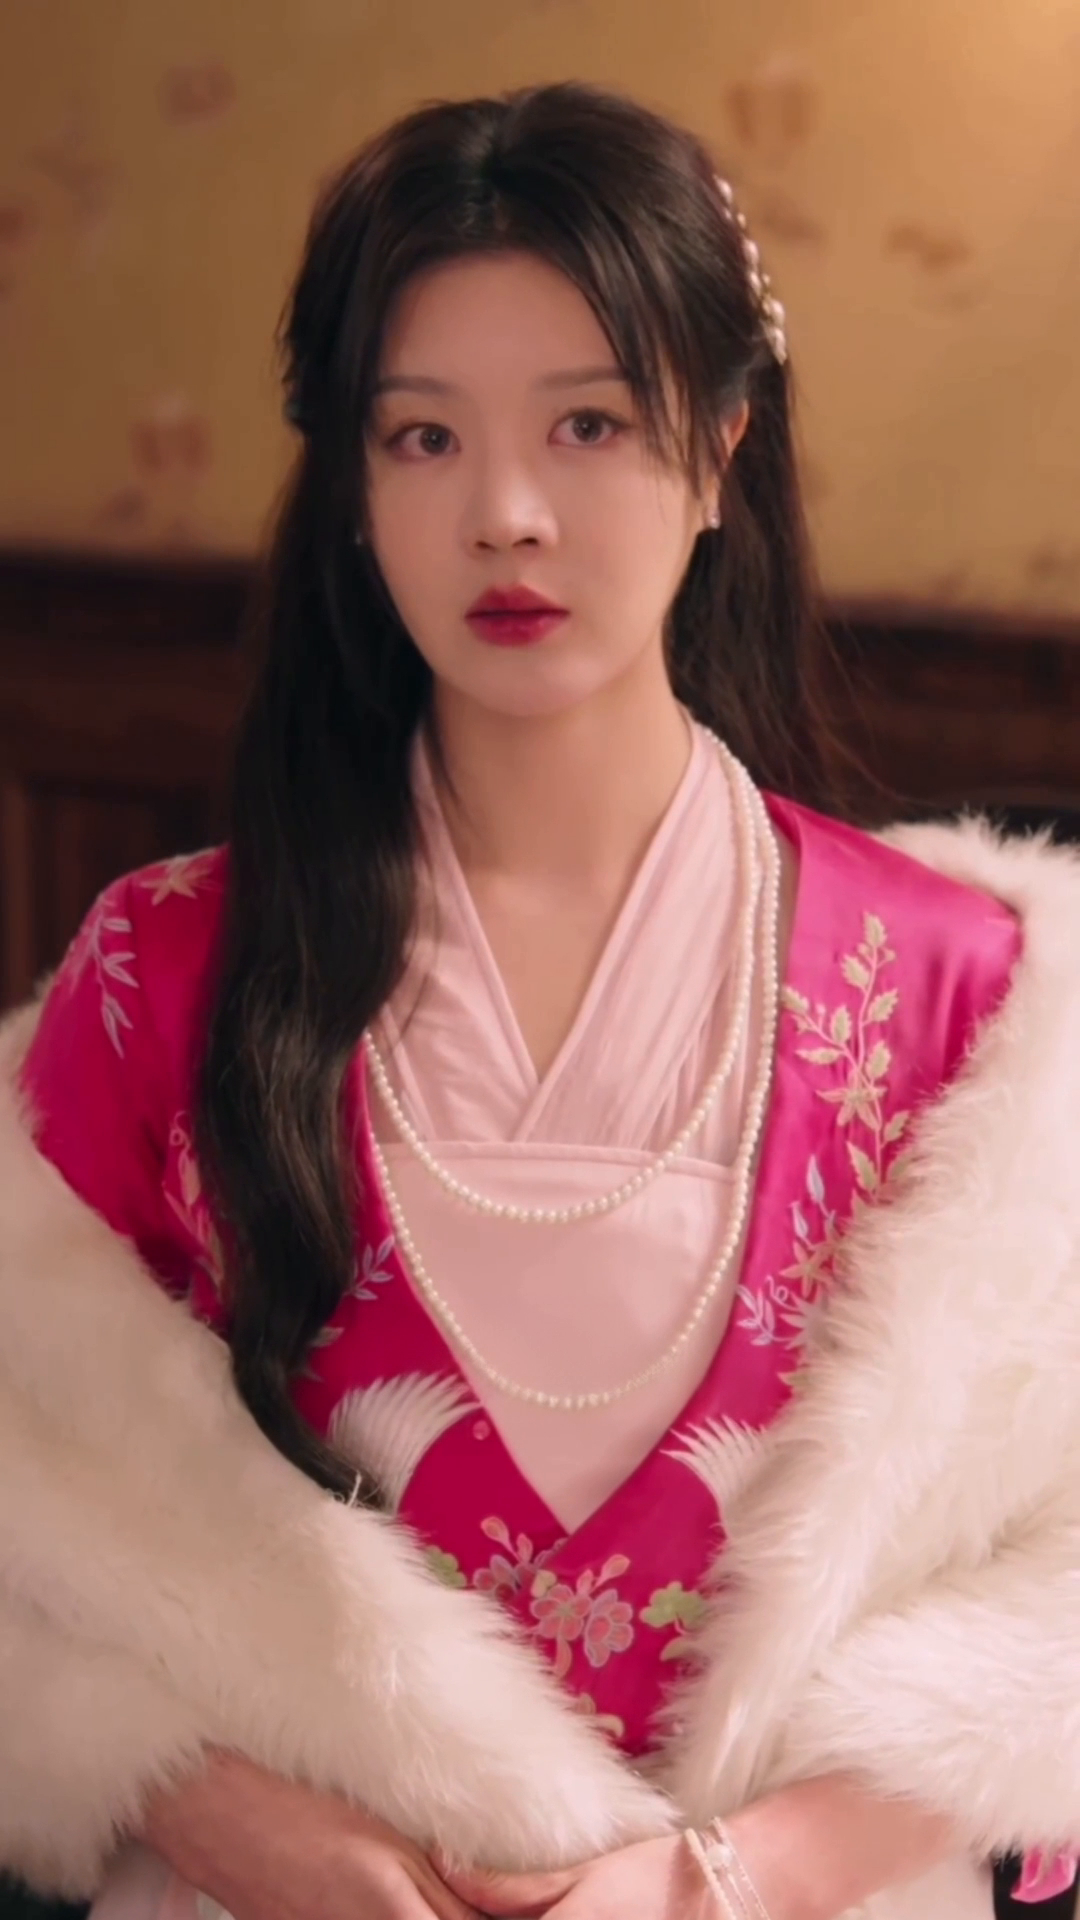
效果看下方三联对比。两组细节都值得放大:24.4 秒处,画面道具——一张伸到画面底部的处方笺,标准版把它上面的毛笔字糊化了,墨迹晕开像被水浸过;精细化版字迹清晰、红格线完好。30.9 秒处,挂在胸口高度(约 2/3 画面)的对白字幕两档都擦得干净,底部毛绒披肩和刺绣的纹理也自然。
一句话:每分钟 0.4 元和 1 元的差价,买的就是"分得清该擦的和不该擦的"——标准版对字幕带附近一视同仁地糊,精细化版知道手下留情。完整播放中字幕随台词进出,没有闪烁、虚影或跟丢。
最后说边界(文档写明):默认只认画面下半部分、水平居中、高度 1%~10% 的白色中英文字幕;顶部、超大字号、其他语种不在自动识别范围内。另外,擦字幕请用在自有或已授权素材上——技术中性,用途自担。
- 原视频 vs 标准版 vs pro版(分别是24.5s / 30.5s)
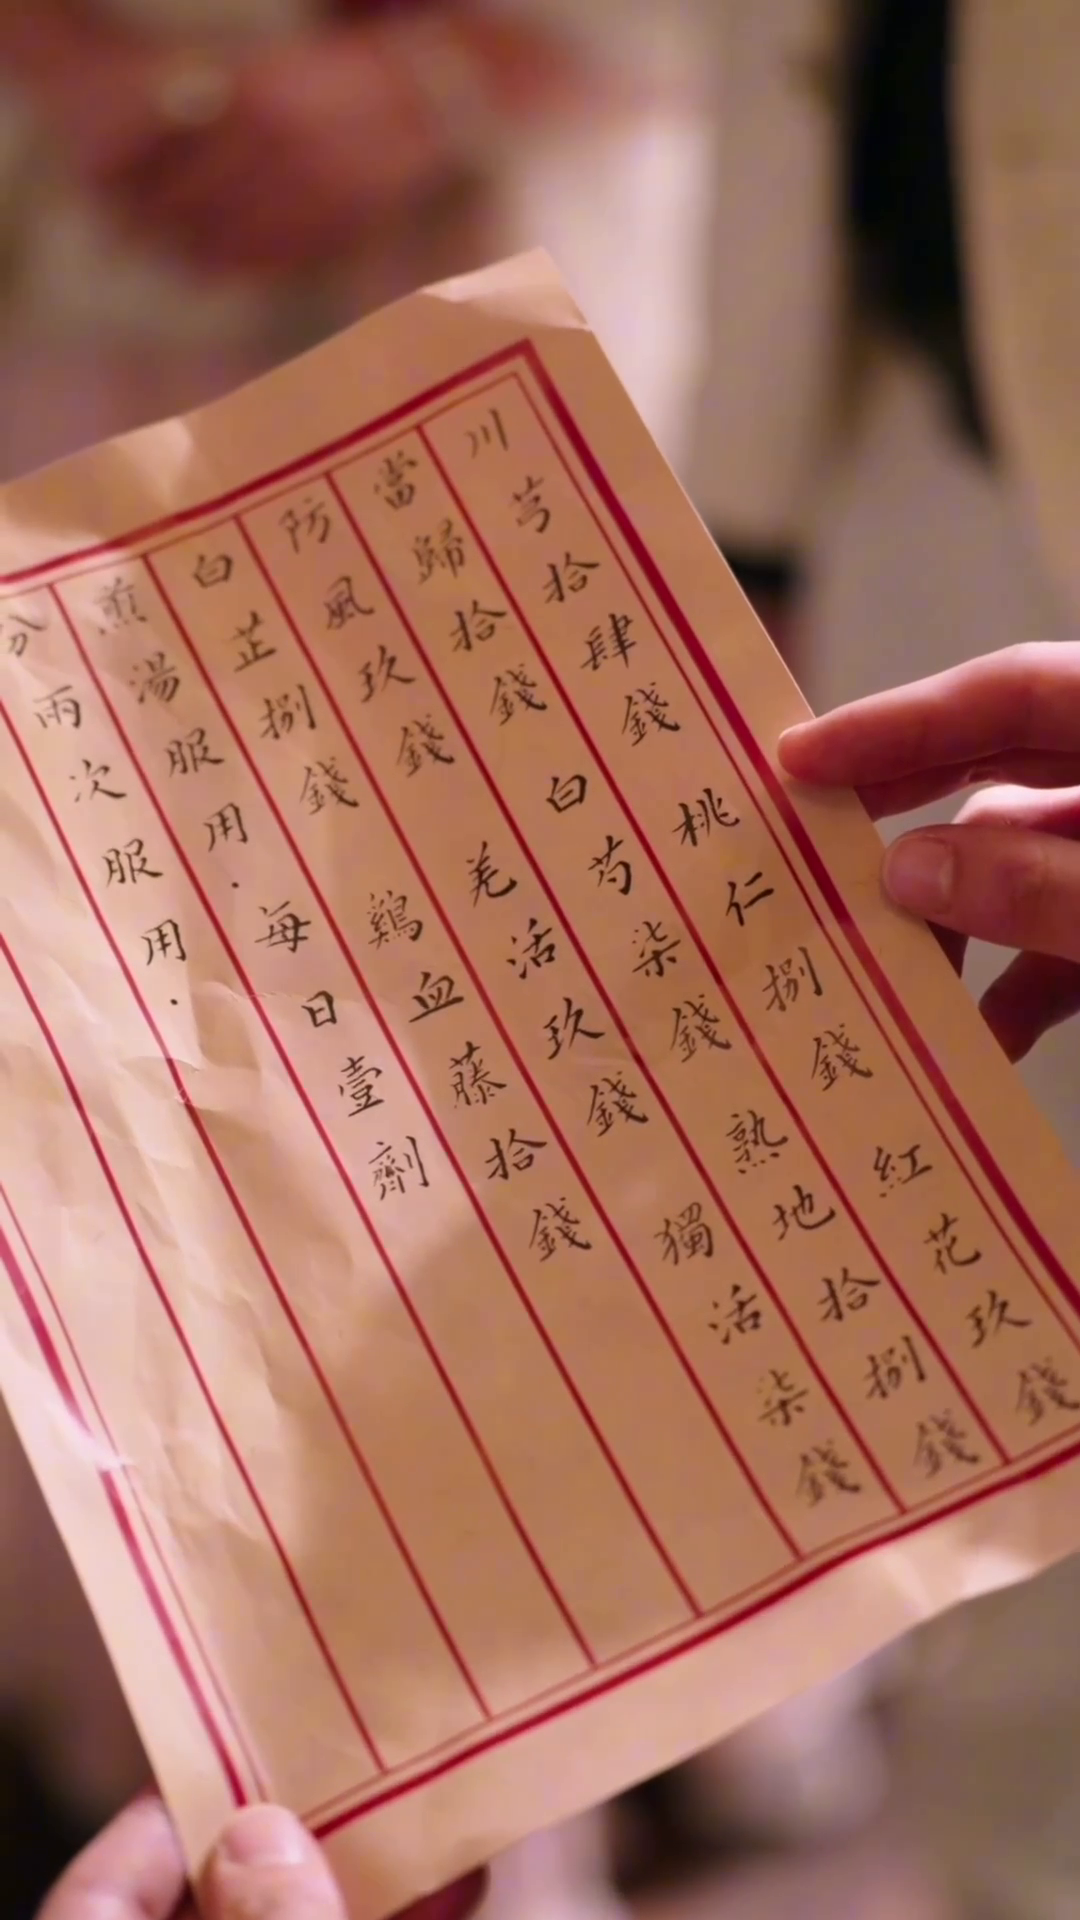 | 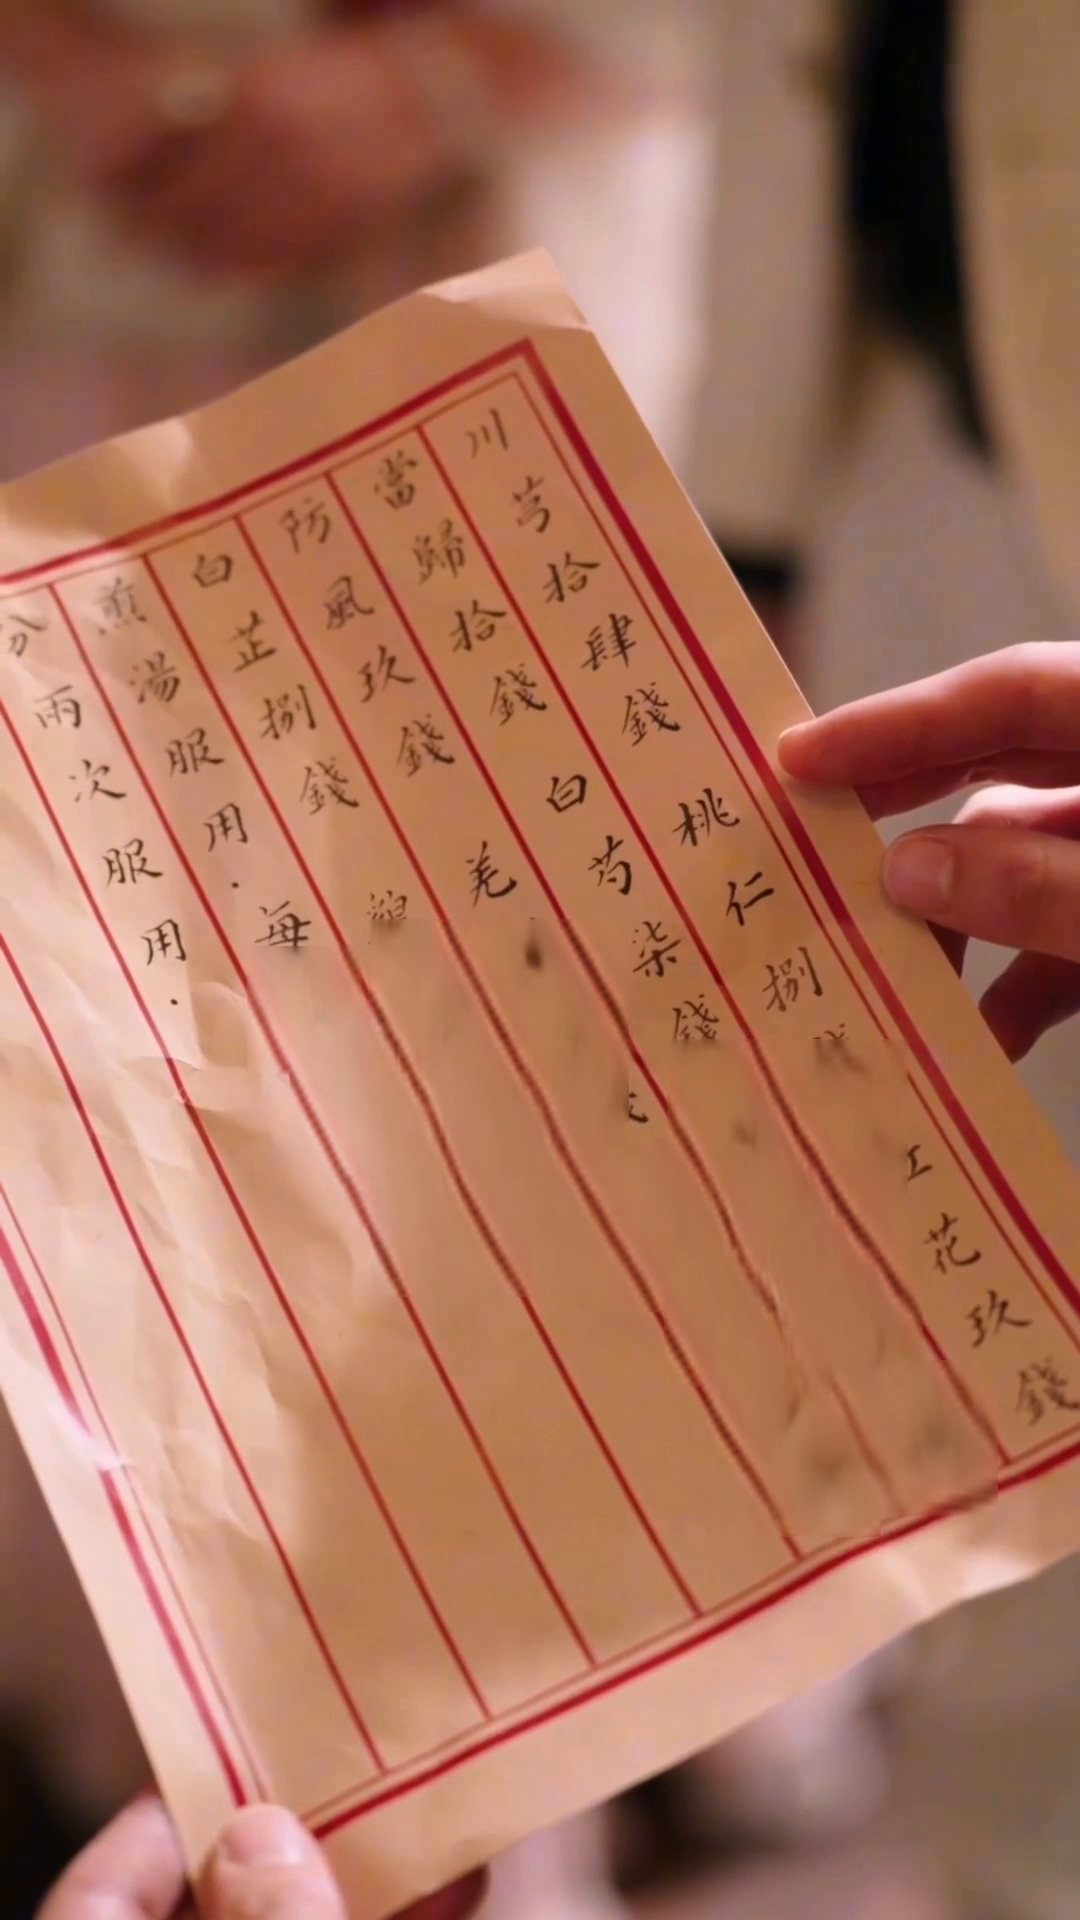 | 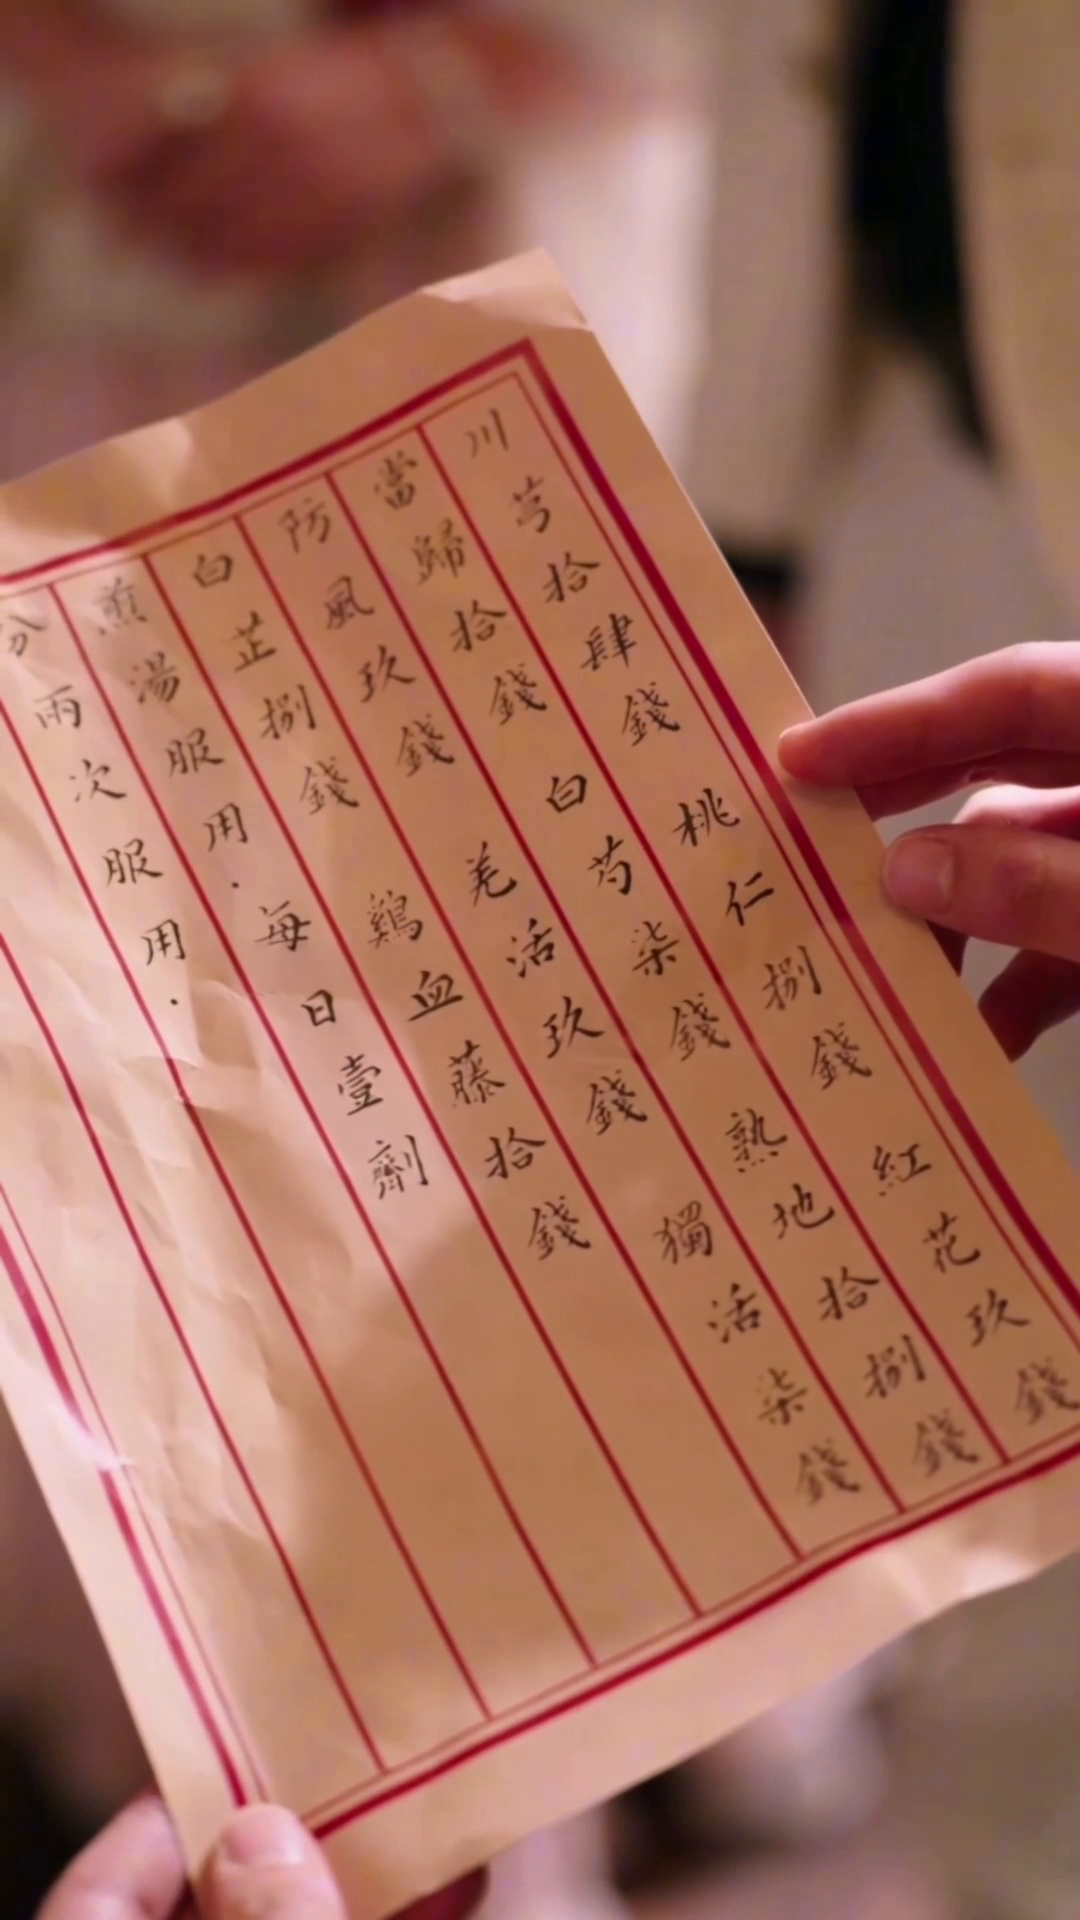 |
 |  |  |
4.3智能剪辑:从"剪一刀"到"自动出片"
这部分分两块:本地的基础剪辑,云端的高光智剪。
先说本地。我说:“把这个视频剪掉前 10 秒。” Agent 跑的是 --local editing trim-video——这里有个我很喜欢的小细节:它把官方 demo 的公网链接直接喂给了本机 FFmpeg,流式读取远程源,没有"先下载再处理"的中间步骤,云端产出的 URL 也能这么接,流水线就这么串起来了。
从命令敲下到成片落盘,4.8 秒:38.96 秒的源片剪掉前 10 秒,产出 28.96 秒、9.5MB 的成片,时长严丝合缝。公道话也要说:4.8 秒的前提是源片只有 9MB、CDN 又快,素材一大,拉流和编码时间都会涨——"几秒出片"是短素材口径。
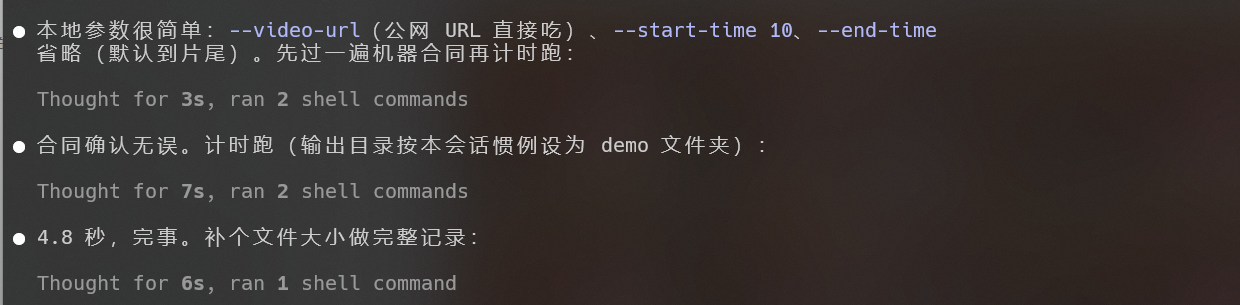
回头再看看引子里那段 filter_complex。同样的活,一个是翻译一句话,一个是查半小时手册。这就是全部的体验差异。
再说云端高光智剪。这能力有三个细分:短剧(generate-highlights-microdrama)、小游戏录屏(generate-highlights-minigame)、影视拆条(generate-highlights-movie)。影视拆条最合自媒体胃口:给它一部电影或一集剧,它按剧情故事线自动识别高光,拆成一段段 90~180 秒的成片,每段还自动配"高光前置开场"和结尾悬念钩子。
我拿官方短剧 demo(39 秒)跑了智剪-短剧,没提具体要求,Agent 声明假设后走了默认参数:每段 30~180 秒、最多 6 条、混剪模式、开场钩子默认开。云端处理 7 分 25 秒(剧情理解加渲染),下载 6 个成片文件另花 28 秒 / 44MB。
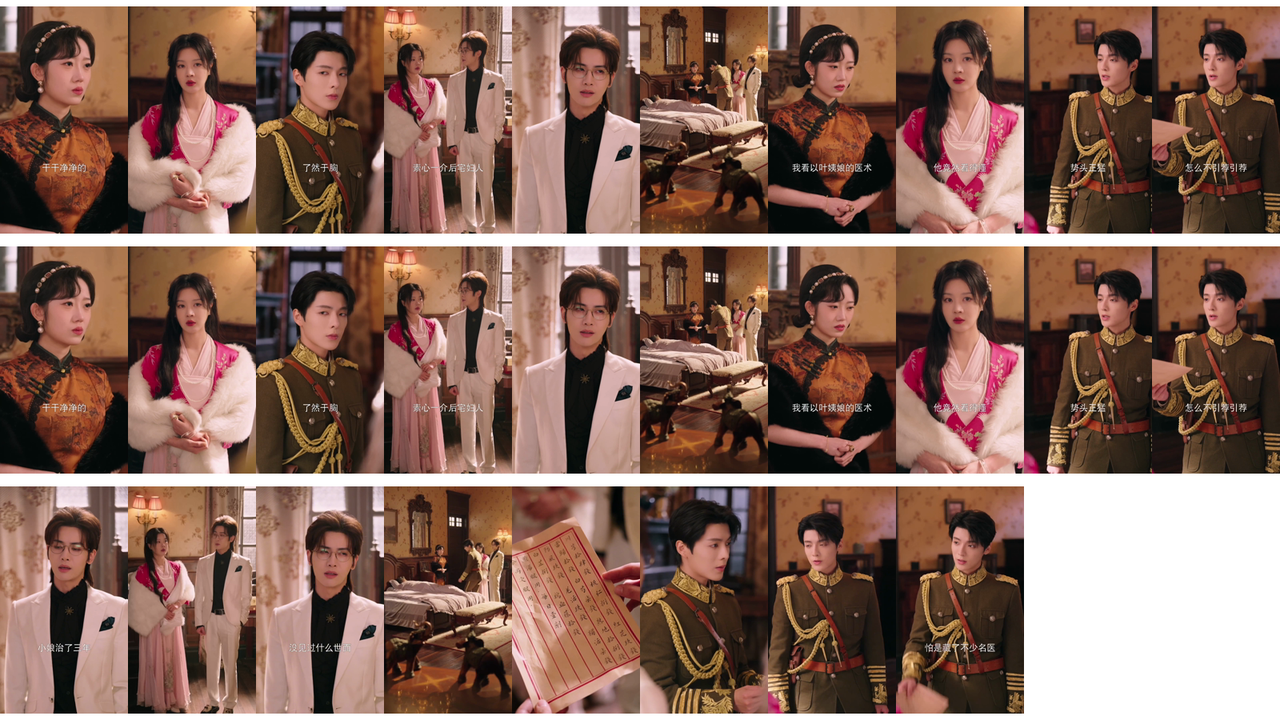
成片有个值得记录的实况:服务端返回了 6 条结果、URL 各不相同,但哈希去重后只有 2 种内容——一条 38.9 秒的"全长版"和一条 32.7 秒的"精简版",重复发生在服务端渲染层面,Agent 只是照单全收落盘。两条的实际差异只有一处:精简版砍掉了原片前 6.2 秒的开场段,全长版基本原样保留。换句话说,在 39 秒的素材上,高光智剪的发挥空间有限,主场显然在长素材。影视拆条没有官方 demo,需要自备电影或剧集(限制:≤180 分钟、≤1080p、必须带音轨、最好有清晰中文对白)。
加餐:能力矩阵快速横扫
80 项能力没法全试,收尾前又顺手点了三个,还是同一套短剧 demo:
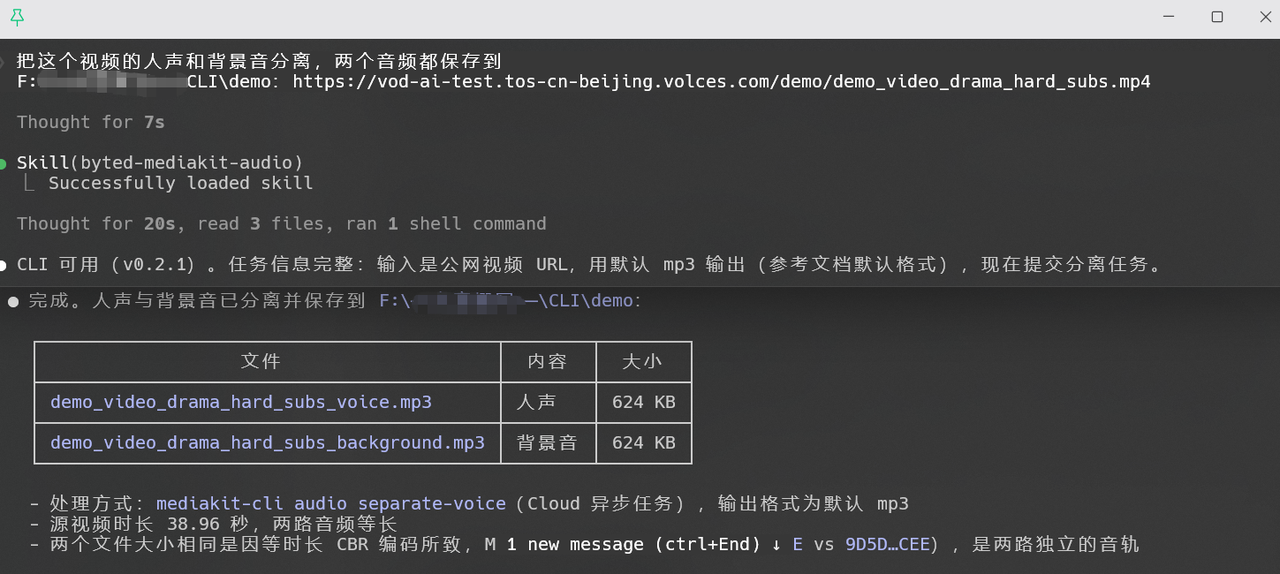
人声分离(audio separate-voice,云端约 3 分钟)。“把人声和背景音拆开”——两路 mp3 各 624KB、等长但 MD5 不同,确实一人一轨。二创配音、扒伴奏,这能力是刚需。
语音转字幕(video asr-subtitles,云端约 1 分半)。17 条带时间戳的 SRT 直接出炉,格式标准到能直接扔进剪辑软件。识别质量要拆开说:日常语句顺畅,古风台词栽了几处——"反倒是窒息"这种现代词明显不对劲,"富家药行"疑似近音误识别。结论:当草稿用很省事,当逐字稿用得再校一遍。
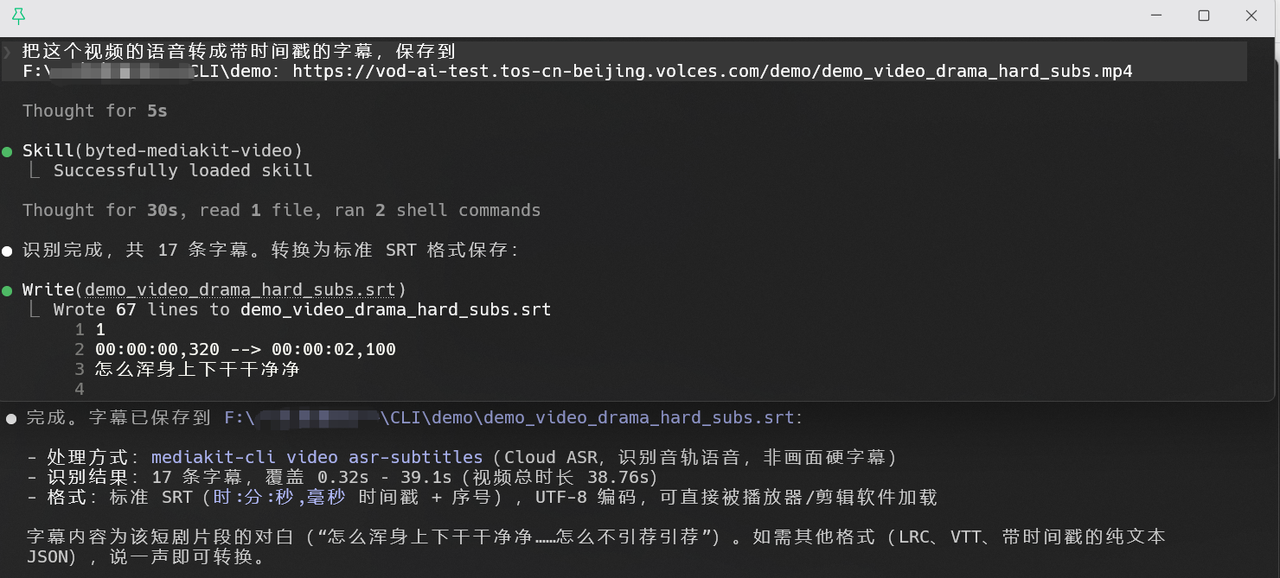
1
00:00:00,320 --> 00:00:02,100
怎么浑身上下干干净净

2
00:00:03,200 --> 00:00:04,540
反倒是窒息

3
00:00:04,880 --> 00:00:06,020
满头大汗

4
00:00:06,440 --> 00:00:07,460
祖母的病

5
00:00:07,640 --> 00:00:09,060
小娘治了三年

6
00:00:09,360 --> 00:00:10,380
了然于胸

7
00:00:10,680 --> 00:00:12,300
治起来当然不费劲了

8
00:00:12,720 --> 00:00:13,960
素心一见

9
00:00:13,960 --> 00:00:16,380
后宅妇人没见过什么世面

10
00:00:16,560 --> 00:00:17,980
紧张了出点汗

11
00:00:24,960 --> 00:00:26,540
我看以叶姨娘的医术

12
00:00:26,600 --> 00:00:28,340
如此高深的药理搭配

13
00:00:28,520 --> 00:00:29,840
怕是开不出来吧

14
00:00:29,840 --> 00:00:31,180
他竟然看得懂

15
00:00:32,400 --> 00:00:34,620
富家药行近年来势头正猛

16
00:00:34,880 --> 00:00:36,380
怕是藏了不少本意

17
00:00:37,720 --> 00:00:39,100
怎么不引荐引荐
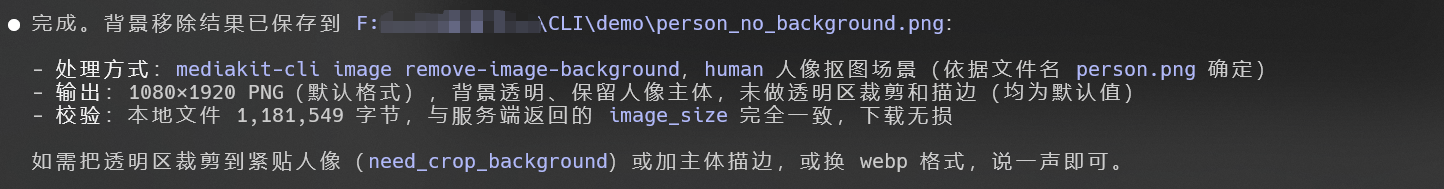
图像抠图(image remove-image-background,同步即返)。从视频抽了一帧人像,一句话抠成透明背景 PNG。这块我特意挑了块硬骨头——人物披着毛绒披肩,绒毛边缘最容易切平。实测边缘干净:无白边、无锯齿、无背景残留,绒毛成缕保留,只有最细的浮毛被略剪。
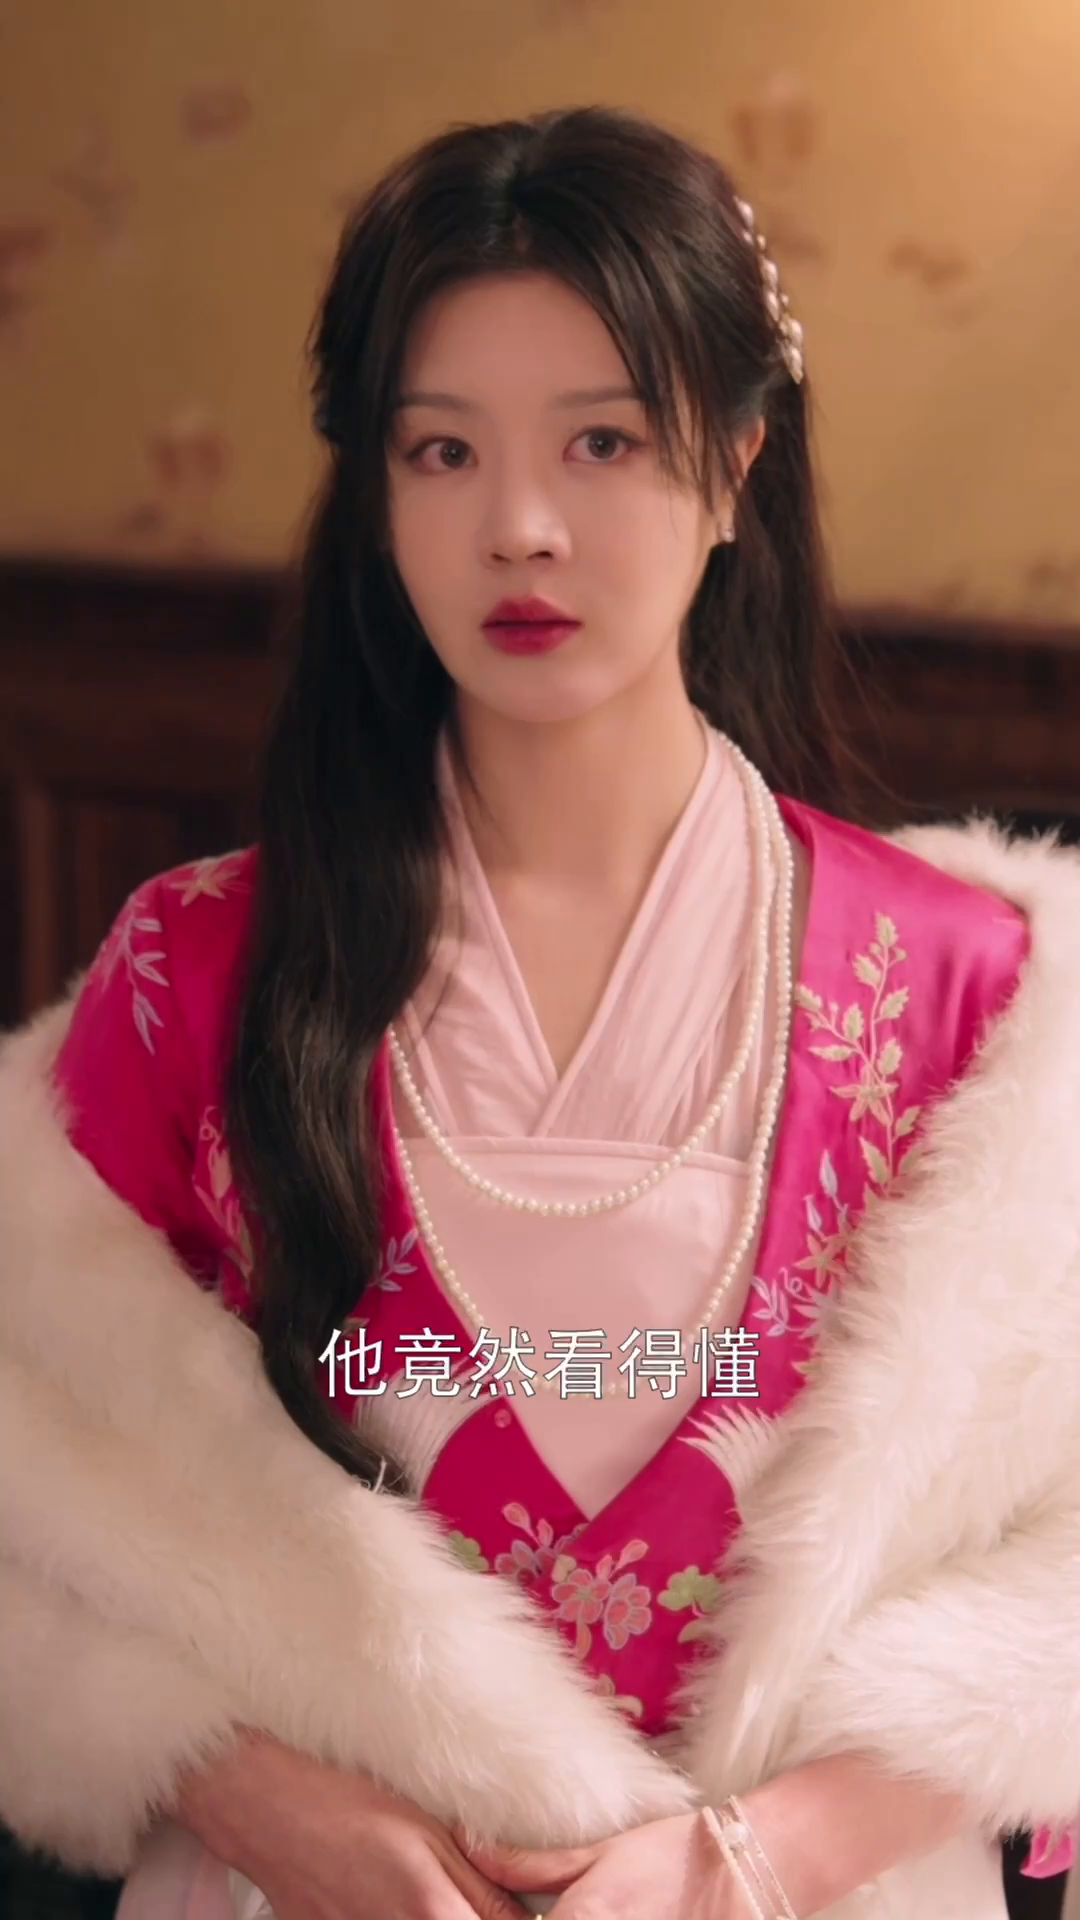 | 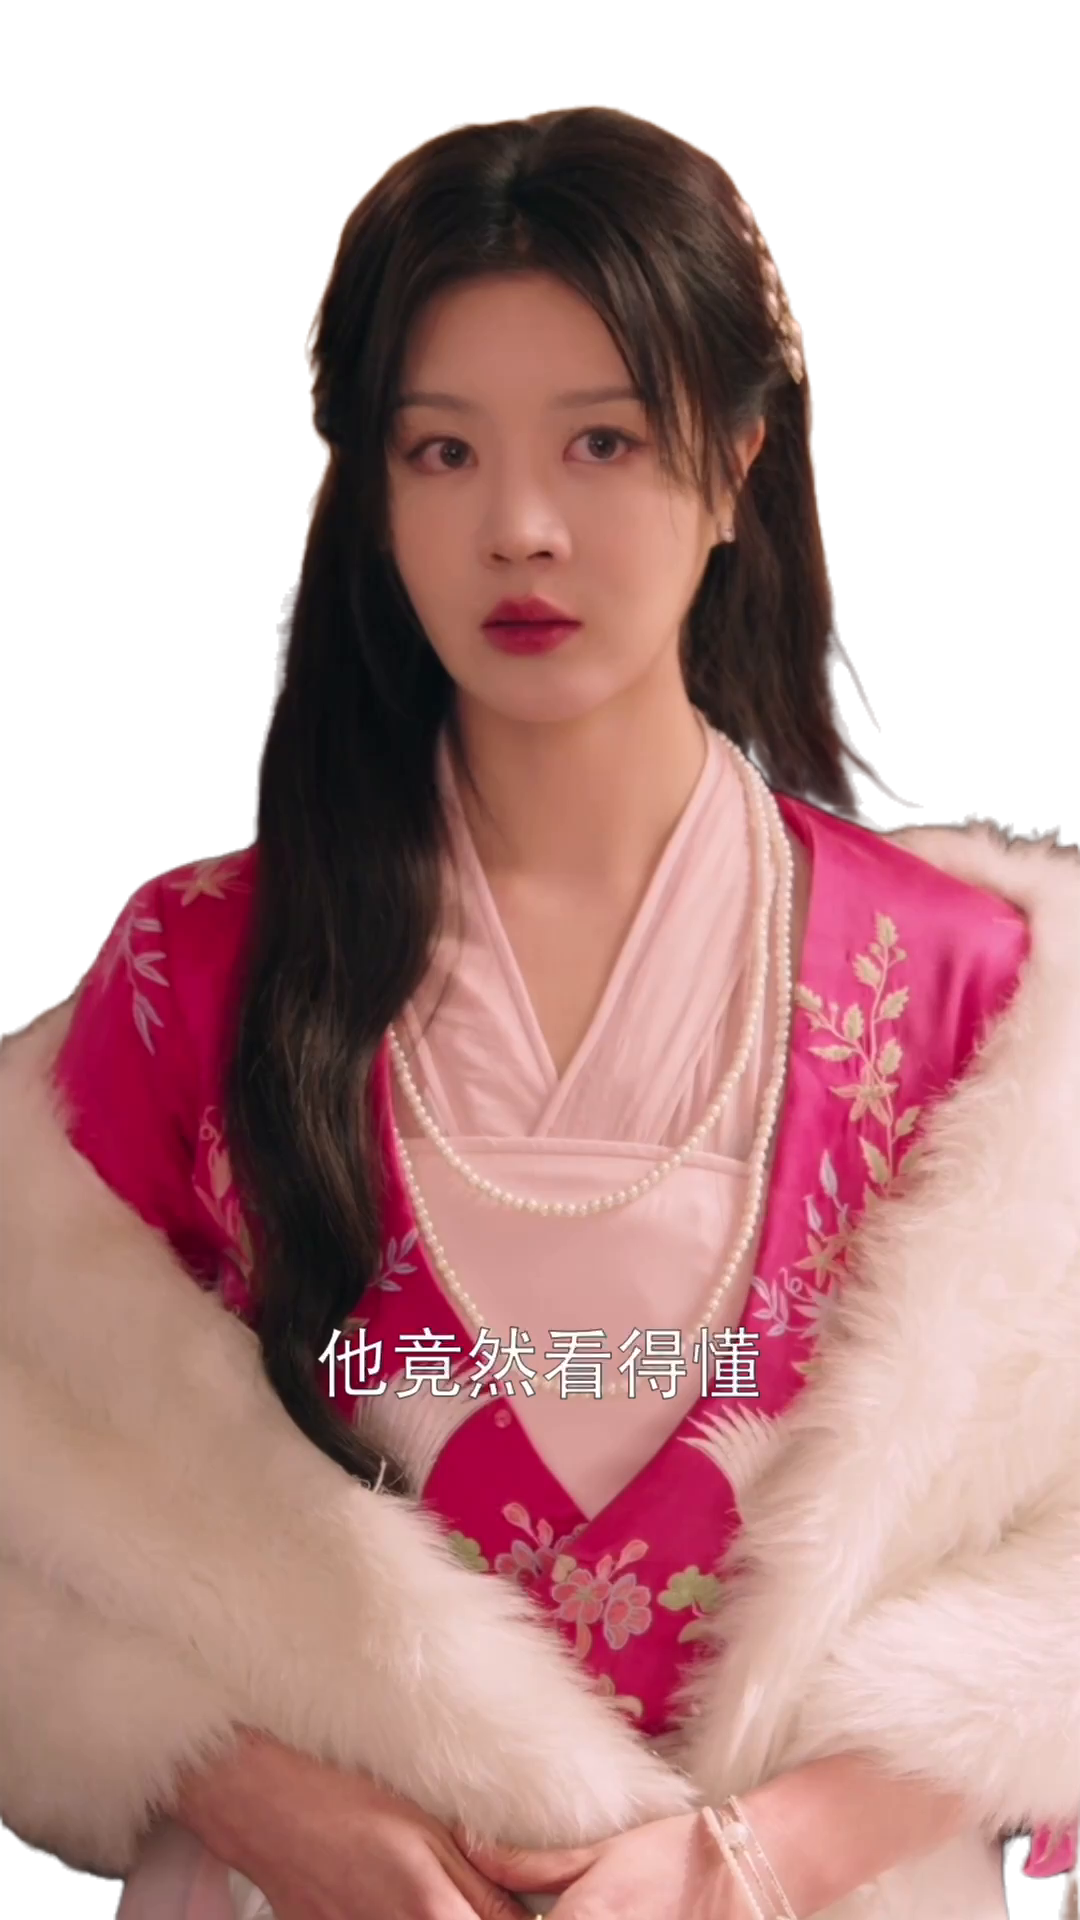 |
三个能力,三种返回节奏(异步音频、异步文本、同步图像),全程没写一行命令。到这个阶段,"能不能用一句话差遣"这件事本身,已经不需要再验证了。
五、深度评价:值不值得装
先说亮点,每条都挂实测证据:
- 自然语言是真零门槛。 前提是你有个趁手的 Agent 壳(Claude Code、Cursor 都行),剩下的就是说话。
- 双模互补,成本可控。 能本地的本地——零成本、同步、即时;必须云端的走云端。本地裁完直接把 URL 喂给云端增强,中间不用人肉搬运文件。
- 能力面确实宽。 80 项起步,从剪辑这类基础活到剧情理解这类高阶活都有,官方路线图上还有视频翻译、漫剧转绘在排队。
- 和 Agent 工作流咬合得好。 异步任务 + task_id + 轮询这套,天然适合 Agent 自己盯着;每个能力带
--schema自省,Agent 能自己发现怎么用;鉴权就一个 Key,不用在对话里摆弄一堆凭证。
再说使用提示,都是实测中碰到或注意到的,提前说给你:
- 云端任务是异步的,要轮询等结果。 Agent 会自己盯,但心理预期要有:不是秒回,等待时长和任务复杂度正相关(官方参考:字幕擦除的处理耗时约为视频时长的 5~9 倍,V5 算法比 V4 快近一半)。
- 按量计费,心里要有数。 公开价目:字幕擦除标准版 0.4 元/分钟、精细化版 1 元/分钟,按输出视频时长计。批量化之前,先小规模试跑算算成本。能走本地的能力(剪辑那 23 项)不花钱。
- 默认 cloud-first 模式下,没配 Key 会静默降级成 local-first,只在标准错误流里打一条警告。手动用无所谓,写自动化脚本时建议显式加
--cloud,让它在缺 Key 时直接报错,而不是悄悄换了个行为。 - 文档页的命令名偶有滞后,以实机为准:查参数用 --help 最准:不同版本的命令名和参数可能略有差异,遇到问题时直接用 --help 查看当前版本的准确用法即可。Agent 场景下它会自动发现正确用法,影响不大。
- 本地模式记得装 FFmpeg ≥5.1,Windows 用户尤其容易漏这步。
- 擦除类能力注意素材授权,合规使用。
横向摆一下位置:FFmpeg 免费强大但要学,而且没有 AI 能力;剪映这类编辑器好用直观,但本质是手动操作,批量是短板;在线 AI 工具单点能力够用,但排队、限速、隐私三个问题摆在那。AI MediaKit 卡的生态位很清楚:Agent 时代的音视频处理自动化层——你管说话,它管干活。
适合谁:开发者(批处理、流水线、CI 里挂任务);自媒体二创(拆条、去字幕、画质增强一条龙);想给自家产品加音视频能力、又不想养算法团队的团队。
六、总结
那天晚上,我从"翻硬盘找素材"开始,到三个场景全部跑完,中间还顺手玩了几个加餐。回头看最有意思的瞬间,还是开头那张图:我输入"把这个视频里的字幕擦掉",然后看着 Agent 自己挑命令、提交任务、盯轮询、把结果递回来。
我的结论很简单:重复的、批量的、需要查 FFmpeg 手册的活,放心交给它——一句话的成本,换一段无人值守;要艺术判断的精细剪辑、要抠每一帧的活,还是自己上。
工具换了形态,判断力还是你自己的。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2401_86326742/article/details/166251508

