

本文记录 SenseNova U1.5 Lite 在 Windows 和 8GB NVIDIA 显卡上的 ComfyUI 部署、工作流整理与底层加速实践。
有视频有真相:
2048×2048,8 steps
Prompt:A beautiful young woman with long dark hair, wearing a simple white blouse, standing in a sunlit garden, natural expression, realistic portrait photography, soft daylight, natural skin, sharp facial details, no text, no watermark.
comfyui_sensenova_acceleration
前一版主要解决了 Q8 GGUF 在本地运行的问题。这次继续向下做了一层:Q8权重部分量化为INT8、把生成分支接入 ConvRot W8A8、硬件 fused dequant + INT8 GEMM、合并 QKV/gate-up 和 cuDNN GQA,并保留 TeaCache 作为可选项。重点不是换一个启动参数,而是减少量化、反量化和权重搬运过程中的重复开销。
在同一台 RTX 4070 Laptop 8GB 上,2048×2048、8 步、low + pageable 配置的已有记录如下:
- Q8 GGUF 基线:117.03 秒
- ConvRot W8A8 + cu130 fused dequant + INT8 GEMM + 合并投影 + cuDNN GQA:41.82 秒,约 2.80 倍加速
- 在上面的组合上开启 TeaCache:36.85 秒,约 3.18 倍加速
时间均为模型加载完成后的生图阶段。本文同时说明如何直接使用一键安装包,以及这套优化在实际工作流中解决了什么问题。
一、项目内容
项目由两部分组成:
ComfyUI-SenseNova-U1.5-Lite-Q8:Q8 GGUF、本地 ComfyUI 节点、工作流和 Windows 便携部署。ComfyUI-SenseNova-U1.5-Lite-Acceleration:面向生成分支的 ConvRot W8A8 和硬件 kernel 加速层。
两部分可以单独使用。只想先体验模型,可以使用 Preview 或 Lite 一键包;希望测试底层加速,再使用 U1.5lite int8加速 目录中的版本。
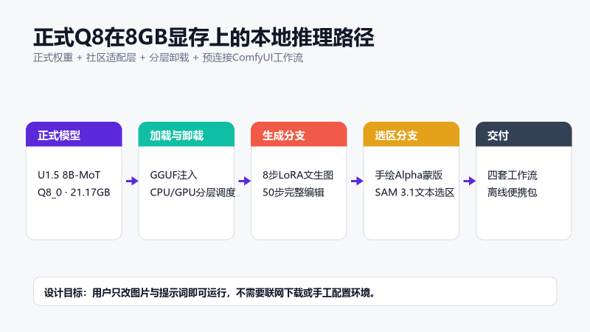
图 1 项目结构:模型、ComfyUI、工作流和加速层分开管理
二、实机环境
本次记录使用的机器和软件版本如下:
GPU                 NVIDIA GeForce RTX 4070 Laptop GPU
显存                8 GiB(约 8188 MiB)
计算能力            SM89
CPU                 Intel Core i7-14650HX,16 核 24 线程
内存                31.8 GiB
系统                Windows 11
Python              3.12.x
PyTorch             2.9.1+cu130
CUDA                13.0
comfy-kitchen       0.2.27
显存模式            low
主机内存            pageable
Attention           cuDNN GQA
Q8 主模型文件为:
SenseNova-U1.5-8B-MoT-Q8_0.gguf
文生图工作流使用官方 8-step LoRA。局部编辑、SAM 选区、图文交错和整图重绘使用正式基础模型。这样分开配置,文生图适合快速试图,编辑流程则保留更多输入图像信息。
三、三个一键包怎么用
同一个百度网盘地址下现在有三个目录:
U1.5 previewU1.5 liteU1.5lite int8加速
三个目录都是一键安装和一键启动版本,压缩包密码统一为 123,网盘提取码为 yuwn。
1. 下载和解压
下载后选择需要的目录,解压到非系统盘。建议放在 E:\SenseNova 或其他空间充足的目录,不要放在带有同步软件的临时目录中。
百度网盘下载:
https://pan.baidu.com/s/14IDSNH2aBfqOcfGqq-D4gA?pwd=yuwn
解压密码:
123
网盘提取码:
yuwn
2. 安装运行环境
进入所选目录后,第一次使用双击对应的安装脚本:
U1.5 preview       安装_SenseNova_便携版.bat
U1.5 lite          安装_SenseNova_便携版.bat
U1.5lite int8加速  install_int8.bat
安装包已经包含便携 Python、PyTorch、ComfyUI、自定义节点、工作流和运行依赖。安装脚本主要负责检查路径、目录和依赖,不需要用户重新搭建 Python 环境。
3. 启动 ComfyUI
安装完成后,根据需要双击工作流入口:
01_文生图.bat
02_局部替换.bat
03_SAM自动选区替换.bat
04_图文交错生成.bat
05_图片文字整图重绘.bat
浏览器打开:
http://127.0.0.1:8188
启动脚本会检查端口、模型和工作流路径。首次加载模型需要等待,之后可以在 ComfyUI 中直接打开已经接好的 JSON 工作流。
4. 停止服务
使用完毕后双击:
U1.5 preview / U1.5 lite       停止_SenseNova.bat
U1.5lite int8加速              stop_int8.bat
脚本只清理本目录启动的 ComfyUI 和 Python 进程,不影响其他程序。
四、工作流入口
当前包内已经准备好几类常用流程,用户不需要从空白画布开始接线。
1. 8 步 LoRA 文生图
适合快速测试提示词、生成参考图和批量预览。本文的房间金属球参考图就是通过这条流程生成的。
2. 提示词 + 图像编辑
把已有图片和一段自然语言一起送入编辑节点,适合替换物体、改变材质、调整颜色和修改局部内容。
3. 手工蒙版局部编辑
先在 ComfyUI 中载入蒙版,再进入局部编辑。适合明确知道修改区域的情况,padding、feather 和 edge cleanup 可以按目标边界调整。
4. SAM 3.1 自动选区
用目标描述得到选区,再交给局部编辑节点完成替换,减少手工涂蒙版的步骤。
5. 图文交错和整图重绘
用于更复杂的文字和图像输入。对应工作流已经保留,用户可以按自己的素材继续测试。
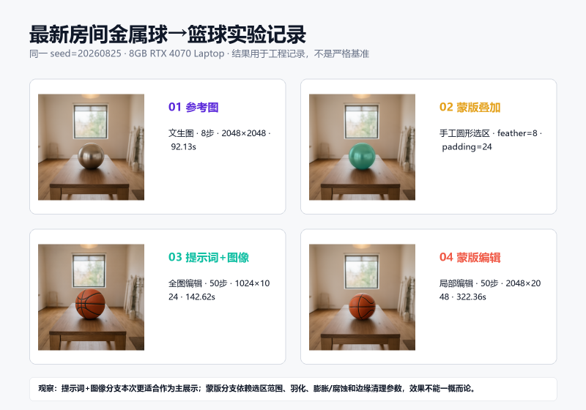
图 2 从参考图、选区到替换结果的连续工作流记录
五、实际案例:把金属球替换成篮球
1. 生成参考图
先用 8 步 LoRA 生成一个自然采光的房间,桌面放置一个抛光金属球。实验记录为 2048×2048,约 92.13 秒。
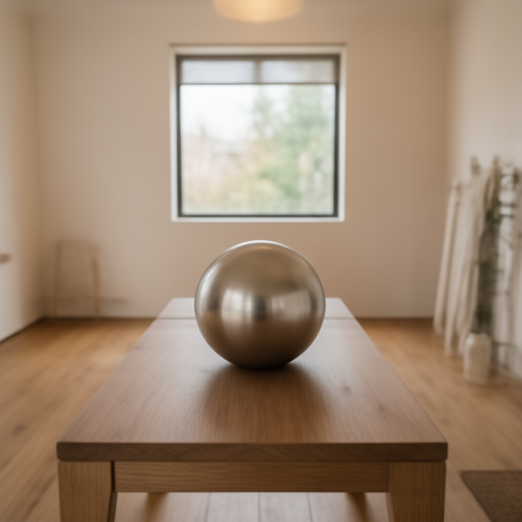
图 3 文生图得到的房间与金属球参考图
2. 使用提示词 + 图像完成替换
将参考图作为输入,再使用下面的提示词:
Replace the single polished metal sphere on the table with one regulation
orange leather basketball with black channels. Keep the same room, table,
camera angle, perspective, lighting, shadows, cup, book and background.
Photorealistic, no extra objects, no text, no watermark.
这段提示词分为三部分:先说明动作是 Replace,再指定篮球的材质和外观,最后列出需要保留的房间、桌面、相机角度、光照和背景元素。提示词+图像编辑这次记录约 142.62 秒。
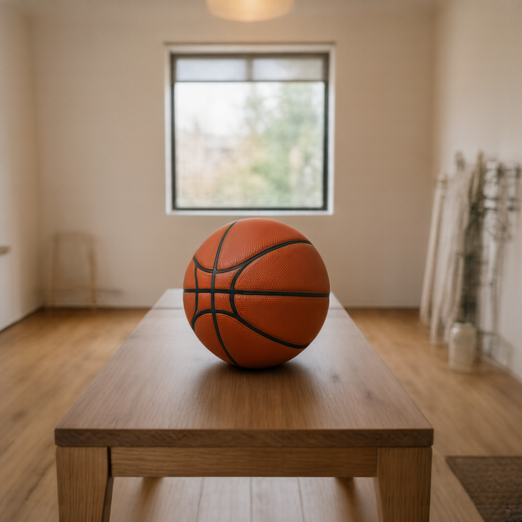
图 4 提示词 + 图像编辑后的篮球结果
3. 使用蒙版进行局部编辑
同一张参考图也可以进入蒙版流程。先确认蒙版选区和 alpha 方向,再设置 padding、羽化和边缘清理参数。修正后的记录中,金属球已经被篮球完整替换,背景和桌面保持在原有位置。
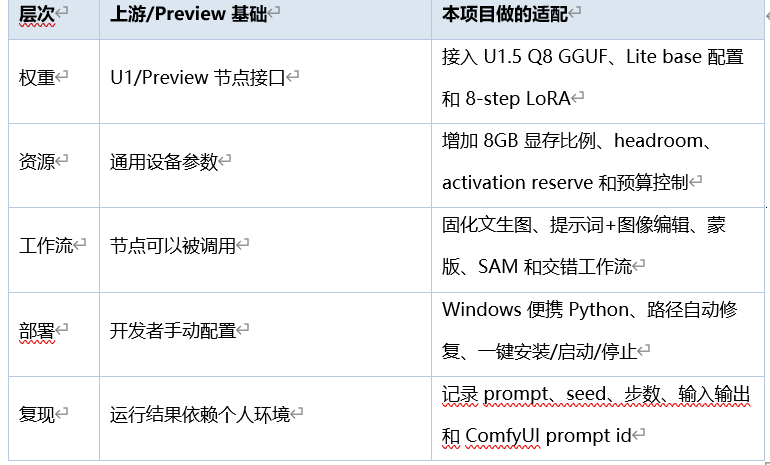
图 5 局部编辑前的蒙版和节点配置记录
蒙版流程适合需要明确控制修改区域的场景;提示词+图像流程则更适合快速试效果。两条路径都保留在工作流包中,可以根据素材选择。
六、底层加速做了什么
这次加速主要处理生成分支中的矩阵计算、量化和权重搬运。
1. 硬件 fused dequant + INT8 GEMM
传统路径可能先将 INT8 权重恢复成浮点,再进行矩阵乘。这样会产生额外的中间张量和显存读写。本项目使用 comfy-kitchen 提供的 CUDA kernel,把反量化和 GEMM 尽量合并到同一条硬件路径中,直接利用 Tensor Core 计算能力。
2. ConvRot W8A8
将Q8权重部分量化为INT8,权重按输出通道做 INT8 重排和缩放,激活在运行时按行量化。转换结果保存为独立分片和 manifest,不修改原始 GGUF。当前覆盖 42 层、294 个生成分支投影模块。
3. 合并 QKV 和 gate/up
Q、K、V 使用同一组输入,MLP 的 gate 和 up 也使用同一组输入。合并处理可以减少重复量化和重复搬运,尤其适合显存只有 8GB 的场景。
4. cuDNN GQA
注意力路径使用 cuDNN GQA,并在实验日志中记录实际 backend、调用次数和 token 数量,便于确认运行时确实走到目标路径。
5. TeaCache
TeaCache 保持为可选项。当前 8 步实验中,阈值为 0.35,最少计算 2 步,最多跳过 1 步,实际跳过了一次完整的 42 层 decoder pass。它让记录从 41.82 秒降到 36.85 秒,但主要收益仍来自 fused kernel 和 ConvRot W8A8。
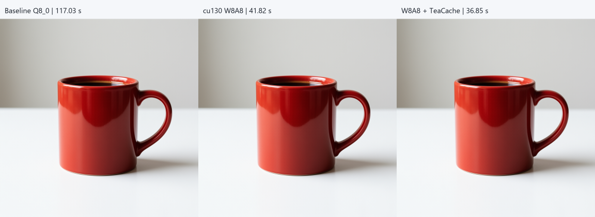
图 6 Q8 基线、ConvRot W8A8 与 TeaCache 的同配置对照
七、实验记录
本次对照使用相同的提示词、seed、分辨率和 8 步设置,比较模型加载后的生图阶段:
分辨率            2048×2048
采样步数          8
显存模式          low
主机内存          pageable
Attention         cuDNN GQA

Q8 GGUF 基线      117.03 s
ConvRot W8A8      41.82 s
加 TeaCache       36.85 s
另有一组 1 步短测:
Q8 GGUF 基线      58.52 s
ConvRot W8A8      17.79 s
1 步短测用于确认 kernel 路径,正式展示以 8 步对照为主。实验日志、图片哈希、manifest 和运行报告都保存在项目的 experiments 目录中。
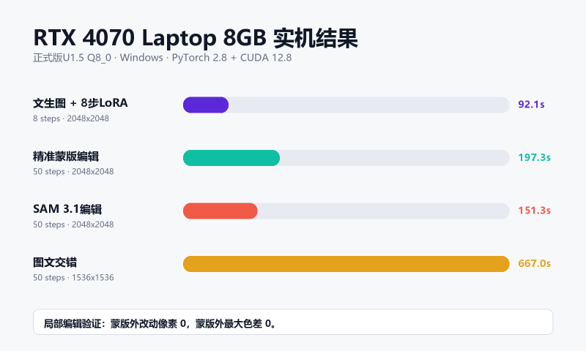
图 7 加速前Q8权重多工作流运行记录和时间对照
八、源码、权重和一键包
源码仓库:
- Q8 工作流与节点:https://github.com/superalp1985/ComfyUI-SenseNova-U1.5-Lite-Q8
- 加速层:https://github.com/superalp1985/ComfyUI-SenseNova-U1.5-Lite-Acceleration
百度网盘一键包:
https://pan.baidu.com/s/14IDSNH2aBfqOcfGqq-D4gA?pwd=yuwn
网盘目录中包含:
U1.5 preview:Preview 便携运行环境和工作流。U1.5 lite:Lite 便携运行环境和工作流。U1.5lite int8加速:加入 ConvRot W8A8 和硬件 fused dequant + INT8 GEMM 的加速版本。
三个目录都是一键安装、一键启动,压缩包密码统一为 123,网盘提取码为 yuwn。仓库主要放代码、工作流、文档和示例图,模型权重通过网盘提供,避免 GitHub 仓库被大文件占满。
九、适合的使用场景
- 产品和广告草图:先生成场景,再替换产品、材质或颜色。
- 游戏美术预研:快速测试道具、环境和风格变化。
- 室内与展陈方案:保持机位和空间结构,替换家具与摆件。
- 活动内容制作:在本地完成图片初稿,减少素材来回上传。
- ComfyUI 教学与二次开发:直接打开工作流,查看节点、参数和输出。
这套方案的重点是把模型能力落到普通设备上:下载后解压,运行安装脚本,双击工作流入口即可开始使用;需要进一步研究时,再从源码仓库和实验记录入手。
十、总结
这次工作在原有 Q8 本地部署基础上,补上了生成分支的底层加速路径。通过将Q8权重部分量化为INT8,采用 cu130、comfy-kitchen、硬件 fused dequant + INT8 GEMM、ConvRot W8A8、合并投影和 cuDNN GQA,2048×2048、8 步生图的已有记录从 117.03 秒降到 41.82 秒;开启 TeaCache 后为 36.85 秒。
同时,Preview、Lite 和 Lite INT8 加速三个一键包已经按目录整理,运行环境、依赖、ComfyUI、节点和工作流一并提供。用户可以直接下载体验,也可以从 GitHub 代码和实验记录继续改造。
官方项目:https://github.com/OpenSenseNova/SenseNova-U1
需要提前说清楚的边界
第一,本文的时间是单机实验记录,不是跨硬件、跨驱动的正式 benchmark。温度、后台负载、缓存状态、输入分辨率和模型驻留方式都会改变实际耗时。
第二,提示词+图像编辑表现较好,说明这条路径在本次案例中是可用的,但不等于所有图片都能得到相同结果。提示词最好把动作、目标、位置关系和保留项写清楚。
第三,蒙版替换必须承认调参局限。选区偏移、alpha 方向、羽化、padding、腐蚀/膨胀和边缘清理都会影响最终结果,同一个参数不可能适合所有主体。文章展示的是一组修正后的实验结果,不是对所有素材的普遍承诺。
第四,当前加速层是 Q8 GGUF 之上的生成分支 overlay,不是完整纯 INT8 权重。理解分支和其他未覆盖部分仍由 GGUF 提供,这样做是为了在收益、质量和工程可回滚性之间取得平衡。
第五,fast 显存模式在当前 8GB 硬件上仍需谨慎,稳定推荐是 low + pageable。别为了让启动日志看起来更激进,就把系统内存和显存一起逼到墙角。
SenseNova U1.5 Lite 这次实践最有价值的地方,不是把 8GB 显卡包装成了 80GB,也不是宣布所有工作流从此都能秒出。它做的是一件更踏实的事:把模型、节点、工作流、显存策略、硬件 kernel 和分发方式串成一条可以走通的路。
在这条路上,2048×2048 文生图约 92.13 秒,提示词+图像篮球替换约 142.62 秒;加速实验中,Q8 基线约 117.03 秒,ConvRot W8A8 约 41.82 秒,叠加 TeaCache 后约 36.85 秒。它们都不是实验室里脱离现实的数字,而是这台 8GB 移动显卡在具体配置下留下的脚印。
所以我的判断很简单:8GB 显卡当然不是什么奢侈配置,但也没有必要因为它不奢侈,就放弃本地创作。只要工作流设计得当、参数边界写清楚、实验记录不藏着掖着,本地模型一样可以完成一些实际工作。至于要不要把它再推向更快、更省显存、更大分辨率,那就是下一轮实验的事情了。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2611_95631403/article/details/164092959

