

贪心核心思想:每一步只做当前局部最优的选择,希望最终得到全局最优解
一、区间问题概念
区间:一般用 [start, end] 表示一段范围,比如 [1,3],起点 1,终点 3。
区间类贪心常见题型:
1、区间选点:最少放几个点,覆盖所有区间
2、区间覆盖:用最少区间覆盖目标线段
3、无重叠区间:最多能选出多少互不重叠的区间
4、区间合并:把重叠 / 相邻区间合并成不重叠区间
区间贪心通用套路:先排序
排序两种常用策略:
1、按区间右端点从小到大排序(区间选点、无重叠区间优先这个)
2、按区间左端点从小到大排序(区间合并、区间覆盖常用)
为什么优先按右端点排序?
每次选结束最早的区间,留给后面剩下的空间最大,局部最优,进而全局最优。
二、核心重点总结
1、贪心解题固定两步:
第一步:确定排序规则(区间左 / 右端点)
第二步:写出贪心选择策略,并证明局部最优→全局最优
2、区间重叠判断:
两个区间 [s1,e1]、[s2,e2],假设已经排序 e1 <= e2
若 s2 < e1 → 区间重叠;s2 >= e1 → 不重叠
3、易错点:
排序写错(把左端点排序当成右端点排序,直接结果错误)
边界:[1,2] 和 [2,3] 一般视为不重叠(端点接触不算重叠)
回溯本质:暴力搜索 + 剪枝
回溯就是深度优先 DFS,尝试所有可行方案,当发现当前路径走不通,就回退到上一层(撤销选
择),尝试别的分支。
模板核心四步:选择 ——> 递归 ——>撤销选择(回溯)
1、 排列问题
从集合中选出元素排成有序序列,顺序不同算不同结果。
例:[1,2],排列:[1,2]、[2,1]
特点:
元素不能重复选,需要标记used数组记录元素是否已经选过
排列关注顺序,所以每次递归都从头遍历数组
2. 子集问题
从集合选出元素,不考虑顺序,[1,2]和[2,1]是同一个子集。
例:[1,2]的子集:[] [1] [2] [1,2]
特点:
为了避免重复子集,递归时只从当前位置往后遍历,不回头选前面元素
不需要used数组,用startIndex控制起始下标
3. 去重概念
去重分为两种:
1、树层去重(最常用,子集 / 组合):同一层递归,不能选取相同数值元素,避免出现重复集
合。需要先排序数组,判断 nums[i]==nums[i-1],跳过。
2、树枝去重:同一个分支内不能重复选取同一个元素,用used数组(排列问题)。
重点区分:
子集:用startIndex,控制只向后取;有重复元素数组要排序 + 树层去重
排列:用used数组标记是否被选;有重复元素数组要排序 + 树层去重
二、回溯通用模板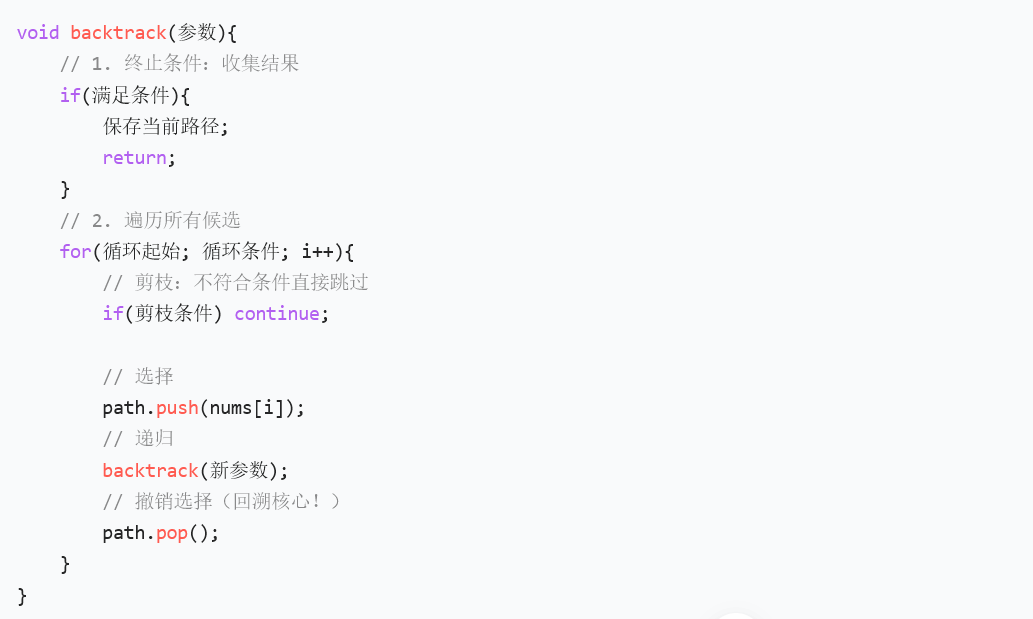
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2601_96469072/article/details/165871241

