

目录
一、先说下背景
我在虚拟机里装了个金仓数据库,然后往里面塞了一张订单表。这张表吧,数据量不算特别大,大概10万条左右。表结构其实挺简单的,就是下面这个样子:
CREATE TABLE orders (
    id SERIAL PRIMARY KEY,
    order_no VARCHAR(20),
    customer_name VARCHAR(50),
    amount DECIMAL(10,2),
    order_date DATE,
    status VARCHAR(10)
);
字段的话呢,就是订单号、客户名、金额、下单日期、状态这几个。数据是我用随机方式生成的,日期分布在最近一年左右,每个月的都有一点,还算比较均匀。
然后有一个查询场景,就是按日期范围去查订单。具体来说,查的是2026年1月1号到6月30号这半年的数据。
最开始的时候,表里是没有建任何索引的。我当时想的是,10万条数据其实也不算多,应该不会太慢吧。结果真跑了一下,发现情况跟我想的不太一样。
二、先确认一下数据量
我先执行了一条 SELECT COUNT(*) FROM orders;,确认了一下表里到底有多少条数据。结果显示是10万条整,不多不少。
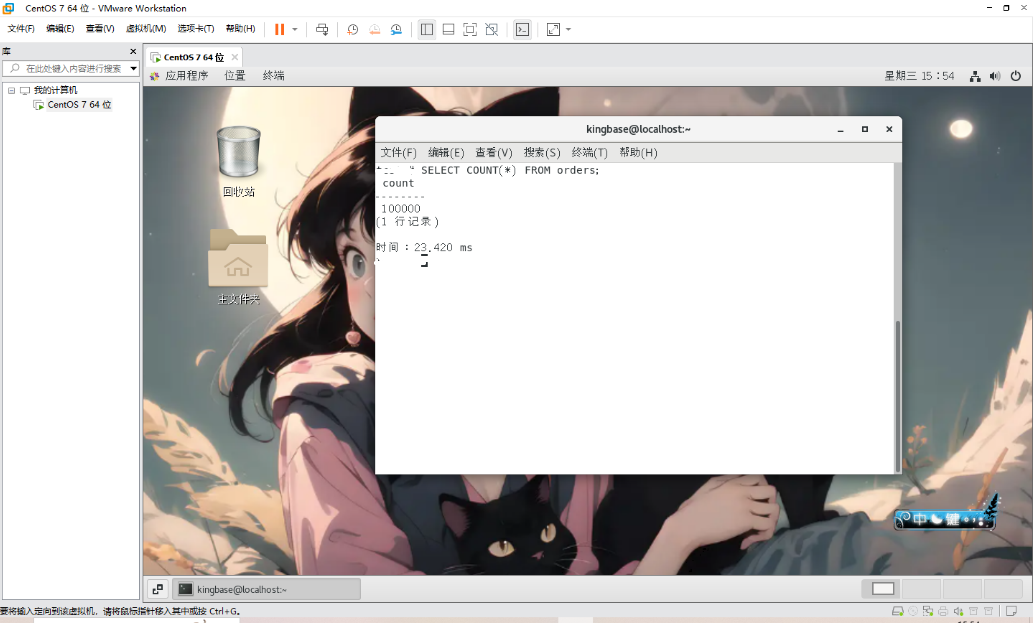
这个数据量怎么说呢,你说它大吧,其实也就10万,不算大。你说它小吧,也不小了,毕竟百万千万级的数据量也是从这个量级涨上去的。我当时想着,加个索引应该能快不少吧,结果后面的情况,怎么说呢,有点出乎意料。
三、没加索引的时候,到底有多快?
我先查了一下符合条件的订单到底有多少条,用的是这条语句:
SELECT COUNT(*) FROM orders WHERE order_date >= '2026-01-01' AND order_date <= '2026-06-30';
命中了 49600条。也就是说,这半年的数据占了全表数据量的差不多一半,49.6%的样子。
然后我就跑了一下全量查询,看看不加索引的情况下,查这49600条数据要花多长时间。语句是这样的:
SELECT * FROM orders WHERE order_date >= '2026-01-01' AND order_date <= '2026-06-30';
结果是返回了49600行,耗时 171.146 ms。
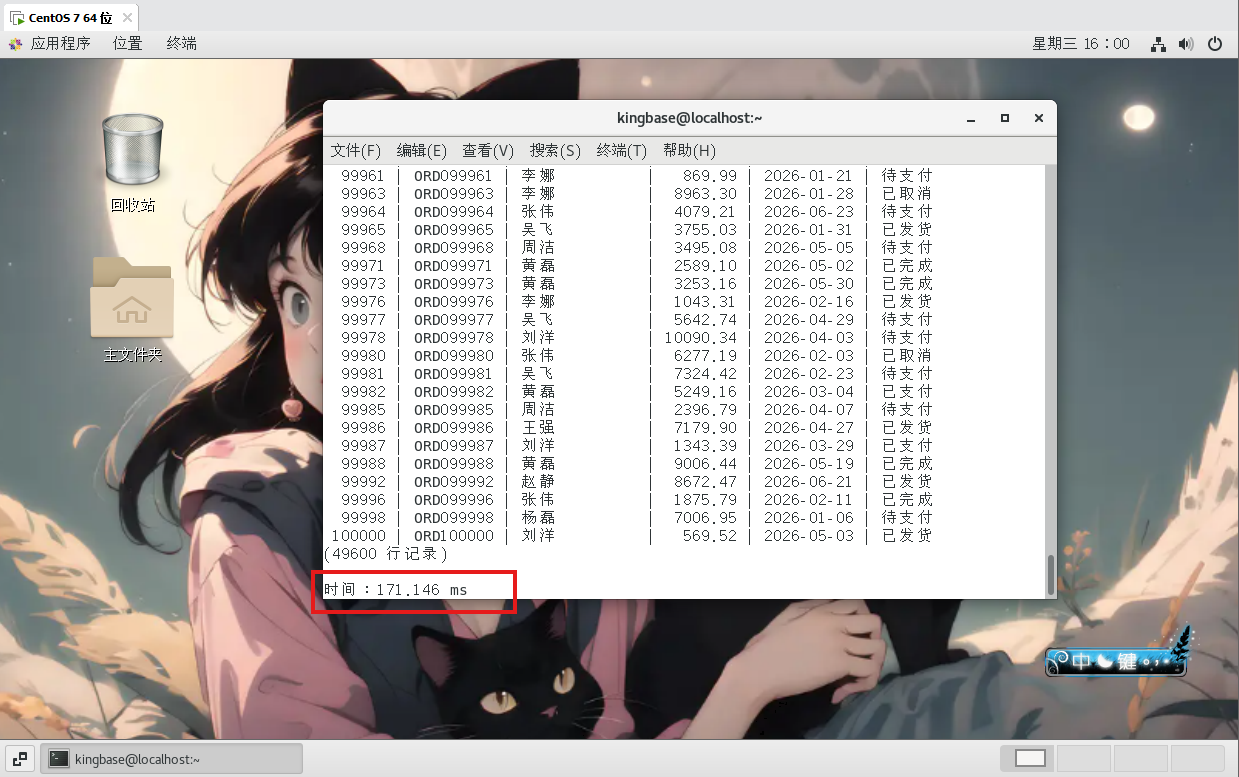
100多毫秒这个速度吧,说实话,如果是我自己一个人查着玩,其实感觉还行,不算慢。但是你要这么想,如果这是一个业务系统里的功能,用户点一下按钮就要等100多毫秒,那体验上就不太友好了。而且数据量再翻几倍的话,这个时间肯定还会往上涨。
然后我用了 EXPLAIN ANALYZE 看了一下执行计划,想搞清楚这个查询到底是怎么执行的:
EXPLAIN ANALYZE SELECT * FROM orders WHERE order_date >= '2026-01-01' AND order_date <= '2026-06-30';
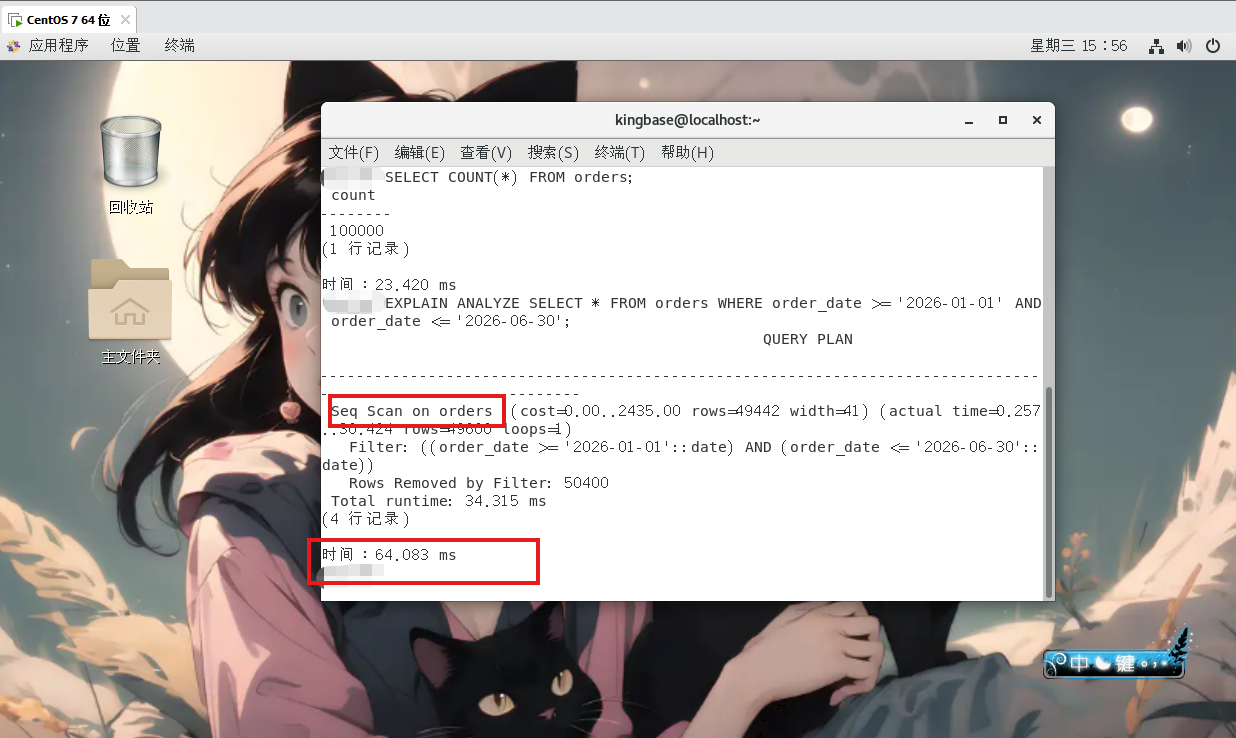
执行计划里显示的是 Seq Scan on orders。Seq Scan 是什么意思呢?就是全表扫描。也就是说,数据库把整张表的10万行数据从头到尾翻了一遍。
它怎么做的呢?就是一行一行去判断,这一行的 order_date 符不符合我给出的范围条件。符合的就留下,不符合的就扔掉。执行计划里还有一行是 Rows Removed by Filter: 50400,这个数字说明,数据库翻了10万行,其中50400行被过滤掉了,剩下的49600行就是最终返回的结果。
也就是说,这个查询把整张表从头到尾读了一遍,不管数据在不在范围内,每条都扫了一遍。这个操作的工作量是固定的,就是10万行。
四、那就加个索引试试呗
既然查询条件是日期字段,那按照常规的思路,给 order_date 加个索引应该能提速吧?
我当时也是这么想的,所以就建了一个索引:
CREATE INDEX idx_order_date ON orders(order_date);

索引建好了,看了一下耗时,花了 514.049 ms。对于一张10万条数据的表来说,这个建索引的速度其实还算正常,不算快也不算慢。
五、加了索引之后呢?反而更慢了……
索引建好之后,我重新跑了一遍同样的查询,语句还是那个语句,没变:
SELECT * FROM orders WHERE order_date >= '2026-01-01' AND order_date <= '2026-06-30';
结果你猜怎么着?这次耗时变成了 262.512 ms。
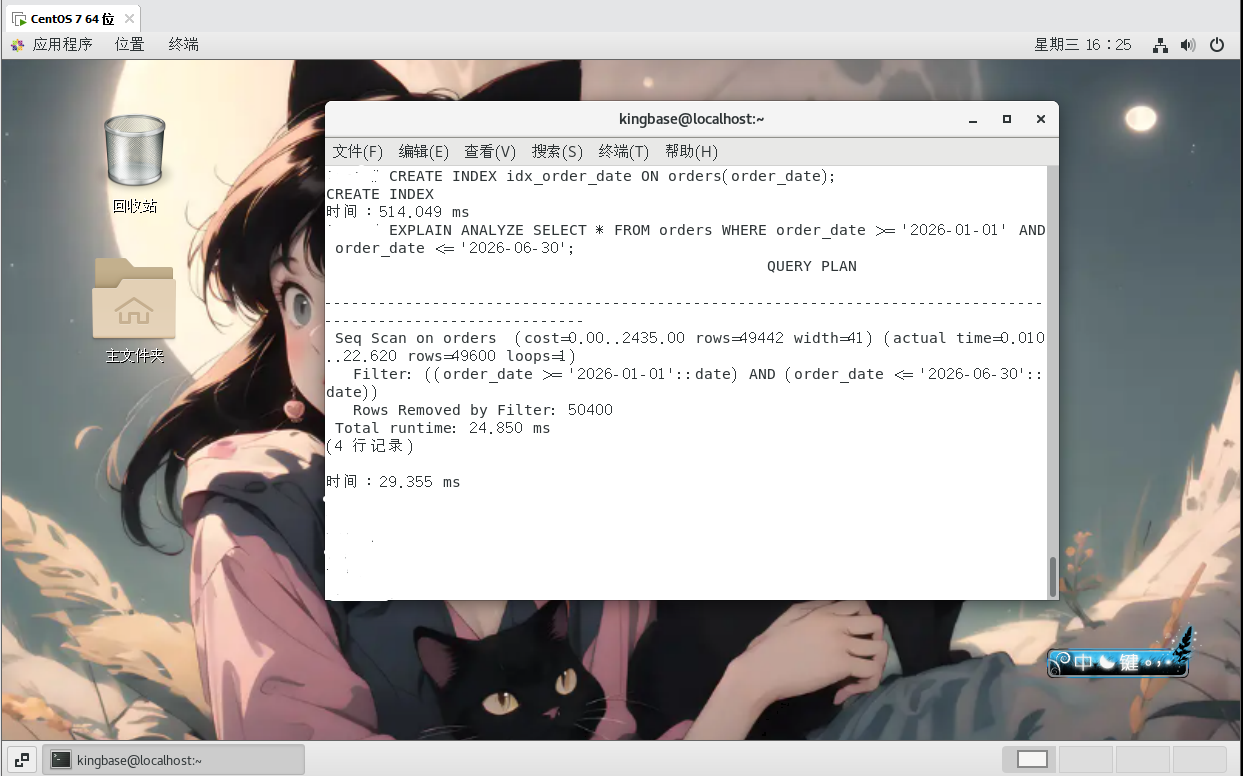
不加索引的时候是171ms,加了索引反而变成了262ms,慢了差不多50%。这个结果确实有点出乎我的意料。
然后我又看了一次执行计划:
EXPLAIN ANALYZE SELECT * FROM orders WHERE order_date >= '2026-01-01' AND order_date <= '2026-06-30';
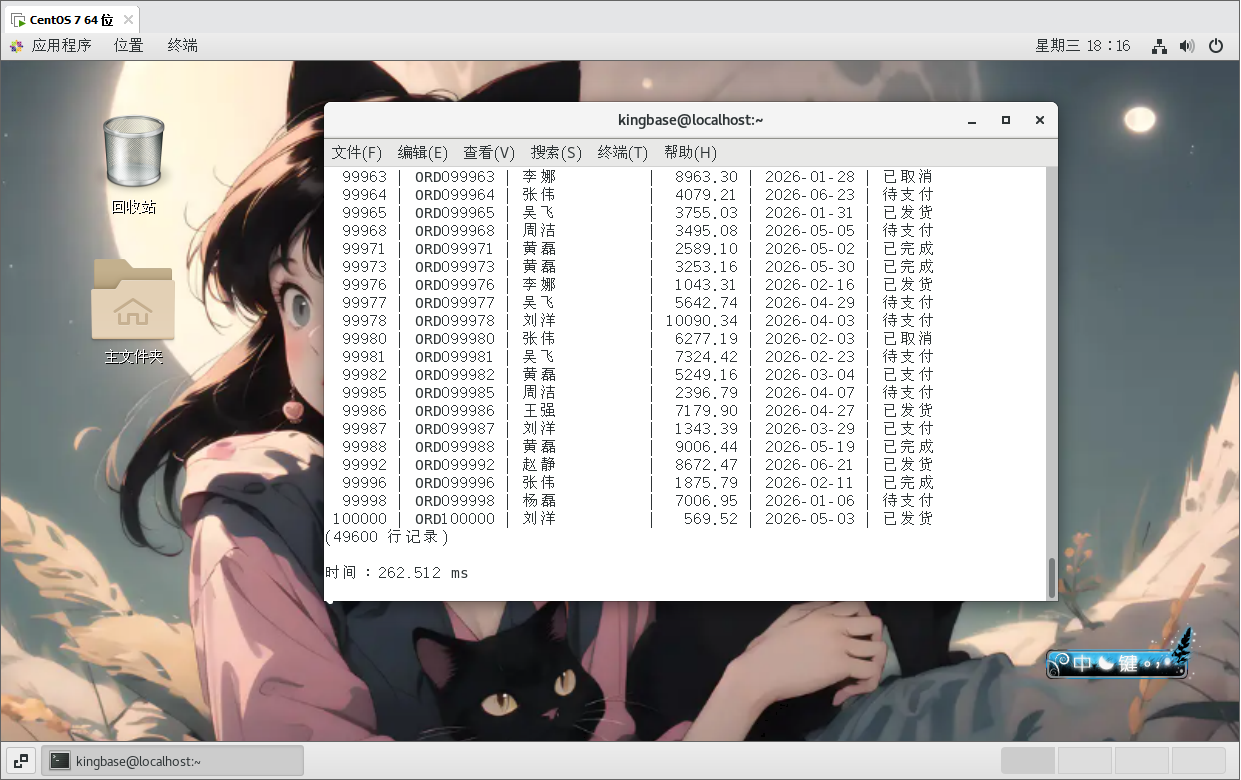
执行计划依然是 Seq Scan on orders,也就是说,索引压根没用上。
我花了514ms建了个索引,结果查询的时候根本没走索引,还是老老实实去扫全表。更尴尬的是,因为索引本身占用了存储空间,数据插入和维护的时候还要额外去更新索引,这部分开销反而让查询变得更慢了。
六、那为什么加了索引却不走呢?
这个问题我琢磨了一下。原因其实没有那么复杂。
一个原因是数据占比的问题。 我查的是2026年上半年的数据,占了全表的49.6%,差不多快一半了。数据库的优化器其实是一个成本计算器,它会算一笔账:如果走索引的话,需要先查索引树,找到所有符合条件的行的物理位置,然后还要回表去取完整的数据行。如果命中的数据量太大,比如超过全表的20%或者30%,那回表的成本可能比直接扫全表还要高。
另一个原因就是优化器的成本估算。 优化器会比较不同的执行路径,选一个它认为成本最低的。在这个场景里,优化器觉得全表扫描的成本更低,所以就选了全表扫描。这个选择其实是对的,因为结果也证明了,走全表扫描确实比走索引要快。
所以结论其实挺简单的:索引不是万能的。 不是说给字段加了索引,查询就一定会走索引。特别是当你的查询命中了表中很大比例的数据时,全表扫描反而是优化器认为更优的选择。
七、那这个索引是不是白建了?
也不能说完全白建了。
虽然这次查询没走索引,但索引在别的场景下可能还是有用的:
- 比如说,如果你查某一天的订单,比如
WHERE order_date = '2026-06-01',这种精确匹配的情况下,走索引的概率就大多了。 - 再比如说,如果你在查询里加了
ORDER BY order_date,索引本身是有序的,可能会被用来优化排序,就不用额外再排一次了。 - 还有就是,如果数据继续增长,从10万涨到100万、1000万,索引的优势就会越来越明显。现在数据量不大,索引的优势体现不出来而已。
但在当前这个场景下,对于一个命中一半数据的范围查询来说,索引确实没帮上什么忙。
八、那如果真想优化,可以从哪几个方向入手?
如果你非要在这种场景下优化,可以考虑这几个方向:
-
分区表:按日期分区。查询的时候只扫描对应的分区,不用扫全表。比如我这查的是2026年上半年,那就只扫这半年的分区,其他分区不用管。
-
覆盖索引:如果查询只涉及少量字段,比如只需要订单号和日期,可以建一个只包含这两个字段的索引。这样走索引的话就不需要回表了,因为索引里就已经包含了查询需要的所有数据。
-
跟业务商量一下,看能不能缩小查询范围:如果能缩短日期区间,比如从半年改成一个月,命中数据的占比降下来了,索引走上的可能性就大了。
但这些方案都有各自的代价,分区表需要维护多个分区,覆盖索引增加了存储占用,缩小查询范围涉及业务上的妥协。所以要根据实际业务场景来权衡,不是技术上都堆上去就一定好。
九、一点个人的感受
这次折腾下来,最大的感受其实就是一句话:数据库优化不是加个索引就完事了这么简单。
加了索引之后查询反而变慢了,执行计划还是全表扫描。这种事情吧,听起来确实有点反直觉,但在实际工作中其实挺常见的。
我以前也一直以为,只要给查询字段加了索引就一定能加速。这次算是被真实的数据打脸了。后面还是得老老实实地看执行计划,理解优化器为什么要这么选,然后再去做针对性的调整。
这次折腾虽然没有达到“加了索引秒变快”的效果,但至少让我对索引的适用场景有了更清晰的认知。写出来供大家参考一下,希望对遇到类似问题的朋友多少有点帮助。
数据对比表
| 对比项 | 无索引 | 有索引 |
|---|---|---|
| 执行计划 | Seq Scan(全表扫描) | Seq Scan(全表扫描) |
| 扫描行数 | 约100000行 | 约100000行 |
| 查询耗时 | 171.146 ms | 262.512 ms |
| 性能变化 | — | 反而慢了53% |
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/yunjianyue1314/article/details/163704466

