

当 LLM 应用从实验阶段走向生产环境,团队关注的东西会发生明显变化。在实验阶段,大家更关心“这个提示词能不能跑通”“这个模型回答得准不准”;而到了生产环境,问题会变成:每天有多少请求?延迟有没有变高?成本是不是在可控范围内?用户对回答的满意度是上升还是下降?这些问题如果只靠人工翻日志,几乎不可能及时回答。Opik 的生产环境监控能力,就是为这种场景准备的。
Opik 从设计之初就考虑到了高容量 traces 的支持,这使得它非常适合用来监控生产环境中的 LLM 应用。所谓高容量,意味着即使你的应用每天产生成千上万条 trace,Opik 也能稳定地接收、存储和展示这些数据。对于生产系统来说,这一点很关键,因为监控工具本身不能成为瓶颈。
在 Opik 里,你可以通过任意项目中的 Insights 标签,查看反馈分数、trace 数量、延迟和成本随时间的变化。内置的 Project Overview 提供了一个一目了然的健康检查,里面有统计卡片和时间序列图表。如果你之前用过其他监控系统,可以把它理解成一个专门为 LLM 应用定制的仪表盘:左边是关键指标卡片,右边是趋势图,不需要自己拼凑。
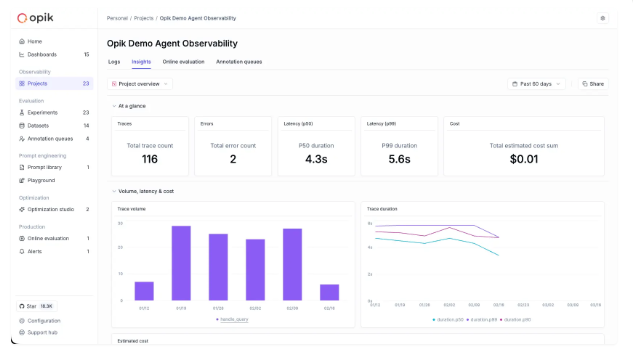
除了看时间趋势,你还可以在 traces 表格里查看项目中所有 trace 的平均反馈分数。这个功能看起来简单,但在实际使用中非常实用。比如,当你怀疑最近一轮提示词改动导致质量下降时,直接看平均反馈分数的变化,比逐条检查 trace 快得多。
记录反馈分数:生产监控的基石
要监控 LLM 应用的表现,首先得有“表现”的量化指标。Opik 把这部分称为 feedback scores,也就是反馈分数。你可以通过 Python SDK 和 UI 来记录这些分数。反馈分数的来源可以很多样:用户点赞点踩、人工标注、自动评估模型,甚至是业务侧的转化数据。关键是要把它们和具体的 trace 关联起来。
定义在线评估指标
在生产环境中,最省力的方式之一是让 LLM 自己当裁判。Opik 平台支持定义 LLM as a Judge 指标,这些指标会自动为所有或部分生产 traces 打分。你可以在 Online evaluation 部分找到如何定义这些指标的详细信息。一旦规则定义好,Opik 就会对项目中的 traces 进行评分,并允许你跟踪这些反馈分数随时间的变化。
这里有个很实用的点:你不需要对所有 trace 都打分。比如,你可以只对包含特定标签的 trace 评分,或者只对某个用户群体的请求评分。这样既能控制成本,又能把注意力放在最需要关注的数据上。
Opik 还提到,除了 LLM as a Judge 指标,未来很快会支持定义 Python 指标,给用户更多控制权。对于有自定义评估逻辑的团队来说,这是一个值得期待的功能。
手动记录反馈分数
当然,不是所有反馈都能自动获得。很多时候,你需要手动记录。Opik 允许你在记录 traces 的同时,把反馈分数一起写进去。下面是一个典型的代码示例:
from opik import track, opik_context

@track
def llm_chain(input_text):
    # LLM chain code
    # ...

    # Update the trace
    opik_context.update_current_trace(
        feedback_scores=[
            {"name": "user_feedback", "value": 1.0, "reason": "The response was helpful and accurate."}
        ]
    )
这段代码的意思是:在 llm_chain 函数执行过程中,除了记录 trace 的基本信息,还通过 opik_context.update_current_trace 更新了当前 trace 的反馈分数。反馈分数的名字叫 user_feedback,值是 1.0,理由是这个回答有帮助且准确。你可以根据实际情况定义多个反馈分数,比如 relevance、accuracy、toxicity 等。
这种方式的优点是实时性高,数据一旦产生就立刻关联到 trace 上。缺点是需要在业务代码里嵌入监控逻辑,可能会让代码稍微复杂一点。不过对于生产系统来说,这种嵌入往往是值得的,因为它能保证反馈数据不丢失。
更新已有 traces 的反馈分数
有时候,反馈分数不是在 trace 产生时就能获得的。比如,用户可能在几个小时甚至几天后才提交评价,或者人工标注团队需要离线处理一批 trace。这时候,你就需要先获取这些 trace,然后再更新它们的反馈分数。
使用搜索 API 获取 traces
Opik 提供了 Opik.search_traces 方法,用来获取你想要标注的 traces。代码很简单:
import opik

opik_client = opik.Opik()

traces = opik_client.search_traces(
    project_name="Default Project"
)
search_traces 方法允许你根据任何 trace 属性来筛选 traces。比如,你可以只搜索某个时间范围内的 trace,或者只搜索带有特定标签的 trace。这种灵活性让批量标注变得很容易。
更新反馈分数
拿到 traces 之后,就可以用 Opik.log_traces_feedback_scores 方法来更新反馈分数了:
for trace in traces:
    opik_client.log_traces_feedback_scores(
        scores=[
            {
                "id": trace.id,
                "name": "user_feedback",
                "value": 1.0,
                "reason": "The response was helpful and accurate.",
                "project_name": "Default Project"
            }
        ],
    )
这段代码会遍历所有获取到的 trace,为每个 trace 添加一个名为 user_feedback 的反馈分数。更新完成后,你就可以在 Opik dashboard 中看到这些反馈分数,并跟踪它们随时间的变化。
这里有一个细节值得注意:log_traces_feedback_scores 方法接受一个 scores 列表,这意味着你可以一次性为同一个 trace 添加多个反馈分数。比如,同时添加 user_feedback 和 auto_eval_score。这在需要多维度评估时非常方便。
更新 trace 内容
除了反馈分数,有时候你还需要更新 trace 本身的内容。比如,你发现某条 trace 的输出有误,想要修正;或者你想给某条 trace 添加额外的元数据。Opik 也支持这些操作。
获取 trace 内容
要更新 trace,首先得知道它的内容。你可以使用 Opik.get_trace_content(id: str) 来查看 trace 的内容,通过 ID 查找。trace ID 可以通过 Opik.search_traces() 方法找到,也可以在 Projects > ‘My-project’ 视图的 ID 列中看到。
from opik import Opik

TRACE_ID = 'EXAMPLE-ID' # UUIDv7 Identifier

opik_client = Opik()
trace_content = opik_client.get_trace_content(id = TRACE_ID)
这会返回一个 TracePublic 对象,这是一个 pydantic 模型对象,包含了与找到的 trace 相关的所有数据。你可以把它理解成一个结构化的字典,里面有你需要的所有字段。
按 ID 更新 trace
拿到 trace ID 之后,你可以先重新实例化这个 trace,然后更新它的任意属性:
from opik import Opik

TRACE_ID = 'EXAMPLE-ID' # UUIDv7 Identifier

opik_client = Opik()
trace = opik_client.trace(id = TRACE_ID)
trace.update(output = updated_output)
Trace.update() 方法支持更新以下属性:
end_time:trace 的结束时间。metadata:与 trace 关联的额外元数据。input:trace 的输入数据。output:trace 的输出数据。tags:与 trace 关联的标签列表。error_info:包含错误信息的字典(通常在 trace 函数失败时使用)。thread_id:用于将多个 trace 分组到一个 thread 中。这个标识符是用户定义的,并且在每个项目中必须唯一。
这些属性覆盖了 trace 生命周期中可能需要修改的大部分内容。比如,你可以在 trace 结束后补充 end_time,或者给一个失败的 trace 添加 error_info,方便后续排查。
为什么生产监控值得投入
很多团队在 LLM 应用上线初期,会把注意力放在功能实现上,监控往往是事后才补的。但实际情况是,LLM 应用的行为比传统软件更难预测。同一个提示词,在不同时间、不同用户输入下,可能产生完全不同的结果。如果没有持续的监控,你很难知道系统是在变好还是变坏。
Opik 的生产监控能力,本质上是在帮你建立一套反馈闭环。通过记录反馈分数,你可以把主观感受变成可量化的指标;通过 Insights 标签和 Project Overview,你可以把这些指标可视化;通过搜索和更新 API,你可以对历史数据进行追溯和修正。这套组合拳打下来,团队就能从“凭感觉”转向“看数据”。
更重要的是,Opik 的设计考虑到了生产环境的规模。高容量 traces 的支持意味着你不需要担心数据量大了之后系统变慢。自动评分和手动记录的结合,则让你可以根据实际情况选择最合适的评估方式。对于刚开始做生产监控的团队,建议先从内置的 Project Overview 看起,了解哪些指标最重要;然后逐步定义自己的 LLM as a Judge 规则,把重复性的评估自动化;最后再根据业务需要,手动补充一些关键反馈。这样循序渐进,既不会一下子负担太重,也能持续积累对系统的理解。
生产环境监控不是一次性任务,而是一个持续的过程。Opik 提供的这些工具,目的就是让这个过程尽可能顺畅。当你能够随时看到反馈分数的变化、trace 数量的波动、延迟和成本的趋势时,你就有了做出正确决策的基础。无论是调整提示词、切换模型,还是优化系统架构,数据都会告诉你方向。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/oscar999/article/details/166493635

