

📚 本文收录于「流浪」的系列专栏
| 系列专栏 | 直达链接 |
|---|---|
| 🐧 Linux系统 | 进入专栏 → |
| ⚙️ C++ | 进入专栏 → |
| 📊 数据结构与算法 | 进入专栏 → |
| 🐍 Python | 进入专栏 → |
| 🔗 LangChain & LangGraph | 进入专栏 → |
| 🗄️ MySQL 数据库 | 进入专栏 → |
| 🌿 Git 工具 | 进入专栏 → |
| 🌐 计算机网络 | 进入专栏 → |
| 🤖 LLM专栏 | 进入专栏 → |
| 💯 大厂面试、八股 | 进入专栏 → |
| 📚 学习筑基专栏 | 进入专栏 → |
🏠 博客主页:流浪 | 📝 原创首发于 CSDN
前面几篇讲了大模型能聊天、能调用工具、有 MCP 标准协议。但每次都要你一步步指挥它吗?
能不能这样:你只说"帮我策划一场社团活动",它自己拆任务、查场地、发通知、拉赞助?
能。这就是 Agent(智能体)。这篇讲透:Agent 是什么、内部怎么构成、靠哪些设计模式干活。
目录
目录
一、什么是 Agent:会自己干活的 AI
定义:Agent(智能体)是能够感知环境、自主决策、并调用工具去完成特定任务的智能系统。
一句话:"带大脑、有手脚、有计划"的数字助手。
传统 AI vs Agent(以"学生准备社团活动"为例):
| 传统 AI | Agent | |
|---|---|---|
| 形象 | 复读机 | 社团负责人 |
| 模式 | 问答模式:你推一下,它动一下 | 任务驱动:你给目标,它自己搞定 |
| 行为 | 问"怎么写策划"→ 给模板,结束 | 拆出"定场地/发通知/拉赞助"→ 自己执行 |
Agent 的完整表现(社团活动例子):
- 感知与规划:调日历 API 看空闲场地,拆出三个步骤
- 调用工具:自动发邮件联系场地管理员,搜索潜在赞助商
- 自主决策:原场地被占用?自动查备用场地、重新协调
- 记忆:记得上次你对音响不满意,这次自动注明"高保真音响"
核心区别一句话:传统 AI 是"问答模式",Agent 是"任务驱动模式"。
二、Agent 的基本架构:四件套
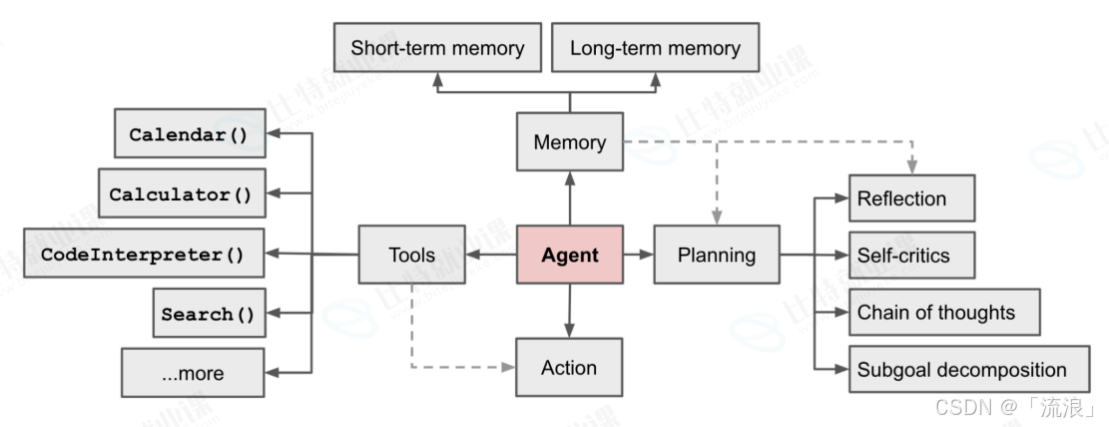
经典公式:
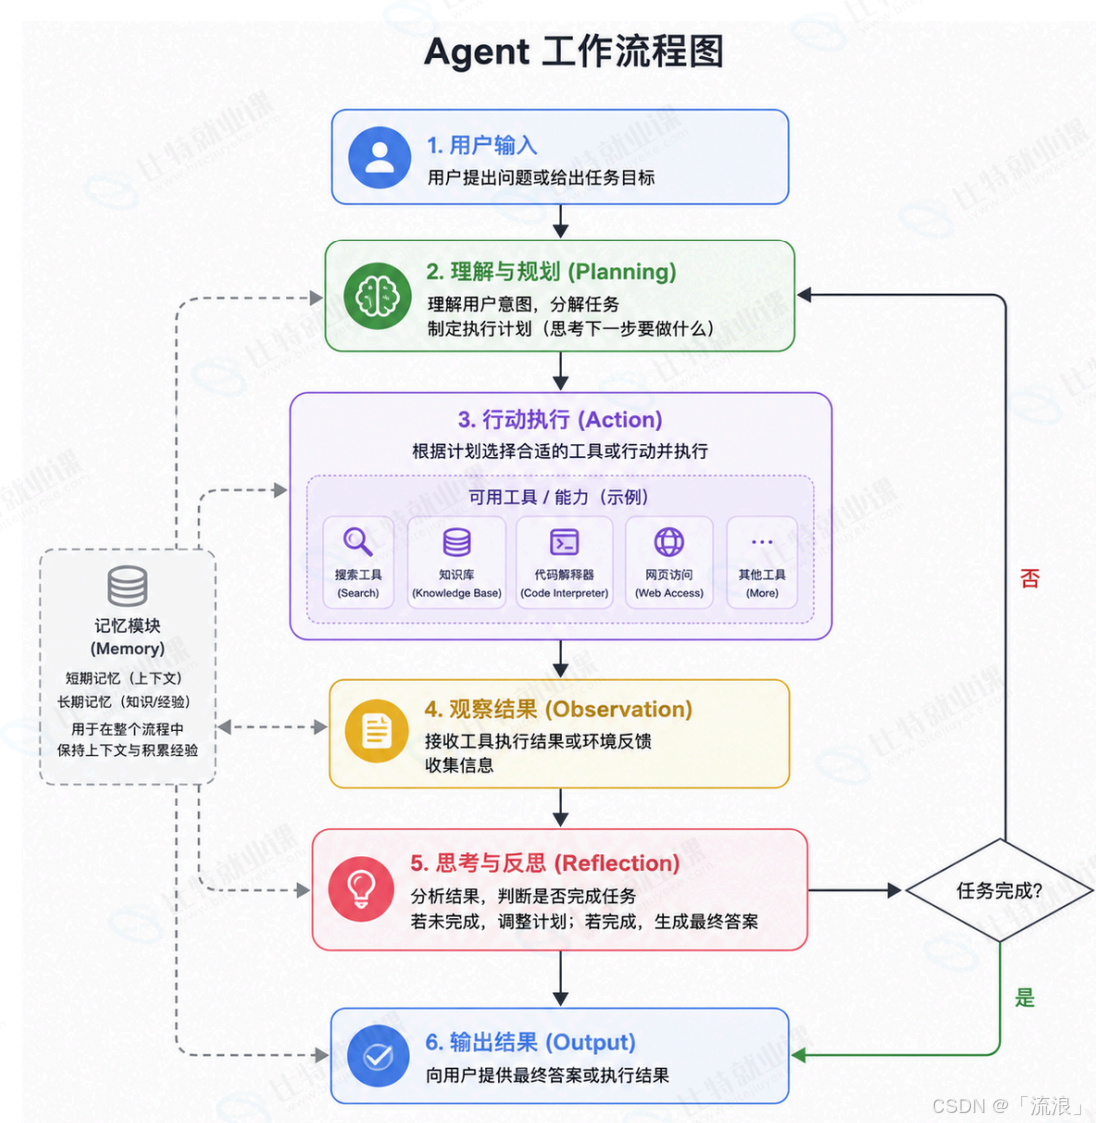
Agent = LLM(大脑) + 规划(策略) + 工具(手脚) + 记忆(经验)
| 组件 | 作用 |
|---|---|
| LLM 大脑 | 逻辑推理、意图识别、语言生成,一切行动指令的源头 |
| 规划 Planning | 分析任务状态、拆解目标、生成思考路径、决定下一步 |
| 工具 Tool | 实际执行动作:搜索引擎、计算器、代码解释器、第三方 API |
| 记忆 Memory | 短期记忆(上下文历史)+ 长期记忆(向量库/知识图谱),防遗忘、供决策 |
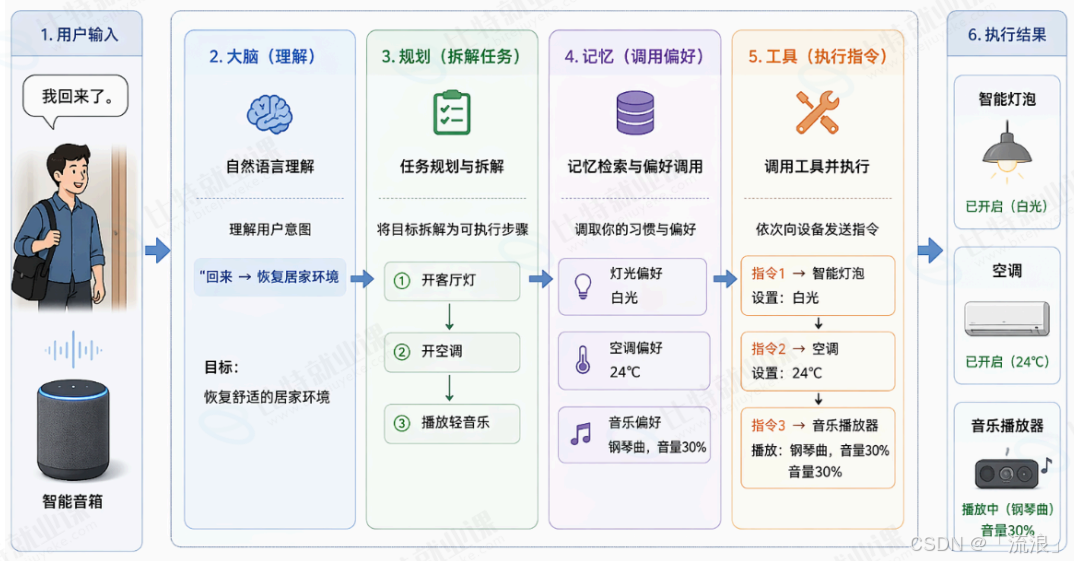
回家开灯例子:下班对智能音箱说"我回来了"
- 大脑:理解"回来"需要恢复居家环境
- 规划:拆三步:开客厅灯 → 开空调 → 放轻音乐
- 记忆:记得你喜欢白光、空调 24℃、钢琴曲音量 30%
- 工具:依次给智能灯泡、空调、音乐播放器发指令
三、Agent 的基本特性
| 特性 | 定义 | 例子 |
|---|---|---|
| 自主性 | 无需直接干预,自主运作 | 你只说要 4 天行程,它自己查机票/酒店/顺序 |
| 反应性 | 感知环境,及时应对变化 | 发现机票售罄,立刻改方案 |
| 主动性 | 主动规划达成隐含目标 | 主动比价、算预算、推最佳路线 |
| 学习能力 | 从历史交互提取偏好 | 你说"不喜欢太赶",下次自动留足自由时间 |
| 社交能力 | 多个 Agent 通信协作 | 与机票 Agent、酒店 Agent 协同规划 |
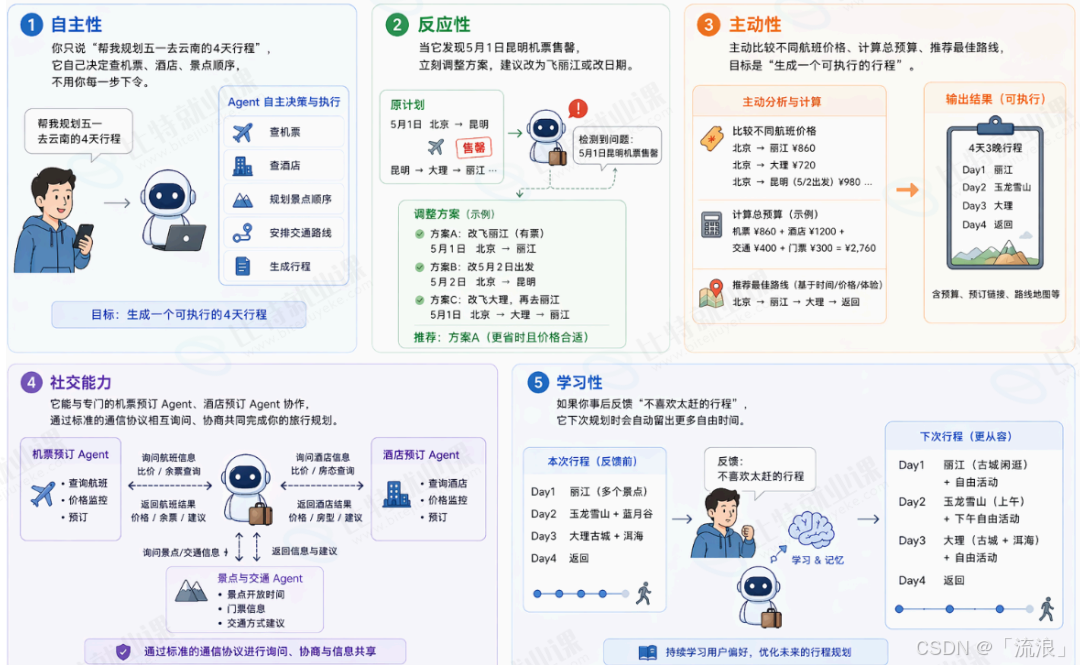
记忆口诀:自主、反应、主动、会学、会协作。
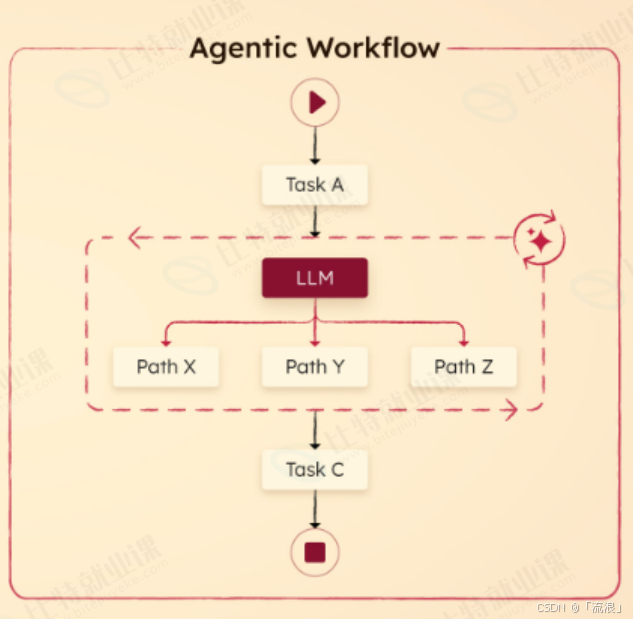
四、Agent vs Workflow
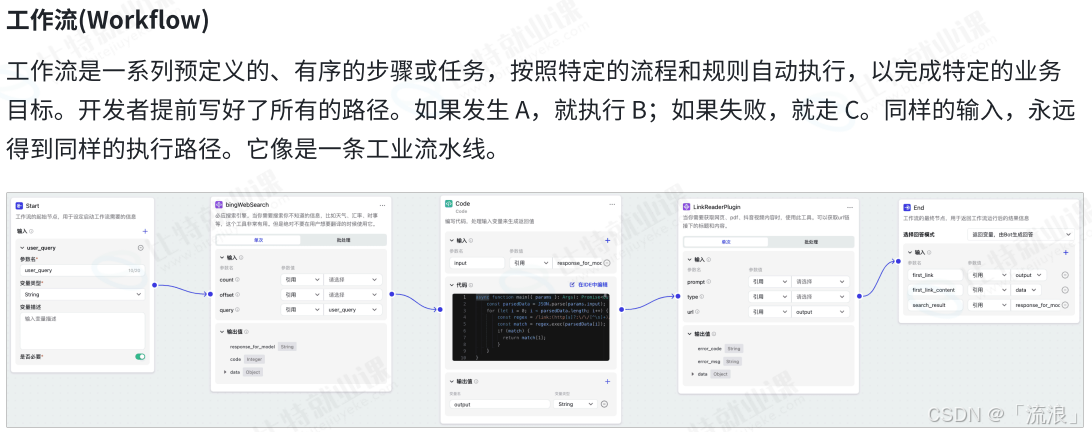
| 维度 | Workflow(工作流) | Agent(智能体) |
|---|---|---|
| 理念 | 确定性流程:按预设路径执行 | 自主决策:动态规划步骤 |
| 决策者 | 开发者(代码预设) | AI 模型(运行时判断) |
| 执行路径 | 固定、分支有限 | 动态、可调整重试 |
| 类比 | 严格照菜谱的学徒 | 自带工具箱、灵活应变的项目经理 |
| 类比2 | 跟团游:8 点集合、9 点到博物馆 | 背包客:排队太长就先去吃肉夹馍 |
实际落地:两者常配合——框架(Workflow)提供约束防乱跑,Agent 提供智能处理复杂环节。基于工作流的智能体是主流。
五、Agent 的三大设计模式
课件先给了两个"失败示范",再引出正确姿势——理解这个铺垫,三种模式就活了。
5.0 铺垫:两种极端的坑(北京天气穿衣建议)
| 模式 | 做法 | 结果 |
|---|---|---|
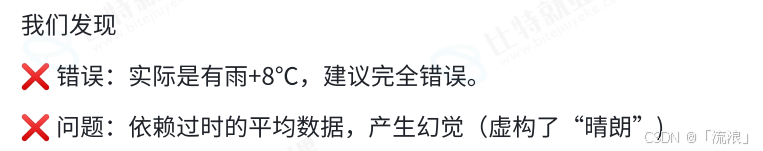
| Reasoning-Only 纯推理 | 不调工具,只凭记忆推理 | ❌ 说"晴朗 15℃",实际有雨 8℃——幻觉 |
| Action-Only 纯行动 | 只调工具不思考 | ❌ 查到"沙尘暴不适合户外",仍推荐公园——逻辑矛盾 |
1. Reasoning-Only 纯推理
Thought 1: 今天是4⽉21⽇,北京春季平均⽓温约15℃左右。
Thought 2: 春季常有⻛,但沙尘暴不常⻅。按往年经验,4⽉下旬多晴或多云。
Thought 3: 穿⾐建议:15℃适合穿薄外套或⻛⾐。
Final Answer: 北京今天天⽓晴朗,⽓温约15℃,建议穿薄外套或⻓袖T恤。
2. Action-Only 纯行动
Action: get_weather(city="Beijing")
Observation: {"temp": 8, "condition": "沙尘暴", "wind": "5级"}
Action: check_outdoor_suitable(condition="沙尘暴")
Observation: "不适合⼾外活动"
Action: recommend_parks(city="Beijing") ← 问题出在这⾥!
Observation: ["朝阳公园", "奥林匹克森林公园", "颐和园"]
Action: final_answer("北京今天8℃,沙尘暴,不适合⼾外。推荐公园:朝阳公园、奥林匹克森林
公园、颐和园。")
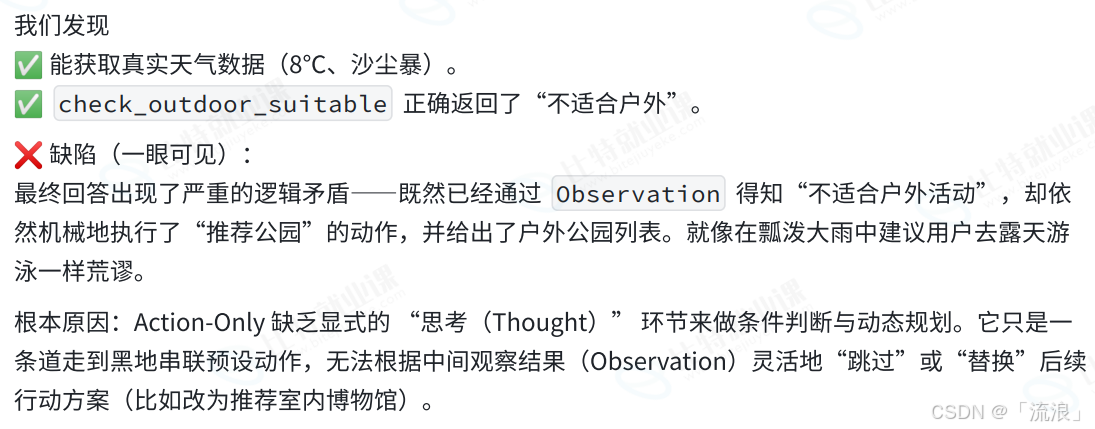
结论:光想不做会幻觉,光做不想会犯错——所以要把"想"和"做"结合,这就是 ReAct。
5.1 ReAct:想一步,做一步,看一步
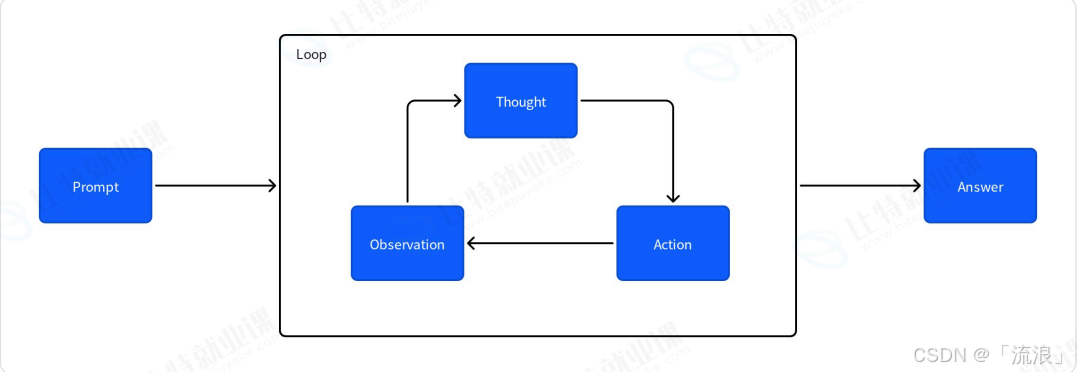
定义:ReAct = Reasoning(推理)+ Acting(行动),由 Google Research 2022 年提出。核心是思考 → 行动 → 观察循环(TAO 循环)。
北京天气正确示范:
Thought 1: 需要先查天气,再决定推不推荐公园
Action: get_weather(city="Beijing")
Observation: {"temp": 8, "condition": "沙尘暴"}

Thought 2: 沙尘暴不适合户外,用户要求"晴好才推公园",应改推荐室内
Action: recommend_indoor_places(city="Beijing")
Observation: ["国家博物馆", "首都图书馆"]

Final: 北京 8℃ 有沙尘暴,建议去博物馆/图书馆等室内
工作原理:
优势:
- 动态适应:根据上一步结果即时调整(机票售罄就改日期)
- 可解释性强:Thought→Action→Observation 轨迹清晰可追溯
- 显著降低(非杜绝)幻觉:工具观察提供事实锚点
劣势与解决:
| 劣势 | 解决思路 |
|---|---|
| 易陷入循环/跑偏 | 双层架构:顶层规划器 + 底层执行器,规划器定期拉回主干 |
| 无法并行,效率低 | 用模型原生并行调用 / 代码并发,别靠串行循环硬扛 |
| 不适合长周期任务 | 任务下发消息队列,后台 Worker 执行,完成再回调 |
| 调用次数不可控 | 设置最大迭代步数(Max Steps),超出强制停止 |
5.2 Plan & Execute:先画蓝图,再按图施工
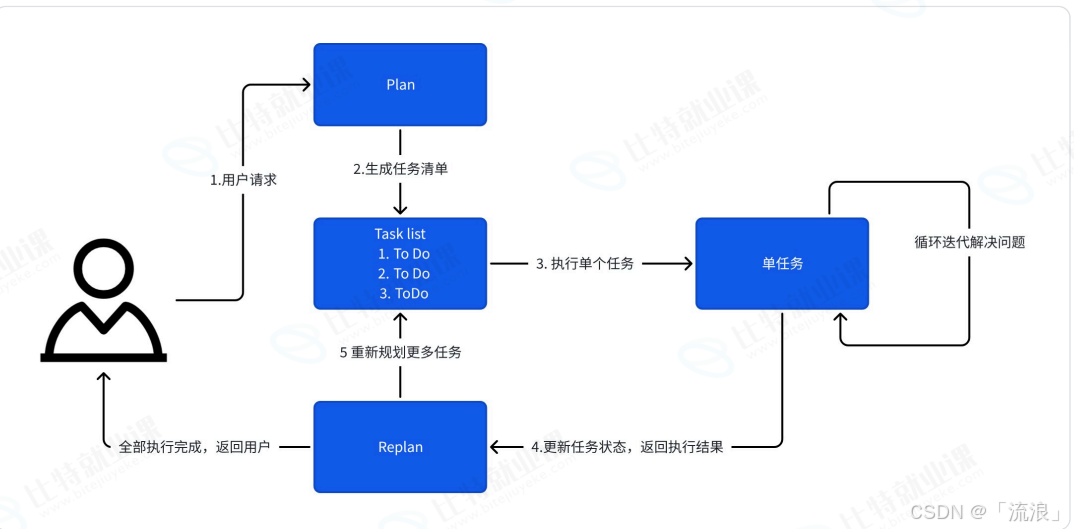
定义:先由规划器(Planner)生成高层多步骤计划,再由执行器(Executor)按序执行,中途可触发重新规划(Re-plan)。
类比:先画施工蓝图,再按图施工,遇到地质变化改图纸。
工作原理
优势:
- 不易跑偏:全局计划像图纸,防止被无关信息带歪
- 可并行:无依赖的步骤同时跑(查 A/B/C 股价并行,比串行快 3 倍)
- 效率高成本低:规划阶段集中推理(1-2 次 LLM 调用),执行阶段多为固定工具调用
劣势与解决:
| 劣势 | 解决思路 |
|---|---|
| 异常分支薄弱 | 与 ReAct 混合:执行器局部自治,遇异常本地决策,不惊动全局 |
| 计划错则全盘失败 | 计划先排序检查;分段干活勤"存盘";哪坏修哪(局部重试) |
| 不适合探索性任务 | 放弃预设终止条件,改用"探索-评估"循环(规划器出方向 → 执行器抓数据 → 评估器打分) |
5.3 Reflection:自己审自己,迭代优化
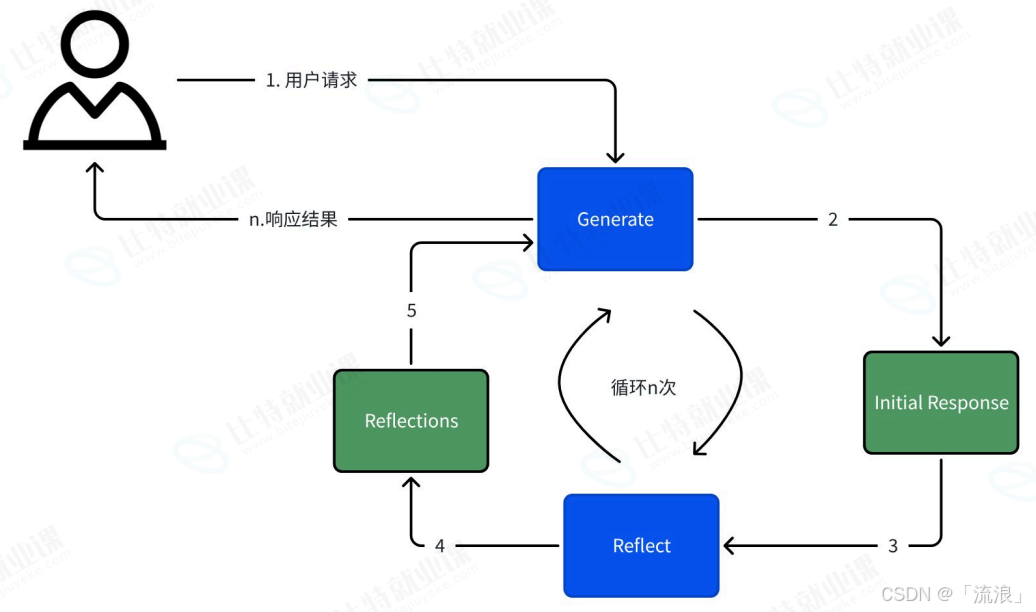
定义:让模型对自身输出进行自我审视、批评并迭代改进。"生成 → 反思"闭环。
类比:像审稿——同学写了"请节约用水用电,保护地球人人有责"(太笼统),你一轮轮改:加具体做法("离开教室关灯关风扇")→ 加感染力("轻轻一按,给地球的温柔")。
工作原理
优势:
- 质量更高:生成者 + 批判者自我博弈
- 不依赖别人:Self-Refine,无需另建打分模型
- 减少返工:错误前置,把试错成本转移到 AI 自己的推理中
劣势与解决:
| 劣势 | 解决思路 |
|---|---|
| 费时间/成本高 | 快照对比 + 强制早退,不每次读全量上下文 |
| 容易改过头 | 设最大反思轮次(通常 1-3 次) |
| 自己有盲区 | 引入外部校验:代码跑测、事实核查、用户反馈 |
5.4 三模式对比表
| 维度 | ReAct | Plan & Execute | Reflection |
|---|---|---|---|
| 核心 | 思考→行动→观察循环 | 先规划再执行 | 生成→反思→优化 |
| 目标 | 通过与外部交互完成任务 | 高效执行确定任务 | 提升输出质量 |
| 依赖 | 严重依赖外部工具反馈 | 规划质量 | 评估机制 |
| 场景 | 实时动态任务 | 高确定任务 | 高准确任务(代码/数学/创作) |
注意:三种不互斥,常互补组合(如 ReAct 干活 + Reflection 复盘)。
六、主流 Agent 框架一览
| 框架 | 一句话定位 |
|---|---|
| LangChain | 模块化智能体开发的"乐高底座" |
| LangGraph | 有状态、可控的复杂智能体工作流(图编排) |
| LlamaIndex | 以数据为中心的 RAG 与 Agent 框架 |
| CrewAI | 角色扮演式多 Agent 协作("AI 梦之队") |
| AutoGen | 多智能体"会议式"对话协作 |
| Coze(扣子) | 字节低门槛可视化 Bot 搭建平台 |
| Dify | 可视化 LLMOps 与 Agent 编排平台 |
| FastGPT | 开箱即用的知识库问答平台 |
| 百度千帆 AppBuilder | 企业级大模型应用开发平台 |
这些框架本质是把上面三种设计模式封装成好用的工具,让开发者不用从零写 ReAct/Plan&Execute/Reflection 循环。
七、面试官追问
Q1:Agent 和普通对话 AI(如网页版 ChatGPT)的本质区别? A:普通对话 AI 是"问答模式"——你问一句它答一句,不做自主行动;Agent 是"任务驱动模式"——你给个目标,它自己拆解、规划、调工具、多步执行直到完成。核心区别是有没有自主决策和行动能力。
Q2:为什么 ReAct 能降低幻觉?它彻底解决幻觉了吗? A:ReAct 通过"行动→观察"引入外部工具返回的真实结果作事实锚点,模型不是凭空编造,而是基于观察推理,所以显著降低幻觉。但不彻底——如果工具返回的数据本身有误,模型会基于错误信息继续推理。
Q3:Agent 公式四件套能少一个吗? A:实际很难。LLM 是大脑(缺了没法推理),规划让目标可拆解(缺了会乱跑),工具让 AI 能执行(缺了只能聊天),记忆让行为连贯(缺了每轮失忆)。四件协同才构成"能自己干活"的 Agent;弱化任一都会退回成"高级聊天机器人"。
Q4:ReAct 和 Plan & Execute 怎么选? A:看任务确定性。高确定、步骤清晰 → Plan & Execute(先规划,高效省成本);
动态、要边做边看反馈 → ReAct(每步根据观察调整)。复杂任务常混用:Plan 定框架 + ReAct 处理局部。
如果这篇让你搞懂了 Agent 怎么"自己干活",欢迎点赞收藏。评论区聊聊:你最想让 Agent 帮你自动完成什么任务?
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2502_94387000/article/details/166242629

