

🌱 代码仓库 :MSTcheng · Gitee
《数据结构》
《算法学习》
《C++由浅入深》
《Linux操作系统》
在前面的文章中,我们向大家介绍了 Linux 的基本开发工具,接下来就要正式进入进程相关话题的学习了!进程是Linxu系统中非常重要的一部分,学好了进程才能理解后面的CPU调度等知识,总之万事开头难,只要把第一步迈开了后面就不觉得难了。
文章目录
一、冯·诺依曼体系结构深度解析
1.1 什么是冯·诺依曼体系结构?
- 定义:以英特尔 x86 台式机、笔记本、服务器为代表的主流计算机硬件体系结构
- 命名:以科学家冯·诺依曼的名字命名,是一项划时代的技术
1.2 冯·诺依曼体系结构的五大组成部分
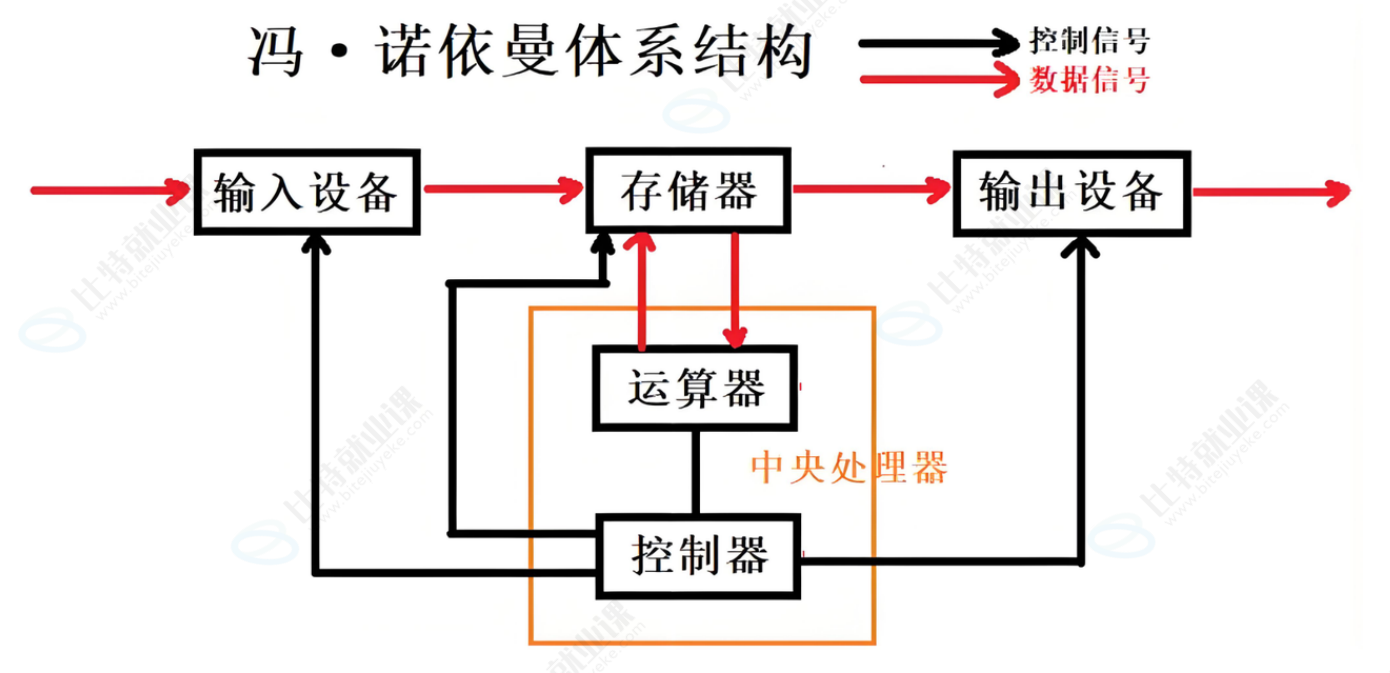
各部分功能详解:
-
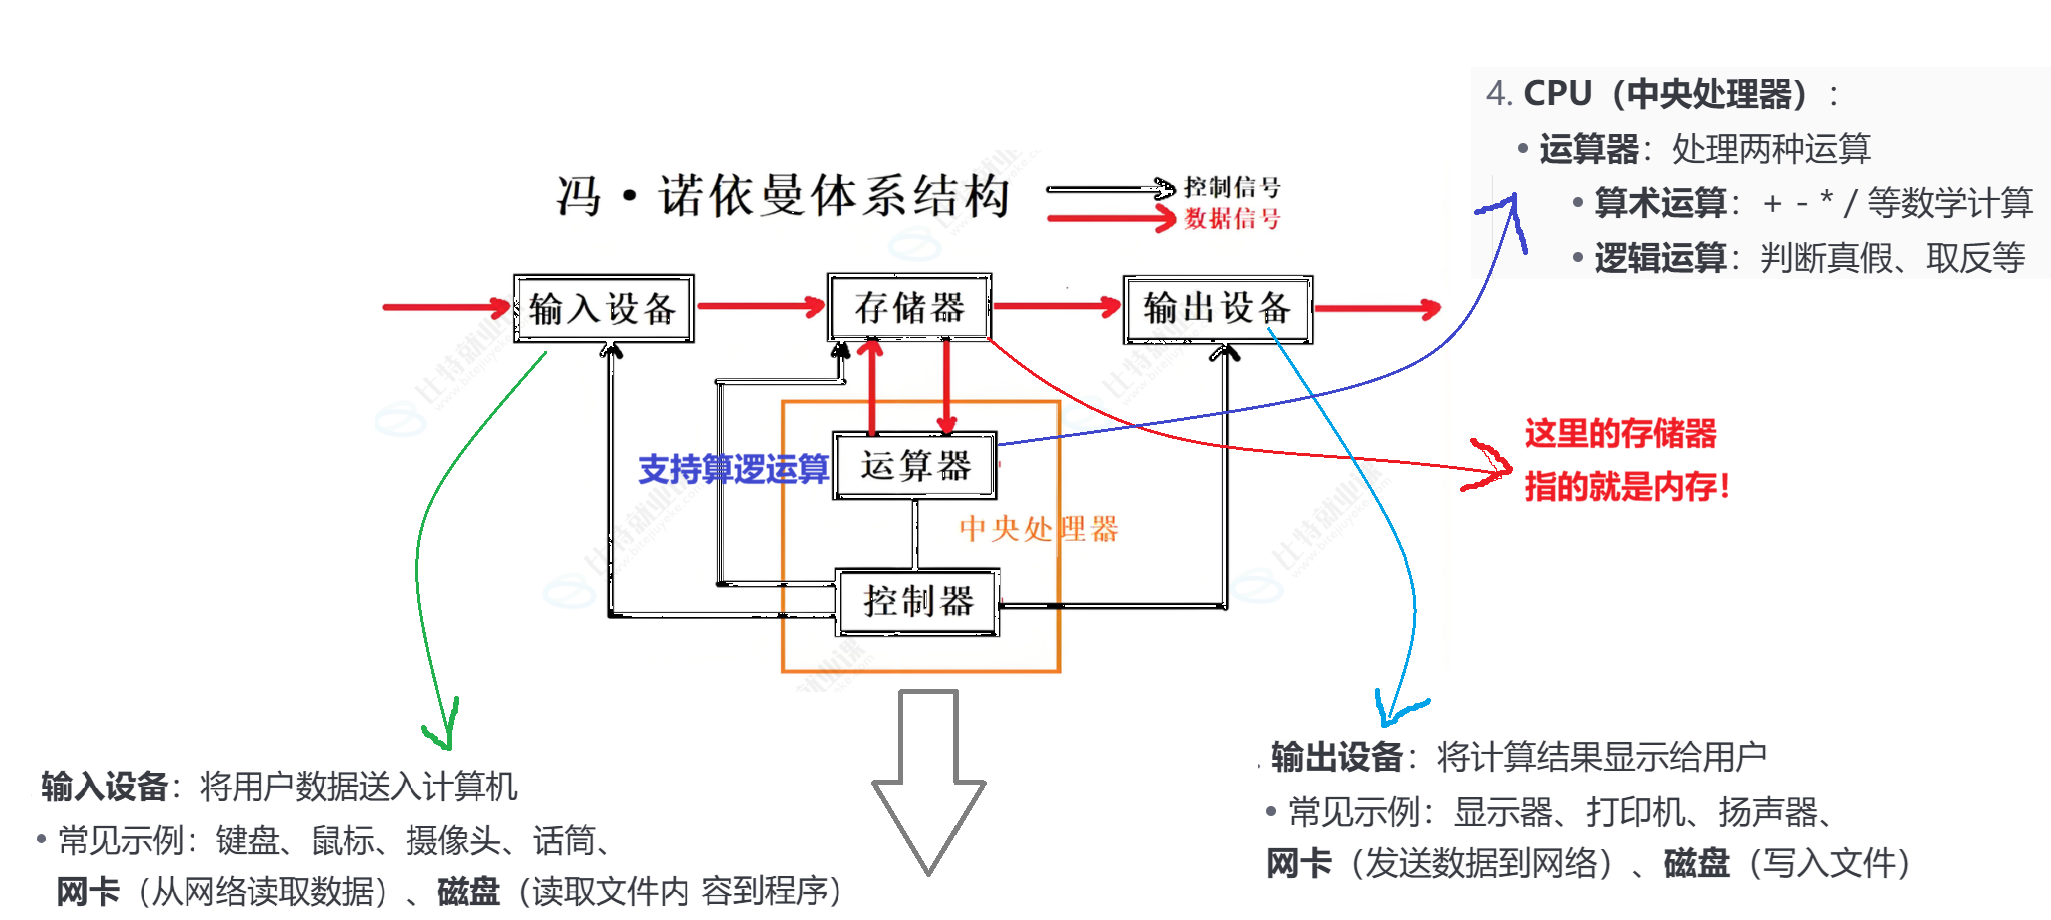
输入设备:将用户数据送入计算机
- 常见示例:键盘、鼠标、摄像头、话筒、网卡(从网络读取数据)、磁盘(读取文件内容到程序)笔记本获取网络数据,本质上是网卡从网线上读取数据。
-
输出设备:将计算结果显示给用户
- 常见示例:显示器、打印机、扬声器、网卡(发送数据到网络)、磁盘(写入文件)
- 关键结论:输入、输出设备统称外设(外围设备/外部设备)
-
存储器:特指内存(RAM)
- 内存(内部存储/RAM)与外存(外部存储:磁盘、U 盘、SSD)
- RAM 分为 SRAM(静态)和 DRAM(动态),笔记本上一般为 DRAM
-
CPU(中央处理器):- 运算器:处理两种运算
- 算术运算:+ - * / 等数学计算
- 逻辑运算:判断真假、取反等
- 控制器:执行读取指令、分析指令、响应中断等(不作为重点)
- 运算器:处理两种运算
⚠️注意: 输入->计算 - >输出
输入输出都是设备统称外设!(外部设备)外设距离CPU较远,所以速度特别慢!!
既然外设距离 CPU 较远、速度又慢,那 CPU 该如何高效地获取数据呢?这就引出了内存的作用。
二、为什么需要内存?
- 上面我们说了存储设备就是内存,而内存相较于磁盘(外存)离CPU较近,那么为什么要有内存??
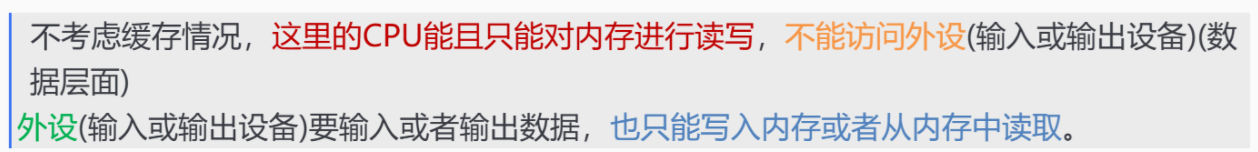
- 其实核心就一句话:CPU不与外设之间打交道,而是跟内存打交道!
下面我们分三个层次来理解为什么需要内存?
2.1第一层:存储分级
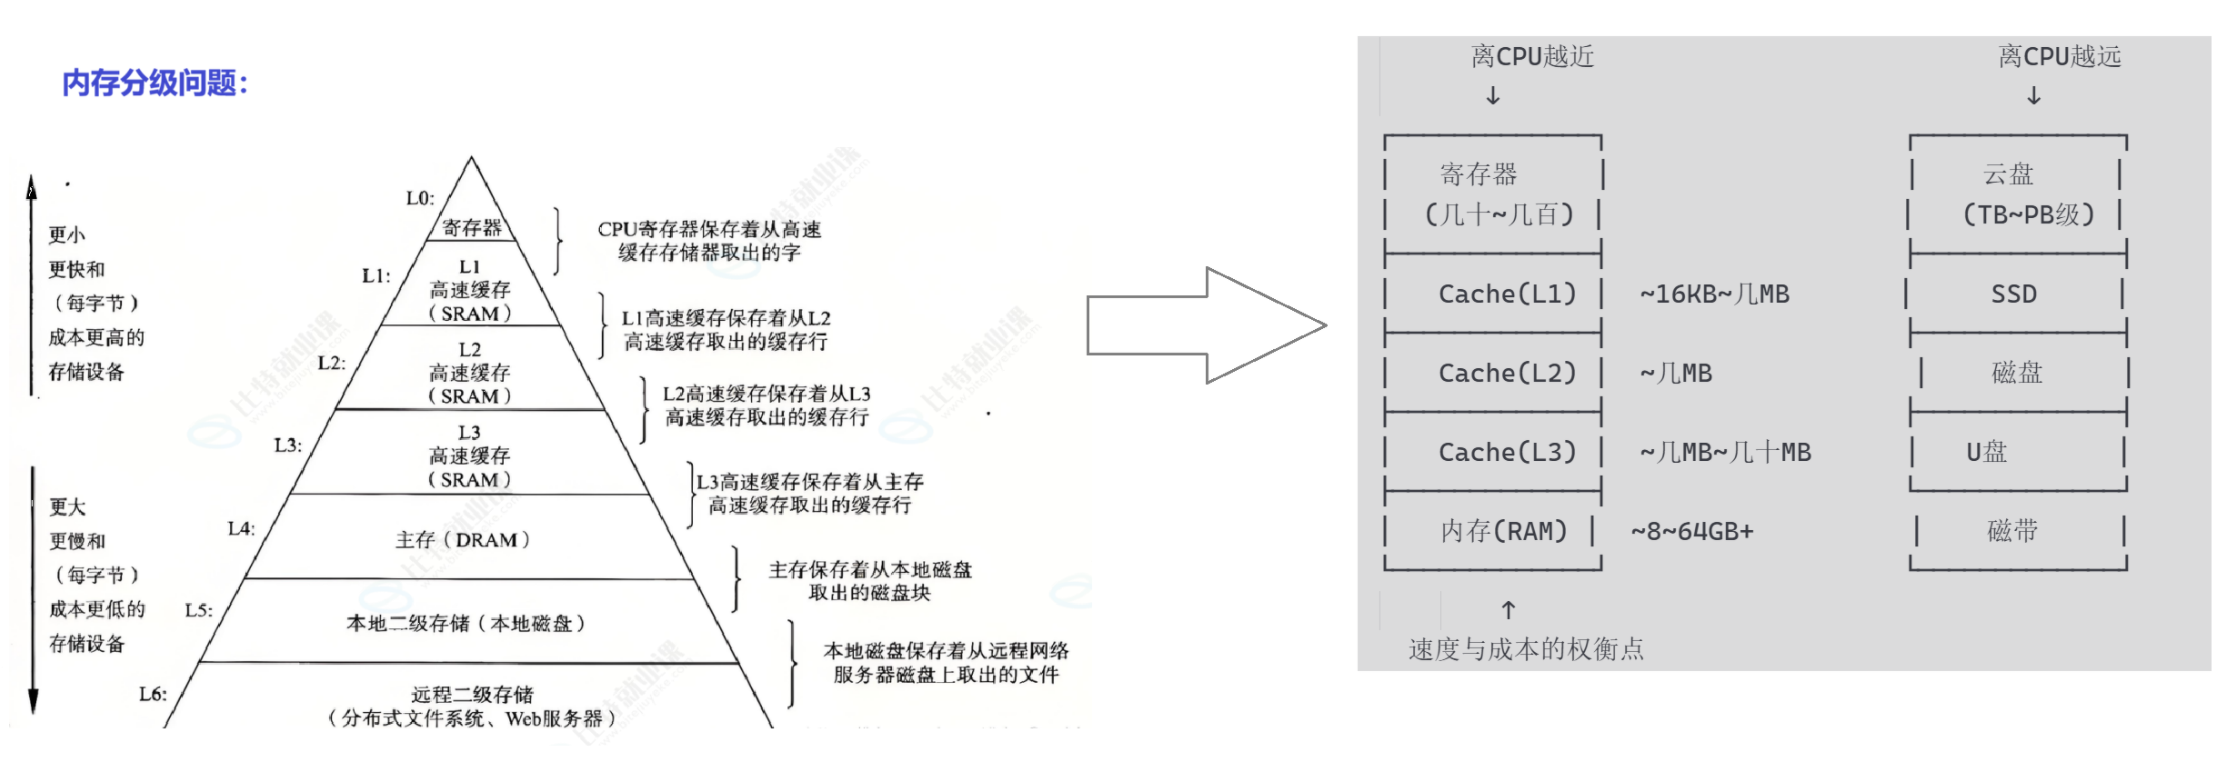
存储分级的核心规律:
- 离CPU越近 → 容量越小、单价越贵、效率越高
- 离CPU越远 → 容量越大、单价越便宜、效率越低
2.2第二层:体系结构效率问题(木桶原理)
如果没有内存会怎样?
原始设计(低效):  输入设备 ──→ CPU ──→ 输出设备
                (毫秒级)  (纳秒级)  (毫秒级)
                              ↑
                         CPU大部分时间在等待!
速度量级差距:
- CPU访问:纳秒级(ns)
- 磁盘访问:毫秒级(ms)
- 差距:10的6次方倍 ≈ 100万倍
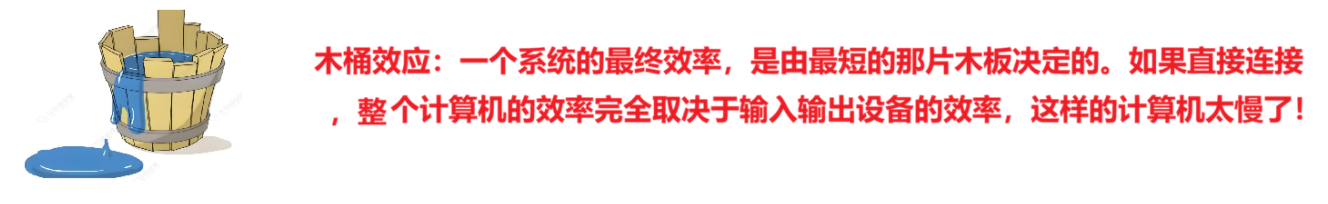
引入内存后的设计:
改进设计(高效):  输入设备 ──→ 内存 ──→ CPU ──→ 内存 ──→ 输出设备
                (预加载)      (纳秒级)     (写回)  (刷新)
                              ↑
                        整个系统效率以内存为主!
关键数据流变化:
- 在数据层面:CPU不和外设直接打交道,只会和内存打交道(这是体系结构规定!)
- 输入设备的数据 → 先存入内存 → CPU从内存读取。
- CPU的计算结果 → 写回内存 → 再从内存刷新到输出设备。
- 💡总结:内存充当CPU与外设之间的数据传输桥梁。
2.3第三层:局部性原理(让预加载成为可能)
-
问题:即使有了内存,串行执行的话,根据木桶原理,效率不还是一样慢吗?
-
答案:引入 预加载机制,配合局部性原理,让系统效率以内存为主。
局部性原理(Principle of Locality): -
局部性原理和预加载:当你正在访问某个位置的数据时,未来一段时间内,你有非常大的概率会访问周围的数据,所以第一次加载的时候就会把周围的数据也一起加载进内存!
举个例子:读取磁盘上一个100MB的文件,但只用到前10个字节 操作系统的做法:直接把100MB全部预加载到内存中 后续CPU每次读取都直接从内存取 → 效率以内存为主!
2.4第四层:技术推动生产力(终极意义)
为什么一定要用内存做性价比最优解?
| 方案 | 问题 |
|---|---|
| 全部用寄存器 | 造价极度增加,一台电脑几十万甚至更多,普通人接受不了 |
| 全部用磁盘 | 效率太低,比人快一点点,没有十倍百倍提升,无法广泛普及 |
| 内存居中 | ✅ 性价比最优 → 普通人几千块就能买到高效计算机 |
一张图总结: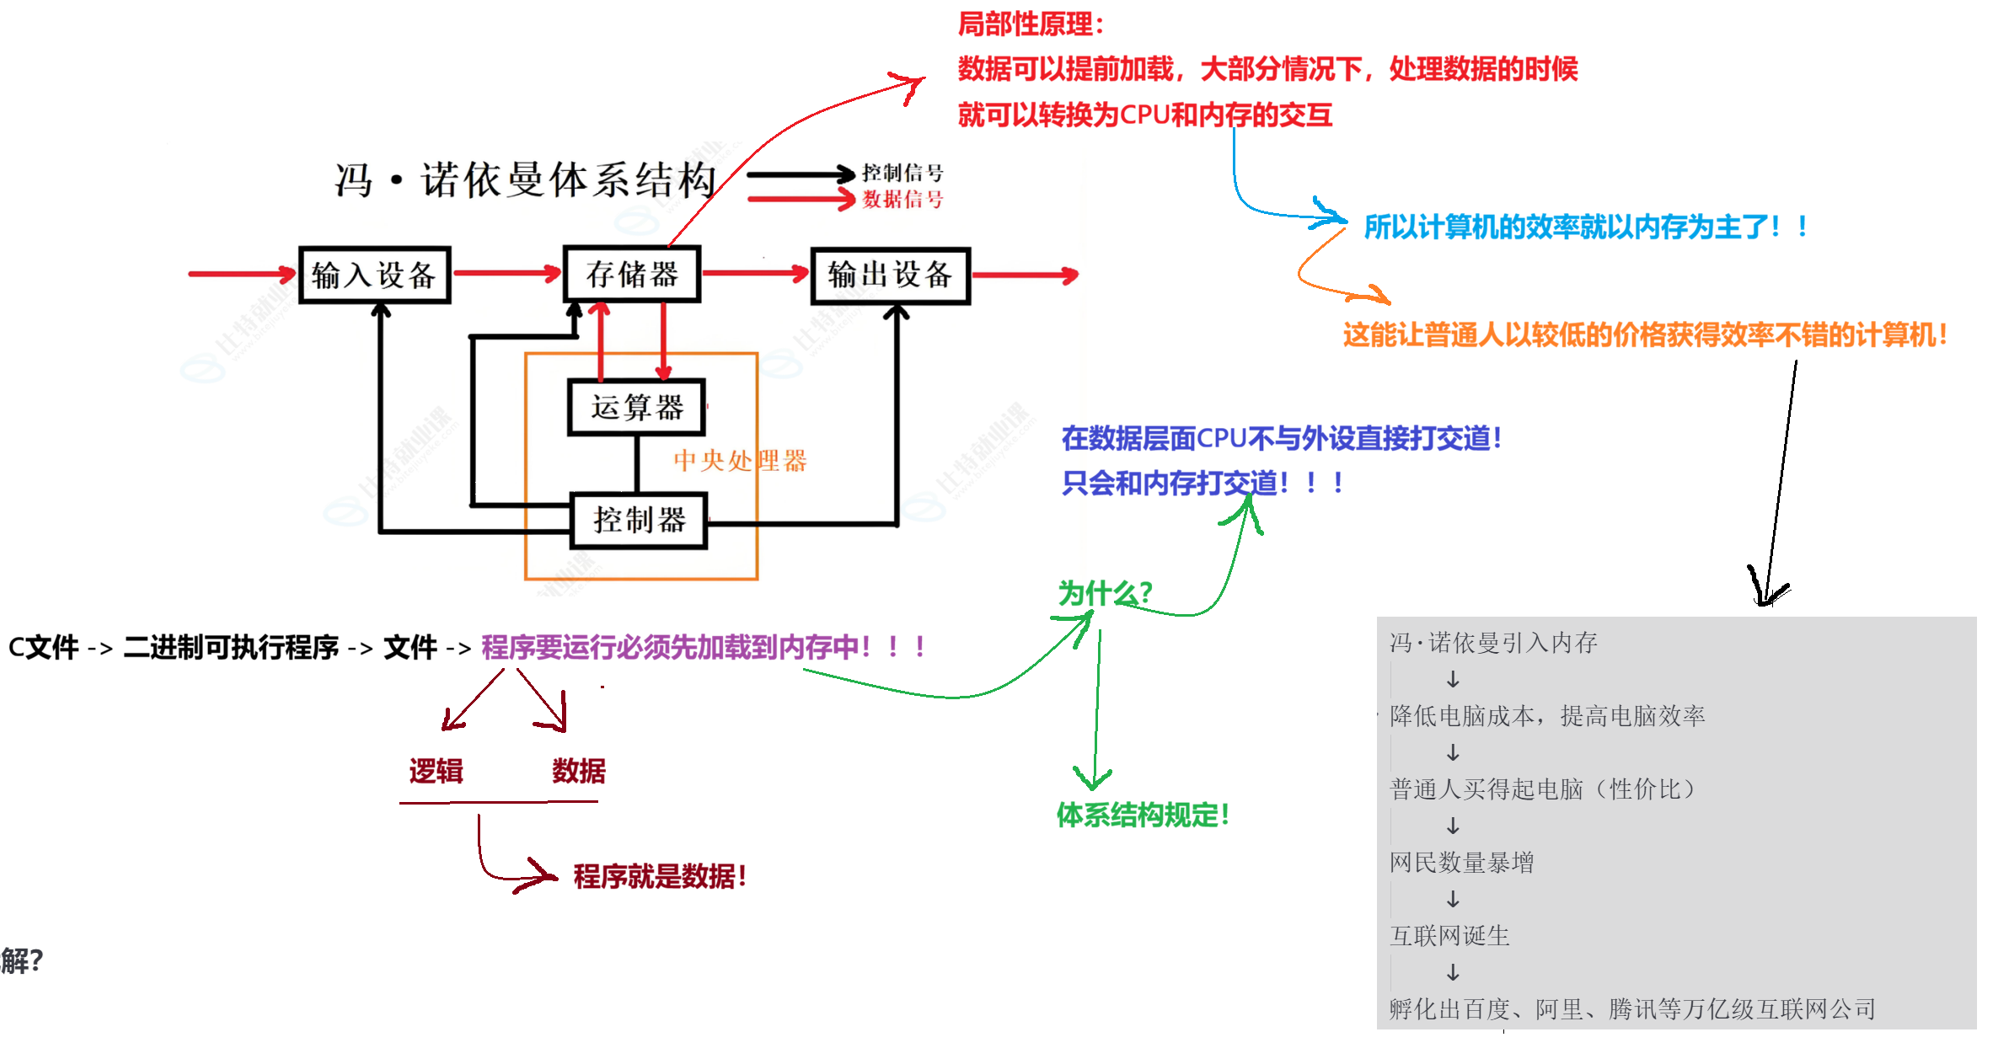
理解了内存为何如此重要之后,我们再来看看数据在内存与外设之间是如何流动的,这就涉及输入/输出的概念。
三、 输入/输出(IO)的概念本质的概念本质
3.1 IO的定义角度
-
我们口中的输入和输出,是是站在谁的角度考虑问题的??
-
“输入输出本质上站在内存角度来理解的”
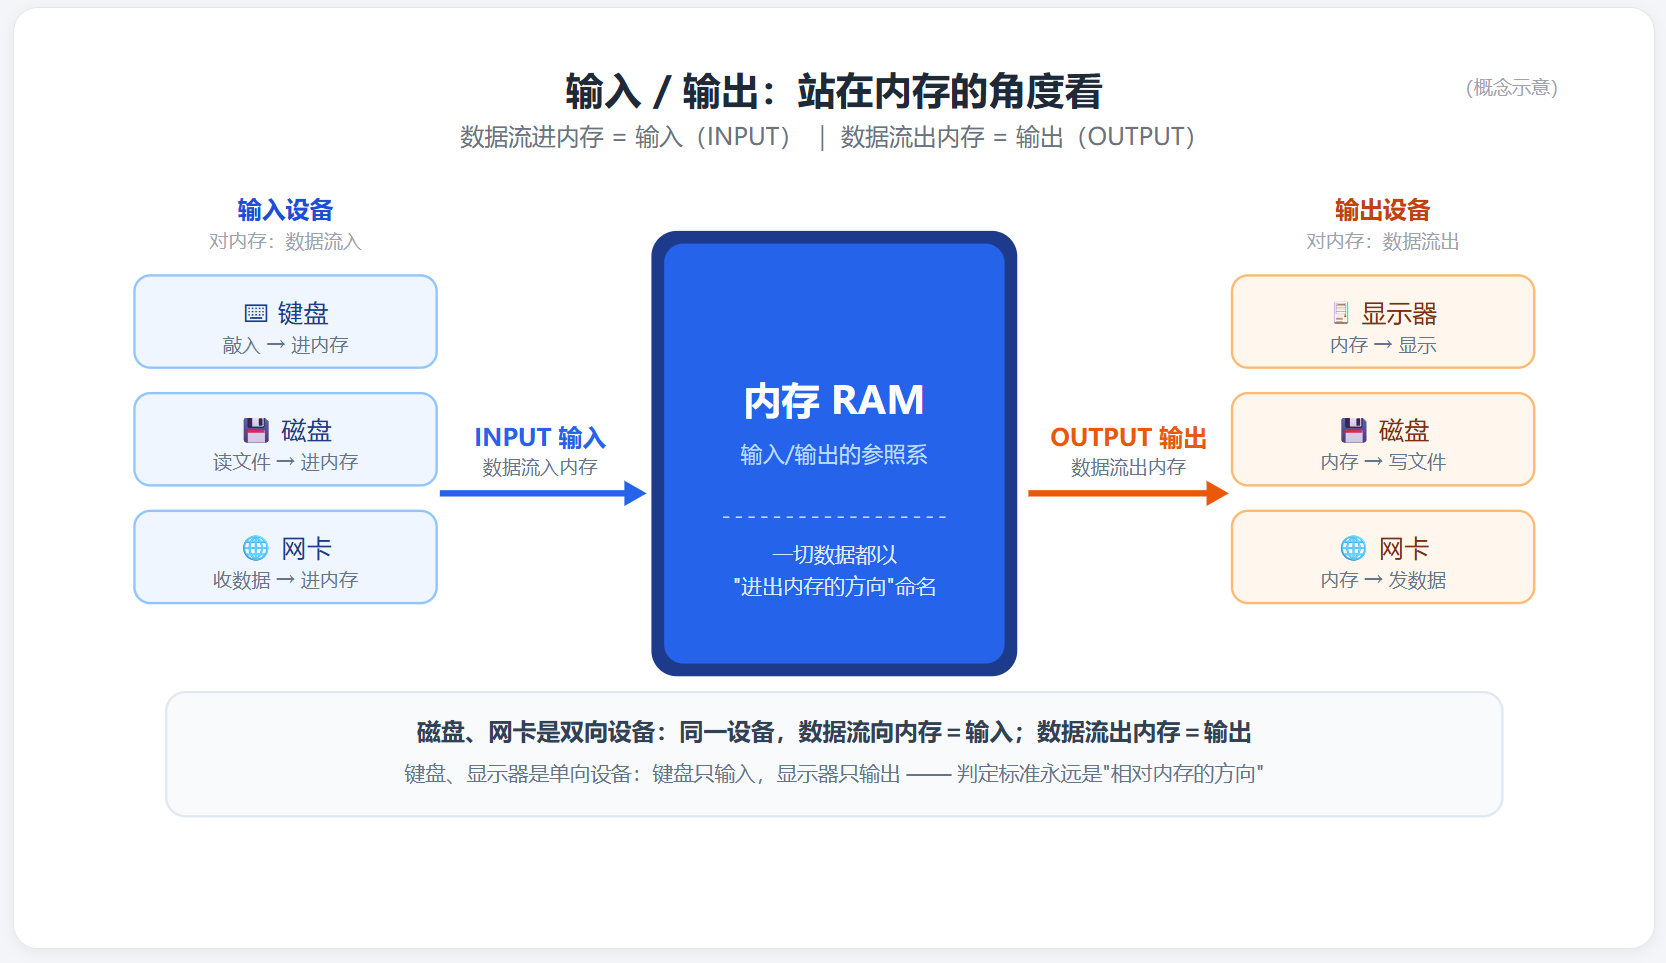
关键理解:
- 从外设把数据拿到内存 → Input(输入)
- 从内存把数据推到外设 → Output(输出)
- 合称
IO(Input/Output)
3.2 从程序角度理解IO
因为程序运行时加载到内存中,所以:
“站在内存的角度,就是站在加载到内存中的程序的角度”
程序视角:
  scanf / 从磁盘读文件 → 程序在"输入" → input
  printf / 写磁盘文件  → 程序在"输出" → output

  这就解释了为什么C/C++代码第一行永远是:
  #include <stdio.h>   ← std = standard(标准), io = input/output
  #include <iostream>
- 所以程序开头引入头文件就是为了更好的告诉编译器这些
IO函数长什么样!(声明)
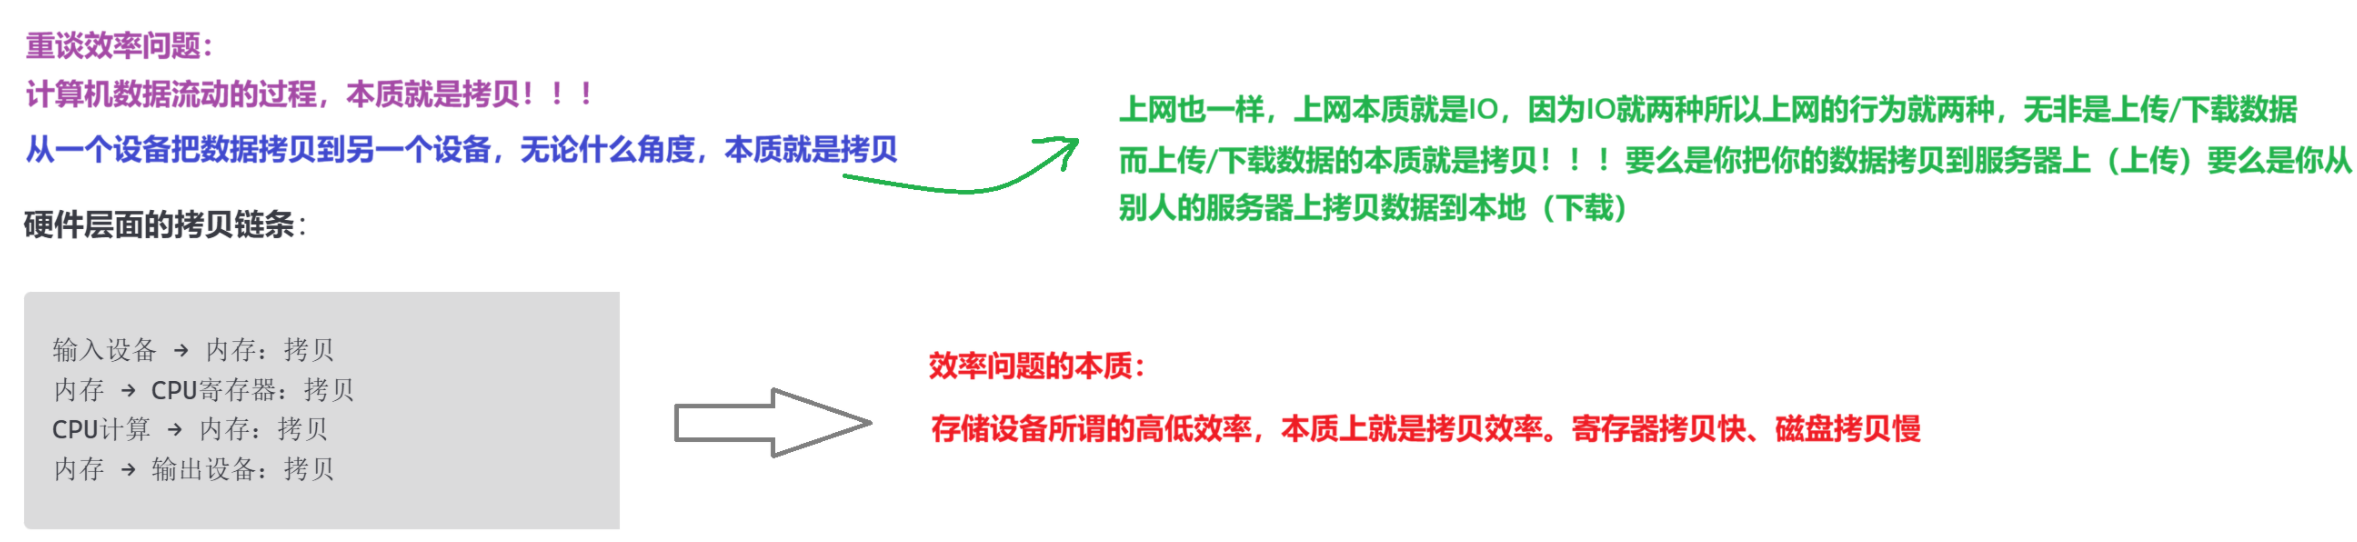
3.3 IO的本质是"拷贝"
- 从一个设备把数据拷贝到另一个设备,无论什么角度,本质就是拷贝!
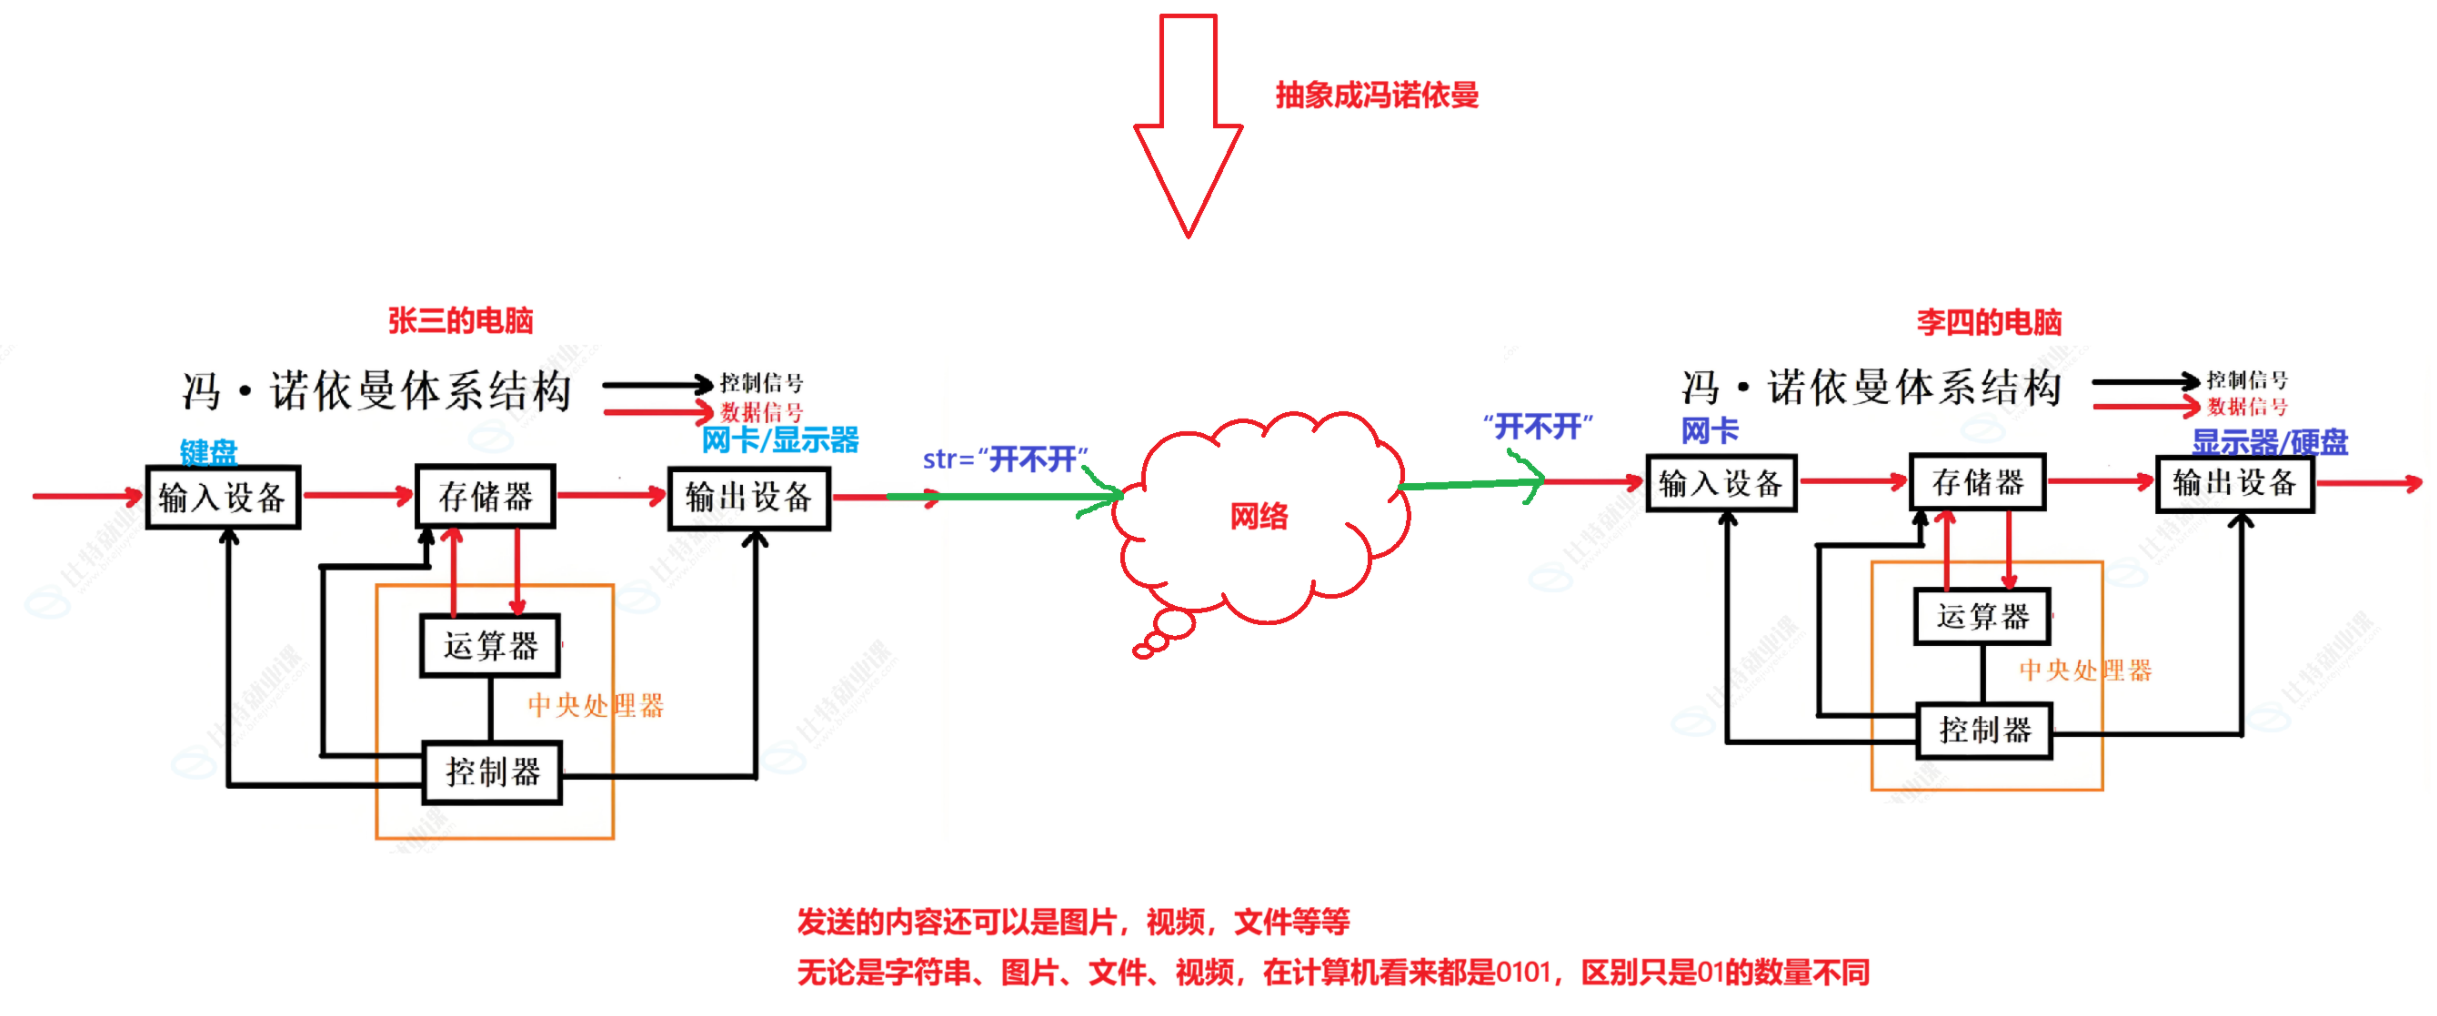
3.4 两台计算机通信的数据流动过程
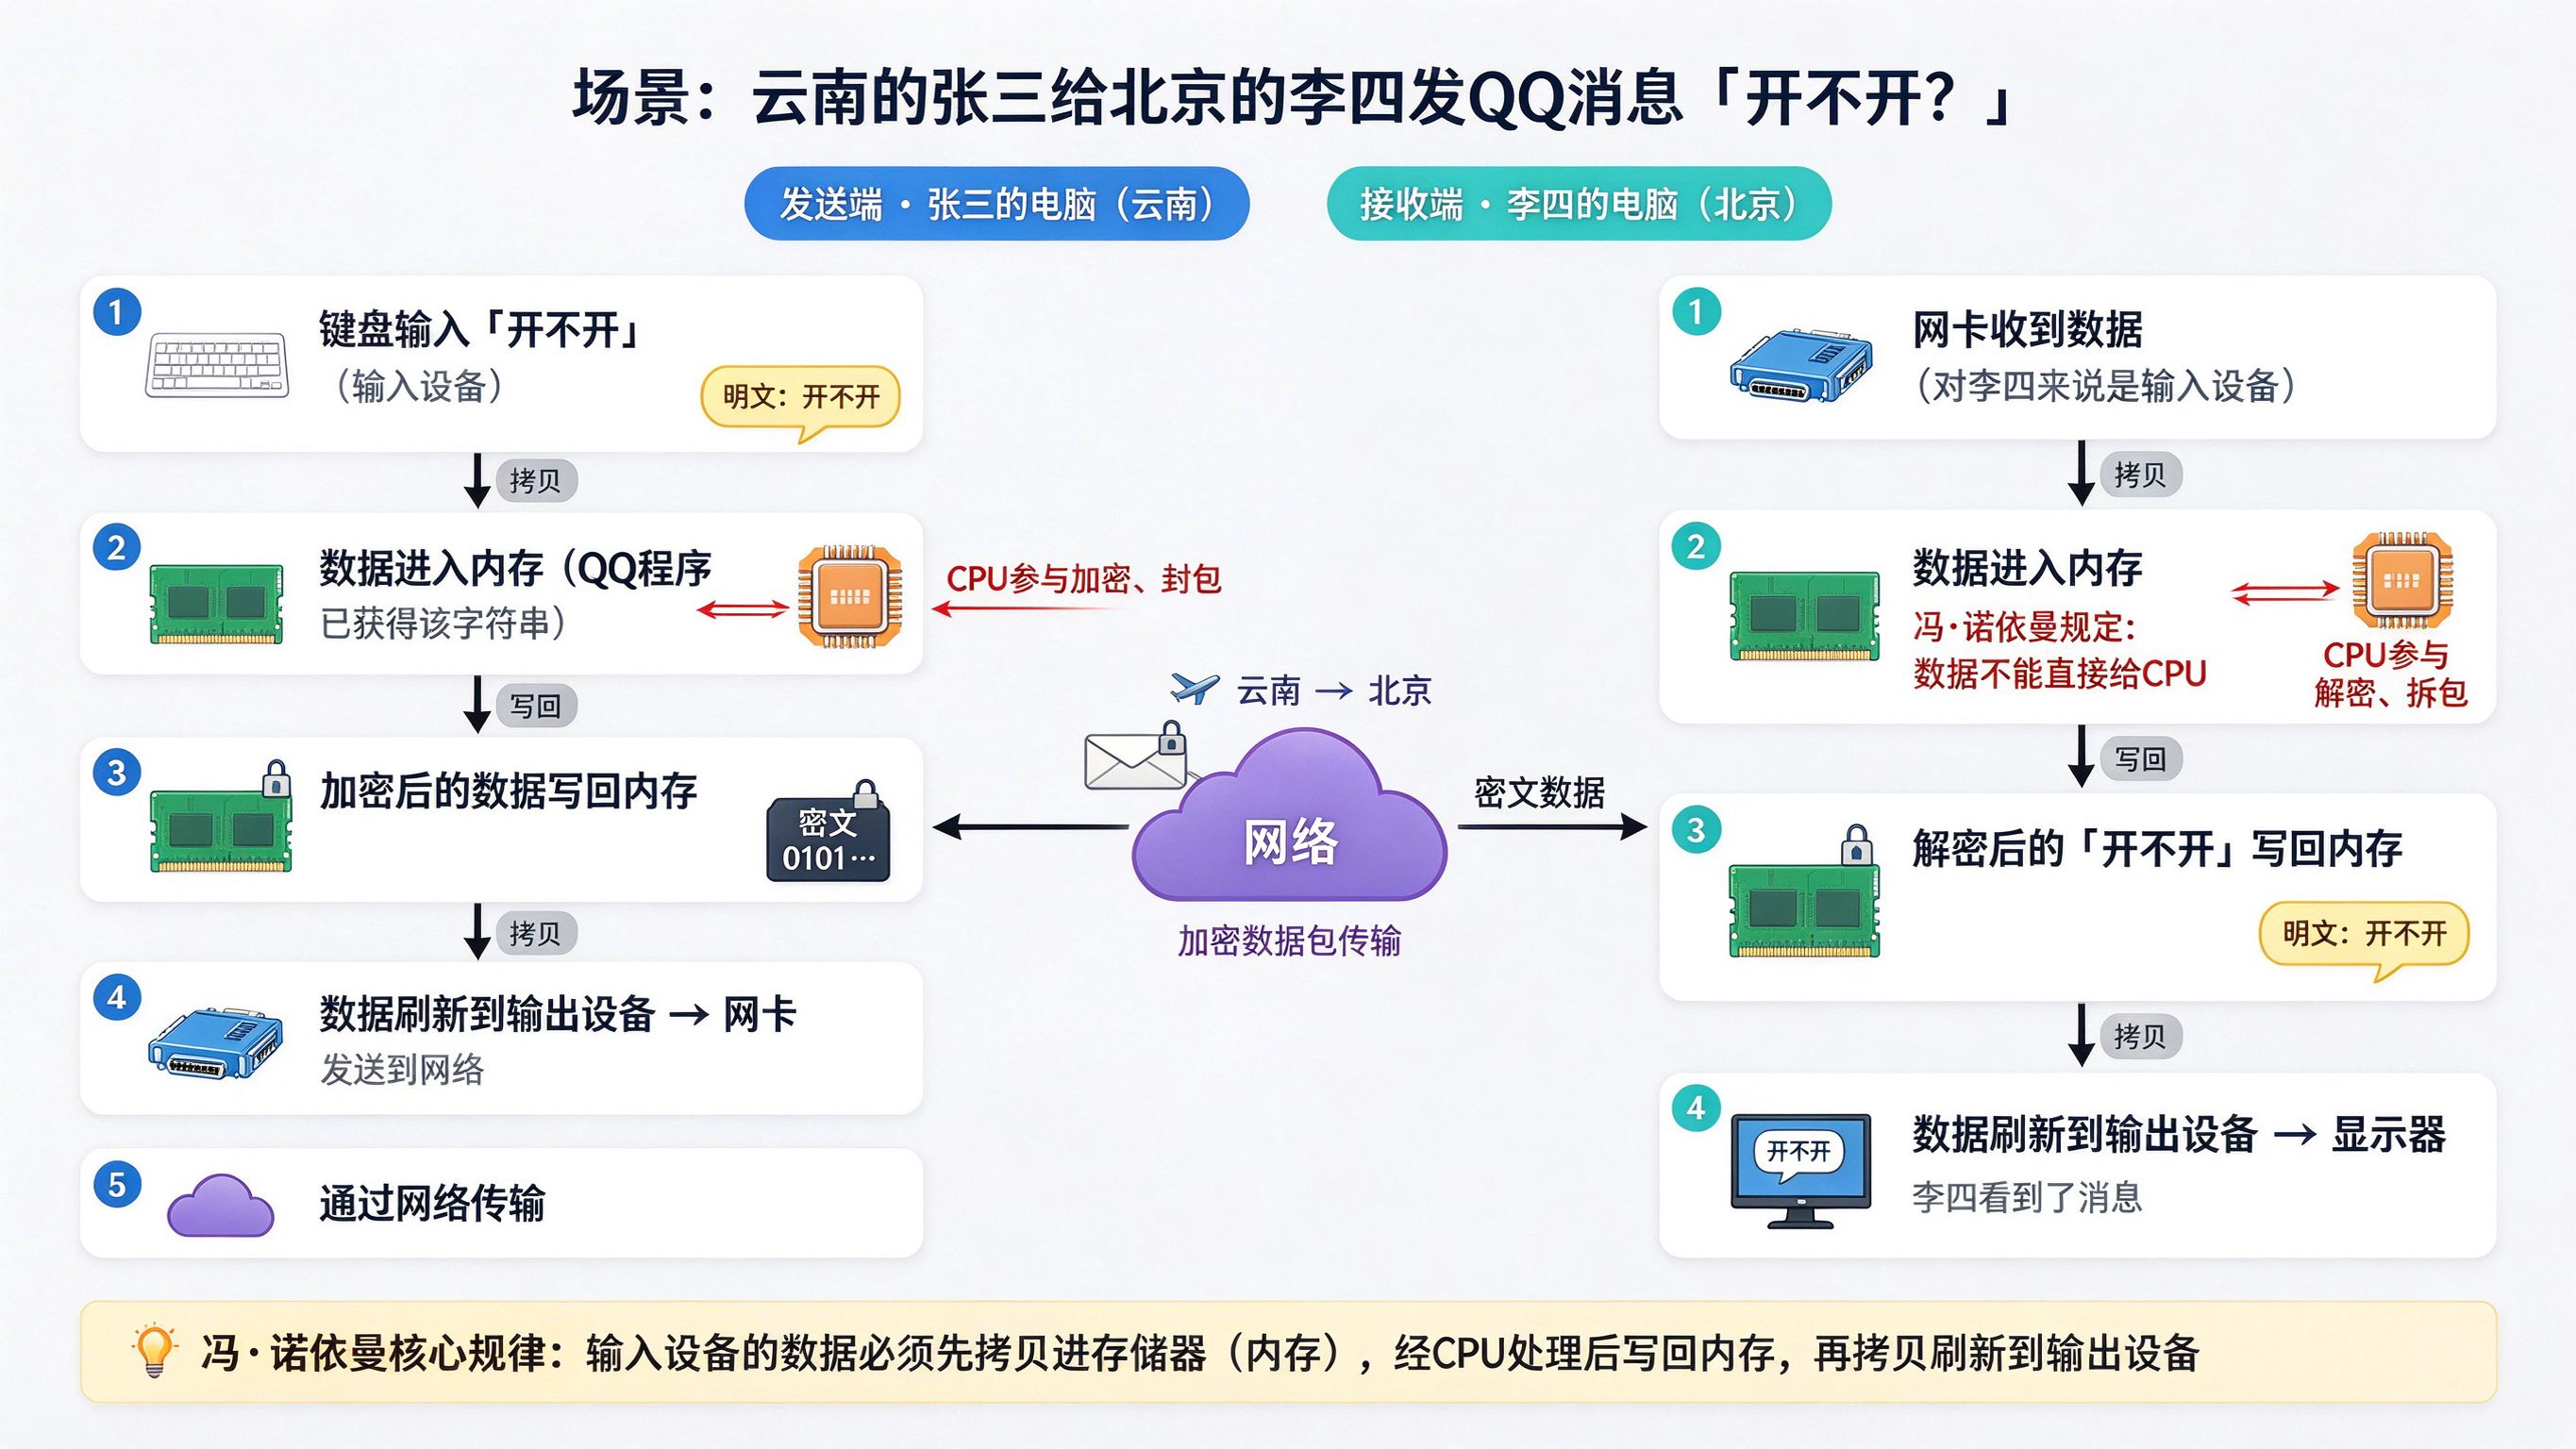
关键要点总结:
- QQ程序必须先加载到内存才能运行(QQ也是可执行程序,本质是文件)。
- 数据必须经过内存:CPU永远不和外设直接交互数据
- CPU的角色:执行加密/解密、封装/拆包的算法。
- 输出的目的地可以有多个:既可以发往网卡,也可以同时显示在显示器上。
"路怎么修,人就怎么走。硬件怎么做,软件将来就必须得这么干!"硬件层面的数据流动规则已经清楚了,那么谁来统一管理这些硬件资源、让上层软件能方便地使用它们呢?答案就是操作系统。
四、操作系统概念作系统概念
4.1 什么是操作系统?
4.2 狭义操作系统 vs 广义操作系统
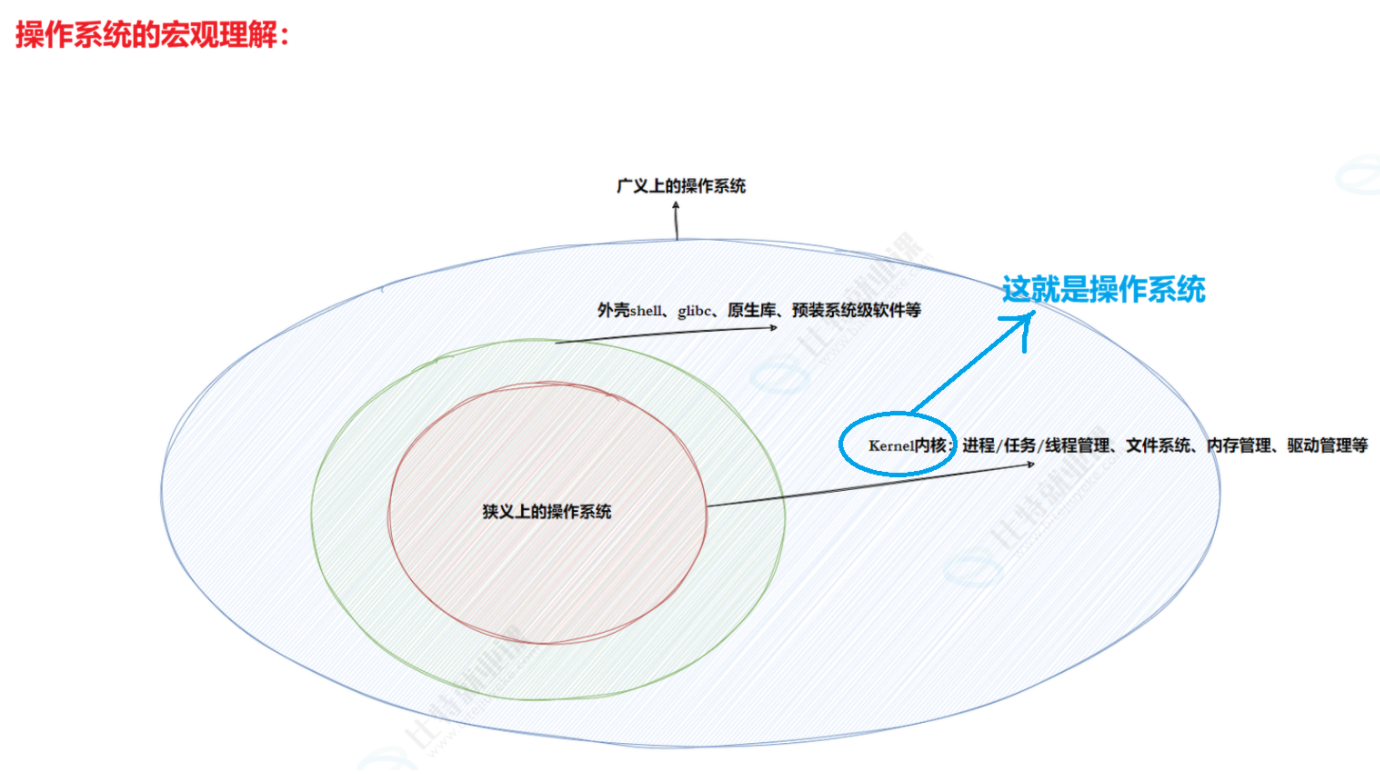
从上面这张图我们能看到:
- 狭义操作系统 = 内核。
- 广义操作系统 = 内核 + 外壳程序(Shell/bash /Windows GUI/Android UI) + 配套生态软件(QQ、浏览器、Office等)。
4.3 操作系统的四大管理功能
| 管理模块 | 对应硬件资源 | 说明 |
|---|---|---|
| 进程管理 | CPU | 管理执行流(线程/进程) |
| 内存管理 | 内存 | 分配、回收、保护 |
| 文件管理 | 磁盘 | 文件系统、路径、权限 |
| 驱动管理 | 各类外设 | 显卡、网卡、键盘等 |
4.4 为什么要有操作系统?
- 根本原因:人不能直接操作硬件。
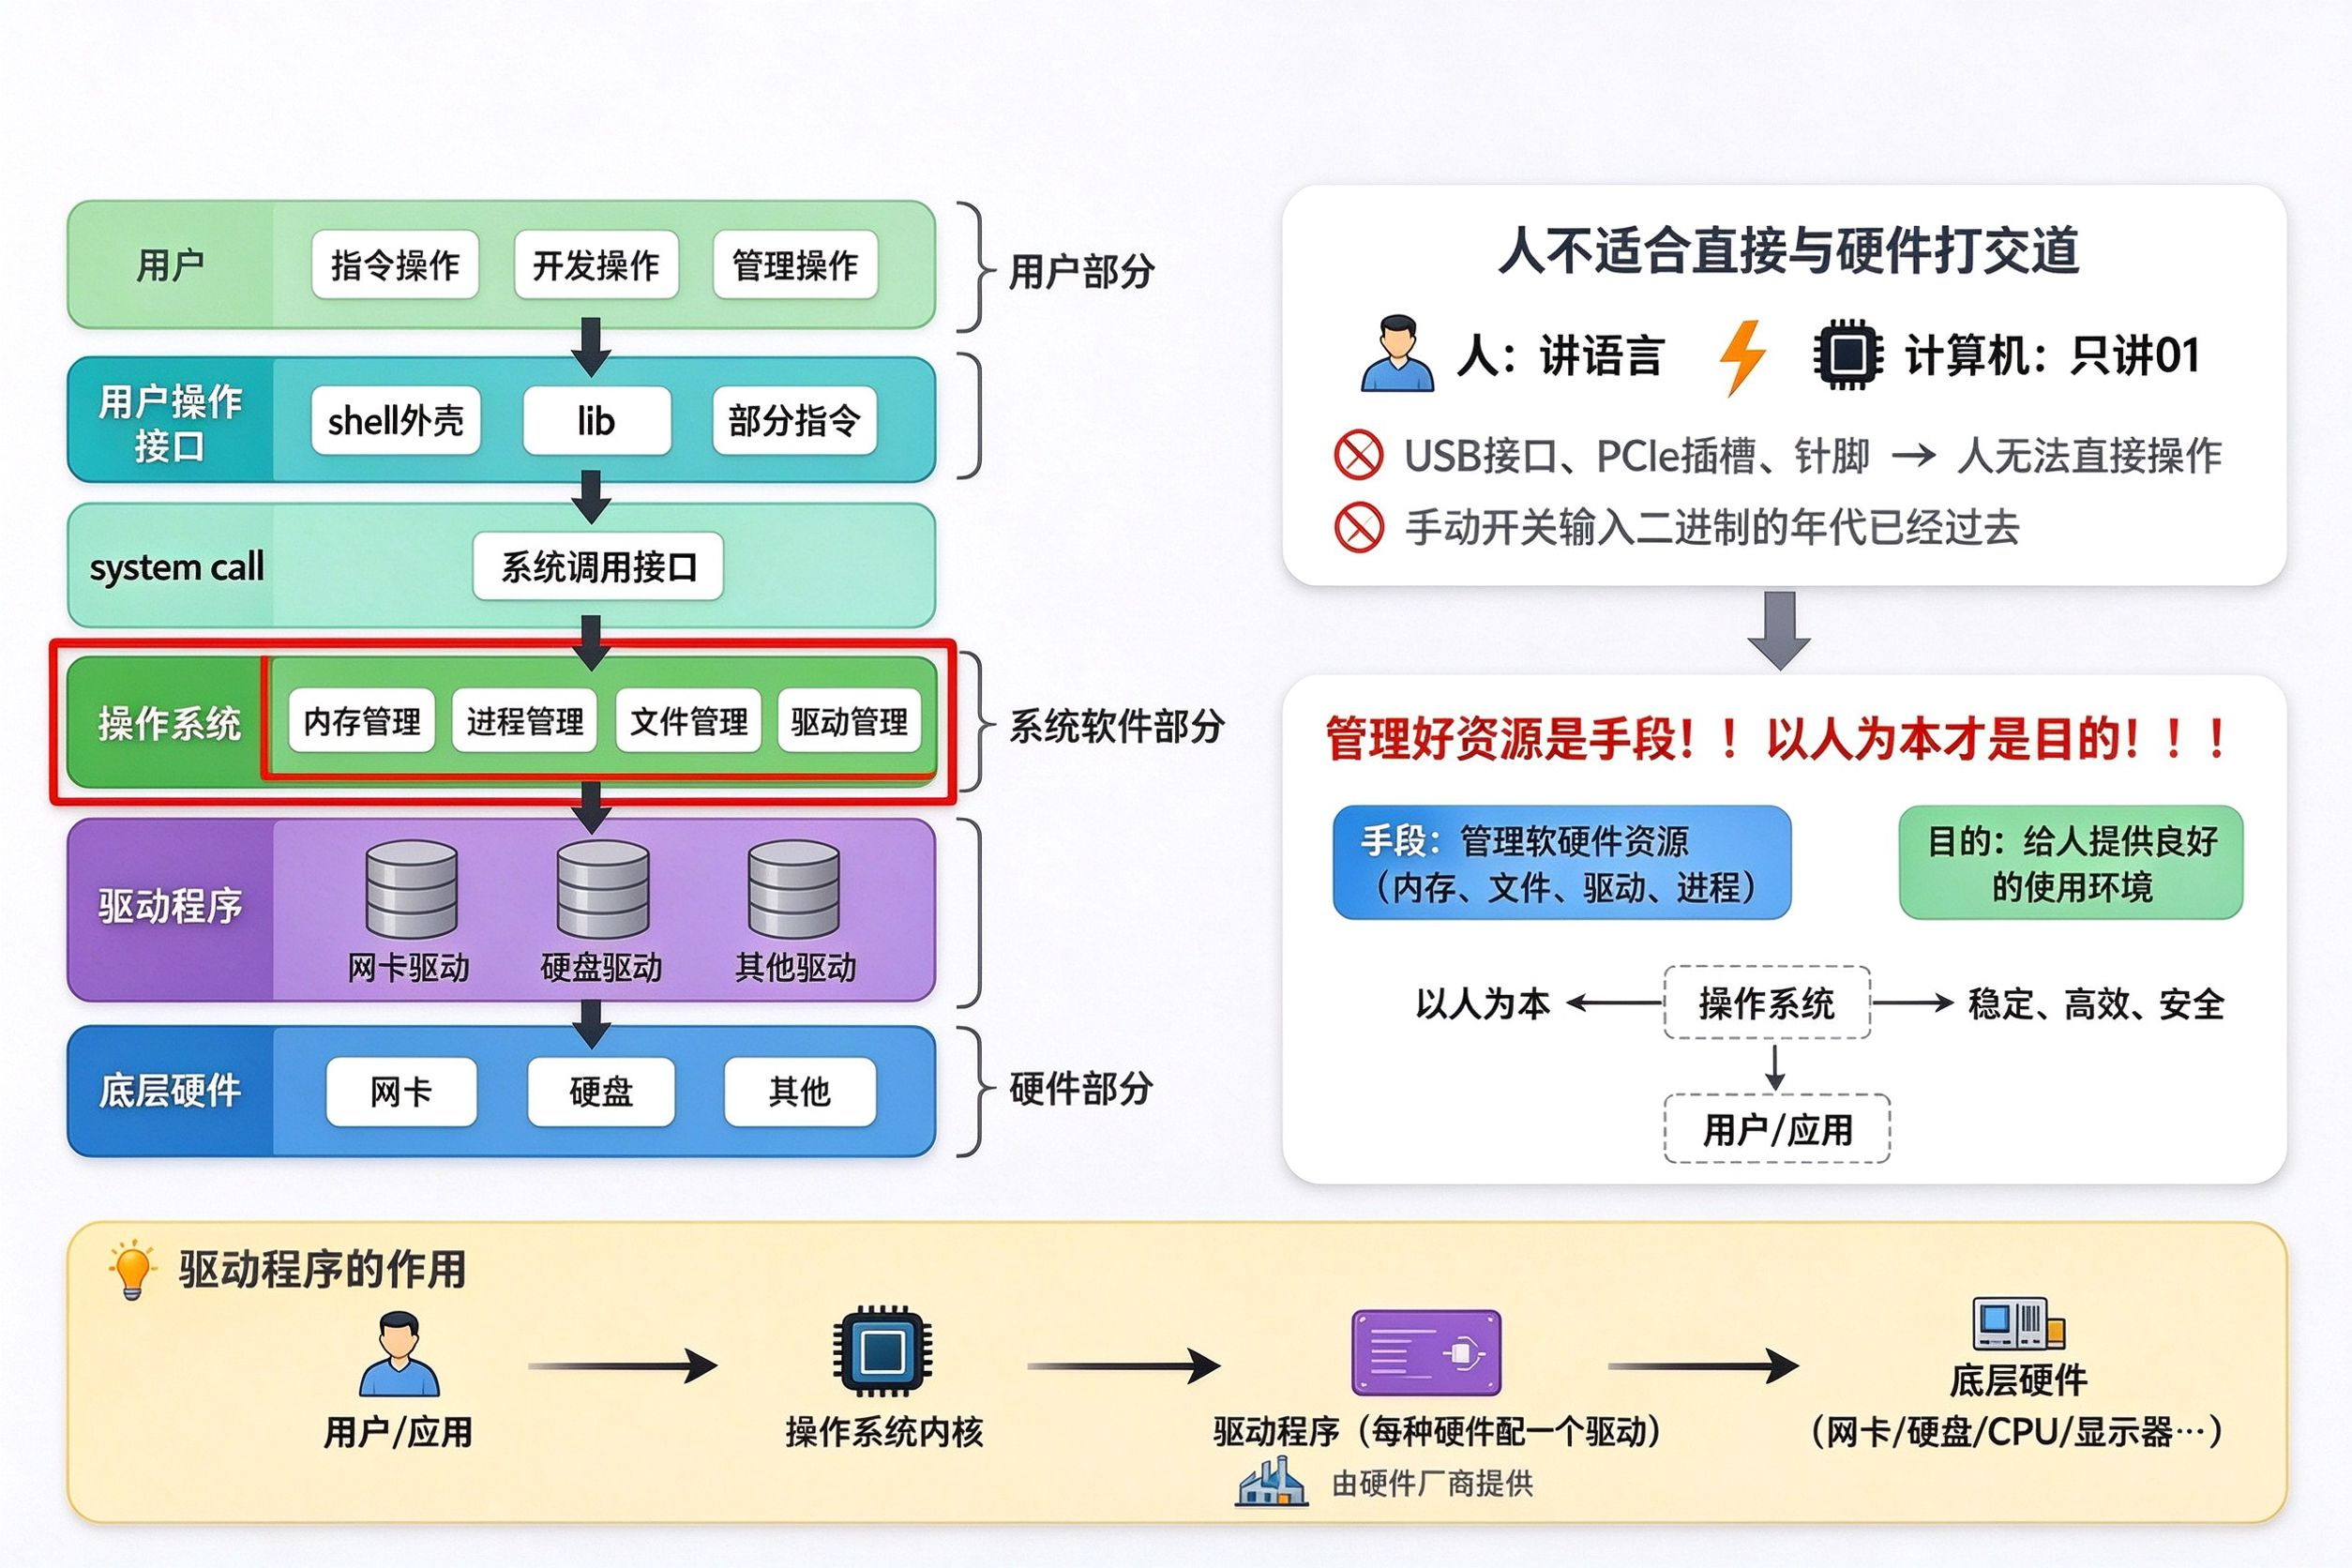
4.5 驱动程序的作用
用户/应用
    ↓
操作系统内核
    ↓
驱动程序(每种硬件配一个驱动)← 由硬件厂商提供
    ↓
底层硬件(网卡/硬盘/CPU/显示器...)
关键要点:
- 操作系统不直接操作硬件,通过驱动程序访问。
- 每个硬件需要配套的驱动,厂商提供。
- 插入USB鼠标后需要"安装成功"弹框 → 驱动加载完成才能使用。
4.6 操作系统的分层架构
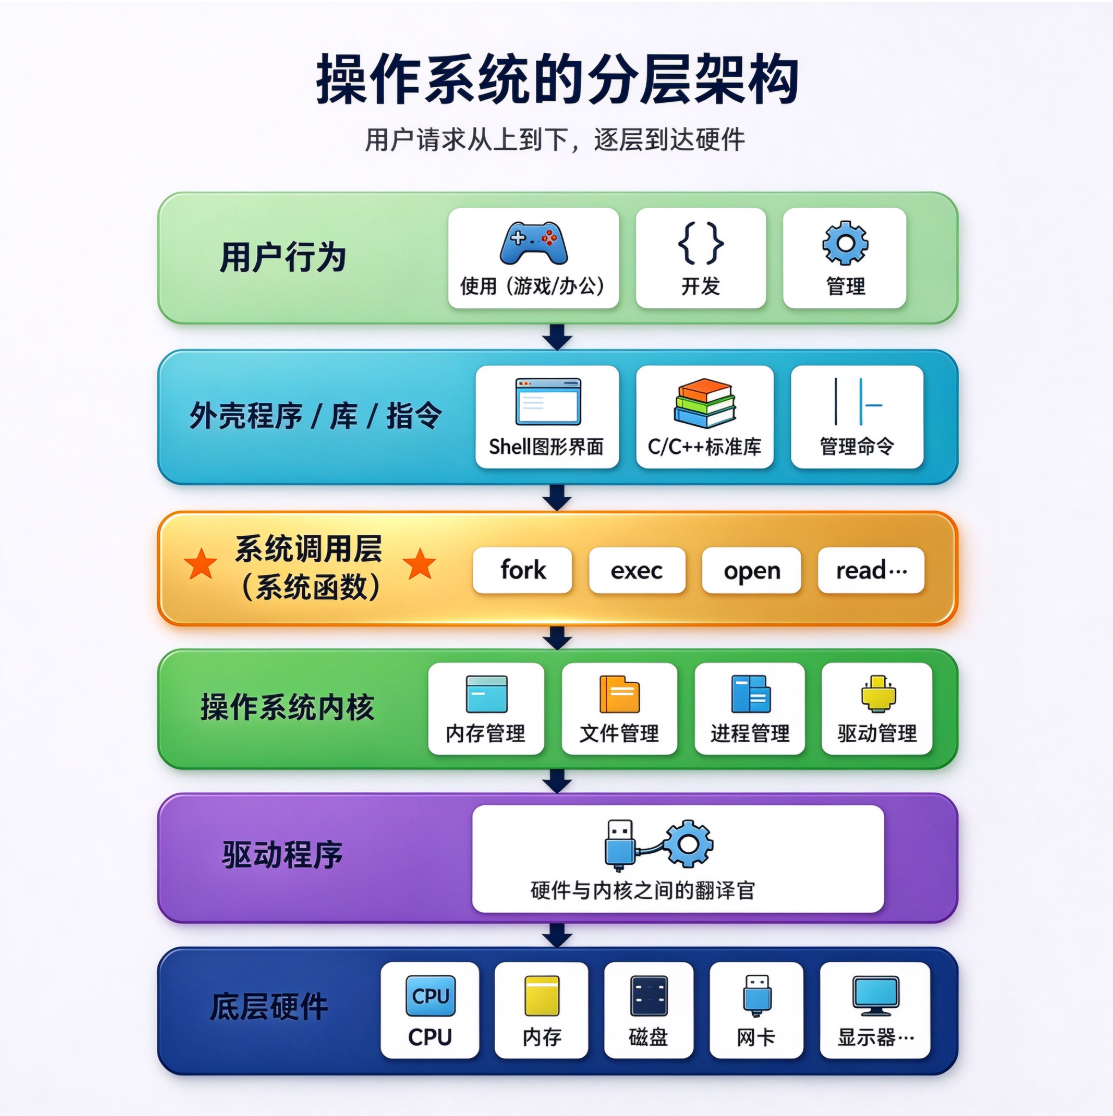
用户的三种操作方式:
- 玩/用操作系统 → 外壳程序(GUI、Shell命令、APP)
- 在操作系统上开发 → C/C++标准库(printf、scanf、fopen等)
- 管理操作系统 → 管理指令(apt、控制面板、安装/卸载软件)
"外壳程序、库函数、指令,最终都直接或间接调用系统调用来完成工作。
五、操作管理的本质——「先描述,再组织」,再组织」
- 🔺"将来学的所有内容全部都围绕着这六个字展开:先描述,再组织</fon
5.1 现实世界的管理模型
角色划分:
- 校长(管理者):负责做决策
- 辅导员:负责获取信息
- 学生(被管理者):负责做执行
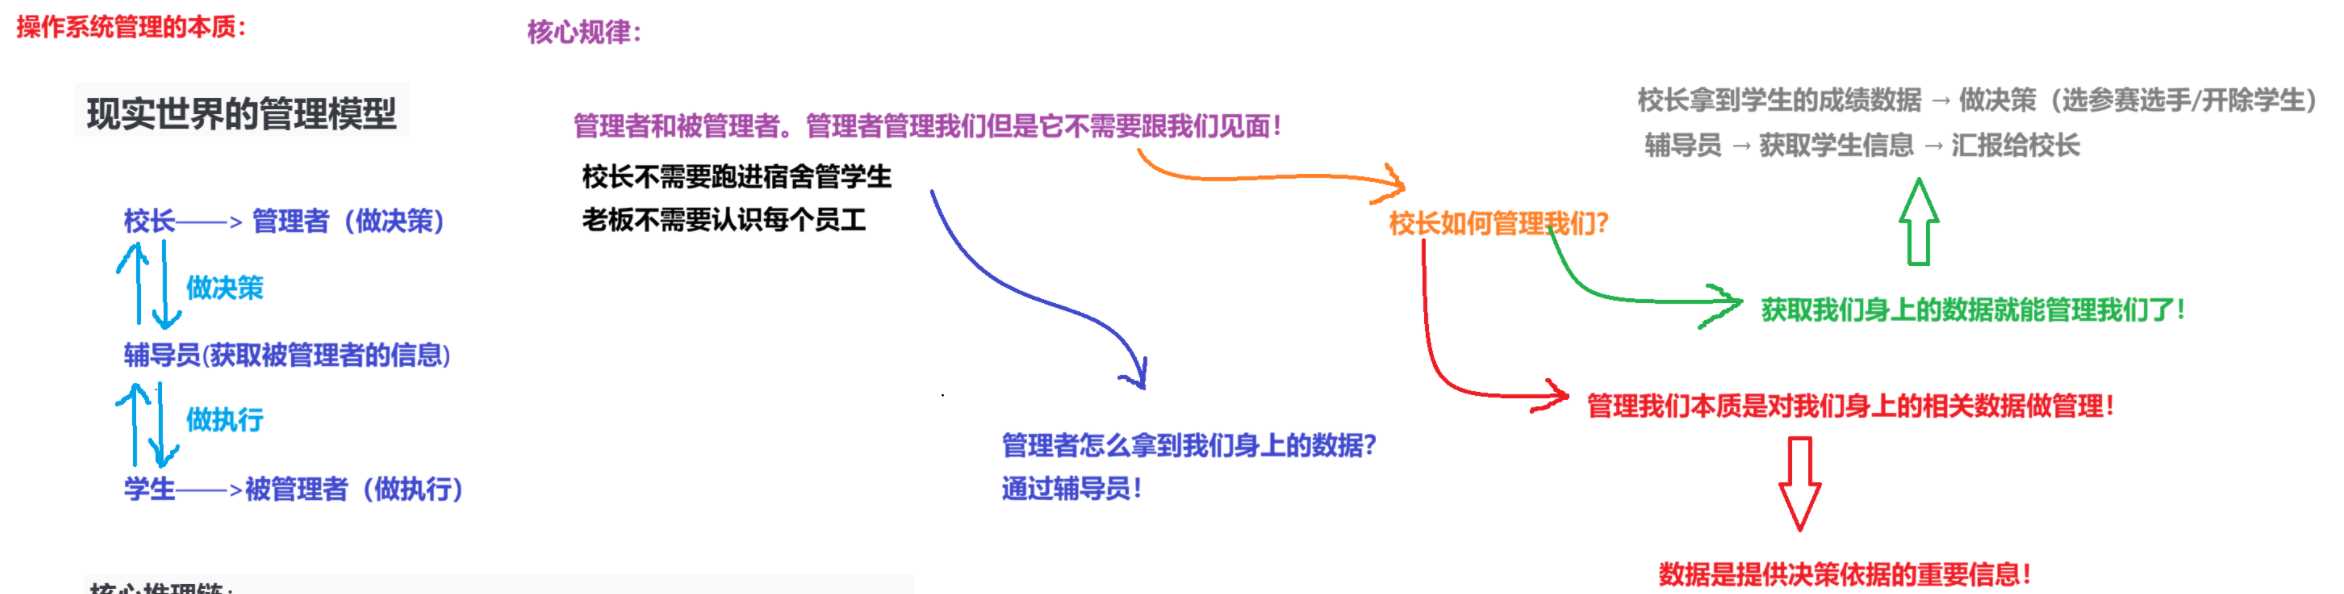
核心推理链:
1.管理者和被管理者不需要见面。
2.校长管理学生,是通过 获取学生身上的数据(成绩、出勤、奖惩)。
3.校长如何获取数据?→通过辅导员。
4.校长如何做决策?→根据数据进行分析(排序、筛选、比较)。
5.管理本质=对数据进行管理,数据提供决策依据。
5.2 将现实管理问题转化为计算机问题(建模)
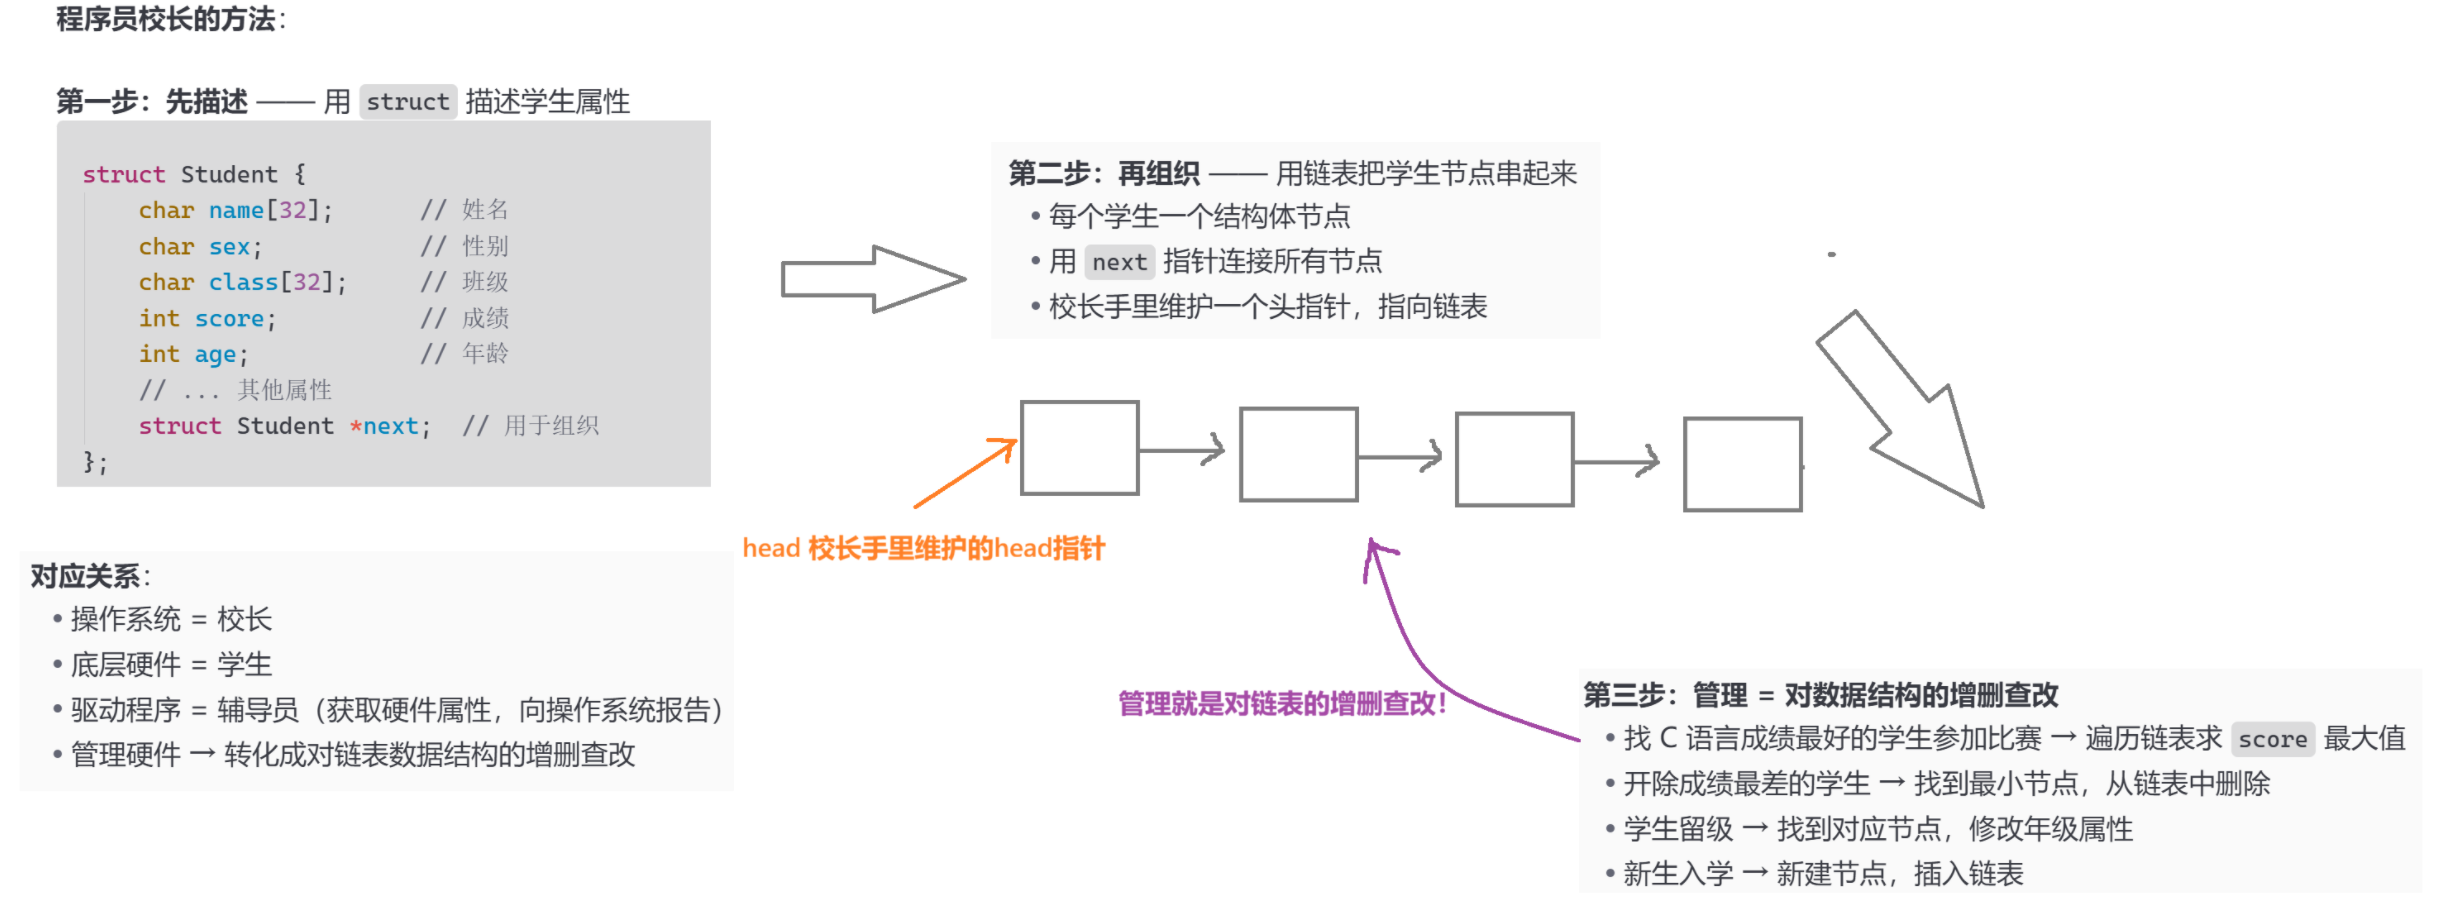
- ⚠️特别注意:
- 在老内核
Linux2.4中,图中所说的head指针就是runqueue_head它是全局就绪双向循环链表的 链表头,所有就绪进程都挂在这个head上! - 但是在
Linux2.6(现代内核)中每一个CPU都有一个独立的runqueue,不再是单一的一条大链表了!- 里面按照优先级分成了多条链表(
prio_array) - 每个优先级都有自己独立的
struct list_head queue[]作为改优先级子队列的链表头! - 另外还有
rq->curr指针,指向当前CPU正在运行的task进程!
- 里面按照优先级分成了多条链表(
上面涉及到进程调度相关的知识了,如果不理解等到看完后面进程调度的篇幅再回来看就瞬间理解了!
5.3 「先描述,再组织」的跨领域延伸
扩展1:操作系统管理硬件
// 操作系统用结构体描述硬件设备
struct device {
    int type;       // 设备类型
    int status;     // 设备状态
    char vendor[20];// 厂商
    bool accessible;// 是否可访问
    struct device *next; // 指向下一个设备
};

// 把所有设备组织成链表
// 管理设备 → 链表增删查改
结论:操作系统内核中存在大量的数据结构!
扩展2:C++面向对象设计的本质
C++的 class       →  "先描述"  (描述事物属性)
C++的 STL容器     →  "再组织"  (vector/list/map/set...)
- 写通讯录 → 先写Person类描述人,再用vector组织。
- 写扫雷游戏 → 先写坐标/Mine类,再组织数据结构。
扩展3:为什么所有编程语言都是面向对象的?
C++	  有class + STL
Java  有class + Collection框架
Python有class + list/dict
Go    有struct + slice/map

不是因为语言特点,而是因为:
      "先描述再组织" 是现实世界的真相!
5.5 「一切皆对象」的本质
为什么Python/Java/JavaScript都是面向对象的语言?
因为在现实世界中,我们要管理任何事物都需要先描述其属性(类),再组织这些实例(对象集合)。这不是语言特性的选择,而是建模的必要方法。
5.6 操作系统的定义
操作系统是一款进行 软硬件资源管理 的软件。当我们看到"管理"二字,立刻想到:
- 先描述:用结构体描述被管理对象。
- 再组织:用数据结构组织所有对象。
- 管理 = 数据结构的增删查改
六、系统调用(System Call)
6.1 为什么要引入系统调用?
不妨先来看看下面这个例子:
- 银行金库里的现金和贵重物品是核心资产,绝不允许外人随意进出;同样,操作系统内核中的关键数据结构和代码也是核心机密,不能让上层用户直接访问,否则一旦被恶意操作,整个系统都会面临安全风险。因此,银行在墙上开小窗口——系统调用,它是银行对外提供的服务接口,客户只能通过这些窗口办理业务,而无法直接触碰金库内部的资产。
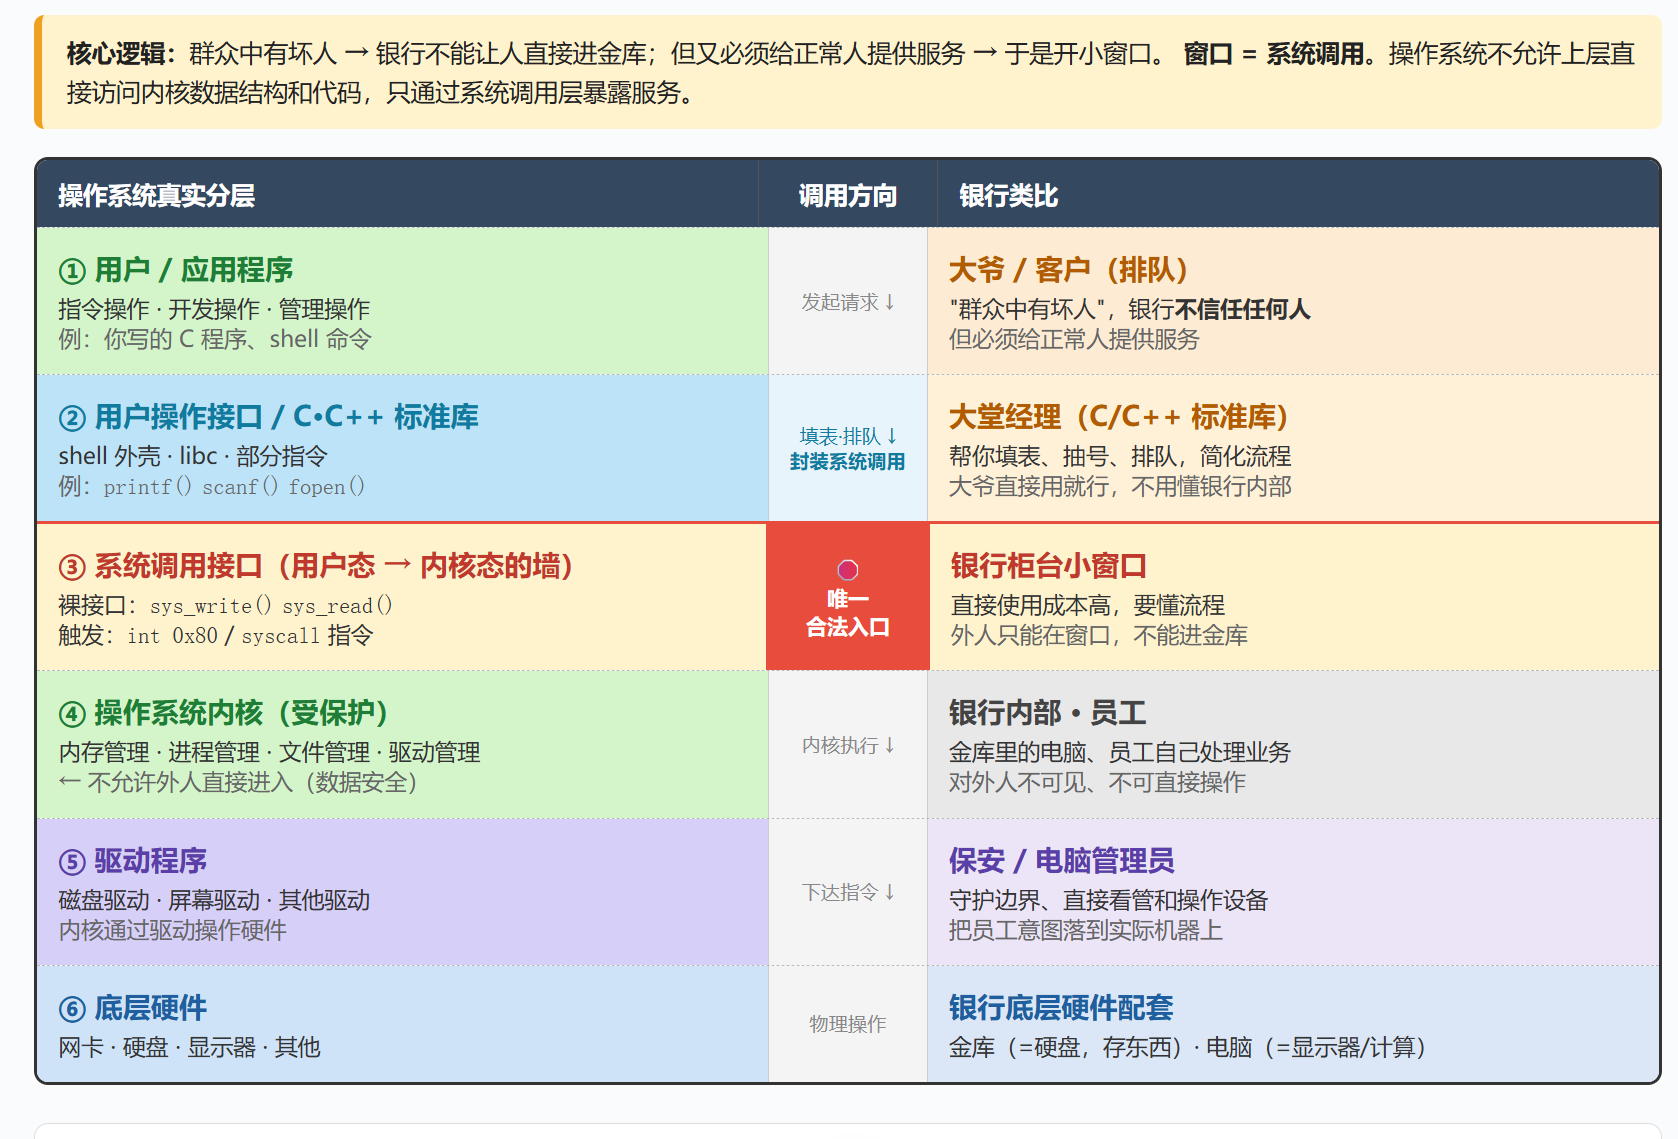
6.2 为什么之前没见过系统调用?—— 库函数的封装
大堂经理类比:
银行窗口(系统调用)     →  直接使用成本高,需要了解流程
    ↑
大堂经理(C/C++标准库) →  帮你填表、抽号、排队,简化使用
    ↑
大爷(开发者)          →  直接用就行,不需要懂银行内部流程
库函数 = 对系统调用的封装
| 层级 | 示例 | 说明 |
|---|---|---|
| 系统调用 | sys_write(), sys_read() | 裸接口,直接操作内核 |
| 标准库 | printf(), scanf(), fopen() | C标准库封装了系统调用 |
“以前写C语言,用的
printf、scanf、fopen这些都是C标准库提供的,底层封装了系统调用。所以我们从来没有直接见过系统调用。”
关键流程图:
printf("hello")          ← 你调用的库函数
    ↓
libc库内部准备缓冲区
    ↓
int 0x80 / syscall指令    ← 触发系统调用
    ↓
内核sys_write()          ← 实际执行
    ↓
内核 → 驱动 → 显示器硬件
重要结论:
- 凡是涉及访问硬件的操作,最终都要贯穿操作系统,调用系统调用
- 向显示器写入数据 → 经过操作系统 → 经过显卡驱动 → 写入显示器
- 向磁盘写入文件 → 经过操作系统 → 经过磁盘驱动 → 写入磁盘
- 覆盖率:标准库中**60%-70%**的函数是对系统调用的封装
系统调用在后面的文件管理模块学习时还会重点介绍,本节就是一个引子宏观理解一下系统调用即可!
七、总结
- 冯·诺依曼体系结构:计算机由输入、输出、内存、运算器、控制器五部分组成(运算器+控制器=CPU),CPU 只与内存打交道,输入输出统称外设。
- 为什么需要内存:离 CPU 越近越快越贵;内存作桥梁解决 CPU(纳秒级)与磁盘(毫秒级)的速度差;配合局部性原理预加载,性价比最优。
- IO 本质:站在内存角度,外设→内存是输入,内存→外设是输出,本质是数据拷贝。
- 操作系统:狭义=内核,广义=内核+外壳+生态软件;通过驱动管理硬件,四大功能为进程、内存、文件、驱动管理。
- 管理本质:先描述(结构体),再组织(数据结构),管理=增删查改。
- 系统调用:内核的安全接口,标准库是对其封装;凡访问硬件最终都要调用系统调
一句话:硬件定规则,内存作桥梁,操作系统管资源,系统调用供入口。
以上就是本篇文章的全部内容,掌握了这些基础概念,后续的进程、内存、文件管理等知识学起来就会轻松很多。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2403_86779341/article/details/166370695

