

智能体编辑世界模型——重新思考大语言模型智能体的世界建模范式
arXiv编号:arXiv:2609.28416v1 [cs.CL]
摘要
大语言模型驱动的智能体已经可以在多样化环境中处理长视界任务。现有的语言世界模型大多预测环境观测结果;但当可以获取真实工具反馈时,重建高熵、强执行依赖的工具返回响应收益十分有限。与此同时智能体会遭遇任务状态污染(task‑state contamination):无依据的假设、过时的计划残留在交互历史中,扭曲后续全部决策。本文提出A(\mathcal E)W(\mathcal M)(Agent‑(\mathcal E)diting World (\mathcal M)odel,智能体编辑世界模型),不再模拟工具返回观测,转而建模推理与动作如何塑造后续任务进展。
A(\mathcal E)W(\mathcal M)包含两大核心模块:Action Judge动作判别器,将决策划分为关键(CRITICAL)、探索((\mathcal E)XPLORATORY)、噪声(NOISY)三类;State Revision状态修订模块,基于已有观测历史,编辑噪声类的推理‑动作接续片段。(\mathcal E)ditAct将上述能力和真实执行流程深度集成:直接修改后续决策所依赖的底层状态,而不是仅仅输出批评意见。
本文在搜索、终端、软件工程三大领域,通过中期预训练与有监督微调完成A(\mathcal E)W(\mathcal M)训练。在自建Action Judge评测基准上,A(\mathcal E)W(\mathcal M)取得70.5%宏F1,相比最强前沿基线高出10.6个百分点。在6项评测基准、3套智能体基座上,(\mathcal E)ditAct相比最优基线平均提升3.2‑6.7分。进一步,基于经过验证的(\mathcal E)ditAct轨迹做拒绝采样微调,得到A(\mathcal E)W(\mathcal M)‑RFT;推理阶段不再依赖在线A(\mathcal E)W(\mathcal M)指导,在三个领域相比Self‑RFT提升2.2‑2.6分。
关键词
大语言模型智能体;世界模型;状态编辑;长视界任务;任务状态污染;拒绝采样微调
目录
- 引言
- A(\mathcal E)W(\mathcal M)智能体编辑世界模型
- 模型学习与能力内化
- 实验
- 任务状态污染案例分析
- 讨论与局限性
- 结论
- 参考文献
- 附录A 数据构造细节
- 附录B 完整超参数与训练脚本
- 附录C 补充实验结果
1 引言
世界模型被视作通用智能的基础,用于捕获环境结构与动力学,支撑理解、推理与规划。具身AI、视觉交互视频生成领域的大量工作验证了世界模型价值。对于长视界大模型智能体,世界模型帮助智能体理解任务环境,维持连贯决策。
传统世界模型遵循以环境为中心的优化目标:根据动作预测下一个状态/观测。该范式适合具身物理仿真、视频生成。但很多语言智能体场景下,工具返回观测具备高熵、强执行依赖:网页搜索结果受网页内容与排序动态变化;终端输出、单元测试结果依赖文件系统与运行时状态。当可以调用真实工具拿到真实反馈,去预测这些观测的收益有限;仿真生成的虚假观测甚至会误导智能体后续推理。
本文轨迹分析发现一类高频失败根源:任务状态污染。智能体在陌生环境探索时,会维护假设、计划、对已取得进展的判断。智能体容易把未证实的假设当成事实、即便收到矛盾反馈依旧保留过时计划、误将局部进展当作任务完成。这些错误会残留在交互历史中,通过每一步局部看似合理的动作持续放大恶化;即便存在真实环境观测,也不会自动修正智能体内部的理解与假设。
传统世界模型目标:预测环境观测;
A(\mathcal E)W(\mathcal M)目标:建模智能体自身推理、动作会如何影响后续任务进展,对污染的推理‑动作片段直接做编辑修改,而不是预测环境输出。
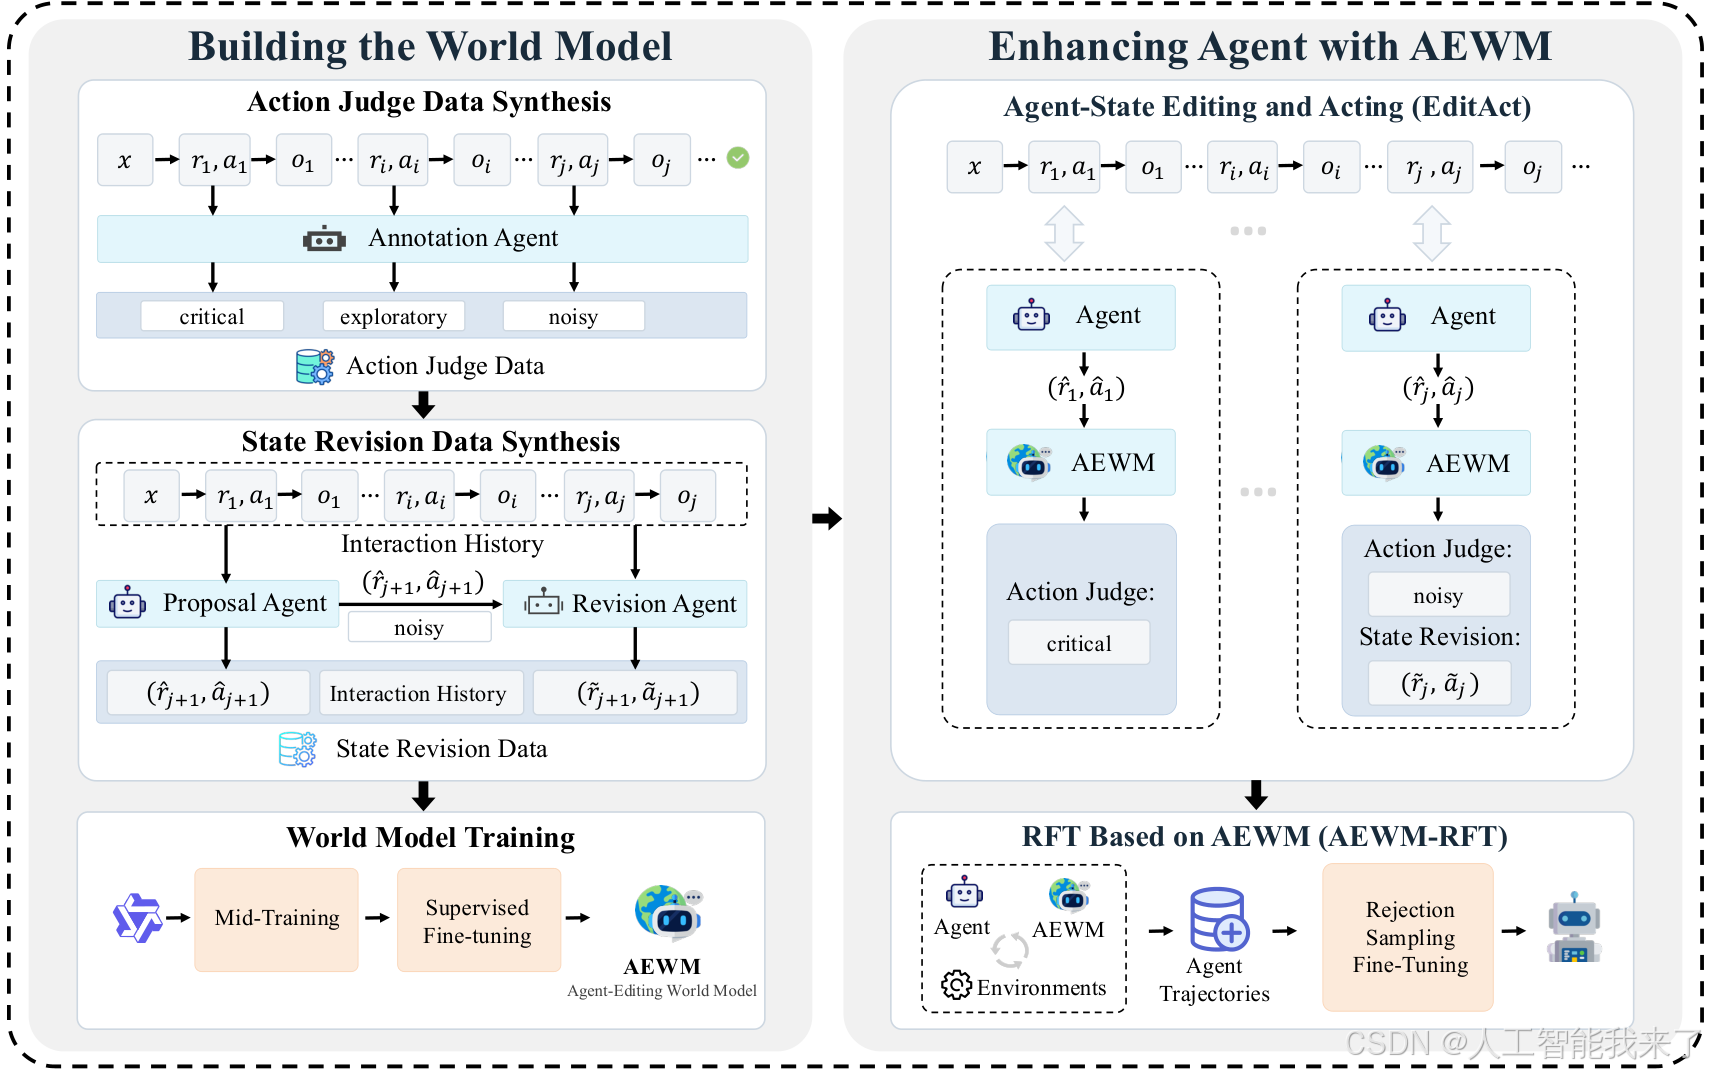
A(\mathcal E)W(\mathcal M)由两大模块构成:
- Action Judge动作判别器:接收执行前完整状态,将待执行推理‑动作对标记为三类:
CRITICAL关键:缩小核心信息缺口、获取必需证据、完成关键状态变更;\(\mathcal E\)XPLORATORY探索:有效降低不确定性、测试可行分支;NOISY噪声:几乎不推进任务,带来重复、无关、约束违背、错误方向。
- State Revision状态修订模块:针对被判定为噪声的片段,生成修订后的推理与动作,修正错误假设、更新计划。
(\mathcal E)ditAct推理流程:智能体原始输出推理‑动作对,A(\mathcal E)W(\mathcal M)做判别;仅噪声片段会被替换为修订版本;将处理后的推理动作送入真实环境执行;编辑后的内容会进入后续交互历史,直接改变后续全部决策依赖的状态,而不是仅仅输出一段批评文本。
训练分为两阶段:中期预训练(52B交互token),接着在120K条高质量样例做有监督微调SFT。进一步收集(\mathcal E)ditAct运行轨迹,做拒绝采样微调得到A(\mathcal E)W(\mathcal M)‑RFT,推理阶段不再需要A(\mathcal E)W(\mathcal M)在线介入,把编辑带来的能力直接内化进智能体基座。
本文核心贡献
- 提出A(\mathcal E)W(\mathcal M)智能体编辑世界模型,摒弃预测环境观测的传统范式,转而建模决策带来的任务进展,直接编辑智能体内部状态,缓解长视界交互过程的任务状态污染;提出(\mathcal E)ditAct推理流程,执行前选择性替换噪声推理‑动作接续片段。
- 构建跨域训练流水线,通过轨迹合成得到Action Judge与State Revision训练数据;构建3000条决策级Action Judge评测基准;提出A(\mathcal E)W(\mathcal M)‑RFT,利用(\mathcal E)ditAct真实轨迹,把编辑能力离线迁移进普通智能体。
- 在搜索、终端、软件工程三大领域验证有效性:Action Judge任务宏F1达到70.5%,高出最强基线10.6个点;(\mathcal E)ditAct在6项基准、3个基座上平均提升3.2‑6.7分;A(\mathcal E)W(\mathcal M)‑RFT离线模式相比Self‑RFT提升2.2‑2.6分。消融实验证明:直接替换推理‑动作片段,效果优于单纯重采样、提示批判。
2 智能体编辑世界模型
2.1 符号前置定义
任务
x
x
x;
t
t
t步之前交互历史:
h
t
=
(
x
,
(
r
i
,
a
i
,
o
i
)
i
=
0
t
−
1
)
h_{t}=\big(x,(r_i,a_i,o_i)_{i=0}^{t-1}\big)
ht=(x,(ri,ai,oi)i=0t−1)
r
i
r_i
ri第
i
i
i步推理,
a
i
a_i
ai第
i
i
i步动作,
o
i
o_i
oi环境观测。
智能体策略
π
θ
\pi_\theta
πθ基于历史
h
t
h_t
ht输出候选推理动作对:
(
r
^
t
,
a
^
t
)
\left(\hat r_t,\hat a_t\right)
(r^t,a^t)。
执行前完整状态:
s
t
=
h
t
⊕
(
r
^
t
,
a
^
t
)
s_t = h_t \oplus (\hat r_t,\hat a_t)
st=ht⊕(r^t,a^t)
传统观测预测世界模型KaTeX parse error: Can't use function '\(' in math mode at position 10: \mathcal \̲(̲\mathcal M\)_{o…学习分布KaTeX parse error: Can't use function '\(' in math mode at position 10: \mathcal \̲(̲\mathcal M\)_{o…,目标预测环境返回。
A(\mathcal E)W(\mathcal M)不预测观测;建模:给定证据、当前推理‑动作,会如何影响后续任务进展;对于会带来污染的接续片段,直接编辑修改。
2.2 智能体状态建模与状态编辑
A(\mathcal E)W(\mathcal M)模型KaTeX parse error: Can't use function '\(' in math mode at position 10: \mathcal \̲(̲\mathcal M\)分为两个子能力:
- KaTeX parse error: Can't use function '\(' in math mode at position 10: \mathcal \̲(̲\mathcal M\)_{A…(Action Judge):输入状态 s t s_t st输出标签 y ^ t ∈ { critical , exploratory , noisy } \hat y_t\in\{\text{critical},\text{exploratory},\text{noisy}\} y^t∈{critical,exploratory,noisy}。
- KaTeX parse error: Can't use function '\(' in math mode at position 10: \mathcal \̲(̲\mathcal M\)_{S…(State Revision):输入 s t s_t st,对噪声样本生成修订后的推理动作对 ( r ~ t , a ~ t ) \big(\tilde r_t,\tilde a_t\big) (r~t,a~t)。
范式对比
- 传统世界模型:KaTeX parse error: Can't use function '\(' in math mode at position 27: …arrow{\mathcal \̲(̲\mathcal M\)_{o…,预测假想环境观测;
- A(\mathcal E)W(\mathcal M)编辑世界模型:KaTeX parse error: Can't use function '\(' in math mode at position 27: …arrow{\mathcal \̲(̲\mathcal M\)_{S…;保留历史 h t h_t ht,替换当前推理‑动作,后续再向真实环境拿观测。
2.3 (\mathcal E)ditAct:状态编辑与真实执行集成推理流程
每一步 t t t(非终止步)完整流程:
- 智能体输出候选推理‑动作 ( r ^ t , a ^ t ) \left(\hat r_t,\hat a_t\right) (r^t,a^t),构造执行前状态 s t s_t st。
- Action Judge输出标签KaTeX parse error: Can't use function '\(' in math mode at position 19: …t y_t=\mathcal \̲(̲\mathcal M\)_{A…。
- 选择最终送入执行的推理‑动作对:
( r t , a t ) = { ( r ^ t , a ^ t ) y ^ t ∈ { critical , exploratory } ( r ~ t , a ~ t ) y ^ t = noisy \left(r_{t}, a_{t}\right)= \begin{cases} \left(\hat r_t,\hat a_t\right) & \hat y_t\in\{\text{critical},\text{exploratory}\} \\ \left(\tilde r_t,\tilde a_t\right) & \hat y_t=\text{noisy} \end{cases} (rt,at)={(r^t,a^t)(r~t,a~t)y^t∈{critical,exploratory}y^t=noisy
仅噪声样本调用State Revision做修订。
- 将 a t a_t at送入真实环境KaTeX parse error: Can't use function '\(' in math mode at position 10: \mathcal \̲(̲\mathcal E\),拿到真实观测 o t o_t ot。
- 更新交互历史: h t + 1 = h t ⊕ ( r t , a t , o t ) h_{t+1}=h_t \oplus(r_t,a_t,o_t) ht+1=ht⊕(rt,at,ot),进入下一轮。
(\mathcal E)ditAct关键点:修订后的推理会写入交互历史,直接改变智能体后续每一步的上下文;不是只输出仅供阅读的批判提示。
3 模型学习与能力内化
3.1 数据集构造
两套合成数据流水线:
- Action Judge标注数据:标注智能体对原始交互轨迹逐轮做决策标注,输出
critical / exploratory / noisy标签;构建3000条决策级跨域评测基准。 - State Revision修订数据:Proposal提案智能体输出噪声推理‑动作;Revision修订智能体基于完整交互历史生成修正后的推理动作对。
领域覆盖:网页搜索Search、终端Terminal、软件工程SW(\mathcal E);训练集合计120K条样例。
3.2 两阶段训练流程
- 中期预训练 (\mathcal M)id‑training:52B tokens多领域交互轨迹数据,让模型学习通用智能体交互知识。
- 有监督微调SFT:在120K条Action Judge+State Revision合成样例微调,同时激活判别、修订两项能力。
3.3 A(\mathcal E)W(\mathcal M)‑RFT:拒绝采样微调迁移能力
- 基座智能体开启(\mathcal E)ditAct,在环境中大量运行,收集经过A(\mathcal E)W(\mathcal M)编辑修正后的完整真实轨迹;
- 使用拒绝采样微调RFT,将经过验证的高质量轨迹用于微调原始基座模型;
- 推理阶段不再加载A(\mathcal E)W(\mathcal M);普通智能体直接内化编辑带来的决策能力。
意义:把在线的编辑干预,转化为模型本身的内在能力,消除推理阶段额外开销。
4 实验
4.1 实验设置
4.1.1 评测基准
6项端到端智能体基准:BrowseComp、DeepSearchQA、Terminal‑Bench 2.0、Doc2Repo、NL2Repo、SW\(\mathcal E\)‑Bench‑Pro。
自建评测集:Action Judge判别基准(3000条跨域决策样本)。
4.1.2 基线对比
- ReAct原生基线;
- Step‑level Best@3:单步采样多条候选,挑选最优单步;
- Trajectory‑level Best@3:完整轨迹采样挑选最优轨迹;
- Resample重采样基线;
- Hint提示批判基线:只输出批评文本,不替换推理‑动作。
4.1.3 模型基座
Qwen3.5‑4B、Qwen3.5‑9B、Qwen3.5‑35B‑A3B,三套大小不同基座,验证方法普适性。
4.2 Action Judge判别任务结果
A(\mathcal E)W(\mathcal M)取得70.5%宏F1;对比所有前沿基线,相比第二名提升**+10.6个百分点**。
| 模型 | 宏F1 |
|---|---|
| Gemini‑3‑Pro | 49.5 |
| GL(\mathcal M)‑5.2‑Pro | 55.0 |
| Qwen3.7‑(\mathcal M)ax | 61.3 |
| GPT‑5.5 | 64.2 |
| DeepSeek‑V4‑Pro | 66.1 |
| A(\mathcal E)W(\mathcal M)(Ours) | 70.5 |
4.3 (\mathcal E)ditAct端到端智能体主实验
(\mathcal E)ditAct挂载在三套不同基座上,相比该基座对应的最优基线,平均提升:
- Qwen3.5‑4B:+6.7分
- Qwen3.5‑9B:+5.2分
- Qwen3.5‑35B‑A3B:+3.2分
现象:小模型增益更大;大基座本身质量较高,增益幅度收窄,但依旧稳定提升。在全部6个基准上均观测到正向收益。
4.4 A(\mathcal E)W(\mathcal M)‑RFT离线迁移实验
经过(\mathcal E)ditAct生成的轨迹做拒绝采样微调;推理阶段不再使用A(\mathcal E)W(\mathcal M)在线编辑。
| 配置 | Search | Terminal | SW(\mathcal E) |
|---|---|---|---|
| 原始Self‑RFT | 43.2 | 37.1 | 41.4 |
| A(\mathcal E)W(\mathcal M)‑RFT(Ours) | 45.4 | 39.7 | 43.6 |
相对Self‑RFT,三个领域分别提升:+2.2、+2.6、+2.2分。证明编辑带来的高质量经验可以离线内化进基座。
4.5 消融实验
- 消融:仅做重采样(Resample),不做State Revision替换:性能提升有限,显著弱于完整(\mathcal E)ditAct。
- 消融:只输出批判提示Hint,不直接替换推理‑动作接续片段:收益有限。
结论:收益核心来自直接替换噪声推理‑动作对,而不是仅仅提示批评,也不是多候选重采样。
- 消融:移除中期预训练,只使用SFT微调:性能明显下降,中期预训练是跨域泛化重要基础。
5 任务状态污染案例分析
论文给出真实轨迹案例:智能体接受未经证实假设,后续多步全部建立在错误假设之上;即便环境返回矛盾观测,历史旧假设不会自动消失,持续污染后续规划。
传统方案:只输出批评文本,历史推理‑动作不会被改写,污染根源仍然保留在上下文。
(\mathcal E)ditAct方案:直接替换产生问题的推理‑动作片段,修改写入交互历史,从根源切断污染传播。
6 讨论与局限性
- A(\mathcal E)W(\mathcal M)依赖高质量的判别与修订生成;当噪声决策本身极难识别时,判别器会漏判,污染依旧会传播。
- State Revision修订模块本身也会生成错误推理,引入新错误。
- 本工作实验限定文本工具智能体;尚未拓展具身多模态视觉智能体。
- A(\mathcal E)W(\mathcal M)‑RFT效果上限取决于(\mathcal E)ditAct产出轨迹质量;若编辑本身存在缺陷,会被一并内化进模型。
未来方向:拓展到多模态具身世界建模;优化判别器召回;结合强化学习进一步优化编辑策略。
7 结论
本文提出A(\mathcal E)W(\mathcal M)智能体编辑世界模型,摒弃传统预测环境观测的世界建模范式;转而建模智能体决策对任务进展的影响。包含Action Judge决策判别与State Revision状态修订两大模块;(\mathcal E)ditAct在执行前直接替换噪声推理‑动作片段,从源头缓解任务状态污染。
两阶段训练得到A(\mathcal E)W(\mathcal M),Action Judge判别任务显著优于基线;(\mathcal E)ditAct挂载到不同基座,在6项智能体基准稳定提升性能。进一步A(\mathcal E)W(\mathcal M)‑RFT通过拒绝采样微调,把编辑能力离线内化,推理阶段不再需要在线A(\mathcal E)W(\mathcal M)介入。消融证明核心收益来自直接替换推理‑动作接续片段,而不是单纯提示批评或多候选重采样。
8 参考文献
完整参考文献查阅原始arXiv网页:https://arxiv.org/html/2609.28416v1
附录简要说明
- 附录A:Action Judge、State Revision数据集合成完整流水线、标注智能体prompt、样例。
- 附录B:全部超参数、模型配置、训练脚本、环境参数。
- 附录C:细分基准完整数值、额外消融、失败案例样例轨迹。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_44626085/article/details/166599615

