


文章目录
一、引言:一段代码,三种结局
先看一段几乎每个 C++ 初学者都写过的代码:
#include <iostream>

int main() {
    std::cout << "你好,世界" << std::endl;
    return 0;
}
在 Linux 上它可能正常输出;在 Windows 的某些环境下可能变成一串乱码;换一个编译器选项,结果又变了。为什么一个"Hello World"级别的程序,在不同平台表现如此不同?
答案就藏在本文的主题里:字符的"宽"与"窄",以及字符串在内存中到底以什么编码存在。很多 C++ 程序员用过 wchar_t、std::wstring,却说不清它们和 char、std::string 的本质区别,于是遇到乱码只能靠"试"。本文从编码原理出发,把 C++ 宽窄字符的关系讲透,并给出跨平台的现代最佳实践。
二、前置知识:字符、码点与编码单元
要理解宽窄字符,必须先理解三个概念:字符(Character)、码点(Code Point)、编码单元(Code Unit)。
2.1 ASCII 时代的错觉:字符 = 字节
ASCII 用 7 个比特给 128 个符号编号(0x00~0x7F),一个字节就能装下,所以早期程序员形成了"一个字符就是一个字节"的印象。这个印象至今仍然坑人——因为 ASCII 只覆盖英文、数字和少量符号,它从来不是为中文设计的。
2.2 多字节字符集:GBK 的"窄"字符困境
为了容纳汉字,简体中文世界出现了 GB2312/GBK 这类多字节字符集(MBCS):ASCII 字符占 1 字节(0x00~0x7F),汉字占 2 字节。注意,这里出现了第一个关键事实:
窄字符串里,一个"字符"可能占用多个字节,且具体字节数取决于编码。
GBK 的致命问题是:编码不统一。同一个 "中",在 GBK 里是 D6 D0,在 Big5(繁体)里是 A4 A4,在 UTF-8 里是 E4 B8 AD。多字节字符集之间没有统一的映射,A 系统写出的文件到 B 系统就乱码——这就是"乱码"最古老、也最广泛的来源。
2.3 Unicode:给每个字符一个唯一的编号
Unicode 试图终结这种混乱:它给全世界几乎每一个字符分配一个唯一的整数编号,称为码点(Code Point),记作 U+XXXX。比如:
| 字符 | 码点 |
|---|---|
A | U+0041 |
中 | U+4E2D |
😀(emoji) | U+1F600 |
Unicode 码点范围是 U+0000 ~ U+10FFFF,一共约 110 万个位置。
码点只是"编号",不是"存储形式"。同一个码点可以用不同编码规则变成字节序列,这就引出了 UTF 家族。
2.4 三种主流编码:UTF-8 / UTF-16 / UTF-32
| 编码 | 变长? | 每字符字节数 | 兼容 ASCII | 典型用途 |
|---|---|---|---|---|
| UTF-8 | 是 | 1~4 | 是(U+0000~U+007F 与 ASCII 完全一致) | 文件、网络、跨平台数据交换 |
| UTF-16 | 是(2/4 字节) | 2~4 | 否 | Windows 系统内部、Java/.NET 字符串 |
| UTF-32 | 否 | 4 | 否 | 需要按码点随机索引的场景 |
- UTF-8:按码点大小用 1~4 字节编码,ASCII 兼容,因此对英文文本"零开销",是互联网事实标准。
- UTF-16:
U+0000~U+FFFF用 2 字节;超出部分(如 emoji)需要用一对**代理对(Surrogate Pair)**占 4 字节。Windows 系统内部使用 UTF-16(小端序)。 - UTF-32:每个码点固定 4 字节,索引简单但空间浪费严重(英文文本膨胀 4 倍)。
2.5 编码单元(Code Unit):宽窄的本质
编码单元是一次读写的最小单位。UTF-8 的编码单元是 1 字节,UTF-16 是 2 字节(16 位),UTF-32 是 4 字节(32 位)。一个字符可能由多个编码单元组成:
| 字符 | UTF-8 编码单元数 | UTF-16 编码单元数 |
|---|---|---|
A | 1 | 1 |
中 | 3 | 1 |
😀 | 4 | 2(代理对) |
现在可以说出本文最核心的一句话了:
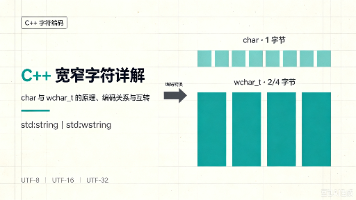
"宽字符"和"窄字符"的区别,本质是编码单元宽度的区别,而不是"能不能存中文"的区别。
wchar_t 之所以叫"宽",是因为它的编码单元比 char 宽(16 或 32 位);char 之所以叫"窄",是因为它的编码单元只有 8 位。两者都能存中文,但存储形式和语义完全不同。
三、C++ 的字符类型家族
C++ 的字符类型从 C++98 到 C++20 经历了三次扩展,理解这个演进脉络,就理解了宽窄字符的全部历史。
3.1 char:一字节的"字节"类型
char c = 'A';        // OK,ASCII 没问题
char c2 = '中';      // 危险:'中' 需要多个字节,char 装不下(多数编译器直接报错/截断)
char 的语义在标准里非常"暧昧":它既是"字符",又是"字节"。sizeof(char) == 1 恒定,但 1 个 char 不保证能表示一个字符。一个 std::string 存中文时,size() 返回的是字节数,不是字符数:
#include <iostream>
#include <string>

int main() {
    const std::string s = "中";        // 假设源码和执行字符集都是 UTF-8
    std::cout << "字节数: " << s.size() << '\n';      // 输出 3,而不是 1
    for (unsigned char c : s) {                       // e4 b8 ad
        std::cout << std::hex << static_cast<int>(c) << ' ';
    }
    std::cout << '\n';
}
3.2 wchar_t:宽度由平台决定的"宽字符"
wchar_t 是 C++98 就有的宽字符类型,但它的大小和编码都是实现定义的——这是它最大的问题:
| 平台 | sizeof(wchar_t) | 实际编码 |
|---|---|---|
| Windows(MSVC) | 2 字节 | UTF-16(小端) |
| Linux / macOS(GCC/Clang) | 4 字节 | UTF-32 |
#include <iostream>

int main() {
    // Windows 输出 2,Linux/macOS 输出 4
    std::cout << "sizeof(wchar_t) = " << sizeof(wchar_t) << '\n';
}
这意味着:用 std::wstring 写的代码,在 Windows 上是 UTF-16 语义,在 Linux 上却是 UTF-32 语义。同一个 L"中",在 Windows 里占 1 个编码单元(2 字节),在 Linux 里占 1 个编码单元(4 字节),而一个 emoji 在 Windows 里占 2 个编码单元、在 Linux 里占 1 个。跨平台代码一旦涉及宽字符,行为立刻分叉——这就是 wchar_t 被称为"不可移植陷阱"的原因。
3.3 char16_t 与 char32_t(C++11):把编码写进类型
C++11 意识到 wchar_t 的混乱,引入了两个编码固定的类型:
char16_t a = u'中';    // 固定 16 位,UTF-16 编码单元
char32_t b = U'中';    // 固定 32 位,UTF-32 编码单元(一个码点)
char16_t 和 char32_t 与平台无关:无论在 Windows 还是 Linux,sizeof(char16_t) == 2、sizeof(char32_t) == 4 恒成立。可惜它们只在 C++11 之后可用,且 API 生态(尤其是 Windows)并不买账。
3.4 char8_t(C++20):为 UTF-8 正名
C++20 之前,u8"..." 字面量的类型是 const char[],和普通窄字符串无法区分——这带来两个问题:
- 重载歧义:
void f(const char*); void f(const wchar_t*);调用f(u8"x")会走窄字符串重载,但调用者本意是"UTF-8 数据",语义被稀释。 - 类型不安全:UTF-8 字符串可以被静默地和 GBK 窄字符串拼接,编码混用而编译器毫无察觉。
C++20 引入 char8_t(P0482 提案)彻底解决:
char8_t c = u8'中';          // C++20:类型为 char8_t
std::u8string s = u8"中文";  // C++20:std::basic_string<char8_t>
char8_t 仍然是 1 字节,但类型上明确表达"这是 UTF-8 编码单元",与普通 char 不再能隐式互转,从编译期就拦截编码混用。GCC 10+、Clang 7+、MSVC 2019 16.10+ 在 C++20 模式下均支持。
3.5 字符类型汇总表
| 类型 | sizeof(常见平台) | 编码 | 引入版本 | 对应字符串类型 | 备注 |
|---|---|---|---|---|---|
char | 1 | 实现定义(执行字符集) | C++98 | std::string | 本质是"字节",不保证是字符 |
wchar_t | Windows: 2 / Linux: 4 | 平台相关 | C++98 | std::wstring | 可移植性最差 |
char16_t | 2 | UTF-16 | C++11 | std::u16string | 编码固定 |
char32_t | 4 | UTF-32 | C++11 | std::u32string | 每个码点一个单元 |
char8_t | 1 | UTF-8 编码单元 | C++20 | std::u8string | 类型上明确"这是 UTF-8" |
四、字符串字面量与"执行字符集"
4.1 字面量前缀对照表
const char*     s1 = "中文";        // 编码 = 执行字符集(不确定!)
const wchar_t*  s2 = L"中文";       // 编码 = 宽执行字符集(平台相关)
const char16_t* s3 = u"中文";       // UTF-16,固定
const char32_t* s4 = U"中文";       // UTF-32,固定
const char8_t*  s5 = u8"中文";      // C++20 起类型为 const char8_t*,UTF-8 固定
| 前缀 | 字面量类型(C++20 起) | 编码 |
|---|---|---|
"..." | const char[] | 执行字符集(实现定义) |
L"..." | const wchar_t[] | 宽执行字符集(平台相关) |
u8"..." | const char8_t[] | UTF-8 |
u"..." | const char16_t[] | UTF-16 |
U"..." | const char32_t[] | UTF-32 |
注意:u8、u、U 前缀的编码是标准强制固定的,不受平台和编译器选项影响;而裸 "..." 和 L"..." 的编码是实现定义的——这正是乱码的温床。
4.2 源字符集与执行字符集:乱码的第一来源
C++ 标准区分两个概念:
- 源字符集(Source Charset):
.cpp源文件本身的编码(你保存文件时选的编码)。 - 执行字符集(Execution Charset):字符串字面量在运行时内存中的编码(编译后存进二进制里的字节)。
一个 "中" 字面量要正确,必须经过:源文件编码 →(编译器转换)→ 执行字符集。任何一步不匹配,字节就错了:
源文件(UTF-8) ──编译器──► 执行字符集(UTF-8) ──运行时──► 终端(UTF-8)   ✅ 正常
源文件(GBK)   ──编译器──► 执行字符集(UTF-8) ──运行时──► 终端(UTF-8)   ❌ 乱码
源文件(UTF-8) ──编译器──► 执行字符集(GBK)  ──运行时──► 终端(GBK)     ❌ 乱码
编译器相关选项:
# GCC/Clang
g++ -finput-charset=UTF-8 -fexec-charset=UTF-8 main.cpp   # 默认多为 UTF-8
# MSVC(VS2015 15.3 起)
cl /utf-8 main.cpp        # 等价于 /source-charset:utf-8 /execution-charset:utf-8
这里有一个高频坑:MSVC 默认使用系统本地代码页(中文 Windows 为 GBK/936)作为源和执行字符集。如果你的源码保存为无 BOM 的 UTF-8,又没加 /utf-8,编译器会把 UTF-8 字节当作 GBK 处理,中文立即乱码。Windows 上用 MSVC 编译含中文的源码,务必加 /utf-8 或让文件带 BOM。
五、宽窄字符的转换:原理与实现
5.1 关系本质
宽窄字符串的转换,本质是编码转换:把"字节序列 + 编码 A"翻译成"编码单元序列 + 编码 B"。转换前必须知道两侧编码,否则就是瞎猜。
5.2 C 库函数 mbstowcs / wcstombs(依赖 locale)
C 标准库提供 mbstowcs / wcstombs,但它们依赖进程 locale,不指定具体编码,可移植性很差:
#include <clocale>
#include <cstdlib>
#include <iostream>
#include <string>

int main() {
    setlocale(LC_ALL, "");            // 切换到系统 locale(Linux 下通常是 UTF-8)
    const char* narrow = "中文";
    std::wstring wide(64, L'\0');
    const std::size_t n = mbstowcs(&wide[0], narrow, wide.size());
    if (n == static_cast<std::size_t>(-1)) {
        std::cerr << "转换失败:当前 locale 无法解码该字节序列\n";
        return 1;
    }
    wide.resize(n);
    std::wcout << wide << L'\n';
}
致命缺点:转换结果取决于 setlocale 设置的 locale。Linux 终端是 UTF-8 locale 就按 UTF-8 转,Windows 控制台是 GBK 代码页就按 GBK 转——同样的代码,两边转出的字节不同,程序一跨平台就行为漂移。
5.3 std::wstring_convert:方便,但已被弃用
C++11 提供了 std::wstring_convert 配合 std::codecvt_utf8 等 facet:
#include <locale>
#include <string>

std::wstring_convert<std::codecvt_utf8<wchar_t>> conv;
std::string  utf8 = conv.to_bytes(L"中文");    // 宽 -> UTF-8
std::wstring wide = conv.from_bytes(utf8);     // UTF-8 -> 宽
问题在于:它的错误处理依赖 std::range_error 异常,设计糟糕;且与 locale 纠缠不清。C++17 起标准委员会已将其标记为弃用(deprecated),并明确不推荐新代码使用。社区普遍认为:与其用这个半吊子 API,不如自己写转换或使用第三方库。
5.4 Windows 平台:MultiByteToWideChar / WideCharToMultiByte
Windows 上 wchar_t 就是 UTF-16,Win32 API 提供了高效且不依赖 locale 的转换函数:
#include <windows.h>
#include <string>

// UTF-8 窄字符串 -> UTF-16 宽字符串
std::wstring Utf8ToWide(const std::string& utf8) {
    if (utf8.empty()) return {};
    const int len = MultiByteToWideChar(CP_UTF8, 0,
        utf8.data(), static_cast<int>(utf8.size()), nullptr, 0);
    std::wstring w(len, L'\0');
    MultiByteToWideChar(CP_UTF8, 0,
        utf8.data(), static_cast<int>(utf8.size()), w.data(), len);
    return w;
}

// UTF-16 宽字符串 -> UTF-8 窄字符串
std::string WideToUtf8(const std::wstring& w) {
    if (w.empty()) return {};
    const int len = WideCharToMultiByte(CP_UTF8, 0,
        w.data(), static_cast<int>(w.size()), nullptr, 0, nullptr, nullptr);
    std::string s(len, '\0');
    WideCharToMultiByte(CP_UTF8, 0,
        w.data(), static_cast<int>(w.size()), s.data(), len, nullptr, nullptr);
    return s;
}
注意:CP_UTF8 是写死的,转换结果与系统 locale 无关,这才是跨平台程序在 Windows 侧该用的姿势。
5.5 手写 UTF-8 ↔ UTF-16 转换(理解原理的关键)
不依赖任何平台 API,理解编解码算法后,可以自己写出正确的转换。这段代码同时展示了 UTF-8 变长解码和 UTF-16 代理对机制,是理解宽窄字符最好的教材:
#include <cstdint>
#include <stdexcept>
#include <string>
#include <vector>

// ---- UTF-8 解码:从位置 i 解出一个码点,i 前进到该码点末尾 ----
std::int32_t decode_utf8(const std::string& s, std::size_t& i) {
    const auto b0 = static_cast<unsigned char>(s[i]);
    if (b0 < 0x80) { i += 1; return b0; }              // 1 字节:ASCII

    std::uint32_t cp = 0;
    int trailing = 0;                                  // 续字节个数
    if      ((b0 & 0xE0) == 0xC0) { cp = b0 & 0x1F; trailing = 1; }
    else if ((b0 & 0xF0) == 0xE0) { cp = b0 & 0x0F; trailing = 2; }
    else if ((b0 & 0xF8) == 0xF0) { cp = b0 & 0x07; trailing = 3; }
    else return -1;                                    // 非法首字节

    if (i + trailing >= s.size()) return -1;           // 越界
    for (int k = 1; k <= trailing; ++k) {
        const auto b = static_cast<unsigned char>(s[i + k]);
        if ((b & 0xC0) != 0x80) return -1;             // 续字节必须以 10 开头
        cp = (cp << 6) | (b & 0x3F);
    }
    // 拒绝过长编码与代理区(UTF-8 规范禁止编码代理对)
    if ((trailing == 1 && cp < 0x80) ||
        (trailing == 2 && cp < 0x800) ||
        (trailing == 3 && cp < 0x10000) ||
        (cp >= 0xD800 && cp <= 0xDFFF) || cp > 0x10FFFF) {
        return -1;
    }
    i += trailing + 1;
    return static_cast<std::int32_t>(cp);
}

// ---- 码点 -> UTF-16:超出 BMP 时生成代理对 ----
void append_utf16(std::uint32_t cp, std::vector<std::uint16_t>& out) {
    if (cp < 0x10000) {
        out.push_back(static_cast<std::uint16_t>(cp));
    } else {
        cp -= 0x10000;
        out.push_back(static_cast<std::uint16_t>(0xD800 | (cp >> 10)));   // 高代理
        out.push_back(static_cast<std::uint16_t>(0xDC00 | (cp & 0x3FF))); // 低代理
    }
}

// ---- UTF-8 -> UTF-16 ----
std::vector<std::uint16_t> utf8_to_utf16(const std::string& s) {
    std::vector<std::uint16_t> out;
    std::size_t i = 0;
    while (i < s.size()) {
        const auto cp = decode_utf8(s, i);
        if (cp < 0) throw std::runtime_error("非法 UTF-8 序列");
        append_utf16(static_cast<std::uint32_t>(cp), out);
    }
    return out;
}

// ---- UTF-16 解码:处理代理对 ----
std::int32_t decode_utf16(const std::vector<std::uint16_t>& s, std::size_t& i) {
    const auto u = s[i];
    if (u >= 0xD800 && u <= 0xDBFF) {                  // 高代理,必须跟低代理
        if (i + 1 >= s.size()) return -1;
        const auto lo = s[i + 1];
        if (lo < 0xDC00 || lo > 0xDFFF) return -1;
        i += 2;
        return 0x10000 + ((u - 0xD800) << 10) + (lo - 0xDC00);
    }
    if (u >= 0xDC00 && u <= 0xDFFF) return -1;         // 孤立低代理
    i += 1;
    return static_cast<std::int32_t>(u);
}
关键点总结:
- UTF-8 通过首字节的前缀位(
0、110、1110、11110)判断字符占用 1~4 字节; - UTF-16 通过
0xD800~0xDBFF(高代理)和0xDC00~0xDFFF(低代理)拼接出 BMP 之外的码点; - 代理区(
U+D800~U+DFFF)在 UTF-8 中禁止使用——所以"UTF-8 里出现ED A0 BD之类字节"一定是编码错乱或数据被错误转换过。
5.6 生产环境选型
- ICU(
icu::UnicodeString):功能最全,Unicode 事实标准库; - iconv:POSIX 系统的通用编码转换接口;
- Boost.Locale / boost::nowide:前者封装 ICU,后者专治"Windows 下用 UTF-8 调窄字符 API"的痛;
- 平台 API:Windows 用
MultiByteToWideChar,Linux 直接处理 UTF-8 字节(多数场景根本不用转)。
六、平台差异与经典陷阱
6.1 Windows:系统语言是 UTF-16
Windows 内核与 Win32 API 的 Unicode 接口(CreateFileW、MessageBoxW、std::filesystem::path 内部表示)全部使用 UTF-16。因此 Windows 原生开发中,std::wstring 是"系统语言",std::string 反而是"外来户"。老式 A 结尾 API(CreateFileA)在中文系统上默认按 GBK 解释窄字符串,是乱码高发区。
6.2 Linux:UTF-8 是事实标准
Linux 的文件系统、终端、绝大多数库默认 UTF-8。在这里 std::string(UTF-8 字节)就是通用语言,wchar_t(4 字节 UTF-32)反而笨重且生态稀疏。很多 Linux 老手多年不用 wchar_t,也是这个原因。
6.3 经典陷阱逐个看
陷阱 1:strlen / size() 数的是字节
std::string s = "中文";          // UTF-8
std::cout << s.size();           // 6,不是 2
std::cout << s[0];               // 0xE4,一个"半截字符",直接输出是乱码
对 UTF-8 字符串按下标遍历、substr 截断,都可能把多字节字符拦腰截断,产生"�"。
陷阱 2:UTF-16 的"字符数"也不可靠
emoji 😀(U+1F600)在 UTF-16 中是 2 个编码单元(代理对)。std::wstring(L"😀").size() 返回 2,wcslen 同理。而且用户感知的"字符"(字素簇,如 👍🏻 肤色变体、组合音标)往往由多个码点组成——所以"数字符个数"这件事,永远比想象中复杂。
陷阱 3:GBK 字节被当 UTF-8 解码
网络、文件、数据库三方编码不一致时,最常见的乱码就是"把 GBK 字节当 UTF-8 读"。这类乱码的特征是出现大量 � 或"锟斤拷"(GBK 的 EF BF BD 反复解码的产物)。
陷阱 4:控制台编码与程序编码不一致
#include <iostream>
int main() {
    std::cout << "中文\n";   // Linux 终端 OK;Windows 老控制台默认 GBK,若程序输出 UTF-8 则乱码
}
Windows 解决手段:chcp 65001 切换控制台到 UTF-8;或程序启动时 SetConsoleOutputCP(CP_UTF8);新系统可在清单中声明 activeCodePage="UTF-8"。
陷阱 5:wchar_t 宽度移植
把 L"中文" 的 sizeof(wchar_t) 当 2 写死(Windows 习惯)的代码,到 Linux 上会出错。跨平台代码应避免直接处理 wchar_t,或统一用 char16_t/char32_t 这类尺寸确定的类型。
七、现代 C++ 的最佳实践(2026 视角)
7.1 原则一:UTF-8 Everywhere
社区经过多年踩坑,形成了共识:程序内部与数据交换层统一使用 UTF-8(std::string / C++20 的 std::u8string),只在系统边界(Windows API、文件系统)处转换成目标编码。理由:
- UTF-8 兼容 ASCII,对英文零开销,无字节序问题;
- 是文件、网络、数据库、终端的通用语言,几乎无需再转;
char8_t(C++20)从类型上防止与普通窄字符串混用。
7.2 原则二:利用 C++20/23 的新工具
- C++20
char8_t/std::u8string:编码意图进入类型系统,编译期拦截混用; - C++20
std::u8string_view等 view 类型:零拷贝读取 UTF-8 数据; - C++23
std::text_encoding(P1885 提案):首次把"当前字面量/环境的编码"标准化,可以查询std::text_encoding::literal()拿到执行字符集信息,为运行时编码判断提供标准依据。注意它只负责"识别/查询"编码,不做转换,具体支持程度随编译器版本而异,使用前请确认工具链。
7.3 一个完整的跨平台姿势
// 内部统一 UTF-8(std::string);Windows 边界处转 wchar_t
#ifdef _WIN32
std::wstring to_native(const std::string& utf8) { return Utf8ToWide(utf8); }   // 见 5.4
#else
const std::string& to_native(const std::string& utf8) { return utf8; }         // Linux 直接透传
#endif
同时遵循三条纪律:
- 源码统一保存为 UTF-8(Windows 侧加
/utf-8编译选项); - 内存中统一
std::string存 UTF-8,禁止混用wstring; - 只在调用系统 API 的那一行做转换,转换函数集中封装、便于审计。
八、总结:一张决策表
| 场景 | 推荐类型 | 原因 |
|---|---|---|
| 跨平台文件、网络、序列化、日志 | std::string / std::u8string(UTF-8) | 通用语言,兼容性好 |
| Windows 原生 API(Win32/WinRT) | 边界处转 std::wstring(UTF-16) | 系统内部就是 UTF-16 |
| 需要按码点随机访问 | std::u32string | 每个码点固定一个单元 |
| 仅存英文/ASCII | std::string | 最省空间 |
| 与 ICU 等库交互 | 按其要求的类型转换 | 遵循宿主库约定 |
一句话版本:char 是字节,wchar_t 是"宽度随平台漂移"的宽字符,char16_t/char32_t 是编码固定的宽字符,char8_t 是"明确说自己是 UTF-8 的字节";宽窄的本质是编码单元宽度,乱码的根源是编码不匹配;现代 C++ 的最佳实践是内部统一 UTF-8、边界才转换。
如果你在实际开发中遇到过更离奇的乱码,或者对某个编码细节有疑问,欢迎在评论区讨论。
参考资料
- cppreference:Fundamental types(char / wchar_t / char16_t / char32_t 的尺寸与编码说明):https://en.cppreference.com/w/cpp/language/types
- cppreference:String literals(字面量前缀与编码规则):https://en.cppreference.com/w/cpp/language/string_literal
- cppreference:std::wstring_convert(C++17 弃用说明):https://en.cppreference.com/w/cpp/locale/wstring_convert
- cppreference:std::text_encoding(C++23):https://en.cppreference.com/w/cpp/text/text_encoding
- Microsoft Learn:/utf-8(源字符集与执行字符集选项):https://learn.microsoft.com/en-us/cpp/build/reference/utf-8-set-source-and-executable-character-sets-to-utf-8
- GCC 文档:-finput-charset / -fexec-charset:https://gcc.gnu.org/onlinedocs/gcc/Code-Gen-Options.html
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/afghjhg/article/details/166133561

