

Python后端AI专题23:Rerank 重排:为什么召回第一名不一定最会回答
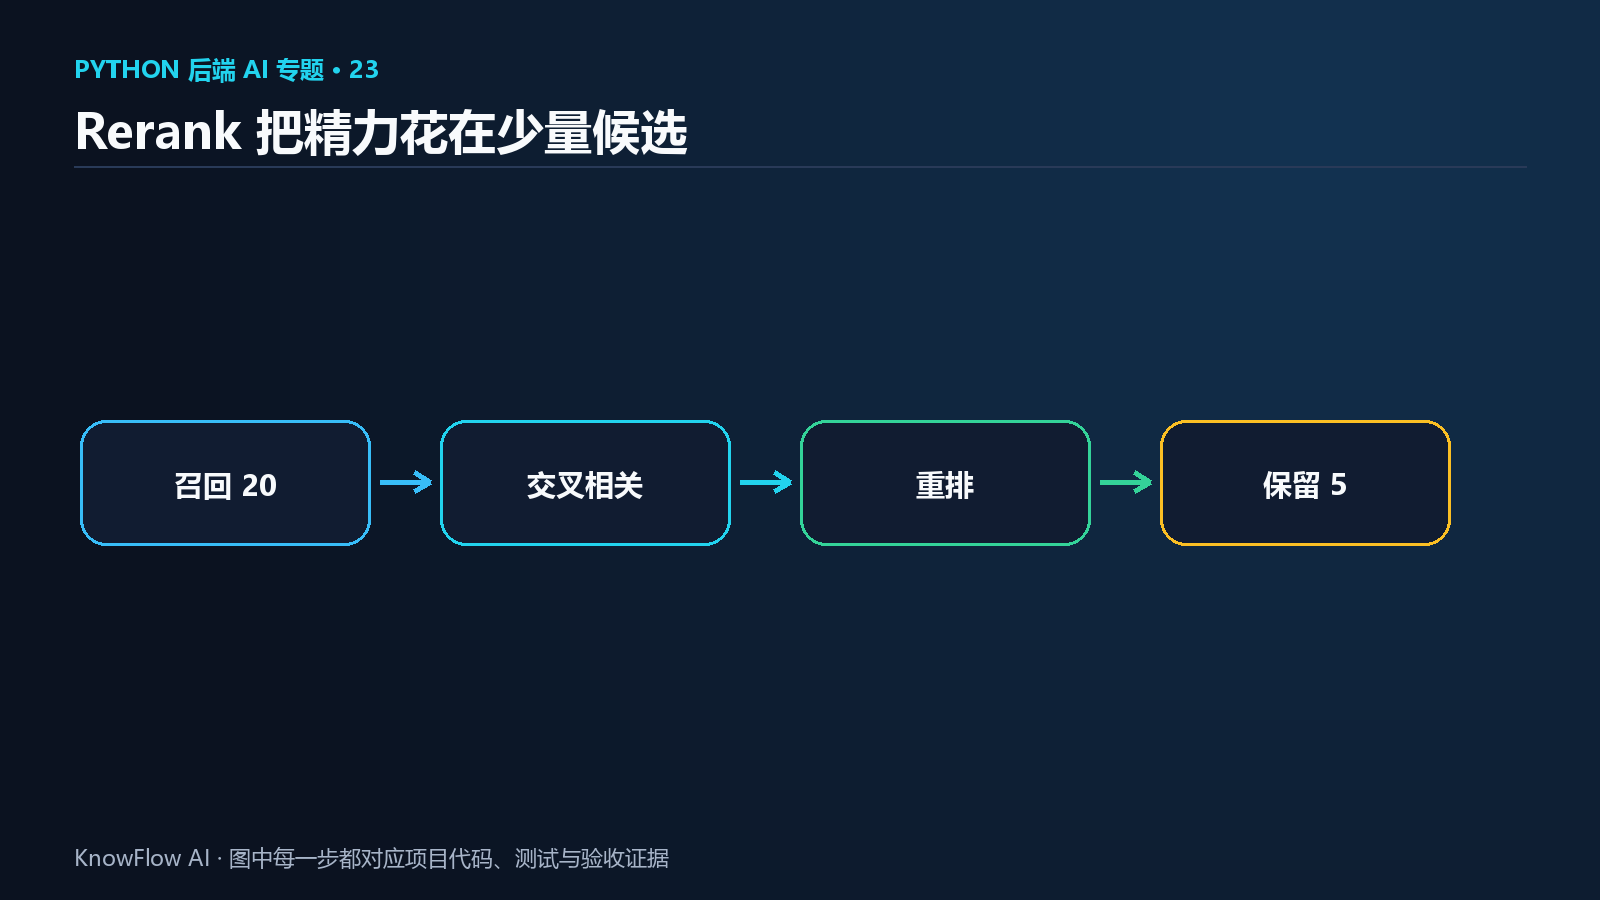
向量召回用单个向量近似整段语义,关键词召回看精确词,RRF 再根据名次投票;它们适合快速找候选,却没有逐对阅读“问题 + 文档”。Rerank 的职责是在较小候选集上做更精细的相关性判断,而不是替代第一阶段检索全库。
RRF 手算与测试答案
k=60:
A = 1/61 + 1/63 = 0.03227
B = 1/62 + 1/61 = 0.03252
C = 1/63        = 0.01587
D = 1/62        = 0.01613
顺序为 B、A、D、C。B 在两路都靠前,所以超过向量第一的 A。
完整测试还验证输入没有被修改:
def test_rrf_hand_calculation_preserves_input_scores() -> None:
    vector = [
        RetrievedChunk("A", "A", 0.91),
        RetrievedChunk("B", "B", 0.82),
        RetrievedChunk("C", "C", 0.73),
    ]
    keyword = [
        RetrievedChunk("B", "B", 9.0),
        RetrievedChunk("D", "D", 7.0),
        RetrievedChunk("A", "A", 5.0),
    ]
    result = reciprocal_rank_fusion(vector, keyword, k=60)

    assert [item.id for item in result] == ["B", "A", "D", "C"]
    by_id = {item.id: item for item in result}
    assert by_id["A"].diagnostics["vector_rank"] == 1
    assert by_id["A"].diagnostics["keyword_rank"] == 3
    assert "keyword_rank" not in by_id["C"].diagnostics
    assert [item.score for item in vector] == [0.91, 0.82, 0.73]
真实结果:4 passed in 0.09s。
为什么是两阶段漏斗
假设有一百万 chunk。Cross-encoder/Rerank 若对每个候选都联合编码问题与正文,计算量远大于向量点积。常见漏斗:
100 万 → 向量 Top 30 + 关键词 Top 30
      → RRF 去重约 40 条
      → Rerank Top 5
      → 上下文预算再裁剪
召回阶段追求别漏掉,重排阶段追求前几名准确。候选太少,Rerank 无法救回没被召回的答案;候选太多,延迟和费用上升。
Fake Rerank 如何保证回归确定性
课程 Fake 使用问题与正文的字符集合重叠,并以原排名稳定打破平分:
score = len(query_terms & terms) / max(1, len(query_terms))
scored.append(RerankResult(item.id, score, rank))
scored.sort(key=lambda result: (-result.score, result.original_rank))
它不代表真实重排质量,只让管线在无网络时可重复测试。生产适配器应调用真实 reranker,并通过评测集比较;不能把 Fake 的字符分数写进项目简历说“语义重排”。
完整检索管线
from __future__ import annotations

from time import perf_counter

from app.providers.contracts import EmbeddingProvider, RerankItem, RerankProvider
from app.providers.vector_store import VectorStore
from app.services.retrieval.fusion import reciprocal_rank_fusion
from app.services.retrieval.keyword import keyword_search
from app.services.retrieval.types import RetrievalResult


class RetrievalPipeline:
    def __init__(self, *, embedder: EmbeddingProvider,
                 vector_store: VectorStore, reranker: RerankProvider) -> None:
        self.embedder = embedder
        self.vector_store = vector_store
        self.reranker = reranker

    async def retrieve(self, *, tenant_id: str, knowledge_base_id: str,
                       query: str, limit: int = 5) -> RetrievalResult:
        timings: dict[str, float] = {}
        started = perf_counter()
        vector = (await self.embedder.embed([query]))[0]
        timings["embedding"] = (perf_counter() - started) * 1000

        started = perf_counter()
        vector_results = await self.vector_store.search(
            tenant_id=tenant_id,
            knowledge_base_id=knowledge_base_id,
            vector=vector,
            limit=max(limit * 3, 10),
        )
        timings["vector"] = (perf_counter() - started) * 1000

        started = perf_counter()
        records = await self.vector_store.records_for(
            tenant_id=tenant_id, knowledge_base_id=knowledge_base_id
        )
        keyword_results = keyword_search(
            query, records, limit=max(limit * 3, 10)
        )
        timings["keyword"] = (perf_counter() - started) * 1000

        fused = reciprocal_rank_fusion(vector_results, keyword_results)
        started = perf_counter()
        try:
            reranked = await self.reranker.rerank(
                query,
                [RerankItem(item.id, item.text) for item in fused],
                top_n=limit,
            )
        except TimeoutError:
            chunks = fused[:limit]
            for chunk in chunks:
                chunk.diagnostics["rerank_degraded"] = True
            timings["rerank"] = (perf_counter() - started) * 1000
            timings["rerank_degraded"] = 1.0
            timings["total"] = sum(
                value for key, value in timings.items()
                if key != "rerank_degraded"
            )
            return RetrievalResult(chunks, timings)
        by_id = {item.id: item for item in fused}
        chunks = []
        for reranked_item in reranked:
            chunk = by_id[reranked_item.id]
            chunk.score = reranked_item.score
            chunk.diagnostics["rerank_score"] = reranked_item.score
            chunks.append(chunk)
        timings["rerank"] = (perf_counter() - started) * 1000
        timings["total"] = sum(timings.values())
        return RetrievalResult(chunks, timings)
limit=max(limit*3,10) 保证即使最终只要 2 条,也给重排至少 10 个向量/关键词候选。真实生产中两个召回大小应独立配置并在评测中寻找成本曲线。
diagnostics 不应在重排后丢失
管线用 id 找回 RRF 对象,只更新最终 score,并增加 rerank_score。因此输出还能看到 vector_rank/keyword_rank/rrf_score。当用户投诉错误答案时,可以判断是未召回、融合落后,还是重排选错。
Rerank 的输入也有安全与长度边界
外部 Rerank 服务会看到候选正文,仍需遵守租户与数据出境要求。超长 chunk 应按供应商限制截断,但截断方式要保留关键段;批量请求也应有超时、并发与降级策略。若 Rerank 暂时不可用,可降级使用 RRF 顺序,但必须在 diagnostics 标记,而不是伪造 rerank_score。
本篇最终完整模块:pipeline.py
前面的代码片段用于解释本次改动;下面是本篇结束时可直接核对和替换的磁盘完整版本。
from __future__ import annotations

from time import perf_counter

from app.providers.contracts import EmbeddingProvider, RerankItem, RerankProvider
from app.core.metrics import RETRIEVAL_STAGE_SECONDS
from app.providers.vector_store import VectorStore
from app.services.retrieval.fusion import reciprocal_rank_fusion
from app.services.retrieval.keyword import keyword_search
from app.services.retrieval.types import RetrievalResult


class RetrievalPipeline:
    def __init__(
        self,
        *,
        embedder: EmbeddingProvider,
        vector_store: VectorStore,
        reranker: RerankProvider,
    ) -> None:
        self.embedder = embedder
        self.vector_store = vector_store
        self.reranker = reranker

    async def retrieve(
        self,
        *,
        tenant_id: str,
        knowledge_base_id: str,
        query: str,
        limit: int = 5,
    ) -> RetrievalResult:
        timings: dict[str, float] = {}
        started = perf_counter()
        vector = (await self.embedder.embed([query]))[0]
        timings["embedding"] = (perf_counter() - started) * 1000
        RETRIEVAL_STAGE_SECONDS.labels(stage="embedding").observe(
            timings["embedding"] / 1000
        )

        started = perf_counter()
        vector_results = await self.vector_store.search(
            tenant_id=tenant_id,
            knowledge_base_id=knowledge_base_id,
            vector=vector,
            limit=max(limit * 3, 10),
        )
        timings["vector"] = (perf_counter() - started) * 1000
        RETRIEVAL_STAGE_SECONDS.labels(stage="vector").observe(
            timings["vector"] / 1000
        )

        started = perf_counter()
        records = await self.vector_store.records_for(
            tenant_id=tenant_id, knowledge_base_id=knowledge_base_id
        )
        keyword_results = keyword_search(query, records, limit=max(limit * 3, 10))
        timings["keyword"] = (perf_counter() - started) * 1000
        RETRIEVAL_STAGE_SECONDS.labels(stage="keyword").observe(
            timings["keyword"] / 1000
        )

        fused = reciprocal_rank_fusion(vector_results, keyword_results)
        started = perf_counter()
        try:
            reranked = await self.reranker.rerank(
                query,
                [RerankItem(item.id, item.text) for item in fused],
                top_n=limit,
            )
        except TimeoutError:
            chunks = fused[:limit]
            for chunk in chunks:
                chunk.diagnostics["rerank_degraded"] = True
            timings["rerank"] = (perf_counter() - started) * 1000
            RETRIEVAL_STAGE_SECONDS.labels(stage="rerank").observe(
                timings["rerank"] / 1000
            )
            timings["rerank_degraded"] = 1.0
            timings["total"] = sum(
                value for key, value in timings.items() if key != "rerank_degraded"
            )
            return RetrievalResult(chunks, timings)
        by_id = {item.id: item for item in fused}
        chunks = []
        for reranked_item in reranked:
            chunk = by_id[reranked_item.id]
            chunk.score = reranked_item.score
            chunk.diagnostics["rerank_score"] = reranked_item.score
            chunks.append(chunk)
        timings["rerank"] = (perf_counter() - started) * 1000
        RETRIEVAL_STAGE_SECONDS.labels(stage="rerank").observe(
            timings["rerank"] / 1000
        )
        timings["total"] = sum(timings.values())
        return RetrievalResult(chunks, timings)
本篇练习:给重排做失败降级设计
写一个 FailingRerankProvider 总是抛 TimeoutError。为管线设计两种策略并比较:A. 整个搜索返回 503;B. 返回 RRF Top N,并在每个结果 diagnostics 写 rerank_degraded=True。选择一种适合“内部知识库只读搜索”的策略,给出完整伪代码和至少两个测试:降级顺序正确、非超时的协议错误不能被静默吞掉。
下一篇会给出选择与可运行实现,然后建立引用校验和无证据拒答,让“搜到内容”不再自动等于“答案可信”。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/a1250467048/article/details/164598226

