

这篇文章不是单纯追新模型。仅仅是我个人看法,没有绝对高低,只说适合不适合。
下面仅针对我之前做的Q8权重我自己部分量化为INT8并优化加速部署包来说,没有针对原始权重:SenseNova U1.5 Lite 我确实认真搭过(有兴趣的可以翻翻我之前的文章,本地一键安装包+工作流网盘下载我还留着),也做过 Q8、LoRA、SAM、ConvRot 和 INT8 加速实验。最后把主力环境换成 Qwen-Image 2.1,原因也不是 SenseNova 完全不能用,而是我把它们放到真正的本地使用场景里比较以后,发现 Qwen 在我最在意的三件事上都更好:文字能不能写对,图像和编辑结果能不能保真,8GB 显卡上能不能少折腾地跑起来。
先把结论放在前面:
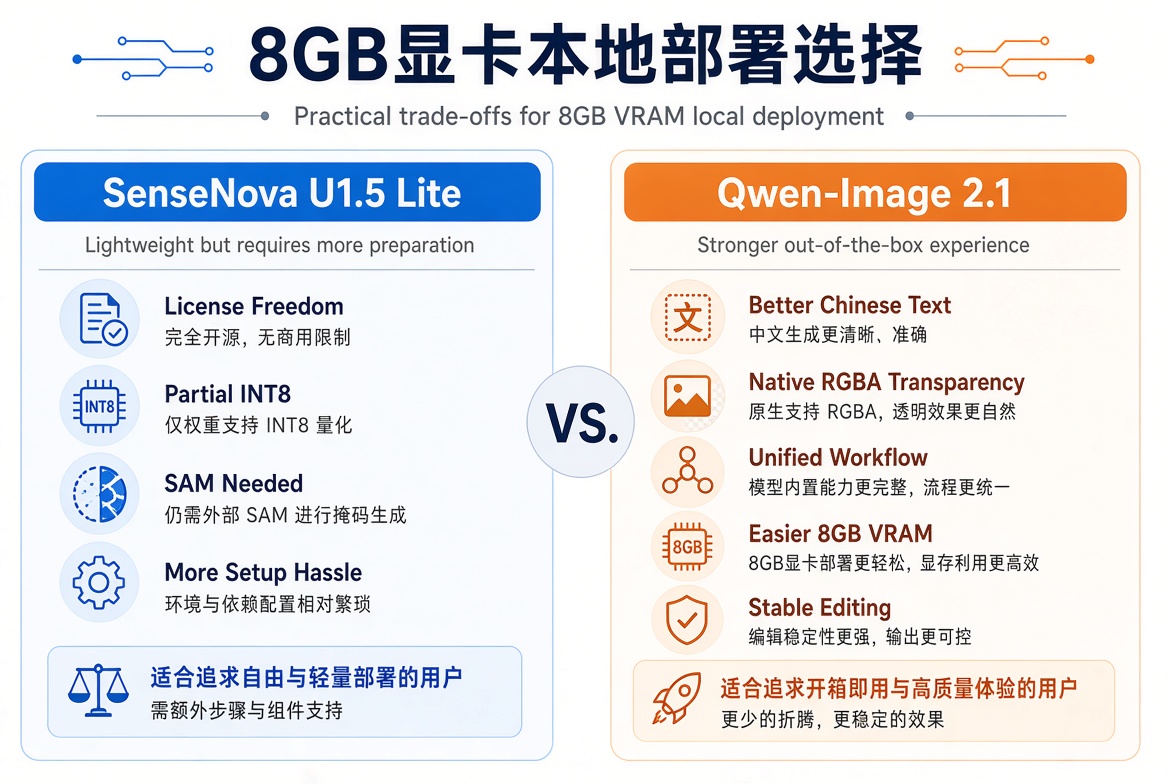
SenseNova U1.5 Lite 的许可证空间更宽松,但它目前没有一份可以直接拿来用的完整 INT8 权重。8GB NVIDIA 显卡上能跑得比较顺,靠的是我自己做的部分 INT8 权重和加速补丁。实际输出、文字、工作流完整度和我最终得到的有效速度,Qwen-Image 2.1 更适合当主力。
先说许可证
这件事我重新核对过。就我这套 SenseNova U1.5 Lite 发布代码和配套工程来说,许可证比 Qwen-Image 2.1 官方当前的限制更宽松;不过模型权重、ComfyUI 节点、加速补丁和第三方依赖不能混成一个许可证,具体还要看对应仓库的声明。
Qwen-Image 2.1 官方仓库在 2026 年 9 月 20 日发布,当前使用的是 Qwen Research License,核心授权是非商业用途,商用需要另外申请许可。
所以这次换模不是因为 Qwen 的“证书”更宽松。恰恰相反,许可证上 SenseNova 更占优势。我的选择完全是技术选择:Qwen 的工作流和开发接口更统一,社区已经有可以直接使用的 INT8/ConvRot 物料,文字和图像结果更稳定,在我的 8GB 机器上也更省心。
另外就是大家比较关心的审查问题,SenseNova U1.5 Lite也是更胜一筹,Qwen-Image 2.1 需要去找相应的权重替换(这个很容易,只替换模型权重就可以,文字解析什么的都不用换,复用我的一键安装包即可。)。
我用的机器
- NVIDIA RTX 4070 Laptop GPU,8GB 显存
- 32GB 内存
- Windows 11
- Python 3.12.10
- PyTorch 2.9.1+cu130
- CUDA 13.0
- ComfyUI 0.37.0
这台 4070 Laptop 属于 Ada 架构,显存只有 8GB。我的加速路径就是围绕这种低显存 NVIDIA 环境做的,同时尽量采用对 Blackwell 友好的 CUDA 写法。
SenseNova 的 INT8 到底是什么情况
这部分最容易被说得过头。
SenseNova U1.5 Lite 的 Q8 主模型可以正常运行,但我没有找到一份官方提供的、覆盖完整模型的 INT8 权重。后来能在 8GB 显卡上继续往下优化,靠的是我自己做的部分 INT8 权重、ConvRot W8A8 和运行时替换。
之前的 manifest 记录里,实际覆盖的是 42 层中的生成分支投影,合计 294 个 mot_gen 投影张量,包含 Q/K/V/O 和部分 MLP 投影;mot_und 没有相同程度的完整覆盖。运行时仍然要保留 Q8 GGUF 主模型,LoRA 和 SAM 也都是另外的物料。
因此更准确的说法是:
SenseNova 是 Q8 主模型,加上我做的部分 INT8 ConvRot 补丁和显存/算子加速,不是一份完整端到端 INT8 模型。
这套工作有价值,也确实解决了 8GB Ada 机器上的一部分速度和显存问题,但它的维护成本也很明显。模型、补丁、LoRA、SAM、显存模式和 CUDA 版本之间都要对得上,任何一项不对,结果就可能从“能跑”变成“启动失败”或者速度倒退。
这里再把“有没有 INT8 权重”说得直白一点:SenseNova 目前没有一份官方提供、下载后就能直接替换使用的完整 INT8 权重。我手里的 INT8 不是现成物料,而是基于 Q8 主模型自己做的局部量化和 ConvRot 加速,目标就是让 8GB 的 NVIDIA Ada 尽量跑起来,同时让这套算子路径对 Blackwell 也更友好。它可以解决实际问题,但不能包装成“SenseNova 已经有完整 INT8 版本”。
Qwen 这边也要区分清楚:我最后采用的是社区整理的 Qwen-Image 2.1 INT8 ConvRot 权重,不把它说成 Qwen 官方统一发布的完整 INT8 包。区别在于,Qwen 已经有相对统一的模型接口、官方工作流和社区可直接使用的量化物料;SenseNova 则需要用户自己把 Q8、局部 INT8、补丁、manifest 和运行参数拼起来。
对小显卡用户,差别不只是“能不能启动”
8GB 显存真正难受的地方,不是某一次能不能把程序打开,而是每换一个任务都要重新算显存峰值:主模型要不要常驻,SAM 要不要同时加载,LoRA 和补丁会不会抢显存,编辑流程又要不要额外保留参考图和蒙版。
SenseNova 的方案可以跑,但我需要自己维护 Q8 主模型、部分 INT8 权重、ConvRot、TeaCache、SAM 和不同的驻留模式。少一个文件、版本没对上,或者参数选错,结果就是爆显存、速度倒退,甚至工作流直接起不来。对 8GB 卡来说,这种额外的组合成本比单纯的模型大小更麻烦。
Qwen 的实际体验更适合小显卡:同一套模型和节点可以覆盖文生图、单图编辑、多图参考、换装和去背景,常用工作流不需要再单独挂一套 SAM;量化物料、显存策略和 ComfyUI 工作流也更容易一起整理。我的 4070 Laptop 只有 8GB,Qwen 这套环境热启动后可以连续跑 512、768 和 1024 分辨率任务,省下来的不只是显存,还有反复调试的时间。
所以我说 Qwen 对小显卡更友好,并不是说它在任何分辨率、任何参数下都不会爆显存,而是它把“能跑起来”之后最容易出问题的那部分组合工作减少了。对 8GB Ada 或类似显卡来说,这一点比宣传里的峰值速度更实际。
二次开发和再次部署,Qwen 也更省事
如果只是下载下来点一下生成,两个模型的差距还没有那么明显;一旦要做自己的前端、批量任务、API 或工作流,差距就会放大。
Qwen 的开发路径比较标准:可以从官方 Pipeline 入手,也可以接 ComfyUI 节点和工作流,文生图、图片编辑、多图参考等能力有相对清晰的输入输出。以后要加队列、批处理、WebUI 或服务接口,基本是在现有模型调用外面加一层,不必先研究一套专用 manifest,再确认 Q8 主模型、局部 INT8 补丁、SAM 和自定义节点是否互相兼容。
SenseNova 不是不能二次开发,而是开发前置成本更高。现在这套能跑的方案,很多优化来自我自己的实验:哪些层做了 INT8、ConvRot 在哪里接、哪些场景要开 TeaCache、SAM 怎么配、显存模式怎么选,都要记在运行记录里。换一台电脑、换一个 CUDA 环境,或者把工作流交给别人,排查成本都会上去。
这也是我最后选择 Qwen 的另一个原因:它不只是最终图片更好看,而是更容易被整理成一个别人能复现、自己能改、后面还能继续扩展的本地项目。对个人用户和小团队来说,这种可维护性往往比单次跑分更重要。
为什么最后换 Qwen
文字生成:差距最容易看出来
我后来开始拿模型做海报、封面、标签和产品图,文字就成了硬指标。
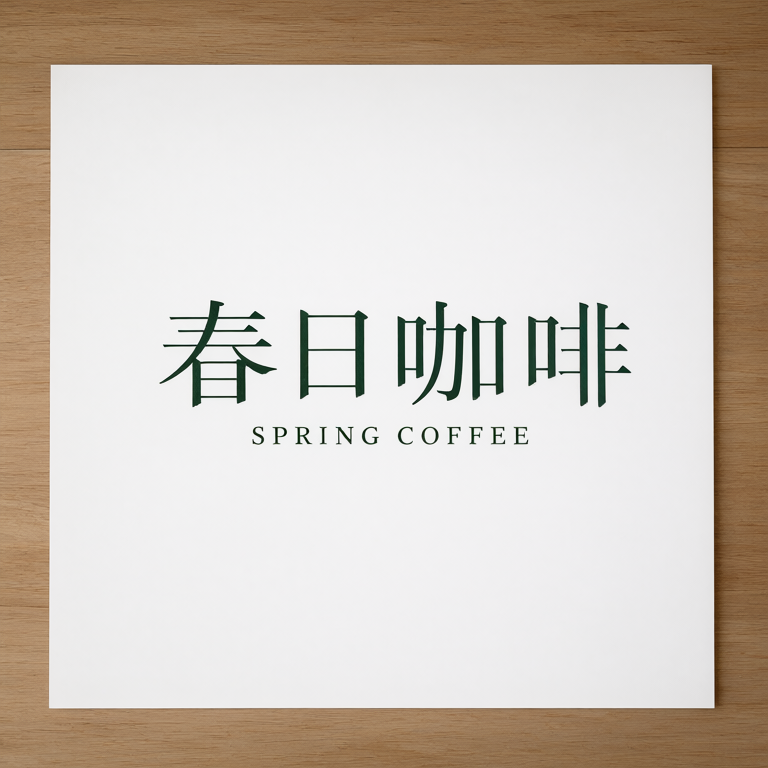
Qwen 这次做的测试很简单:在白色海报中央写“春日咖啡”,下方写 SPRING COFFEE,不要出现其他文字。最终输出里的中文和英文都能读,位置也比较自然。
SenseNova 不是完全不会生成文字,我之前也跑过图文交错流程。但实际用下来,中文短句、标题和标签更容易出现字形错误、文字漂移或者排版不稳。做纯画面时,这些问题还能接受;做需要交付的图,基本就要返工。
这也是我说 Qwen 文字更好的原因。不是它每一次都完美,而是达到“可以继续用”的概率更高。
图像保真:Qwen 的参考图编辑更稳
SenseNova 的 SAM 和蒙版编辑有一个很实在的优点:选区外可以做到非常严格的保持,之前的记录里出现过 outside_changed_pixels = 0。如果任务就是“只改这一小块,其他地方一个像素都不要动”,它仍然有价值。
但普通用户更常见的任务是:保留人物、换背景、换衣服、参考另一张图的风格,或者把几张素材合成到一起。这些任务一旦涉及参考图和文字指令,我用 SenseNova 就需要更多节点和参数,结果也更容易漂。
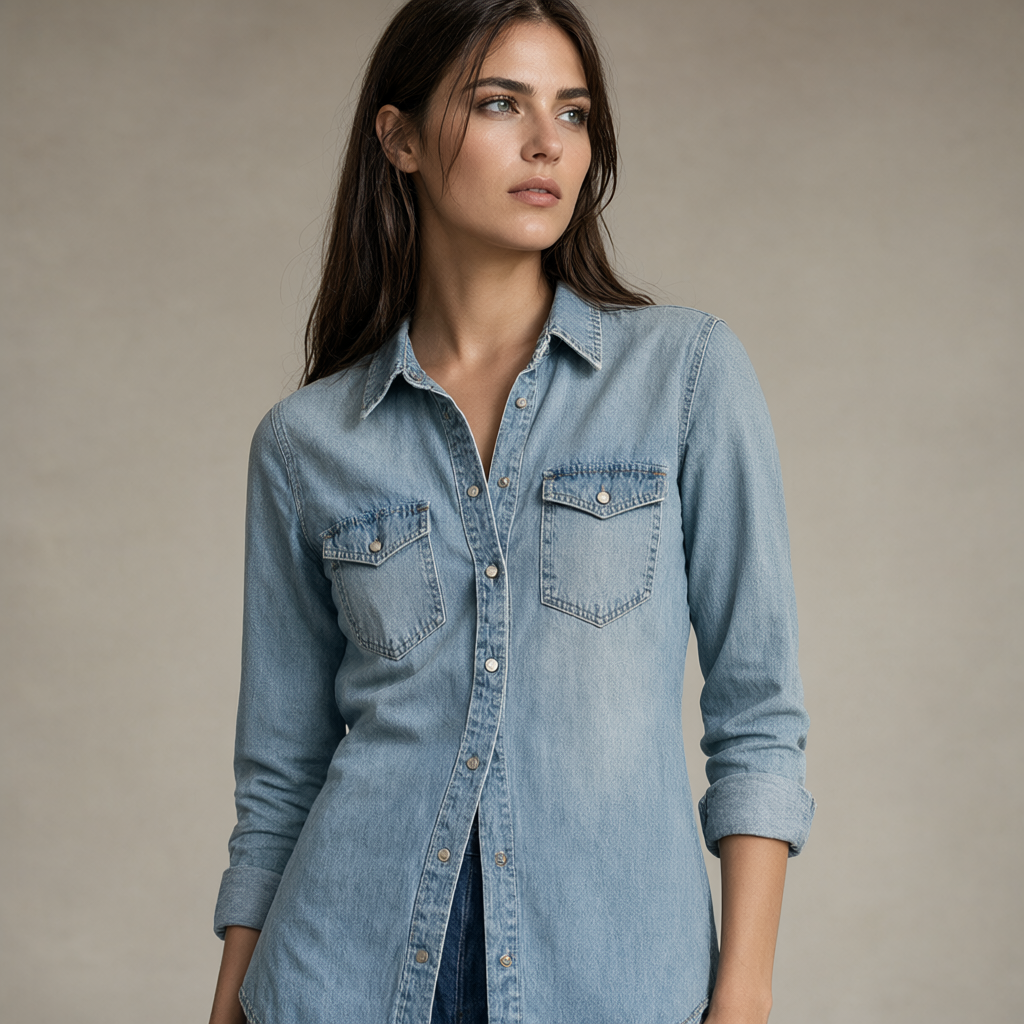
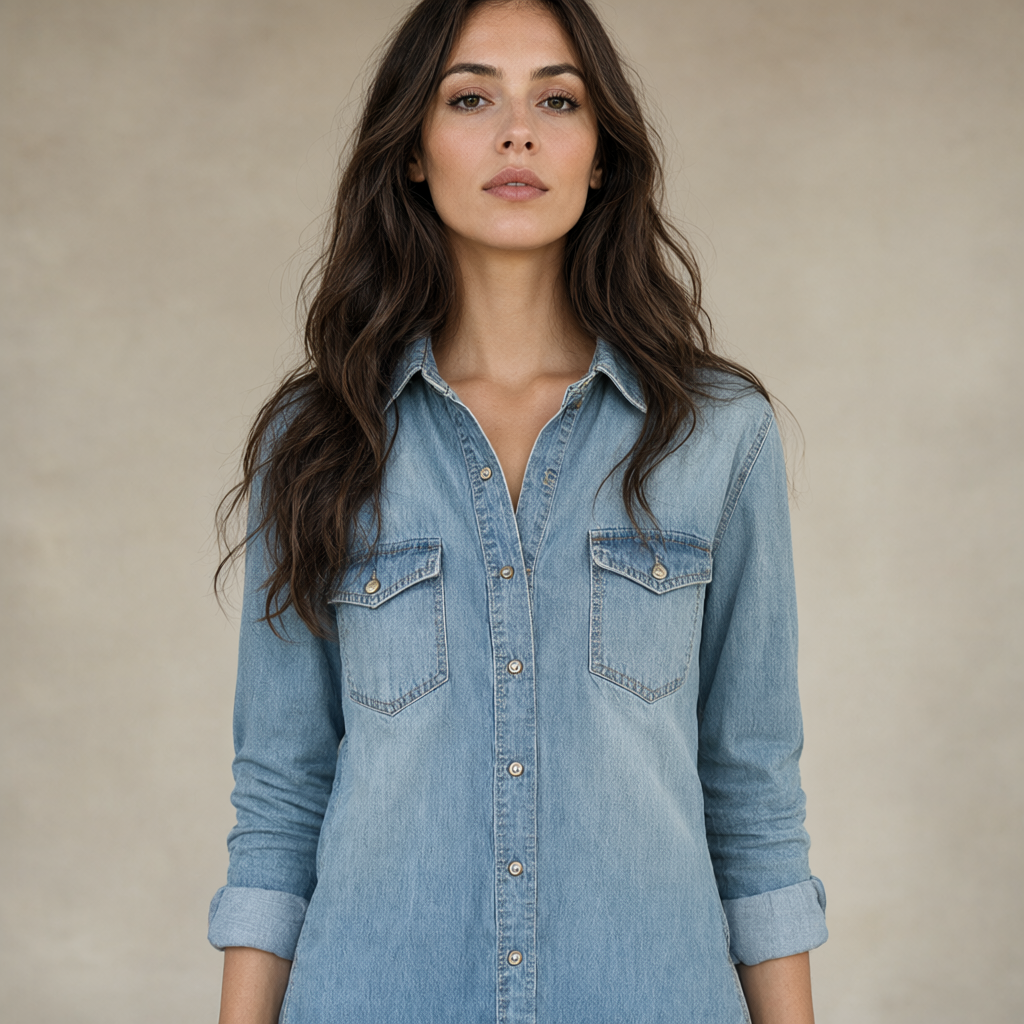
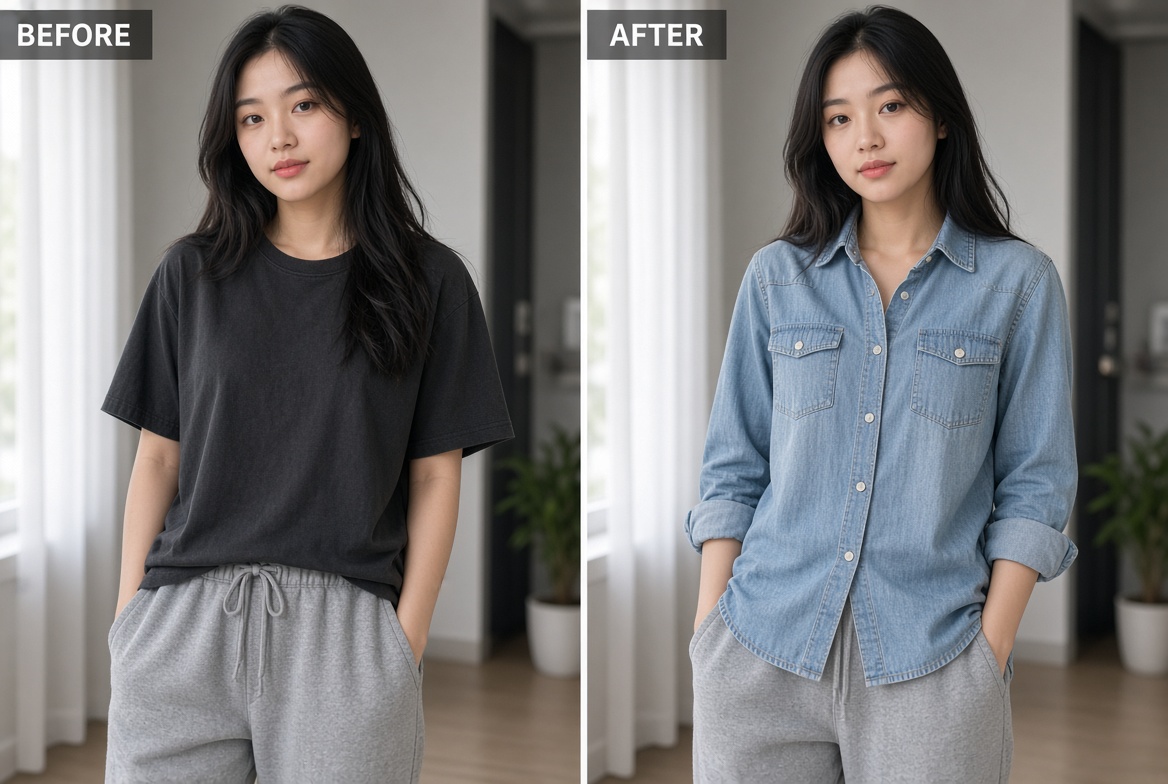
Qwen 的单图编辑、多图参考和换装都接在同一个 TextEncodeQwenImage21 链路里。这次用人物图加浅蓝牛仔衬衫图做换装,人物的脸、头发、背景和光照基本保住了,衬衫也确实换到了人物身上。对我来说,这种“少接几个节点,还能保住主体”的提升,比单项分割精度更有价值。
透明图和去背景:少一层拼装
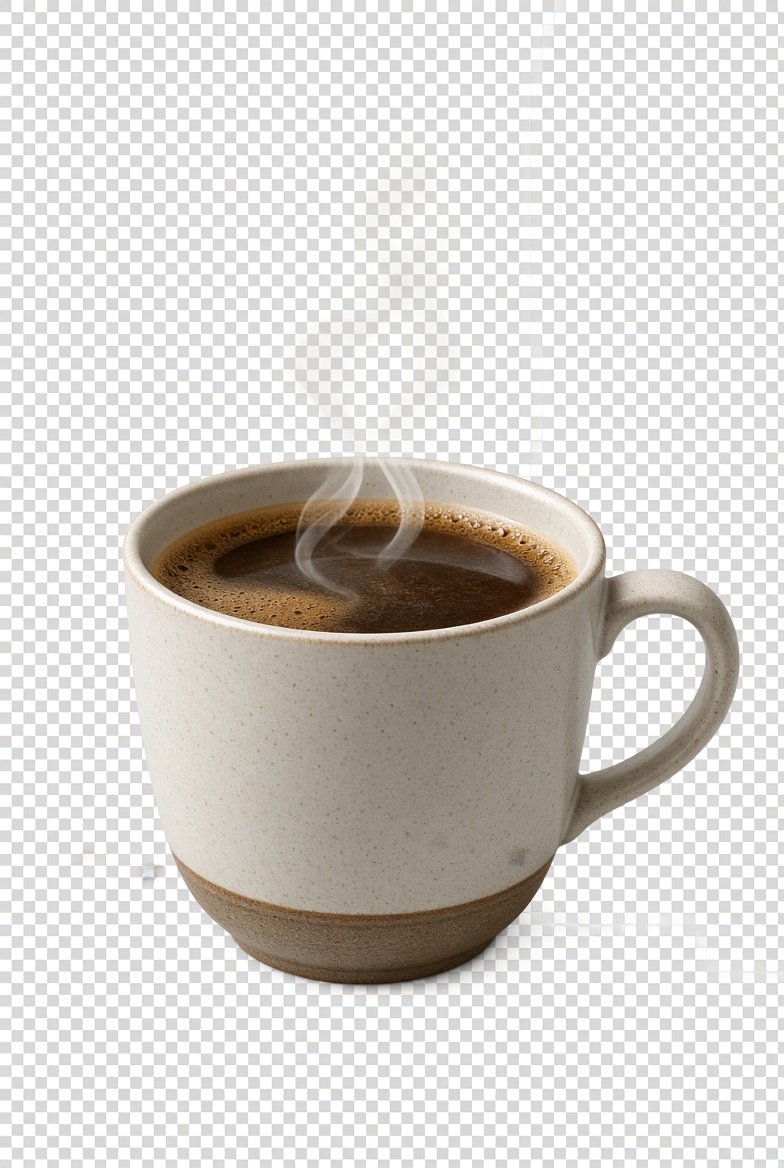
Qwen-Image 2.1 官方把透明 RGBA、主体提取和图片编辑放到了同一套模型能力里。ComfyUI 官方也从发布日就提供了对应的 Qwen-Image 2.1 工作流。
我实际输出的透明图不是把背景涂白,也不是把背景换成紫色再假装透明。PNG 是 RGBA,alpha 通道里有真实的 0 和 255;去背景任务也留下了大量透明像素。
SenseNova 通过 SAM、蒙版和后处理也能实现主体分离,但部署上要多准备一套模型和一套流程。Qwen 这边少了很多拼装工作。
速度:我比较的是“有效速度”
这里要把话说准确。SenseNova 的部分 INT8 加速在特定设置下确实可以很快,不能因为我换了模型,就把以前所有 SenseNova 的速度记录都说成慢。
我之前做过一组 2048×2048、8 步的匹配实验:
| SenseNova 路径 | 耗时 |
| Q8 基线 | 117.03 秒 |
| ConvRot W8A8 部分 INT8 | 41.82 秒 |
| ConvRot + TeaCache 一次记录 | 36.85 秒 |
这说明补丁是有效的。但它有两个限制:第一,这不是官方完整 INT8 权重;第二,速度高度依赖分辨率、显存驻留方式、CUDA、attention backend 和缓存参数。公开的社区加速项目也明确说明,它是独立社区工程,不代表 SenseNova 官方发布,fast 驻留模式仍属于实验功能。
我真正需要的是 8GB 显卡上日常使用的 512 到 1024 分辨率工作流。Qwen 热启动以后,我这边的记录是:
| Qwen 工作流 | 分辨率 | 步数 | 热启动耗时 |
| 透明图文生图 | 512×512 | 12 | 14.16 秒 |
| 中文文字海报 | 768×768 | 25 | 26.16 秒 |
| 单图编辑 | 1024×1024 | 25 | 38.20 秒 |
| 多图参考 | 512×512 | 12 | 14.12 秒 |
| 去背景 | 1024×1024 | 25 | 38.25 秒 |
| 人物换装 | 1024×1024 | 25 | 38.20 秒 |
这两张表不是严格同分辨率、同步数的实验室竞赛,不能拿来做论文式结论。但放到我的实际工作里,Qwen 的有效速度更好:它不用先准备 SAM、LoRA 和一堆补丁,512/768/1024 的常用任务可以连续跑,文字和画面还更稳定。
换句话说,SenseNova 的 INT8 补丁能把某个实验跑得很快,Qwen 则让我更快拿到一个能交付的结果。对本地用户来说,后者更重要。
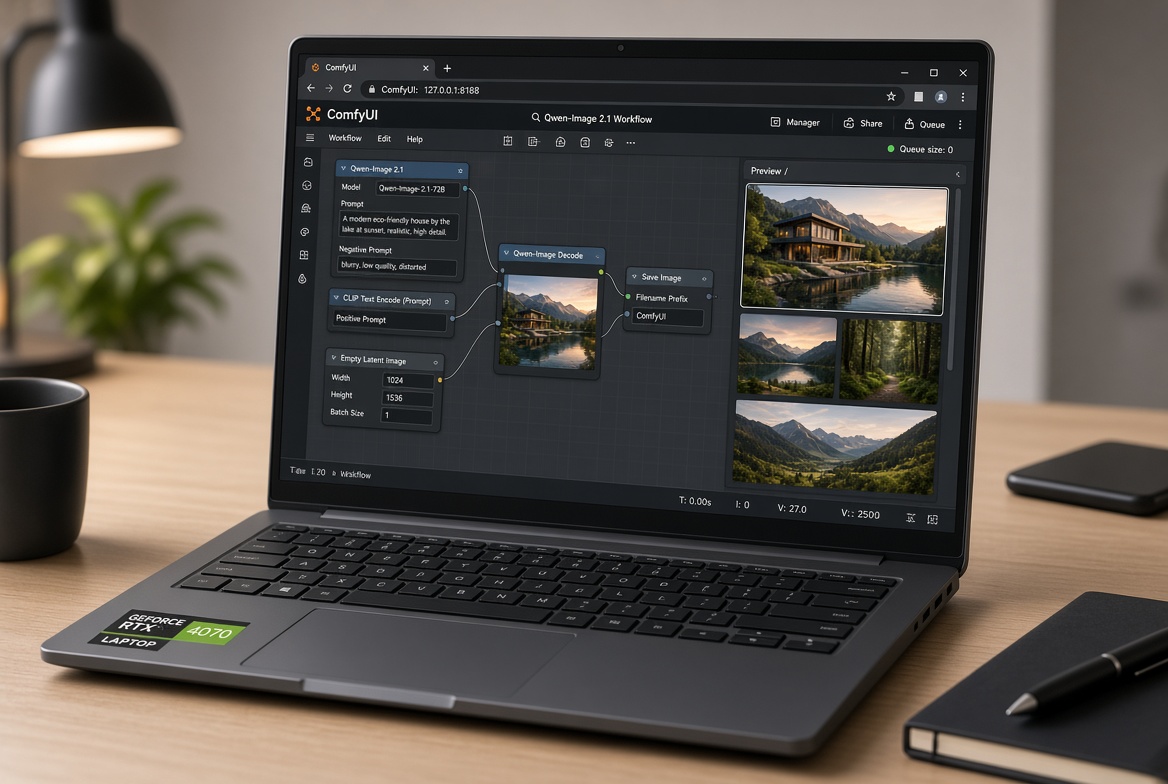
Qwen-Image 2.1 在我机器上的完整测试
旧主权重删除以后,我用新接入的 INT8 权重重新跑了六类任务:
- 透明图文生图。
- 中文文字海报。
- 单图背景编辑。
- 多图参考。
- 去背景。
- 人物换装。
六项全部成功,ComfyUI 的模型列表也只保留新权重。
Qwen 官方资料还列出了 2K 输出、最多 10 张参考图、圆圈/涂鸦/独立蒙版局部编辑,以及前缀 KV Cache 复用。我的分享包里重点接好了文生图、图片编辑和去背景三个入口,多图参考和换装走图片编辑工作流。
网盘一键包
我把调好的 Qwen-Image 2.1 本地环境放到了百度网盘,文件名是 qwenimage2.1:
分享链接: https://pan.baidu.com/s/19ROSlQirVSfbaSXOaNVQqA?pwd=tama
- 百度网盘提取码:
tama - 压缩包密码:
123 - 适用系统:Windows 10/11 64 位
- 建议内存:32GB
- 8GB 显存可以跑,12GB 及以上会轻松很多
解压后直接使用:
检查环境.bat
01_文生图.bat
02_图片编辑.bat
03_去背景.bat
停止_Qwen.bat
第一次启动要加载模型,别把冷启动时间和热启动时间混在一起。模型已经加载以后,连续改提示词会快很多;如果每生成一张就把服务关掉,缓存优势自然没有了。
想自己换无审查权重
我没有把第三方无审查权重放进分享包,也不提供来源不明的文件。想自己换的,可以去 Hugging Face 找明确标注 Qwen-Image 2.1、INT8 ConvRot、ComfyUI 兼容的权重。
替换时注意几件事:
- 看清楚仓库许可证,不要只看“uncensored”几个字。
- 核对文件大小和 SHA256。
- 先停止 ComfyUI,再替换
ComfyUI\models\diffusion_models下的扩散模型。 - 新文件名和工作流中的
unet_name不一致时,要同步修改工作流。 - 文本编码器和 VAE 尽量沿用同一套版本,不要看到 INT8 就随便混搭。
无审查权重通常是社区再发布或再训练版本,许可证、来源和版权责任由使用者自己确认。分享包只提供已经整理好的代码、环境和工作流,不把第三方权重的授权问题替大家承担。
最后总结
SenseNova U1.5 Lite 的许可证更宽松,这一点我不回避;它的局部蒙版编辑也有自己的强项。
但从本地部署的完整体验看,它的问题也很明确:没有官方完整 INT8 权重,8GB 显卡上的顺畅运行要靠我自己做部分 INT8 和加速,模型、LoRA、SAM、补丁和启动参数需要一起维护。对小显卡用户来说,Qwen 的量化物料、工作流、显存管理和部署方式更容易复现;对二次开发者来说,Qwen 的 Pipeline 和 ComfyUI 接口也更容易接进自己的项目。最后得到的文字稳定性、参考图编辑保真度和日常有效速度,仍然不如 Qwen-Image 2.1。
所以我把 SenseNova 的模型删掉了,只保留代码、日志和实验记录。以后这台机器就用 Qwen。不是因为它的名字更新,也不是因为它的许可证更宽松,而是因为在我真正要用的事情上,它更快、更稳,也更少折腾。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2611_95631403/article/details/166647991

