

一、先算一笔账:你的数据库正在被传感器"淹没"
咱们先看一个再普通不过的场景。
某工厂把 2000 台设备接上云,每台设备挂 50 个测点——温度、压力、振动、电流……采样频率 1 次/秒。听起来不算夸张?咱们乘一下:2000 × 50 = 每秒 10 万个数据点,一天下来就是 86 亿条。
这时候如果你把数据塞进传统关系型数据库,会发生什么:
- 写入先扛不住。 磁盘 I/O 和索引维护成本随数据量持续上涨,单机写入很快触及天花板;
- 查询再被拖垮。 “查一下 3 号车间昨天每分钟的平均温度”——这种时序场景里最普通的查询,在 B+ 树上意味着大范围扫描;
- 存储最后爆掉。 设备数据 7×24 小时不间断,一个测点一个 INT 才 4 字节,但加上索引和行格式开销,磁盘账完全没法看。
问题的根子不在数据库本身,而在工作负载不匹配。时序数据有一套非常鲜明的个性:
- 写多读少,只追加不修改——历史数据写完基本不动;
- 查询几乎都带时间范围——“最近一小时”、“昨天对比上个月”;
- 数据有生命周期——热数据看明细,冷数据做降采样,过期数据要清理;
- 乱序不可避免——网关断网续传、设备时钟漂移,迟到数据是常态而不是异常。
这就是时序数据库(Time-Series Database,TSDB)存在的理由:针对这套负载特征做极致优化的数据库。而选型,就是从一堆 TSDB 里挑出和你业务最"合身"的那一个。
目录
二、选型之前,先过五道关
不管最终选谁,我建议先把这五个问题想在前面,能帮你避开 80% 的坑。
第一关:数据模型合不合身。 你的数据天然长什么样?是"设备 → 部件 → 测点"的层级结构,还是"标签 + 数值"的扁平结构?模型不对,后面所有查询和建模都是别扭的。
第二关:写入吞吐和存储成本。 峰值每秒多少个点?数据保留多久?磁盘预算多少?这三个数字直接决定方案生死。
第三关:查询能力够不够用。 降采样聚合、乱序处理、空值填充、最新值查询、多设备对齐……把你业务里最难的十条 SQL 拿出来,让候选产品现场写一遍。
第四关:部署形态能否覆盖全链路。 数据在边缘产生,还是全在云端?需不需要高可用多副本?扩容是加机器就行,还是要停服迁数据?
第五关:生态与长期成本。 协议是 Apache 2.0 这种宽松协议,还是带着商用限制?社区活跃度如何、文档全不全、出了生产事故有没有人管?
带着这五道关,咱们来看这篇文章的主角——Apache IoTDB。
三、Apache IoTDB 是什么来头
一句话介绍:Apache IoTDB 是一款为工业物联网设计的、轻量级的端云一体化时序数据库,Apache 顶级项目,协议 Apache 2.0。
背景值得多说两句。IoTDB 出身清华大学,2018 年进入 Apache 孵化器,2020 年毕业成为 Apache 顶级项目,是基础软件领域少有的"从论文走到生产"的案例。背后的理论积累——列式存储编码、降采样查询处理等一整套研究成果——也持续反哺着工程实现。
商业侧,IoTDB 核心团队创立了商业化公司天谋科技(Timecho),提供企业版 TimechoDB:在开源版基础上增强备份、安全、高可用等企业级能力,并附带原厂技术支持。开源版与企业版的关系,就是社区版与商业版的标准打法——开源版能打,企业版更稳。
定位上,IoTDB 有三个关键词:
- 轻量:内核可以跑在资源受限的边缘网关上,也能撑起云端集群;
- 端云一体:边缘和云端同一套引擎、同一套 SQL、同一套文件格式(TsFile);
- 工业原生:数据模型、编码压缩、查询语义,都是贴着工业场景设计的。
空口无凭,下面拆开看技术细节。
四、四张技术底牌
4.1 树形数据模型:天生对工业场景的"胃口"
IoTDB 用一棵树来组织元数据,路径从根节点一路往下:
root.factory.line1.press01.temperature
 │      │       │       │        └── 测点(measurement)
 │      │       │       └── 设备(device)
 │      │       └── 产线
 │      └── 数据库(database,由 0.x 的存储组演进而来)
 └── 根节点
这个结构和工业世界的真实组织方式——“集团 → 工厂 → 车间 → 产线 → 设备 → 测点”——是同构的。说人话就是:数据怎么长,模型就怎么建,业务方看一眼路径就知道这条数据是哪来的。
建库和建序列的标准姿势:
-- 建数据库
CREATE DATABASE root.factory;

-- 显式建一条时间序列,指定类型与编码
CREATE TIMESERIES root.factory.line1.press01.temperature
WITH DATATYPE=FLOAT, ENCODING=GORILLA;
实际接入时往往等不及先建模型——产线上的设备是动态上下线的。IoTDB 默认开启了自动建元数据,直接 INSERT 就行:
INSERT INTO root.factory.line2.press02(time, temperature, status)
VALUES (now(), 82.5, true);
树形模型的另一个好处是通配查询极其顺手。想知道整个工厂所有温度类测点最近一小时的走势?一句话:
SELECT * FROM root.factory.** WHERE time > now() - 1h;
** 会沿着树展开,匹配所有层级下的所有序列。在"按资产层级看数"的场景里,这比在扁平标签模型里拼一长串 WHERE 条件舒服太多。
4.2 TsFile:把存储格式做成一张开放的牌
IoTDB 的底层存储是自研的 TsFile——一种面向时间序列的列式文件格式。它的设计哲学是:时序数据"变化缓慢、重复度高",那就先编码再压缩,榨干每一个比特。
具体是两层手段叠加:
第一层是编码(encoding),按数据类型选编码器:
- RLE(游程编码):适合状态量。设备运行状态
true, true, true, ...连续一万条,RLE 直接记成"true × 10000"; - TS_2DIFF(二阶差分):适合缓变整数。时间戳本身就是最典型的缓变整数——毫秒级采样时,相邻时间戳的差值几乎恒定;
- GORILLA:适合浮点数。工业测点 25.1 → 25.2 → 25.3,相邻值尾数高度相似,GORILLA 只存异或后的有效位。
第二层是通用压缩,在编码之上再叠 SNAPPY、LZ4、ZSTD 等通用算法(默认 SNAPPY)。
两层叠加的结果,是在典型工业数据集上常见 10:1 以上的压缩比,平滑信号甚至更高。回到第一节的磁盘账:每秒 10 万点的写入量,在合理建模下,一天的落盘可能只有几 GB 量级。当然,这笔账建议你拿自己的真实数据实测——别信任何厂商的 PPT,包括开源项目的。
顺带说一个容易被忽略的点:乱序写入。网关断网续传时,一批"过去的数据"会迟到。TsFile 的处理方式是内存里先接住,查询和后台合并(compaction)时再统一整理顺序,对上层写入方完全透明——你不需要在客户端做任何排序缓冲。
4.3 类 SQL 查询:会写 SQL 的都能上手
IoTDB 的查询语言是 SQL 方言,学习成本几乎为零。几个最能体现时序特色的用法:
降采样聚合——把一天的数据按 10 分钟窗口取最大值和均值,画趋势图的标配:
SELECT max_value(temperature), avg(temperature)
FROM root.factory.line1.press01
GROUP BY ([2026-09-18T00:00:00+08:00, 2026-09-19T00:00:00+08:00), 10m);
最新值查询——设备监控大屏最常用的"LIVE"数字,专门优化过的 LAST 查询:
SELECT LAST * FROM root.factory.**;
多设备对齐——把树形结构"拍扁"成以设备为行的宽表,对接下游分析特别方便:
SELECT * FROM root.factory.line1.** ALIGN BY DEVICE;
数据生命周期管理——热数据放一年自动清理,TTL 一句话配置:
SET TTL TO root.factory 31536000000; -- 365 天,单位毫秒
此外还有 UDF(自定义函数)和触发器(trigger)机制,可以在库内做实时计算和数据改写——比如挂一条规则:某测点超阈值时自动给数据打标。复杂一点的场景不用把数据拉到库外再算。
4.4 一套引擎,三种活法
这是 IoTDB 和大多数时序数据库拉开身位的地方:同一套内核,覆盖边缘、单机、集群三种部署形态。
- 边缘形态:轻量版可部署在工控机、网关上,几百 MB 内存就能跑。边缘侧先做本地缓存、聚合、过滤,扛住断网;
- 单机形态:一台服务器,适合中小规模和开发测试;
- 集群形态:多副本强一致(基于类 Raft 共识协议),节点故障自动切换,横向扩容对上层透明。
形态之间靠**数据同步机制(Pipe)**打通:边缘的 TsFile 可以增量同步到中心 IoTDB 集群,也可以直接落到 HDFS/S3 进数据湖。注意这里的巧妙之处——同步的单元是文件而不是消息:边缘写好的 TsFile 本身就是压缩过的列式文件,搬运它等于同时完成了"传输 + 压缩 + 格式标准化"三件事。
五、和国际主流选手过过招
时序数据库这个赛道,国外有几位绕不开的选手。咱们摆事实讲道理,不吹不黑。
5.1 对比 InfluxDB
InfluxDB 是 InfluxData(美国)出品的 TSDB,DevOps 监控领域的老牌明星,生态成熟,配套的 Telegraf 采集器家喻户晓。它的数据模型是"measurement + tag + field"的扁平标签模型,监控指标类数据用起来很顺。
差异点主要在三处:
- 数据模型的表达力。 标签模型对"指标监控"很友好,但对层级化的工业资产,标签组合会越拼越长,且表达不了树的层级语义;IoTDB 的树形模型则是天然映射。
- 开源版的能力边界。 InfluxDB 的开源版本长期以单机能力为主,集群等能力通常与商业版、云服务绑定;而且 1.x → 2.x → 3.x 的大版本迁移伴随着查询语言(InfluxQL → Flux → 回归 SQL)和存储引擎的多次大调整,跟随升级需要下不小决心。IoTDB 开源版即包含完整集群能力,协议是宽松的 Apache 2.0。
- 边缘形态。 InfluxDB 的思路是"用 Telegraf 在边缘采集,数据回中心处理";IoTDB 的思路是"边缘本身跑一个数据库,断网也能本地读写,联网后增量同步"——对弱网工业现场,这是本质区别。
有意思的是,InfluxDB 3.x 也转向了 Parquet + Arrow 的列存路线并回归 SQL——整个行业都在往"列存 + 开放格式"走,而 TsFile 从项目第一天就是这么设计的。
5.2 对比 TimescaleDB
TimescaleDB 是基于 PostgreSQL 的时序扩展,hypertable 自动按时间分片,最大优势是完整 SQL + 与关系数据无缝 JOIN——订单表和设备数据在同一个库里关联分析,这是它独有的舒适区。
但要留意两点:一是它的扩展路线以单机纵向扩展为主,官方已宣布弃用多节点方案;二是部分关键特性(如压缩)采用 Timescale License(源码可见但非 OSI 开源协议),商用合规上需要多看一眼。如果你的团队已深度绑定 PG 技术栈、时序只是辅助场景,TimescaleDB 值得优先考虑;反过来,如果时序是绝对主力、写入量在百万点每秒级别,方向就不一样了。
5.3 对比 kdb+
kdb+(英国 KX 公司)是金融行业的事实标准,q 语言 + 列式内存计算,性能是天花板级别的存在,在高频交易场景沉淀了几十年。但它的门槛和价格同样是"天花板":授权费用高昂,q 语言人才池子小,生态偏金融垂直。工业物联网团队选它,属于"杀鸡用了屠龙刀,还未必买得起刀"。
5.4 一张表收尾
| 维度 | Apache IoTDB | InfluxDB | TimescaleDB | kdb+ |
|---|---|---|---|---|
| 数据模型 | 树形层级 | 标签模型 | 关系表(PG 扩展) | 列式表(q) |
| 开源协议 | Apache 2.0 | 核心开源,多版本策略调整中 | Apache 2.0 + TSL 双协议 | 商业授权 |
| 开源版集群 | 支持,多副本 | 以单机为主 | 多节点已弃用 | 企业版能力 |
| 边缘形态 | 原生轻量版 | 依赖采集器 | 无 | 无 |
| 大数据生态 | TsFile + Spark/Flink 连接器 | 3.x 转向 Parquet | PG 生态 | 自有生态 |
| 主场 | 工业 IoT、车联网、能源 | DevOps 监控 | PG 团队混合负载 | 金融高频 |
再强调一遍免责声明:没有最好的数据库,只有最合适的数据库。上表是结构性差异的速览,不是排名。
六、大数据视角:TsFile 是被低估的那张牌
聊完单点对抗,把视角拉高一层——从大数据架构的角度看 IoTDB,你会发现它最聪明的设计,其实是 TsFile 这个"文件格式优先"的思路。
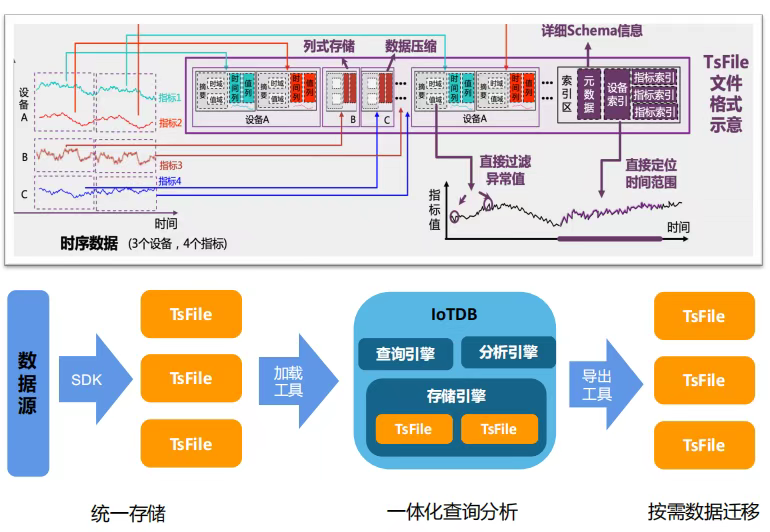
传统的时序数据架构长这样:
设备 → 采集网关 → 消息队列 → 流处理 → TSDB → ETL → 数据湖 → 分析
链路里同一份数据要被序列化、反序列化、转换 N 次,每一跳都是成本和故障点。
IoTDB 给出的方案是让 TsFile 贯穿全链路:
设备 → 边缘 IoTDB(生成本地 TsFile)
              │
              ├─ Pipe 同步 → 云端 IoTDB 集群(在线查询)
              └─ 文件搬运   → HDFS / S3 数据湖(离线分析)
关键在于 TsFile 的"一鱼三吃":
- 它就是 IoTDB 的原生存储格式,数据库读写零转换开销;
- 它是自描述的列式格式,Spark、Flink 均有连接器可以直接读,不经过任何 ETL;
- 它已经是编码压缩后的形态,搬进数据湖不占额外空间。
这对存算分离和数据湖架构是天然友好的:热数据在 IoTDB 集群扛在线查询,冷数据把 TsFile 沉到对象存储,用 Spark 跑年度报表、训练预测性维护模型——同一份文件,两边直接读。
配合官方维护的 Grafana 数据源插件,监控大盘的链路也是现成的。说到底,“数据库的存储层即数据湖的文件格式”,这个设计放在湖仓一体的浪潮里看,依然超前。
七、十分钟上手:从零到第一条查询
光说不练假把式,咱们走一遍最小闭环(以 1.x 版本为例)。
第一步,下载解压。 到官网下载页 https://iotdb.apache.org/zh/Download/ 拿最新发行版,解压即用,无需安装。
第二步,启动服务:
# Linux / macOS
sbin/start-standalone.sh

# Windows
sbin\start-standalone.bat
第三步,进 CLI:
sbin/start-cli.sh -h 127.0.0.1 -p 6667 -u root -pw root
第四步,跑 SQL——建库、写入(自动建元数据)、查询一气呵成:
CREATE DATABASE root.factory;

INSERT INTO root.factory.line1.press01(time, temperature, status)
VALUES (now(), 82.5, true);

SELECT * FROM root.factory.** WHERE time > now() - 1h;
第五步,用代码接入。 以 Python 为例(pip install apache-iotdb,具体 API 以所用版本文档为准):
from iotdb.Session import Session

session = Session(host="127.0.0.1", port=6667, user="root", password="root")
session.open(False)  # False = 不启用 RPC 压缩

# 写入:元数据自动创建
session.execute_non_query_statement(
    "INSERT INTO root.factory.line1.press01(time, temperature) "
    "VALUES (now(), 83.1)"
)

# 查询:结果直接转 pandas DataFrame
result = session.execute_query_statement(
    "SELECT * FROM root.factory.** WHERE time > now() - 1h"
)
df = result.todf()
print(df.tail())

session.close()
除了 Python,IoTDB 还提供 Java、Go 等多语言客户端,并支持 JDBC 协议接入,主流语言栈基本都能找到趁手的工具。
跑通之后,强烈建议做两件事:一是用官方的 IoTDB-Bench 基准工具,灌入接近你真实规模和分布的数据,把写入吞吐、查询延迟、磁盘占用摸一遍底;二是把业务里最复杂的十条查询拿进来试——选型阶段多流汗,上线之后少流泪。
八、运维视角:上线前你最关心的几件事
开发看功能,运维看命。站在运维角度补几个关键信息:
高可用:集群形态基于共识协议做多副本,节点宕机自动切换,副本数可配置,生产环境建议至少三节点起步。
容量与扩容:数据按数据库、时间分区打散到各节点,扩容后新节点逐步分摊负载;配合 TTL 和冷数据下沉,磁盘水位是可控的。
备份恢复:支持对数据目录做快照式物理备份,官方文档有完整的备份/恢复方案;企业版 TimechoDB 还提供增量备份、可视化运维等增强工具。
监控告警:内置 metrics 模块,可对接 Prometheus + Grafana,观察写入延迟、合并堆积等核心指标——时序数据库自己先被监控好,才能安心去监控别人。
权限与安全:用户、角色、权限体系齐全,可以按数据库粒度做读写隔离,多团队共用一套集群时很有用。
版本策略:开源社区迭代活跃,生产环境建议跟随官方标注的稳定版本线;追新版本请先在预发环境演练。
至于"出了事找谁"——开源社区(GitHub issue、邮件列表、用户群)响应不算慢;如果业务关键到需要 SLA,企业版 TimechoDB 背后是原厂团队直接支持。这个决策逻辑,和用开源 Linux 还是订 Red Hat 的支持服务是一回事。
九、选型决策:什么时候选它,什么时候缓一缓
把全文收敛成一张决策清单。
以下场景,IoTDB 值得进入你的短名单:
- 数据源头是设备/传感器,资产天然分层(工厂、产线、设备、测点);
- 写入量大(十万到百万点每秒量级),且来自分散的边缘现场;
- 需要边缘自治——断网可写、联网续传、端云协同;
- 下游有大数据分析诉求,想把时序数据喂给 Spark/Flink 做报表或模型训练;
- 团队在意协议开放性(Apache 2.0)和自主可控。
以下场景,建议再想想:
- 时序数据量很小(每天百万条以内),现有的 MySQL/PostgreSQL 加张分区表完全够用——别为了技术先进性引入新组件;
- 核心诉求是时序数据和业务表频繁 JOIN、复杂关系运算,PostgreSQL 系的方案可能更顺手;
- 团队完全没有 Java 运维经验且极度排斥学习——IoTDB 是 Java 系,JVM 调优不算难,但心态上要接受。
十、写在最后
选型这件事,本质是在"业务负载特征"和"数据库设计哲学"之间找共振。
IoTDB 的答案很清晰:为层级化的工业数据用树形模型,为海量写入用列式编码压缩,为弱网现场用端云一体,为数据价值的长尾用 TsFile 打通数据湖。这不是四处贴补丁的产品,而是一开始就想清楚了的架构。
当然,任何选型文章都替代不了你自己的实测。地址都在这儿:
- Apache IoTDB 下载:https://iotdb.apache.org/zh/Download/
- Apache IoTDB 官网与文档:https://iotdb.apache.org/
- 企业版 TimechoDB(天谋科技):https://timecho.com
拿你的真实数据灌一遍,把最难查的那十条 SQL 跑一遍,答案自然会浮出水面。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/qq_57761637/article/details/166006353

