

MoE-MLP 完整流转(输入→门控选专家→专家计算→输出)
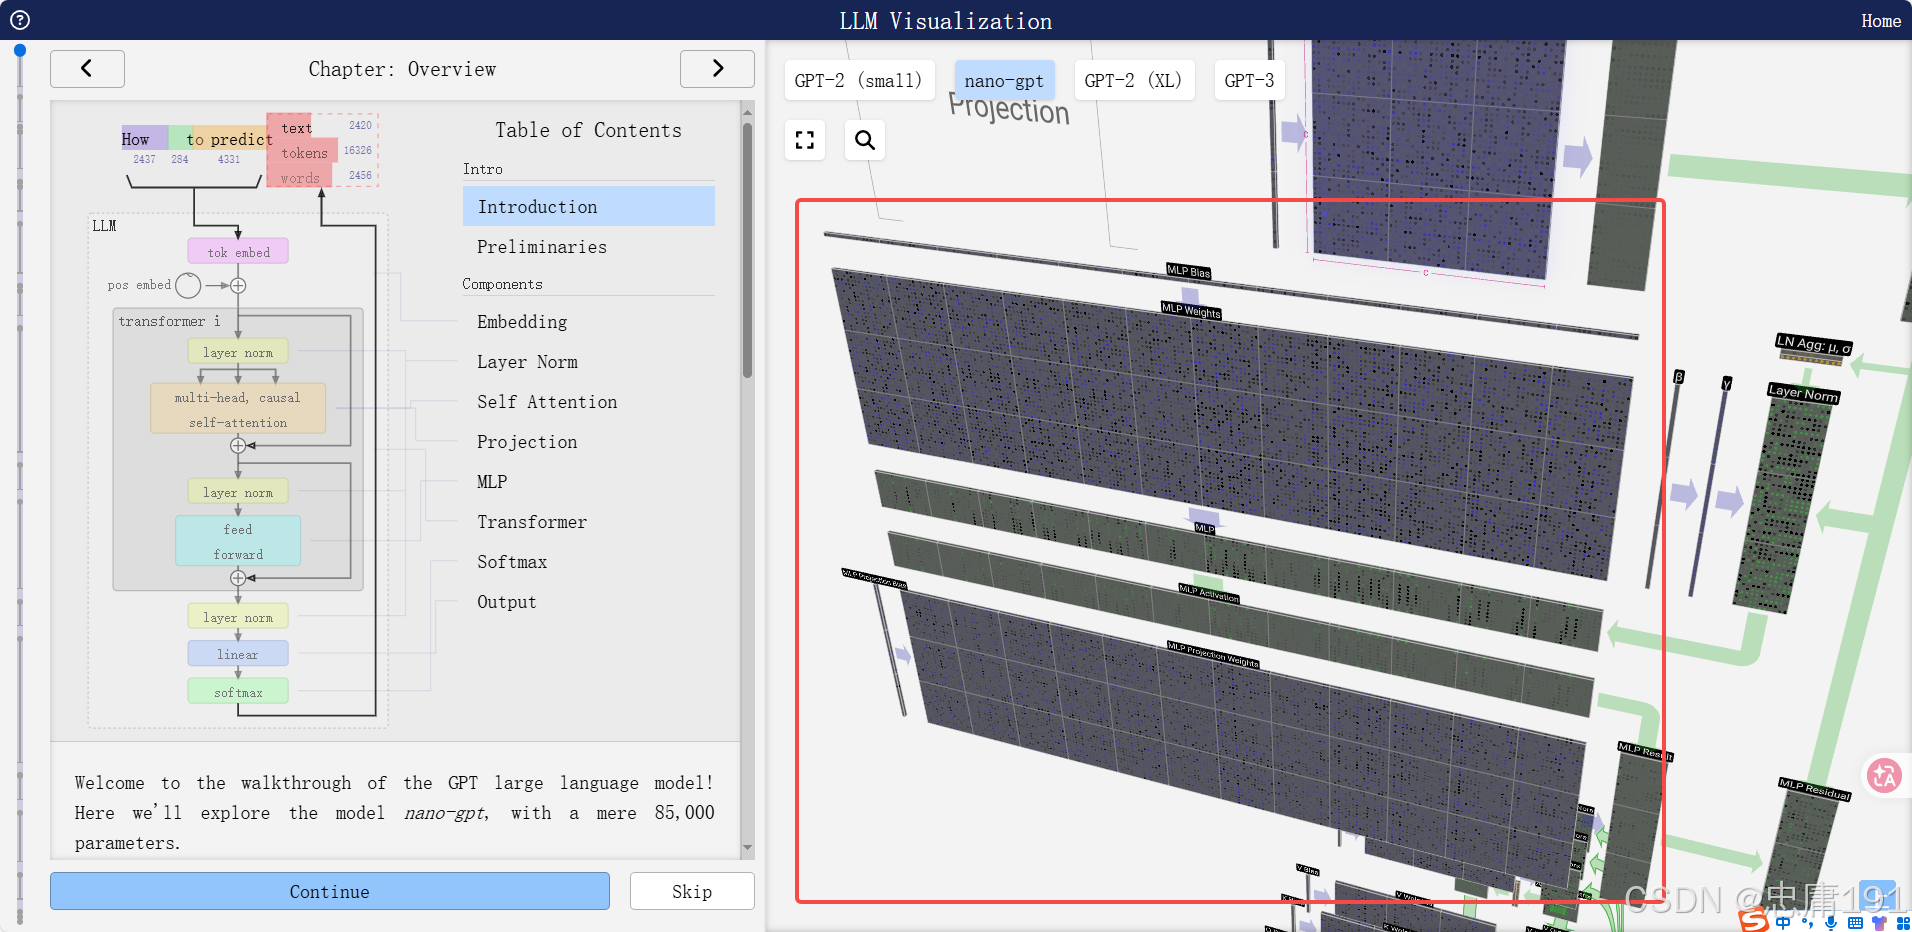
MoE就是把这1套MLP复制成N份(N个专家),再加1个Gate门控。
一、先固定:几个专家、选几个(人工超参,不是模型决定)
这两个数字训练前写死,模型不会自己变:
num_experts:总专家数,比如8个(专家E0~E7,每个都是你截图里那套 w1+gelu+w2 的MLP)top_k:每个token激活几个专家,比如 Top2(Switch Transformer是Top1)
专家数量 = 代码配置,不是MLP算出来的;门控只负责"从N个里挑哪K个"。
二、内部逐层流转(一个token,从输入到输出)
设:隐藏维 d=4,8个专家,Top2,输入token向量
x = [ 0.1 , 0.2 , 0
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/qq_38998213/article/details/166644739

