

目录
·JVM-Java虚拟机/解释器
JVM可以实现“一次编写,到处运行”。
创建一个进程,就会自动创建一个JVM。
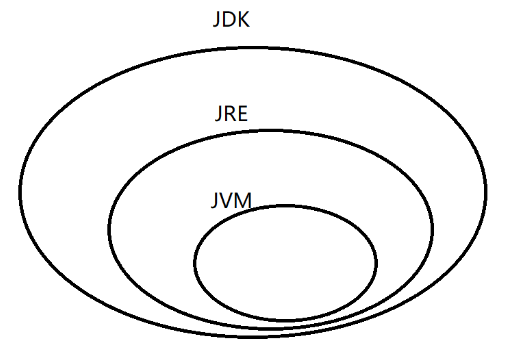
开发Java代码,需要下载JDK;只是运行,只需下载JRE即可。
一次编写,到处编译:
像C/C++这些语言都没有“虚拟机”这个机制,所以写一个代码,使用A平台编译,生成一个A的可执行程序;
使用B平台编译,生成一个B的可执行程序;
在切换平台的时候,就可能要调整代码,且不同的CPU有不同的指令集和,不同的操作系统有不同的API。
一次编写,到处执行:
而像Java/python/JavaScript等,都引入了“虚拟机”,实现“一次编写,到处运行”。
.java文件编译成.class字节码文件,把字节码文件打包成一个.jar包,不同版本的Java虚拟机都可以解释执行相同的字节码。
JVM三个核心内容(面试常考)
1.JVM内存区域划分
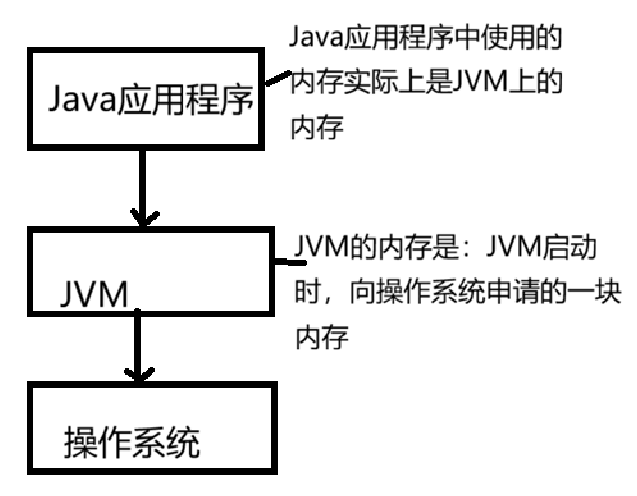
内存区域分为4部分:
(注:以下的堆、栈都是JVM上的,不要和数据结构、操作系统搞混)
1.程序计数器
程序计数器只存一个数字,这个值是下一条要执行的Java字节码指令的地址。
2.栈
虚拟机栈
给Java程序使用的栈,用来维护方法的调用信息。
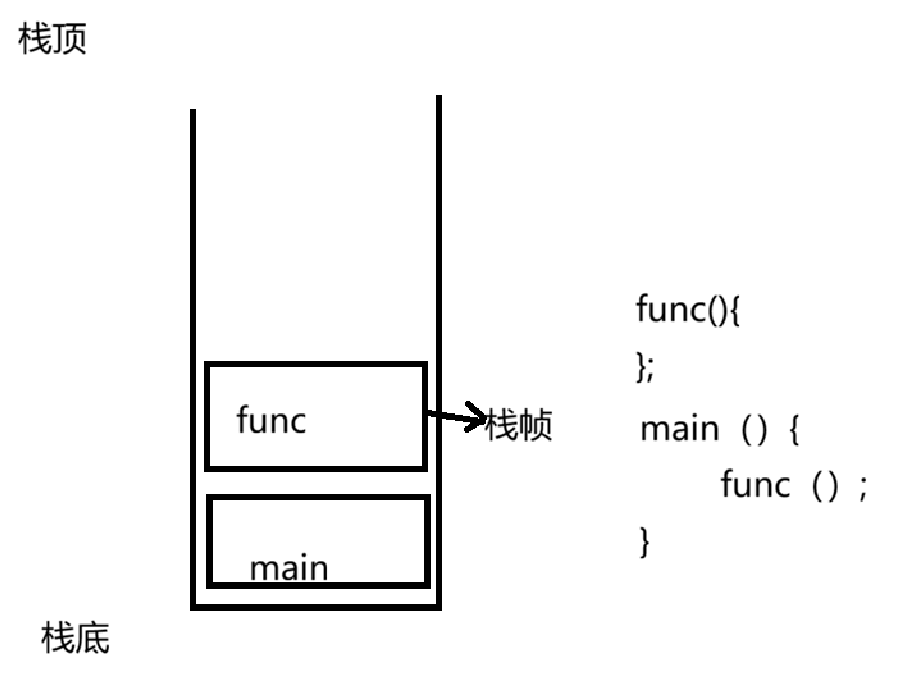
调用方法时,按照调用顺序压入虚拟机栈,先进后出。
栈帧
栈帧存的是
1.调用方法的参数信息
2.方法内部的局部变量
3.方法结束后要返回的上一层方法的位置
4.返回值
本地方法栈
当Java代码调用到native方法时,就把栈帧压入本地方法栈,栈帧记录着C/C++方法的信息。
注:
本地方法栈与虚拟机栈的栈帧记录的内容不同。
native方法源码不在JVM中,在JDK的源码包中,运行时源码被编译为动态库文件xxx.dll,JVM启动时,会加载这个动态库,里面是机器码。
3.堆
最大的内存空间,new的对象都在堆上。
4.元数据区
元数据区存的是 类的元信息。类对象(class实例)存放在 堆内存,该对象引用指向 元数据区的 类的元信息。
类的元信息
类元信息指的是:JVM运行时,把.class文件读取到内存中,解析出来,通过一些特定的结构表示的原始模板数据,存在元空间。
类元信息包括:类名、父类、接口、方法、成员变量的定义、static属性、常量池等这个类的所有信息。
类对象
类对象指的是:JVM为这个类创建的普通对象的实例
类对象包括:持有引用,指向元空间的类元信息;提供一堆方法(反射API),用来读取元空间的元信息
反射:
程序运行期间,拿到一个类的全部信息,运行时才知道类是谁。
//拿到Class类对象
Class clazz = Demo.class;
//拿到test方法
Method method = clazz.getMethod("test");
//调用方法
method.invoke( new Demo() );
5.补充:
局部变量存储在栈上;
成员变量存储在堆上;
类对象/static修饰的属性 存储在 元数据区上;
内存溢出
栈溢出:调用方法信息过多,栈帧过多,导致栈溢出。
堆溢出:new的对象太多,导致堆溢出。
注:Java可以手动设置栈空间和堆空间大小。
线程、进程内存的不同
程序计数器、栈每个线程各有一份;
堆、元数据区一个进程只有一份。
2.JVM类加载机制
类加载:JVM把.class文件读取放到 内存中,构建出 类对象 和 生成元信息 的过程
1.类加载流程
分为5步:
加载
找到.class文件,打开文件,把文件读取到内存中
根据“全限定类名”,找到对应的.class文件
全限定类名:例如“java.util.Scanner”.
根据“双亲委派模型”来找全限定类名。
验证
根据读到的二进制内容,验证是否是合法的格式。
验证依据:ClassFile-JVM官方规定的.class文件的二进制结构模板。
ClassFile
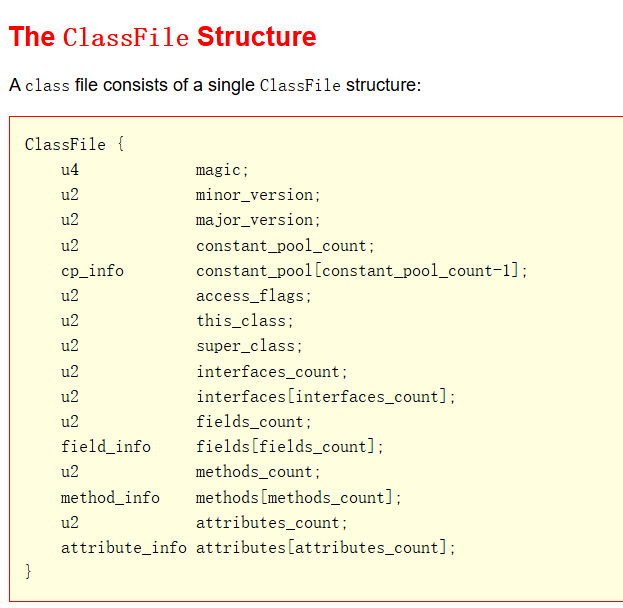
注:二进制内容不包含注释!
u4-》unsigned int
u2-》unsigned short
1.
magic:二进制文件通常把开头的四个字节,设定成特殊值。
设magic的原因是:文件的后缀名可以随便改,所以不靠谱,要设置特殊标记。
JVM读到文件的前4个字节,如果读到CAFEBABE-》是class文件,继续;
不是CAFEBABE-》不是合法class文件,抛出异常,加载失败。
2.
minor_version(次要版本),major_version(主要版本)
描述了这个.class文件是通过哪个java版本的编译器生成的。
如果是Java17编译出来的.class,不能放到Java8的JVM上执行;
如果是Java8编译出来的.class,能放到Java17的JVM上执行;
“向前兼容”
准备
准备元数据区。
例如:
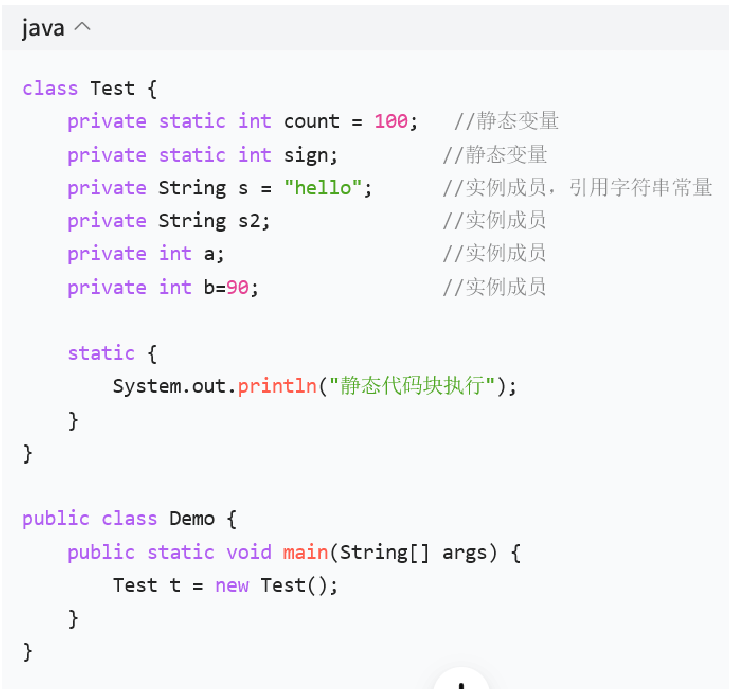
给类对象分配内存,所有静态变量同一赋默认值。
static int count,内存分配,count=0;
static int sign,内存分配,sign=0;
实例变量s,s2,a,,b不处理.
针对字符串常量进行初始化
JVM解析Test.class,发现字面量“hello”
把“hello”放到字符串常量池,字符串拿到地址,但是实例变量s此时还没有拿到这个地址,等到实
例初始化
初始化
执行静态变量显示赋值:count=100;sign没有赋值,默认0.
执行static静态代码块:控制台打印“静态代码块执行”。
到这里,Test类加载全部结束。静态变量count=100,sign=0保存在元空间的类对象中。
2.类加载的时机
一个类的类加载只有一次。
1.第一次new这个类的实例时
2.调用这个类的静态成员变量/静态成员方法时
3.子类的加载,也会触发父类的类加载。
3.双亲委派模型
出现在类加载第一步:加载,找.class文件的全限定类名
涉及到类加载器
JVM中,默认包含3个类加载器:
BootstrapClassLoader(引导类加载器)-负责加载Java标准库中的类
ExtensionClassLoader(扩展类加载器)-负责加载Java扩展库中的类
ApplicationClassLoader(应用类加载器)-负责加载第三方库,以及当前项目中的类
如果在3个类加载器中都找不到全限定类名,就会抛出ClassNotFound异常。
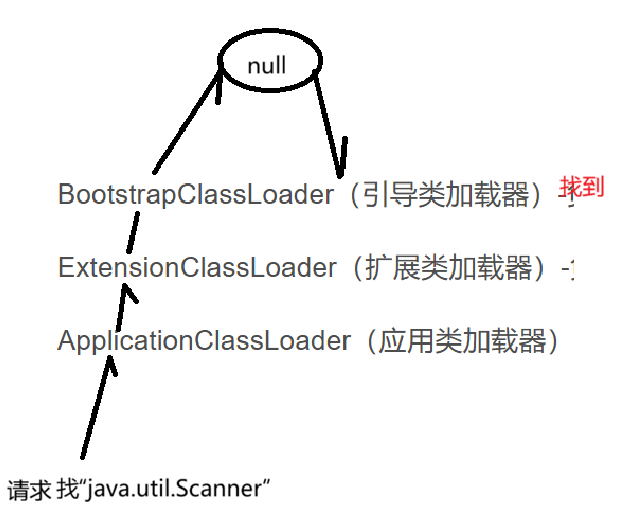
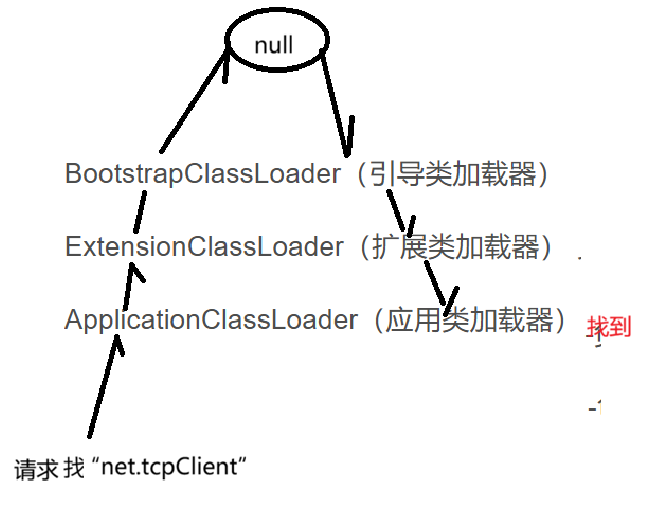
实际上双亲委派模型是约定了“类加载的优先级”
标准库最先加载,其次是拓展库,最后是第三方库/当前项目类
3.JVM的垃圾回收
C++:智能指针应对内存泄露
Java:垃圾回收GC应对内存泄露,JVM引入垃圾回收机制更好地应对内存泄漏(不是100%避免)。
GC回收的是堆上的内容,回收时以 对象 为一个单位回收,不能以字节为单位!
怎么确定一个对象是垃圾呢?——》一个对象没有引用指向就是垃圾(Java使用对象只能通过引用使用)。
如果判断不准,就不回收!
JVM有四种引用:强引用、弱引用、虚引用、软引用。
1.找出垃圾
1.引入
引用计数(Java未采用)
就是在每个对象的内存上安排一块空间存储一个整数,整数的值就是对象引用的个数。如果值为0就释放空间。
缺点:1.消耗更多的内存空间
2.循环引用问题
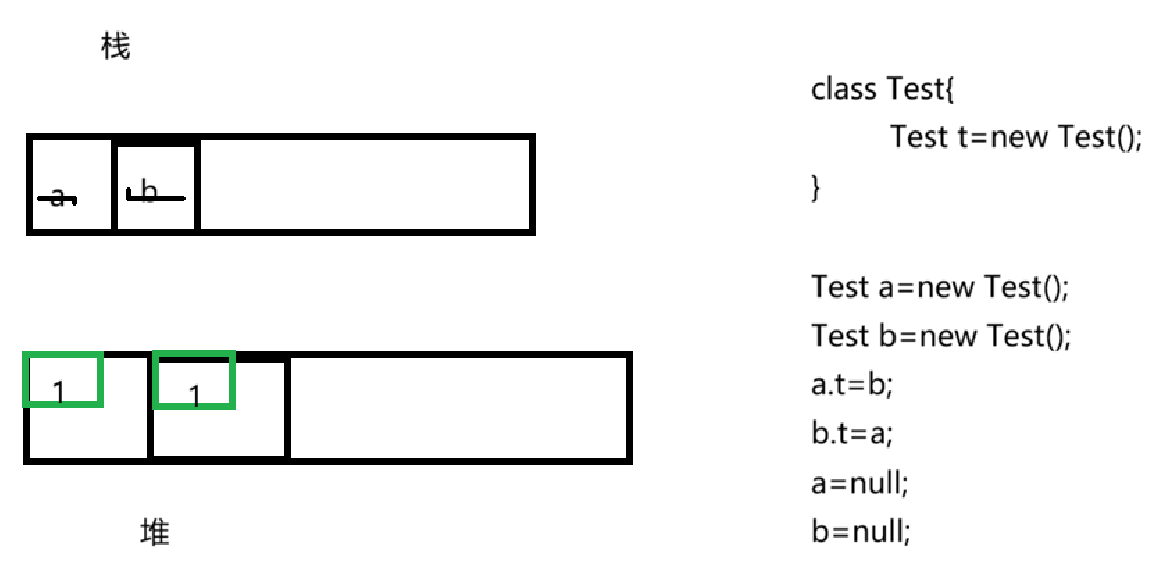
对象无法被释放,也无法被使用!
2.可达性分析
JVM专门指派一些线程,这些线程周期性的扫描代码中申请的内存,自动判定当前这个内存是否已经不再使用了。
一个Java代码中,对象之间有关联关系,这些关系组成很多树/图;
可达性分析:从一个树的根节点开始,经过的节点都标记为“可达”;
JVM知道当前进程中有多少个对象,除去标记的为“可达”的,剩下的都是“不可达的”,不可达的即为垃圾;
随着代码的执行,对象之间的关系也在不停变化,因此可达性分析周期性进行。
GCRoots
GCRoots:GC遍历的起点。
GCRoots来源于:
1.栈上局部变量;
2.常量池引用指向的对象;
3.所有引用类型的静态成员。
一轮GC尽可能地遍历所有GCRoots,尽可能标记可达。
缺点:消耗更多的CPU资源;
消耗更多的时间。
2.识别出是垃圾之后,如何释放内存?
1.标记清除
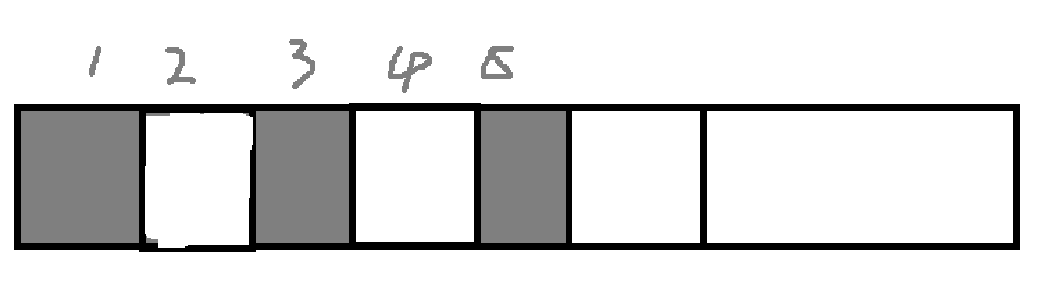
清除垃圾后内存不连续。
内存碎片会造成无法申请连续大内存问题!!!
2.复制算法
把内存分为两步分:
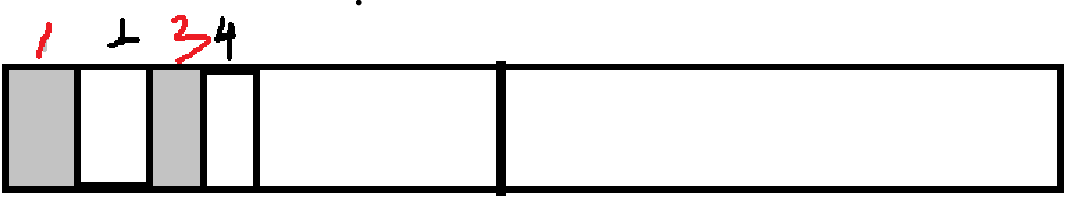
要删除1,3,把2,4复制一份到右边:
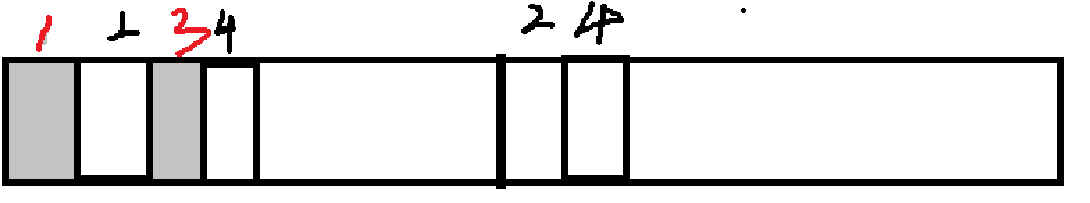
然后删除左边部分全部的:
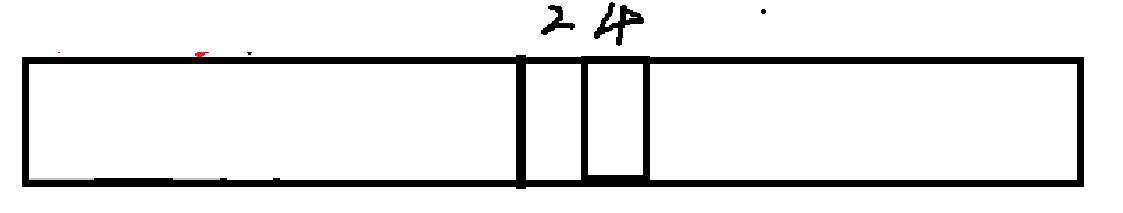
优:避免了内存碎片问题。
缺:空间利用率小,复制开销大
标记整理
标记后,类似于顺序表删除:
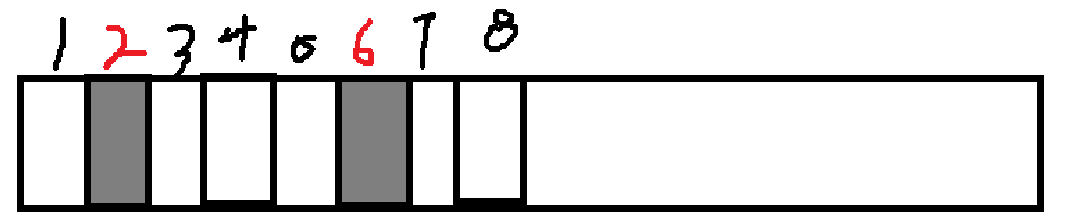
删除:
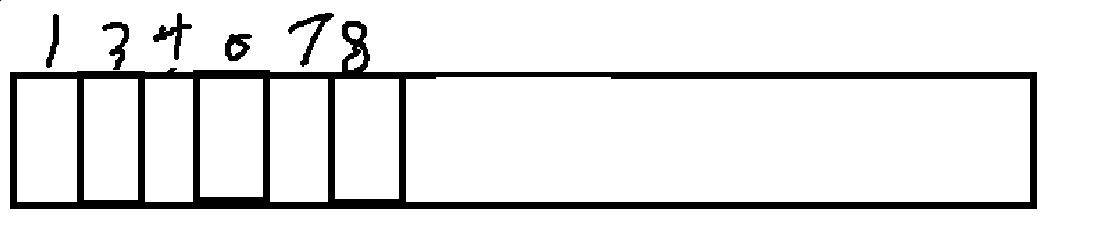
优:避免空间浪费
缺:复制开销大
分代回收
Java实际上综合了上述策略,构成了一个复杂的方案:
分代回收:根据不同对象的情况/特点,采取不同的方案.
年龄指标:如果某个对象年龄比较大有很大概率存活下去。
对象的年龄:与GC的扫描轮次、GC的周期有关,不是轮次+1,年龄就+1;
针对老年代的扫描,称为Major GC(开销较大,频率较低)
针对新生代的扫描,称为Minor GC(开销较小,频率较高)
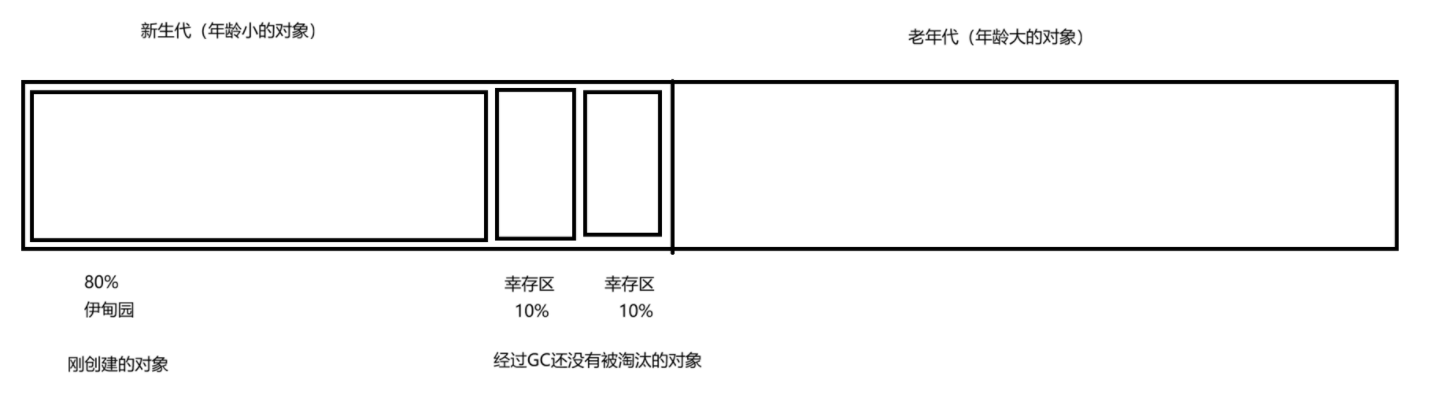
1.新new的对象,放入伊甸园中
2.伊甸园中的对象经过第一轮GC,淘汰掉绝大部分。
没有淘汰掉的,经过复制算法,进入幸存区;
3.下一轮GC会对幸存区的对象扫描,再淘汰掉一大批对象。
没有淘汰掉的,经过复制算法,进入另一个幸存区;
由经验规律发现,每轮GC淘汰掉大部分新对象,因此触发复制的对象就很少,避免了复制算法拷贝开销大的问题;
幸存区只占10%,浪费的内存空间小了。
4.随着每轮GC的进行,对象就会再新生代的幸存区来回拷贝,拷贝一次,年龄+1
5.经过一定时间,对象的年龄达到一定阈值。把这个对象拷贝到老年代。
6.进入老年代之后,GC的频率就低了。针对老年代的对象的回收时曹勇 标记整理 的方式处理。
7.占据内存很大的对象直接进入老年代
上述分代回收过程是简化版,真实情况复杂很多!!!
·结语
山高万仞只登一步
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/captain376/article/details/166368667

