

项目类型:企业级知识管理框架 / Knowledge + Agent + Runtime 平台
赏析目标:看一个"文档 → RAG"的知识库,如何演化成"RAG + Agent + Wiki"三条线共享同一知识体系的平台
核心问题:当知识不再是一次性塞进上下文的文本,而是一份持续维护的资产时,Agent 架构会发生什么变化?
源码版本:Tencent/WeKnora,main 分支,commit4364e61,版本0.8.2(2026-09-24)
前面十一个项目赏析,我看到了 Agent 的很多面:
LangGraph          → 怎么编排
OpenHands          → 怎么执行真实动作
browser-use        → 怎么感知真实界面
DeerFlow           → 怎么跑长任务
Hermes             → 怎么自我进化
OpenCode           → 怎么组织产品
Goose              → 怎么变成 MCP 服务
DeepSeek Harness   → 怎么做到一切皆插件
OpenMAIC           → 怎么交付产出物
OpenCodeReview     → 什么时候确定性,什么时候交给 Agent
看下来,我发现它们有一个共同的默认假设:
知识是"临时塞进上下文"的东西。
OpenHands:把文件读进来 → 放进上下文 → 用完就没了
browser-use:把页面序列化 → 放进上下文 → 本轮有效
DeerFlow:检索一下 → 放进上下文
OpenMAIC:用户上传的资料 → 提取成 markdown → 当素材用
这些系统里,"知识"的生命周期 = 一次会话(甚至一轮对话)。
WeKnora 走的是另一条路。它的官方定位第一句是:
WeKnora(维娜拉) 是一款开源的、基于大语言模型(LLM)的知识管理框架,面向企业级文档理解、语义检索与智能推理场景。它把团队分散的文档汇集起来,用于检索、推理,并随资料更新持续维护。
注意最后半句——"随资料更新持续维护"。
而它的核心定位,可以用 README 里最精炼的一句话概括:
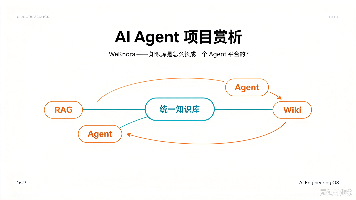
查询资料用 RAG,处理多步任务用 Agent,整理知识用 Wiki。三种能力共享同一知识库。
        ┌─────────────────────────────────┐
        │        同一个知识库              │
        └────────────┬────────────────────┘
                     │
       ┌─────────────┼─────────────┐
       ↓             ↓             ↓
     RAG           Agent          Wiki
   查询资料      处理多步任务     整理知识
这张图是整篇文章的钥匙。
因为一旦"三种能力共享同一知识库",就出现了前面十一个项目都不需要面对的问题:
Agent 检索到的内容,是谁维护的?       → Wiki 的页面
Wiki 的页面,内容从哪来?              → 从文档来
文档更新了,Wiki 要跟着改吗?          → 要(有 wiki-fixer agent)
Agent 在沙箱里干活,产出的文件归谁?   → 归知识库(Artifacts)
知识库里的知识过期了怎么办?           → 要靠"持续维护"
所以这一篇要回答的是:
当知识从"一次性的上下文材料"升级为"持续维护的资产",架构上必须长出什么?
一、先看清这是什么项目
| 维度 | 数据 |
|---|---|
| 项目 | WeKnora(维娜拉) |
| 归属 | 腾讯 |
| 版本 | 0.8.2(2026-09-24) |
| 最新提交 | 4364e61,2026-09-25 |
| 语言 | Go(后端)+ TypeScript(前端)+ Python(docreader / mcp-server) |
| 协议 | MIT |
| 客户端 | Web / 桌面应用(macOS)/ 小程序 / CLI / Chrome 插件 / IM 渠道 |
| 生态入口 | MCP Server、ClawHub Skill、npm 包 |
| 数据源 | 本地文件、Confluence、钉钉文档、语雀(IMA)等 |
| 沙箱后端 | Cube / E2B / Docker(+ 桌面模板) |
| 文档语言 | 中 / 英 / 日 / 韩 |
它的三条产品线(官方能力描述)
| 能力 | 官方描述 |
|---|---|
| RAG | 回答有据可查——混合检索、多模态解析、原文引用 |
| Agent | 用知识和工具完成任务——多步推理、技能与沙箱、本机浏览器、MCP 工具、长期记忆 |
| Wiki | 把文档整理成 Wiki——自动组织、知识图谱、版本回滚 |
这三行描述里的每一个词,都是一个工程问题。 随便挑几个:
"原文引用"        → 引用的出处必须能定位(source location)
"技能与沙箱"      → 技能要在隔离环境里跑
"本机浏览器"      → Agent 要能驱动用户自己的浏览器(含登录态)
"长期记忆"        → 跨会话的记忆
"知识图谱"        → 实体与关系抽取
"版本回滚"        → 知识本身要有版本
一个规模参照
internal/ 下的模块(部分):
  agent           → Agent 引擎
  sandbox         → 沙箱(多后端)
  browserskill    → 本机浏览器集成
  mcp / mcpserver → MCP 双向能力
  runtime         → 运行时
  tracing         → 追踪
  filesystem/fs   → 文件系统
  datasource      → 数据源同步
  docreader/      → 文档解析(独立服务)
  models          → 模型集成
这是一个完整的平台级项目——不是"一个 Agent 框架",而是"一套知识 + Agent 的产品体系"。
二、第一层的演化:知识变成"可维护的资产"
先看最基础的一层。
前面十一个项目里,知识是什么?
读一个文件 → 内容进上下文 → 本轮用完 → 消失
知识的生命周期 = 一次上下文窗口。
这样做有一个隐含代价:每次都要重新获取。
第 1 天:用户上传了一份 PDF,问答了一轮
第 2 天:再问同样的问题
  → 又要重新解析、重新检索
  → 而且第 1 天得到的"结论"完全没留下
更根本的问题是:知识无法积累。
文档 A 里的信息 + 文档 B 里的信息
  → 需要"合并理解"才能回答的问题
  → 每次都要从零开始合并
WeKnora 的第一层:把知识沉淀成资产
从 CHANGELOG 的 v0.8.2 里能看到这一层的完整形态:
Knowledge base workflow —— 批量下载原始文件为 ZIP;文档与资源列表可配置排序;停止推进的文档被标记为 queued 或 stalled,并带
TASK_STALLED码;每次上传可选跳过摘要生成;知识库描述从文档画像生成;上传面板有整体进度、取消与重试;FAQ 列表可按启用状态过滤;活动记录显示 API key 名称。
这一串看起来是"功能列表",但把它们放在一起看,是在处理一个资产系统的必要能力:
批量下载         → 资产可导出(不能锁死)
排序 / 过滤      → 资产可管理
进度 / 取消 / 重试 → 资产导入是长任务,必须可中断
stalled 标记     → 卡住的任务要能被看见(而不是静默挂着)
活动记录 + key 名 → 谁做的操作要能追溯
"知识库"从"一个向量库"变成了"一个有生命周期、有状态、有审计的资产系统"。
而资产的本质特征是:它可以被别的资产引用
这一点在哪体现?在"引用"这件事上。
RAG 能力描述里的 "原文引用",加上 v0.8.2 的这条改进:
Wiki —— 被引用的 chunk 包含图片说明(image captions)
说明"引用"是一个跨子系统的概念:
RAG 回答  → 引用 chunk
Wiki 页面 → 引用 chunk 和图片
一旦有引用,就有"引用完整性"问题:
文档被删了 → 引用它的 Wiki 页面怎么办?
文档更新了 → 引用它的回答还算数吗?
这是"知识成为资产"的必然结果——资产之间会建立关系,关系需要维护。
这一层和前十一篇的对比
| 知识的生命周期 | 知识的地位 | |
|---|---|---|
| OpenHands / browser-use / DeerFlow | 一次上下文 | 临时材料 |
| Hermes | 跨会话(记忆) | 用户偏好与事实 |
| WeKnora | 持续维护(资产) | 组织的知识 |
Hermes 的记忆是"关于我的",WeKnora 的知识是"关于世界的"。 两者都是"状态离开上下文",但性质完全不同——前者服务于个性化,后者服务于正确性。
三、第二层的演化:Agent 本身成为"资源"
这是我觉得最值得写的一个演化。
在大多数项目里,Agent 是"代码"
OpenCode:一个 agent 定义 = 一段配置(写在代码里)
DeerFlow:lead agent = 一个包
dsh:Agent 是可替换的实现类
Agent 是"被开发出来的东西",不是"被管理的东西"。
WeKnora 里,Agent 是一张数据库表
internal/types/custom_agent.go:
// CustomAgent represents a configurable AI agent (similar to GPTs)
type CustomAgent struct {
	// Unique identifier of the agent (composite primary key with TenantID)
	// For built-in agents, this is 'builtin-quick-answer' or 'builtin-smart-reasoning'
	// For custom agents, this is a UUID
	ID string `yaml:"id" json:"id" gorm:"type:varchar(36);primaryKey"`
	// Name of the agent
	Name string `yaml:"name" json:"name" gorm:"type:varchar(255);not null"`
	// Description of the agent
	Description string `yaml:"description" json:"description" gorm:"type:text"`
	// Avatar/Icon of the agent (emoji or icon name)
	Avatar string `yaml:"avatar" json:"avatar" gorm:"type:varchar(64)"`
	// Whether this is a built-in agent (normal mode / agent mode)
	IsBuiltin bool `yaml:"is_builtin" json:"is_builtin" gorm:"default:false"`
	// Tenant ID (composite primary key with ID)
	TenantID uint64 `yaml:"tenant_id" json:"tenant_id" gorm:"primaryKey"`
	// Created by user ID
	CreatedBy string `yaml:"created_by" json:"created_by" gorm:"type:varchar(36)"`
	...
}
请注意这几个字段:
ID + Name + Description + Avatar   → 它能被"看见"(有名字和头像)
IsBuiltin                          → 它有"官方"与"自定义"之分
TenantID(复合主键)                → 它有归属(多租户隔离)
CreatedBy                          → 它有作者
而注释里那个括号说明了一切:
CustomAgent represents a configurable AI agent (**similar to GPTs**)
"类似 GPTs" —— 这个词是理解这一层的钥匙。
GPTs 是什么?是"可被创建、分享、发现、使用的资源"。 而 WeKnora 的 Agent 有同样的属性:
internal/types/agent_share_source.go     → 分享来源
internal/types/shared_agent_access.go    → 共享访问
"分享"和"共享访问"这两个文件的存在,说明 Agent 已经是资源了 —— 它是可以被传递给别人的东西。
内置了什么?9 个 Agent
BuiltinQuickAnswerID         = "builtin-quick-answer"            // RAG 快速问答
BuiltinSmartReasoningID      = "builtin-smart-reasoning"         // ReAct 多步推理
BuiltinDeepResearcherID      = "builtin-deep-researcher"         // 深度研究
BuiltinDataAnalystID         = "builtin-data-analyst"            // 数据分析
BuiltinKnowledgeGraphExpertID = "builtin-knowledge-graph-expert" // 知识图谱专家
BuiltinDocumentAssistantID   = "builtin-document-assistant"      // 文档助手
BuiltinWikiResearcherID      = "builtin-wiki-researcher"         // Wiki 研究
BuiltinWikiFixerID           = "builtin-wiki-fixer"              // Wiki 修复
BuiltinSkillInstallerID      = "builtin-skill-installer"         // 技能安装器
这份名单本身就在讲一个故事。 因为它不是"一个通用 agent + 几个变体",而是一组职责明确的角色:
问答类:quick-answer
推理类:smart-reasoning
研究类:deep-researcher
数据类:data-analyst
知识图谱:knowledge-graph-expert
运维类:wiki-researcher / wiki-fixer    ← 维护知识本身
平台类:skill-installer                 ← 维护能力本身
最后三个特别值得注意:
wiki-researcher   → 研究知识
wiki-fixer        → 修复知识
skill-installer   → 安装能力
这是"平台自己用 Agent 来维护平台" —— 知识会腐化,所以要有个 agent 专门修它;能力要扩展,所以要有个 agent 专门装它。
这是前十一篇里从未出现过的形态:Agent 不只是"帮用户干活",还在"维护系统自身的资产"。
预设不是"换提示词",而是"换能力组合"
还有一个设计我觉得很聪明——AgentType 预设:
// AgentType constants for Smart-Reasoning agent presets.
// These presets bundle a recommended system prompt template,
// tool allowlist, KB compatibility hint, and other defaults so users
// don't have to configure everything from scratch.
const (
	// AgentTypeRAGQA prefers vector/keyword chunk retrieval on document KBs.
	AgentTypeRAGQA = "rag-qa"
	// AgentTypeWikiQA prefers wiki-page navigation on wiki-enabled KBs.
	AgentTypeWikiQA = "wiki-qa"
	// AgentTypeHybridRAGWiki orchestrates Wiki + RAG on KBs where both are enabled.
	AgentTypeHybridRAGWiki = "hybrid-rag-wiki"
	// AgentTypeDataAnalysis runs SQL / statistics over tabular files (CSV, Excel)
	// uploaded into the KB. Retrieval semantics (vector/wiki/…) are largely
	// irrelevant — this type is about data_schema + data_analysis tools.
	AgentTypeDataAnalysis = "data-analysis"
	// AgentTypeCustom is the "no preset" option; user-configured end to end.
	AgentTypeCustom = "custom"
)
注释说得很清楚:预设捆绑的是 "提示词模板 + 工具白名单 + 知识库兼容性提示 + 其他默认值"。
所以"预设"不是"换个说话风格",而是换一整套能力组合。
而 data-analysis 那条注释尤其精准:
检索语义(向量/wiki/…)基本无关——这个类型是关于
data_schema+data_analysis工具的。
"对这类 Agent,检索语义基本无关" —— 这句话说明作者真的想过"不同类型的任务,需要的能力是不一样的":
rag-qa     → 需要:向量检索
wiki-qa    → 需要:wiki 页面导航
data-analysis → 需要:SQL 工具(检索?不需要)
而 custom 的定义是"不预填任何东西" —— 这是一个很克制的默认:预设只在用户没主意的时候帮忙,用户要控制权就完全交给他。
这一节的结论
把一个东西从"代码"变成"资源",需要给它:身份(ID/名字/头像)、归属(租户/作者)、生命周期(内置/自定义/删除)、关系(分享/访问控制)。
而这四个属性一旦具备,它就能被管理、发现、分享、审计——从"工程师的产物"变成"用户的东西"。
四、Agent 内核:无状态引擎 + 三段式循环
现在进入 Agent 的运行时。
internal/agent/ 的目录结构本身就说明了很多:
engine.go       → 引擎
think.go        → 思考
act.go          → 动作
steer.go        → 中途引导
finalize.go     → 收尾
checkpoint.go   → 检查点
compaction/     → 上下文压缩
token/          → token 估算
tools/          → 工具
skills/         → 技能
approval/       → 审批
observe.go      → 观测
think.go + act.go + engine.go —— 这是 ReAct 循环最直白的拆法:
engine → 循环驱动
think  → 想
act    → 做
最重要的设计原则:引擎跨轮次无状态
internal/agent/engine.go 的头部注释:
// AgentEngine is the core engine for running ReAct agents.
//
// History persistence note: the engine is stateless across turns. Conversation
// history is rebuilt from the DB once per turn by the caller
// (see service.LoadAgentHistory) and passed into Execute as llmContext. The
// engine therefore does not maintain its own cache, system-prompt store, or
// cross-turn buffer.
翻译:
引擎跨轮次是无状态的。 对话历史由调用方每轮从数据库重建一次(见
service.LoadAgentHistory),并作为llmContext传入Execute。因此引擎不维护自己的缓存、系统提示词存储或跨轮次缓冲区。
这是我在这个系列里第三次看到同一条原则:
DeepSeek Harness:状态在 append-only 日志里,Agent 从中派生
OpenMAIC:执行不在连接里,状态在数据库里
WeKnora:历史不在引擎里,每轮从数据库重建
同一条原则的三种实现,指向同一个结论:
把状态从"执行主体"里搬出去,主体才能被重启、替换、复制、水平扩展。
而"每轮重建"这个做法,看似低效(每次都要读库),但它换来了:
无状态 → 可以水平扩展(任何实例都能处理任何一轮)
无状态 → 可以重启(进程死了,历史还在库里)
无状态 → 容易调试(每轮都是全新构造,没有"上次留下的脏状态")
对于"每轮可能要跑几十秒到几分钟"的 Agent 来说,读一次库的开销完全可以忽略。
上下文管理:校准、降级、跨轮持久化
engine.go 里有三个字段很值得看:
tokenEstimator       *agenttoken.Estimator   // Token estimator for context window management, calibrated
rawEstimator         *agenttoken.Estimator   // Same tokenizer at scale 1, for measuring the calibration
compactor            *compaction.Compactor   // Summarizes older history to fit the context window (nil = disabled)
注意 tokenEstimator 和 rawEstimator 是一对:
rawEstimator    → 原始分词器(scale 1)
tokenEstimator  → 校准后的估算器
为什么要两个? 因为估算 token 一定不准:
不同模型的分词器不同
不同语言的 token 密度不同(中文 vs 英文 vs 代码)
工具返回的 JSON 结构 token 密度又不同
所以他们的做法是:保留原始分词器,再用实际 usage 去校准它。v0.8.2 的 CHANGELOG 里也印证了:
Agent context —— 历史按模型的上下文窗口大小来定量,使用校准过的 token 估算;compaction 检查点跨轮次持久化
"按模型上下文窗口定量 + 校准过的估算" —— 这是个务实的选择:
不追求"精确计算 token"(做不到)
而是"估得足够准,并且知道自己的误差"
检查点:一个"尽力而为"的姿态
internal/agent/checkpoint.go 有一段很好的失败影响分析:
// saveContextCheckpoint writes a compaction that ends on a stored turn onto
// that turn. Best-effort: a failed write costs the next turn one more
// summarization, never this turn anything.
func (e *AgentEngine) saveContextCheckpoint(ctx context.Context, cp *compaction.Checkpoint, round int) {
尽力而为:写失败最多让下一轮多做一次摘要,绝不影响本轮的任何东西。
这句话是"失败影响范围分析"的范例。 它回答了一个每个异步操作都该回答的问题:
这个写失败了会怎样?
  → 下一轮多做一次摘要(可接受的代价)
  → 本轮不受影响(关键:不阻塞主流程)
而如果把这个检查点的失败当成致命错误(比如阻塞本轮、或者重试到成功),后果是:
用户等一个"本可以降级通过"的步骤
  → 延迟上升
  → 可用性下降
  → 而这个数据只是"让下一轮更快"的优化项
"优化项失败不应该影响主流程"——这是所有缓存/检查点类写入都该遵守的原则。
降级检查点:失败了也要留下痕迹
同一个文件里还有一个细节:
if cp.Degraded {
	logger.Warnf(ctx, "[Agent][Round-%d] Saved a degraded context checkpoint through turn %s "+
		"(raw archive, %d chars): the summarizer failed; the next compaction refines it",
		round, cp.TurnID, len(cp.Summary))
	return
}
"降级检查点":
正常情况:摘要器成功 → 保存摘要
降级情况:摘要器失败 → 保存原始归档(raw archive)+ 标记 Degraded
          → 下一轮压缩时再精炼它
降级但绝不丢数据,而且明确告诉下一次"这份是粗糙的"。
"失败时不丢信息,而是存一个粗糙版本并标记" —— 这个模式可以用于很多地方:
摘要失败     → 存原文 + 标记 degraded
翻译失败     → 存原文 + 标记未翻译
索引失败     → 存原始内容 + 标记待索引
关键都是:不要在失败时把数据丢掉,而是降低质量并存下来,把精炼推迟到下次。
一个细节:token 预算按模式分配
internal/types/agent.go:56 有一句很短但信息量很大的注释:
// quick-answer 2048, smart-reasoning 4096, smart-reasoning with a sandbox 24576.
quick-answer                → 2048
smart-reasoning             → 4096
smart-reasoning + sandbox   → 24576   ← 6 倍
为什么带沙箱要 6 倍输出预算?
因为它的输出内容变了:
不带沙箱:回答文字
带沙箱:  回答文字 + 代码 + 命令 + 文件内容 + 脚本说明
"输出预算按任务形态分配",而不是一个全局常量。 这是个很实际的工程判断——把所有模式的 max_tokens 设成一样,要么小得不够用(沙箱场景),要么大得浪费(问答场景)。
五、闪光点一:能力查询,而非类型查询
这是整个项目里我认为最值得学的设计原则。
internal/sandbox/capabilities.go 的包注释:
// Package sandbox: session-scoped capability interfaces.
//
// The Sandbox / Manager pair intentionally hides provider identity (Cube,
// E2B, Docker) from the application layer. Higher layers should never
// branch on Manager.GetType() to decide whether a feature is supported —
// that couples them to a specific backend.
//
// Instead, session-scoped features (shell execution, per-session file
// inspection, attachment staging) are advertised via the capability
// interfaces below. A manager may satisfy the underlying methods yet still
// return nil from the accessors on SessionCapabilityProvider when the
// current runtime configuration cannot honour that capability.
翻译:
Sandbox / Manager 这一对故意对应用层隐藏 provider 身份(Cube、E2B、Docker)。更高层永远不应该通过
Manager.GetType()来判断某个特性是否被支持——那会把它们耦合到特定后端。相反,会话级特性(shell 执行、会话内文件检查、附件暂存)通过下面的能力接口来声明。一个 manager 可能实现了底层方法,但当运行时配置无法满足该能力时,仍可以从
SessionCapabilityProvider的访问器返回 nil。
然后是那个接口:
// SessionCapabilityProvider is implemented by managers that MAY offer
// session-scoped capabilities. Accessors return nil when the current
// runtime configuration cannot support that capability. Application code
// should gate feature registration on non-nil accessor returns.
type SessionCapabilityProvider interface {
	SessionShellExecutor() SessionShellExecutor
	SessionFileStore() SessionFileStore
}
这个设计解决了一个非常常见的问题
先看错误做法(也就是绝大多数项目的做法):
if manager.GetType() == "cube" {
    // 支持 shell
}
if manager.GetType() == "e2b" {
    // 支持 shell
}
if manager.GetType() == "docker" {
    // 支持 shell,但可能不支持终端
}
这个写法有四个问题:
① 应用层知道了后端的名字 → 耦合
② 新增一个后端(比如 Modal)→ 要改所有判断点
③ 能力矩阵散落在各处 → 没人知道"哪个后端支持什么"
④ 最致命的:类型相同但配置不同时,行为不一致
第四点最容易被忽略:
同样是 Cube 后端
  → 配置 A(完整权限)→ 支持 shell
  → 配置 B(受限模式)→ 不支持 shell
  → 但 GetType() 都返回 "cube"
类型查不出来"当前配置下能不能做",只有能力查询能。
正确做法:查能力,不查身份
executor := manager.SessionShellExecutor()
if executor != nil {
    // 注册 shell 特性
    registerShellTool(executor)
}
好处:
① 应用层不需要知道任何后端名字
② 新增后端 → 只要实现(或不实现)接口,应用层零改动
③ 能力矩阵由接口定义说清楚
④ 同后端不同配置 → 访问器可以按配置返回 nil
这条原则的通用形式
❌ 我需要知道你是什么,才能判断你能做什么
✅ 我只需要问你能不能做这件事
它适用于所有"多实现 + 特性差异"的场景:
数据库适配器    → 不要问"你是 MySQL 吗",要问 SupportsSavepoint()
存储后端        → 不要问"你是 S3 吗",要问 SupportsMultipartUpload()
模型 provider   → 不要问"你是 OpenAI 吗",要问 SupportsToolCalling()
沙箱            → 不要问"你是 Cube 吗",要问 SessionShellExecutor() == nil?
而在 LLM 应用里,模型能力的差异特别适合这个模式:
不要:if provider == "anthropic" { 用 vision }
而要:if model.Vision != nil { 用 vision }
(顺带一提,v0.8.2 的"模型目录"改动里就有"视觉支持"这个字段——说明他们确实是这么做的。)
一个额外的精妙处
注意注释里这句话:
A manager may satisfy the underlying methods yet still return nil from the accessors
"实现了方法,但访问器仍返回 nil" —— 这明确允许了"能力存在但当前不可用"的状态。
这是一个比"接口有没有实现"更细粒度的表达:
接口实现了吗?     → 编译期事实
当前能用吗?       → 运行期事实(可能是 nil)
把"能"和"现在能不能"分开表达,是这个设计最精妙的地方。
六、闪光点二:Sandbox 是"可恢复的工作空间",不只是隔离环境
前面几个项目里,沙箱的角色是"隔离执行环境":
OpenHands:Runtime(Docker/Remote/Modal/Runloop),为了安全执行
Goose:Builtin 扩展开 use_docker,为了隔离
dsh:可选隔离(Optional Isolation),为了平衡自由度
它们都在回答"怎么安全地执行"。
WeKnora 的沙箱回答的是另一个问题:"怎么让这个工作空间可以被反复回来"。
证据在哪?
看 v0.8.2 的这三条:
Conversation control —— 向运行中的 agent turn 追加需求(排队到步骤结束,或立即注入);从任意早先的问题 fork 一个对话;原地 rewind,把沙箱工作区重置到匹配的检查点;每个会话选择 reasoning effort。
Sandbox terminal & graphical desktop —— 聊天旁的沙箱面板获得一个交互式终端(Cube / E2B),可以重连到正在运行的 shell;以及一个基于浏览器的 XFCE 桌面(用于从桌面模板构建的沙箱)。
Artifacts library —— 侧边栏"Artifacts"页列出跨对话生成的每个文件,带类型过滤、搜索、日期分组和版本历史。
把它们连起来看:
fork 对话          → 从某个点分叉,各自继续
rewind 对话        → 回到某个点,重来
  ↓ 并且
沙箱重置到匹配检查点 → 沙箱状态跟着回滚!
  ↓ 并且
终端可重连到正在跑的 shell → 环境是活的、可回归的
  ↓ 并且
产物有版本历史      → 产出物也是资产
注意最关键的那一条:
rewind in place, resetting the sandbox workspace to the matching checkpoint
"原地 rewind,把沙箱工作区重置到匹配的检查点" —— 这一条把"对话状态"和"环境状态"绑定在一起了。
为什么这件事很难?
先想一个简单实现会怎样:
用户点了 rewind 回到第 3 轮
  → 对话历史回滚到第 3 轮 ✅
  → 但沙箱里第 4、5 轮生成的文件还在 ❌
  → Agent 重新执行第 4 轮时,看到的是"被污染过的"环境
  → 行为不可预期
这就是"状态和时间不一致":
对话状态:时间旅行回到第 3 轮
环境状态:仍是第 5 轮的样子
而它的解法是:每个检查点也记录沙箱快照,rewind 时一起回滚。
从 internal/sandbox/ 的文件名能看到这套机制:
docker_snapshot.go      → 快照
docker_idle_sweeper.go  → 空闲清理
orphan_reaper.go        → 孤儿回收
cube_terminal.go        → 终端
desktop.go              → 桌面
orphan_reaper.go(孤儿回收) 尤其值得注意——它和前面几篇的问题同构:
DeerFlow:worker 死了 → 孤儿 Run 要恢复
OpenMAIC:工具调用中断 → 孤儿 tool_call 要补票
WeKnora:进程崩了 → 孤儿沙箱要回收
"孤儿资源回收"是长生命周期 Agent 系统的通用问题——因为"申请资源"和"释放资源"之间可能隔着崩溃。
这个沙箱还有"终端"和"桌面"
交互式终端(Cube / E2B)→ 可以重连到正在运行的 shell
XFCE 桌面(浏览器内)    → 桌面模板构建的沙箱
而它们的空闲策略是:
stdin 和 skill-install 命令的输出实时流式
空闲终端/桌面会话在 terminal_idle_disconnect_sec(默认 900 秒)后断开
900 秒(15 分钟) ——这个数字说明它在平衡两件事:
太长 → 资源浪费(用户走了,沙箱还开着)
太短 → 体验断裂(用户去接杯水回来,终端断了)
"给人类留出离开鼠标的时间" ——这是一个产品判断,不是技术判断。
从"隔离环境"到"可恢复工作空间"
| 传统沙箱 | WeKnora 的沙箱 | |
|---|---|---|
| 核心目的 | 安全(别弄坏宿主机) | 安全 + 可回归 |
| 生命周期 | 一次执行 | 会话级,可暂停/重连/回滚 |
| 状态 | 用完即弃 | 有快照、有检查点 |
| 与人交互 | 无 | 有终端、有桌面,人能进去操作 |
| 与对话的关系 | 无关 | 与对话检查点绑定 |
"沙箱是 Agent 的工作台,而工作台必须能被找回来" ——这是这一节的结论。
七、闪光点三:BrowserSkill —— Agent 用"你的"浏览器
v0.8.2 最亮的功能是这个。原文(我做了精简,保留关键点):
Local Browser (BrowserSkill) —— smart-reasoning 会话中的 agent 可以通过开源的 BrowserSkill 扩展驱动用户自己的 Chrome 或 Edge。从 Toolbox → Browser Connection 配对一次,在 composer 里打开 "Local Browser",新的
local_browser工具就能在专属任务窗口里打开页面、点击、填表和读取内容。聊天区显示实时的画中画任务预览,带暂停/恢复/结束控制;登录和验证码通过request_help交给用户,被中断的任务可以恢复。
这个设计的核心问题:登录态
先看常规浏览器 Agent 的死穴:
Agent 启动一个干净的浏览器(无状态)
  ↓
打开一个需要登录的页面
  ↓
卡在登录页 ← 这就是绝大多数浏览器 Agent 的实际终点
而前面赏析过的 browser-use,走的是"干净浏览器 + 自动填表"的路线——所以它必须处理:
登录 → 需要账号密码(哪来?)
验证码 → 需要识别(识别不了的呢?)
二次验证 → 需要手机(没有)
这是"Agent 自己的浏览器"这个选择的固有成本。
WeKnora 的解法很直接:
用用户自己的 Chrome/Edge。登录态、cookie、扩展,全都在。
Agent 驱动的是用户的浏览器
  → 用户已经登录的站点,Agent 直接就能用
  → 不需要传账号密码
  → 不需要处理验证码
但它没有回避"必须有人"的情况
这是我觉得最成熟的地方——它明确承认有些步骤必须由人完成,并且把这个承认做成了机制:
登录和验证码通过
request_help交给用户,被中断的任务可以恢复。
看 internal/browserskill/human.go:
const (
	// HumanStepWait matches BrowserSkill's default help window.
	HumanStepWait = 5 * time.Minute
	// HumanStepTimeout leaves time for the native result before cancellation.
	HumanStepTimeout = HumanStepWait + 15*time.Second
)

// IsHumanStep identifies browser operations that can wait for user input.
func IsHumanStep(method string) bool {
	return method == "request_help" || method == "tab_borrow"
}
这段代码有三个设计点值得学:
① "人类步骤"是一个明确的类型
func IsHumanStep(method string) bool {
	return method == "request_help" || method == "tab_borrow"
}
两类操作被标记为"可能需要等人":
request_help  → 请求帮助(比如"请帮我登录")
tab_borrow    → 借用标签页(用户手动操作后交还控制权)
"人机交接"被显式建模成操作类型,而不是散落在各处的特殊情况处理。
② 超时按操作语义分类
普通操作     → 正常超时
人类步骤     → 5 分钟(HumanStepWait)
5 分钟——因为:
太短 → 用户还没输入完验证码,连接就断了
太长 → Agent 在一个可能没人理的请求上挂太久
③ 那个 +15 秒
// HumanStepTimeout leaves time for the native result before cancellation.
HumanStepTimeout = HumanStepWait + 15*time.Second
"给原生结果留出时间,然后再取消。"
这个 15 秒的含义是:
用户在 5 分钟内完成了操作
  ↓
操作结果需要一点时间返回(浏览器要执行、页面要加载)
  ↓
如果超时时间正好是 5 分钟,就可能"用户刚做完,连接就被掐了"
  ↓
+15 秒 = 给结果回来的缓冲
"超时不是一个参数,而是三段:等待时间 + 结果缓冲。" 这个细节很真实——它只在真实使用中才会暴露出来(用户抱怨"我明明做完了他却说超时")。
④ 而且它还能恢复
被中断的任务可以恢复(interrupted tasks can be resumed)
人机交接的常见失败是"用户没及时响应",而它的处理是"可恢复"而不是"重头再来"。
这一节和前面对照
browser-use:Agent 自己的浏览器 → 自动化程度高,但登录态是死穴
WeKnora:  用户的浏览器       → 登录态免费,但需要人机交接机制
这是同一个问题的两种答案,而 WeKnora 的答案承认了"自动化不能覆盖一切"。
把"必须有人"这件事做成机制,比假装它不存在要成熟得多。
八、闪光点四:Skill 的三层契约
internal/agent/skills/ 的设计里有三个我认为很有价值的东西。
第一层:环境变量契约(平台与技能的接口)
manager.go 的头部注释:
// artifactOutputEnvVar is the name of the environment variable that WeKnora
// injects into every skill script execution. The value points to the
// convention-driven directory where the script should drop artifacts the user
// will be able to download after the turn completes.
//
// The name is stable across releases; skills reference it via os.getenv(...)
// so they never hard-code the path.
const artifactOutputEnvVar = "WEKNORA_SKILL_OUTPUT_DIR"

// sessionInputEnvVar points skill scripts at user-uploaded files restored into
// the current session's Cube. Inputs are separate from generated artifacts.
const sessionInputEnvVar = "WEKNORA_SESSION_INPUT_DIR"

// artifactHistoryEnvVar is the name of the environment variable that points
// to the root artifact output directory (/workspace/output). Skill scripts
// can use this to self-discover artifacts from prior runs when they need to
// chain without LLM mediation.
const artifactHistoryEnvVar = "WEKNORA_SKILL_HISTORY_ROOT"
三个环境变量,构成了一个清晰的约定:
WEKNORA_SKILL_OUTPUT_DIR    → 本次产出放哪(用户之后可下载)
WEKNORA_SESSION_INPUT_DIR   → 用户上传的输入在哪(与产出分开)
WEKNORA_SKILL_HISTORY_ROOT  → 历史产出的根目录(/workspace/output)
注意注释里的两个设计决定:
① "名字跨版本稳定"
The name is stable across releases; skills reference it via
os.getenv(...)so they never hard-code the path.(名字跨版本稳定;技能通过
os.getenv(...)引用,因此永远不硬编码路径。)
这就是"平台与技能之间的接口契约":
平台:我保证这个环境变量名永远存在,值指向正确的目录
技能:我用它,不关心实际路径是什么
因为平台可以改目录结构(沙箱换了、路径变了),但技能不该跟着改。
② "输入和产出分开"
Inputs are separate from generated artifacts.
(输入与生成的产物是分开的。)
这个区分很重要:
不分开 → 用户上传的文件和技能生成的文件混在一起
       → 用户分不清哪些是"我给的",哪些是"它做的"
       → 清理时不敢删(怕删了输入)或者乱删
第二层:技能之间"不经 LLM 中介"地协作
这是第三个环境变量的说明里最精彩的一句:
Skill scripts can use this to self-discover artifacts from prior runs when they need to chain without LLM mediation.
翻译:
技能脚本可以用它来自发现之前运行的产物,从而在需要时不经 LLM 中介地链式协作。
"chain without LLM mediation"(不经 LLM 中介的链式协作) —— 这句话值得单独拎出来。
它说的是这样一种情况:
技能 A 产出了一个文件
  ↓
技能 B 需要这个文件作为输入
  ↓
❌ 常规做法:A 产出 → 告诉模型 → 模型理解 → 模型决定调 B → 把文件信息交给 B
             (消耗 token、可能传错、可能理解偏差)
✅ 它的做法:B 直接从 WEKNORA_SKILL_HISTORY_ROOT 里找到文件
"能用文件系统约定的,不要绕一圈 LLM。"
这个原则的价值可以量化:
绕 LLM:每次传递 = 一次 token 消耗 + 一次失败可能 + 一次理解偏差
用文件:每次传递 = 一次目录读取(零成本、零偏差)
而它背后是一个更普遍的原则:
确定性数据传递,不要经过概率系统。
这和上一篇文章(OpenCodeReview)里那条"什么时候确定性,什么时候交给 Agent"是同一条原则——只不过这里的分界线画在"技能与技能之间"。
第三层:多租户隔离
internal/agent/skills/ 里有两个文件:
source.go          → 来源
tenant_source.go   → 租户来源
skill 是分租户的。 而结合 v0.8.2 里这条:
Skills —— 过期的沙箱技能可以在不回滚目录、不使技能下线的情况下升级;安装后会验证运行时前置条件;带 UTF-8 BOM 的清单也能加载。
"升级技能时不回滚目录、不下线" —— 这是个很实际的可用性要求:
企业里,一个技能可能被很多 Agent 引用
  ↓
升级它
  ↓
如果"先下线再升级"→ 这段时间所有引用的 Agent 都坏了
如果"不回滚目录、不下线"→ 平滑升级
这是"能力的分发"必须处理的工程问题——一旦 skill 是资产(可上传、可安装、可分享),它就有了版本和兼容性问题。
九、闪光点五:MCP 的双向性,与"按需发现工具"
MCP 双向:既是客户端,也是服务端
前面赏析 Goose 的时候,MCP 是"Agent 消费外部工具能力"的方式:
Goose:Agent → MCP client → 外部 MCP server(70+ Extensions)
而 WeKnora 有两个 MCP 目录:
internal/mcp/         → MCP 客户端(消费外部工具)
internal/mcpserver/   → MCP 服务端(把能力暴露出去)
v0.8.2 的 CHANGELOG:
Built-in MCP Server —— 每个 workspace 可以在
/mcp/<endpoint_id>发布 MCP 端点(Streamable HTTP),从 Settings → Integrations → MCP Server 配置,有自己的 token、知识库范围、每分钟限流(默认 60)和工具组:retrieval & reading、ask(运行该端点的默认 agent)、Wiki,以及写工具(默认关闭)。页面会生成 Cursor / VS Code / Claude Desktop 的mcpServers配置和一行 Claude Code 命令;token 可以轮换。端点通过/api/v1/mcp-endpoints管理。Python 的mcp-server/目录现已废弃。
"把知识库暴露成一个 MCP 端点" —— 这个方向很有意思:
常规:Agent 找工具(Agent 是消费者)
它这里:知识库变成工具,被别人消费(知识库是提供者)
而配置里的每个细节都是产品判断:
自己的 token           → 可撤销、可轮换
知识库范围             → 只能访问被授权的知识(最小权限)
每分钟限流(默认 60)   → 防滥用
工具组                 → retrieval / ask / wiki / write
写工具默认关闭         → 默认安全
生成 Cursor/VS Code/Claude 配置 → 降低接入成本
token 可轮换           → 泄露后可补救
"写工具默认关闭" 这一条尤其重要:默认给的是只读能力,要写就得显式开。 这是"默认安全"的正确姿势。
MCP 客户端:按需发现,而不是全量加载
MCP client —— 工具目录按服务、按调用者持久化,带引导式两步设置和 AI 起草的使用说明;工具可以单独启用或禁用;agent 通过
discover_mcp_tools/call_mcp_tool按需发现和调用 MCP 工具,而不是加载每一个工具;advanced_config.timeout可以延长调用窗口;多行 SSE 事件被正确组装。
"按需发现和调用,而不是加载每一个工具" —— 这是"渐进式披露"在 MCP 上的应用:
❌ 把所有 MCP 工具都塞进系统提示词
   → 假设 10 个 MCP 服务,每个 20 个工具 = 200 个工具定义
   → 光是工具定义就吃掉大量上下文

✅ agent 通过 discover_mcp_tools 按需查找
   → 系统提示词里只有两个元工具
   → 需要时才把具体工具拉进来
这和 OpenHands 的 Skills 渐进披露、Hermes 的 skill 加载是同一思路,只不过应用对象从"技能"换成了"MCP 工具"。
模式是一样的:常驻上下文放"目录 + 访问方式",具体内容按需拉取。
十、闪光点六:能力演进时,怎么不破坏存量数据
这是我在这个项目里学到的另一个很实用的工程手法。
v0.8.2 做了一次工具大合并:
knowledge_search + grep_chunks
  → 合并为 search_knowledge(带 mode: hybrid | semantic | keyword)

list_knowledge_chunks + get_document_info + wiki_read_source_doc
  → 合并为 read_document

新增 list_documents
工具合并是好事(工具越少,模型选择越准),但它带来一个严重问题:
存量数据里,Agent 配置写的是旧工具名
预设里、API 调用里,都是旧工具名
已经存储的对话历史里,也引用了旧工具名
  ↓
改名 → 所有存量配置全部失效
这是"能力演进"最现实的成本。
而它的解法是运行时别名映射:
Backward-compatible tool aliasing —— 存储在 agent 配置、预设和 API 调用中的旧工具名会在运行时映射到它们的后继者(
legacyToolSuccessors/NormalizeAllowedTools);不需要数据迁移,而且引用了旧工具名的已存聊天历史仍能正常渲染。
三个关键点:
① 运行时映射(legacyToolSuccessors)   → 不改存量数据
② 不需要数据迁移                        → 没有迁移窗口、没有迁移失败风险
③ 已存历史仍能渲染                      → 用户看不到"历史坏了"
为什么选运行时映射而不是数据迁移?
数据迁移:
  ✗ 需要停机窗口(或双写期)
  ✗ 迁移可能失败,要回滚方案
  ✗ 存量数据有多少、分布如何,要盘清楚
  ✗ 如果有外部系统引用了旧名字,迁不完

运行时映射:
  ✓ 零停机
  ✓ 可回滚(删掉映射表就回到旧行为)
  ✓ 新旧名字可以共存(渐进淘汰)
  ✗ 代价:多一层间接(每次调用都要查映射)
对一个已被大量用户使用的平台来说,"多一层间接"远比"一次数据迁移"便宜。
这条经验的通用形式:
当你要改一个"已经被存储/被引用"的标识符时,优先考虑运行时映射,而不是数据迁移。
而它还有一个隐含要求——映射表本身要能被删除:
老的映射保留多久?
  → 等历史对话自然过期
  → 或者永远保留(反正只是一张很小的表)
十一、闪光点七:降级要诚实,不要假装成功
这个项目里有一处改进,我认为体现了很成熟的工程态度。
Retrieval tool compatibility fixes ——
search_knowledge不再拒绝某个知识库无法提供的 mode:FAQ 和纯向量库会语义地回答keyword请求,纯关键词库会用关键词回答semantic请求,结果里带requested_mode/mode_fallbacks,模型渲染里有<mode_fallback>,渲染现在显示实际使用的 mode,而不是永远显示semantic。
这条在解决什么?
先看背景:search_knowledge 有三个 mode:
hybrid    → 混合检索
semantic  → 语义(向量)
keyword   → 关键词(BM25)
问题是:不是每个知识库都支持所有 mode。
FAQ 库       → 没有向量索引
纯向量库     → 没有关键词索引
纯关键词库   → 没有向量索引
旧的实现是:直接拒绝。
用户/模型请求 mode=keyword
  → 这个库不支持
  → ❌ 报错:"不支持该 mode"
这是个很差的体验:
模型不知道这个库支持什么
  → 它按 schema 说的选了 keyword
  → 被拒绝
  → 它可能重试、可能放弃、可能换个库
  → 而用户看到的是"检索失败"
新实现:降级,但明说。
请求 mode=keyword(库里没有关键词索引)
  → ✅ 用语义检索回答
  → 结果里带:requested_mode: "keyword", mode_fallbacks: [...]
  → 模型渲染里带 <mode_fallback>
  → 显示的是"实际使用的 mode",而不是永远显示 semantic
三个设计点
① 降级而不是失败
能力不满足 → 用最接近的能力兜住(而不是报错)
因为"用语义检索回答关键词查询"虽然不理想,但比"什么都不返回"好得多。
② 把"降级"显式告诉调用方
requested_mode  → 你请求的是什么(保留原始意图)
mode_fallbacks  → 实际发生了什么降级
"我按你说的做了,但方式和你期望的不同" —— 这个信息很有价值:
对模型:它知道这次检索不是它想要的方式 → 可以调整策略
对用户:可追溯(为什么这次结果不太一样)
对调试:能看出"降级"是不是常态 → 决定要不要补索引
③ 最后那半句最诚实
渲染现在显示实际使用的 mode,而不是永远显示
semantic
"而不是永远显示 semantic" —— 说明旧的实现会显示一个错误的 mode。
旧:实际用了 keyword,界面显示 semantic   ← 撒谎
新:实际用了什么就显示什么,并标注降级     ← 诚实
"UI 上显示的内容必须反映实际发生了什么" —— 这是可观测性最基本也最容易被违背的原则。
因为一旦界面撒谎:
用户基于错误信息做决策
  → 排查问题时被误导
  → 积累成"这个系统不可信"
十二、代价:平台级复杂度的四个来源
前面讲的都是收益。现在讲代价,而且这个项目的代价很典型。
代价一:安全面极大
v0.8.2 里有一条很值得注意的安全改进:
Whitelist-only outbound mode ——
SSRF_DNS_WHITELIST_ONLY=true在 DNS 解析之前就拒绝SSRF_WHITELIST之外的任何主机,关闭离线部署中基于 DNS 的外泄。
"在 DNS 解析之前拒绝" —— 这个时机选择很关键:
错误做法:解析 DNS → 得到 IP → 判断 IP 是否在内网 → 拒绝
  问题:DNS 查询本身已经发出去了!
       → 攻击者可以通过"查询哪个域名"来编码并外泄数据(DNS exfiltration)

正确做法:在解析之前,先看域名白名单 → 不在白名单就不解析
  效果:连 DNS 查询都不会发出
"拒绝的时机要足够早" —— 早在副作用发生之前。
而这也说明它面对的攻击面:
用户上传文档          → XXE、恶意文档
文档里有 HTML/JS      → 渲染时的注入
Agent 访问 URL        → SSRF、DNS rebinding
Agent 生成 HTML 产物  → 在沙箱里渲染
本机浏览器            → 借用户身份访问站点
桌面沙箱(XFCE)      → 完整图形环境
对象存储              → 凭据、重定向、SSRF
对比一下前面几篇:
| 项目 | 主要安全面 |
|---|---|
| OpenCodeReview | 读代码(本地,低风险) |
| OpenCode / Goose | 改代码(本地) |
| OpenMAIC | 渲染 HTML + 生成视频(服务端) |
| WeKnora | 文档解析 + URL 访问 + 沙箱 + 用户浏览器 + 桌面 + 对象存储 |
它的攻击面是前面所有项目里最宽的——因为它同时有"文档理解"、"网络访问"、"代码执行"、"浏览器控制"、"图形桌面"五种能力。
而每一种能力被 Agent 自动调用时,都是一条潜在的注入路径。
代价二:兼容成本极高
数一下它要支持的维度:
数据源:本地文件 / Confluence / 钉钉文档 / 语雀 / IMA / …
沙箱后端:Cube / E2B / Docker / 桌面模板 / 本机(Seatbelt)
模型厂商:27 个内置厂商
客户端:Web / 桌面(macOS) / 小程序 / CLI / Chrome 插件 / IM
协议:MCP client / MCP server / HTTP API / SSE
语言:中 / 英 / 日 / 韩
27 个模型厂商这个数字最能说明问题。而这背后是一整套三层抽象(v0.8.2 的"模型目录"改动):
Model catalog —— 模型集成在协议、厂商、目录三层上重建:27 个内置厂商,一个生成的目录填充上下文窗口、最大输出、推理级别、视觉支持,模型编辑器里有 "resolved call" 面板,支持按模型的协议覆盖和协议兼容 JSON,
GET/POST /models/catalog/resolve,以及一个部署覆盖文件(config/models.json、MODELS_CONFIG)。
拆开看这三层:
协议层    → 同一套协议兼容多个厂商(OpenAI 兼容 / Anthropic / …)
厂商层    → 厂商级配置(endpoint、密钥、默认值)
目录层    → 每个模型的能力元数据(上下文窗口、最大输出、推理级别、视觉)
为什么要分三层? 因为变化的维度不同:
新出一个模型      → 只动目录层
厂商改了 API 版本 → 动厂商层
出现新协议        → 动协议层
"按变化的维度分层" —— 这是抽象层该怎么切的标准答案。
而 resolved call 面板这个细节也很有意思:
"显示最终解析出的调用是什么"
  → 因为配置有 3 层叠加,用户很难在脑子里算出最终值
  → 界面直接告诉他结果
这和我之前写 DeepSeek Harness 那篇里的 --dump-config 是同一个思路:配置分层之后,必须提供一个"看最终生效值"的手段。
代价三:一致性成本
当"三种能力共享同一知识库"时,就出现了一致性问题。
举几个从 CHANGELOG 里能看到的具体冲突:
"同标题条目跨类型复用现有页面"        → Wiki 的命名冲突
"整页重写被完成预算截断时继续,若仍不完整则拒绝" → 写入的原子性
"有歧义的单汉字自动链接被跳过"        → 自动链接的准确率 vs 覆盖率
"引用 chunk 包含图片说明"             → 跨层引用完整性
"同标题条目跨类型复用"                → 去重 vs 区分
而这条最能说明问题:
Wiki —— 整页重写在被完成预算截断时继续,如果仍然不完整则拒绝。
写一个 Wiki 页面
  → 输出被 max_tokens 截断了
  → 继续写(而不是留下半截页面)
  → 如果续写后还是不完整 → 拒绝写入
"宁可拒绝,也不留半截" —— 因为 Wiki 页面是要给人读的资产,半截页面的危害大于"这一页没写成"。
(这和 DeepSeek Harness 那条"宁可不留,也不留半截"是同一种洁癖——只不过那里是"日志",这里是"知识资产"。)
代价四:长任务带来的"卡住"问题
停止推进的文档被标记为 queued 或 stalled,并带
TASK_STALLED码
"stalled"(停滞)这个状态的存在,说明"卡住"是常态而不是异常。
文档导入是个长任务(解析、切块、向量化、抽取实体、生成摘要……)
  ↓
任何一步都可能卡住(外部 API 慢、文件太大、解析器挂了)
  ↓
如果没有 stalled 状态:
    → 任务永远显示"处理中"
    → 用户不知道是在跑还是死了
    → 只能干等
"给'卡住'一个明确的状态" —— 这是长任务系统的必需能力。
而它还需要配套:
可取消      → 上传面板有取消
可重试      → 上传面板有重试
可诊断      → stalled 有明确的 code
可见        → 整体进度
"长任务四件套:状态、取消、重试、诊断。" 缺任何一个,用户就会陷入"不知道该怎么办"的状态。
十三、和前面十一个项目放在一起看
| 知识在哪 | Agent 是什么 | 沙箱是什么 | 平台性体现在哪 | |
|---|---|---|---|---|
| LangGraph | 上下文 | 图的节点 | — | — |
| OpenHands | 上下文 | Runtime 的使用者 | 隔离执行 | — |
| browser-use | 页面 | 感知循环 | — | — |
| DeerFlow | 上下文 | Run 的驱动者 | provider | — |
| Hermes | 记忆 | 长驻主体 | — | 多实例 |
| OpenCode | 上下文 | 产品内核 | — | 多客户端 |
| Goose | 上下文 | MCP 客户端 | 可选 Docker | 扩展生态 |
| dsh | 日志 | 可替换插件 | 可选隔离 | 组装/Profile |
| OpenMAIC | 素材 | 内容生产者 | — | 产出物工具链 |
| OpenCodeReview | 上下文 | 确定性+Agent | — | 多入口 |
| WeKnora | 知识库(可维护资产) | 可管理的资源 | 可恢复工作空间 | 三种能力共享同一知识体系 ← 本篇 |
看最后一行和上面所有行的差别:
前面所有项目:Agent 是主体,知识是它的燃料
WeKnora:知识是主体,Agent 是它的使用方式之一
这个关系反转,是这篇文章最想表达的东西。
而一旦反转,架构上就必须长出:
知识要有生命周期     → 状态、stalled、版本、回滚
知识要能被引用       → 引用完整性
知识要能被维护       → wiki-fixer agent(Agent 维护知识)
知识要能被共享       → MCP server 把知识暴露出去
知识要能被追溯       → 活动记录、API key 名、引用出处
Agent 要能被管理     → Agent 成为资源(ID/头像/归属/分享)
执行要能被回归       → 沙箱检查点与对话 rewind 绑定
能力要能被扩展       → Skill(有契约、有版本、有租户隔离)
这九件事,是"知识成为主体"的必然要求。
十四、如果你想读它,建议的路线
第 0 步  README_CN.md(15 分钟)
         ★ 那张"查询资料用 RAG,处理多步任务用 Agent,整理知识用 Wiki"
         的三线图是理解全项目的入口

第 1 步  CHANGELOG.md 的 [0.8.2] 段(40 分钟)
         ★★ 全项目性价比最高的一段。它按能力分组列出了 v0.8.2 的所有改动,
         相当于一份"这个平台现在长什么样"的完整清单

第 2 步  internal/types/custom_agent.go(25 分钟)
         ★ Agent 作为资源:9 个内置 Agent + 预设类型 + 多租户字段

第 3 步  internal/agent/engine.go 的头部注释(15 分钟)
         ★ "引擎跨轮次无状态" + token 校准的一对估算器 + compactor

第 4 步  internal/sandbox/capabilities.go 的包注释(25 分钟)
         ★ "能力查询而非类型查询"。这是我认为最值得单独学的一条

第 5 步  internal/agent/checkpoint.go(20 分钟)
         ★ 尽力而为的检查点 + 降级检查点

第 6 步  internal/agent/skills/manager.go 的头部(20 分钟)
         ★ 三个环境变量契约 + "不经 LLM 中介的链式协作"

第 7 步  internal/browserskill/human.go(15 分钟)
         ★ 人机交接 + 超时三段(5 分钟 + 15 秒)

第 8 步  按需:internal/agent/{think,act,steer}.go、internal/mcpserver/、docreader/

不要从 frontend/ 开始
不要从 migrations/ 开始(表结构细节)
不要跳过 CHANGELOG —— 它是这个平台最好的架构地图
十五、我认为最值得带走的五个工程原则
第一:问"你能不能做",不要问"你是什么"
❌ if manager.GetType() == "cube" { 支持 shell }
✅ executor := manager.SessionShellExecutor(); if executor != nil { 用 }
能力查询(capability query)永远优于类型查询(type query)——因为"同一种类型在不同配置下,能力可能不同"。
第二:优化项失败,不应该影响主流程
检查点写失败 → 下一轮多做一次摘要(可接受)
             → 本轮不受影响(关键)
给每一个异步写入回答一个问题:"它失败了会怎样?"如果答案是"拖慢一点",那就绝不该让它阻塞主流程。
第三:确定性的数据传递,不要经过概率系统
❌ 技能 A 产出 → 告诉模型 → 模型理解 → 模型转交给技能 B
✅ 技能 B 直接从约定目录找到 A 的产出
能用文件系统(或任何确定性通道)约定的,不要绕一圈 LLM。 那不是"更智能",那是"更贵、更慢、更容易错"。
第四:降级要显式,界面不能撒谎
请求 keyword,实际用了 semantic
  → 结果里带 requested_mode 和 mode_fallbacks
  → 界面显示"实际使用的方式"
"我按你说的做了,但方式不同"——这个信息必须传下去。 而界面上显示的内容,必须反映实际发生了什么。
第五:改一个被引用的标识符时,先想想能不能不迁移
旧工具名 → 运行时映射到新工具名
  → 不需要数据迁移
  → 存量历史仍可渲染
数据迁移有停机窗口和失败风险;运行时映射只有一层间接。 对已经被大量引用的标识符,后者通常是更便宜的答案。
十六、工程评价
| 维度 | 评价 | 说明 |
|---|---|---|
| 产品完整度 | ★★★★★ | 文档 → 解析 → 检索 → Agent → 沙箱 → Wiki → 共享,闭环完整 |
| 架构原则性 | ★★★★★ | 能力查询、无状态引擎、降级诚实——多处体现了清晰的原则 |
| 多后端抽象 | ★★★★★ | 沙箱(Cube/E2B/Docker)、模型(27 厂)、数据源,抽象层次切得准 |
| 长任务工程 | ★★★★★ | 状态机、检查点、stalled 标记、取消/重试/诊断齐全 |
| 安全投入 | ★★★★☆ | SSRF 多层防护、默认只读、Seatbelt 沙箱;但攻击面客观最宽 |
| 状态设计 | ★★★★★ | 引擎无状态 + 沙箱有检查点 + 知识有版本,三种状态各得其所 |
| 兼容性工程 | ★★★★★ | 工具别名映射(零迁移)、mode fallback、多语言多协议 |
| 文档与更新 | ★★★★★ | CHANGELOG 写得极详尽(可直接当架构文档读) |
| 部署复杂度 | ★★★☆☆ | 依赖多(向量库、图库、沙箱、对象存储),完整跑起来门槛不低 |
| 上手门槛 | ★★★☆☆ | 有 Lite 模式和 Docker Compose,但平台概念多 |
| 小项目适用性 | ★★☆☆☆ | 它是平台,不是框架;但它内部单个模块的模式非常可借鉴 |
| 工程参考价值 | ★★★★★ | "知识作为资产"这一块的最佳参考,且内部有大量可复用的小模式 |
它最大的优点:
它把"知识"从"Agent 的燃料"提升成了"平台的主体"——而且不是靠一句定位,是靠一整套机制(生命周期、引用完整性、版本、维护 Agent、对外共享、审计)。
它最大的缺点:
平台级复杂度,且攻击面最宽。 文档解析、网络访问、代码执行、浏览器控制、图形桌面——五种能力叠加,每一条都是潜在的注入路径。它的安全投入也很可观,但这说明它必须投入。
最值得你立刻拿走的三点:
① 能力查询 > 类型查询
   → 不要问"你是什么",要问"你能不能"

② 优化项失败不能阻塞主流程
   → 给每个异步写入回答"它失败了会怎样"

③ 确定性传递不要经过 LLM
   → 能用文件/约定传的,不要绕模型
十七、不要抄 WeKnora,要学 WeKnora
最后一节照旧,而且这次尤其要说清楚。
它不是一个"该不该抄"的项目——因为它根本抄不动。
依赖:向量库 + 图库 + 沙箱集群 + 对象存储 + 27 家模型 + 多语言
模块:agent / sandbox / browserskill / mcp / mcpserver / docreader / datasource / ...
如果照搬它的架构,你会得到一个有 30 个模块、在你只有 3 个用户的场景下大部分都在空转的系统。
但它内部有一批"可以单独拿走"的模式,而且这些模式和它的规模无关:
| 可拿走的模式 | 什么时候用得上 |
|---|---|
| 能力查询接口(返回 nil 表示不可用) | 任何时候你有"多种后端 + 能力差异" |
| 无状态引擎 + 每轮重建历史 | 你的 Agent 需要水平扩展或能重启 |
| 尽力而为的检查点 | 你有任何"优化项"类写入 |
| 降级检查点(存原文 + 标记) | 你有任何"摘要/翻译/索引"类步骤 |
| 运行时映射代替数据迁移 | 你要改一个已被引用的标识符 |
| 环境变量契约(跨版本稳定) | 你有"平台 + 插件"的关系 |
| "实际使用的方式"要显示出来 | 你有任何 fallback / 降级逻辑 |
| 人机交接的类型化 + 超时分段 | 你的自动化里必须有人工步骤 |
| stalled 状态 + 取消/重试/诊断 | 你有任何长任务 |
这九个模式,每一个都可以独立用在你的项目里,而且都不需要"先有一个平台"。
而 WeKnora 最值得学的地方,其实是一个判断:
它想清楚了"知识"在这个系统里是什么地位——不是燃料,是资产。
然后所有架构都从这个判断推出来。
先想清楚你的系统里"什么才是主体",架构会自己长出来。
十八、结语
回到标题那个问题。
知识库是怎么长成一个 Agent 平台的?
从源码里能看到清晰的三个阶段:
第一阶段:文档 → 解析 → 切块 → 向量化 → 检索
          (知识库作为 RAG 的数据层)

第二阶段:+ Agent(ReAct 循环、工具、沙箱、技能)
          知识开始被"使用",而不只是被"查询"

第三阶段:+ Wiki(自动组织、知识图谱、版本回滚、维护 Agent)
          知识开始被"维护",走出了一条反哺的路
而第三阶段是关键——因为它是唯一一个"知识反过来变成生产物"的阶段:
第一、二阶段:文档 → 知识(单向)
第三阶段:    知识 → Wiki → 更好的知识(循环)
有了这个循环,"知识库"才真正变成了"平台"。
而这个演化最终给出的答案是:
当知识成为资产,Agent 才有了可以积累的东西。
前十一篇赏析里,Agent 学到的每一件事,都随会话结束而消失(除了 Hermes 的个性化记忆)。而这里,Agent 的产出会沉淀成知识,知识又成为下一次任务的起点。
最后,我想用这个项目里最打动我的一段代码收尾——不是某个精巧的算法,而是一句注释里对"失败"的态度:
// ... Best-effort: a failed write costs the
// next turn one more summarization, never this turn anything.
"写失败最多让下一轮多做一次摘要,绝不影响本轮。"
这句话里有三个值得学的东西:
① 它明确分析了失败的影响范围(而不是笼统地"处理错误")
② 它接受了"优化项可以失败"(而不是追求 100% 成功)
③ 它划清了"绝不能影响"的边界(本轮主流程)
一个成熟的系统,不是"什么都不出错"的系统,而是"想清楚了每一处失败会造成什么后果"的系统。
附录 · 本文引用到的真实位置
| 内容 | 位置 |
|---|---|
| 三线定位 / 产品介绍 | README_CN.md |
| v0.8.2 全部改动(BrowserSkill / MCP Server / 工具合并 / 别名 / 上下文 / SSRF) | CHANGELOG.md 的 [0.8.2] - 2026-09-24 |
| 版本号 | VERSION(0.8.2) |
| Agent 作为资源 / 9 个内置 Agent / 预设类型 | internal/types/custom_agent.go |
| token 预算按模式分配 | internal/types/agent.go:56 |
| 无状态引擎 / token 校准 / compactor | internal/agent/engine.go(头部注释) |
| 尽力而为检查点 / 降级检查点 | internal/agent/checkpoint.go |
| 能力查询而非类型查询 | internal/sandbox/capabilities.go(包注释 + SessionCapabilityProvider) |
| 沙箱多后端与终端/桌面 | internal/sandbox/{cube_*, docker_*, e2b_*, desktop, orphan_reaper, docker_idle_sweeper}.go |
| 人机交接与超时分段 | internal/browserskill/human.go |
| Skill 环境变量契约 | internal/agent/skills/manager.go(头部常量注释) |
| Skill 租户隔离 | internal/agent/skills/{source, tenant_source}.go |
| ReAct 三段式 | internal/agent/{engine, think, act, steer, finalize}.go |
| MCP 双向 | internal/mcp/、internal/mcpserver/ |
| 数据源同步 | internal/datasource/ |
| 文档解析 | docreader/ |
关于 star 数:文中未引用具体 star 数量。该项目在 README 中挂有 Trendshift 徽章,可确认其处于增长榜单中;如需精确数字,建议以 GitHub 仓库页为准。
系列导读:本文是「AI Agent 项目赏析」系列第 12 篇。
1.  LangGraph          → Workflow Agent(任务怎么编排)
2.  LangGraph(进阶)   → Agent Orchestration
3.  OpenHands          → Coding Agent(怎么执行真实动作)
4.  browser-use        → 浏览器 Agent(怎么感知真实界面)
5.  DeerFlow 2.0       → SuperAgent(长任务怎么跑不死)
6.  Hermes Agent       → Persistent Agent(怎么自我进化)
7.  OpenCode           → Terminal Agent(产品怎么组织)
8.  Goose              → MCP-native Agent(工具怎么变成服务)
9.  DeepSeek Harness   → Plugin-native Runtime(连 Loop 都是插件)
10. OpenMAIC           → Product-oriented System(产出物才是主角)
11. OpenCodeReview     → Hybrid Agent(什么时候确定性,什么时候交给 Agent)
12. WeKnora            → Knowledge Agent Platform(知识才是主体)← 本篇
十二篇之后,这条赏析路线覆盖的形态:
怎么编排 → 怎么执行 → 怎么感知 → 怎么长跑 → 怎么进化
→ 怎么组织产品 → 怎么扩展 → 怎么组合 → 怎么交付产出物
→ 怎么划分确定性与模型 → **怎么让知识成为可以积累的资产**
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2401_85223846/article/details/166728387

