

缓存问题
缓存穿透
缓存穿透就是在短时间内有大量的请求请求到一个数据不存在的数据,不加以处理就会一直查询数据库给数据库造成很大的压力。
解决方案
缓存空数据,当查询到一个数据库不存在则在Redis中把这个数据设为空值,此时请求再次进来时就是查询Redis了而不至于造成缓存穿透的问题。这个方案的缺点是会消耗内存,并且由于缓存的是一个null数据可能后续数据被写入了不能及时写入缓存而出现短暂的数据不一致问题。
布隆过滤器。布隆过滤器的实现原理是使用Redis的位图实现的,位图相当于一个数组,当有数据写入时会通过hash算法找到对应的位置把该位置标为1,后续有请求查找数据时如果查到的布隆器是0的话则直接返回,不过这个布隆过滤器由于是使用hash算法实现的,所以有可能出现误判率。目前已经有很多插件实现了布隆过滤了,比如reidsson,并且Reidssion还能控制误判率。
缓存击穿
缓存击穿就是当一个 key设置了过期时间,当这个过期时间到了但有大量请求来到时会直接打到数据库瞬间把数据库压垮
解决方案
加互斥锁:当数据查询缓存未命中则获取到互斥锁然后重建数据,在这个期间是不允许其他线程访问的,所以不会造成缓存击穿。加互斥锁是强一致但性能差。
使用逻辑过期:就是不会设置key过期但是每次请求时会查询这个key是否过期,过期了则获取一个redssion的互斥锁,然后开启一个新的线程来进行缓存同步,该线程直接返回旧数据,其他线程来到如果获取锁失败也是直接返回旧数据。设置过期时间保证了高可用但不能保证一致性。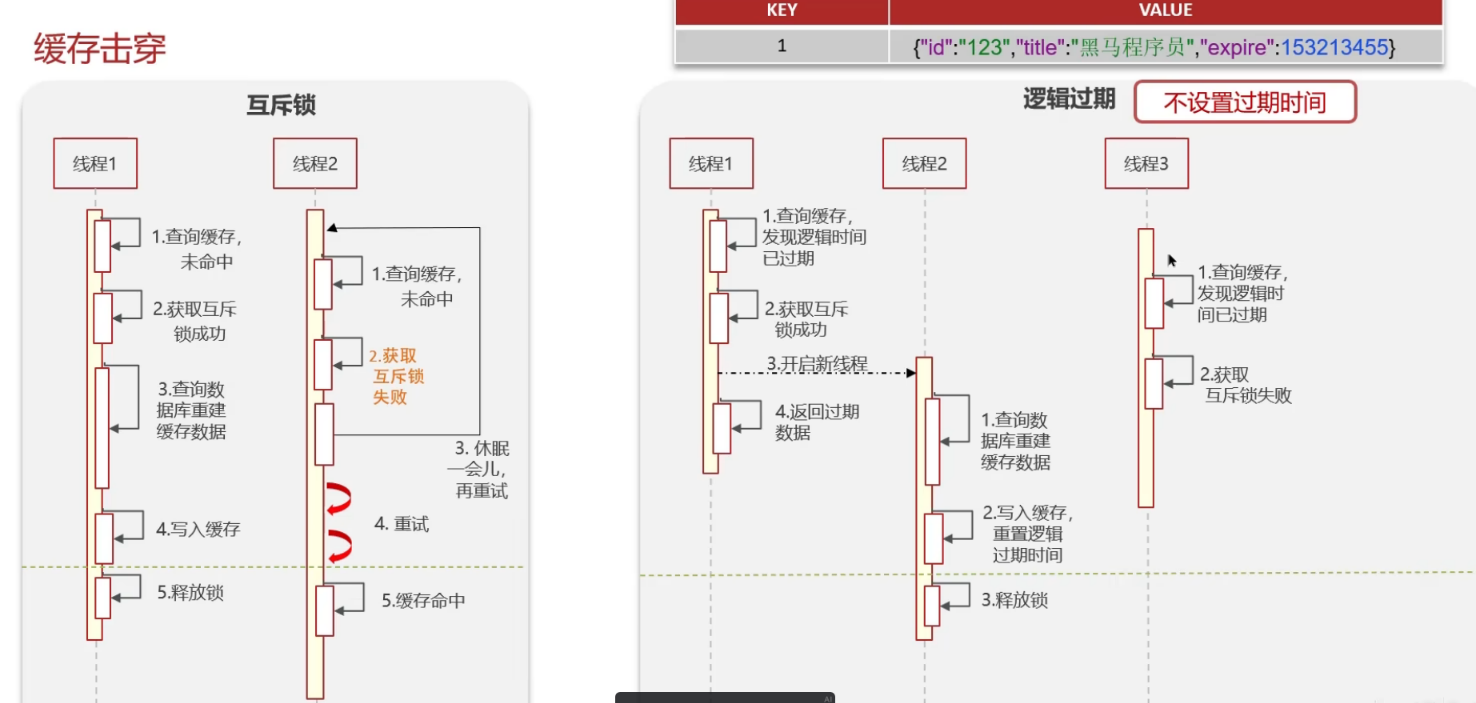
缓存雪崩
缓存雪崩是把key设置了大量相同的过期时间或者服务器突然宕机造成大量的请求打到数据库给数据库造成了很大的压力。
解决方案
针对大量的key设置相同的过期时间,我们可以采用随机数的方法给key设置成随机过期时间;针对Redis服务宕机的解决方案 可以使用Redi的集群模式,可以使用哨兵模式,集群模式。
双写一致性
双写一致性指的是数据库和Redis之间的数据一致性问题。主要是当数据库的数据进行增删改的操作对Redis的数据一致
解决方案
延迟双删
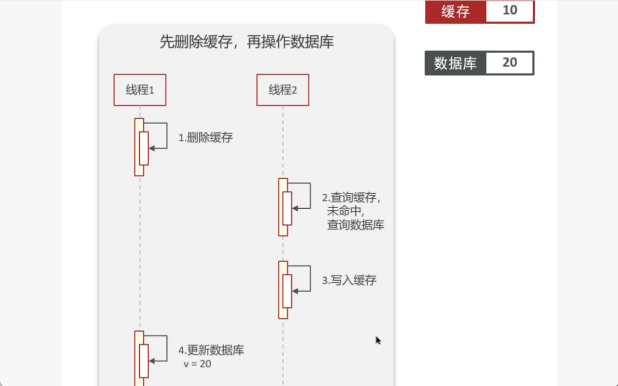
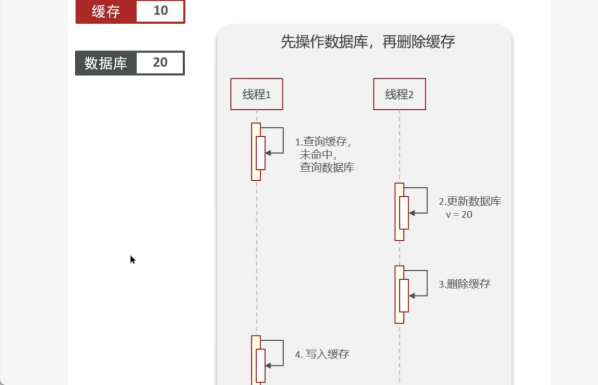
延迟双删就是先删除一次缓存然后修改数据库过一段时间后在删除数据库。为啥要删除两次缓存?假设我们是先删除缓存在操作数据库时:如下图当我们删除缓存瞬间有另一个线程来查询数据,查不到则查数据库,查完数据库在写入缓存,此时删除数据库的线程更新数据库,这时就会造成数据库于缓存之间的数据不一致了;先操作数据库在删除缓存呢?假如在有人查询数据的时候,缓存未命中然后他去查询数据库,查完数据库第二个线程来了,他去操作数据库然后删除缓存,第二个线程结束第一个线程开始执行写入缓存,此时就会出现数据不一致的效果。
延迟双栅呢是等果断时间又删除缓存,此时即使别人查数据的时候查到新的数据就能写入新的数据了,但是延迟多长合适呢?延迟主从同步的时间,但这段时间还是会出现脏数据,所以这个方案是在高可用的情况下尽量一致性
直接加悲观锁。加锁锁住直到增删改数据写入数据库,修改缓存才释放锁,悲观锁由于读写都用同一个🔒锁住故而性能很低,一般用在非常需要强一致的时候,比如强票,秒杀等业务。加读写锁。很多情况是读多写少,读与读直接是不涉及到脏数据的问题的,只有读与写之间才会存在脏读的问题,所以采用读写锁,读与读的时候不回加锁赌住,但一旦有写的时候会连把读线程也锁住实现双写一致性。读写锁目前使用较多的是redisson的读写锁。
Redis的持久化
很多时候,Redis会可能服务器的宕机,黑客的入侵等导致内存中的数据会被删除,所以Redis缓存持久化也是一个面试重点
解决方案
RDB持久化过程:主进程会执行bgsave复制一个页表,子进程指向这个新生成的页表,然后边读边生成rdb快照文件,持久化完成会用新的rdb文件覆盖旧的rdb文件。如果持久化过程有写操作则复制一份内存的副本在这个副本写操作,子进程持久化还是在旧的内存上做持久化。后续也会以这个新的副本作为主进程的数据。因为这时的写操作和持久化有有一定的数据差异,所以如果持久化有写操作服务突然宕机就会出现数据的不一致(AP)。因为rdb是一个快照的二进制文件,记录的是某一个时刻的数据,所以恢复的很快
AOF持久化是保存Redis的增删改的所有命令如set name lisi到缓存区AOF文件中,后续把AOF文件刷盘到磁盘。AOF保存命令有三种刷盘方式,①每条指令执行完立即写入,这个方式是强一致但性能差。②每秒刷盘,每过一秒刷一次盘,这个也是默认的刷盘方式,最多只有一米的数据不一致,性能也很好,Redis主要是缓存这点数据丢失也在接受范围。③交给操作系统刷盘,性能好,丢数据风险大。AOF还有重写机制。比如一个key的value可能修改了三次,但只有最后一次是需要的,如果都记录会大大增大内存压力,所以AOF可以使用aof-rewrite来瘦身,aof-rewrite的机制是fork一个子进程读取Redis的key-value生成一个新的AOF文件,新文件生成后覆盖旧的AOF。由于AOF保存的是Redis指令,所以重启回复的过程很慢,体积也很大。 一般来说AOF和RDB是一起使用的,RDB做备份,AOF做数据恢复
Redis的数据删除策略
惰性删除
Redis的惰性删除是指设置key的过期时间但不管他只有下次用到了才会去查看这个key有没有过期,过期了则删除。惰性删除的好处是对cpu友好,只有查的时候才判断这个key是否过期,不会浪费太多的CPU资源检查key,缺点是占用内存,即使这个key过期的还是不会删除,会一直占用内存。
定期删除
定期删除是每过一段时间就抽查一部分key检查是否过期,过期则删除。定期删除Redis提供了两种策略:SLOW:定时任务,默认10he及100ms执行一次检查删除每次执行不会超过25ms;FAST:频率不固定,两次定期删除之间大于2ms,单次执行不超过1ms。定期删除恰好和惰性删除相反,定期删除消耗CPU资源,但能节省内存空间
企业的选择
再目前的企业开发中是二者配合使用的大部分的key是使用惰性删除等用户访问了才删除,少部分长期没人使用的key会选择定期删除。
数据的淘汰策略
这个淘汰策略是指当内存满了,Redis会怎么处理。Redis提供了八种淘汰策略。记忆方法,allkeys是全部key,valatile是看过期的TTL的key,lru是最久访问,lfu是访问最少,random是随机,ttl是剩余时间,noeviction是不栅。
noeviction:默认策略,不淘汰,内存满拒绝写入(单独记)
2. 🕒 volatile系列(只在设了过期时间的key里面选,4个)
- volatile-ttl:剩余寿命短的优先删
- volatile-random:过期key随机删
- volatile-lru:过期key里,很久没访问的删
- volatile-lfu:过期key里,访问次数最少的删
3. 📦 allkeys系列(全部key,不管有没有过期,3个)
- allkeys-random:全部key随机删
- allkeys-lru:全部key,很久没访问优先删
- allkeys-lfu:全部key,访问次数最少优先删
在企业中使用最多的是allkeys-lru,在所有key中选很少使用的栅。
Redis分布式锁的使用
在抢卷业务中使用到了分布式锁,在抢卷业务中不加锁会产生超卖超买问题,加锁如果只加简单的synchronized锁,在分布式项目组一般会多实例部署,synchronized无法解决线程安全问题,所以在抢卷项目中使用了分布式锁来进行加锁。
分布式锁呢使用的是redssion分布式锁,redssion分布式锁使用的是Redis的setnx+lua脚本实现的,保证了原子性。redssion控制过期时间采用的是看门狗机制,这个看门狗是开启一个新的线程来检查执行业务线程的分布式锁的时间的,当获取锁的时间默认值10秒就会的自动给这个锁续期来保证业务不会因为锁过期导致别的线程执行造成的脏数据。
redssion还是一个可重入的锁,他的可重入底层是采用哈希结构实现的,key存线程的唯一标识线程ID,value存当前的重入次数,当一个线程执行完业务执行会del删除锁,执行删除锁就会扣减一次value值,当value值变成0的时候就会释放锁。
redisson分布式锁是如何解决主从一致性问题的?redisson解决主从一致性问题提供了红锁,但是如果使用红锁后会使得整个业务的效率非常低,Redis官方也不建议使用,因为Redis主要是高可用不是强
Redis主从一致性
Redis的主从一致性有是靠全量同步和增量同步解决的。全量同步是正常同步,增量同步是指从节点宕机了等问题的。
全量同步
全量同步的流程:从节点进行数据同步是都会携带replid和offset发给直节点,主节点判断replid是否和自己的一样,不一样则返回自己的replid给从节点并且使用bgsave生成一个RDB文件一并返回给从节点,从节点根据这个RDB文件进行数据同步。在生成RDB文件的时候如果有命令来执行,主节点会生成一个repl-baklog文件记录,后续从节点第n次进行数据同步时会携带replid和offset给主节点,主节点根据replid判断是否第一次同步,offset判断是否超过阈值要开启增量同步,也会根据从节点offset和主节点的offset来传从节点落后的repl-baklog。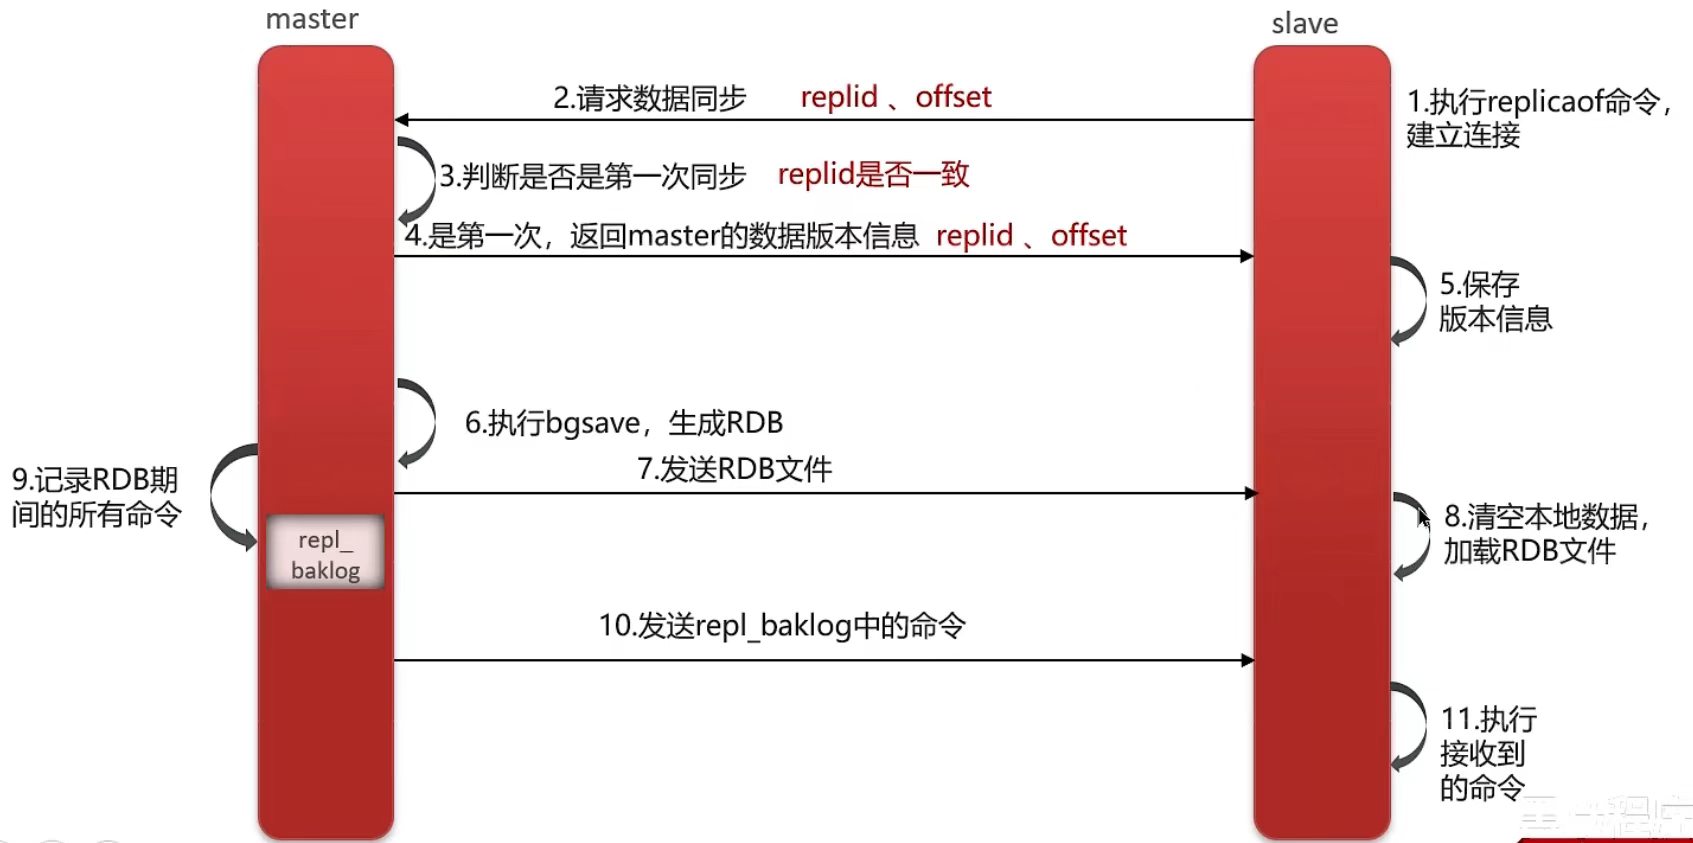
增量同步
增量同步是当从节点宕机等出现了比价严重的数据不同步时触发。增量同步从节点能正常使用了,会携带replid+offset给主节点,因为是增量同步,replid一定相同所以不会走全量同步。主节点收到增量同步的消息后会根据offset从repl-baklog获取到要同步的数据复制到缓冲区然后发送cont inue,等要同步的数据全都复制完发送给从节点同步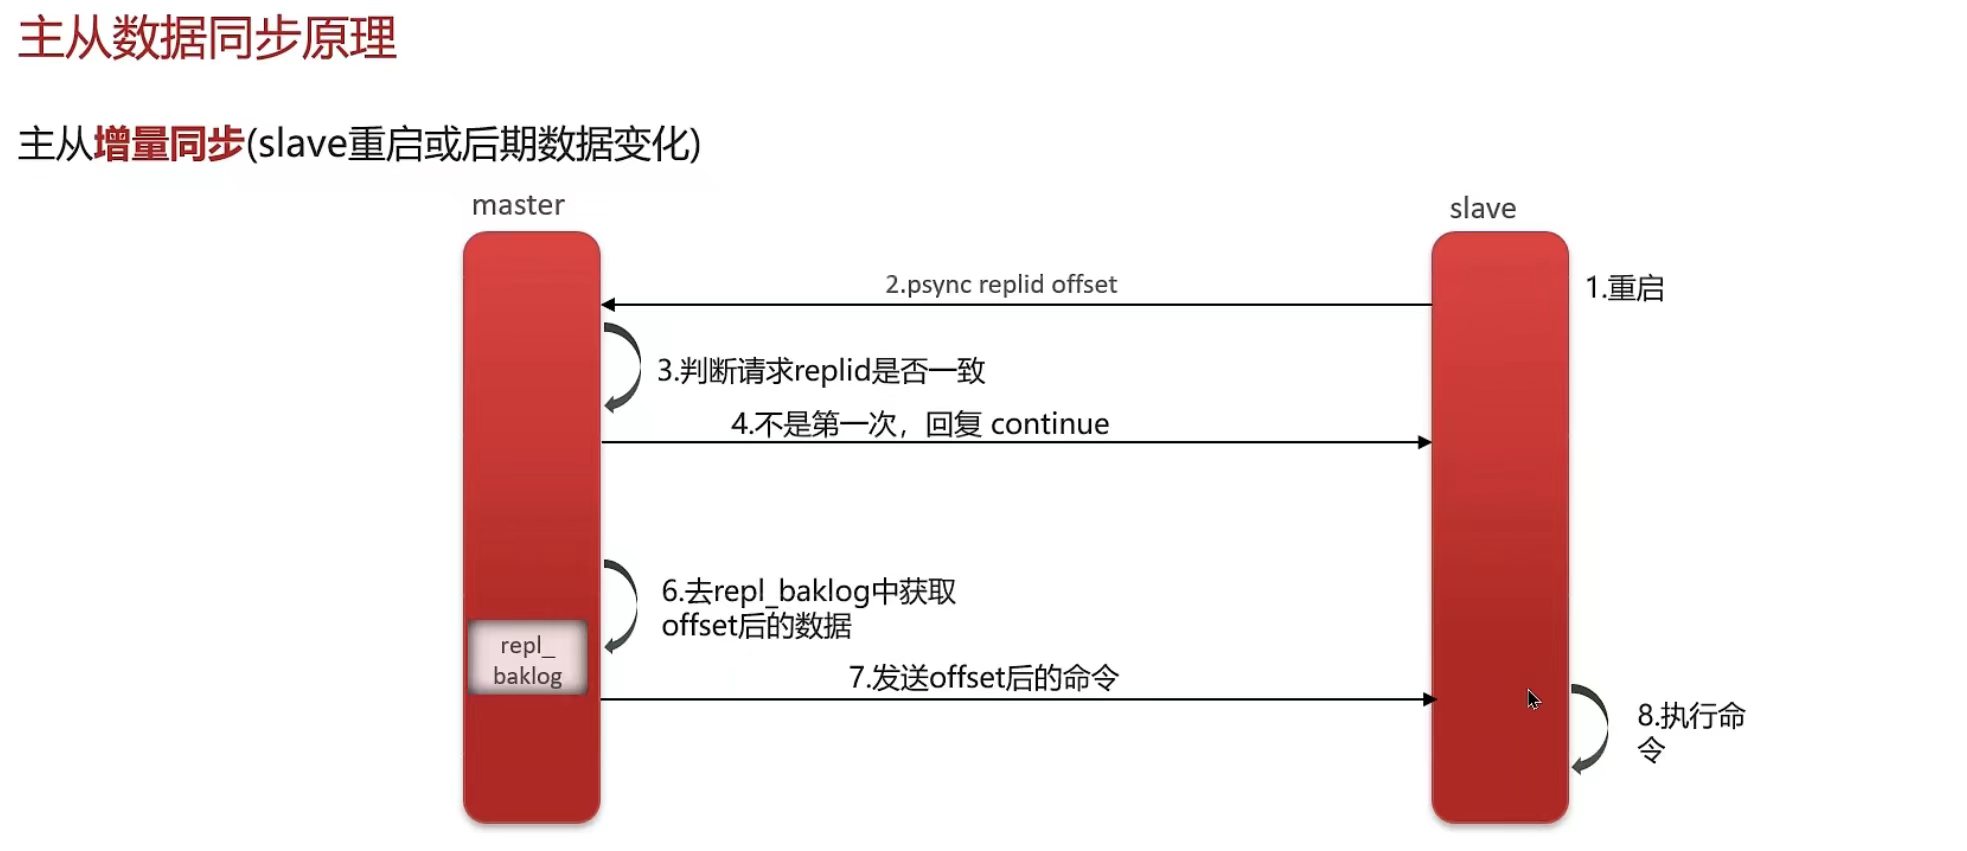
Redis的哨兵模式和脑裂
哨兵模式
Redis的哨模式是指会有几个sentinel充当哨兵,他们会去监控主节点是否出现故障,出现故障就会将一个slave升级为主节点,并通知Java应用;旧的主节点master恢复后也会变成新的从节点。
sentinel是通过每秒ping主节点来检查主节点master是否健康,如果未收到响应则会把这个主节点判定为主观下线。当超过半数的sentinel判定主节点master主观下线则这个主节点就会变成客观下线。
哨兵模式重新选举从节点的依据是①判断那个节点与主节点断开的时间短则直接升级为主节点;②如果第一个相同则判断slave-priority的大小,数值越小则优先级越高,slave-priority是人工设的③前面的都相同则则看offset,offset越高则优先级越高。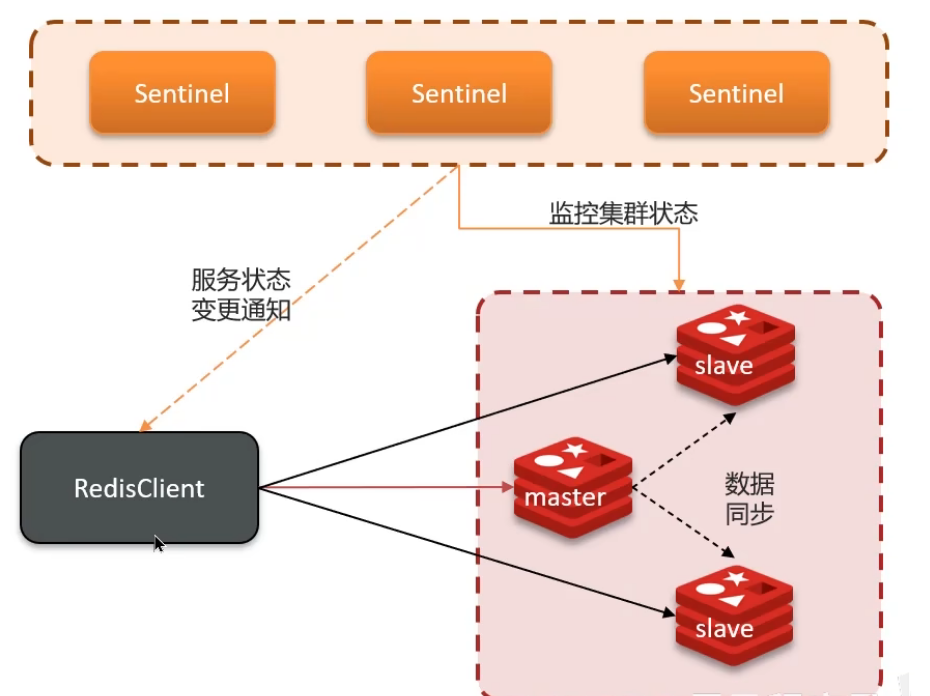
Redis的脑裂
什么是脑裂
脑裂就是指master由于网络原因与哨兵失去联系了,哨兵重新在slave选举了新的master,但旧的master不知道自己已经不是老大了还在接收数据,当旧的master网络正常后会变成一个从节点,自己的数据会清空,此时会出现在有两个master时旧的master接收到的数据就会被清空,导致数据丢失。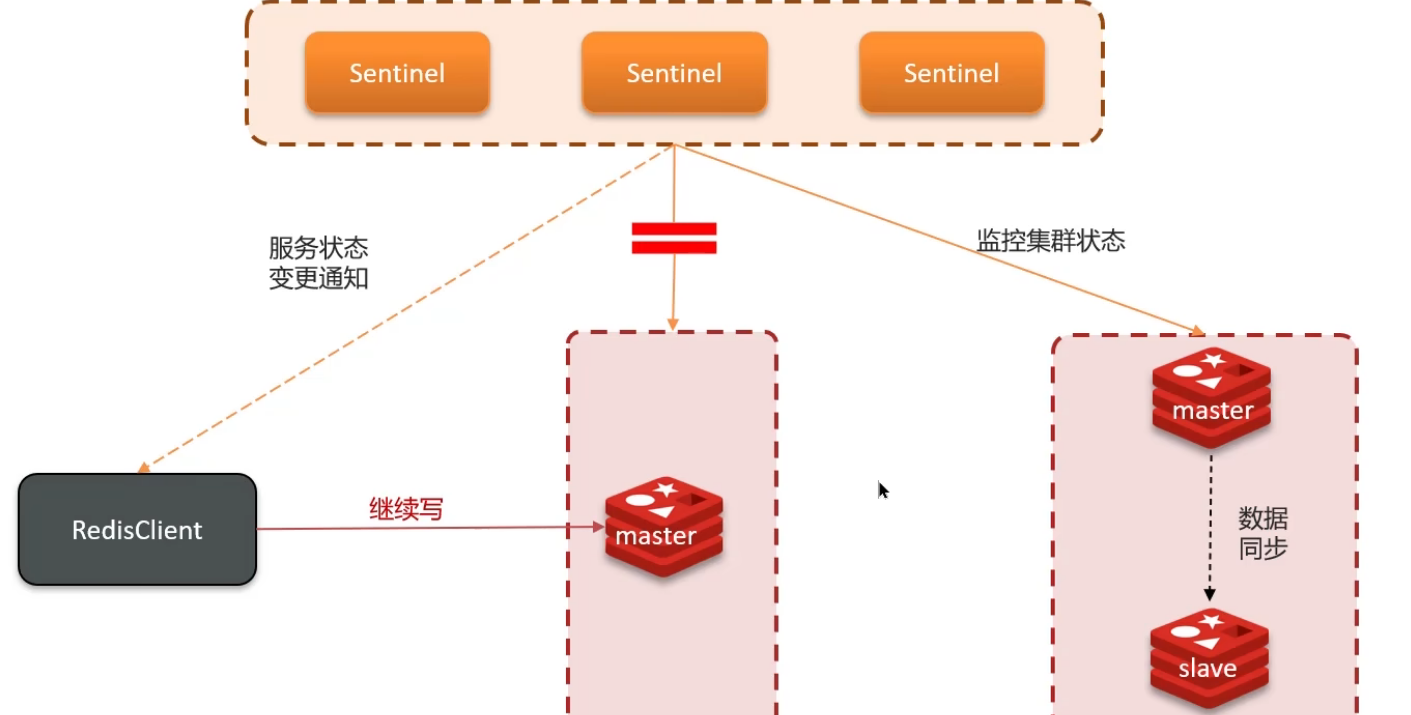
解决方案
Redis的解决方案是可以配置两个参数:min-replicas-write和min-replicas-max-lag两个可以配置的参数,前者代表至少存在多少节点能,后者表示数据复制同步的延迟不能超过多少秒,只能两个达标才运行Java应用对Redis操作。
Redis的分片集群
Redis的分片集群的意思是创建多个master节点,节点之间通过心跳相互判断主节点之间是否健康,主节点还可以使用主从模式提高读写的效率,并且由于每给主节点存的数据不一样还能有多个注解点还能存更多的数据。以下就是他们的工作模式
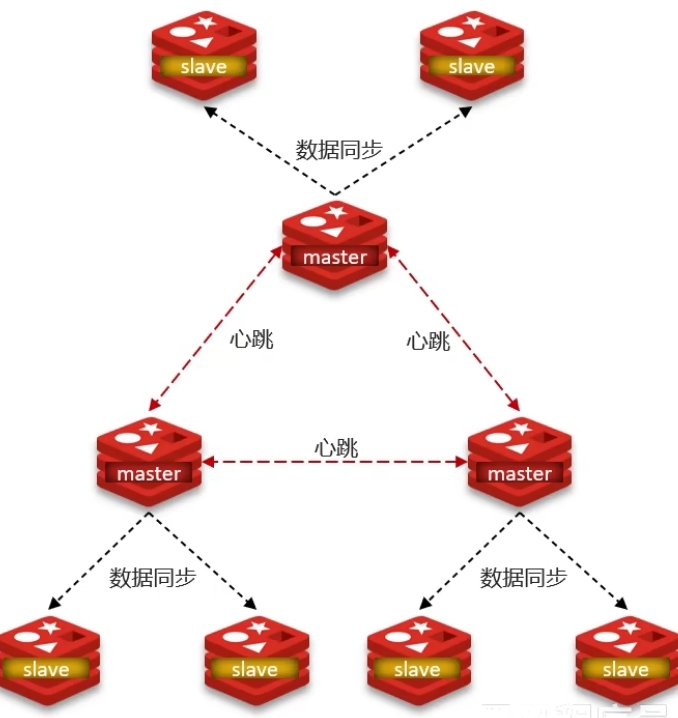
分片集群的数据读写
分片集群是以哈希槽来解决读问题的,Reidis集群有16384个哈希槽,当数据写入时会根据数据的key来通过哈希运算算出存放在那个节点,读也是一样通过计算key的哈希值来去对应的哈希槽读取数据;这个哈希值是可以自定义的,如set{aaa}name zhangsan.
分片集群的主节点故障
分片集群如果如果主节点故障了也是和哨兵机制一样需要半数的master判定这个主节点挂了才算真正的挂了,当这个主节点真的挂了会重新选举主节点,主节点的选举是offset的优先选择。
分片集群的扩容与缩容
扩容:分片集群的扩容是分配好哈希槽,然后在线的把旧的master的哈希槽的数据传给扩容的master,在线迁移,不会停机,单线程执行
缩容:缩容是把需要把需要下线的master的槽的数据全部迁移到其他master在下线,没有迁移完是不会下限的。
Redis为啥那么快?
①最主要的是Redis的读写都是在内存上的,内存的读写速度非常快。
②Redis的网络读写采用了io多路复用,在Redis的数
③某部分采用了多线程。
IO多路复用
据处理中,他的读写操作都是内存上的操作很快,但网络受限就很大,所以他使用io多路复用能极大的提速。
什么是io多路复用呢?
io多路复用是指利用单线程去监听多个socket,挡有socket接受到数据时会通知用户进程,用户进程收到socket的消息会堵塞线程去处理数据。io多路复用的通知方式主要有三种:select,poll和epoll。select和poll的通知方式是通知但不确认是那个的通知,需要用户进程便利寻找;epoll的通知方式是通知用户进程那个socket已经就绪了,Redis采用的是epoll实现的io多路复用。
传统的堵塞io为什么与io多路复用比那么慢?
传统的堵塞io是用户进程堵塞的去等待网卡传来数据。这段时间都是堵塞等待的,非常影响效率。网课传来数据,用户进程拷贝数据到用户缓冲区,拷贝这个时间段也是堵塞的,可以看到堵塞io很多地方堵塞影响性能
什么地方采用多线程?
在读网络请求部分和解析数据部分,写响应三个部分采用了多线程,这两部分的操作都是与网络有关,所以采用了多线程。
为什么主进程不用多线程?
Redis如果主进程采用多线程就要考虑线程安全问题,此时就要加锁来解决线程安全问题,加锁会引起锁的竞争极大消耗了CPU资源,不符合Redis的高可用
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2502_92022936/article/details/166248621

