

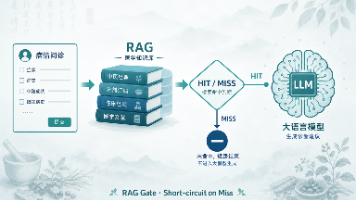
六经辨证准确率怎么评?659 例金标准 + RAG 未命中短路的 Java/Flask 实战拆解
声明:业余项目技术复盘,已脱敏,不含真实病例。
Demo:https://gitee.com/trouble_lonely_love/blog-demos →demos/tcm-rag-pipeline-demo
要解决什么问题
做一个「标准问诊 → 六经辨证建议」的服务时,常见坑是:
- 直接把问卷丢给大模型 → 贵、慢、还容易胡编
- 链路很长(整理病例 / 检索 / 推理)→ 同步 HTTP 容易超时
- 说「准确率很高」,却说不清评测分母和判定标准
本文分享一套更工程化的拆法:业务服务与辨证服务分离 + RAG 门禁 + 异步进度 + 可复现落盘 + 可说清的评测口径。
架构怎么拆
前端(小程序 / Web)
  → 业务后端(Java):账号、方案、预约等
       → HTTP 调用辨证服务
  → 辨证服务(Python / Flask)
       问诊整理 → RAG → Prompt → 模型 → 落盘
| 选择 | 原因 |
|---|---|
| Java 管业务,Flask 管辨证 | 智能侧 Prompt/RAG 迭代快,和事务解耦 |
| 知识库用 RAG 托管 | 交付快,切片与检索开箱 |
| RAG 未命中就停止 | 没有依据硬生成,幻觉和废 Token 都高 |
| 异步 Job + 轮询 | 长链路可展示阶段进度,避免网关超时 |
主流程(按阶段)
| 阶段 | 做什么 | 要点 |
|---|---|---|
| case_text | 标准问诊 → 自然语言病例 | 失败可用模板拼接兜底 |
| rag | 检索中医知识库 | 空结果 直接结束,不进模型 |
| prompt | 组装约束后的提示词 | 病例 + 检索片段 + 结构约束 |
| model | 大模型推理 | 空响应可有限重试 |
| save | 落盘 | 请求、chunks、Prompt、结果都留下,便于复盘 |
进度接口形态:
POST /api/diagnose/start  → { job_id }
GET  /api/diagnose/progress/<job_id>
  → status / stages[] / partial / result / error
准确率怎么评才站得住
这里给一套可对外讲清楚的口径(供同类项目参考):
- 先有一批带金标准标签的样本(本文场景为 659 例)
- 输入要对齐(例如统一转成标准问诊题,避免漏填/错填)
- 上线后由领域方按统一规则核查
- 只比对关键结论字段(本文场景:六经结论),过程文案可不计入准确率
- 错例回写正确标签,用于后续改 Prompt / 补知识库
要点:准确率必须写清「分母是什么、比的是什么、谁判定」。不要只丢一个百分比。
踩过的坑
- HTTP 200 但模型 content 为空 → 要做退避重试,否则前端像随机失败
- 检索未命中仍调模型 → 又贵又胡;改成强制短路后质量更稳
- 下游匹配接口挂了,不应拖死已经完成的辨证结果(匹配可降级)
本地跑 Demo(mock,无需真实 Key)
git clone https://gitee.com/trouble_lonely_love/blog-demos.git
cd blog-demos/demos/tcm-rag-pipeline-demo
pip install flask
python app.py
浏览器打开 http://127.0.0.1:5055 :
- 命中样例:stages 走完,有 mock 六经结论
- 未命中样例:停在 rag,不会进入 model
或仓库根目录双击 一键冒烟测试.bat。
小结
把「会变的智能」放在独立管线里,用 RAG 做依据门禁,用异步和落盘保证可运维、可评测、可迭代。下一篇可以对照「告警分诊」看同一套「先检索再推理」思想。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/devil_xing/article/details/164304854

