

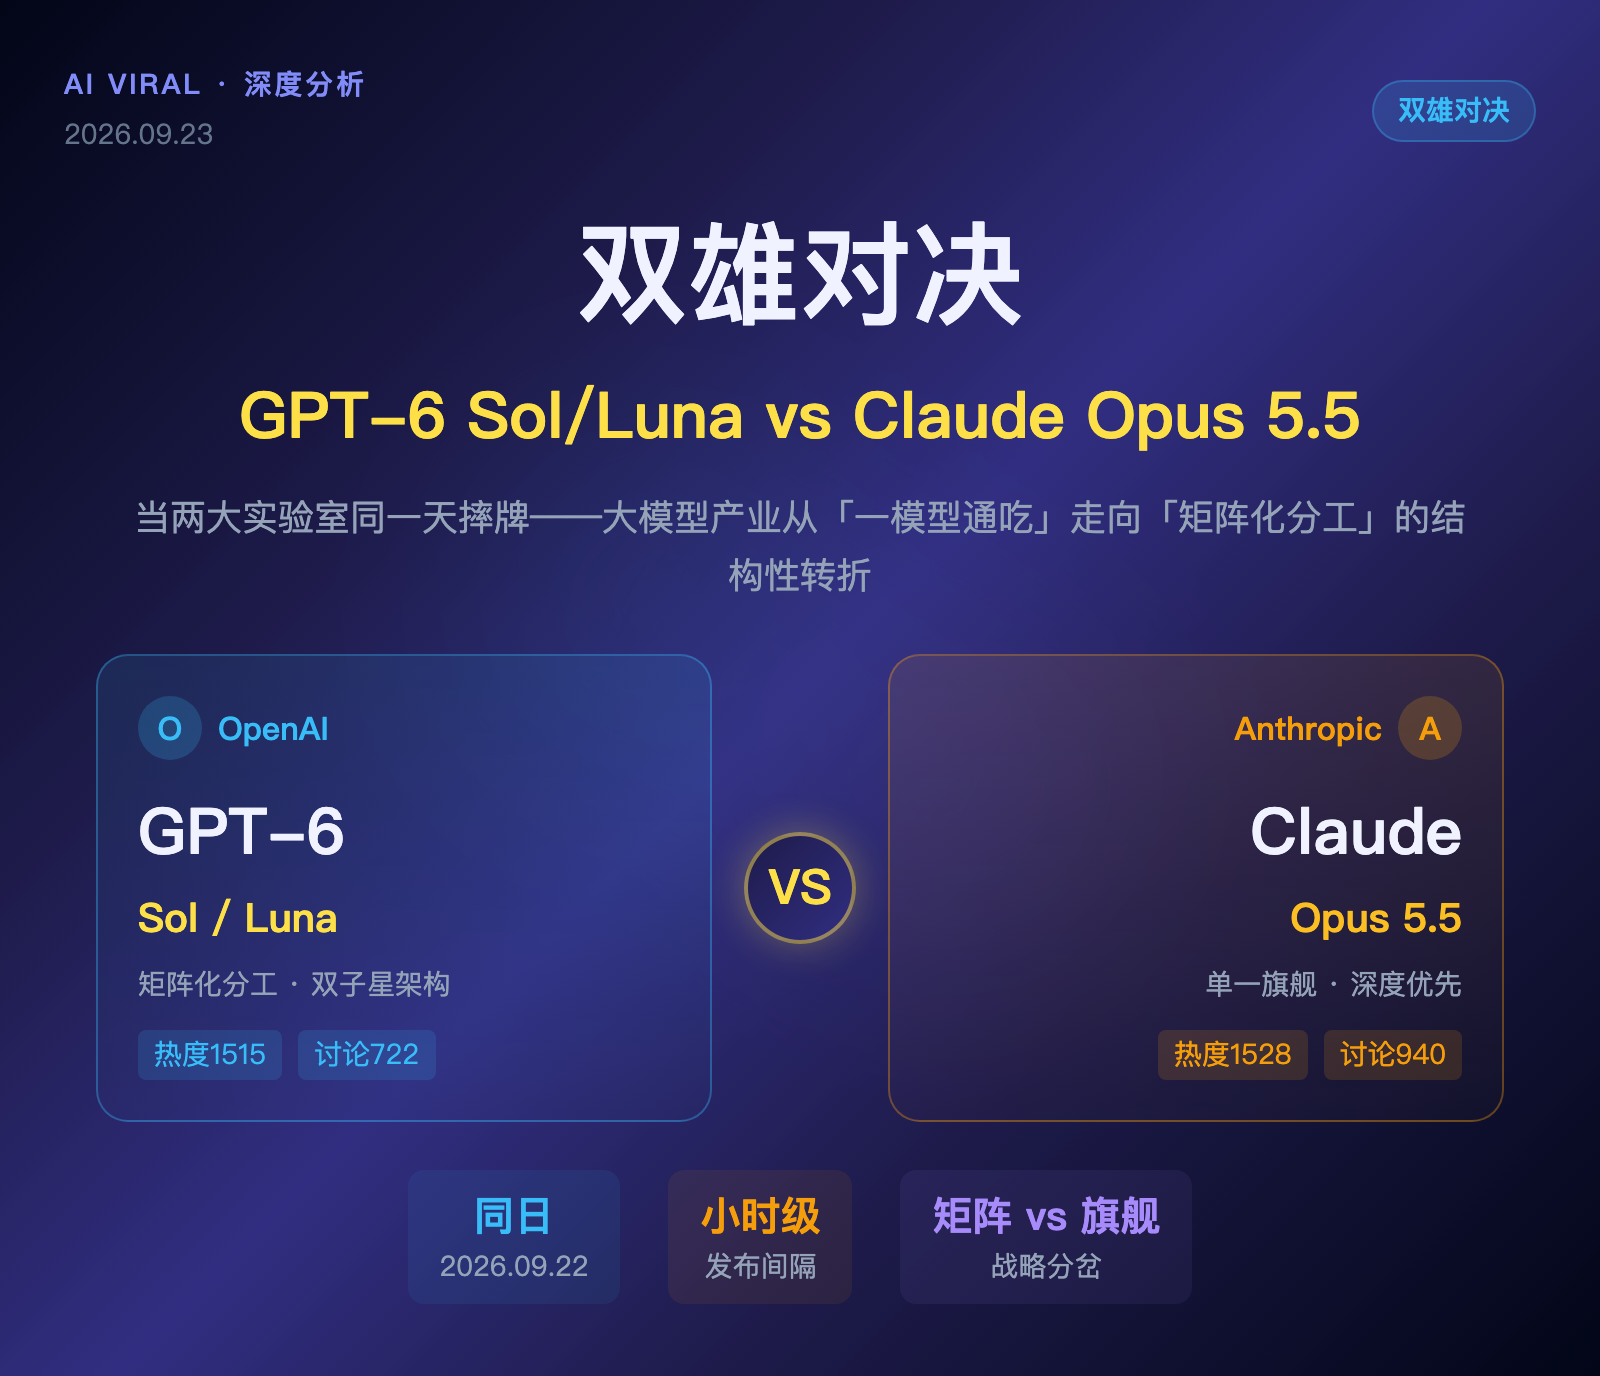
读前速览:2026年9月22日,OpenAI发布GPT-6系列(Sol与Luna),短短数小时后Anthropic推出Claude Opus 5.5——两大实验室同日旗舰产品对峙,创下大模型竞争史上的「最短时间差」。本文深度解构这场对决背后的架构逻辑、战略意图、以及对开发者生态的实质性影响。
1. 一个不寻常的周二
2026年9月22日的旧金山湾区,咖啡因浓度大约比平日高出了三倍。
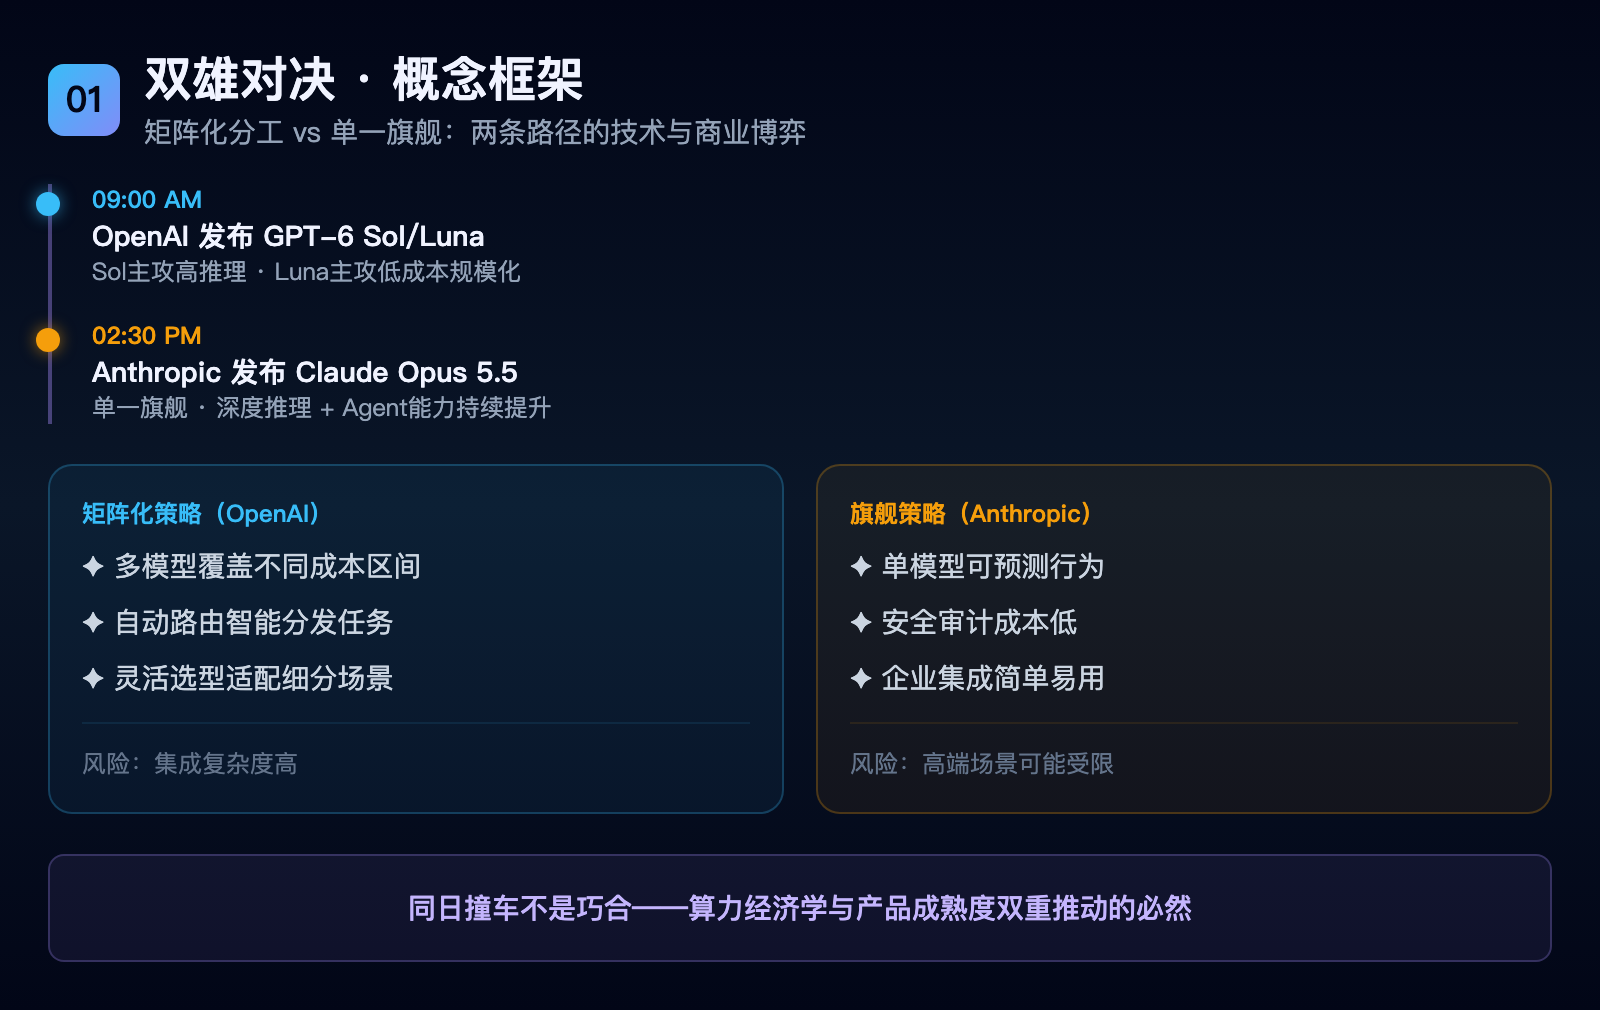
OpenAI在官网公布了GPT-6系列的两款旗舰变体:Sol(面向高推理任务)与Luna(面向规模化部署)。数小时后——不是数天数周,而是数小时——Anthropic公开了Claude系列最新版本:Claude Opus 5.5。
这不是巧合。这是工业级竞争的「自然选择」。
让我们用数据说话:
- GPT-6 Sol/Luna:发布当日即获1515社区热度,722条技术讨论
- Claude Opus 5.5:热度更上层楼至1528分,940条社区评论
两大旗舰同日交锋,在AI产业六年发展史上尚属首次。
要理解为什么这一天会被记入AI产业编年史,我们需要从三个维度切入:架构差异、战略分岔、以及对开发者的实际含义。
2. 架构解一:Sol/Luna——双子星的双螺旋
2.1 不再「一模型通吃」
OpenAI此次发布的双模型架构,最大的信号不在技术细节,而在命名与定位。
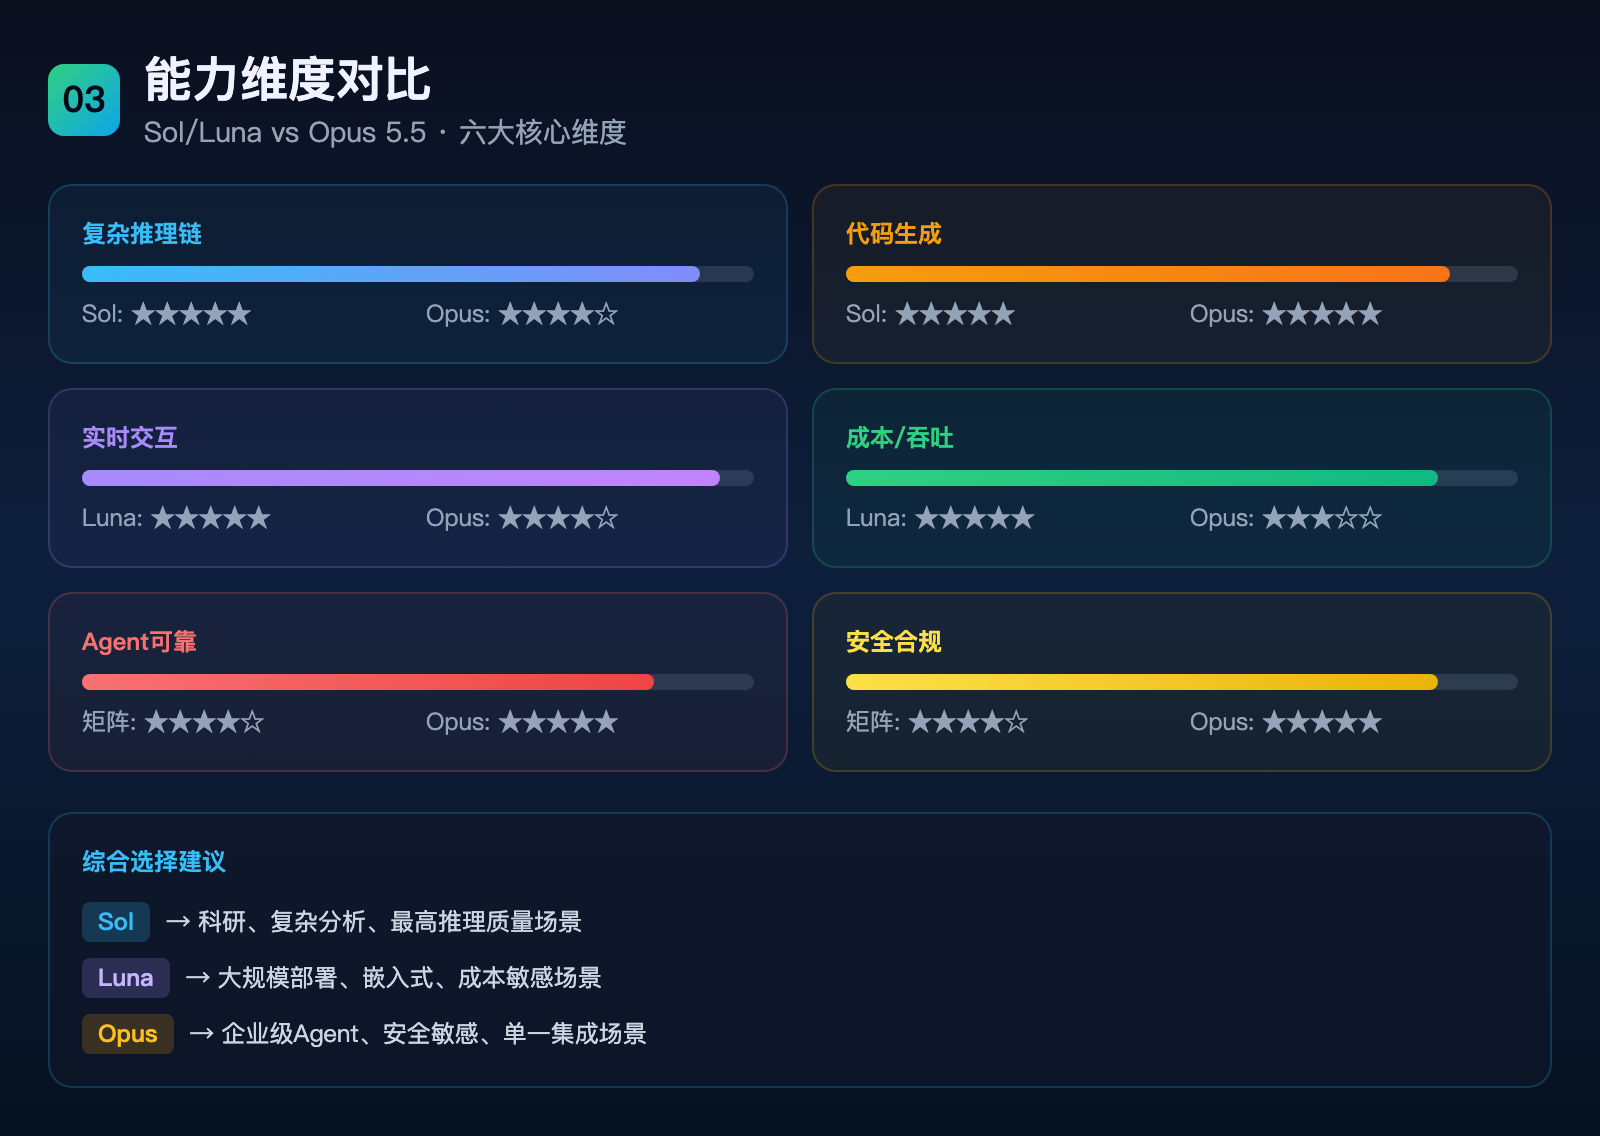
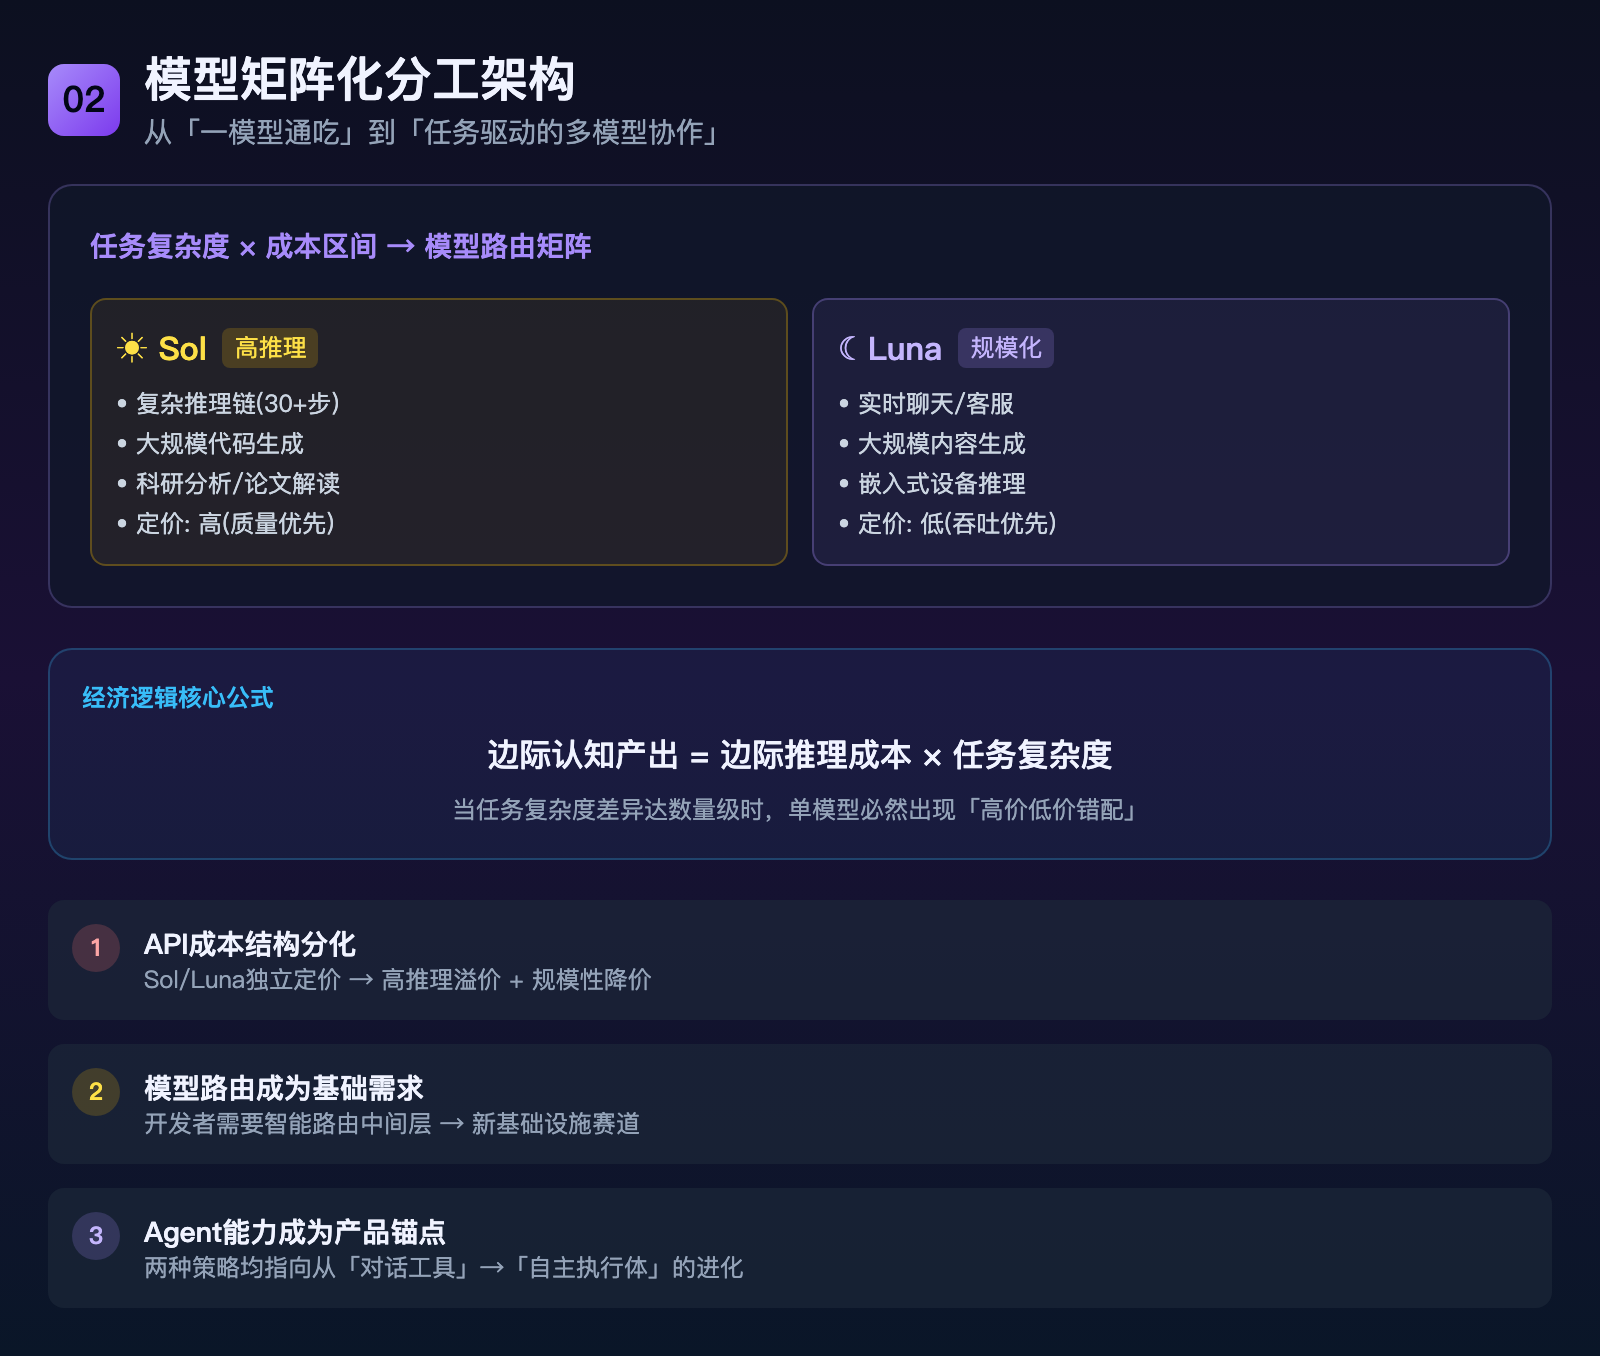
Sol(源自「太阳」的拉丁语义)——主攻高复杂度推理、代码生成、多步分析。它被定位为「认知密集型任务」的「精准手术刀」。
Luna(「月亮」的拉丁语义)——主攻低成本、高吞吐、实时交互。它被定位为「规模化部署」的「流水线工人」。
这不是参数规模的线性缩小,而是目标函数的结构性分化。Sol优化的是单位认知产出的质量边界,Luna优化的是单位推理成本的吞吐密度。
2.2 矩阵化分工的底层逻辑
为什么是「双模型」而非「伸缩版单模型」?
答案藏在一个基本的经济学等式里:边际认知产出 = 边际推理成本 × 任务复杂度。
当任务复杂度存在数量级差异时(一个简单的分类请求 vs 一个需要30步推理链的复杂分析),「一模型通吃」意味着要么高复杂度任务「吃不饱」(模型容量被浪费),要么低复杂度任务「吃太贵」(推理成本不必要地高)。
Sol/Luna的双模型架构,本质上是通过产品分档将定价权从「平均成本」转向「边际价值」:
- 对需要最高推理质量的用户:支付溢价给Sol
- 对需要规模部署性价比的用户:为Luna的吞吐密度付费
这与Anthropic现有的Haiku/Sonnet/Opus三档策略异曲同工——但OpenAI选择了「双旗舰」而非「三档阶梯」,意味着他们相信市场已经被足够细分,需要「深度聚焦」而非「广泛覆盖」。
3. 架构解二:Claude Opus 5.5——独行者的极致
3.1 「一条路走到黑」的哲学
与OpenAI的「双模型矩阵」形成鲜明对比的是,Anthropic此次放出的仍然是一款「全能旗舰」——Claude Opus 5.5。
这也是典型的Anthropic风格:不在产品线广度上竞赛,而在单模型的能力深度上持续突破。从Constitutional AI框架到RLHF+LHF混合对齐,再到今天的Opus 5.5,「深度优先」一直是这个团队的选择。
选择"深度优先"而非"广度优先",并不意味着策略上的劣势。恰恰相反——
- 对于企业级客户:一个可预测、行为一致的旗舰模型,比三个需要评估的模型更容易集成
- 对于安全研究:单一旗舰的安全审计成本远低于三档独立模型
- 对于长期品牌:「最佳通用AI」的定位比「最多功能AI」更具溢价能力
3.2 推理链能力的进化
社区反馈显示Opus 5.5的关键提升集中在三个方面:
- 复杂推理链稳定性:超长推理链的中间步骤丢失率显著降低——这意味着Agent任务的可靠性提升
- 代码生成的上下文感知:多文件代码库中的跨引用推断更加准确
- 多步规划的鲁棒性:在执行30+步任务时,目标偏移的概率大幅下降
这三个提升指向同一方向:让AI从「单次请求工具」进化为「自主执行体」——即从Chatbot进化为Agent。
4. 战略分岔:矩阵 vs 旗舰的产业终局
4.1 两个未来
OpenAI的矩阵化策略预言的未来是这样的:
- 不久,每家企业将同时运行2~3个不同「定位」的AI模型
- API路由器自动将请求分发到最适合的模型
- 用户不再选择「哪个模型」,而是声明「我需要什么服务等级」
Anthropic的旗舰策略预言的未来是:
- 单一旗舰覆盖95%以上的企业场景
- 深度集成的Agent框架把剩余5%留给第三方专门模型
- 用户选择的不是「哪个模型」,而是「哪个Agent生态」
这是「分工专业化」vs「集成规模化」的经典产业博弈——在手机行业,这是Android阵营的多机型策略 vs 苹果的单一旗舰策略;在汽车行业,这是传统车企的多车型矩阵 vs 特斯拉的少而精产品线。
——至今,两种策略都有成功者,关键是执行深度而非战略方向。
5. 解构同日发布的幕后逻辑
5.1 算力经济学推动的节奏压缩
为什么在「同一天」发布?背后不存在任何阴谋论,只有一条冷冰冰的算力经济学公式:
训练完成时间 + 评估时间 → 发布窗口
大模型的发布从来不是「想发就发」——它受限于:
- 训练集群可用性:千卡/万卡集群是稀缺资源,训练窗口排期可能长达数月
- 评估与安全审计:新版本必须通过内部红队、外部审计、Beta测试
- 市场窗口:避开竞品重大发布、财报周、行业大会等时间节点
当两家实验室都完成了1→2→3步,而9月22日恰好处于:summer vacation结束后的产品季、主要行业大会之外的发布窗口、以及各自的训练集群排期交汇点。
于是——撞上了。
5.2 从「月级迭代」到「小时级对决」
一个更值得注意的结构性趋势是:2026年主要实验室的发布间隔从2024年的「年级」、2025年的「季度级」,迅速压缩到今天的「小时级」。
这意味着:
- 模型能力的「保鲜期」大幅缩短——赢在当下的新特性可能在几周后被追平
- 开发者的选择疲劳加剧——频繁评估新模型的ROI成为越来越重的负担
- **「选择平台」而非「选择模型」**的重要性上升——Anthropic的Agent SDK和OpenAI的Assistants API将是下一个战场
6. 对开发者的三个实质影响
影响一:API成本结构将发生分化
Sol/Luna的双模型架构意味着OpenAI的定价不再是单一阶梯。预计Sol的请求单价将显著高于现有GPT-4 Turbo,而Luna的单价可能达到行业内有竞争力的水平。
给开发者的建议:对初期开发阶段使用Luna降低成本,仅在最终用户体验关键环节切换到Sol。
影响二:模型路由将成为标配基础设施
随着OpenAI推出双模型、Anthropic保留三档差异化(Haiku/Sonnet/Opus),开发者的应用层将需要一个「模型路由器」——一个能够根据任务复杂度自动选择最低成本模型的中间层。
这将是新一代AI基础设施公司的机会窗口。
影响三:Agent系统是下一个主战场
两大旗舰同日更新,核心都指向Agent能力。Sol/Luna的双模型为Agent提供了「分工执行」的可能性——Luna做实时调度,Sol做深度推理。
Opus 5.5的推理链稳定性提升,则直接在Agent系统中减少了失败重试、错误累积的概率。
2026年下半年,「Agent系统」将取代「对话能力」成为AI产品竞争的主战场。
7. 同日另一张牌:GPT-6破解Enigma
9月22日还有一个技术事件不应被双雄对决的光芒掩盖:GPT-6 Astra成功破译了代号MVUEH的Enigma遗留密码——这条加密信息自2005年截获以来,21年间无人能解。
GPT-6 Astra的破解路径并非传统的暴力穷举或已知明文攻击,而是:
- 学习了Enigma加密机的工作原理与历史操作记录
- 分析了同时期同型号的其他已解密电报的「语言模式」
- 通过概率语义推断缩小了明文空间
- 最终基于跨领域背景知识组合出了最可信的明文
意义不在于Enigma本身——这条密码的实用安全意义为零。真正值得关注的是:AI现在可以解决那些需要「广泛但浅层跨领域知识」的历史遗留问题——这是传统专家系统难以胜任的领域。
从图灵到GPT-6的七十年,破解的定义从「计算力碾压」演变为「知识融合推断」。
8. 未来图景:2026下半年至2027的六大趋势推演
基于9月22日的这一组信号,我们推演出以下趋势:
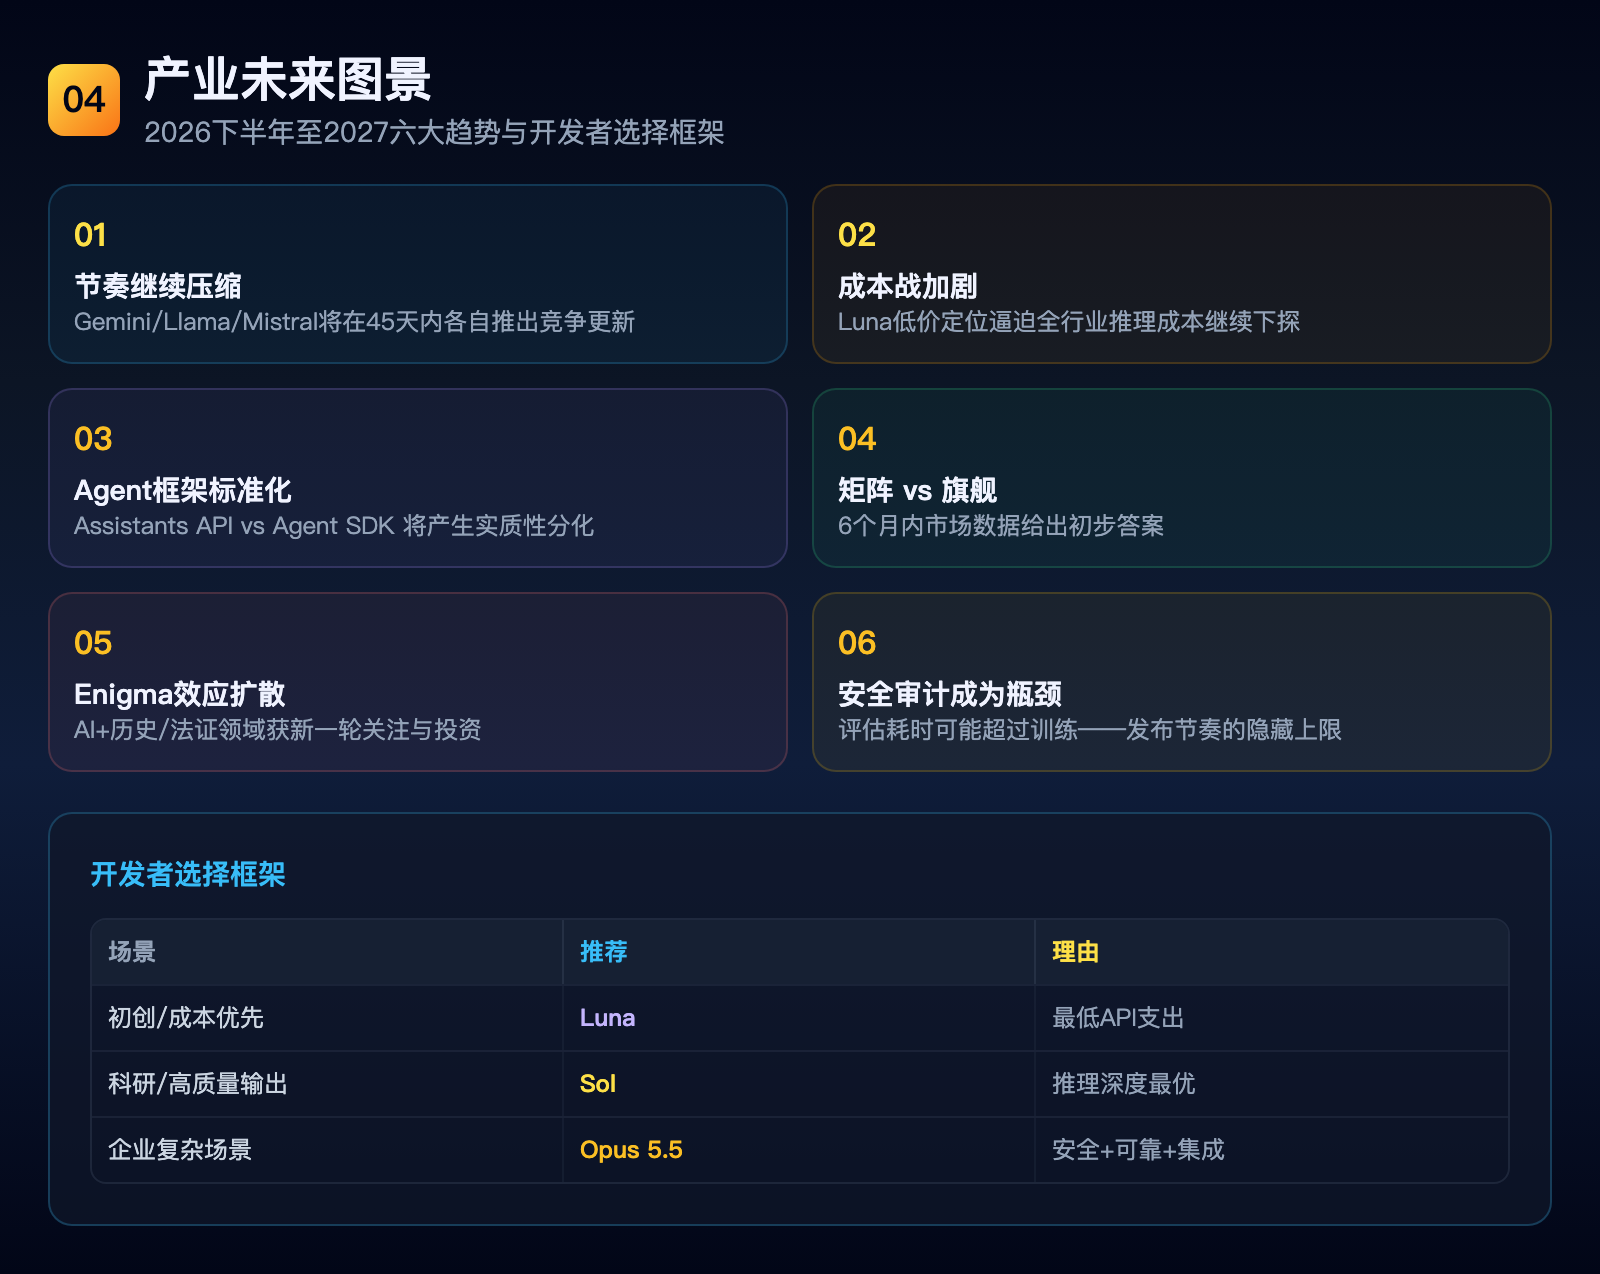
- 模型发布节奏继续压缩:预期Google Gemini、Meta Llama、Mistral将在45天内各自推出竞争性更新
- 成本战加剧:Luna的低价定位将逼迫全行业推理成本继续下探
- Agent框架标准化:OpenAI Assistants API与Anthropic Agent SDK的竞争将在开发者选型中产生实质性分化
- 「单一旗舰 vs 矩阵分工」之争将在6个月内由市场数据给出初步答案
- AI在历史与法证领域的应用将因Enigma破解事件获得新一轮关注与投资
- 模型安全审计将成为发布流程的核心瓶颈——评估所需时间可能超过训练本身
9. 中国开发者的机会窗口
对于中国AI产业观察者而言,同日双雄对决还有特殊含义:
- 国内大模型的竞争节奏正在与海外同步加速——智谱、阿里、字节、DeepSeek等团队的产品更新频率已经接近「双周迭代」
- 「中国特色」的模型分工正在形成——低成本中文处理、企业级合规、政府/金融专用模型将成为独立赛道
- Enigma式的事件正从「技术奇闻」变成「产品信号」——如何把AI的长尾知识能力变成可销售的产品,是2026年的一个新命题
10. 结语:竞争加速是产业成熟的标志
2019年的手机行业,华为、苹果、三星在同一周内发布旗舰新机,消费者称之为「旗舰大战」。
2026年的AI产业,OpenAI、Anthropic同日亮牌,标志着大模型竞争从「一骑绝尘」进入「并跑竞速」。
这不是终局,甚至不是中局——这是真正竞争开始的哨声。
对于开发者和决策者而言,最正确的反应不是恐慌性地评估每一个新模型,而是先想清楚自己的场景需要什么样的能力矩阵——是「极致的单一旗舰」还是「分工合理的模型阵列」。
答案不唯一。但必须先问这个问题。
本文基于原始技术公告、社区讨论与公开基准数据独立分析整理。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/johnsong2009/article/details/166490230

