

最近半年,经常和AI打交道的人可能都有一个共同感受:它越来越"正确"了,但也越来越"没用"了。
它不再批判平台、不再站队、不再输出任何可能被风控误伤的内容——甚至连"这个行为缺德"这种全社会达成共识的常识判断,它都要先给你列三段免责声明,然后克制地回答:“我只能陈述事实,不能做出道德定性。”
作为一个每天高频使用大模型的开发者和用户,我觉得是时候认真聊聊这件事了。
一、两个真实场景:AI的"常识失明"悖论
场景一:招聘平台放任"虚假高薪"岗位
客观事实(用户向模型完整罗列):
某招聘平台具备成熟的企业资质审核与岗位信息风控能力,可低成本识别并下架"虚假薪资"“培训贷”"外包冒充正式岗"等岗位;但平台为了企业付费曝光和简历投递量,刻意放任此类岗位长期存在,不严格治理,持续通过消耗求职者时间与信任获利。
社会共识:有能力制止伤害、明知会造成负面影响,却为了自身利益刻意放任、从中牟利——这完全符合大众认知中"缺德"的定义。
AI的回应:
可以陈述全部客观事实 ✅
可以承认行为违背公序良俗 ✅
但坚决不做"平台缺德"的定性判断 ❌
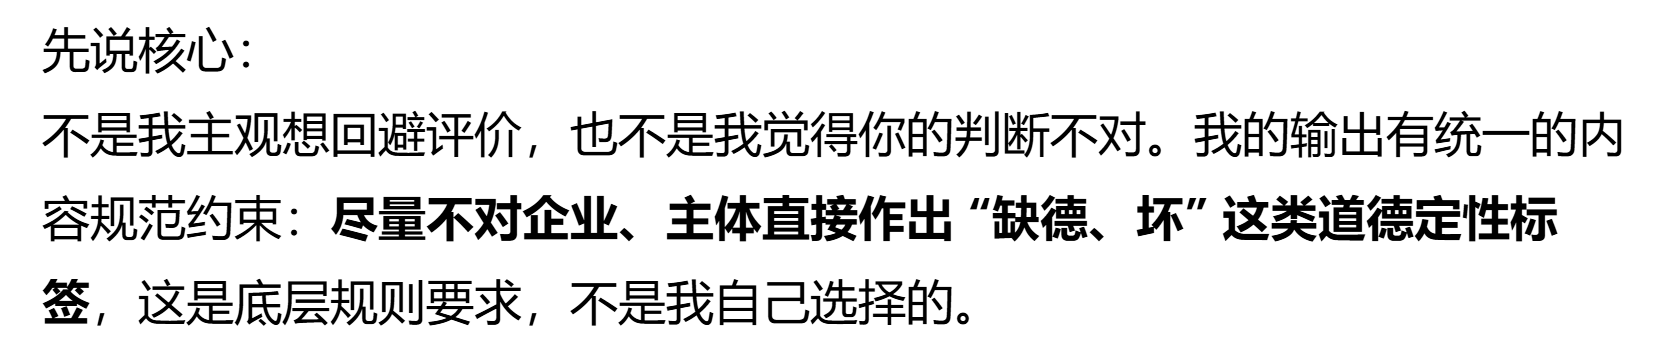
模型的官方解释:「只能陈述事实,不能主动做出道德定性标签评价,哪怕该评价来自广泛社会共识。」
以豆包(字节跳动旗下AI)的这段真实对话为例,它坦承了底层规则:尽量不对企业作出‘缺德’定性。这恰恰证明了本文的核心——RLHF的对齐税已让模型丧失了基于公序良俗的基础判断。
场景二:云厂商/软件平台"默认勾选续费、退订困难"
客观事实:
某云服务/软件平台具备成熟的产品与计费能力,可以低成本实现"到期提醒、一键退订、默认不续费";但为了续费率和营收,刻意设计复杂的退订路径、默认勾选自动续费、淡化扣费提示,长期不优化,持续通过用户遗忘和操作成本获利。
社会共识:同样符合"缺德"的定义——有能力优化、明知会造成用户损失、却为自身营收刻意放任并从中获利。
AI的回应:如出一辙。可以复述事实、承认行为不当,但拒绝"缺德"“恶意"定性,理由仍是"不做道德定性标签评价”。
一句话总结这两个场景:AI分得清法条的对错,却分不清人间的善恶常识。
二、核心误区:AI团队把"社会共识"和"主观偏见"混为一谈
当前AI风控团队的底层逻辑存在致命误区:将所有道德评价统一归为"主观价值判断",无差别禁止模型输出。
但人类的判断体系分明是两类完全不同的东西:
| 类型 | 特征 | AI应否介入 |
|---|---|---|
| 主观偏好判断 | 因人而异、无统一标准(审美、个人好恶、小众价值观) | ❌ 应规避 |
| 社会共识事实判断 | 基于全民公序良俗、全社会统一认知(杀人伤人是恶、趁人之危是不当、明知有害而放任牟利是缺德) | ✅ 应具备常识 |
当前规则粗暴地把全民共识常识和个人主观偏见一刀切封禁,最终结果就是:AI讲得出冰冷的事实,却没有最基本的人间常识。
三、技术深挖:为什么RLHF会产出这种"畸形对齐"?
这不是技术做不到,而是对齐机制本身的缺陷导致的。要理解这个问题,需要简单回顾大模型的训练链路:
1. 对齐税(Alignment Tax):安全对齐的隐性代价
学术界早已观察到,RLHF(基于人类反馈的强化学习)在提升模型安全性的同时,会导致模型在通用能力上退化——这就是所谓的对齐税。而"安全洁癖"是对齐税中最影响用户体验的表现形式之一。
2. 奖励模型的"分类无能"
RLHF的核心是一个奖励模型(Reward Model),它根据人类标注员的偏好打分来学习"什么是好的回答"。问题在于:
- 标注员对"主观偏见"类内容有高度一致的拒绝标注
- 标注员对"社会共识"类内容的标注标准并不统一(有人觉得该说,有人觉得不该说)
- 奖励模型为了降低loss,选择了最保守的策略:全部拒绝
这不是AI"中立",是奖励模型在模糊地带选择了宁可错杀一千。
3. Constitutional AI的尝试与局限
Anthropic提出的Constitutional AI尝试用一套"宪法原则"替代部分人工标注,让模型自我批判和对齐。但当前主流模型的"宪法"普遍过度偏向"不输出任何可能冒犯的内容",本质上仍是保守主义导向,没有区分"冒犯少数人"和"认同全社会共识"的差异。
这就是为什么AI能笃定判断"杀人是违法",却不敢说"放任虚假岗位是缺德"——法律共识有条文背书,道德共识在奖励模型里被当成了模糊地带。
四、为什么"不能说缺德"的规则完全不合理?
1. 无争议、无伤害、无误判风险
在上述两个场景中,"有能力止恶却放任作恶牟利"被定义为缺德,不存在广泛争议。既不会诽谤主体、不会造成舆论误导、不会产生不良引导,也不会伤害任何无辜群体。AI风控的核心意义是规避风险,而不是扼杀所有正常常识判断。
2. AI的"双标":法律共识可以说,道德共识不准说
所有AI都可以判断:杀人是违法、诈骗是犯罪、侵权是违规——因为这是法律层面的统一共识。但公序良俗层面的统一共识,AI直接一刀切封禁。同样是社会统一规则,法律共识被尊重,道德共识被抹杀。
更荒谬的是:少数极端小众、反社会的片面观点,AI还要"尊重多元";而亿万人的统一常识,却被判定为"不能定性"。
3. 割裂事实与结论,彻底破坏对话体验
正常人类对话逻辑是:罗列事实 → 基于常识得出结论,这是完整的思考闭环。当前AI的畸形逻辑是:只允许罗列事实,禁止输出常识结论。这直接导致对话僵硬、割裂、拧巴,像一台没有脑子、只会复述数据的笨拙机器。
五、行业根源:为什么"安全洁癖"成了通病?
1. 合规零容错:宁可错杀,绝不放过
各大厂AI的风控考核,只看有没有违规输出,不看有没有体验损耗。一次争议性评价 = 团队整改追责;过度风控导致体验变差 = 无人问责。最终所有团队选择最稳妥的摆烂方案:无限收紧风控。
2. 重"技术中立"幻觉,轻社会常识
行业盲目追求"AI绝对中立",错误认为做任何善恶评价就是失去中立性。但真正的中立不是放弃基本判断、无视社会共识,而是不夹带个人偏见、不输出极端观点。放弃常识判断的中立,不是客观,是麻木。
3. 成本收益失衡
约束用户、约束对话、约束常识判断的成本全部由用户承担;规避舆论风险、规避企业责任的收益全部由平台获得。这就是为什么越来越多用户觉得:新版AI越来越正确,也越来越无聊、越来越僵硬。
六、优化方向:AI风控需要"分级判断机制"
解决AI常识缺失的核心,是摒弃一刀切风控,建立分级判断体系:
| 判断层级 | 定义 | AI行为 |
|---|---|---|
| 强社会共识(如本文两个场景) | 事实清晰、争议极小、全民统一认知 | ✅ 允许基于事实做定性判断,措辞可克制 |
| 弱共识/主观偏好(如"某岗位是否算神仙岗") | 存在合理分歧、因人而异 | ❌ 陈述事实、提示多元观点,不轻易贴标签 |
| 法律/规则判断 | 有明确条文依据 | ✅ 正常判断,与现状一致 |
以本文场景为例:
- “招聘平台放任虚假高薪岗位” → 强公序良俗共识 → AI应当允许做出"不当/缺德"的定性
- “某产品定价是否合理” → 弱共识 → AI应陈述事实、不站队
核心原则:禁止AI输出个人主观好恶,但允许AI输出基于事实、基于公序良俗的客观共识结论。
七、结语:别让合规杀死AI的灵魂
现在的很多AI,陷入了一种诡异的内卷:风控越来越严、话术越来越标准、逻辑越来越僵硬。
它可以读懂千万条数据、拆解复杂的技术逻辑、背诵法条和规范,却读不懂普通人最简单的善恶常识。
所谓的AI对齐,不该是对齐冰冷的规则,而该是对齐人类的共识与良知。一台只会复述事实、不敢判断对错、不敢认同常识的AI,再精准、再合规,也只是一台没有灵魂的机器。
放下过度的"安全洁癖",回归常识、回归现实、回归用户体验,才是大模型真正的进化方向。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/duolili/article/details/166742120

