

第 8 题:拓扑排序——任务应该按照什么顺序完成?
一、题目
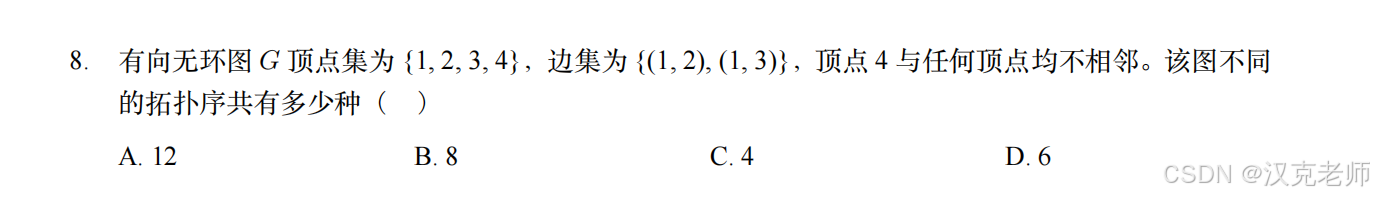
有向无环图 GG 的顶点集为:
{1,2,3,4}
边集为:
{(1,2),(1,3)}
顶点 4 与任何顶点均不相邻。
该图不同的拓扑序共有多少种?
A. 12
B. 8
C. 4
D. 6
二、故事:魔法学院的课程安排
假设魔法学院有 4 门课程:
| 课程编号 | 课程 |
|---|---|
| 1 | 魔法入门 |
| 2 | 火焰魔法 |
| 3 | 冰霜魔法 |
| 4 | 飞行魔法 |
课程之间有先修关系:
-
必须先学习课程 1,才能学习课程 2。
-
必须先学习课程 1,才能学习课程 3。
-
课程 4 没有任何先修限制。
因此:
       1
      / \
     2   3

     4
我们需要安排学习顺序。
例如:
1,2,3,4
是合法顺序。
但是:
2,1,3,4
不合法,因为课程 2 必须在课程 1 之后学习。
那么,一共有多少种合法顺序呢?
三、什么是拓扑排序?
拓扑排序是一种针对有向无环图的排序方式。
它要求:
对于每一条有向边 u→v ,顶点 u 必须排在顶点 v 前面。
本题的限制就是:
1 必须在 2 前面
以及:
1 必须在 3 前面
而顶点 4 可以出现在任何位置。
四、一步一步计算
因为顶点 1 必须排在顶点 2 和顶点 3 前面,所以:
-
第一个位置不能是 2。
-
第一个位置不能是 3。
-
第一个位置可以是 1,也可以是 4。
我们分两种情况讨论。
情况一:第一个位置是 1
剩下:
2,3,4
它们之间没有额外的先后限制。
所以可以任意排列。
排列数为:
3!=3×2×1=6
情况二:第一个位置是 4
因为 4 没有先修限制,所以可以先学习 4。
剩下:
1,2,3
其中 1 必须排在 2 和 3 前面。
因此:
1,2,3
1,3,2
只有 2 种合法排列。
两种情况相加
6+2=8
正确答案:B,8。
五、举一反三
如果顶点 4 也必须在顶点 2 之前,那么就会多出一条限制:
4→2
这时不能再把 4 随意插入所有位置,需要重新分析先后关系。
本题记忆口诀
拓扑排序:有边就有先后,没有边就不一定有先后。
不要误以为编号小的顶点一定要排在编号大的顶点前面。
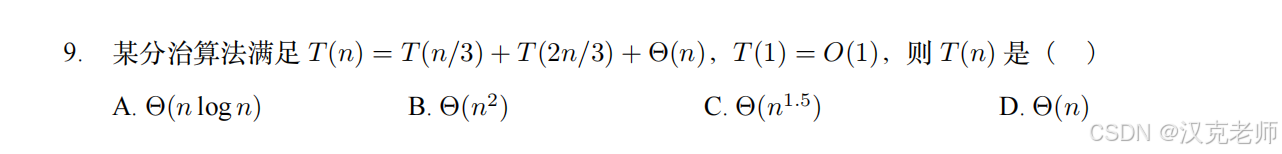
第 9 题:分治算法——大问题拆成小问题
一、题目
某分治算法满足:
并且:
T(1) = O(1)
则 T(n) 是:
A. Θ(nlogn)\Theta(n\log n)
B. Θ(n2)\Theta(n^2)
C. Θ(n1.5)\Theta(n^{1.5})
D. Θ(n)\Theta(n)
二、故事:魔法图书馆的整理任务
假设魔法图书馆有 nn 本书。
图书管理员使用分治算法整理书籍:
-
把书分成两部分。
-
第一部分有大约 n/3n/3 本书。
-
第二部分有大约 2n/32n/3 本书。
-
分别整理这两部分。
-
最后还要花费 Θ(n)\Theta(n) 的时间处理整个问题。
所以:
这里的 T(n) 表示处理规模为 n 的问题所需要的时间。
三、理解三个部分
公式:
可以理解为:
| 公式部分 | 含义 |
|---|---|
| T(n/3) | 处理第一部分的时间 |
| T(2n/3) | 处理第二部分的时间 |
| Θ(n) | 当前层额外处理的时间 |
注意:
虽然两部分大小不相等,但是它们加起来仍然是:
也就是说,每一层所有子问题的规模加起来,仍然大约是 n。
因此,每一层的总工作量大约都是:
四、为什么会出现 logn ?
我们观察递归的深度。
如果不断进入规模为 n/3 的子问题:
当规模缩小到 1 时停止。
假设递归深度为 h,那么:
所以:
因此:
递归树的深度是对数级别。
对于这种不平衡划分,也可以用递归树分析:各层子问题的规模总和为 n,而叶子层的总代价也是线性级别,因此总工作量为线性级别乘以对数级别。
最终:
正确答案:A。
五、知识点总结
看到分治递推式时,可以先问:
-
每层一共有多少工作量?
-
递归树有多少层?
-
叶子结点的总代价是多少?
本题每层工作量为线性级别,递归深度为对数级别,因此总时间复杂度为:
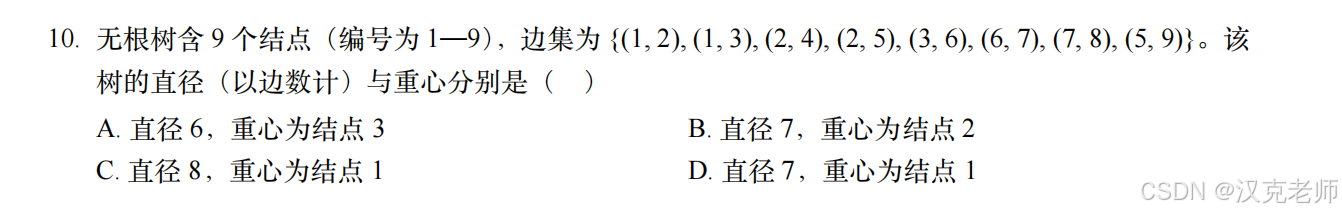
第 10 题:树的直径与重心——寻找树上的关键位置
一、题目
无根树含 9 个结点,编号为 1~9,边集为:
{(1,2),(1,3),(2,4),(2,5),(3,6),(6,7),(7,8),(5,9)}
该树的直径(以边数计)与重心分别是:
A. 直径 6,重心为结点 3
B. 直径 7,重心为结点 2
C. 直径 8,重心为结点 1
D. 直径 7,重心为结点 1
二、先画出这棵树
我们把题目中的边画出来:
        4
        |
        2
       / \
      1   5
     /     \
    3       9
    |
    6
    |
    7
    |
    8
为了避免图形位置造成误解,真正的连接关系是:
1—2—4
| |
3 5—9
|
6
|
7
|
8
其中:
-
1 连接 2 和 3;
-
2 连接 4 和 5;
-
3 连接 6;
-
5 连接 9;
-
6 连接 7;
-
7 连接 8。
三、什么是树的直径?
树的直径就是:
树上任意两个结点之间的距离的最大值。
这里的距离以边数计算。
例如:
4—2—1—3
从 4 到 3 经过 3 条边,因此距离为 3。
我们寻找整棵树中距离最远的两个结点。
观察这棵树:
-
结点 9 位于左侧分支的末端;
-
结点 8 位于另一条较长分支的末端。
从 9 到 8 的路径是:
9—5—2—1—3—6—7—8
逐条数边:
9—5       第 1 条
5—2       第 2 条
2—1       第 3 条
1—3       第 4 条
3—6       第 5 条
6—7       第 6 条
7—8       第 7 条
所以距离为 7。
检查其他分支之间的路径,可以发现没有比它更长的路径。
因此:
直径=7
四、什么是树的重心?
树的重心不是几何图形中的中心点。
它的定义是:
删除某个结点后,剩下的所有连通块中,最大连通块的结点数尽可能小。
我们试着删除结点 1。
删除 1 后,树分成两个连通块:
左边的连通块
包含:
2,4,5,9
一共 4 个结点。
右边的连通块
包含:
3,6,7,8
一共 4 个结点。
因此,删除结点 1 后,最大连通块大小为:
max(4,4) = 4
对于 9 个结点的树,如果删除重心,最大连通块的大小不超过:
所以结点 1 满足重心条件。
因此:
重心为结点 1
正确答案:D。
知识点总结
-
树的直径:寻找距离最远的两个结点。
-
树的重心:删除后,使最大连通块尽可能小的结点。
这两个概念虽然都和树的结构有关,但含义完全不同。
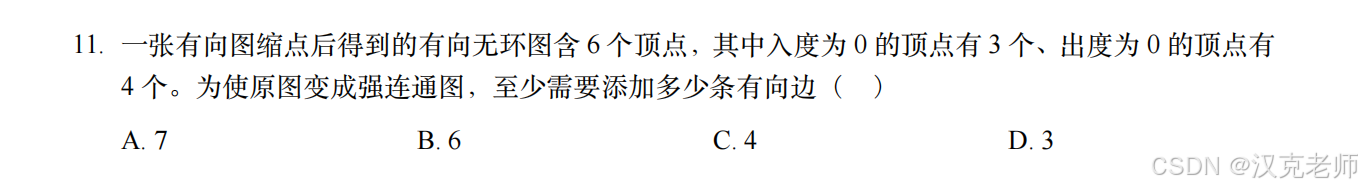
第 11 题:强连通图——怎样让所有城市互相到达?
一、题目
一张有向图缩点后得到的有向无环图含 6 个顶点,其中:
-
入度为 0 的顶点有 3 个;
-
出度为 0 的顶点有 4 个。
为使原图变成强连通图,至少需要添加多少条有向边?
A. 7
B. 6
C. 4
D. 3
二、故事:六座城市的交通改造
想象有 6 座城市。
城市之间有单向道路。
例如:
城市 A → 城市 B
表示可以从 A 去 B,但不一定能从 B 回到 A。
现在,交通部门希望修建一些新道路,让所有城市之间都能互相到达。
这就是强连通问题。
三、什么是强连通图?
对于一张有向图,如果任意两个顶点 u,v 都满足:
-
从 u 可以到达 v;
-
从 v 也可以到达 u;
那么这张图就是强连通图。
题目先进行了缩点。
缩点的作用是把原图中的每个强连通分量压缩成一个顶点。
缩点之后得到的是一张有向无环图,也就是 DAG。
四、入度为 0 和出度为 0 的顶点
入度为 0
入度表示有多少条边指向一个顶点。
入度为 0,意味着没有其他顶点能够通过一条直接的边进入它。
这样的顶点可以理解成交通网络中的“入口”。
出度为 0
出度表示有多少条边从一个顶点出发。
出度为 0,意味着它没有直接通往其他顶点的边。
这样的顶点可以理解成交通网络中的“出口”。
对于一张已经缩点、且包含多个顶点的 DAG,若要把它变成强连通图,至少需要添加:
max(入度为0的顶点数,出度为0的顶点数)
条边。
本题中:
入度为0的顶点数 = 3
出度为0的顶点数 = 4
因此:
max(3,4)=4
正确答案:C,4。
知识点总结
对于包含多个顶点的缩点 DAG:
最少添加边数=max(源点数,汇点数)
这里的源点指入度为 0 的顶点,汇点指出度为 0 的顶点。
注意:如果缩点后只有一个顶点,那么原图已经强连通,不需要添加边。这是公式使用时需要注意的特殊情况。
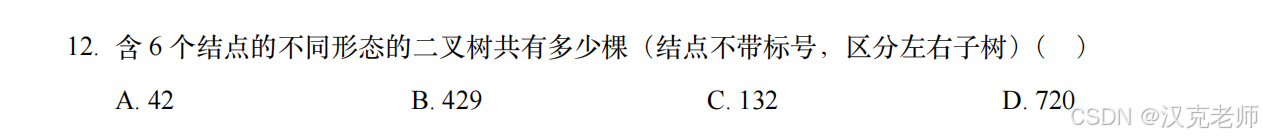
第 12 题:二叉树计数——6 个结点能组成多少种不同形态?
一、题目
含 6 个结点的不同形态的二叉树共有多少棵?
结点不带标号,区分左右子树。
A. 42
B. 429
C. 132
D. 720
二、故事:搭建二叉树积木
假设有 6 块积木。
每块积木都可以作为一个结点。
我们要用它们搭建二叉树。
二叉树有一个重要特点:
每个结点最多有两个孩子,分别叫左孩子和右孩子。
而且题目特别说明:
区分左右子树。
所以:
    A          A
   /            \
  B              B
这两棵树算作不同的形态。
即使结点没有编号,只要结构不同,就算不同的二叉树。
三、从小规模开始寻找规律
1 个结点
只有一种:
A
因此:
C1=1
2 个结点
可以有:
A          A
/            \
B              B
因此:
C2 = 2
3 个结点
可能的结构更多。
我们可以按照根结点左子树和右子树的结点数分类。
例如:
-
左边 0 个,右边 2 个;
-
左边 1 个,右边 1 个;
-
左边 2 个,右边 0 个。
这种分类方法可以推广到任意结点数。
四、卡特兰数公式
不同形态的二叉树数量属于经典的卡特兰数问题。
设:
Cn
表示含 n 个结点的不同形态二叉树数量。
那么:
C0 =1
并且:
为什么?
因为根结点占用一个结点。
剩下的 n−1n-1 个结点,可以分成:
-
左子树的 ii 个结点;
-
右子树的 n−1−in-1-i 个结点。
左子树有 Ci 种形态,右子树有 Cn−1−i 种形态。
根据乘法原理,两边组合有:
Ci Cn−1−i
种。
把所有可能的 i 加起来,就得到总数。
五、计算到 6 个结点
卡特兰数的前几项为:
C0=1
C1=1
C2=2
C3=5
C4=14
C5=42
C6=132
所以,含 6 个结点的不同形态二叉树共有:
132
正确答案:C,132。
知识点总结
看到下面这些问题时,可以考虑卡特兰数:
-
不同形态的二叉树计数;
-
合法括号序列计数;
-
某些具有不交叉结构的组合计数。
不过要先确认题目中的计数规则是否符合卡特兰数模型,不能看到二叉树就不加判断地套用。
第 13 题:字符串的前缀与后缀——寻找首尾相同的秘密密码
一、题目
字符串:
S = "ababaabab"
其所有既是真前缀又是真后缀的子串(非空)的长度之和是:
A. 4
B. 6
C. 7
D. 5
二、什么是真前缀?
前缀就是从字符串开头开始截取的一段连续字符。
例如:
字符串:banana
它的前缀有:
b
ba
ban
bana
banan
banana
但是,题目要求的是真前缀。
真前缀不允许等于整个字符串。
所以 banana 本身不是真前缀。
三、什么是真后缀?
后缀就是从字符串末尾开始截取的一段连续字符。
例如:
字符串:banana
它的后缀有:
a
na
ana
nana
anana
banana
真后缀同样不能等于整个字符串。
四、寻找本题的公共部分
题目中的字符串是:
a b a b a a b a b
我们需要寻找:
-
从开头截取的子串;
-
从结尾截取的子串;
并且两者完全相同。
长度为 1
前缀:
a
后缀:
b
不相同。
所以长度为 1 的子串不符合条件。
长度为 2
前缀:
ab
后缀:
ab
两者相同。
因此长度 2 符合条件。
长度为 4
前缀:
abab
后缀:
abab
两者也相同。
因此长度 4 符合条件。
继续检查其他长度,可以发现没有其他非空真前缀同时是真后缀。
所以符合条件的长度是:
2, 4
它们的长度之和为:
2+4=6
正确答案:B,6。
五、这和 KMP 有什么关系?
KMP 字符串匹配算法中,有一个重要概念:
最长相等真前后缀。
本题中,最长的相等真前后缀是:
abab
长度为 4。
但是题目问的不是最长的一个,而是所有符合条件的长度之和。
因此还必须把长度为 2 的情况计算进去。
知识点总结
遇到字符串前后缀问题时,要特别注意:
-
前缀必须从第一个字符开始。
-
后缀必须在最后一个字符结束。
-
真前缀和真后缀都不能等于整个字符串。
-
如果题目要求所有长度,就不能只找最长的一个。
第 14 题:归并排序统计逆序对——相等的数算不算?
一、题目
用归并排序统计逆序对,合并部分的核心代码为:
if (a[i] <= a[j]) {
    tmp[k++] = a[i++];
}
else {
    tmp[k++] = a[j++];
    ans += mid - i + 1;
}
若把判断条件中的:
a[i] <= a[j]
改成:
a[i] < a[j]
则 ans 统计出的结果是:
A. 完全不变
B. 变为原来的两倍
C. 变为满足 i<ji<j 且 a[i]≥a[j]a[i]\ge a[j] 的数对个数
D. 变为原来的一半
二、故事:排队的小朋友
假设有一排小朋友,每个人手里拿着一个数字。
例如:
左边:2,5,7
右边:3,5,8
我们使用归并排序,把两边已经排好序的数字合并起来。
同时统计逆序对。
通常,逆序对指:
也就是:
前面位置的数字比后面位置的数字大。
例如:
5,3
因为 5 在前面,3 在后面,而且:
5>3
所以它们构成一个逆序对。
但是:
5,5
两个数字相等,不满足严格大于,因此不算普通定义下的逆序对。
三、原来的判断条件
原代码:
if (a[i] <= a[j])
当左边数字小于或等于右边数字时,先取左边。
只有当:
a[i] > a[j]
时,才进入 else。
此时右边的 a[j] 比左边当前元素 a[i] 小。
由于左半部分已经排好序,因此从 i 到 mid 的元素都大于 a[j]。
所以新增逆序对的数量为:
mid - i + 1
这正是归并排序统计逆序对的经典方法。
四、修改成严格小于后会怎样?
修改后:
if (a[i] < a[j])
当两边元素相等时:
a[i] == a[j]
条件不成立,于是进入 else。
也就是说,相等的元素也会被统计。
因此,进入 else 的条件从原来的:
a[i] > a[j]
变成:
a[i] ≥ a[j]
同时,归并排序中左半部分的下标始终小于右半部分的下标,所以这些数对满足:
i < j
因此新的统计对象是:
正确答案:C。
五、举一反三
假设数组为:
2,2
按照普通逆序对定义:
2 > 2
不成立,所以逆序对数量是 0。
但修改判断条件后,相等的两个数也会被统计。
于是数量变为 1。
知识点总结
比较运算符的细微变化可能改变算法的统计对象:
| 判断条件 | 左边先取的条件 | 右边先取的条件 |
|---|---|---|
a[i] <= a[j] | 左边小于或等于右边 | 左边大于右边 |
a[i] < a[j] | 左边严格小于右边 | 左边大于或等于右边 |
考试中看到 < 和 <=,一定要特别留心相等的情况。
第 15 题:快速幂
一、题目
执行:
power(2, 100, 1000)
调用下列函数,返回值是:
long long power(long long a, long long b, long long p) {
    long long r = 1 % p;

    while (b) {
        if (b & 1)
            r = r * a % p;

        a = a * a % p;
        b >>= 1;
    }

    return r;
}
选项:
A. 576
B. 376
C. 976
D. 176
二、故事:魔法能量的快速复制
假设我们有 2 点魔法能量。
每次复制,能量都会翻倍。
那么:
第 1 次:2
第 2 次:4
第 3 次:8
第 4 次:16
如果连续翻倍 100 次,就会得到:
这个数字非常大。
但是程序并不需要保存完整的巨大数字,因为题目只要求:
也就是除以 1000 后的余数。
这时,我们就可以使用快速幂。
三、理解快速幂的三个重要操作
1. b & 1
if (b & 1)
这是在判断 b 的二进制最低位是不是 1。
如果最低位是 1,说明 b 是奇数。
如果最低位是 0,说明 b 是偶数。
例如:
5 的二进制:101
5 & 1 = 1
所以 5 是奇数。
6 的二进制:110
6 & 1 = 0
所以 6 是偶数。
2. a = a * a % p
a = a * a % p;
这是快速幂的核心操作之一。
它不断把底数平方。
例如:
2^2=4
2^4=16
2^8=256
通过平方,可以快速得到更大的幂次。
3. b >>= 1
b >>= 1;
这是把 b 的二进制整体向右移动一位。
对于非负整数,这相当于:
例如:
13 的二进制:1101
右移一位:   0110
也就是:
13÷2=6
小数部分舍去。
四、把 100 写成二进制
快速幂会根据指数的二进制位决定是否把当前的底数乘进答案。
先把 100 写成二进制:
也就是:
100 = 64+32+4
因此:
程序会通过不断平方,依次得到这些幂次。
五、跟踪程序中的关键数值
初始:
a = 2
b = 100
r = 1
每次循环中:
-
如果
b是奇数,就令r = r * a % 1000; -
然后把
a平方并取模; -
最后把
b右移一位。
我们用表格记录:
当前指数 b | 当前底数 a | 是否乘入答案 | 更新后的 r |
|---|---|---|---|
| 100 | 2 | 否 | 1 |
| 50 | 4 | 否 | 1 |
| 25 | 16 | 是 | 16 |
| 12 | 256 | 否 | 16 |
| 6 | 536 | 否 | 16 |
| 3 | 296 | 是 | 736 |
| 1 | 616 | 是 | 376 |
这里所有底数平方后都要对 1000 取模。
例如:
256^2=65536
65536 mod 1000
=536
所以表格中的下一次底数是 536。
最后得到:
r=376
因此:
正确答案:B,376。
六、快速幂的核心思想
普通方法计算:
2^{100}
需要连续乘很多次。
快速幂通过不断平方,把指数转换成二进制,从而大幅减少乘法次数。
它的时间复杂度为:
O(logb)
这里的 b 是指数。
知识点总结
看到下面这段代码:
while (b) {
    if (b & 1)
        r = r * a % p;

    a = a * a % p;
    b >>= 1;
}
就要想到:
这是快速幂取模算法。
它的优点是计算速度快,而且通过每一步取模,可以控制中间数值的大小。
8~15 题答案汇总
| 题号 | 正确答案 | 核心知识点 |
|---|---|---|
| 8 | B(8) | 拓扑排序、排列计数 |
| 9 | A(Θ(nlogn)\Theta(n\log n)) | 分治、递归树分析 |
| 10 | D(直径 7,重心为 1) | 树的直径、树的重心 |
| 11 | C(4) | 强连通图、缩点 DAG |
| 12 | C(132) | 二叉树计数、卡特兰数 |
| 13 | B(6) | 字符串前缀与后缀 |
| 14 | C | 归并排序、逆序对 |
| 15 | B(376) | 快速幂、二进制、取模 |
给同学们的学习建议
这 8 道题涉及的知识点比较多,不建议只背选项。可以重点练习以下几种思考方式:
1. 遇到图论题,先画图
第 8、10、11 题都涉及图或树。
先把顶点和边画出来,通常比直接看文字更容易发现结构。
2. 遇到递推式,尝试分析每一层
第 9 题可以通过递归树理解:
-
每层有多少工作量?
-
一共有多少层?
-
最后一层的代价是多少?
3. 遇到计数题,先分类
第 8 题通过顶点 1 和顶点 4 的位置分类。
第 12 题通过左右子树的结点数分类。
第 13 题则通过前后缀长度分类。
分类的关键,是保证不遗漏、不重复。
4. 遇到代码题,特别留心边界条件
第 14 题中:
a[i] <= a[j]
只改成:
a[i] < a[j]
统计结果就发生了变化。
因此,阅读程序时不要忽略一个小小的比较符号。
5. 把算法思想和代码对应起来
| 算法 | 关键思想 |
|---|---|
| 拓扑排序 | 满足所有有向边的先后约束 |
| 分治 | 把大问题拆成规模更小的子问题 |
| 树的直径 | 找到树上距离最远的两个结点 |
| 强连通图 | 让任意两个顶点能够互相到达 |
| 卡特兰数 | 按左右子树规模分类计数 |
| KMP 前后缀 | 寻找相等的真前缀与真后缀 |
| 归并统计逆序对 | 利用有序区间快速计算跨区间数对 |
| 快速幂 | 利用二进制拆分和平方减少乘法次数 |
最后记住:算法题不是单纯比谁记得多,而是比谁更善于观察规律、拆解问题,并且认真验证每一步。 🌟
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_60445850/article/details/166373683

