

摘要:cron 把"何时执行"压缩成一行五字段的文本,而真正让它落地的,是三类各司其职的调度器:系统守护进程按分钟心跳扫描,应用框架在进程内维护最近到期的时间队列,分布式平台用行锁和分片把一次触发扩展到整个集群。
1. cron 是什么
cron 诞生于 1970 年代末的贝尔实验室,由 Unix 创始人之一 Ken Thompson 设计,随 Version 7 Unix(1979)对外发布,名字取自希腊语 chronos(时间)。今天各 Linux 发行版自带的实现大多源自 Paul Vixie 在 1987 年重写的 Vixie cron 及其维护分支 cronie,语法上则保持了近五十年不变:一行表达式,声明一个周期规律。
讨论定时任务时,把三件事分开会让问题清晰得多:
- 表达式——声明"何时"的纯文本协议,本身不执行任何东西;
- 调度引擎——解析表达式、维护时间、在触发时刻唤醒任务的程序,如 Linux 的 crond、Java 的 Scheduler;
- 任务本体——被触发的命令或函数。
表达式是一种被反复复用的"时间语言"。所以"写一条 cron"在不同语境里含义完全不同:对运维是编辑 crontab,对 Java 开发者是填 @Scheduled 注解参数,对 Kubernetes 用户是写 CronJob 的 spec 字段。三个语境,本文都会覆盖。
2. cron 表达式:五个字段与八种符号
2.1 五个字段,五个并列的过滤器
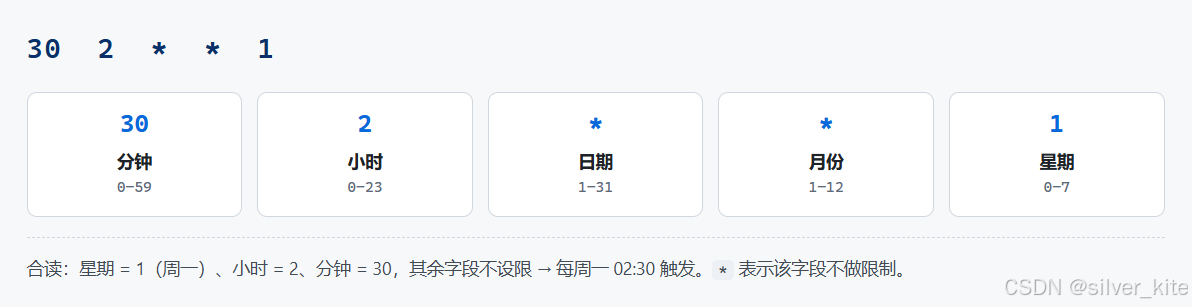
标准表达式由五个空格分隔的字段构成,从左到右依次约束分钟、小时、日期、月份、星期[2]。一条表达式描述的不是一个孤立时刻,而是一个可能无限延伸的匹配集合:任何同时满足五个字段约束的分钟,都会触发一次任务。
五个字段的取值范围和含义如下:
| 字段 | 取值范围 | 说明 |
|---|---|---|
| 分钟 | 0-59 | 每小时的第几分钟 |
| 小时 | 0-23 | 每天的第几小时 |
| 日期 | 1-31 | 每月的第几天 |
| 月份 | 1-12 | 每年的第几个月 |
| 星期 | 0-7 | 每周的第几天,0 和 7 都表示周日 |
2.2 特殊字符:四个通用,四个扩展
五个字段支持四种通用操作符,覆盖绝大多数场景。
| 字符 | 含义 | 示例 | 触发时机 |
|---|---|---|---|
* | 该字段所有合法取值 | * * * * * | 每分钟 |
, | 列举多个取值 | 0 8,12,18 * * * | 每天 08:00、12:00、18:00 |
- | 连续区间 | 0 9-18 * * 1-5 | 工作日 9 点至 18 点的每个整点 |
/ | 区间内按步长取值 | */15 * * * * | 每小时的 0、15、30、45 分 |
四种通用特殊字符。Linux 的标准 crontab 只支持这四种。
步长的语义值得拆开看。*/15 是 0-59/15 的缩写,起点固定为 0;写 10/15 则从 10 开始,得到 10、25、40、55。这意味着"每 15 分钟一次"永远包含第 0 分钟——想避开整点的场景必须显式改起点,比如 5/15 表示 5、20、35、50 分。
Quartz 系框架(Quartz、Spring、ElasticJob 的部分语法)在通用字符之外扩展了四种,用于表达"月末""最近工作日"这类天然带日历语义的时刻[4]。
| 字符 | 含义 | 示例 | 触发时机 |
|---|---|---|---|
? | 不指定(限日期与星期二选一) | 0 0 12 ? * 1 | 每周日 12:00 |
L | 最后一天 / 最后一个星期几 | 0 0 0 L * ?、0 0 17 ? * 6L | 每月最后一天零点;每月最后一个周五 17:00 |
W | 距离指定日最近的工作日 | 0 0 0 15W * ? | 每月距 15 号最近的工作日零点 |
# | 本月第 N 个星期几 | 0 0 0 ? * 6#3 | 每月第三个周五零点 |
Quartz 扩展字符。注意 Quartz 的星期编号是 1–7、从周日开始,与 Linux 的 0–7 并不相同;示例均为 Quartz 标准六字段写法,需满足 2.4 节的字段数约束。
2.3 常用表达式速查
| 表达式 | 含义 |
|---|---|
*/5 * * * * | 每 5 分钟 |
0 * * * * | 每小时整点 |
30 2 * * * | 每天 02:30 |
0 0 * * * | 每天零点 |
0 9 * * 1-5 | 工作日 09:00 |
0 12 * * 0 | 每周日 12:00(0 为周日) |
0 0 1 * * | 每月 1 号零点 |
0 4 8-14 * * | 每月 8 号至 14 号的每天 04:00 |
五字段常用表达式。以上均为 Linux 标准写法,Quartz 六字段版本需在最前面补秒位。
2.4 字段数并不统一
Linux cron 停在五字段;Quartz 在最前面加了秒、在最后加了可选的年份,共六到七字段;Spring 的 @Scheduled 采用 Quartz 风格的六字段(秒开头、无年份)[3];Go 的 robfig/cron 默认五字段、可显式开启秒位。同一个字符串在不同系统里可能指不同的时刻。
易错点
0 12 * * *在 Linux crontab 里是"每天 12:00",放进 Spring 注解里却成了"每小时的第 12 分 0 秒"。跨系统复制表达式时,先核对字段数与星期编码,再谈语义。
2.5 四个经典陷阱
表达式语法本身十分钟就能掌握,翻车几乎都发生在以下几个语义细节上。
- 日期与星期是"或"
0 0 1 * 1 不是"每月 1 号且是周一",而是"1 号或周一都触发"。Vixie cron 的规则是:日期与星期两个字段都被显式限定时,满足任意一个即匹配;只有其中一个是 * 时,另一个才单独生效[2]。要表达"且"的语义,标准做法是拆成两条任务,Quartz 则用 ? 显式忽略一侧。
- 不存在的日期永不触发
0 0 31 2 * 在等待一个永远不会到来的 2 月 31 日。同理 0 0 30 2 *、0 0 31 4,6,9,11 * 都是哑表达式,不会报错,只是永远沉默。月末类需求优先用 Quartz 的 L,或在脚本里自行判断。
- 夏令时制造幽灵时刻
在启用夏令时的时区,春季换时某天的 02:30 可能不存在,秋季换时某天的 01:30 会出现两次。各种实现对这两个区间的处理策略并不一致,任务可能被跳过或延迟。务实做法是让关键任务避开 01:00–03:30 这段换时窗口。
- 时区错位
服务器跑在 UTC、业务在东八区,"工作日 9 点预热缓存"实际会在北京时间 17:00 执行。cronie 支持 CRON_TZ=Asia/Shanghai 声明行;Spring 用注解的 zone 属性;容器环境要确认 TZ 环境变量真的传进了进程。
3. 定时任务的实现方式
3.1 Linux 系统:crontab 与守护进程
最原汁原味的用法在 Linux 服务器上。每个用户有一张自己的任务表,由 crontab 命令编辑,持久化在 /var/spool/cron/ 下(路径随发行版略有差异),系统守护进程负责按分钟扫描并触发[2]。常用命令四件套:crontab -e 编辑、-l 列出、-r 清空(无确认,慎用)、-u <user> 操作指定用户。
crontab -e 编辑的用户任务表# 每天 02:30 执行数据库备份,输出追加进日志 30 2 * * * /opt/scripts/db_backup.sh >> /var/log/backup.log 2>&1 # 工作日 08:45 预热缓存 45 8 * * 1-5 /usr/bin/curl -s http://127.0.0.1:8080/internal/warmup # 每 15 分钟采集一次系统指标 */15 * * * * /opt/scripts/collect_metrics.sh
系统级任务不走 crontab 命令,而是直接落文件:/etc/crontab 与 /etc/cron.d/*(每行比用户任务多一列执行用户),/etc/cron.daily/、cron.weekly/、cron.monthly/ 目录里则放可执行脚本。这些目录由 anacron 体系驱动。
anacron 解决的是 cron 的天然缺陷:心跳以分钟为单位,机器关机时错过的任务不会补跑。7×24 小时的服务器无所谓,但笔记本和台式机常错过日清理、周备份。anacron 在开机后核对每个任务的上次执行时间戳,把超过周期的任务补跑一遍,粒度只到"天"。
注:任务环境里的
PATH通常只有/usr/bin:/bin,脚本里引用非标准路径的程序要写绝对路径;crontab 里的%是特殊字符(第一个 % 之后的内容会作为标准输入),写date +%F必须转义成date +\%F;任务的输出默认邮寄给本地用户,邮箱没人看,长期任务务必显式重定向,否则失败无人知晓。
3.2 应用内调度框架
Web 应用本身是常驻进程,再绕道系统 crontab 反而割裂——任务无法访问应用上下文,还要处理权限与路径。主流语言因此都进化出了进程内调度器:表达式解析、时间管理、触发执行全部在应用进程内完成。
Java · Spring @Scheduled(六字段,秒开头)
@Component
public class ReportJob {

    // 每天 02:30:00 执行,显式锁定时区
    @Scheduled(cron = "0 30 2 * * *", zone = "Asia/Shanghai")
    public void generateDailyReport() {
        reportService.aggregateAndExport();
    }
}
Python · APScheduler
scheduler = BackgroundScheduler()
scheduler.add_job(
    cleanup_expired,            # 目标函数
    trigger="cron", hour=3, minute=0,
    misfire_grace_time=600,      # 错过 10 分钟内仍补跑
    max_instances=1,            # 同一任务不并发
)
scheduler.start()
Go · robfig/cron
c := cron.New(cron.WithSeconds())     // 启用六字段,秒开头
c.AddFunc("0 0 3 * * *", purgeExpired)
c.AddFunc("@every 30m", refreshCache) // 便捷间隔语法
c.Start()这一类框架的共同短板写在出生证上:它们是单机组件。默认调度线程池很小(Spring 默认单线程,一个任务卡住会顺延其余全部任务);进程重启后错过的时刻不会补跑(APScheduler 配合持久化 jobstore 与 misfire 宽限是少数例外);部署多实例时每个实例都会各自触发——重复执行不是故障,而是进程隔离的必然结果。
3.3 分布式调度:锁、行锁与调度中心
应用多实例部署后,"同一任务只跑一次"从进程内的免费属性变成需要显式设计的问题。三条主流路线,投入依次递增。
路线一是分布式锁:任务仍写在每个实例里,触发时先抢一把 Redis 锁(SET key token NX PX ttl),抢到的实例执行。十行代码解决重复执行,但边界很硬:持锁实例在临界点崩溃,这一轮任务直接丢失;锁过期时间小于任务时长会导致第二个实例接着执行;释放必须用"校验唯一 token 再删除"的 Lua 脚本,否则会误删他人的锁。
路线二是数据库行锁:Quartz 集群模式把任务定义与触发时间写进数据库,所有节点轮询同一张表,用行级锁抢占触发权,天然保证唯一执行。代价是全部调度流量经过数据库,规模上限一般,胜在零额外组件。
路线三是调度中心:XXL-Job、ElasticJob 把"何时触发"从应用中抽离,集中到独立的调度层,执行节点只暴露任务接口。调度中心之间用数据库行锁(XXL-Job)或 ZooKeeper 协调(ElasticJob)互斥,再按路由策略把任务派给执行器集群,附带故障转移、分片广播、失败重试与运行报表。任务多到几十上百个、需要可视化和告警时,这是常规终点。
3.4 容器化环境
Docker 单机部署的常见做法是宿主机 crontab 调 docker exec 进入容器。Kubernetes 则提供原生的 CronJob 资源:控制器按表达式定期创建 Job 对象,Job 再拉起 Pod 执行,每次任务都是全新容器,天然避免了宿主机与镜像的耦合。concurrencyPolicy: Forbid 可以禁止上一次未结束时的重叠调度;超过容错窗口(startingDeadlineSeconds)错过的调度会被直接跳过。它不提供应用内的细粒度控制,适合"到点做一件事"的批处理形态。
3.5 秒级精度:crontab 到不了的地方
系统 crontab 的精度被它的心跳模型锚死在分钟级——守护进程睡到下一个整分钟才醒来匹配(见 4.1 节),五字段表达式里也没有写秒的位置。需要"每 5 秒一次""每分钟的第 15 秒"这类粒度时,落点不止一个。
留在系统层,换 systemd timer。它的日历表达式 OnCalendar 精确到秒,如 *-*-* *:*:15 表示每分钟的第 15 秒。注意默认的 AccuracySec=1min 允许实际触发落进计划点之后约 1 分钟的窗口——实现借此把相邻唤醒合并以省电,追求精度必须显式配置 AccuracySec=1s。
进入应用进程,这是大多数场景的正解。Quartz、Spring @Scheduled、robfig/cron 的六字段表达式第一位就是秒,APScheduler 的 cron 触发器则提供独立的 second 参数;不需要表达式时,语言自带定时器同样胜任——Java 的 scheduleAtFixedRate、Go 的 time.Ticker、Node 的 setInterval。它们的精度由进程内的优先队列或时间轮保证(见 4.4 节),毫秒级唤醒正是这些结构的主场。
自写循环时,警惕两种写法的精度差别。while + sleep 是最朴素的诱惑,但下面两段代码一寸之差、天壤之别: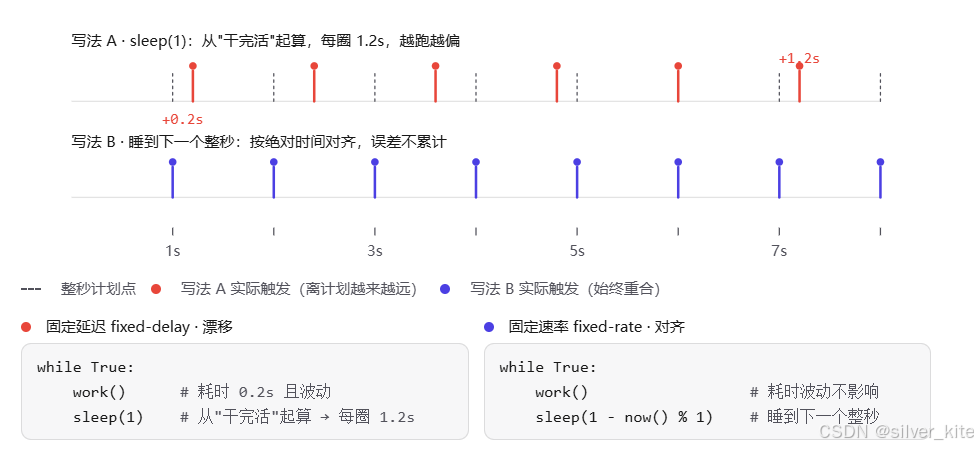
漂移写法(fixed-delay):每圈周期 = 执行耗时 + sleep,误差逐圈累计
while True:
    do_work()                        # 耗时 0.2s 且有波动
    time.sleep(1)                    # 从"干完活"起算,实际周期 1.2s
对齐写法(fixed-rate):每圈睡到下一个整秒,误差不累计
while True:
    do_work()
    time.sleep(1 - time.time() % 1)  # 睡到下一个整秒边界,耗时波动会被拉回
差别只在"下次时间"怎么算——相对累加,还是按绝对边界取整。Java 标准库里恰好有一对对应方法:scheduleWithFixedDelay 是前者的语义,scheduleAtFixedRate 是后者,Go 的 time.Ticker 亦为固定速率语义。
| 需求形态 | 推荐方案 | 关键点 |
|---|---|---|
| 系统守护任务需要秒级 | systemd timer | OnCalendar 写到秒,AccuracySec=1s |
| 应用内每 N 秒的业务动作 | 六字段框架或语言定时器 | 表达式首位即秒,精度由进程内队列保证 |
| 必须自写循环 | while + sleep 对齐整秒 | sleep(1 - now() % 1),防累计漂移 |
| 海量高频延迟任务 | 延迟队列、时间轮 | 别让调度中心每秒空转 |
分布式:别让调度中心每秒一跳
把"每秒一次"塞给 XXL-Job、ElasticJob 这类平台,意味着调度层每秒承受一次数据库行锁争抢与派发往返,任务量一大必然压垮存储。更稳的形态是"低频拉起、进程内自旋":调度中心每分钟触发一次外壳任务,任务内部用时间轮或循环展开成每秒执行;或者改用延迟队列——Redis ZSET 按到期时间排序轮询、RocketMQ 延迟消息——把高频延迟任务从调度器里剥离出去。
最后校准预期:秒级定时器保证的是"不早触发","准时"则受 GC 停顿、线程调度与系统负载影响,几十毫秒内的抖动属于正常现象;追求亚毫秒乃至硬实时的确定性,用户态框架无能为力,需要内核级定时器(Linux timerfd)或实时操作系统。
3.6 选型对比
| 方案 | 适用场景 | 多实例去重 | 主要代价 |
|---|---|---|---|
| 系统 crontab | 单机运维脚本、备份清理 | 不适用(单点) | 环境受限、无观测、错过不补 |
| @Scheduled 等进程内框架 | 单实例应用内的周期任务 | 无,多实例必重复 | 单线程瓶颈、错过不补 |
| 进程内框架 + 分布式锁 | 小规模多实例 | 依赖锁实现的正确性 | 临界崩溃丢一轮、需自管日志 |
| Quartz 集群 | 传统 Java 应用、任务需持久化 | 数据库行锁保证 | 调度吞吐受数据库制约 |
| XXL-Job / ElasticJob | 中大型微服务集群 | 调度中心统一派发 | 多一套平台组件的运维 |
| Kubernetes CronJob | 容器原生的批处理 | 由控制器与 Job 语义保证 | 无秒级精度、无分片能力 |
4. 底层原理:从心跳循环到分布式互斥
4.1 守护进程的心跳循环
Vixie cron 的主循环朴素得近乎固执:算出下一分钟的起点,睡到那一刻,扫描全部任务,匹配则执行,如此往复。它并不依赖"每 60 秒设一个闹钟",而是每次醒来都重新计算"tick + 60 秒"并对齐到分钟边界,把逐次累积的漂移消掉——这也是所有 cron 实现精度锚定在"分钟级"的根本原因。
循环里的三个细节值得展开。变更检测:用户运行 crontab -e 保存时,命令会通知守护进程重载,通知失效时靠每分钟核对文件修改时间兜底。匹配执行:匹配的任务被 fork 成子进程,切换到任务属主的身份后 exec 目标命令,因此任务以用户权限运行、彼此隔离。错过不补:关机或休眠期间的时间窗不会在下次开机时重新扫描,只有 anacron 体系以"天"为粒度补偿日/周/月级任务。
4.2 匹配算法与"下一次触发时间"
解析阶段,每个字段都被编译成显式的取值集合:0-30/10 展开为 {0, 10, 20, 30},1-5 展开为 {1, 2, 3, 4, 5},星号就是该字段的全部合法值。判断一个时刻是否触发,就是五个集合包含测试的交集;唯一的例外在日期与星期这对字段上——Vixie cron 为它们各记录一个"是否为星号"的标志,两个字段都被显式限定时改按"或"匹配,这正是 2.5 节陷阱一的实现根源。
调度器内部还有第二个常量问题:下一次触发在何时。计算从当前时刻出发逐字段试探:在分钟集合里找不小于当前分钟的最小值,找不到就向小时字段进位并把分钟重置为集合最小值,逐级向上直到所有字段收敛。Quartz、Spring、robfig/cron 都内置了这套"表达式反推 next fire time"的例程,Quartz 更是把结果持久化为 QRTZ_TRIGGERS 表里的 NEXT_FIRE_TIME 列,作为集群抢占的排序依据。
4.3 两种工作模型,与 Quartz 的混合设计
心跳扫描并不是唯一的睡法。以"谁决定醒来时机"为准,调度器分成两派工作模型:
- 心跳扫描型:不记录任何"下次时间",固定周期醒来全表匹配。cron 守护进程是这一派——任务表随时增删、粒度只到分钟,每分钟空转一次的开销可以忽略,换来的是"改了任务下一圈自然生效"的简单性。
- 最近到期型:所有任务按"下次触发时间"排序,线程只盯最近的一个,算出时间差睡过去,醒来执行、再算该任务的下一次时间。JDK 的
ScheduledThreadPoolExecutor、Go 的运行时定时器都属此派。它必须解决心跳模型没有的问题:新任务若比当前等待的更早到期,必须主动唤醒线程,否则会睡过头。
Quartz 的调度线程是两者的混合,这不是折中,而是处境使然。它的粒度要求到秒——若照搬心跳扫描,等于每个节点每秒空扫一次数据库,集群模式下这是一场行锁风暴;而它的触发器又必须持久化在数据库里供集群抢占(见 4.5 节),纯内存的优先队列重启即丢,担不起这份职责。于是它两头取巧:QuartzSchedulerThread 从 JobStore 按 NEXT_FIRE_TIME 取出最近的一批触发器,睡到最早的触发点;这个等待有两个出口——进程内新调度了更早的任务时,内部信号会提前叫醒它重算;集群里其他节点写入的触发器无法跨进程通知本节点,则由兜底超时(idleWaitTime,默认约 30 秒)保证最多约 30 秒后重查数据库。空表时几乎不占资源,新任务又不至于睡过头——这正是"记录下次时间、睡到执行时刻"的现实版本。
4.4 两种计时内核:优先队列与时间轮
分钟粒度的 cron 不在乎计时开销,但当精度提到毫秒、定时器数量到十万级——网络连接超时、延迟消息、限流窗口——调度内核的数据结构就开始分化。应用框架里存在两派主流实现。
优先队列一派用最小堆维护"按最近到期时间排序"的全序结构,堆顶永远是下一个该执行的任务。插入和取消是 O(log n),查看堆顶 O(1)。JDK 的 ScheduledThreadPoolExecutor 底层就是一个延迟工作队列。缺点在高并发下:所有插入都竞争堆的全局锁,每次出队都要重新堆化。
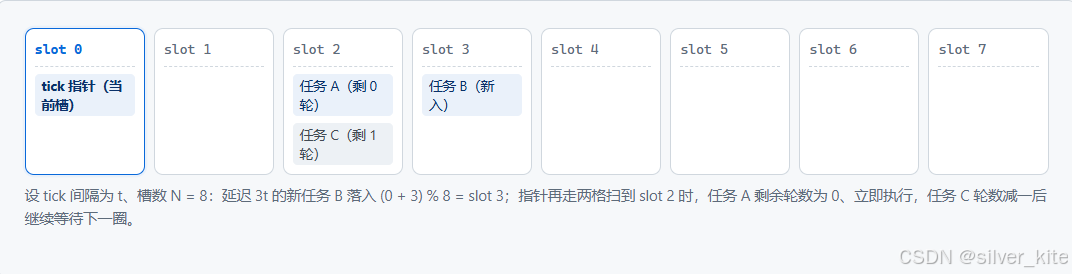
时间轮一派放弃全序,改用散列。把一圈划分成 N 个槽,指针每 tick 前进一格;新任务按 (当前指针 + 延迟/tick) % N 落槽,追加到槽内链表尾,插入退化为 O(1)。指针扫过某槽时,链表里"剩余轮数"为零的任务执行,其余轮数减一后原地等待。Netty 的 HashedWheelTimer 是单层实现的代表;Kafka 则用层级时间轮覆盖任意长延迟——上层槽到期后任务降级进入下层,像时钟的时针向分针、分针向秒针交棒一样,用固定大小的小轮子管理无限的时间。
| 维度 | 优先队列(最小堆) | 时间轮 |
|---|---|---|
| 插入 | O(log n) | O(1) |
| 取消 | O(log n) | O(1)(链表摘除) |
| 到期检查 | O(1)(看堆顶) | O(1)(扫当前槽) |
| 高并发瓶颈 | 堆的全局锁与堆化 | 无全序维护,几乎无竞争 |
| 代表实现 | ScheduledThreadPoolExecutor;Quartz 内存模式(红黑树,同一语义) | Netty HashedWheelTimer、Kafka 层级时间轮 |
两种计时结构的复杂度对比。千级以内任务两者无感;十万级毫秒级定时器是时间轮的主场。
4.5 Quartz 集群如何只跑一次
Quartz 集群的互斥完全落在数据库行锁上[4]。触发器记录带一个状态机:WAITING → ACQUIRED → EXECUTING → 回到 WAITING。每个节点扫描"下次触发时间已到"的 WAITING 触发器时,先在行锁事务内把状态改为 ACQUIRED——同一行只有一个节点能改成功,其余节点查到状态已变就自然跳过。执行完毕后节点更新 NEXT_FIRE_TIME,把状态交还 WAITING,等待下一轮争抢。
misfire 机制处理另一种失败:节点在触发后、执行前宕机,触发器会卡在中间状态。超过阈值(misfireThreshold,默认 60 秒)仍未真正执行的触发器进入 misfire 流程,按策略二选一——立即补跑一次再恢复正常节奏(FIRE_ONCE_NOW,CronTrigger 的默认策略),或放弃本轮、等下一个调度点(DO_NOTHING)。配合 SCHEDULER_STATE 表的实例心跳,集群能感知节点离场并回收其触发器。
4.6 分布式去重与分片的工程要点
分布式锁的正确姿势比想象中窄。锁值必须放唯一 token,释放时用 Lua 脚本校验 token 后再删除,避免 A 的锁被 B 误删;任务可能超过锁 TTL 时,要么用看门狗自动续期(Redisson 的做法),要么放弃锁、改用"抢占即写库"的方案。还要清醒:锁只解决重复,不解决丢失——该触发的瞬间持锁节点恰好崩溃,这一轮任务就消失了,业务上需要幂等设计或补偿机制兜底。
调度中心模式把问题转化得更彻底。以 XXL-Job 为例:调度线程每秒把"未来 5 秒内到期"的任务推进一个 60 格的秒级环形队列,由独立线程逐秒消费派发;多调度节点之间靠数据库行锁争抢,保证同一任务同一秒只被一个节点派发。执行层的重复被路由策略消化:故障转移选一个可用实例,分片广播让全部实例各领一个分片号,把一份全量数据切片后并行消化——重复执行问题就此变成并行扩展能力,这是分布式调度相对单机最本质的收益。
5.END
写表达式先核对字段数与星期编码,跨系统差异比语法本身更容易埋雷;从单机走向集群的分水岭不是性能而是互斥,先考虑"多实例时谁保证只跑一次"再谈选型;只有当精度超过分钟、定时器数量超过万级时,时间轮这类结构才值得请进自己的代码,其余时候它只是基础设施替你消化掉的复杂度。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2401_87660168/article/details/166690366

