

在上篇的内容中我们学习了,TCP与IP的关系,IP协议的基本概念,IP协议格式,网段划分
一.路由
1.数据路由过程
在复杂网络里找到去往目标地址的传输路径。
举个例子方便理解:假设在通信不发达的时代,你来到一个陌生地点,只知道目的地名称,该如何抵达?最可行的办法就是沿路询问路人。被询问的路人有三种情况:不清楚路线,但告诉你可以去问下一个人;知道具体怎么走;自身所在位置就是终点,无需继续查找。
我们可以把自己看作数据包,目的地对应目标 IP,询问的路人就相当于路由器。路人判断回答的过程,就是路由器查询路由表。路由转发就是这样一跳一跳(Hop By Hop)不断 “问路” 的过程。这里的 “一跳”,指数据链路层上的一段传输范围,在以太网中,就是从源 MAC 地址到目的 MAC 地址之间的数据帧传输区间。
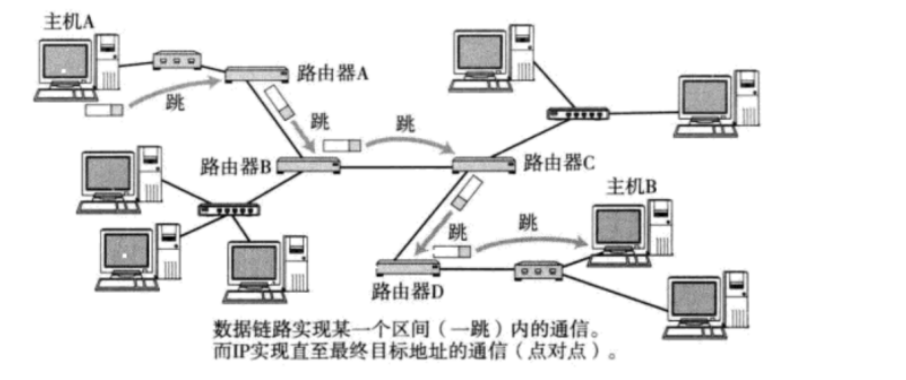
当决定把数据交给下一跳路由器时,这个下一跳路由器必然和当前主机处于同一个局域网。
这种一跳一跳的转发过程,就是子网内的数据转发。从宏观来看,整个互联网本质就是由无数个子网拼接组成。
IP 数据包的传输过程和问路的例子类似,传输途中会经过多个路由器完成路由转发。数据包每到达一台路由器,路由器都会查看报文的目的 IP 地址,判断这个数据包可以直接交付给目标主机,还是转发给下一跳路由器。该过程不断重复,直到数据包抵达目标 IP 对应的主机。
如何判断当前数据包应该转发到什么位置?
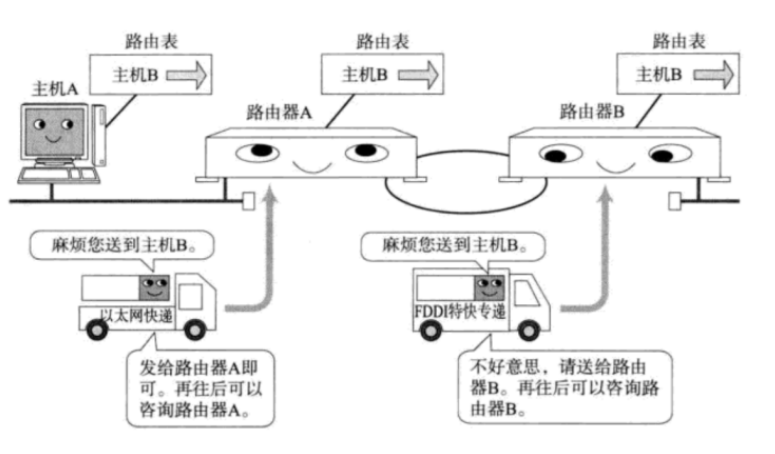
依靠每个网络节点内部维护的路由表来完成。
路由器查询路由表之后,会出现三种结果:
- 查询路由表,找到匹配条目,确定数据包需要转发到的下一跳子网。
- 路由表中没有找到匹配的子网条目,路由器会把数据包交给默认路由进行转发。
- 查询路由表后发现,数据包的目标网络就是当前所在子网,路由器直接把数据包交付给本网内对应的主机。
2.路由表
- 每个路由器内部会维护一个路由表,我们在 Windows 下可以用命令:route PRINT 查看路由表。
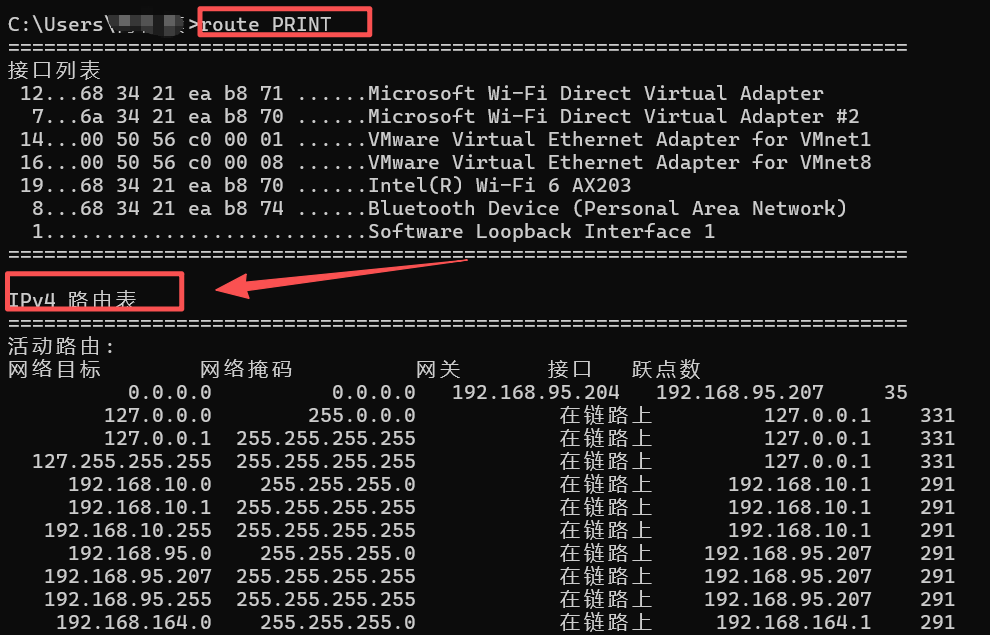
- 在 Linux 下,可以通过命令:route 查看云服务器上对应的路由表。
如果目的 IP 命中了路由表,那直接转发即可。
路由表中的最后一行主要由下一跳地址和发送接口两部分组成,当目的地址与路由表中其它行都不匹配时,就按缺省路由条目规定的接口发送到下一跳地址。
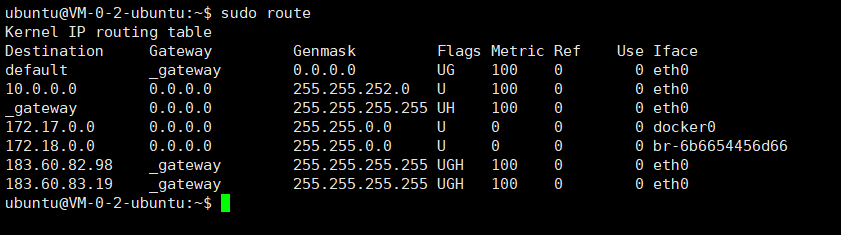
- Destination:目的网络地址。
- Gateway:下一跳地址。
- Genmask:子网掩码。
- Flags:U 标志表示此条目有效(可以禁用某些条目),正在使用;G 标志表示此条目的下一跳地址是某个路由器的地址,默认网关(路由器)。没有 G 标志的条目表示目的网络地址是与本机接口直接相连的网络,不必经路由器转发。
- Iface:发送接口。
Destination     Gateway         Genmask         Flags  Metric  Ref  Use  Iface
192.168.10.0    *               255.255.255.0   U      0       0    0    eth0
192.168.56.0    *               255.255.255.0   U      0       0    0    eth1
127.0.0.0       *               255.0.0.0       U      0       0    0    lo
default         192.168.10.1    0.0.0.0         UG     0       0    0    eth0
发往
192.168.10.0/24的数据,从eth0直连出去。发往
192.168.56.0/24的数据,从eth1直连出去。发往
127.0.0.0/8的数据,走本地回环lo。其他所有数据,走默认路由,下一跳是
192.168.10.1,从eth0出去。
这台主机有两个网络接口:一个网络接口连到 192.168.10.0/24 网络,另一个网络接口连到 192.168.56.0/24 网络。
如果待发送数据包的目的地址为 192.168.56.3?
将该地址和第一条路由的子网掩码做按位与运算,得到结果 192.168.56.0,和第一条的目的网络不一致。继续和第二条路由的子网掩码做与运算,得到 192.168.56.0,与第二条的目的网络吻合,数据包就从 eth1 接口发出。因为 192.168.56.0/24 网段是 eth1 接口直连的网络,可以直接把数据包发给目标主机,不需要再交给其他路由器转发。
如果待发送数据包的目的地址为 202.10.1.2?
依次和路由表前面的条目匹配,全部无法命中。此时匹配默认路由,数据包从 eth0 接口发出,转发到 192.168.10.1 这台路由器,后续由 192.168.10.1 根据自身路由表,继续确定下一跳。
(1)查询路由表过程
当 IP 数据包抵达路由器后,路由器会遍历路由表内的所有条目。拿报文的目的 IP 地址,依次和每条路由表的子网掩码 Genmask 执行按位与运算,算出报文所属的目标网络。将运算结果和路由条目的目的网络 Destination 比对,二者一致的话,就把数据包从对应的出接口 Iface 转发出去。 如果遍历完成后,没有找到任何匹配的目的网络,路由器就会把数据包交给默认路由,对应路由表里目标网络为 default 的条目。
(2)总结
- 遍历路由表条目。
- 目的 IP 和子网掩码做按位与运算,匹配目标网络;匹配失败,则走默认网关。
- 通过对应的 Iface 接口发送数据包。
注意:IP 协议并不负责设备实际转发的动作,IP 提供
3.路由表生成算法(这部分选学)
路由表既可以由网络管理员手动配置维护,也就是静态路由;也能够依靠相关算法自动生成,即动态路由。常见的生成算法包含距离向量算法、LS 算法、Dijkstra 算法等。
二.分片与组装
在路由器之间传递的确实是 IP 报文,但真正在网线上跑的是 MAC 帧,MAC 帧是数据链路层的协议。
1.最大传输单元 —— MTU
MAC 帧属于数据链路层协议,它会把 IP 层下发的数据封装成数据帧,再发送到网络中。MAC 帧承载的有效载荷存在最大长度限制,IP 层传给 MAC 帧的报文不能超过这个上限,也就是链路层单次能够向外传输的报文大小上限,这个数值叫做最大传输单元(MTU,支持修改),默认一般为 1500 字节。
但是单个报文的大小并不是由 IP 决定的,在网络里控制报文大小的是 TCP。
所以 IP 层设计了对应的处理方案:当 IP 层要传输的数据超过 1500 字节时,IP 会先对这份数据进行分片处理,再把分片之后的数据交给下层封装成 MAC 帧发送。
由发送端的 IP 层完成分片工作,接收端的 IP 层负责重组分片。
分片功能依靠 IP 报头里下面这三个字段实现:
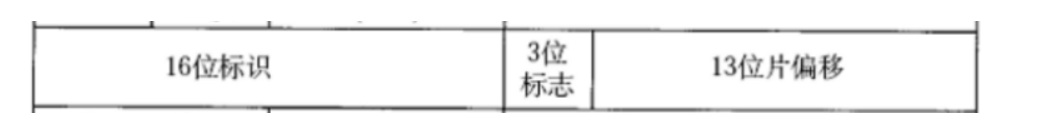
- 16 位标识:用来唯一标记主机发出的一份报文。如果这份报文在 IP 层被分片,那么所有分片都会使用相同的标识 ID。
- 3 位标志字段:第一位保留,暂未定义用途。第二位是禁止分片位,若置 1,报文长度超过 MTU 时 IP 模块会直接丢弃报文。第三位为 “更多分片” 位,如果报文没有分片,该位为 0;如果存在分片,除最后一个分片外,其余分片该位都置 1。
- 13 位片偏移:代表当前分片相对于原始报文数据起始位置的偏移量。分片实际的字节偏移量等于该字段数值乘以 8。因此除最后一个分片以外,其余分片的数据长度必须是 8 字节的整数倍,否则分片的数据无法对齐
那么如何识别报文和报文之间的不同?
可以通过 16 位标识,不同的报文标识不同,相同报文的分片具有相同的标识。
如果一个报文没有被分片的标志是什么?
更多分片标志位为 0,13 位片偏移也为 0。 判断逻辑:
if(报文->更多分片 & 0x1)
    return 是分片报文;
else if(报文->片偏移 > 0)
    return 是分片报文;
else
    return 独立完整报文;
解释:
- 只要更多分片 (MF) 标志位 = 1:说明后面还有分片,当前报文一定是分片。
- 如果 MF=0,但片偏移 > 0:代表这是分片的最后一片,同样属于分片报文。
- MF=0 并且 片偏移 = 0:代表没有分片,是完整独立 IP 报文。
2.分片流程
如何区分分片里的起始分片、中间分片和末尾分片?
- 起始分片:更多分片标志位为 1,片偏移等于 0。
- 中间分片:更多分片标志位为 1,片偏移不为 0。
- 末尾分片:更多分片标志位为 0,片偏移不为 0。
中间分片可能存在多个,那如何确认所有分片已经全部收到?
把收到的分片按照片偏移从小到大升序排列,利用当前分片偏移量 + 当前分片数据长度 = 下一个分片的偏移量进行校验。如果等式不成立,说明中间存在分片丢失;如果可以一直推算到末尾分片,则代表所有分片全部接收完毕。
假设 IP 层需要发送 2980 字节的数据,IP 报头不含选项字段,加上 20 字节报头后总长度为 3000 字节,超出 MTU,需要分片。
注意:分片切分的是原始数据部分,每一段分片数据都要单独加上 IP 报头。
先切出 1480 字节纯数据,加上 20 字节 IP 报头,总长度 1500 字节。
剩余 1500 字节纯数据,继续切出 1480 字节纯数据,加上 20 字节 IP 报头,总长度同样 1500 字节。
最后剩余 20 字节纯数据,加上 20 字节 IP 报头,得到 40 字节的分片。
最终分为三段,报文总长度依次为:1500、1500、40。
接下来为三个分片报文填写报头中的三个分片相关字段:
| 分片报文序号 | 16位标识 | 更多分片 | 13位片偏移 |
|---|---|---|---|
| 1 | 1111 | 1 | 0 |
| 2 | 1111 | 1 | 185 |
| 3 | 1111 | 0 | 370 |
原始数据:2980 字节,每片携带数据:1480、1480、20。
片偏移 = 该片数据在原始数据中的起始位置 ÷ 8
第 1 片:起始位置 0,偏移 = 0 ÷ 8 = 0
第 2 片:起始位置 1480,偏移 = 1480 ÷ 8 = 185
第 3 片:起始位置 2960,偏移 = 2960 ÷ 8 = 370
分片报文的三个 IP 头部字段填写规则如下:
三份分片报文的 16 位标识必须保持一致,用来标识它们属于同一个原始 IP 报文。具体填什么值由发送方决定,不一定非得是 1111,图里只是举例。
- 第 1 个分片:更多分片标志位填 1,片偏移填 0。代表这是起始分片,后面还有分片。
- 第 2 个分片:更多分片标志位填 1,片偏移等于 1480 ÷ 8 = 185。代表这是中间分片,后续仍有分片。
- 第 3 个分片:更多分片标志位填 0,片偏移等于 2960 ÷ 8 = 370。代表这是最后一个分片,没有后续分片。
3.组装流程
通过 16 位标识来确定这些报文曾经属于同一个报文,通过更多分片加上 13 位片偏移来确定该报文有没有被切分,以及哪部分是开头、哪部分是结尾、顺序是怎样的。
先找到分片报文中 13 位片偏移为 0 的那一片,然后提取出它 IP 报头中的 16 位总长度字段,通过计算就能得出下一个分片报文对应的 13 位片偏移。按照这种方式,依次把各个分片报文拼接起来。
一直拼接到一个“更多分片”标志位为 0 的分片报文,就说明分片报文组装完毕了。
计算方式:用当前分片的片偏移乘以 8,得到当前分片在原始数据中的起始位置,再加上当前分片携带的数据长度,就得到下一个分片的起始位置,再除以 8 就是下一个分片的片偏移。把公式补上会更清楚。
4.分片的影响(坏处)
分片行为不是主流,在网络通信里,严重推荐不分片。原因如下:
在网络层分片和组装的过程,上层,也就是传输层和应用层,是不知道的。
分片会增加丢包的概率。因为一个报文被切成了多个报文,只要有一个报文丢失,就会造成拼接失败,因为不知道是哪个报文丢了。TCP 不关心分片。而网络层有校验和,如果报文丢弃了,就导致传输层重传,比如 TCP,而 UDP 就直接丢包了,对 UDP 的影响更大,整个报文都要重传。
更准确地说,是 IP 层不负责重传,它丢了分片不会通知上层。上层只看到整个数据报没到,所以只能重传整个报文。这才是分片影响大的根本原因。
UDP 受影响更大,是因为 UDP 本身不保证可靠,也不重传。如果 UDP 报文被分片了,其中一片丢了,整个 UDP 报文就废了,接收端根本收不到完整数据,也没有机制让 UDP 重传。上层应用只能自己处理,或者干脆丢数据。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2501_93351213/article/details/166375239

