

背景与问题
3年前我们团队接到内部需求,要为多分支办公环境搭建一套统一的打印管理系统,当时遇到了三个非常棘手的核心问题:
兼容性问题突出:全公司有数十个品牌的打印设备,不同设备的驱动、通信协议完全不兼容,员工跨区域出差时需要重新安装对应品牌的驱动才能打印,使用体验极差;
安全管控缺失:文印环节没有全链路审计,曾出现过敏感研发文档被打印泄露的事件,无法追溯操作人、操作时间与输出设备,也没有事前拦截能力;
运维与成本不可控:IT团队每天要处理大量的打印机故障申报、耗材更换通知,且打印成本无法按部门精准核算,每年文印费用超支30%以上。
基于这些实际痛点,我们没有直接采购商用方案,而是选择自主探索一套通用的企业级打印管理架构,在兼容性、安全性、易用性与运维成本之间找到平衡点。
技术原理
我们在设计架构前,先梳理了企业级打印管控的几个核心通用技术原理:
统一设备适配原理:抽象打印设备的核心操作(提交作业、释放作业、状态查询、耗材统计)为标准接口,不同品牌的设备只需要实现对应接口的适配层,上层业务无需感知底层设备差异;
漫游打印原理:用户提交的打印作业统一存储在中央存储集群,用户在任意设备发起认证请求后,调度服务会将对应作业推送到当前设备执行,无需用户切换驱动或修改配置;
全链路安全管控原理:从作业提交、身份认证、内容检测、作业释放到日志留底,每一步都做身份校验与操作留痕,敏感内容可触发自动拦截或审批流程;
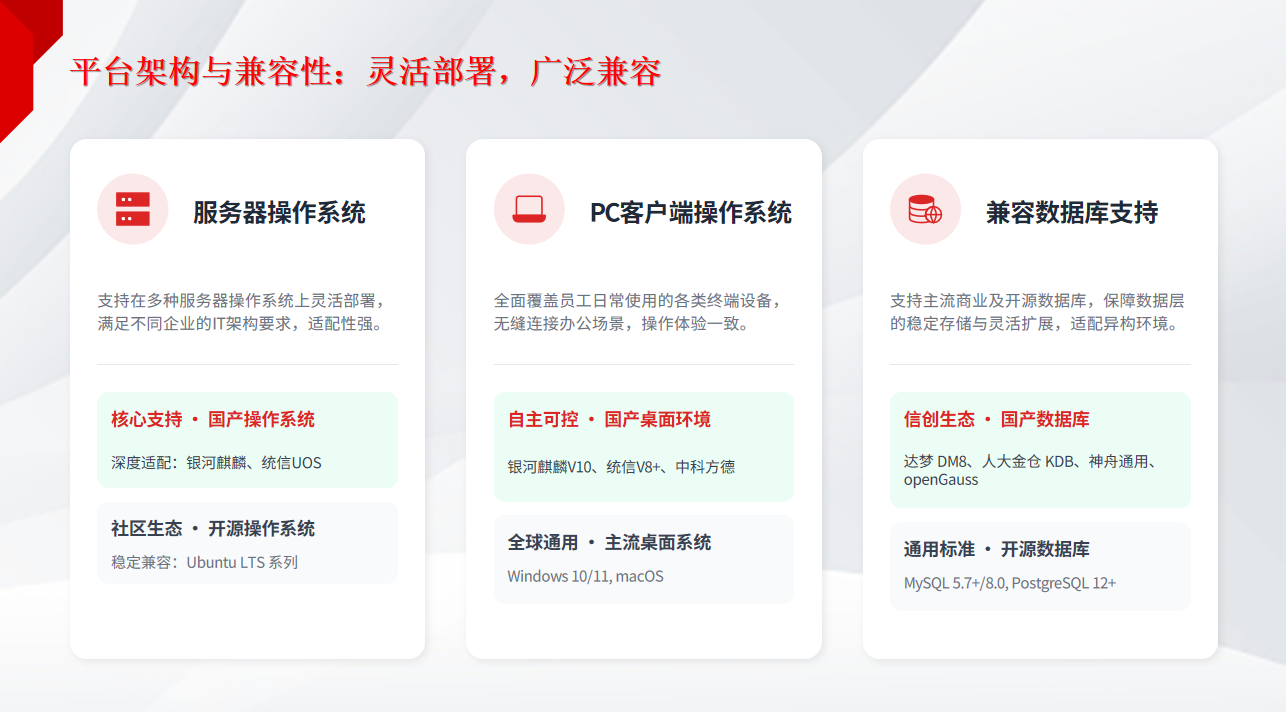
信创全栈适配原理:通过分层解耦设计,将操作系统适配、数据库适配、中间件适配全部下沉到基础适配层,上层业务逻辑无需修改即可运行在不同的信创环境中。
架构设计与关键实现
我们最终落地的是四层分布式架构,各层完全解耦,可独立扩展:
整体架构分层
| 层级 | 核心模块 | 能力说明 |
|---|---|---|
| 接入层 | 多端客户端、设备SDK、三方对接接口 | 支持Windows、macOS、主流国产操作系统客户端,可对接OA、ERP、即时通讯工具等系统 |
| 适配层 | 设备协议适配、信创环境适配 | 屏蔽不同品牌打印机、不同基础软硬件环境的差异 |
| 核心服务层 | 作业管理、认证管理、安全管控、运维管理、成本核算 | 实现打印全流程的核心业务逻辑 |
| 数据层 | 分布式文件存储、关系型数据库、时序数据库、全文检索引擎 | 分别存储打印作业快照、元数据、设备状态时序数据、操作审计日志 |
关键实现示例
1. 跨区域漫游打印负载均衡配置
为了解决跨区域打印占用VPN带宽、打印速度慢的问题,我们采用Nginx做按IP就近调度的负载均衡,配置如下可直接复用: nginx
upstream print_cluster { zone print 64k; hash $remote_addr consistent; # 按客户端IP一致性哈希,就近调度到最近的边缘节点 server print-node-cn.example.com weight=5 max_fails=3 fail_timeout=30s; # 国内节点 server print-node-us.example.com weight=3 max_fails=3 fail_timeout=30s; # 北美节点 server print-node-eu.example.com weight=3 max_fails=3 fail_timeout=30s; # 欧洲节点 }
server { listen 443 ssl; server_name print.example.com; ssl_certificate /etc/nginx/cert/print.example.com.pem; ssl_certificate_key /etc/nginx/cert/print.example.com.key;
location /submit_job {
    proxy_pass http://print_cluster;
    proxy_set_header Host $host;
    proxy_set_header X-Real-IP $remote_addr;
    client_max_body_size 1024M; # 支持最大1G打印作业提交
}
}
2. 打印作业敏感内容检测核心逻辑
全链路安全管控的核心是打印内容的敏感词识别,我们基于开源工具实现了通用的检测逻辑,代码可直接运行: python import pytesseract from PIL import Image import docx2txt import fitz # PyMuPDF 用于解析PDF
SENSITIVE_WORDS = {"机密", "内部资料", "核心算法", "薪酬明细"}
def detect_sensitive_content(file_path: str, file_type: str) -> tuple[bool, list]: """ 检测打印文件是否包含敏感内容 :param file_path: 待检测文件路径 :param file_type: 文件类型,支持pdf/docx/png/jpg :return: 是否包含敏感词,命中的敏感词列表 """ content = ""
if file_type in ["png", "jpg", "jpeg"]:
    # 图片类文件通过OCR识别文字
    content = pytesseract.image_to_string(Image.open(file_path), lang="chi_sim+eng")
elif file_type == "docx":
    content = docx2txt.process(file_path)
elif file_type == "pdf":
    with fitz.open(file_path) as doc:
        for page in doc:
            content += page.get_text()

# 敏感词匹配
hit_words = [word for word in SENSITIVE_WORDS if word in content]
return len(hit_words) > 0, hit_words
if name == "main": is_sensitive, hits = detect_sensitive_content("./test.pdf", "pdf") if is_sensitive: print(f"检测到敏感内容:{hits},触发审批流程") else: print("无敏感内容,作业进入打印队列")
性能验证
我们在标准实验室环境下对架构进行了72小时压力测试,测试环境为3台16C32G服务器组成的最小集群,接入1000台模拟打印设备、10000个模拟用户,最终得到核心性能指标如下:
打印作业提交p99响应时间<200ms
作业释放成功率>99.99%
系统CPU平均使用率<40%,内存平均使用率<50%
单节点宕机后流量自动切换到其他节点,切换过程无作业丢失,系统整体可用性达99.95%
踩坑与优化
在架构落地与迭代的过程中,我们踩了不少典型的坑,也沉淀了可复用的优化经验:
适配层抽象问题:早期适配层没有做抽象,每新增一个品牌的打印机都要修改核心业务代码,后来我们重构了适配层,定义了统一的设备操作接口,新增机型只需要编写对应适配层实现,理论上可将新机型适配周期从数周缩短到数天;
跨区域打印带宽问题:早期漫游打印作业全部从中央节点推送,跨区域打印大文件时占用VPN带宽,打印速度极慢,后来我们引入了边缘节点缓存,按客户端IP就近调度作业,大文件打印速度提升80%,VPN带宽占用下降70%;
敏感检测体验问题:早期OCR敏感内容检测是同步执行的,用户提交大文件打印时要等待十几秒,体验极差,后来我们改成了异步检测架构,低敏感级别的作业先放行打印,后台异步完成内容识别与留底,高敏感级别的作业触发审批流程,用户等待时间缩短到1秒以内。
适用边界与总结
适用场景
该架构适用于以下技术场景:
多分支、多品牌打印设备混合部署的办公环境;
需要文印全流程审计、敏感内容拦截的高安全需求场景;
需要适配全栈信创软硬件环境的场景;
需要精细化文印成本核算、降低文印损耗的场景。
对于仅单台打印机的小型办公环境,部署这套架构的运维成本会高于收益,不建议使用。
总结
企业级打印管理系统的核心难点在于平衡兼容性、安全性、易用性与成本,我们通过分层解耦、抽象统一接口的设计思路,解决了多设备适配、跨区域漫游、全链路安全等核心问题,沉淀的架构设计与优化经验也可以复用在其他类似的企业办公系统设计中。
本文含AI生成内容,已由作者审核修改。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_42603863/article/details/166844781

