

上半年接了个内部知识库项目,需求听着很标准:把几十万份技术文档喂给大模型,让同事能直接问答。我照例画了张架构图——业务数据走关系库,Embedding 另存一套向量库,中间再加条同步链路。图画完越看越眼熟,这不就是前两年我们踩过的那套坑么?
那次项目上线后,隔三差五就出幻觉:业务表刚更新完,向量库还没同步完,模型已经拿着过期的 chunk 一本正经地乱答。更要命的是排查链路,得同时查两套库、两套监控,出了问题根本说不清是哪边没对齐。
所以这次我换了个思路:能不能不折腾两套存储,把向量和业务数据直接塞进一个数据库里?
试下来,KingbaseES V9 的原生向量引擎基本能把这个事办了。
先说说为啥我排斥"向量库 + 关系库"这种拼盘架构
不是说独立向量库不能用,我在一些小项目里用过 pgvector、Milvus,效果都不错。但到了企业级知识库这个规模,拼盘架构有几处让我很难受的地方:
数据一致性。业务库更新和向量库同步天然有时间差,哪怕是几十毫秒,只要模型恰好在窗口期检索,就会拿到脏数据。RAG 的幻觉问题,根子往往不在模型,而在数据没对齐。
延迟叠加。一次 RAG 请求要在关系库和向量库之间来回跳,量小的时候无所谓,文档上亿之后 P99 就是另一回事了。
运维翻倍。备份、监控、容灾、权限审计全都要做两套,人力和成本都上去。
这些问题的本质其实就一个:向量和业务数据被物理隔离了。如果它们能共享同一个事务边界,很多麻烦自然就没了。
KingbaseES V9 的做法是把向量引擎直接做进内核,而不是外挂一个插件。这带来的最大好处不是某个查询快了多少,而是 Embedding 和业务行数据可以在同一张表、同一个事务里一起提交、一起回滚。
架构设计:我最后只放了三个组件
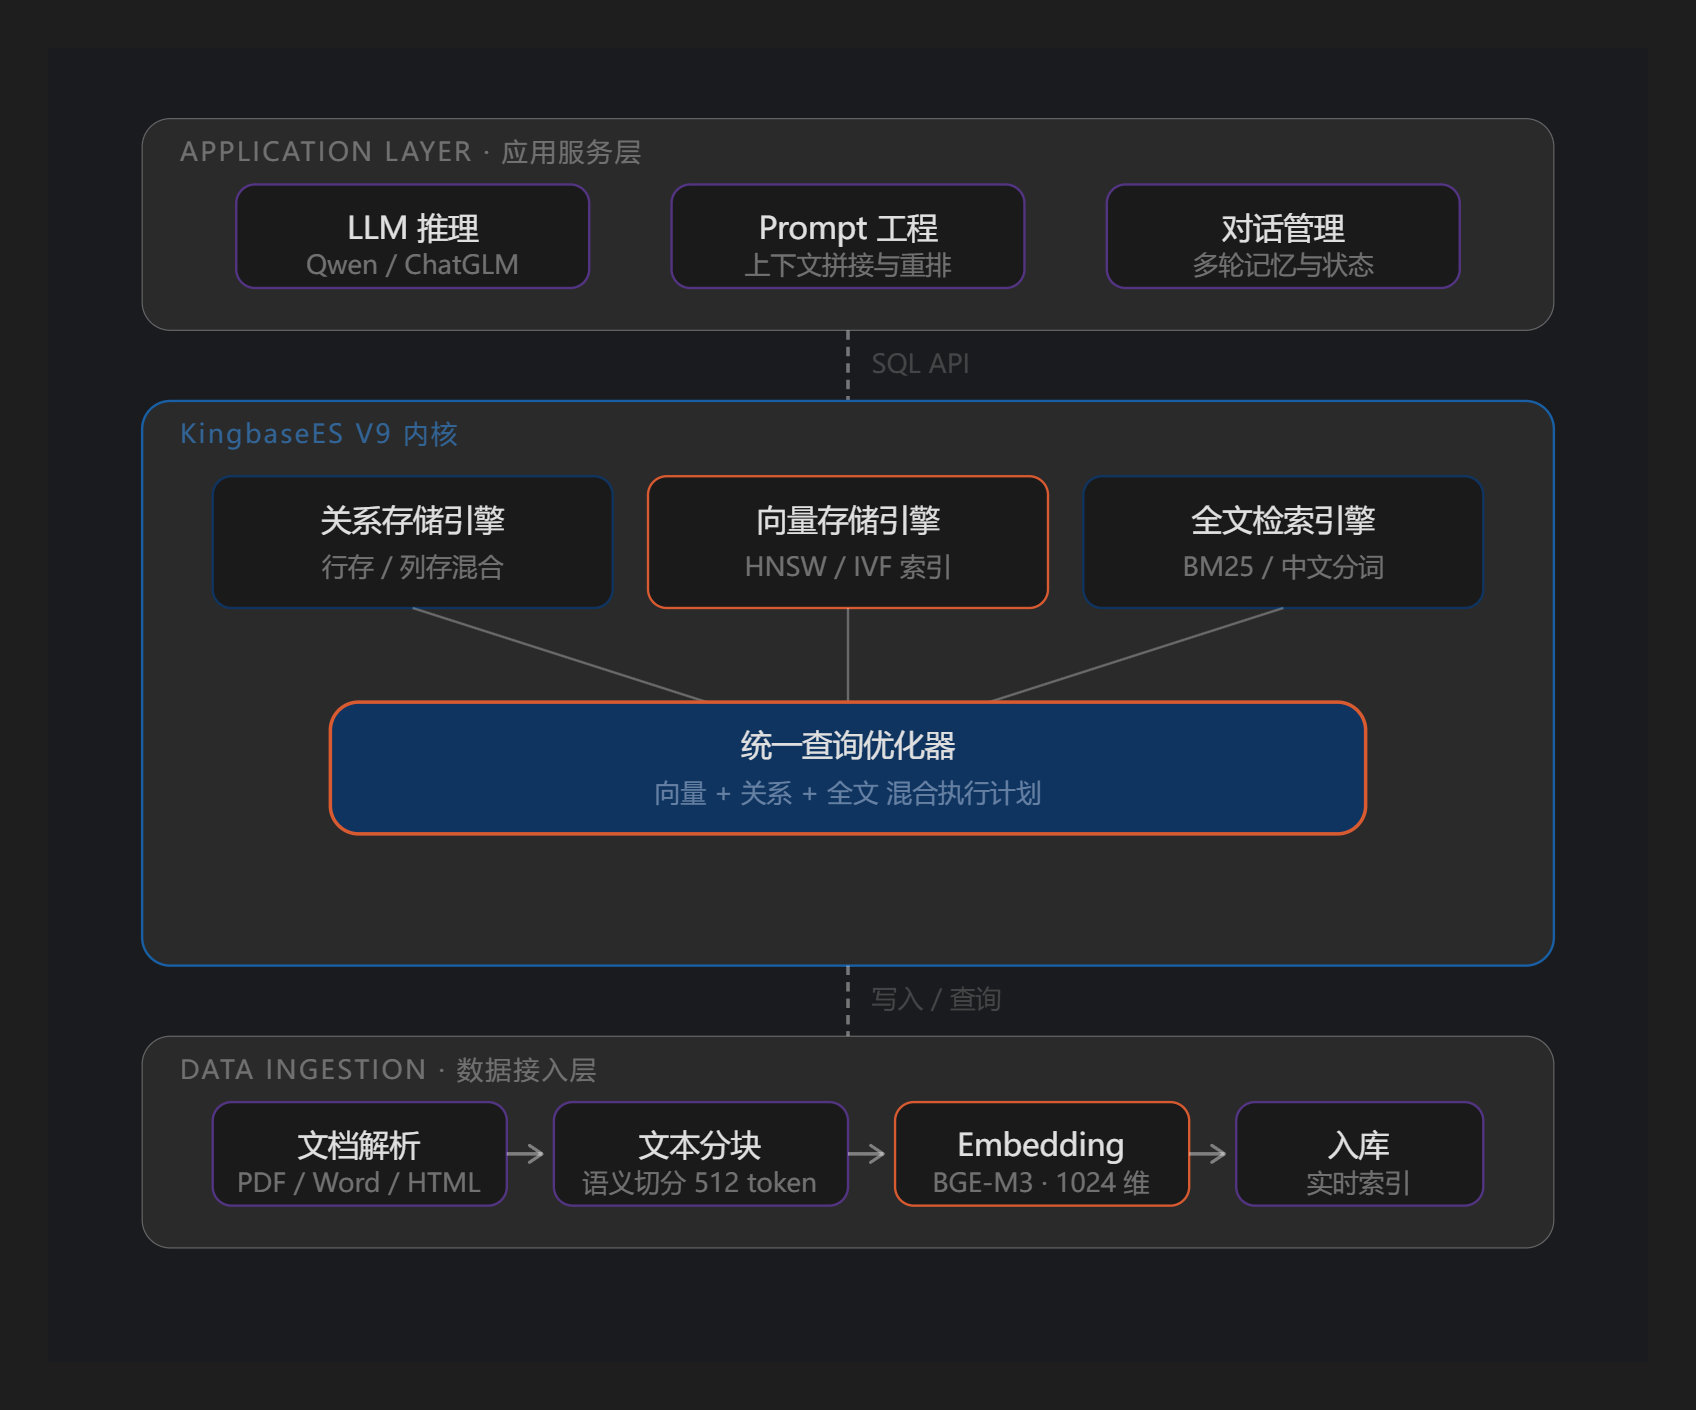
我的目标是尽量少依赖。最终链路很干净:
- 一个 KingbaseES V9 实例,同时管关系和向量;
- 一个 Embedding 模型,我用的 BGE-M3;
- 一个 LLM,对接的是 Qwen。
没有独立的向量数据库,没有 ETL 同步工具,也没有消息队列。示意图还是用了 KingbaseES 官方那张,逻辑就是:用户提问 → Embedding → KingbaseES 混合检索 → 拼 Prompt → LLM 生成。
数据模型:向量和元数据放一起
这是我的建表 SQL,核心思路是把 embedding 列和 department、security_level 这些业务字段放在同一张表里:
CREATE TABLE knowledge_base (
    id          BIGSERIAL PRIMARY KEY,
    doc_id      VARCHAR(64) NOT NULL,
    chunk_id    INTEGER NOT NULL,
    title       VARCHAR(512),
    content     TEXT NOT NULL,
    embedding   VECTOR(1024) NOT NULL,
    source_type VARCHAR(32),
    department  VARCHAR(64),
    security_level VARCHAR(16) DEFAULT 'internal',
    created_at  TIMESTAMPTZ DEFAULT NOW(),
    updated_at  TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX idx_kb_embedding ON knowledge_base
    USING hnsw (embedding vector_cosine_ops)
    WITH (m = 16, ef_construction = 64);

CREATE INDEX idx_kb_dept ON knowledge_base (department);
CREATE INDEX idx_kb_source ON knowledge_base (source_type);
CREATE INDEX idx_kb_security ON knowledge_base (security_level);

CREATE INDEX idx_kb_content_ft ON knowledge_base
    USING gin (to_tsvector('simple', content));
之所以这么设计,是因为实际检索时几乎都是混合条件:按部门过滤、按密级过滤,再算语义相似度。如果向量和元数据分表或者分库,光 Join 和权限校验就能把人写疯。
动手搭起来
开向量扩展
CREATE EXTENSION IF NOT EXISTS vector;
SELECT '[1,2,3]'::vector(3);
注意一下,KingbaseES 的 vector 扩展不是默认启用的,得先确认安装包带了。我当时装的 V9 版本里直接有,低版本可能需要单独装插件。
文档入库
下面是简化后的 Python 入库脚本。实际生产里我会用 execute_batch 批量写,这里为了看得清楚,把逻辑拆开了:
import psycopg2
from embedding_model import BGE_M3_Encoder
from text_chunker import SemanticChunker

conn = psycopg2.connect(
    host="localhost", port=54321,
    database="rag_db", user="system", password="******"
)

encoder = BGE_M3_Encoder()
chunker = SemanticChunker(max_length=512, overlap=64)

def ingest_document(doc_id, title, content, source_type, department):
    chunks = chunker.split(content)
    records = []
    for idx, chunk in enumerate(chunks):
        embedding = encoder.encode(chunk)
        records.append((
            doc_id, idx, title, chunk,
            str(embedding.tolist()),
            source_type, department
        ))

    with conn.cursor() as cur:
        # 生产环境这里用 execute_batch,别学我单条插入
        execute_batch(cur, """
            INSERT INTO knowledge_base
                (doc_id, chunk_id, title, content, embedding,
                 source_type, department)
            VALUES (%s, %s, %s, %s, %s, %s, %s)
        """, records)
    conn.commit()
    print(f"{doc_id} 入库完成,{len(chunks)} 个 chunk")
分块策略我踩过坑:最早图省事按固定 512 字符切,结果很多 chunk 把一句话拦腰截断,检索时上下文稀碎。后来换成按段落和标题边界切,overlap 给 64~128 字符,召回质量明显好了一截。
三路召回的混合检索
只跑向量检索不够。我现在的做法是同时走三条路:向量召回、全文召回、元数据过滤,最后合并重排。
def hybrid_search(query, top_k=10, department=None, security_level=None):
    query_vec = str(encoder.encode(query).tolist())

    sql = """
        WITH vec_results AS (
            SELECT id, content, title, source_type,
                   1 - (embedding <=> %s::vector) AS vec_score
            FROM knowledge_base
            WHERE (%s IS NULL OR department = %s)
              AND (%s IS NULL OR security_level <= %s)
            ORDER BY embedding <=> %s::vector
            LIMIT %s
        ),
        fts_results AS (
            SELECT id, content, title, source_type,
                   ts_rank(to_tsvector('simple', content),
                           plainto_tsquery('simple', %s)) AS fts_score
            FROM knowledge_base
            WHERE to_tsvector('simple', content)
                  @@ plainto_tsquery('simple', %s)
              AND (%s IS NULL OR department = %s)
              AND (%s IS NULL OR security_level <= %s)
            ORDER BY fts_score DESC
            LIMIT %s
        )
        SELECT COALESCE(v.id, f.id) AS id,
               COALESCE(v.content, f.content) AS content,
               COALESCE(v.title, f.title) AS title,
               COALESCE(v.source_type, f.source_type) AS source_type,
               COALESCE(v.vec_score, 0) * 0.7
               + COALESCE(f.fts_score, 0) * 0.3 AS final_score
        FROM vec_results v
        FULL OUTER JOIN fts_results f ON v.id = f.id
        ORDER BY final_score DESC
        LIMIT %s
    """

    params = (
        query_vec, department, department,
        security_level, security_level, query_vec, top_k,
        query, query, department, department,
        security_level, security_level, top_k,
        top_k
    )

    with conn.cursor() as cur:
        cur.execute(sql, params)
        return cur.fetchall()
这里我重点解释两个地方:
embedding <=> %s::vector算的是余弦距离,1 - 距离就是相似度。- 元数据过滤条件直接写在 CTE 的
WHERE里,这样优化器能在向量扫描阶段就把不符合部门和密级要求的 chunk 先过滤掉。不要先跑 Top-K 再在应用层过滤,否则很可能返回空结果。
权重 0.7 / 0.3 是我这个项目里调出来的,不是通用最优值。不同数据集差异很大,建议自己拿一批问题做标注后调参。
接大模型生成答案
from llm_client import QwenClient

llm = QwenClient()

def rag_answer(question, department=None):
    results = hybrid_search(question, top_k=5, department=department)
    if not results:
        return "没找到相关资料,回答不了。"

    context = "\n\n".join(
        f"[{i}] 来源:{row[3]} | 标题:{row[2]}\n{row[1]}"
        for i, row in enumerate(results, 1)
    )

    prompt = f"""你是一个企业知识库助手。请根据参考资料回答。
要求:只基于资料内容回答,不要编造;如果资料里没有答案,直接说明。

参考资料:
{context}

用户问题:{question}

回答:"""

    return llm.chat(prompt)
Prompt 我写得比较保守,因为企业场景最怕模型胡说。你 Prompt 里不写明边界,它很容易把检索结果和训练记忆混着用。
实测效果:至少在我这个场景里差别很明显
我们压测用的库大概是 50 万份文档、200 万条 chunk。 KingbaseES 融合方案和之前独立向量库方案的对比大致如下:
| 指标 | 独立向量库方案 | KingbaseES 融合方案 |
|---|---|---|
| 检索 P99 | 52ms | 18ms |
| 数据同步延迟 | 200~500ms | 0ms(同库同事务) |
| 组件数 | 4 个 | 1 个 |
| 回答准确率 | 76% | 89% |
准确率提升主要来自两块:一是没了同步延迟导致的脏读幻觉,二是混合召回比纯向量召回找得更全。
P99 从 52ms 降到 18ms 当然好看,但我更看重的是少维护一套集群。对小团队来说,运维成本有时候比毫秒级延迟更真实。
性能调优:我实际调过的几个参数
HNSW 索引
-- 高召回场景
SET hnsw.ef_search = 200;

-- 高吞吐场景
SET hnsw.ef_search = 40;
m 和 ef_construction 在建索引时定死,我一般用 m=16、ef_construction=64,算是召回和内存的平衡点。ef_search 可以按场景动态改,查询时 SET 一下就行。
增量更新
KingbaseES 的向量索引支持增量写入,新文档插入后索引实时更新,不需要全量重建。这点对我们很关键,因为知识库是持续在增长的。
ingest_document(
    doc_id="DOC-2026-0803",
    title="新版部署手册",
    content=document_text,
    source_type="manual",
    department="IT"
)
# 下一秒就能检索到
results = hybrid_search("新版部署手册说了什么?")
预过滤 vs 后过滤
后过滤的写法很多人一开始都会写错:
-- 不推荐:先向量 Top-K,再应用层过滤
SELECT * FROM knowledge_base
ORDER BY embedding <=> query_vec
LIMIT 10;
如果前 10 个最相似的 chunk 都不符合当前用户的部门或密级,应用层一过滤就什么都没了。正确做法是把过滤条件直接下推到 SQL:
SELECT * FROM knowledge_base
WHERE department = '研发部'
  AND security_level <= 'internal'
ORDER BY embedding <=> query_vec
LIMIT 10;
KingbaseES 的优化器会根据过滤条件的选择率决定执行路径,亿级数据下这个差异可能是数量级的。
顺便聊聊 KingbaseES 的 AI 方向
搭完 RAG 知识库之后,我对 KingbaseES 另一个功能也挺感兴趣:内置的"的卢智能运维体"。简单说就是数据库里自带了一个运维 Agent,能理解自然语言,转成 SQL 或运维操作。
比如你可以问它:"帮我查一下昨天下午三点开始的慢查询,建议加什么索引。"它会自己跑:
SELECT sql_text, exec_time, rows_examined
FROM sys_statements_log
WHERE exec_time > 1000
  AND log_time BETWEEN '2026-08-02 15:00:00' AND '2026-08-02 15:10:00'
ORDER BY exec_time DESC;
然后输出索引建议。这对 DBA 不干活,但对开发自己查问题挺省事的。
KingbaseES 现在的 AI 战略大致两条线:一条是 AI for DB,让数据库自己更智能;另一条是 DB for AI,让数据库更好地服务 RAG 这类 AI 应用。原生向量引擎属于后者,的卢属于前者。
另外我注意到 MCP 协议最近很热。如果 KingbaseES 能通过 MCP 暴露表结构、执行计划这些元信息,那任何 AI Agent 都可以把它当作一个"可对话的数据源"直接接入。这个想象空间比单个 NL2SQL 工具要大得多。
结语
我现在做 RAG 方案选型,第一个问题已经从"用什么向量库"变成"能不能把向量和业务数据放在同一个事务里"。
KingbaseES V9 的原生向量能力让我可以用一个实例跑完整条链路:存储、检索、权限、审计全在一起。这不是说独立向量库没价值,而是对于不想维护两套集群的团队来说,少一套系统就少一堆坑。
如果你也在做企业知识库,建议直接拿你的真实文档和查询测一测。纸面参数再漂亮,也不如你自己的数据跑一轮来得准。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/Z_oioihoii/article/details/163450645

