

前几篇我们学会了发请求、提取数据。但你发现没有——数据抓到了,可都在 Python 变量里。程序一结束,就什么都没了。
这一篇解决两件事:
- 把抓下来的数据存进 CSV 文件(Excel 能直接打开)
- 用循环翻页,一次抓好几页的数据
CSV 是什么?
一句话:CSV 是用逗号分隔的纯文本文件,Excel 能直接打开,兼容性最好。
书名,作者,价格
Python入门,张三,39.9
数据分析,李四,49.9
每行一条数据,每列之间用逗号隔开。Python 自带的 csv 模块就能读写,不用装额外东西。
方法一:Python 内置 csv 模块写入
基本写法
import csv

with open('books.csv', 'w', encoding='utf-8-sig', newline='') as f:
    writer = csv.writer(f)

    # 写表头
    writer.writerow(['书名', '作者', '价格'])

    # 写数据行
    writer.writerow(['Python入门教程', '张三', 39.9])
    writer.writerow(['数据分析实战', '李四', 49.9])
两个必须注意的参数(新手踩坑重灾区)
1. encoding='utf-8-sig' —— 解决 Excel 中文乱码
用 utf-8 存,记事本打开没问题,但 Excel 打开中文全乱码。因为 Excel 默认用 GBK 编码打开 CSV。
utf-8-sig 会在文件开头加个 BOM 标记,Excel 看到就知道"这是 UTF-8",正常显示中文。
记住:存 CSV 给 Excel 用,编码一定写 utf-8-sig。
2. newline='' —— 解决空行问题
不加的话,在 Windows 上用 Excel 打开会发现每两行之间多一个空行。加上 newline='' 就好。
方法二:pandas 存 CSV(更简单)
如果你装了 pandas(后面数据分析肯定要用),还能更简单:
import pandas as pd

# 数据装成字典列表
data = [
    {'书名': 'Python入门教程', '作者': '张三', '价格': 39.9},
    {'书名': '数据分析实战', '作者': '李四', '价格': 49.9},
]

# 转成 DataFrame,存 CSV
df = pd.DataFrame(data)
df.to_csv('books_pandas.csv', encoding='utf-8-sig', index=False)
三行搞定。index=False 是不让 pandas 把索引列(0、1、2…)也存进去。
两种方法怎么选?
| 情况 | 推荐 |
|---|---|
| 数据量小、想少依赖 | csv 模块 |
| 数据量大、后面还要分析 | pandas |
| 数据已经是字典列表 | pandas |
| 边抓边写 | csv 模块 |
翻页抓取:从 1 页到 N 页
真实场景里,数据很少只在一页上。排行榜 10 页、搜索结果 50 页,总不能手动改 URL。
怎么找分页规律?
打开有分页的网页,点"第2页",看地址栏:
第1页:https://example.com/ranking?page=1
第2页:https://example.com/ranking?page=2
第3页:https://example.com/ranking?page=3
规律很明显——page= 后面的数字就是页码。有的网站用 p=、pageNum=,思路都一样:找到 URL 里变化的数字,用循环变量替换它。
基本写法
import requests
from bs4 import BeautifulSoup

for page in range(1, 4):  # 抓第1到第3页
    url = f'https://example.com/ranking?page={page}'
    print(f'正在抓取第 {page} 页')

    response = requests.get(url)
    soup = BeautifulSoup(response.text, 'lxml')
    # ... 提取数据的代码 ...
就一个 for 循环,把页码当变量拼进 URL。搞定。
完整实战:抓 3 页排行榜存进 CSV
把所有知识串起来,来一个完整的:
import csv
import time
import requests
from bs4 import BeautifulSoup

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36'
}

all_data = []

for page in range(1, 4):  # 抓 3 页
    url = f'https://example.com/ranking?page={page}'
    print(f'正在抓取第 {page} 页...')

    response = requests.get(url, headers=headers)

    if response.status_code != 200:
        print(f'第 {page} 页请求失败,状态码:{response.status_code}')
        continue

    soup = BeautifulSoup(response.text, 'lxml')

    # 提取数据(根据实际网页结构调整选择器)
    items = soup.select('.ranking-item')
    for item in items:
        rank = item.select_one('.rank').get_text(strip=True)
        title = item.select_one('.title').get_text(strip=True)
        score = item.select_one('.score').get_text(strip=True)
        all_data.append({'排名': rank, '标题': title, '分数': score})

    print(f'第 {page} 页抓了 {len(items)} 条')

    time.sleep(1)  # 每抓一页歇1秒,别太快

# 全部抓完,存进 CSV
with open('ranking.csv', 'w', encoding='utf-8-sig', newline='') as f:
    writer = csv.DictWriter(f, fieldnames=['排名', '标题', '分数'])
    writer.writeheader()          # 写表头
    writer.writerows(all_data)    # 批量写所有数据

print(f'全部搞定!共存了 {len(all_data)} 条数据到 ranking.csv')
三个关键点
1. csv.DictWriter:数据是字典列表时用它,按字段名写入,不用操心列顺序。
2. time.sleep(1):每抓一页歇 1 秒。请求太快对方服务器压力大,可能封你 IP。既礼貌,也自保。
3. status_code != 200 判断:某一页失败了就跳过,不至于整个程序崩掉。数据采集,容错很重要。
真实运行效果
上面这套流程,用配套资源包在真实站点 books.toscrape.com 上跑一遍,抓前 3 页:
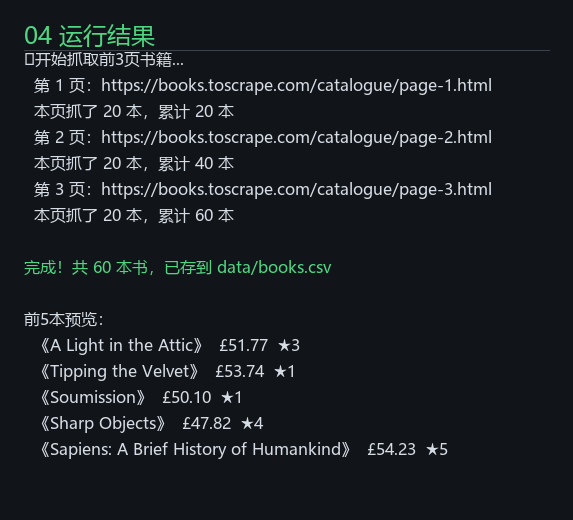
每页 20 本,3 页共 60 本书,全部抓完存进 data/books.csv,前 5 本预览正常。翻页、容错、休眠、写入 CSV 全链路跑通。
新手常见坑
| 坑 | 症状 | 解决 |
|---|---|---|
| Excel 中文乱码 | 记事本正常,Excel 乱码 | encoding='utf-8-sig' |
| 每行之间空行 | Excel 打开多空行 | open 加 newline='' |
| 字段里有逗号 | 担心列错位 | 用 csv 模块,自动加引号处理 |
数据里有逗号完全不用怕——csv 模块会自动给含逗号的字段加双引号,读取时再自动去掉。所以别自己手动拼字符串,用 csv 模块就对了。
今天的重点回顾
- CSV 是逗号分隔的纯文本文件,Excel 直接打开
- csv 模块是 Python 自带的,
writer.writerow()一行一行写 - 编码一定写
utf-8-sig,不然 Excel 中文乱码 - open 加
newline='',防止空行 - pandas 存 CSV 更简单:字典列表 → DataFrame →
to_csv - 翻页用 for 循环,找到 URL 里的页码变量,循环替换
- 加
time.sleep()休眠,别请求太快被封
到这一步,你已经能独立完成一个完整的小型数据采集项目:发请求 → 解析提取 → 翻页 → 存 CSV。
完整可跑工程版(真实站点 books.toscrape.com 抓前3页60本书存CSV)在配套资源包里。
下一篇讲工程化完善——超时、重试、异常捕获,把爬虫从"能跑"变成"耐造"。
梅雅达编程工作室 · Python数据实战系列第4篇
能抓能存,你已经能独立跑通一个小型采集项目了。别小看这一步,很多人学很久都做不到。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2601_96428997/article/details/164853157

