

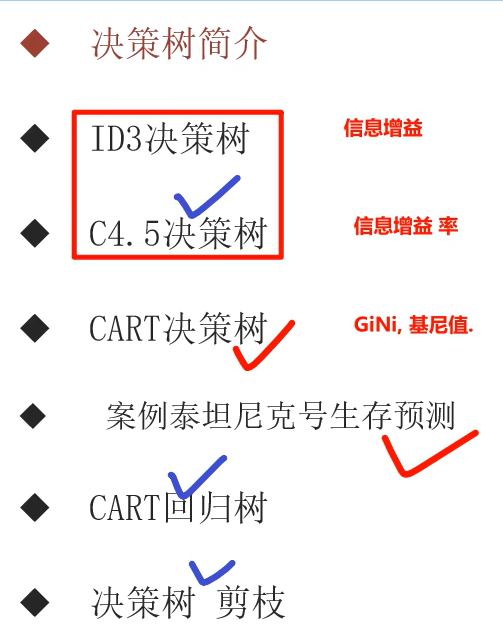
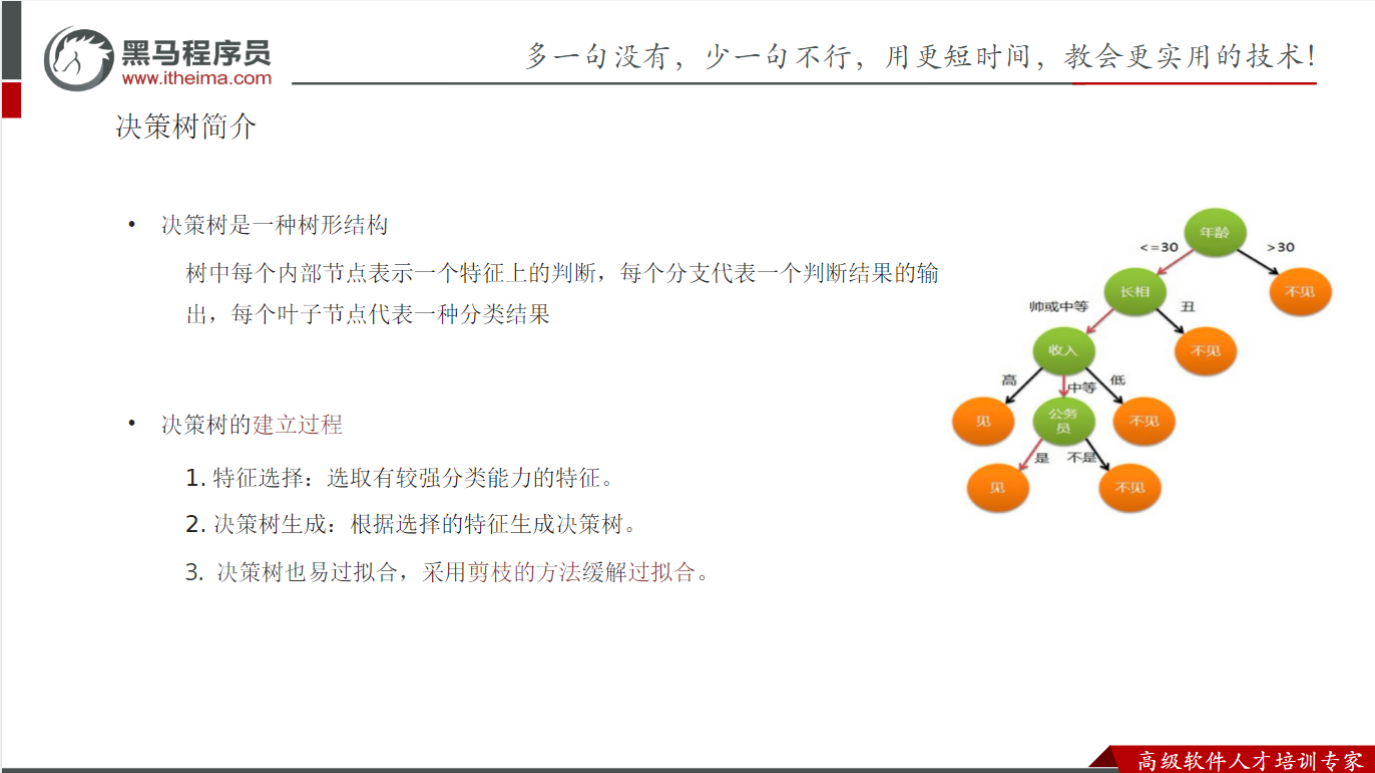
决策树简介
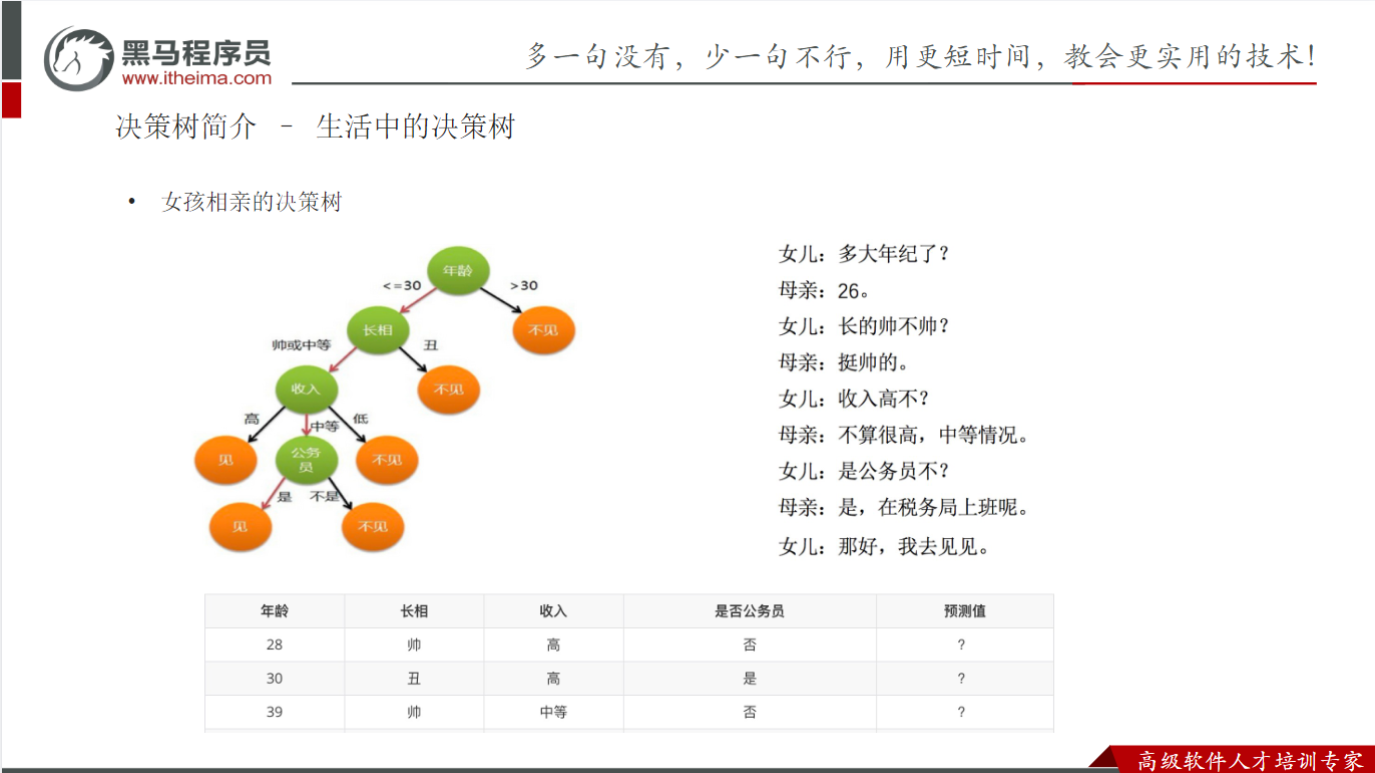
通俗来讲:
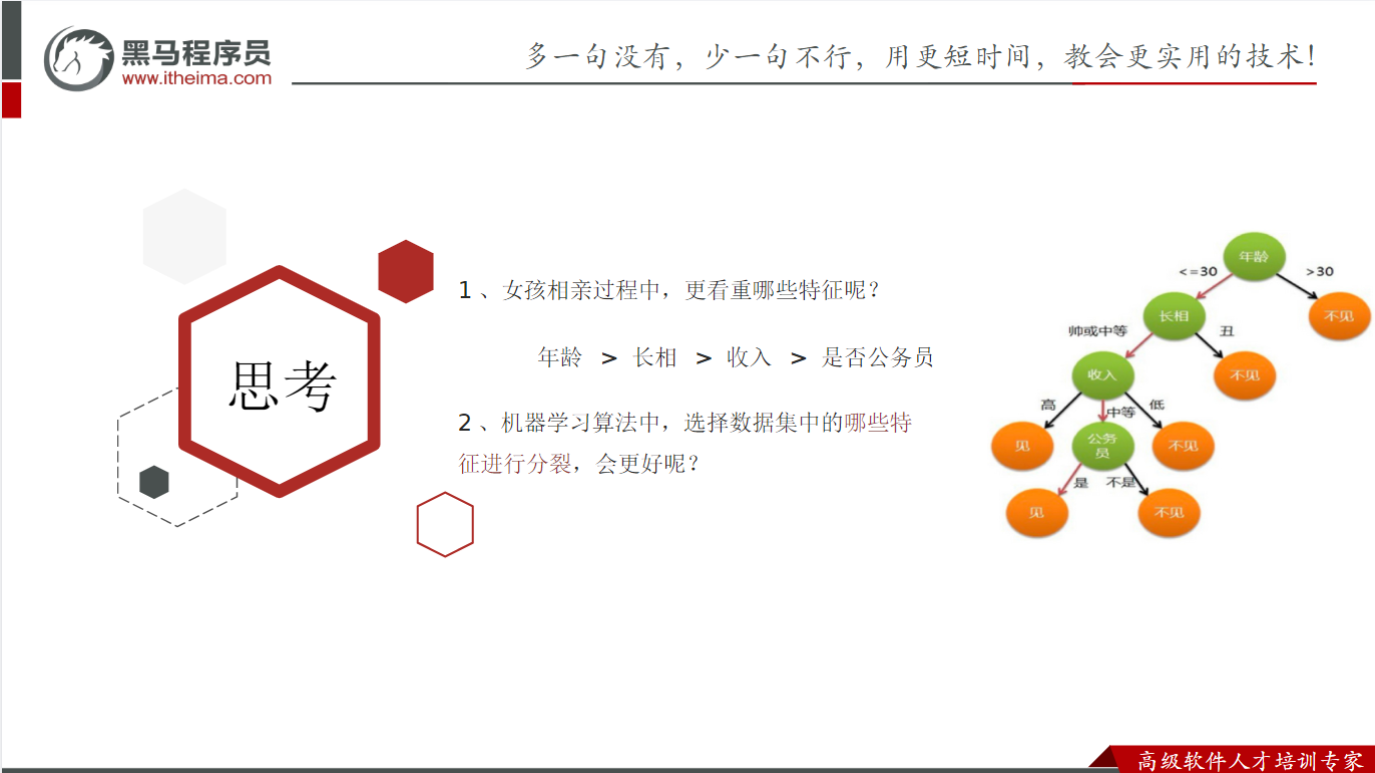
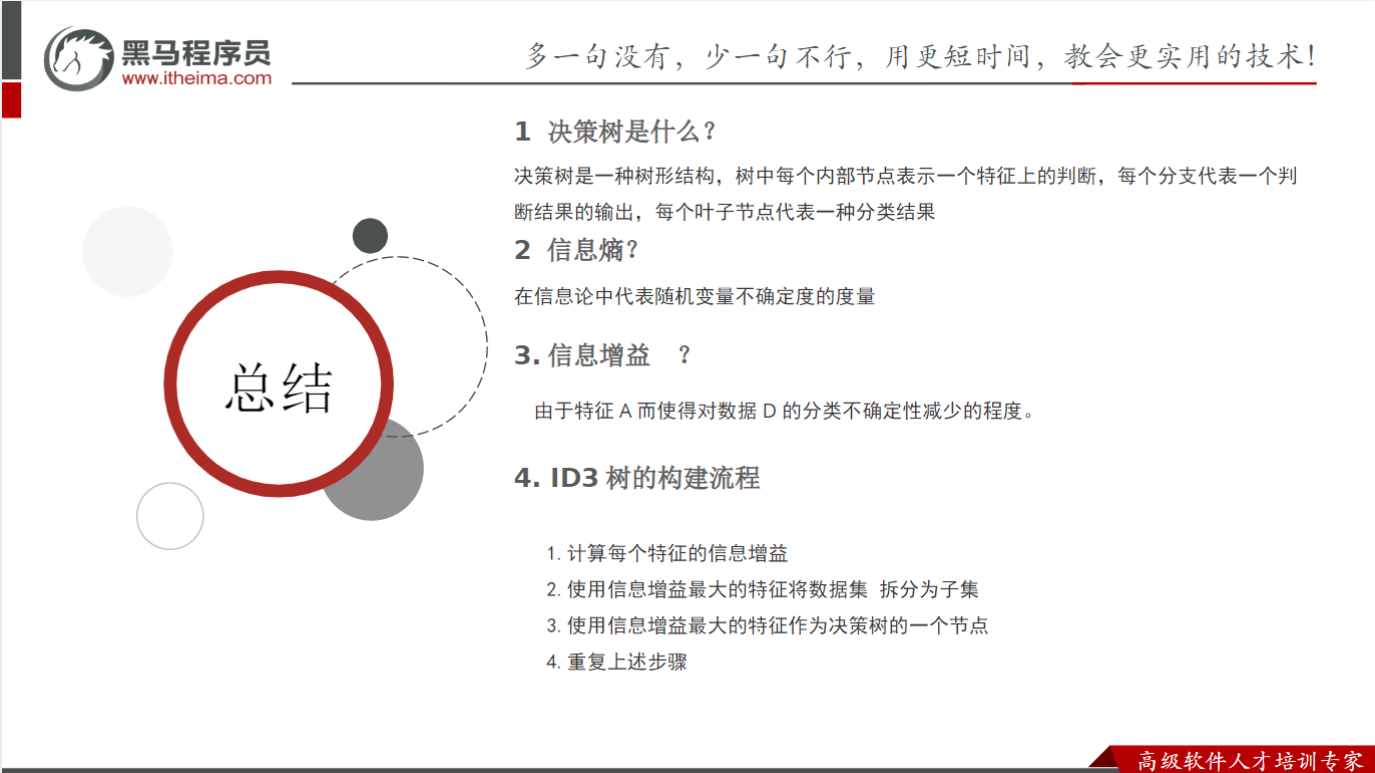
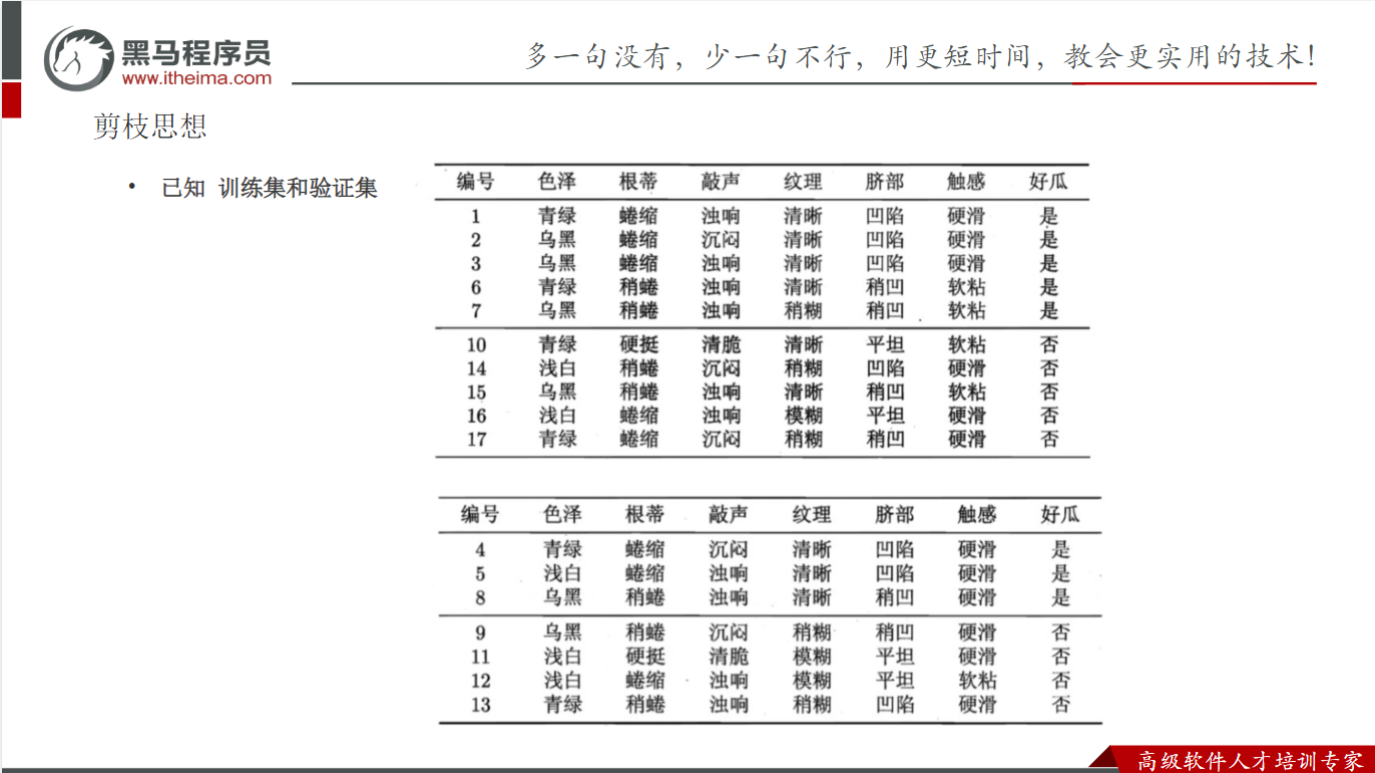
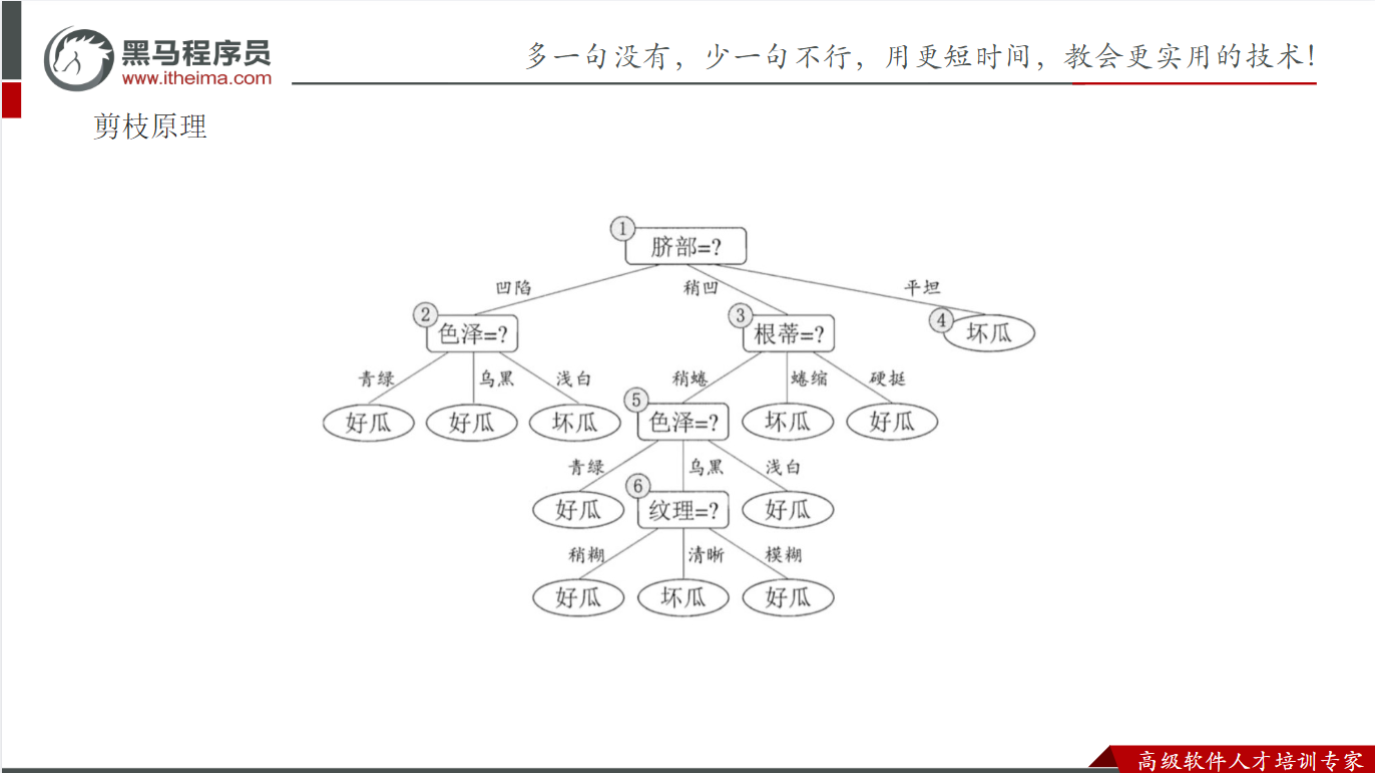
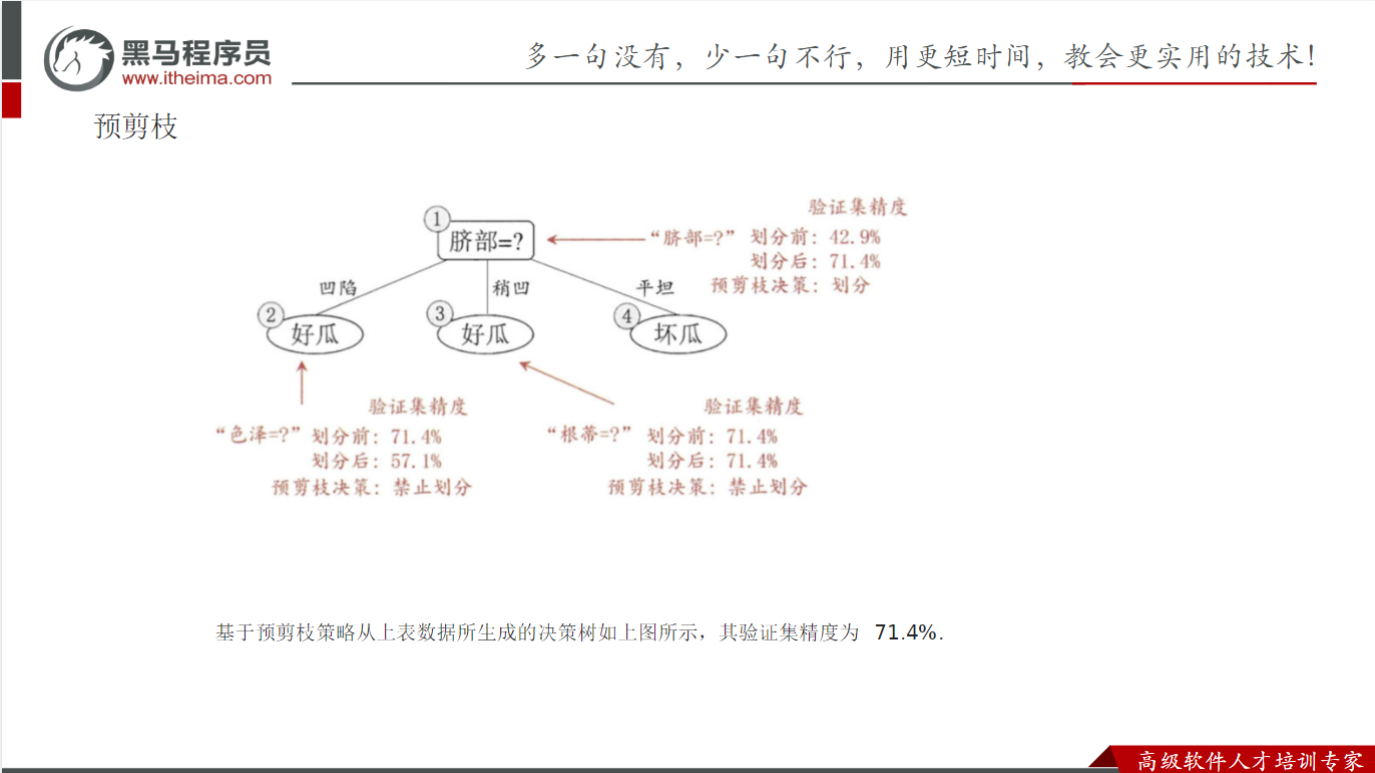
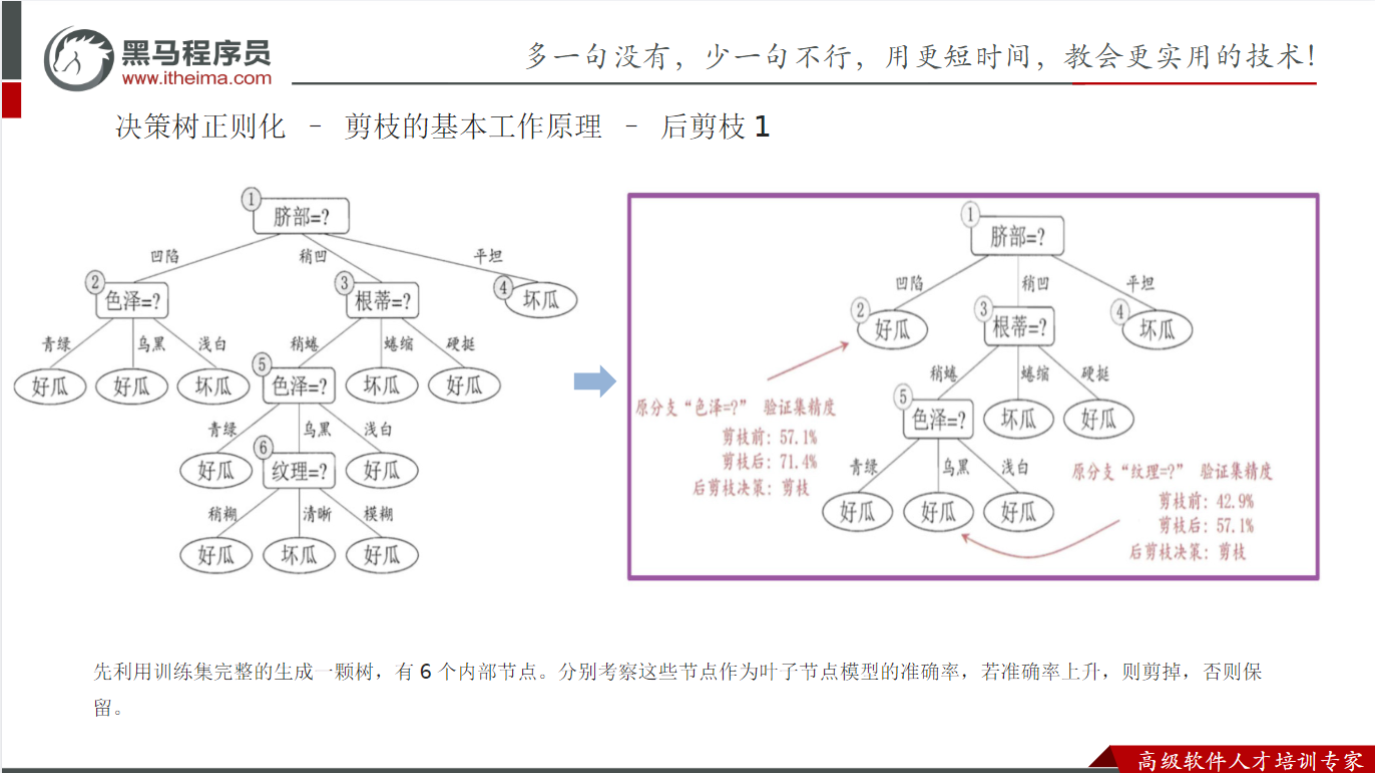
决策树就是根据你的某些特征或者信息作为根节点,来往下划分子集的过程;其中哪列当根节点哪列当二层节点,需要掌握方法;最后树如果过于复杂就会发生过拟合,所以要学会剪枝
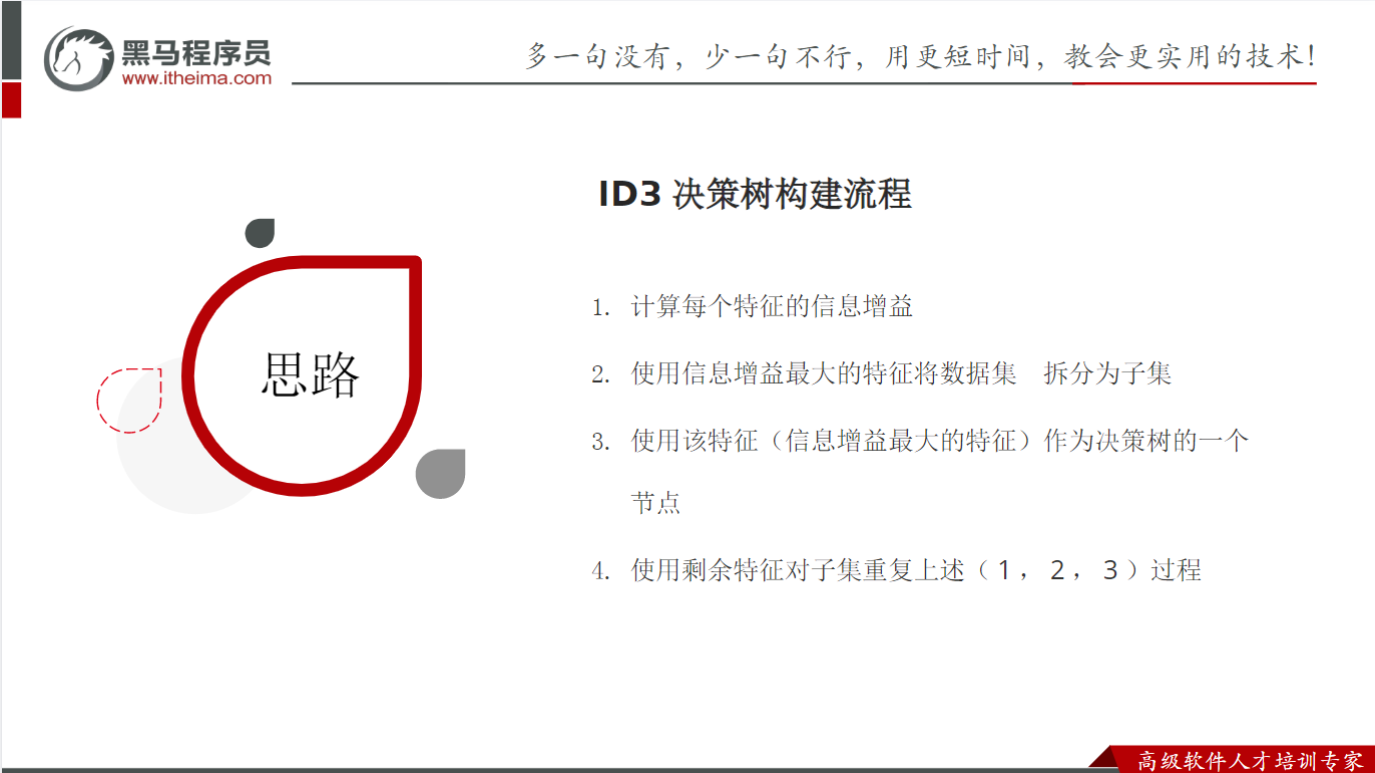
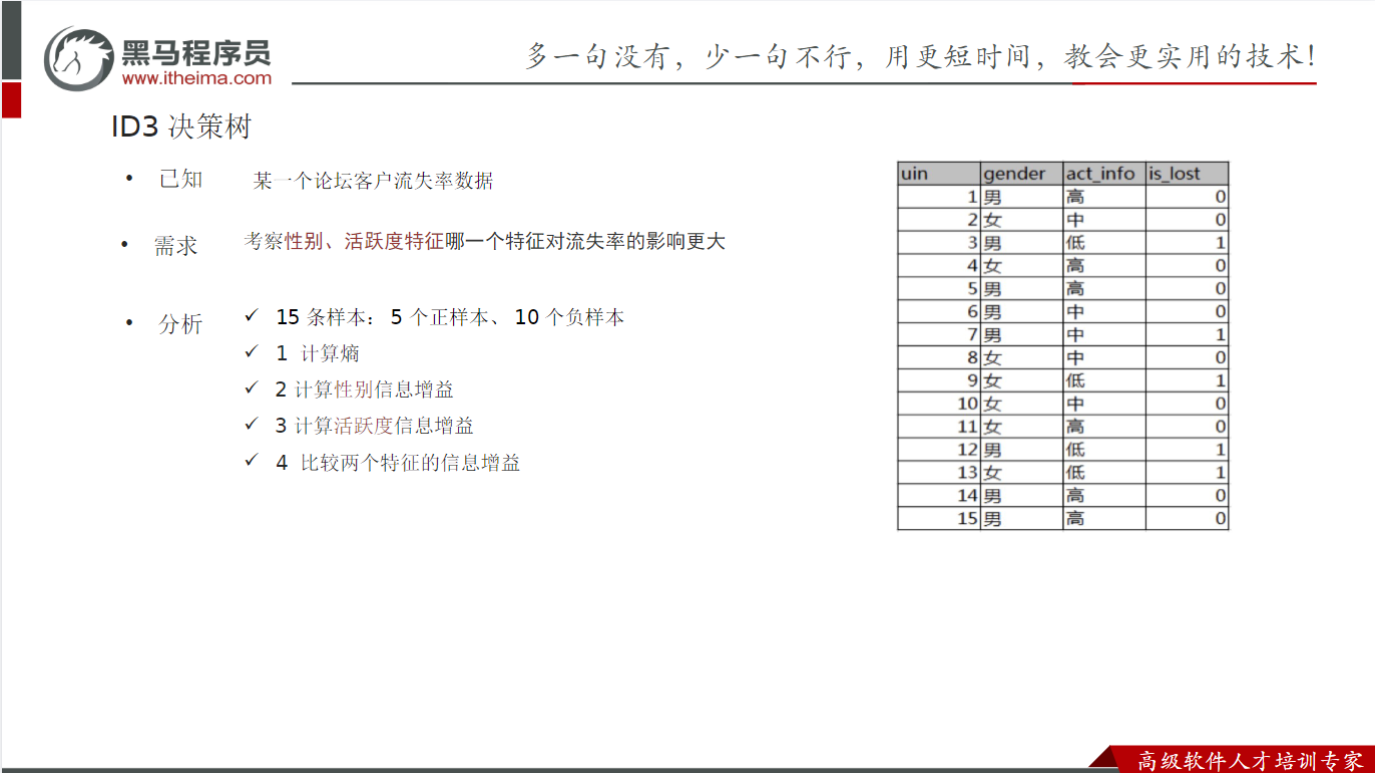
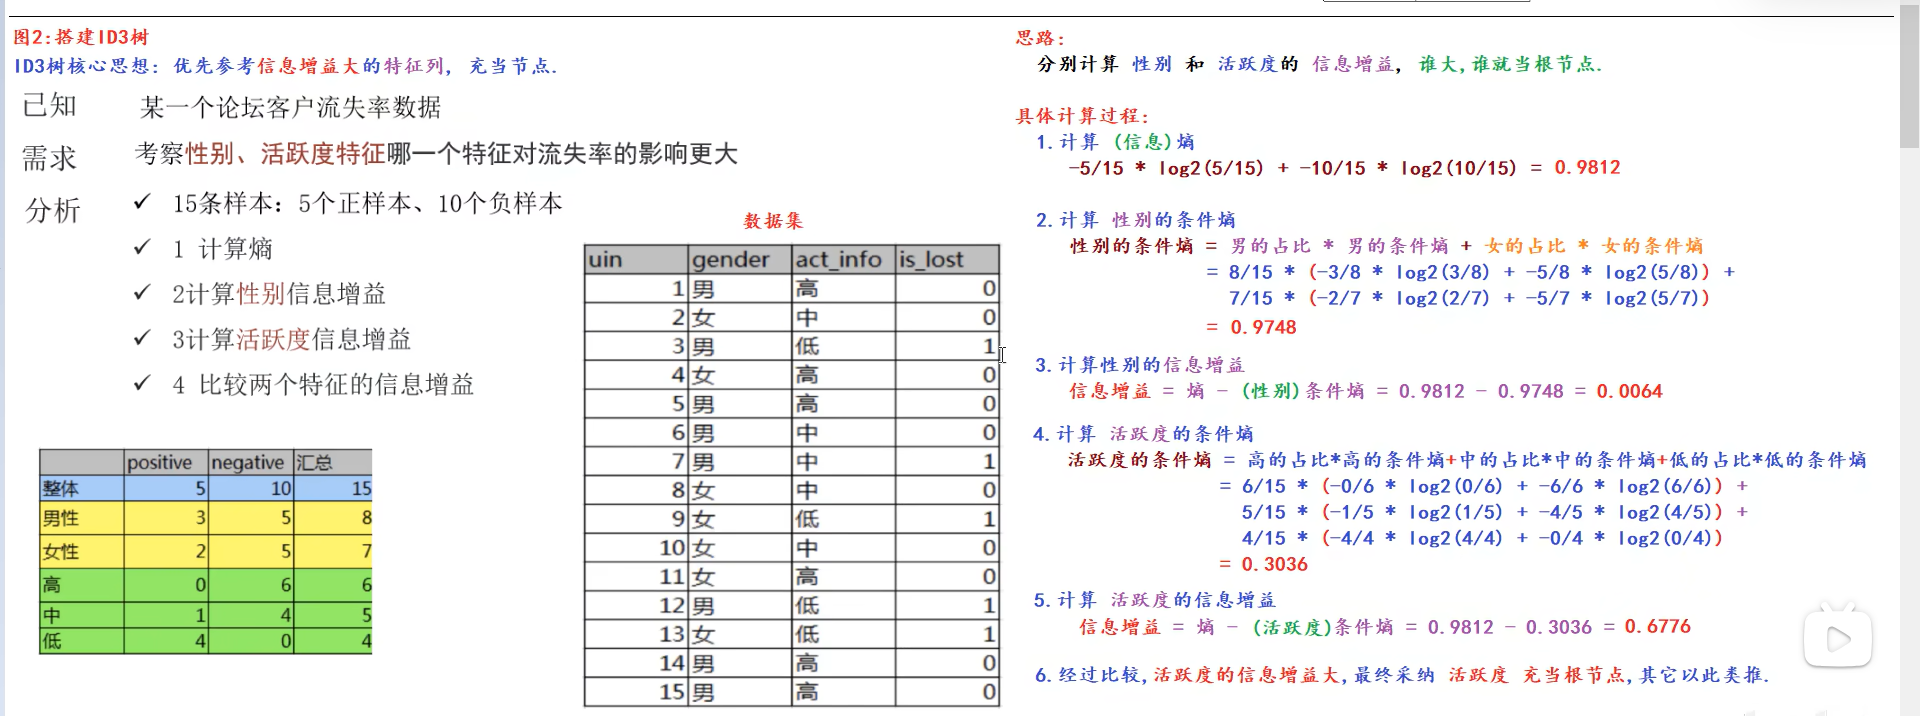
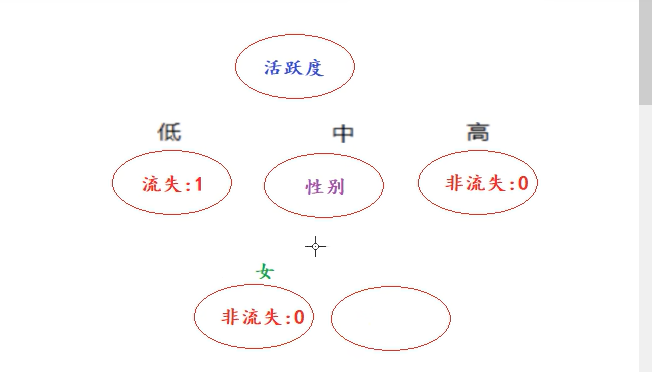
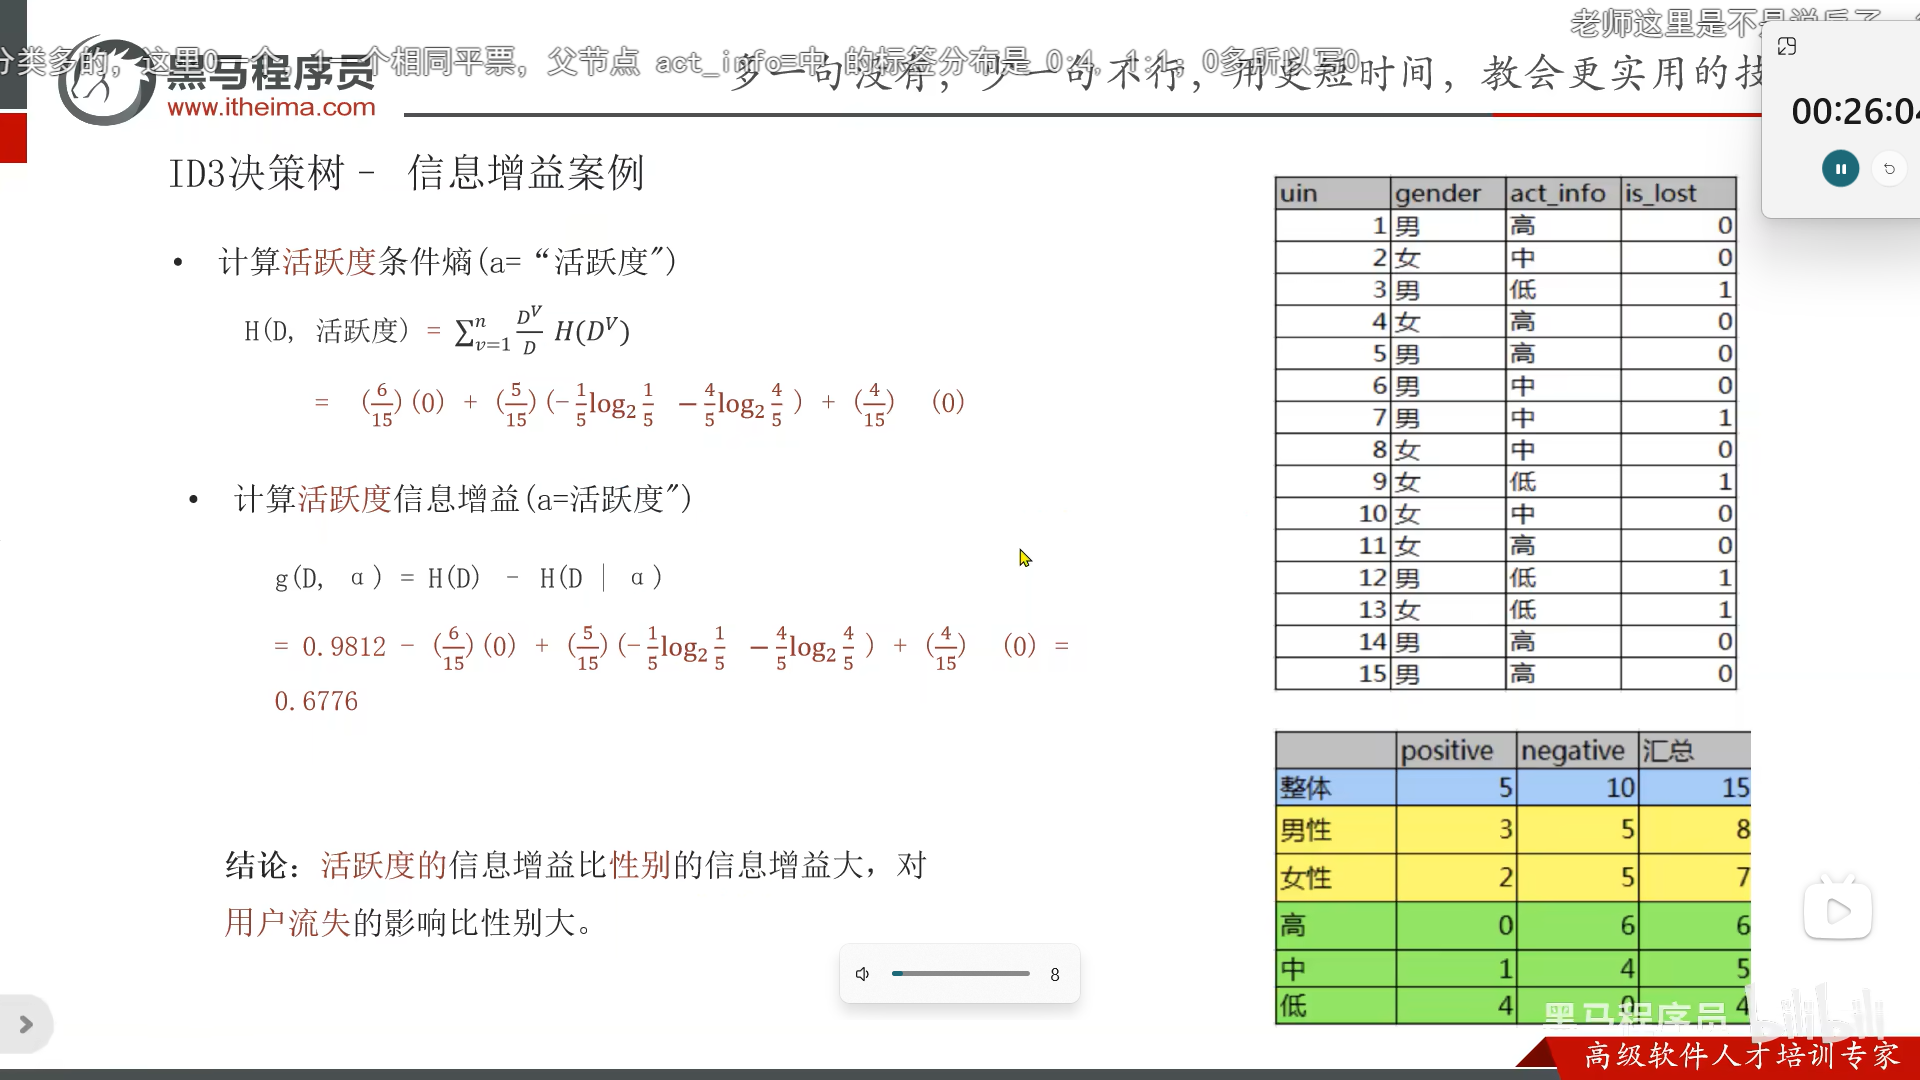
ID3决策树
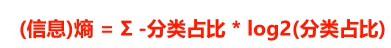
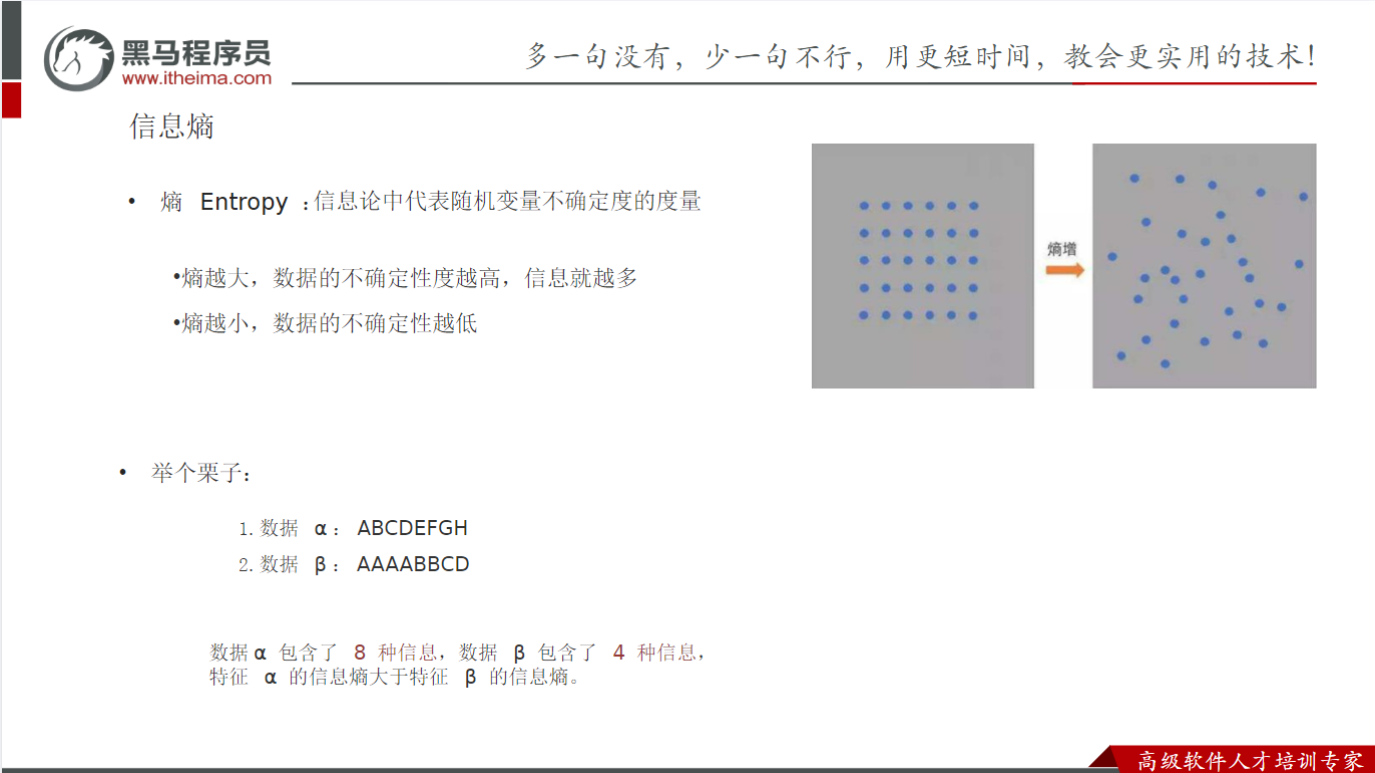
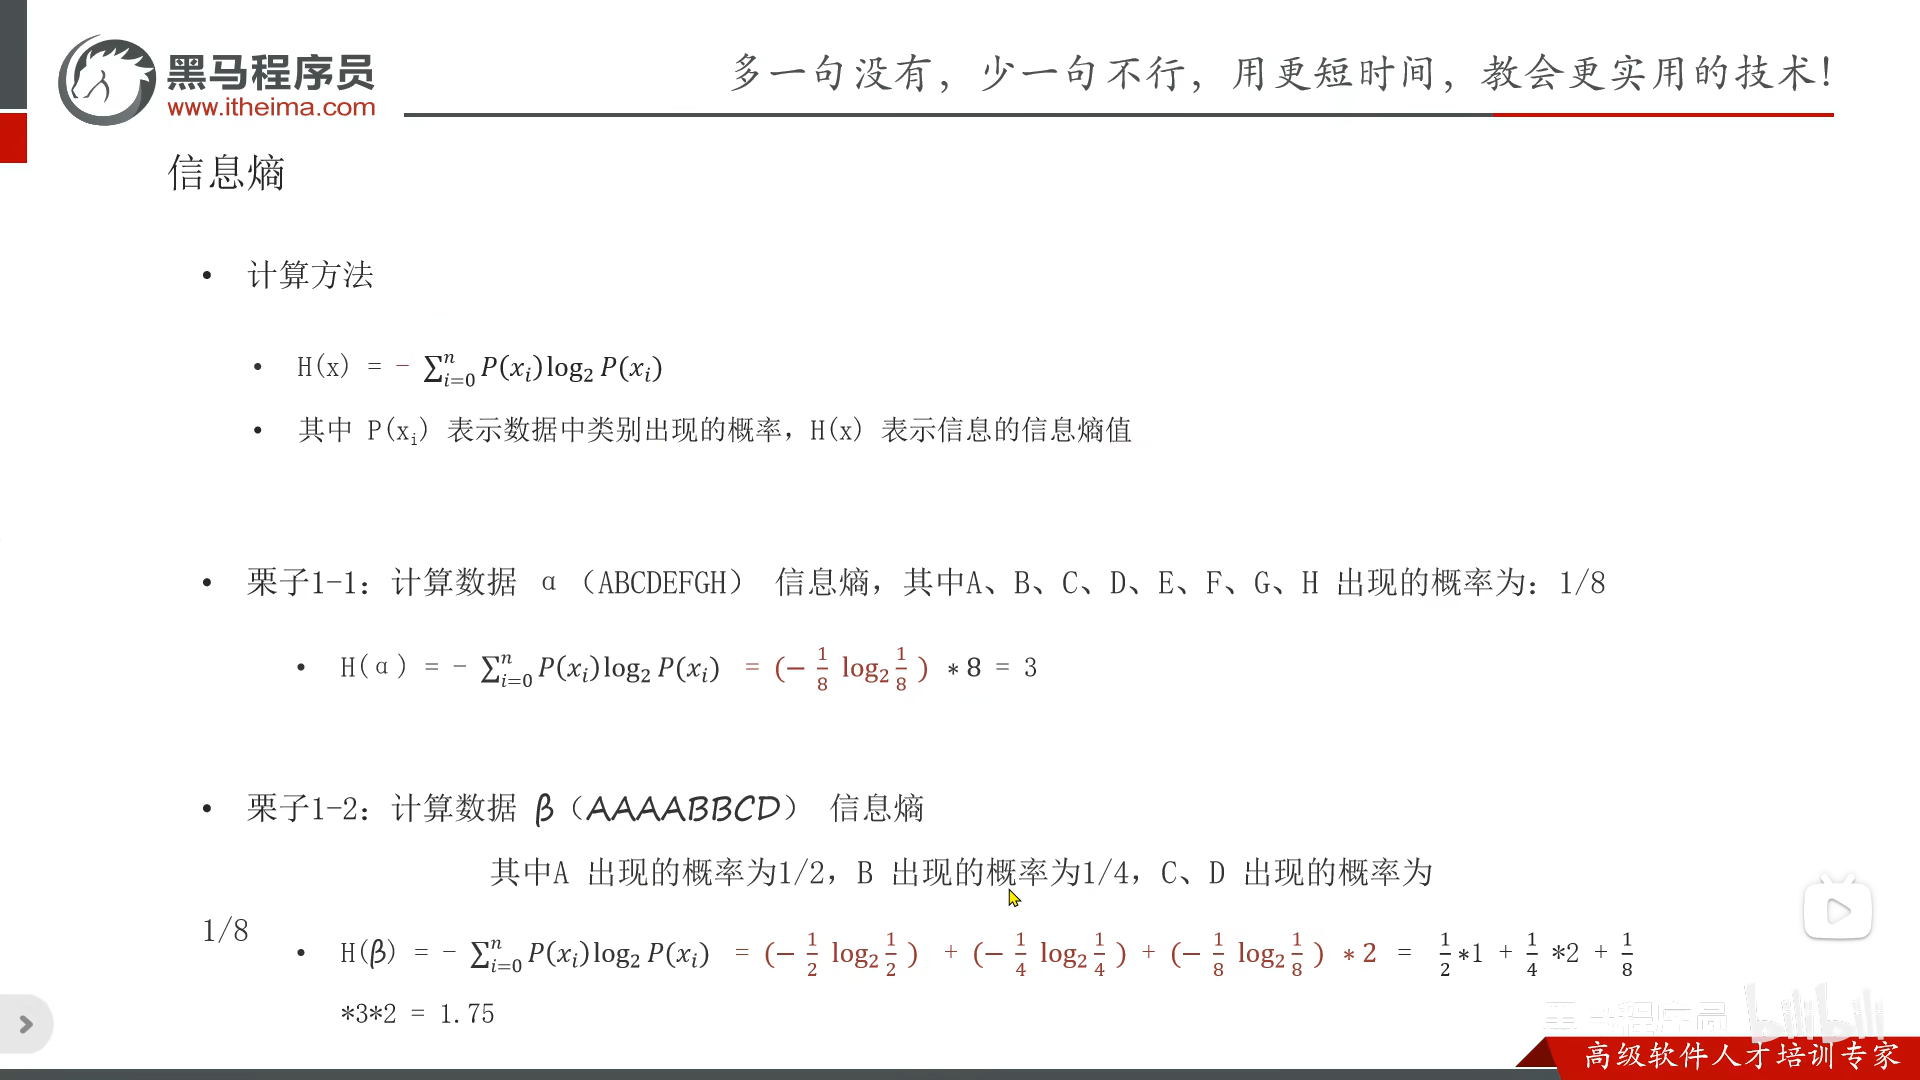
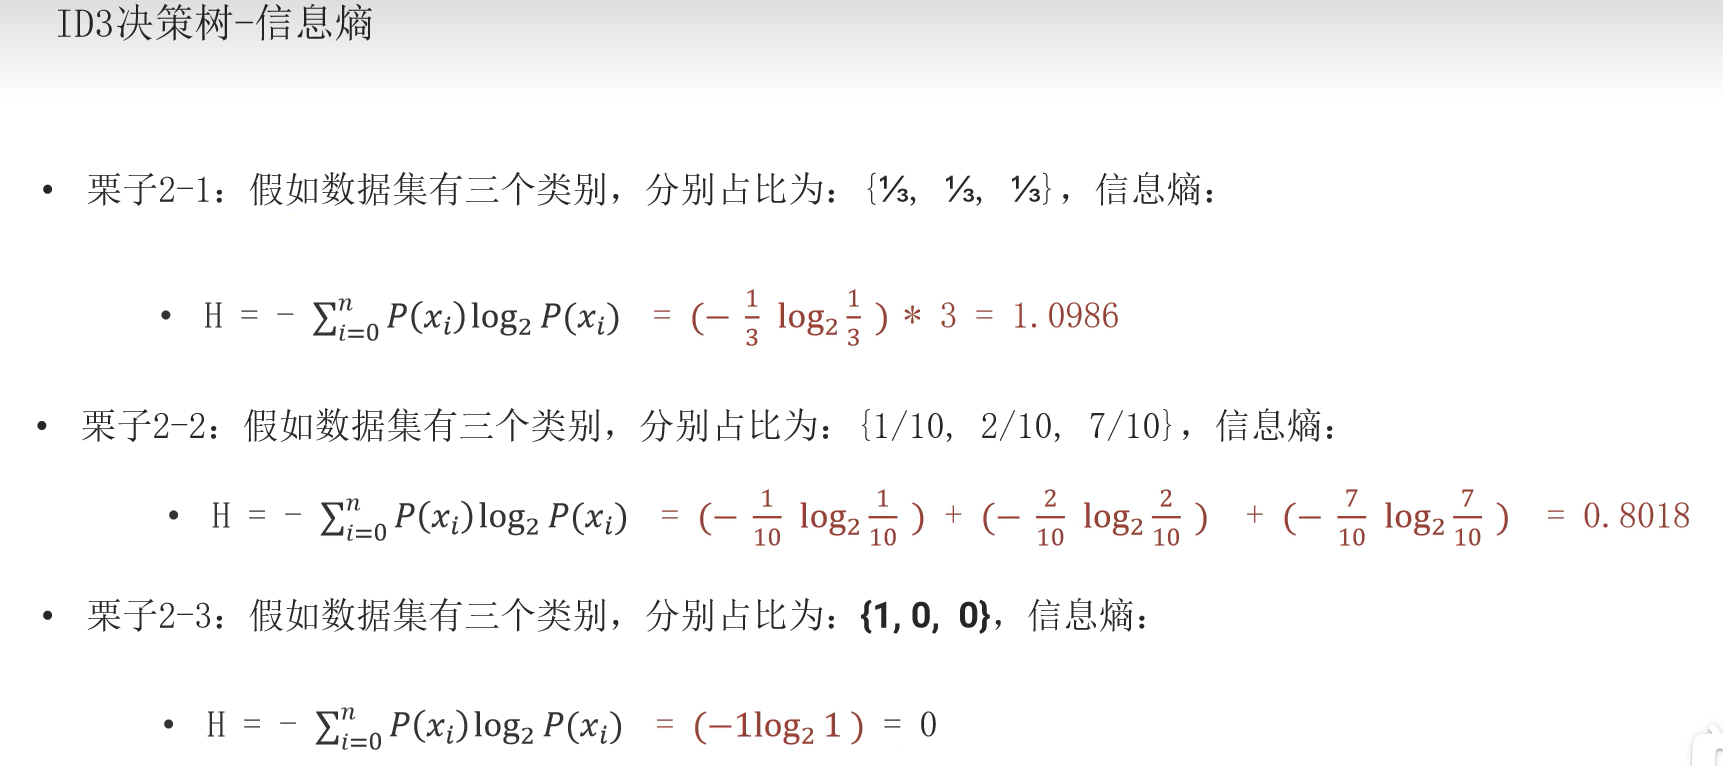
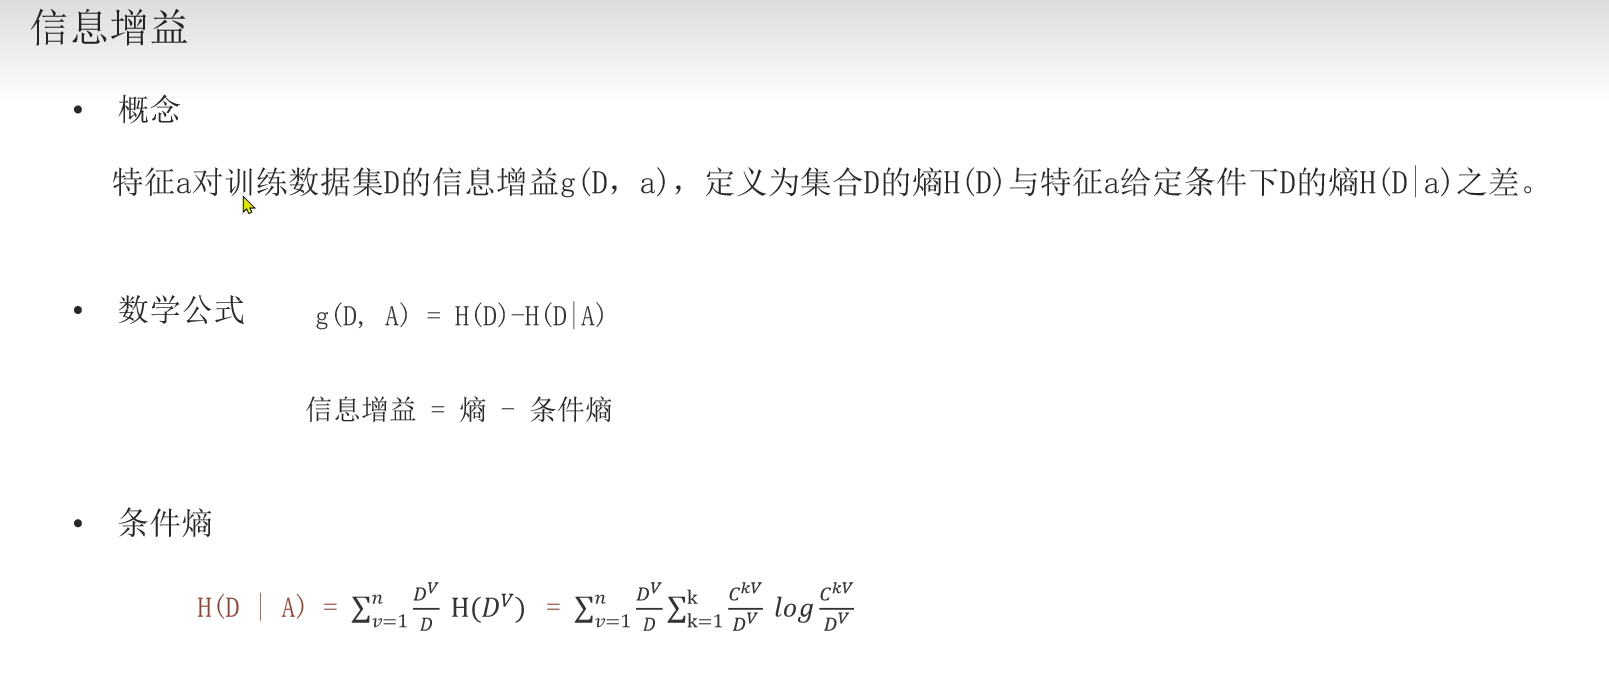
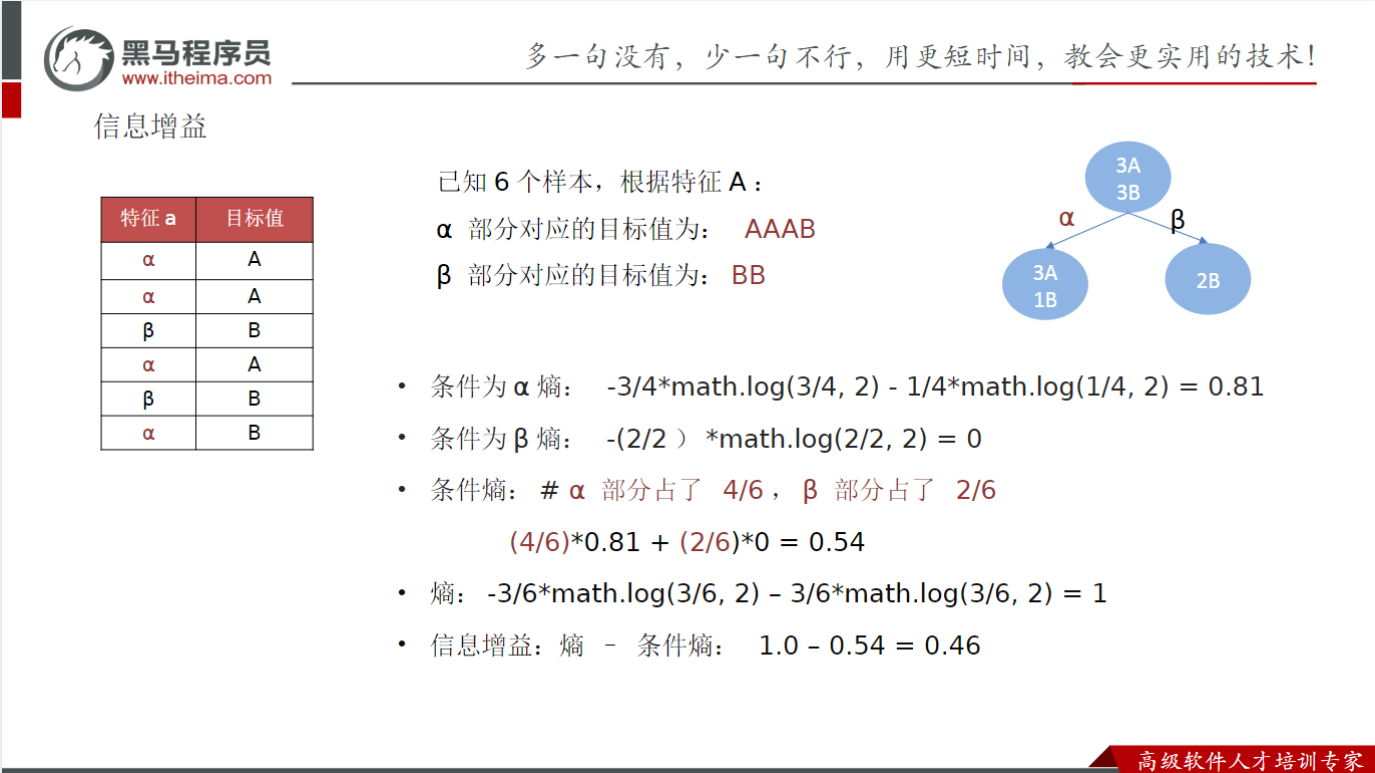
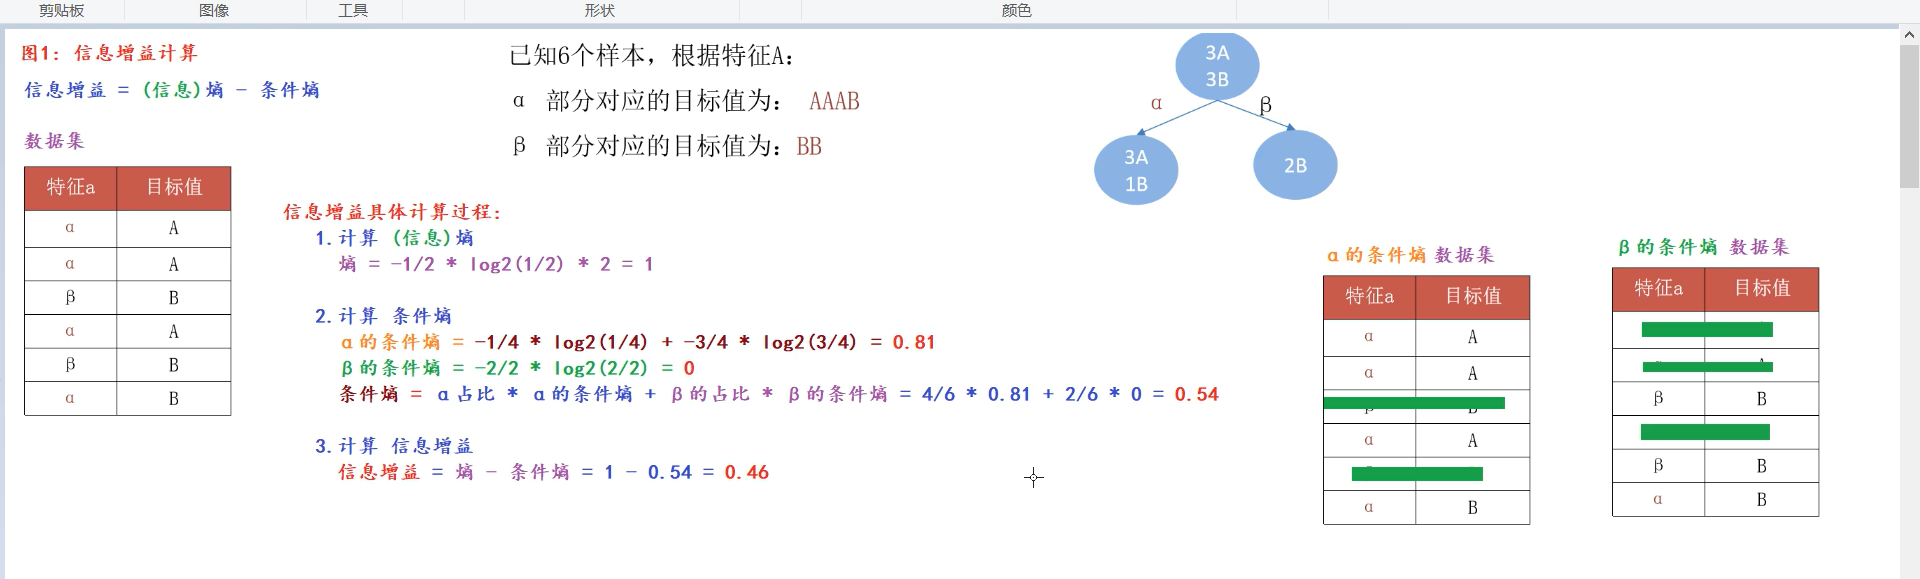
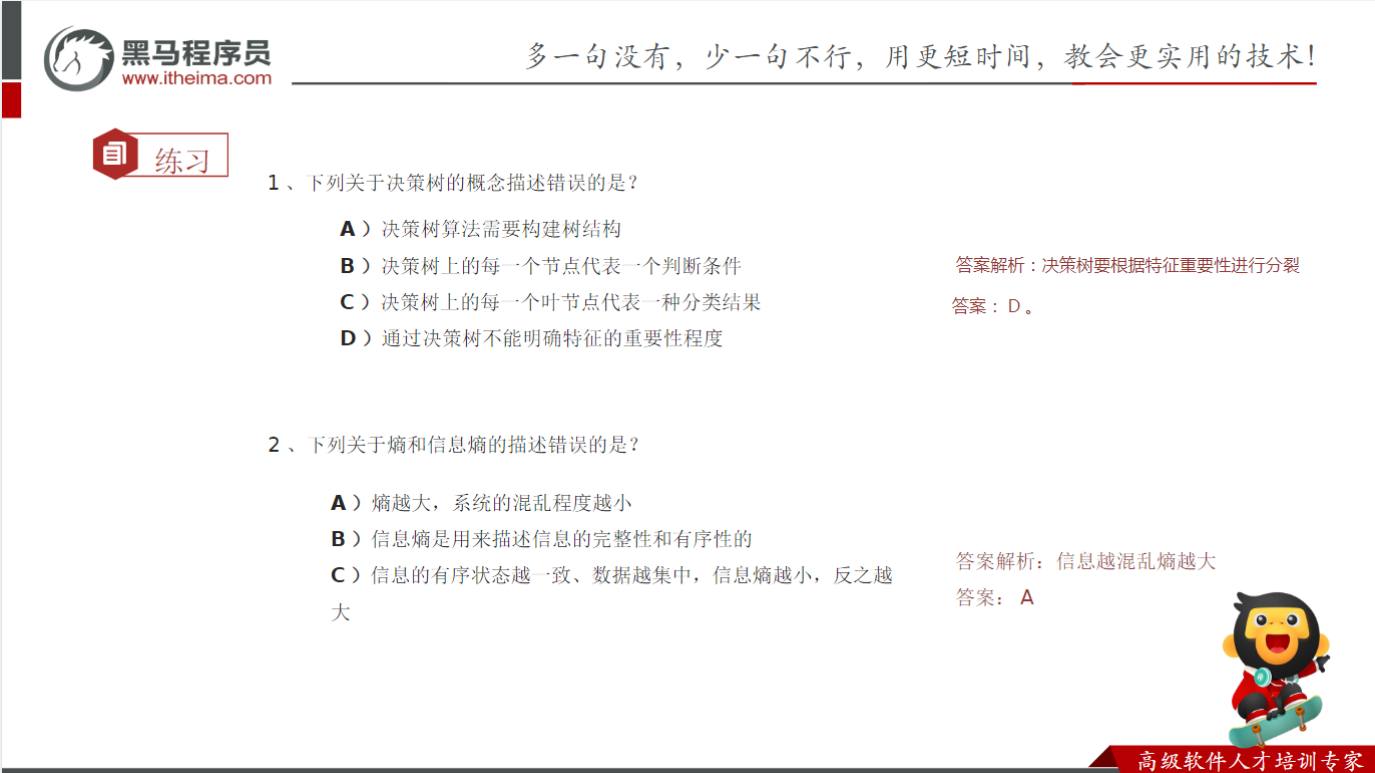
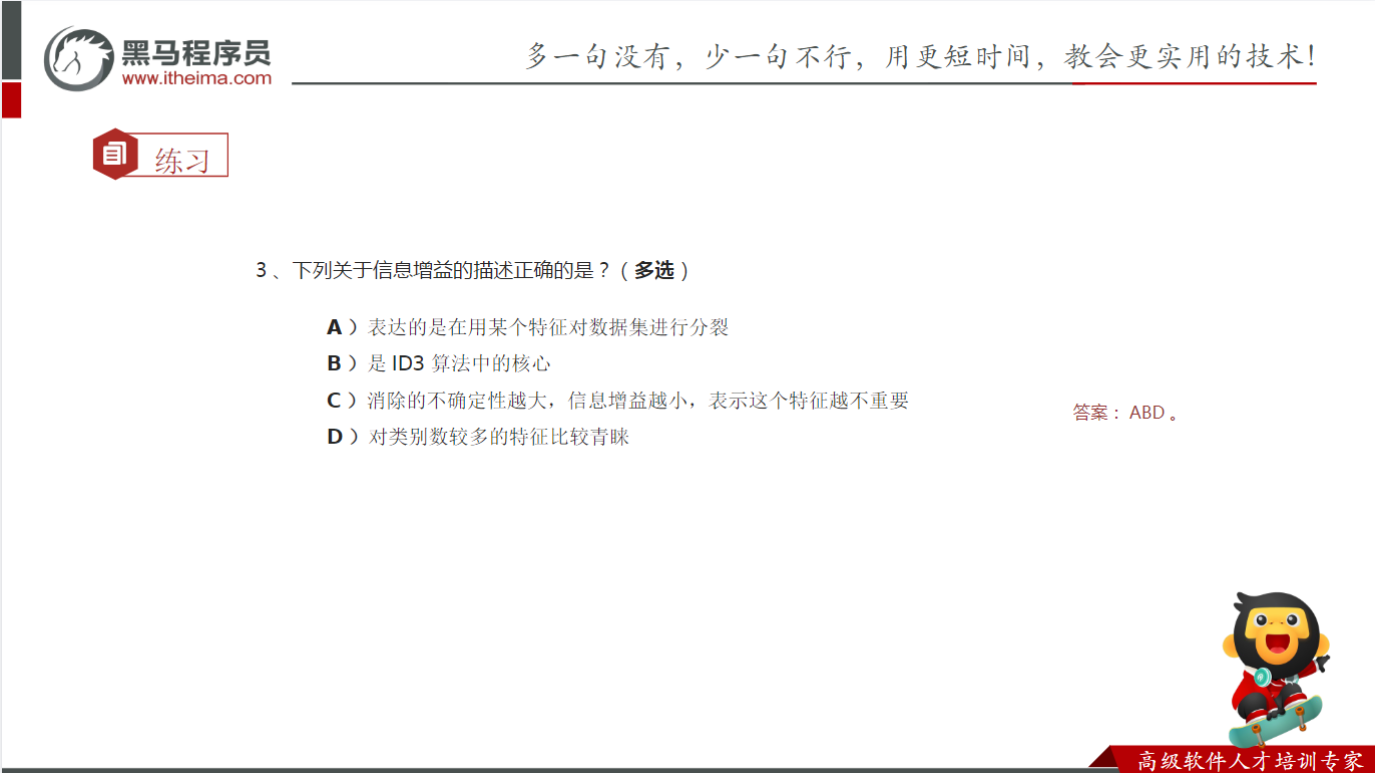
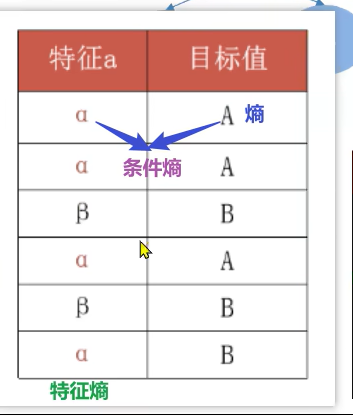
熵其实就是混乱程度
C4.5决策树
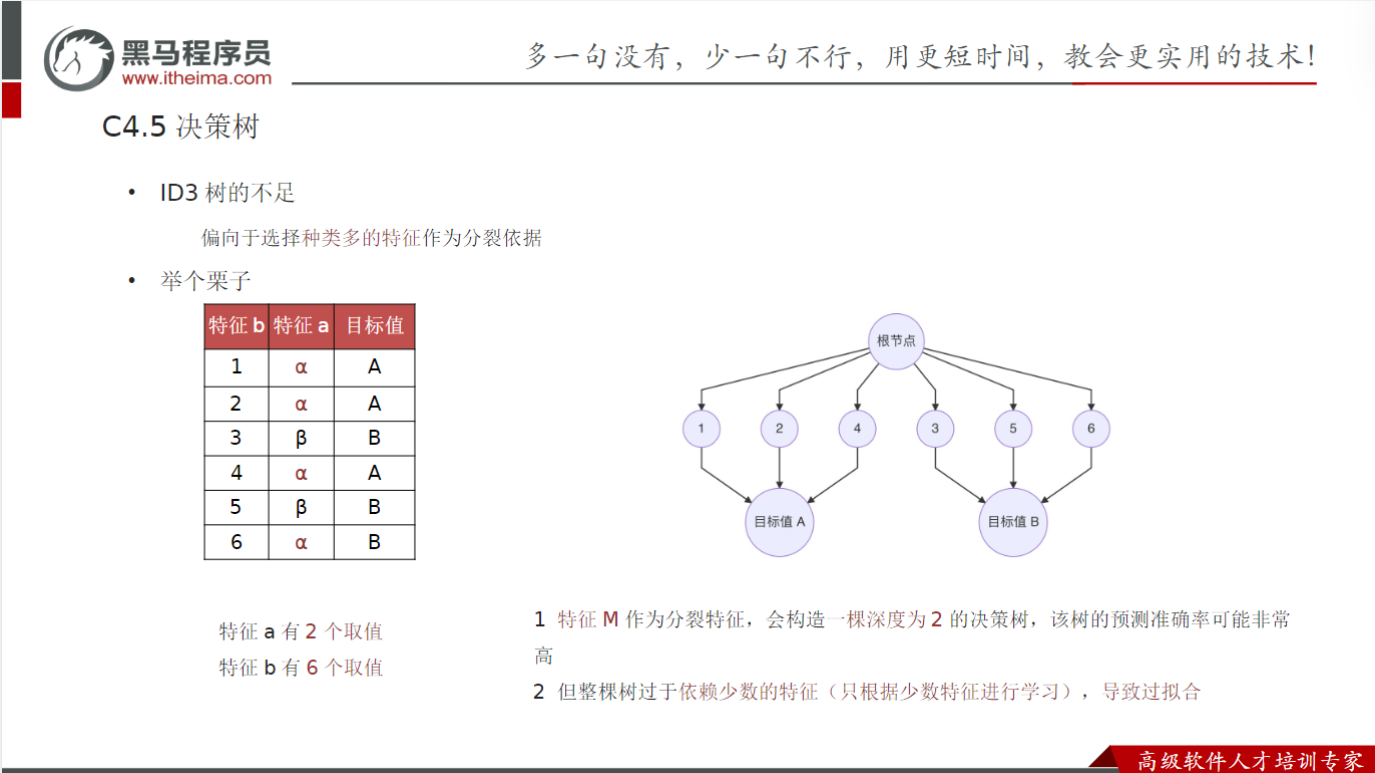
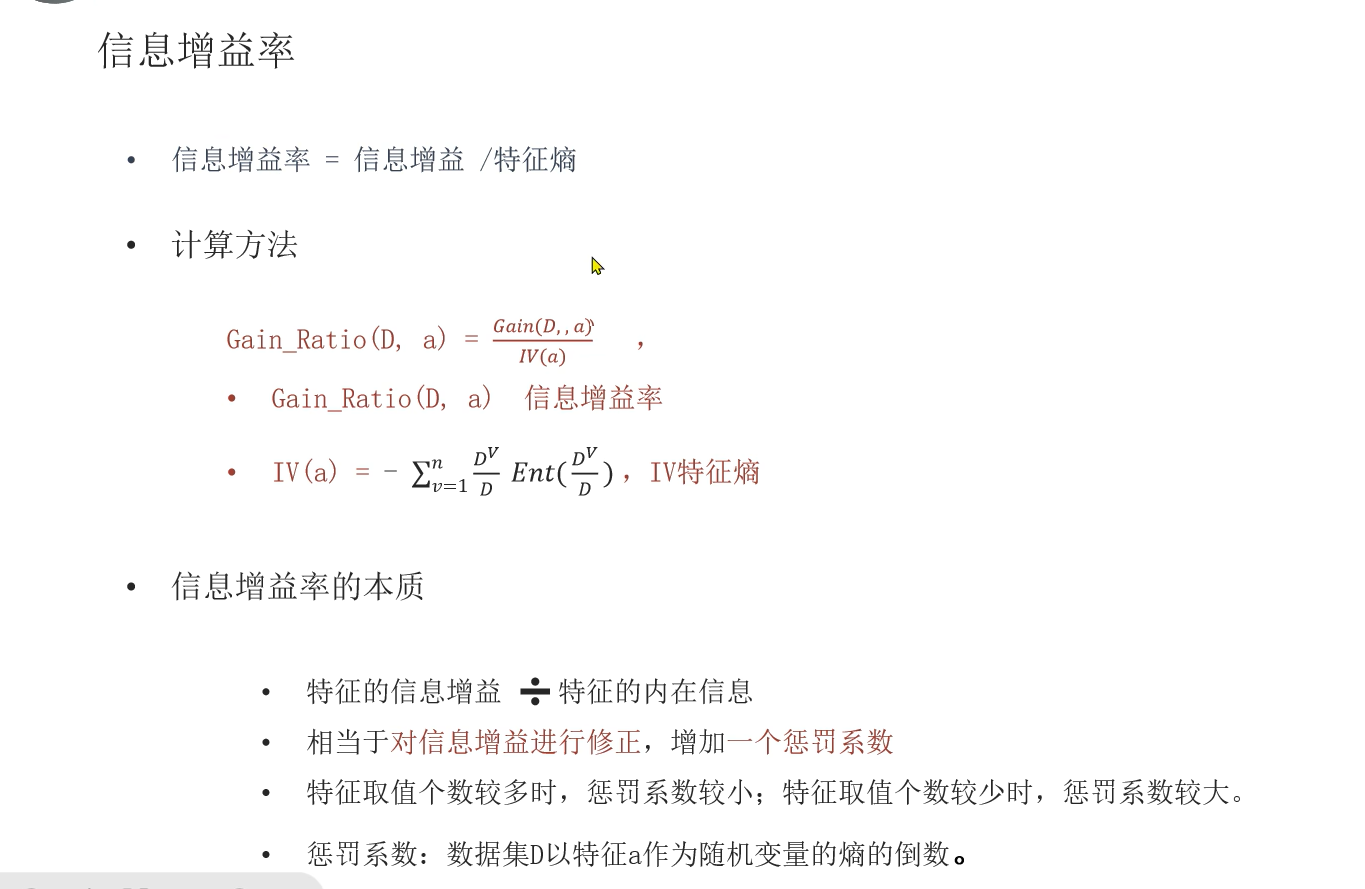
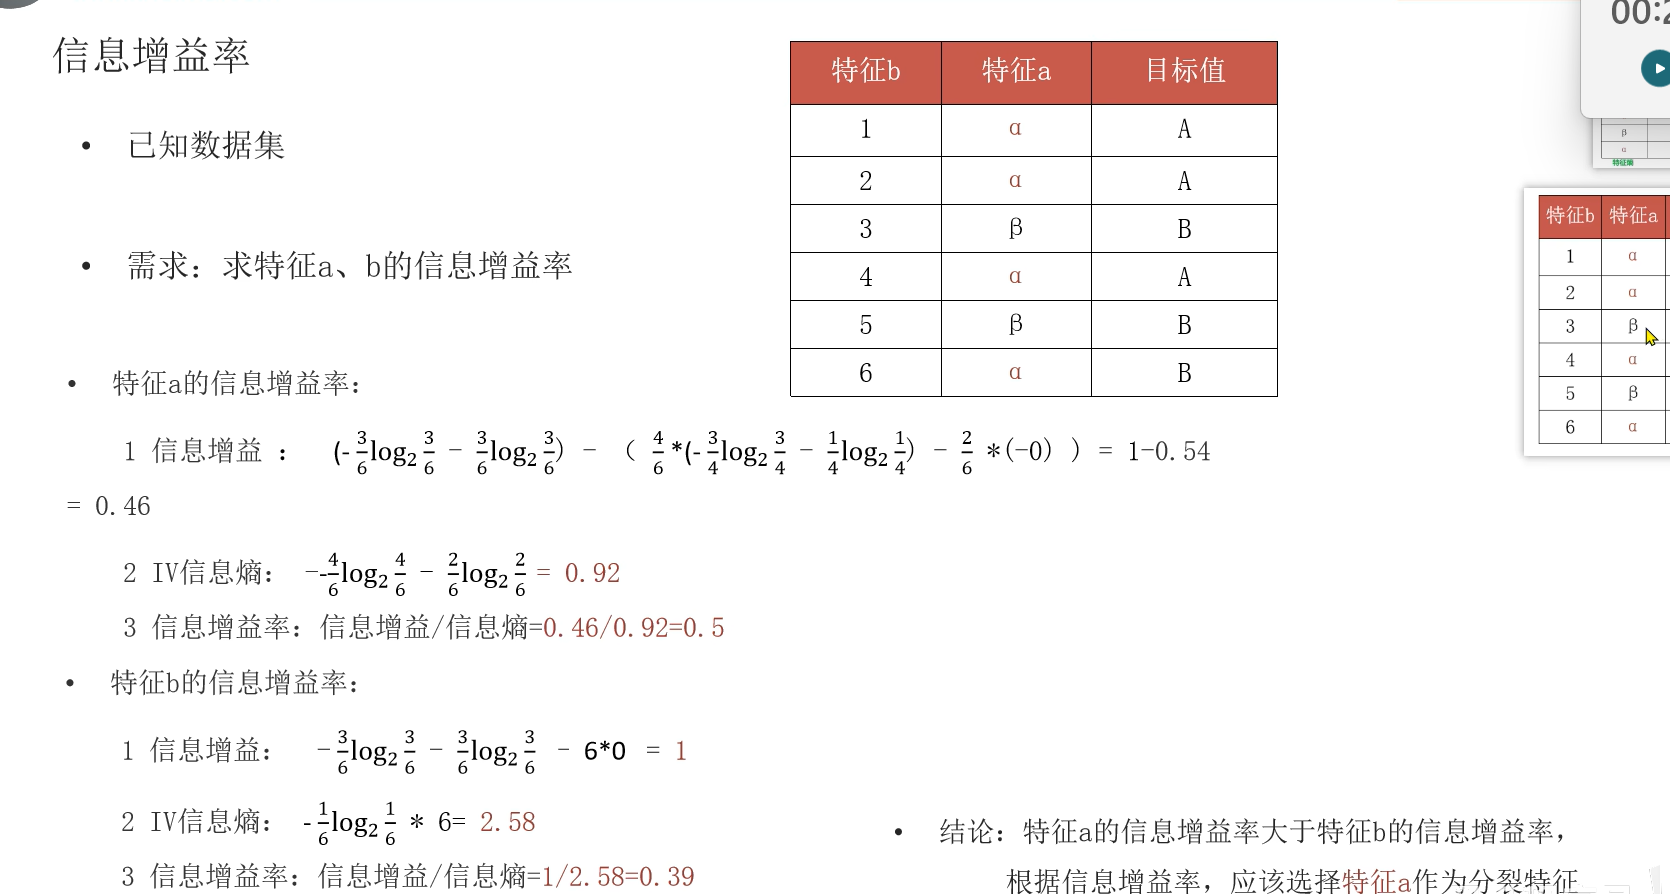
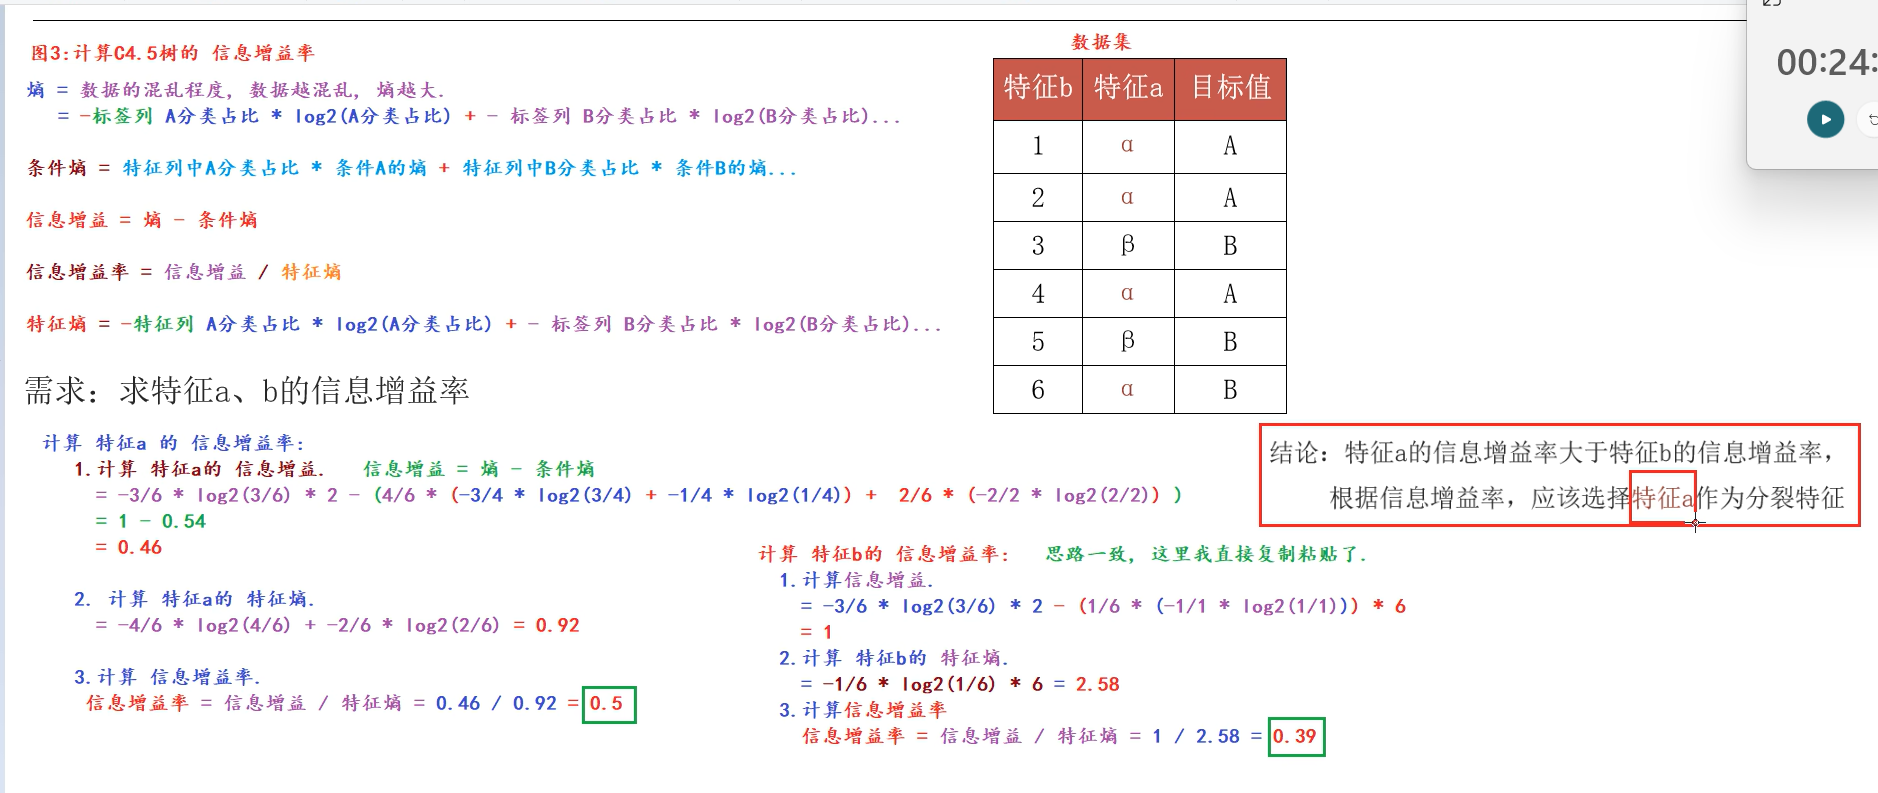
特征取值越多 特征熵越大(分母越大) 信息增益率越小 把特征熵倒数设为惩罚系数很绕 不如把特征熵设为惩罚系数
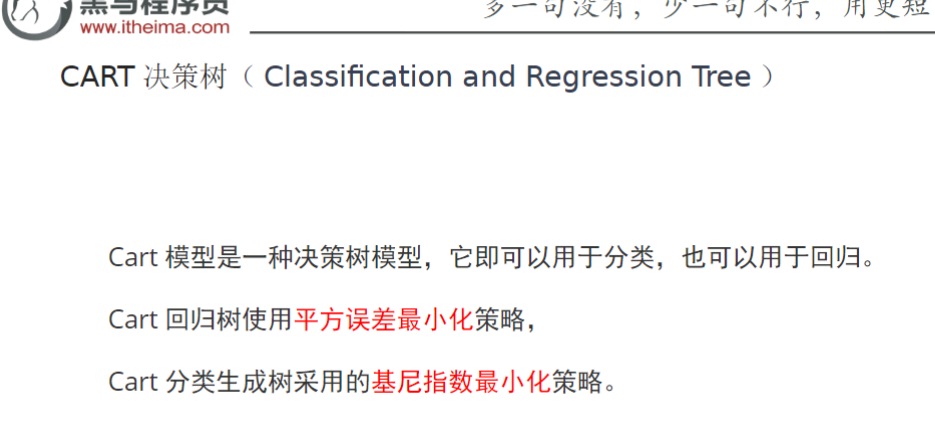
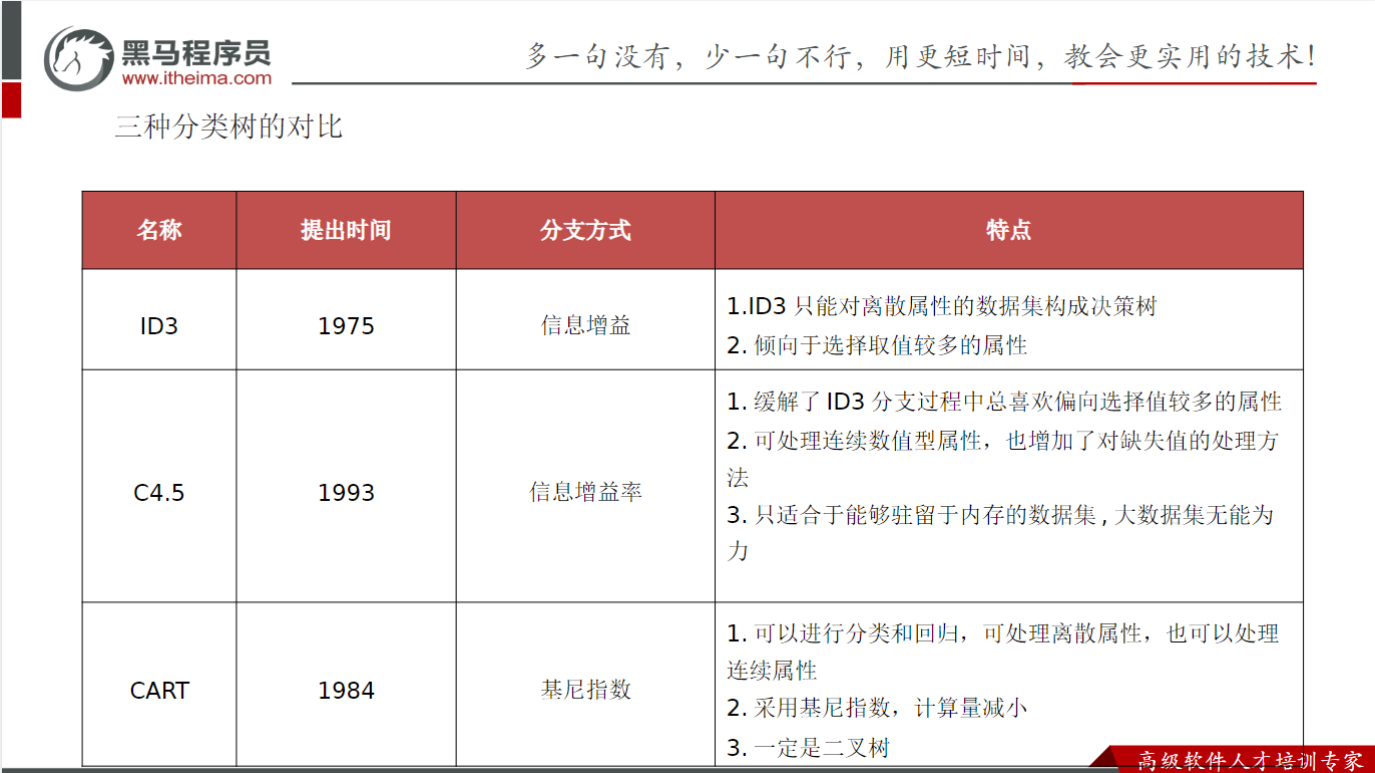
CART决策树
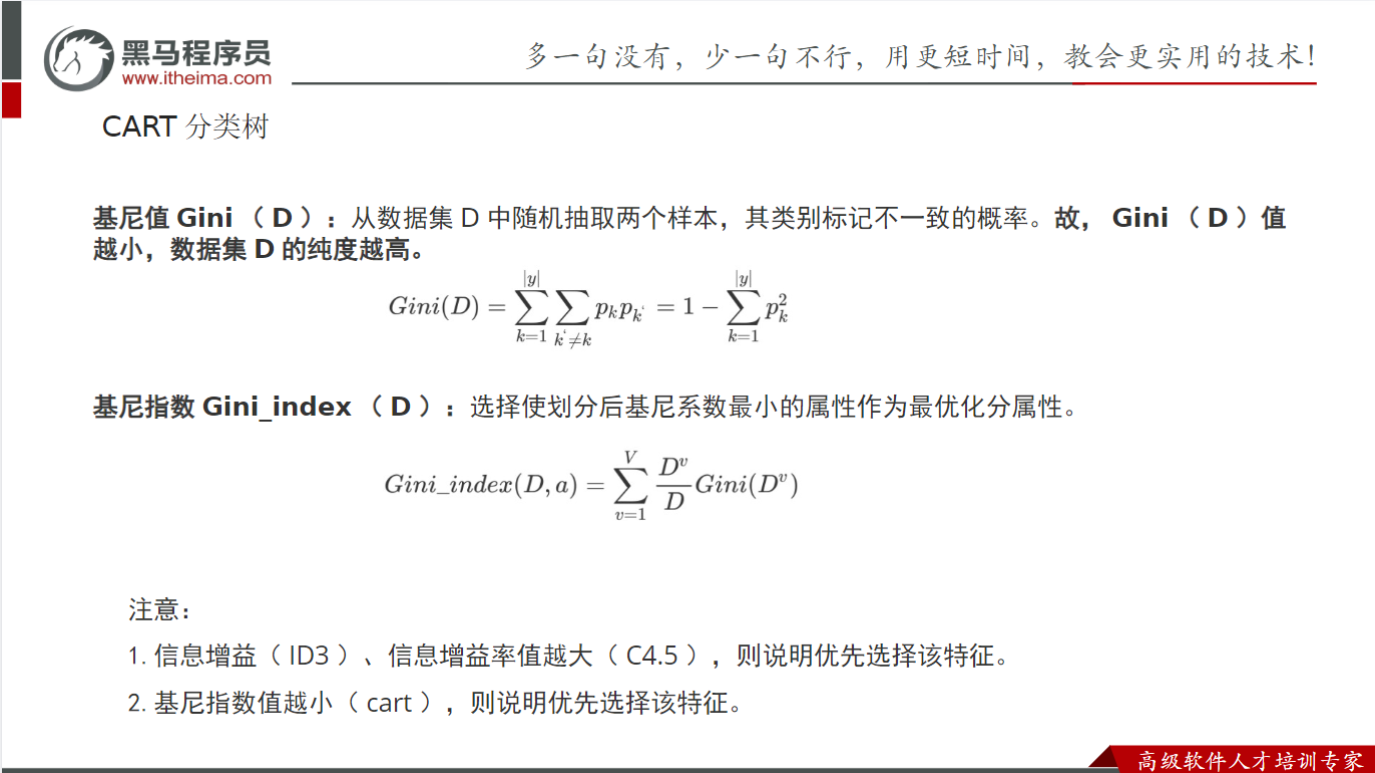
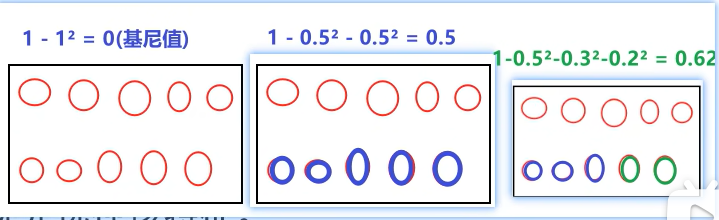
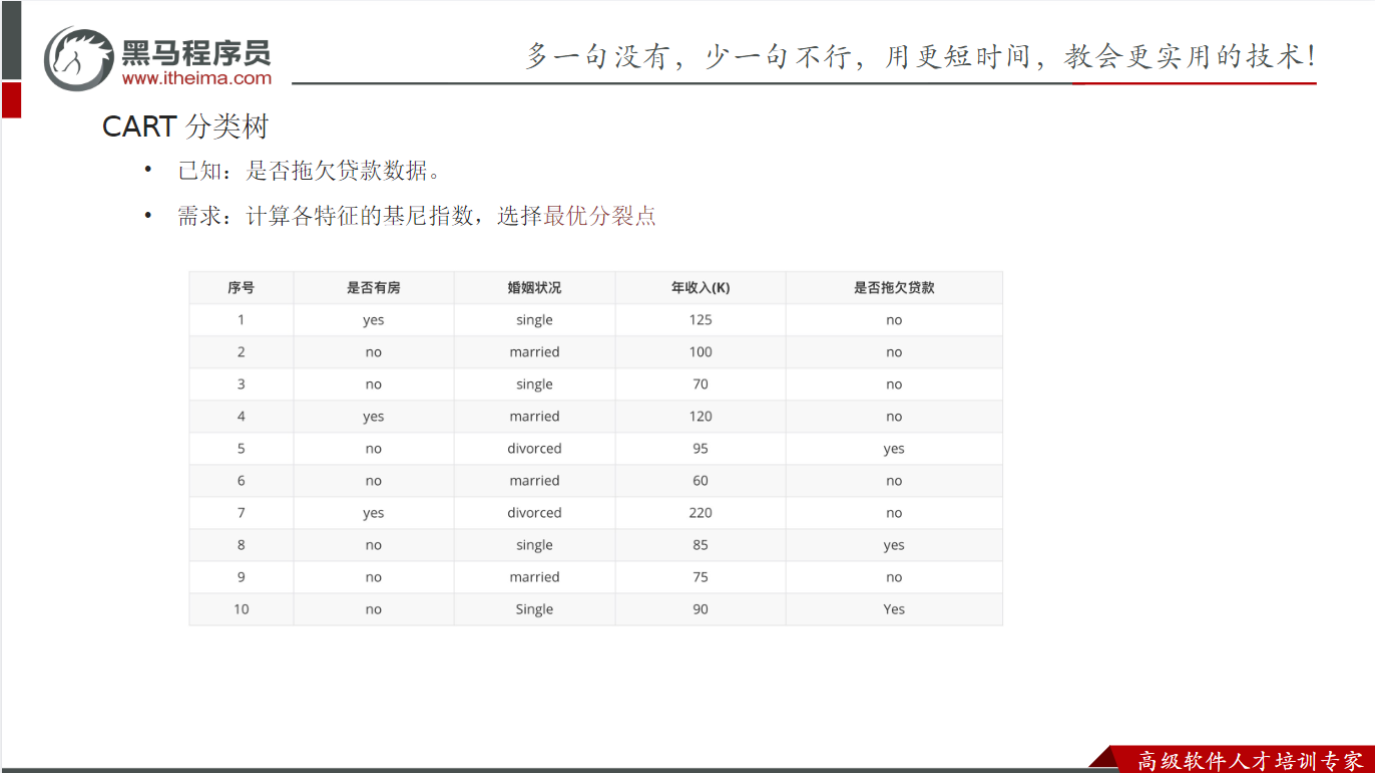
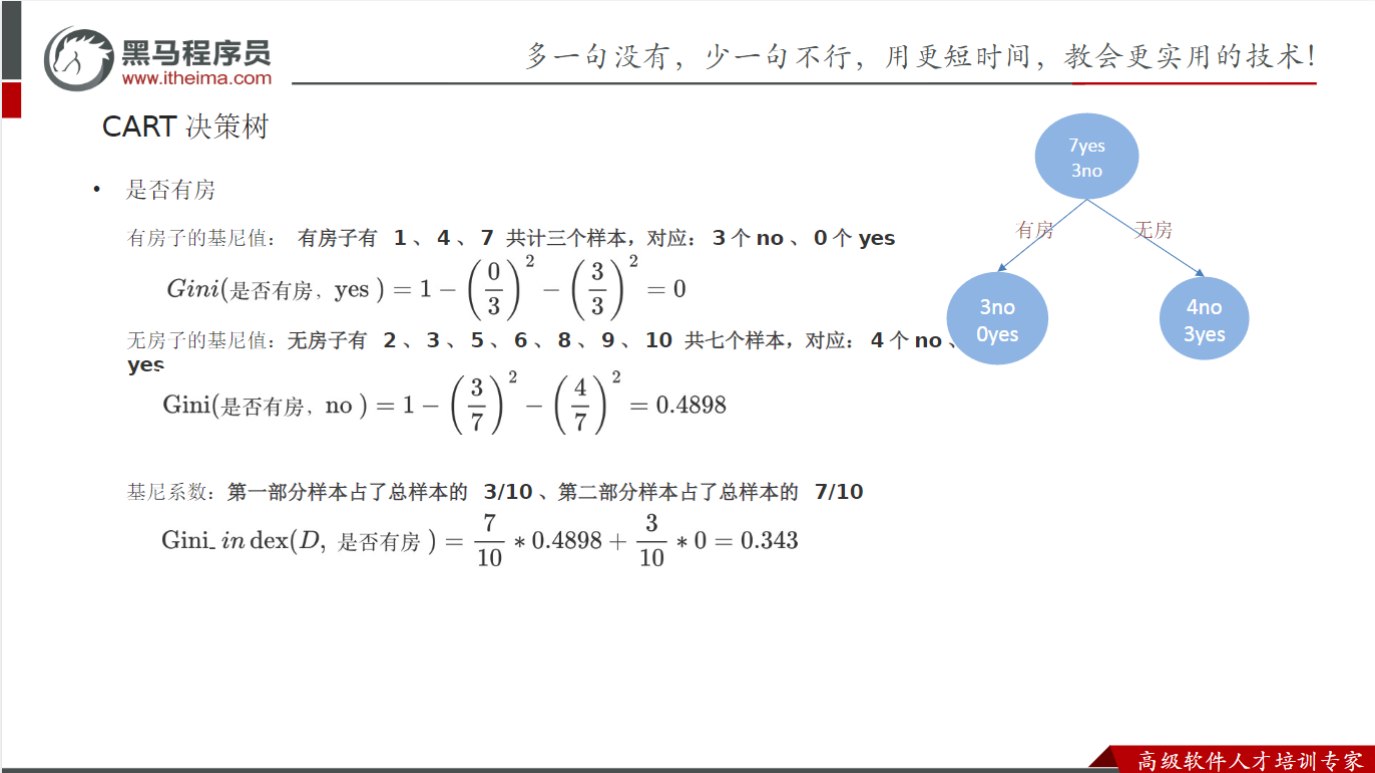
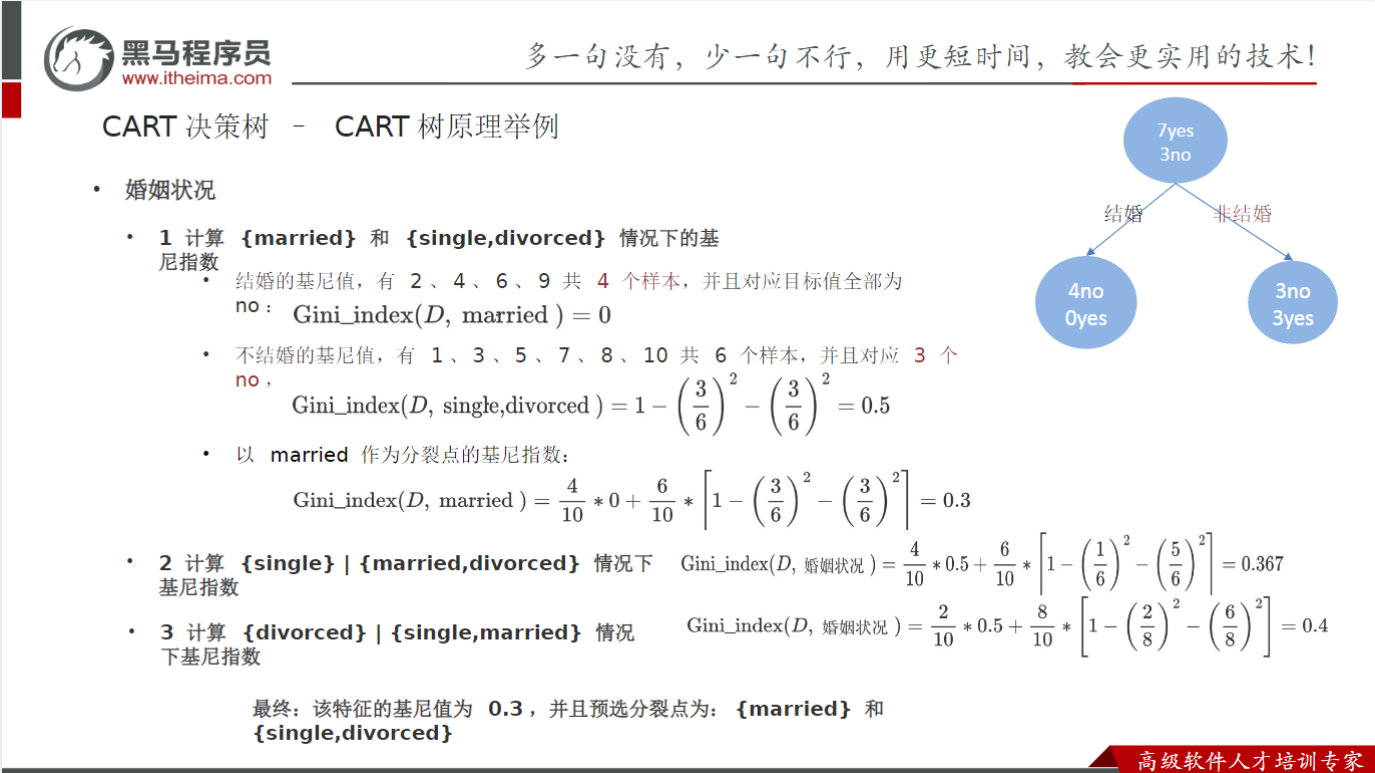
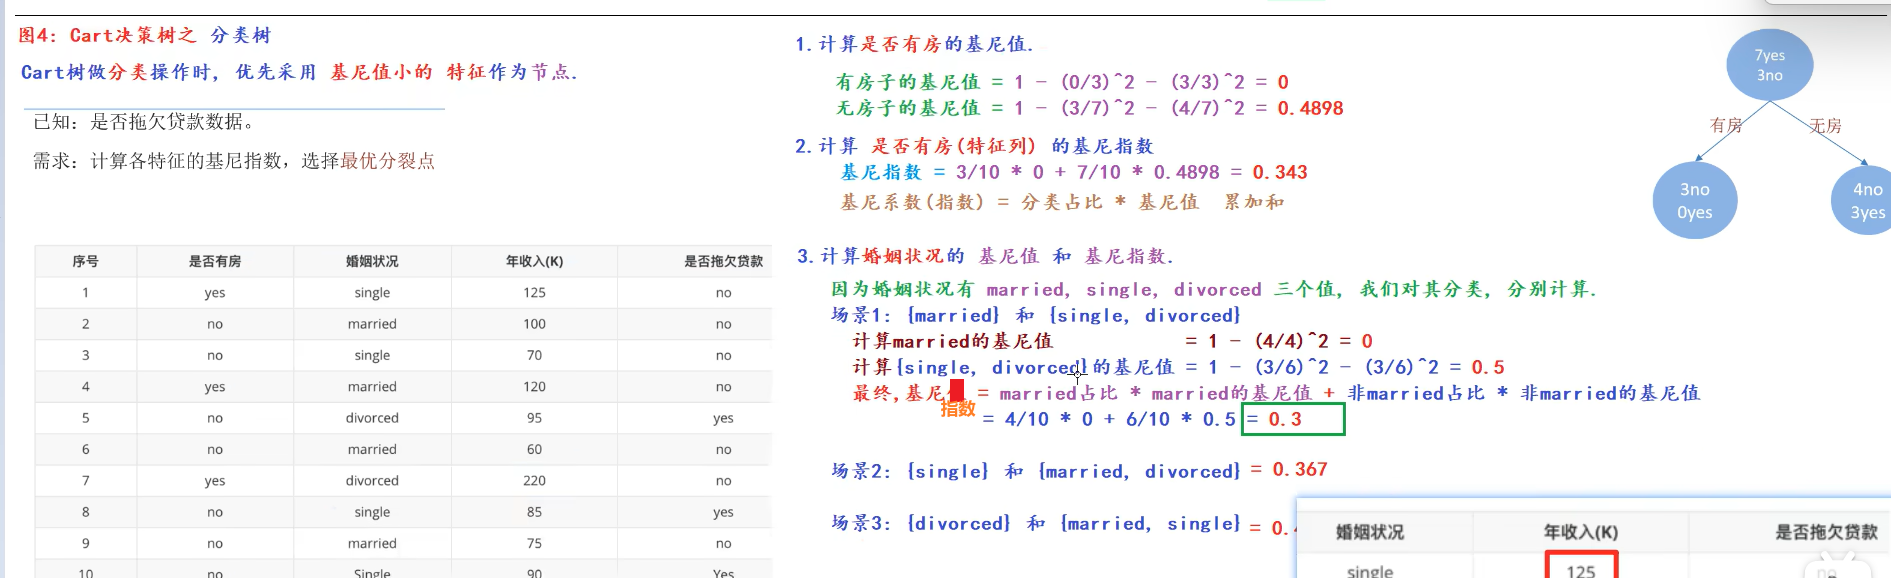
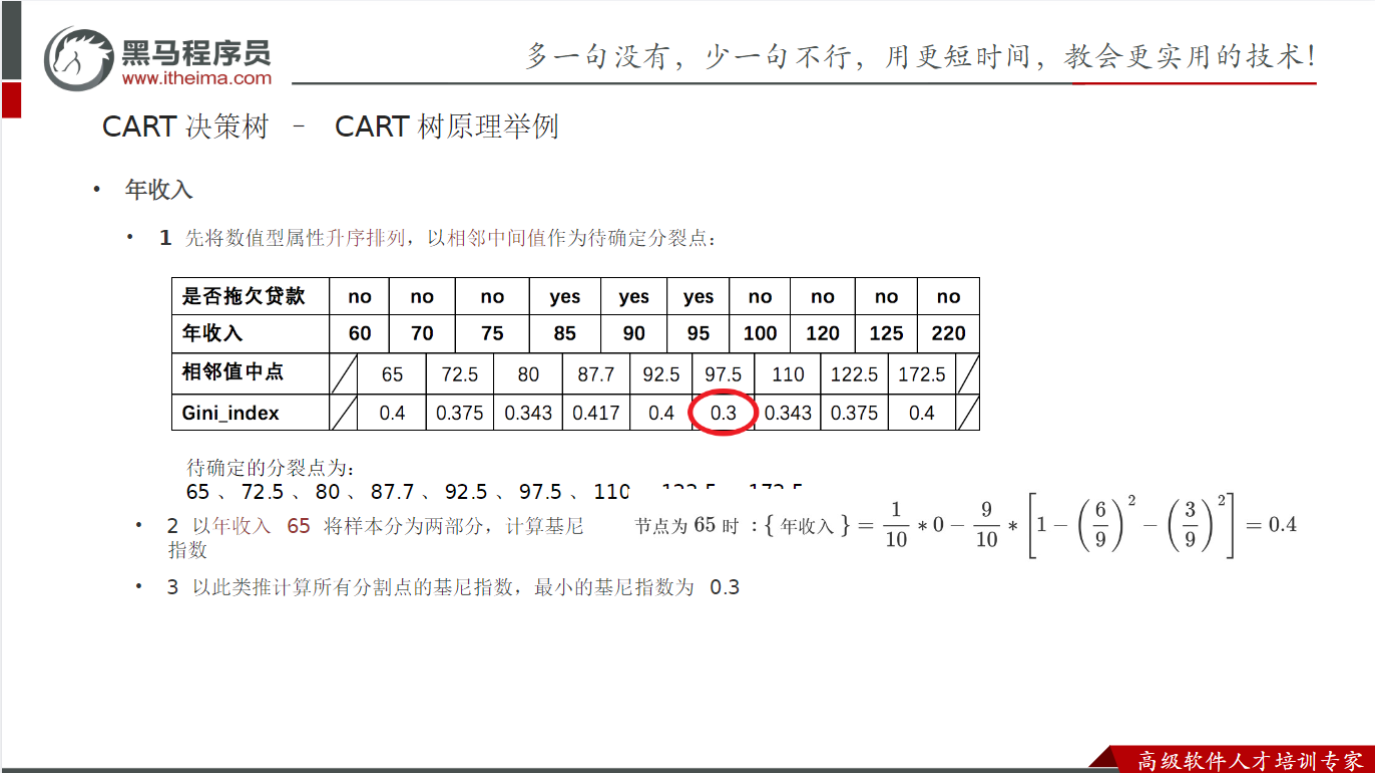
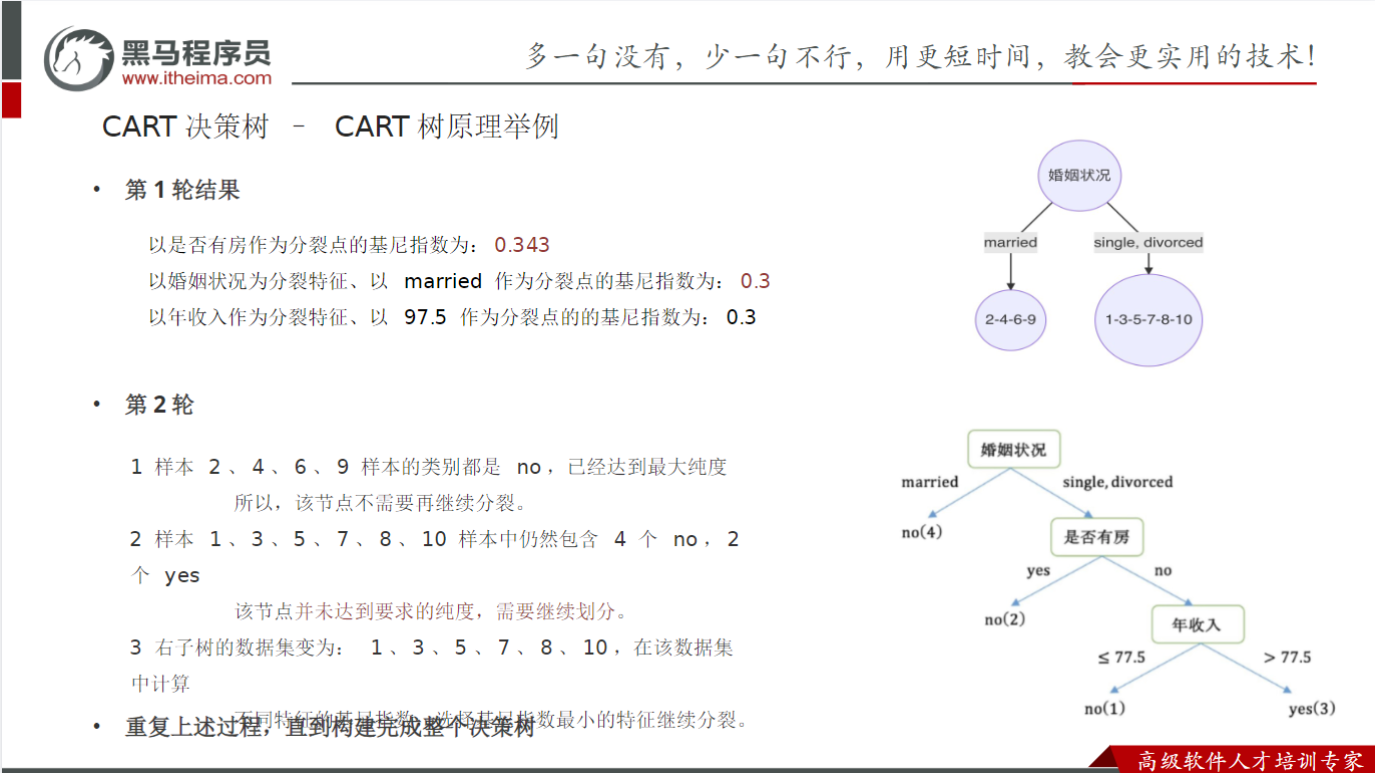
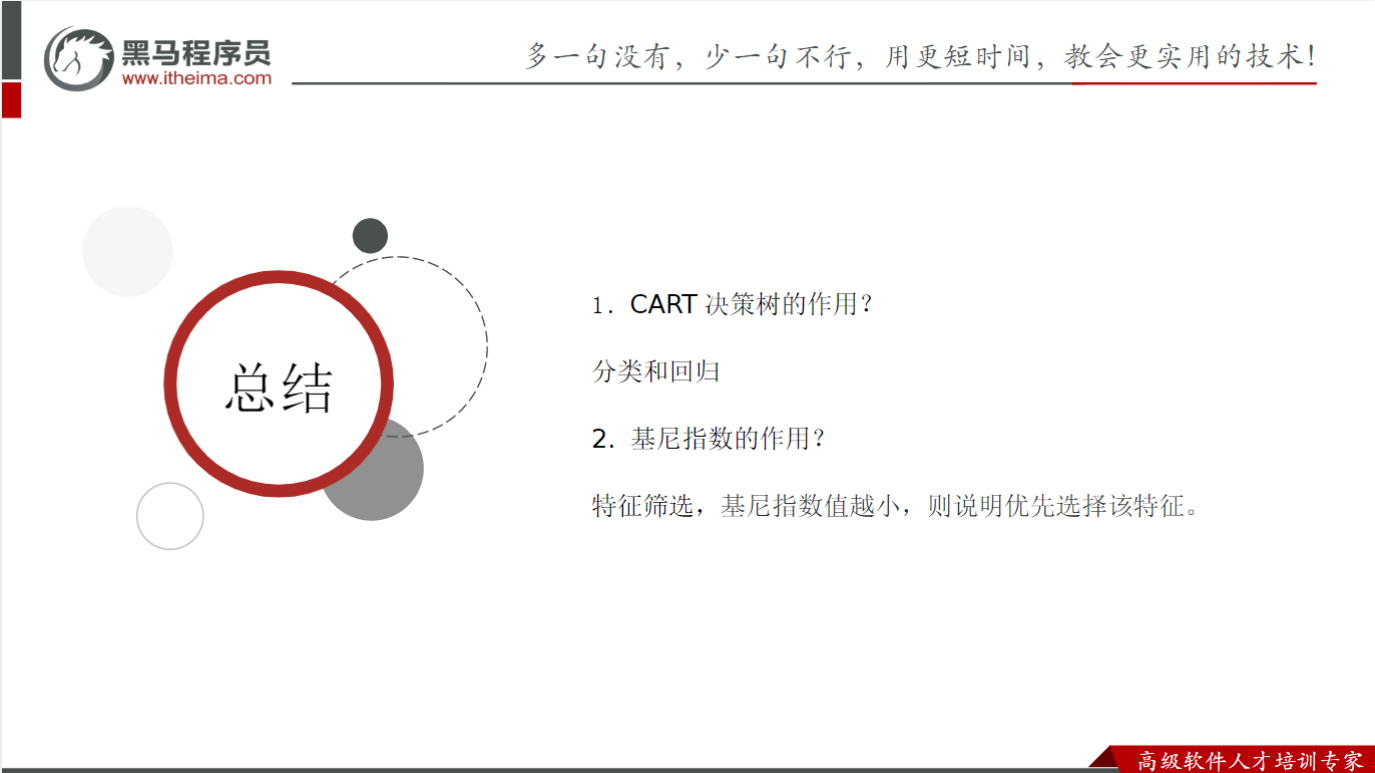
基尼指数:可以算任意多分类的不纯度 决策树分裂:永远是一分为二,所以计算时看起来像二分类
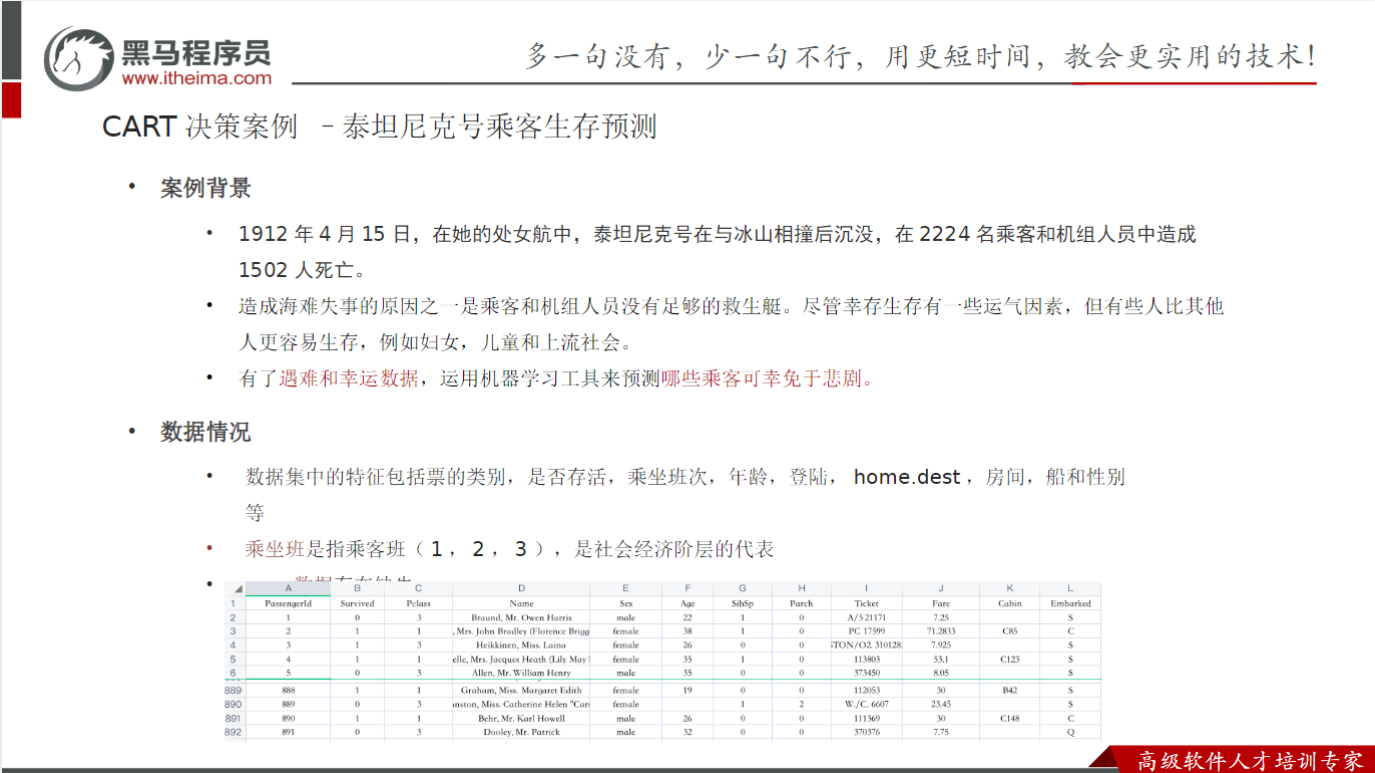
案例泰坦尼克号生存预测
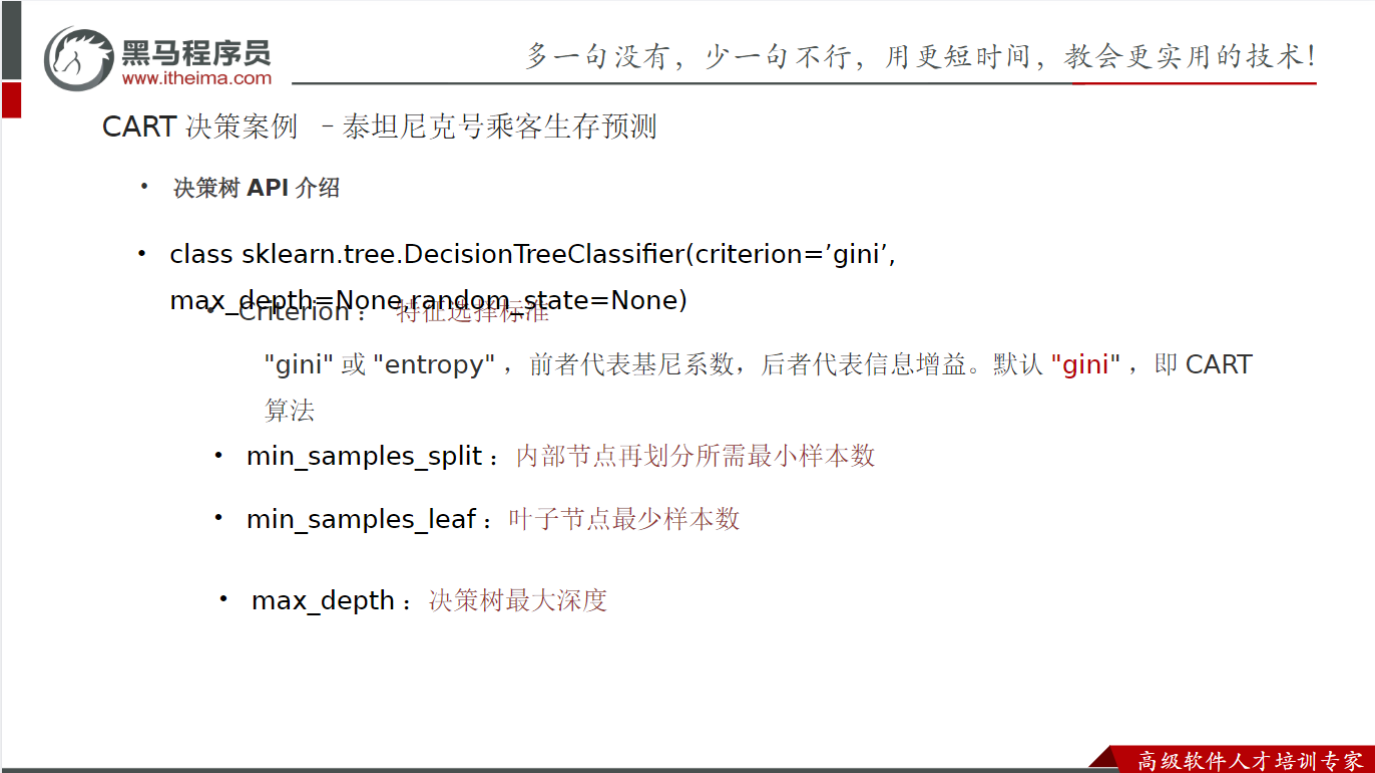
API介绍:
class sklearn.tree.DecisionTreeClassifier(criterion=’gini’, max_depth=None,random_state=None)
criterion
特征选择标准
"gini"或者"entropy",前者代表基尼系数,后者代表信息增益。一默认"gini",即CART算法。
min_samples_split
内部节点再划分所需最小样本数
这个值限制了子树继续划分的条件,如果某节点的样本数少于min_samples_split,则不会继续再尝试选择最优特征来进行划分。 默认是2.如果样本量不大,不需要管这个值。如果样本量数量级非常大,则推荐增大这个值。我之前的一个项目例子,有大概10万样本,建立决策树时,我选择了min_samples_split=10。可以作为参考。
min_samples_leaf
叶子节点最少样本数
这个值限制了叶子节点最少的样本数,如果某叶子节点数目小于样本数,则会和兄弟节点一起被剪枝。 默认是1,可以输入最少的样本数的整数,或者最少样本数占样本总数的百分比。如果样本量不大,不需要管这个值。如果样本量数量级非常大,则推荐增大这个值。之前的10万样本项目使用min_samples_leaf的值为5,仅供参考。
max_depth
决策树最大深度
决策树的最大深度,默认可以不输入,如果不输入的话,决策树在建立子树的时候不会限制子树的深度。一般来说,数据少或者特征少的时候可以不管这个值。如果模型样本量多,特征也多的情况下,推荐限制这个最大深度,具体的取值取决于数据的分布。常用的可以取值10-100之间
random_state
随机数种子
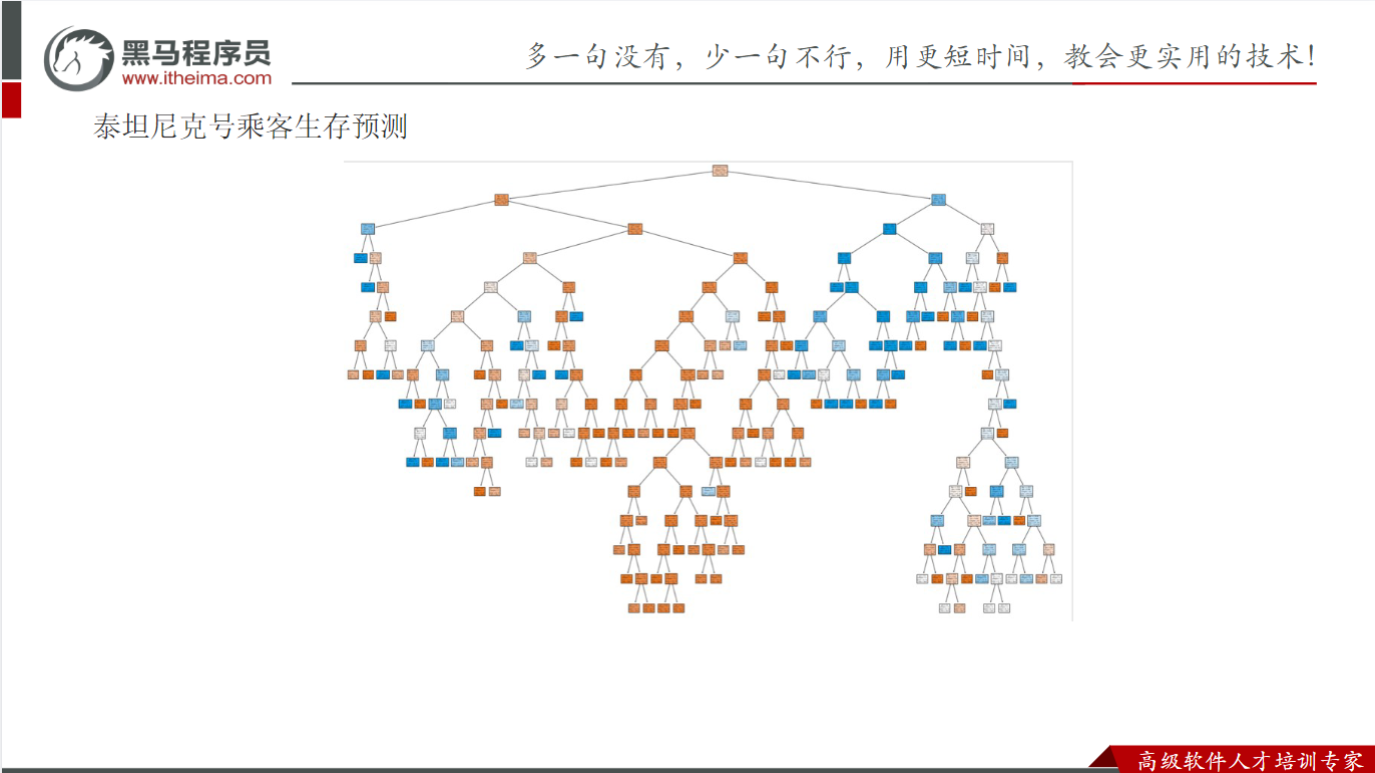
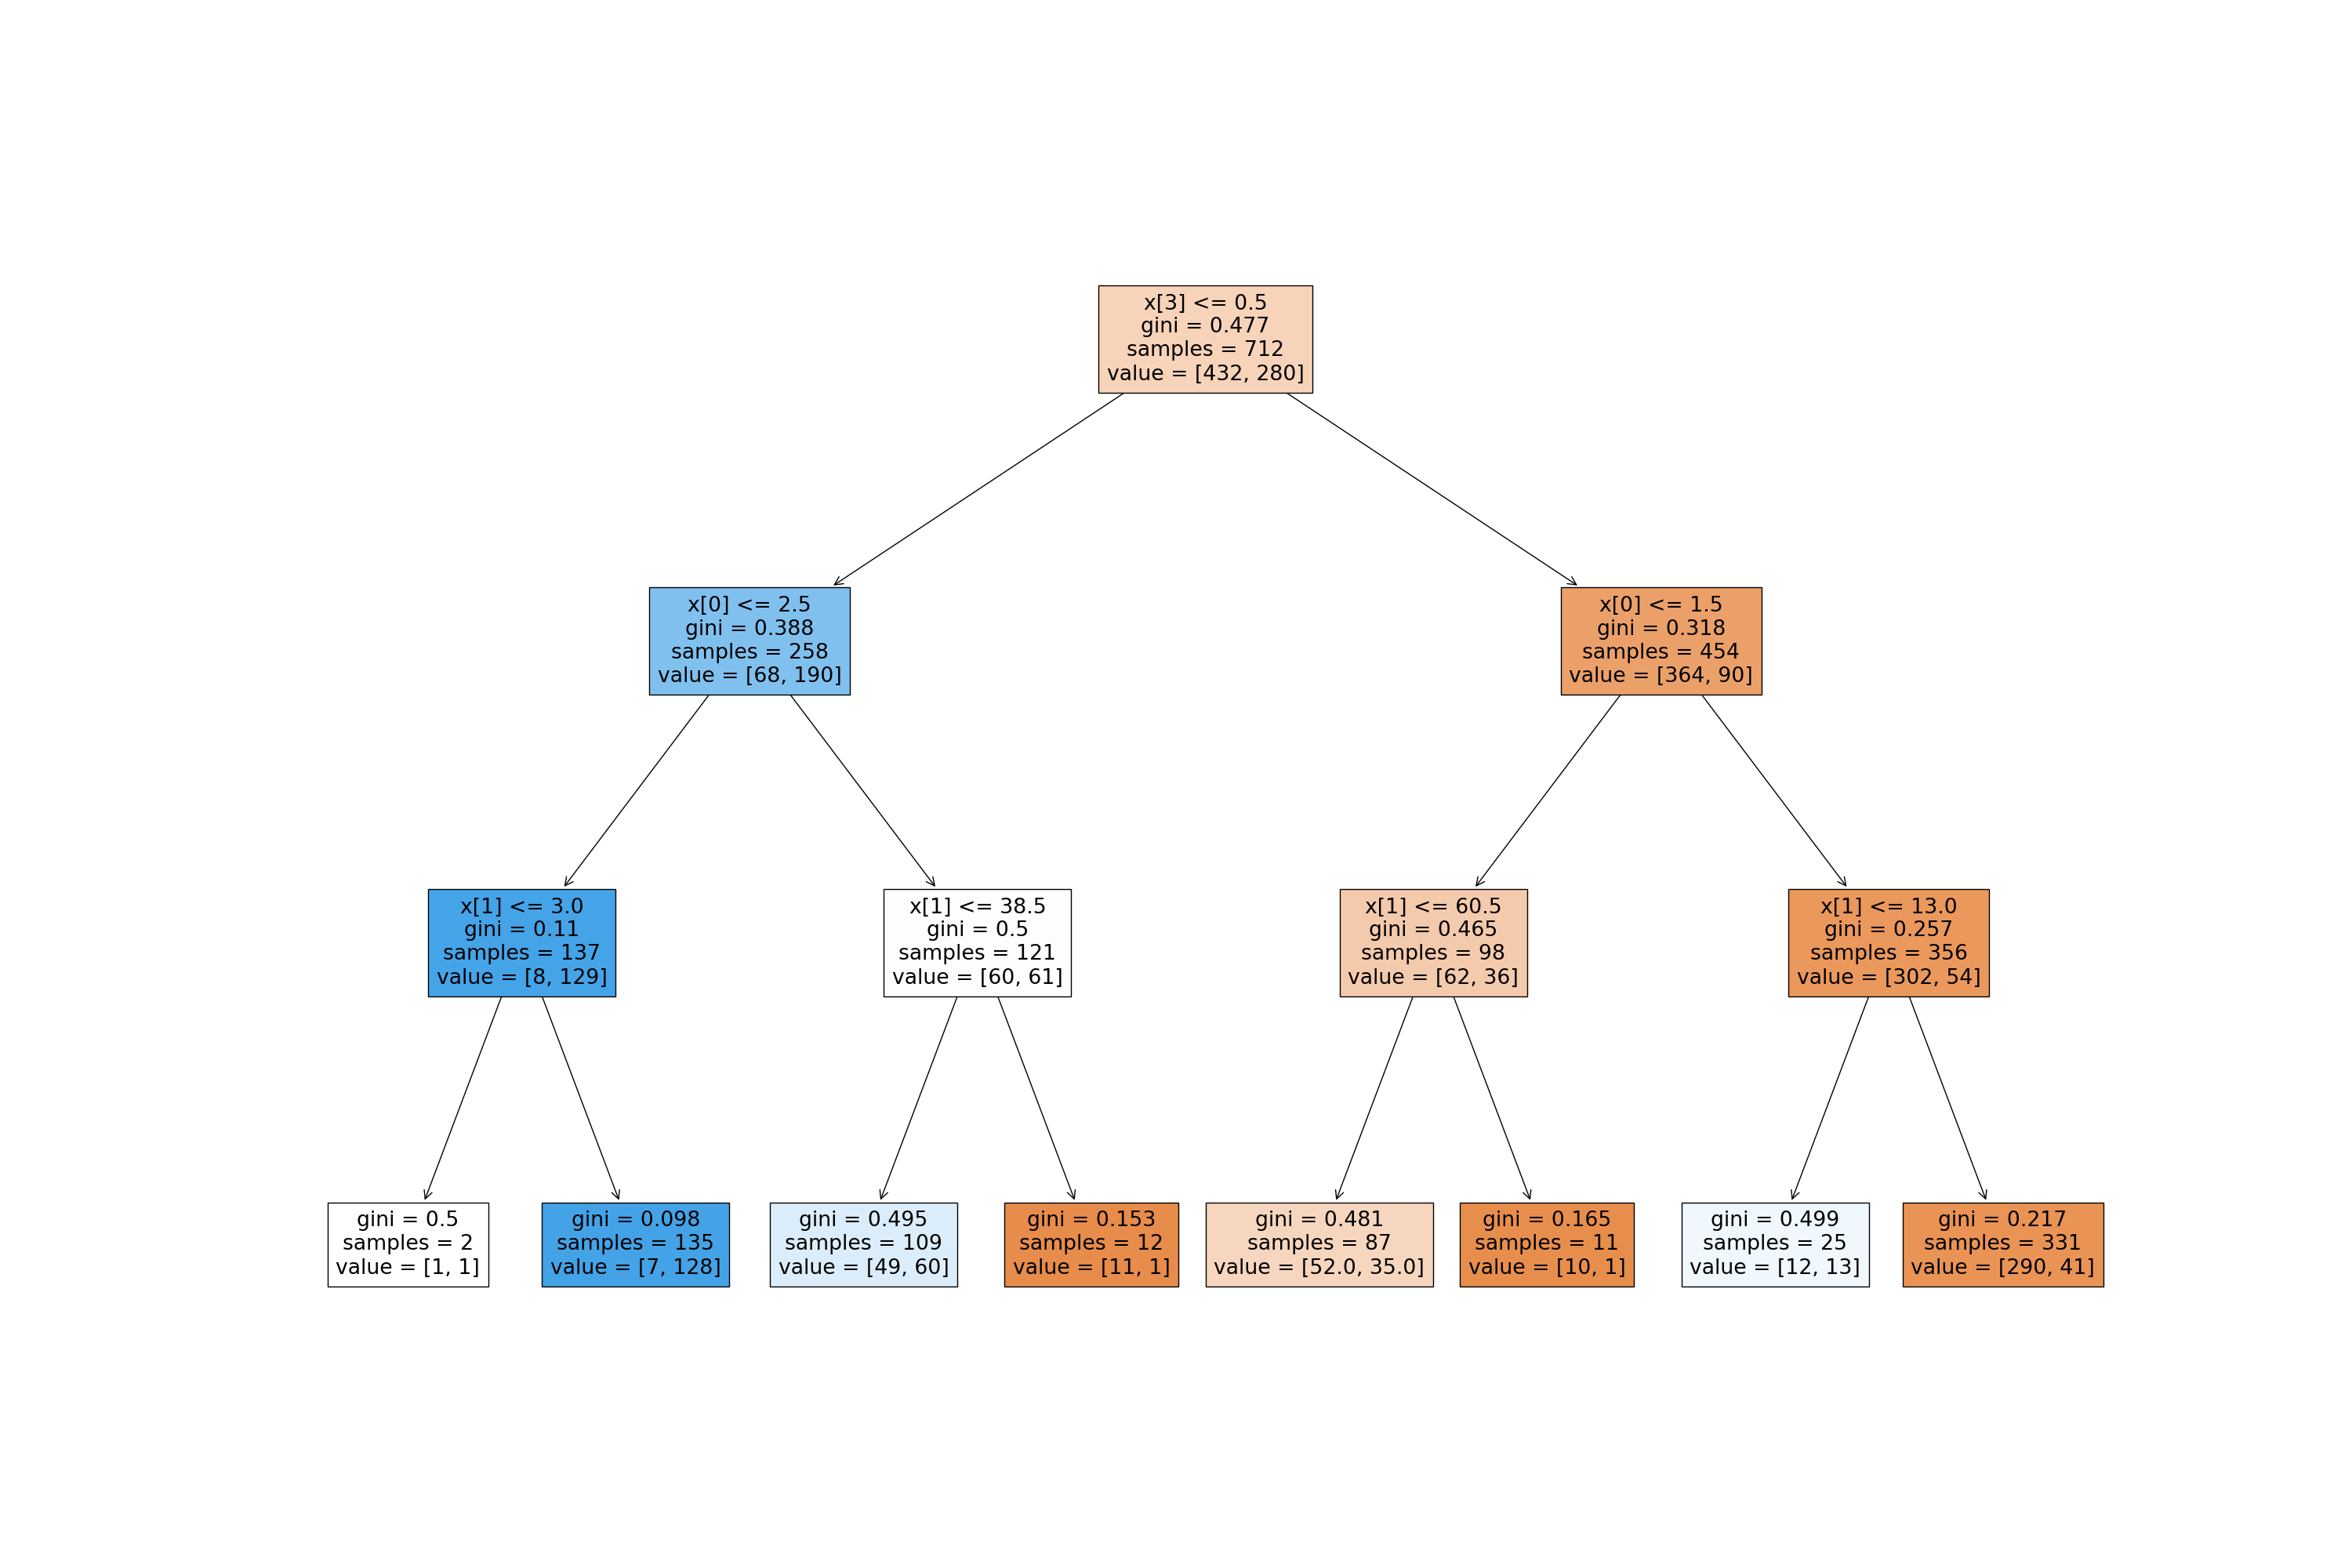
深度为3层的话,类似上面的那个
相比其他学习模型,决策树在模型描述上有巨大的优势,决策树的逻辑推断非常直观,具有清晰的可解释性,也有很方便的模型的可视化。在决策树的使用中,无需考虑对数据量化和标准化,就能达到比较好的识别率。
''''
案例:泰坦尼克号生存预测
'''
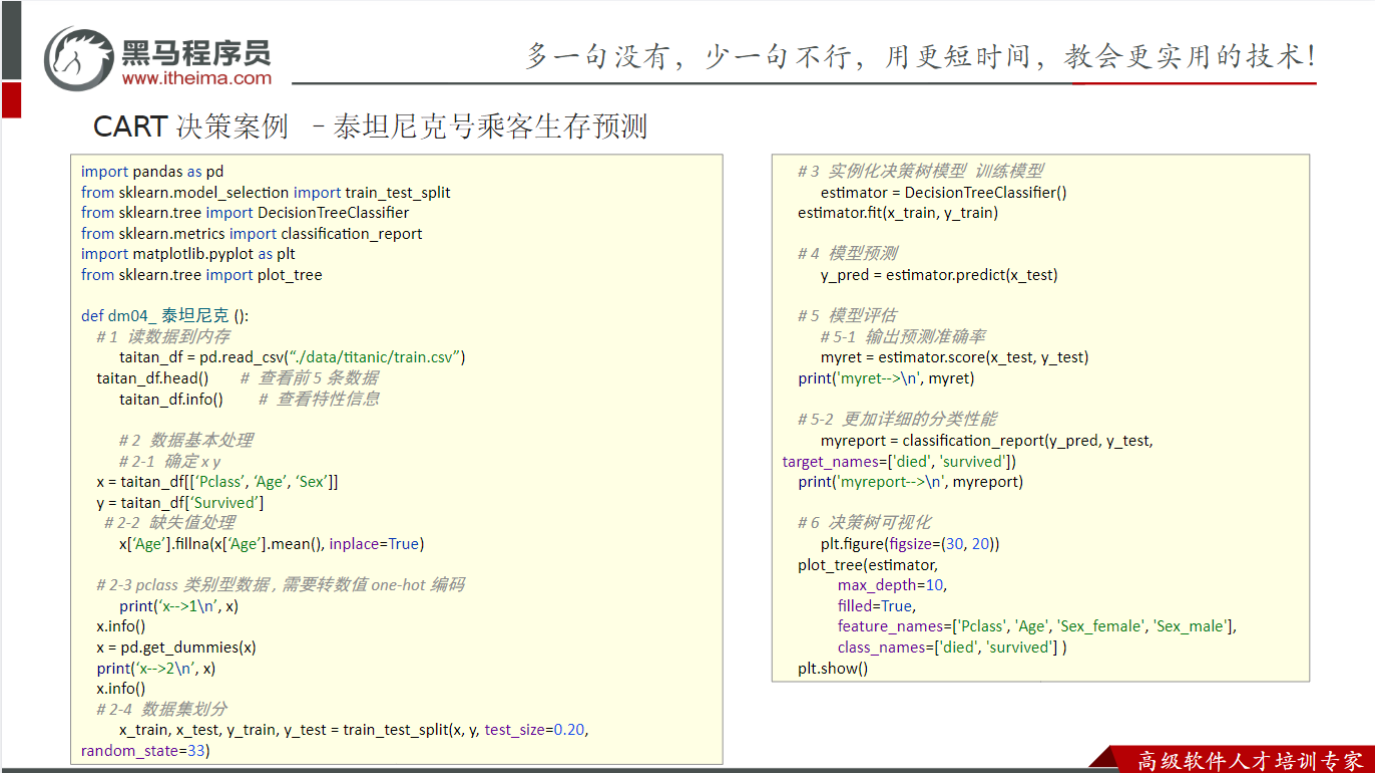
#导包
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import classification_report
import matplotlib.pyplot as plt
from sklearn.tree import plot_tree
#1.加载数据
data=pd.read_csv('./datas/train.csv')
data.info()
#2.数据预处理
#2.1提取特征和标签
x=data[['Pclass','Sex','Age']]#我们需要这3个特征,但是发现Age有缺失值,所以可以先将缺失的值填充为平均值
y=data[['Survived']]
print(x.head(5))
print(y.head(5))
#2.2对Age进行缺失值填充
# x['Age'].fillna(x['Age'].mean(),inplace=True)#会报警告,但是可以用
# x['Age']=x['Age'].fillna(x['Age'].mean())#会报警告,因为修改的是源数据
#解决方案:使用copy()方法复制一份数据,再对复制的数据进行缺失值填充
x=x.copy()
#对复制的数据进行缺失值填充
x['Age']=x['Age'].fillna(x['Age'].mean())
#2.3查看处理后的数据集
x.info()
#2.4由于Sex是Object类型,所以需要将其转换为数值类型,可以进行独热编码
x=pd.get_dummies(x,columns=['Sex'])
x.info()
#2.5划分数据集为训练集和测试集
x_train,x_test,y_train,y_test=train_test_split(x,y,test_size=0.2,random_state=10)
#3.特征工程
#4.模型训练
#参数:max_depth=10表示最大深度为10,绘制决策树时,最多10层
estimator=DecisionTreeClassifier(max_depth=10)
estimator.fit(x_train,y_train)
#5.模型预测
y_pre=estimator.predict(x_test)
print(f'模型预测结果:{y_pre}')
#6.模型评估  直接生成评估报告
print(f'模型评估结果:{classification_report(y_test,y_pre)}')
#7.模型可视化,绘制决策树图
plt.figure(figsize=(30,20))#设置图片大小为,30*100(dpi)*20*100(dpi)=3000*2000像素
#参数1:模型对象, 参2: 是否用颜色填充, 参3: 绘制的 决策树结构, 最多10层.
plot_tree(estimator,filled=True,max_depth=10)
plt.savefig('./datas/决策树.png')
plt.show()
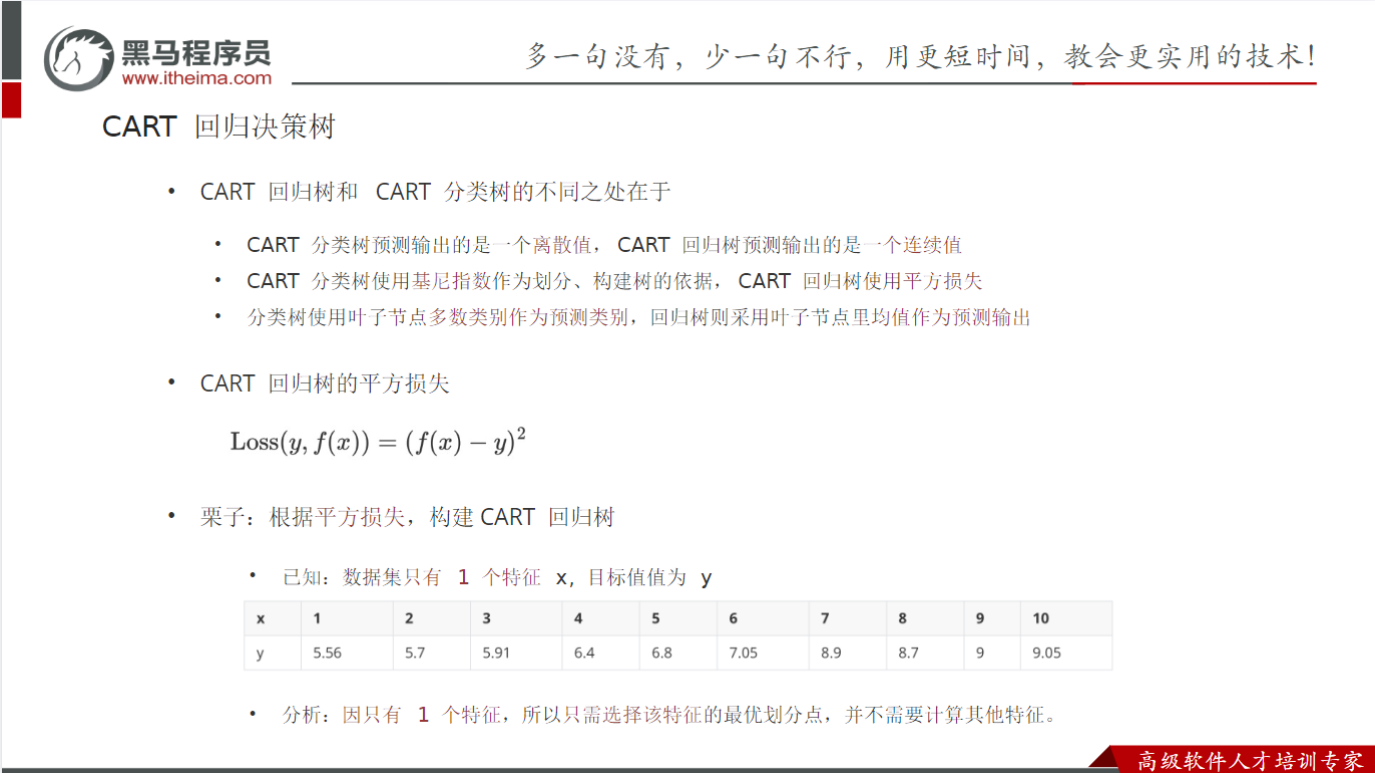
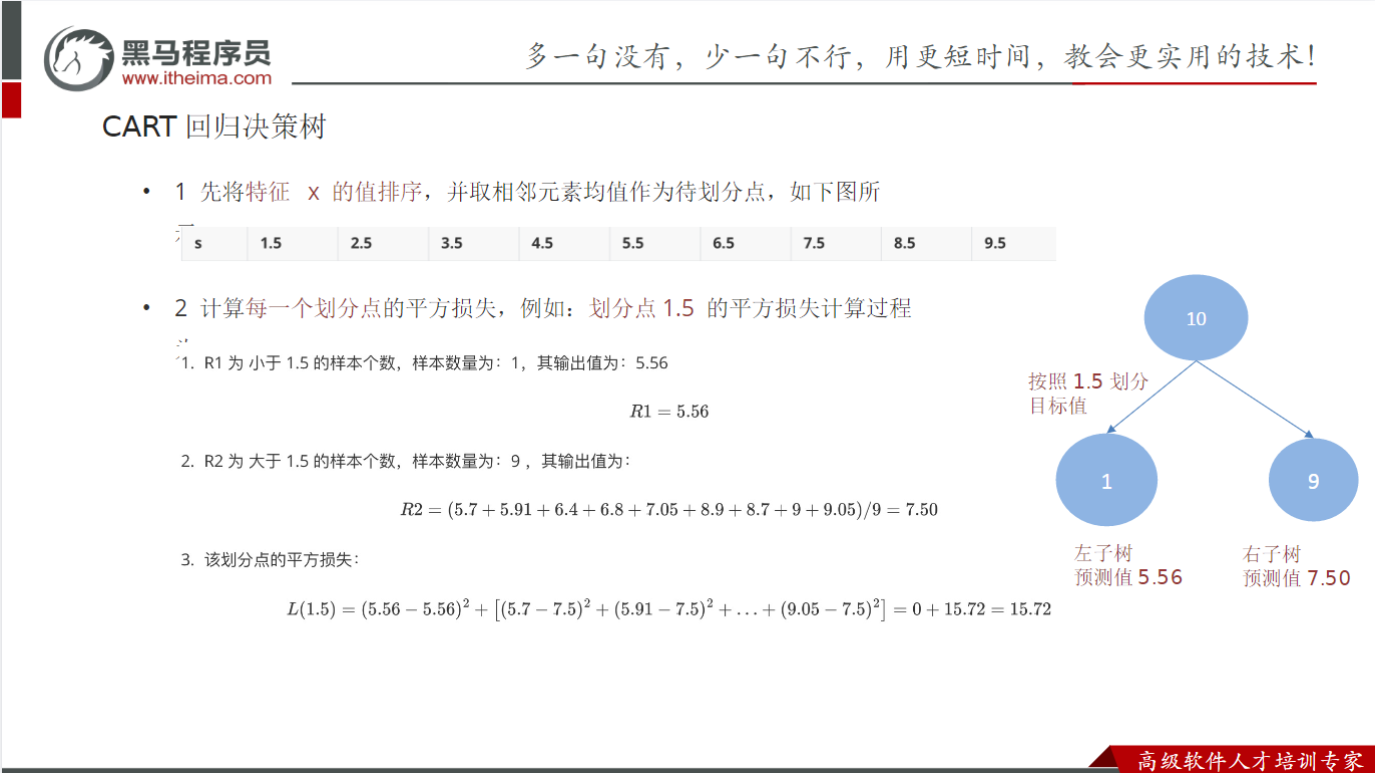
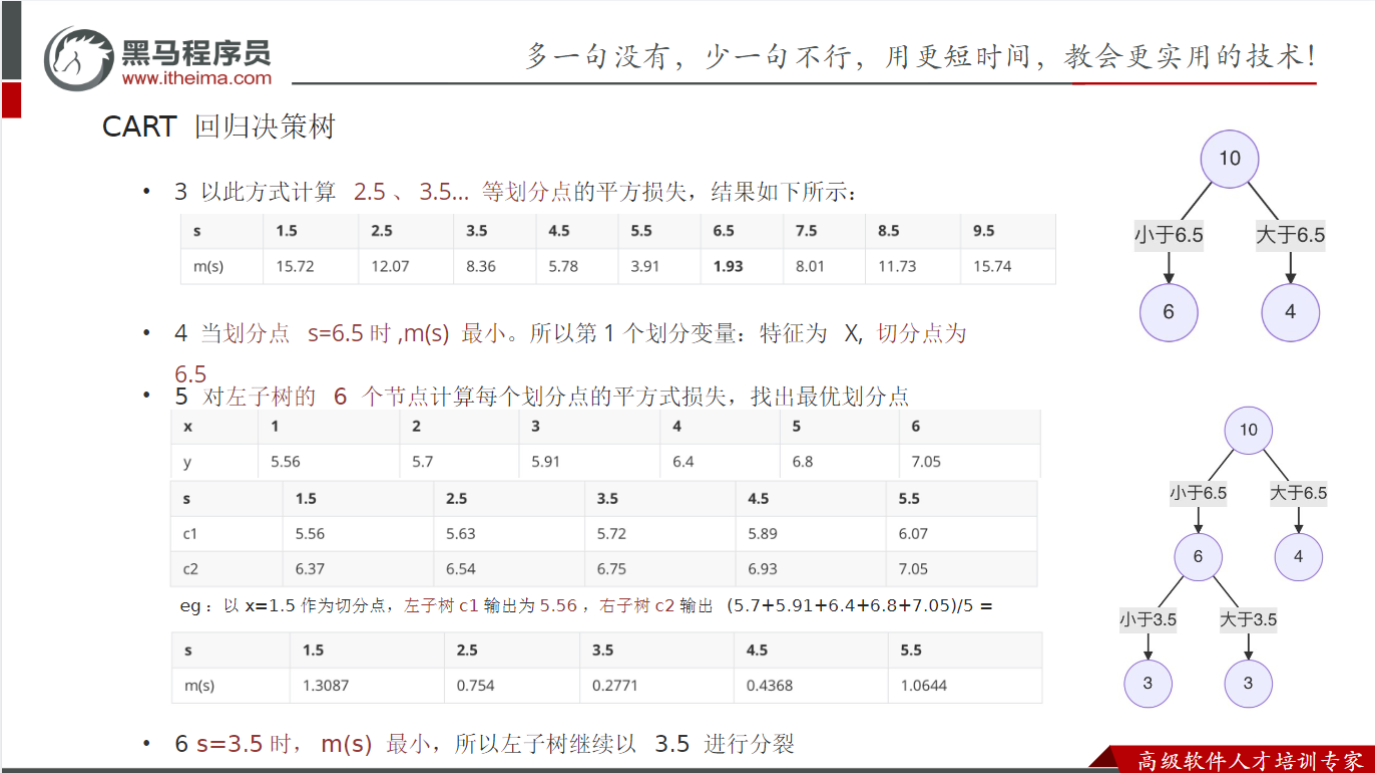
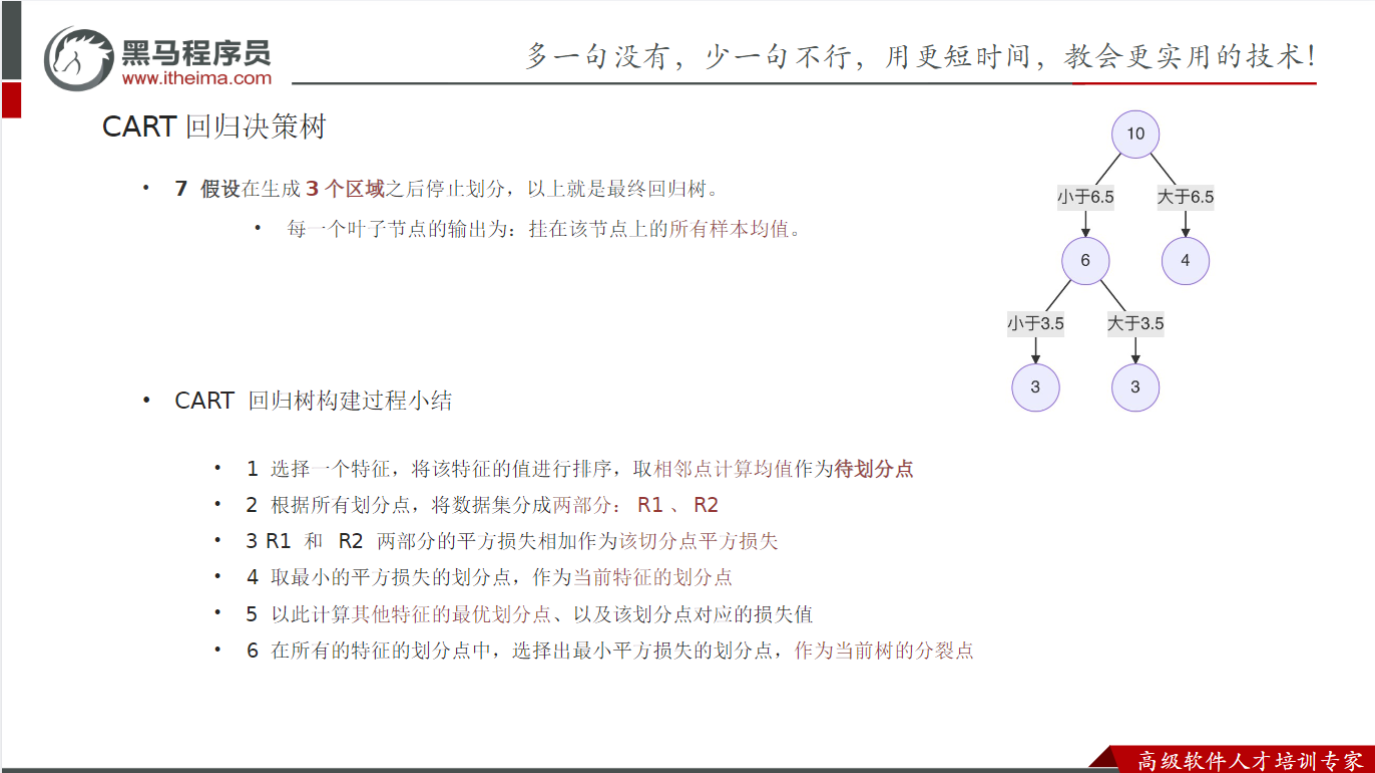
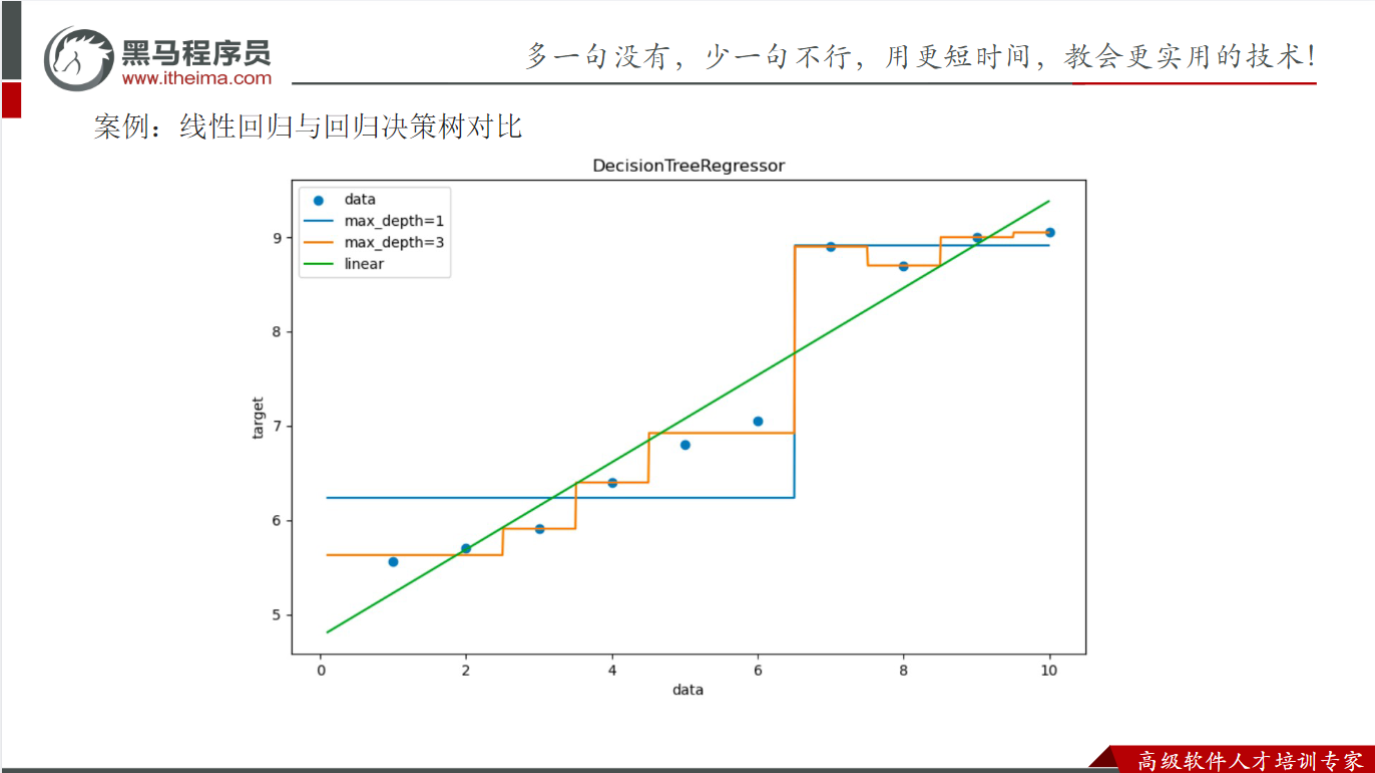
CART回归树
'''
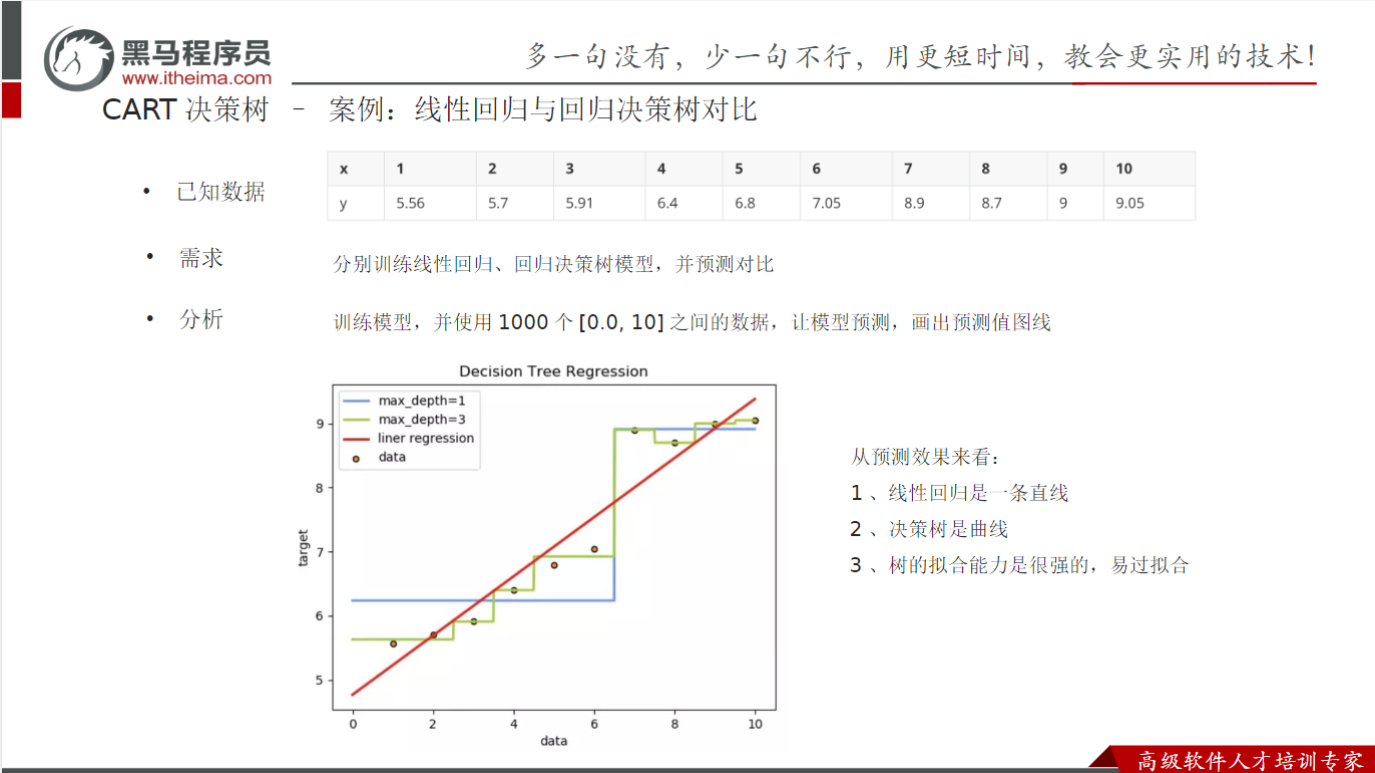
案例:线性回归和回归决策树的比较
细节:
CART:分类回归决策树,既可以做分类,也可以做回归,一般做分类
做分类采用的是基尼值,做回归采用的是平方损失(类似于最小二乘)
'''
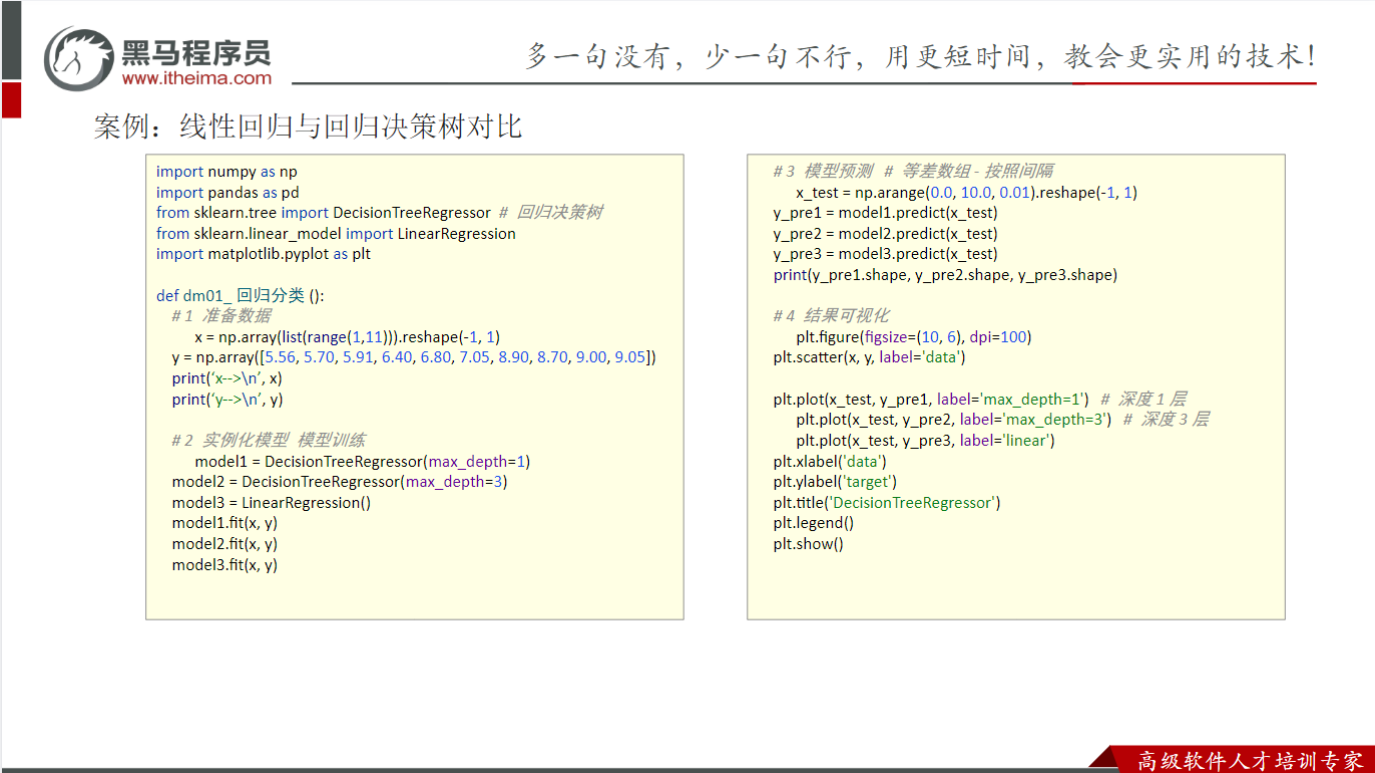
#导包
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.tree import DecisionTreeRegressor#回归决策树
from sklearn.linear_model import LinearRegression#线性回归

#1.准备数据
#训练集的特征数据
x_train=np.array(list(range(1,11))).reshape(-1,1)
#训练集的标签数据
y_train=np.array([5.56,5.7,5.91,6.4,6.8,7.05,8.9,8.7,9,9.05])
print(x_train)
print(y_train)
#2.数据预处理
#3.特征工程
#4.模型训练
#4.1分别创建线性回顾和回归决策树模型对象
estimator1=DecisionTreeRegressor(max_depth=1)#回归决策树,最大树深度为1
estimator2=DecisionTreeRegressor(max_depth=3)#回归决策树,最大树深度为3
estimator3=LinearRegression()#线性回归
#4.2模型训练
estimator1.fit(x_train,y_train)
estimator2.fit(x_train,y_train)
estimator3.fit(x_train,y_train)
#5.模型预测
#5.1准备测试集的特征数据
# x_test=np.array(list(range(1,11))).reshape(-1,1)#报错,Python自带的range()函数,不支持小数
x_test=np.arange(1,11).reshape(-1,1)
print(x_test)
#5.2具体的训练动作
y_pre1=estimator1.predict(x_test)
y_pre2=estimator2.predict(x_test)
y_pre3=estimator3.predict(x_test)
#5.3打印预测结果
print(f'回归决策树,最大树深度为1的预测结果:{y_pre1}')
print(f'回归决策树,最大树深度为3的预测结果:{y_pre2}')
print(f'线性回归的预测结果:{y_pre3}')
#6.模型评估
#7.模型可视化
#7.1以真实值(训练集)为x轴,以预测值为y轴,绘制散点图
plt.scatter(x_train,y_train,c='gray')
#7.2以预测值(线性回归,回归决策树)绘制折线图
plt.plot(x_test,y_pre1,color='red',label='max depth=1')
plt.plot(x_test,y_pre2,color='blue',label='max depth=3')
plt.plot(x_test,y_pre3,color='green',label='linear regression')
#7.3添加图例
plt.legend()
#7.4设置x轴和y轴的标签,标题
plt.xlabel('x')
plt.ylabel('y')
plt.title('Linear Regression and Decision Tree Comparison')
plt.show()
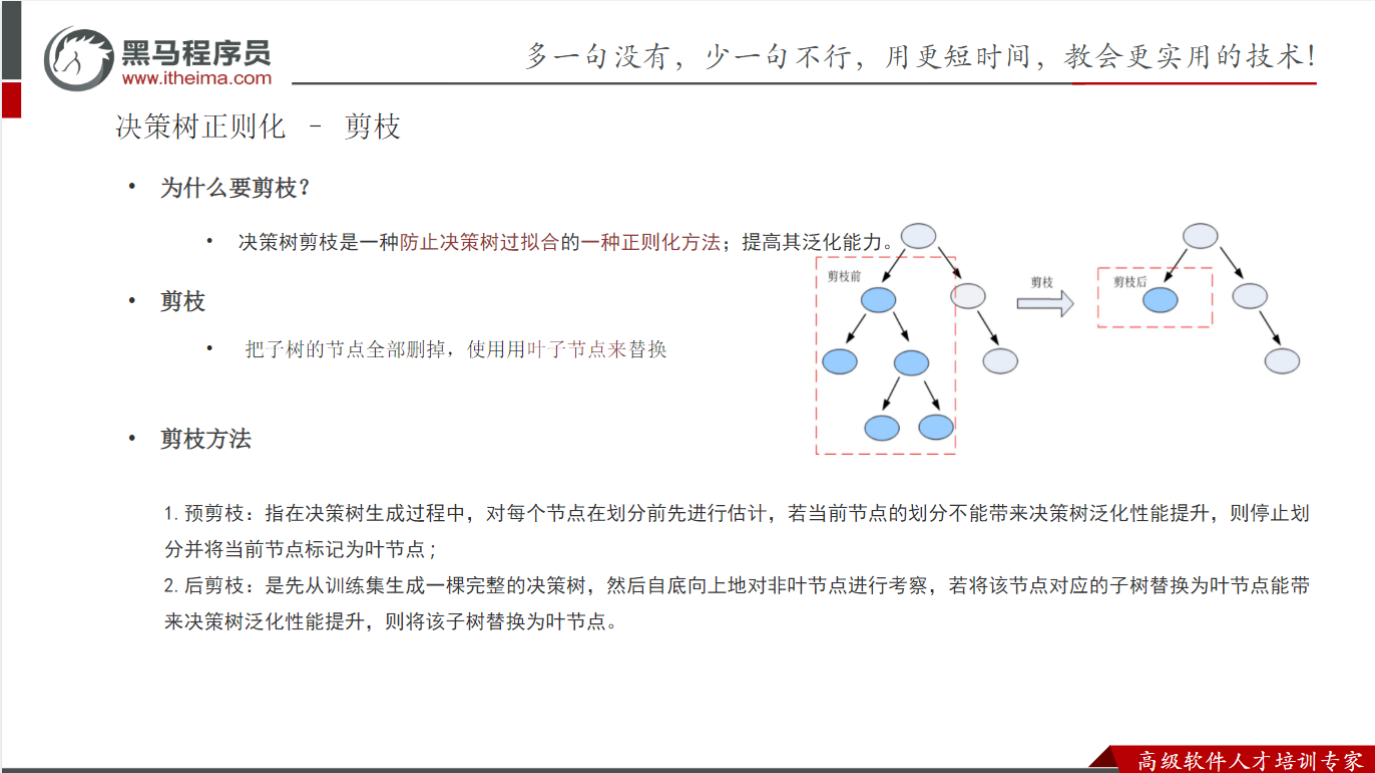
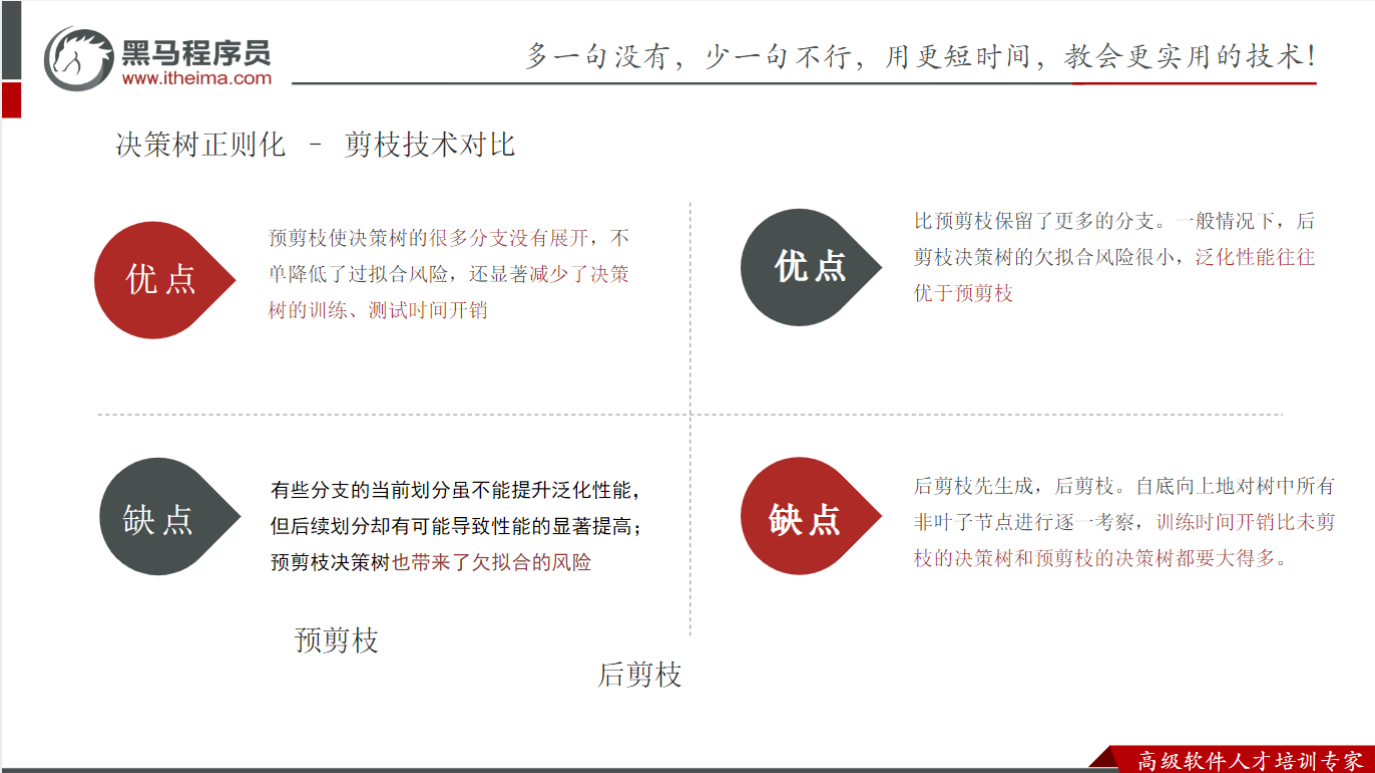
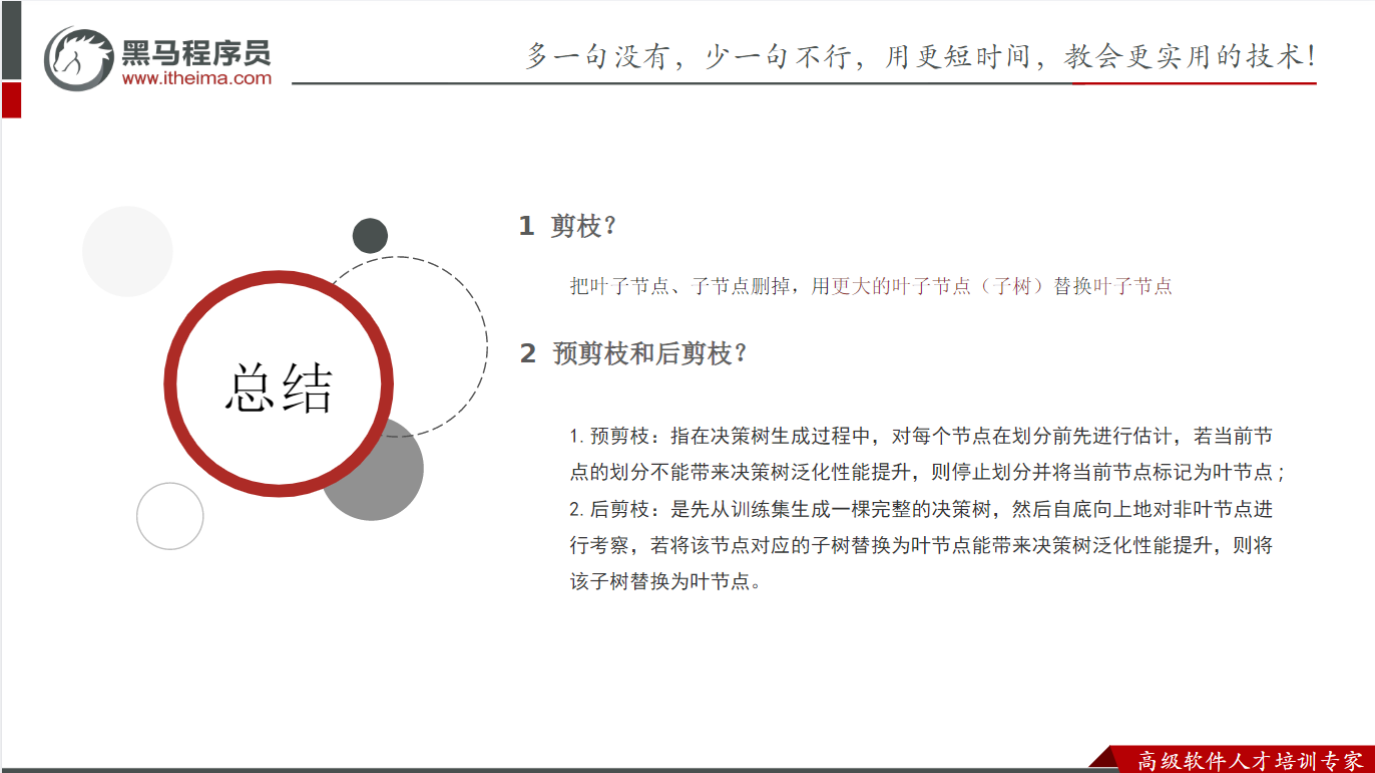
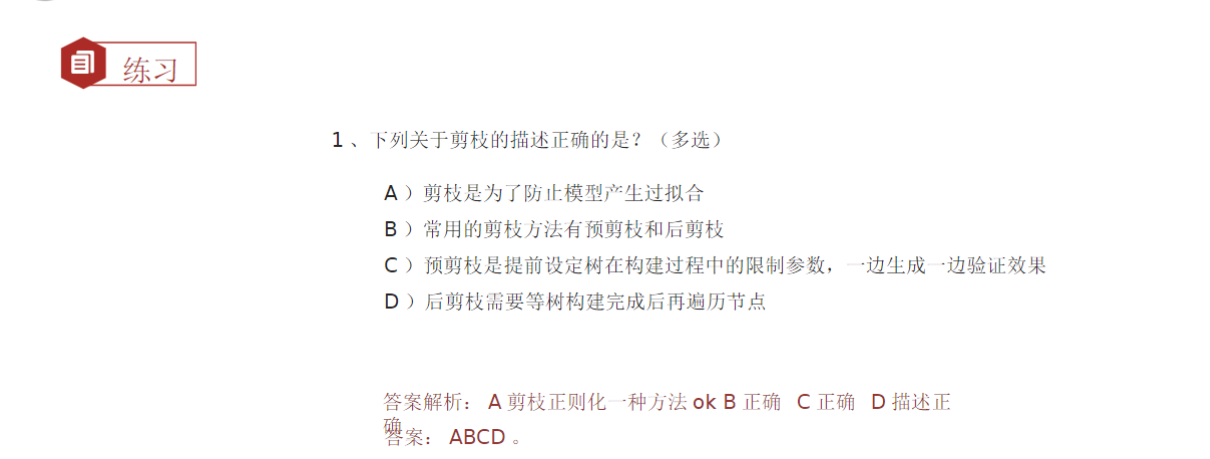
决策树,剪枝
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2401_87118211/article/details/166643552

