

光给指令不够,还得手把手教:Few-shot少样本提示让大模型照猫画虎
前面七篇文章,我们把Function Calling、流式输出这些硬核的代码架构都搭好了。我们的Agent已经能自己查数据库,能并行调用工具,还能把结果总结出来。
但是呢,当你真的把这套东西拿去给老板演示的时候,老板可能还是会皱眉头。为什么?因为大模型给出的分析报告,虽然内容对了,但是格式乱七八糟。有时候它写一大坨散文,有时候它又列一堆干巴巴的数字。老板看得很费劲。
你去质问大模型:“我指令里不是让你‘给出详细分析’吗?你怎么乱写?”
大模型也很委屈。在它看来,“详细分析”这几个字太抽象了。它脑子里有成百上千种详细分析的方法,它不知道你到底想要哪一种。
这就引出了我们今天的话题:提示词工程里最实用的一招,Few-shot少样本提示。这招说白了,就是照猫画虎。你不光要告诉它干什么,你还得给它打个样,让它看看你要的最终成品长什么样。
一、 为什么大模型有时候像个轴子,怎么教都教不会
1.1 回顾一下我们之前写的干瘪指令
我们先回想一下,之前我们在拼Prompt的时候,是怎么写的。
我们在指令里写:“请仔细分析这段数据,找出其中是否存在异常波动的点。如果有,请告诉我异常发生的时间点,以及当时的数值。最后简单分析一下可能的原因。”
这段话你觉得说得很清楚了吧?但大模型的理解跟你的理解,往往是有偏差的。
你眼里的“简单分析一下原因”,可能是想让它列个1234点,每点写一句话。但大模型可能觉得,“简单分析”就是写一段两百字的短文,里面把各种可能性都揉在一起说。
这就叫认知差异。大模型是预训练出来的,它见过互联网上各种各样的文本。它不知道你们公司、你们团队对“分析报告”的定义是什么。它只能按它见过的最主流的方式去写,但那往往不是你要的。
1.2 它没见过你这套业务的真实套路
更麻烦的是,不同业务的时序分析,套路是完全不一样的。
比如做运维的,分析CPU异常,套路就是“看是不是GC -> 看是不是流量打满 -> 看是不是死锁”。做金融的,分析股票异常,套路是“看宏观政策 -> 看资金流向 -> 看技术面背离”。
如果你只给一句“分析原因”,大模型可能拿金融的套路去分析CPU,那得出的结论就是驴唇不对马嘴。
它不是不聪明,它是不知道你这儿的规矩。那你怎么办?你得把规矩具体地展示给它看。
二、 什么是Few-shot,为啥它这么管用
2.1 大白话解释:照猫画虎
Few-shot,翻译过来叫少样本提示。听着挺学术,其实道理土得掉渣。
就跟我们带新员工一样。你如果只跟新人说:“去,写个周报。”新人肯定写出来五花八门。但如果你把自己以前写的一份优秀周报甩给他,说:“照着这个写。”那他写出来的东西,八成就能让你满意。
大模型也是一样。你在提示词里,不光给指令,还给它一两个例子。例子包括:输入的数据长啥样,输出的分析长啥样。
大模型一看例子,瞬间就悟了。哦,原来你要的是这种格式,原来你要的是这种推理逻辑。它照着葫芦画瓢,出来的结果就稳多了。
2.2 Zero-shot、One-shot、Few-shot的区别
在行话里,有这几个词:
- Zero-shot:就是不给例子,只给指令干说。以前我们干的就是这个。
- One-shot:给一个例子。
- Few-shot:给两三个例子。
通常来说,One-shot或者Few-shot的效果是最好的。Zero-shot最容易翻车。给太多例子也不行,一个是费Token,另一个是例子太多模型反而会懵,抓不住重点。
所以在时序分析里,一般给一个到两个极其典型的样例,就足够把大模型的手给教出来了。
三、 在时序分析里怎么构造一个好用的样例
构造样例,是一门手艺。你不能随便拿一段废数据当样例,那会带沟里去。
3.1 样例的输入要长啥样
样例里的输入,必须跟你真实要查的数据格式一模一样。
比如我们之前定义的数据格式是:“时间, 指标名, 数值”。那你的样例输入里,也必须是这种格式。
我们挑一段典型的历史数据。比如上个月发生的一次真实的CPU突刺。
2023-09-15 10:00:00, CPU, 25%
2023-09-15 10:01:00, CPU, 26%
2023-09-15 10:02:00, CPU, 88%
2023-09-15 10:03:00, CPU, 91%
2023-09-15 10:04:00, CPU, 27%
这就叫样例输入。简短,但是包含了典型的异常模式。
3.2 样例的输出必须是你心目中完美的报告格式
这是最核心的。你想要什么样的报告,你就得自己手写一份完美的报告当样例。
如果你想要结构化的列表,你就这么写:
【异常检测报告】
1. 异常时间点:2023-09-15 10:02:00 与 10:03:00
2. 异常指标及数值:CPU使用率分别飙升至88%和91%
3. 关联分析:该时段内存使用率未见明显上升,网络流量正常,初步排除GC和流量冲击。
4. 原因推测:极大可能为某个离线计算任务突发启动占用大量CPU,建议排查定时任务调度日志。
你看这份手写的报告。有明确的标题,有1234的序号,逻辑是从异常点 -> 排除关联项 -> 给出推测。这就是你立的规矩。
大模型以后看到新数据,它就会努力模仿这个结构去写。它写出来的东西,就再也不是一坨散文了。
3.3 别给太长的样例,它记不住也学不像
有一点要注意,样例千万别写太长。
有的朋友一写样例,收不住了,搞了个一千字的报告当例子。这有两个坏处。第一,费Token。每次请求都要把这个例子带上去,成本吃不消。第二,太长了模型抓不住重点。它可能去模仿你的一些废话语气,反而把核心逻辑丢了。
样例要短小精悍。数据有个五六行就行,报告有个五六行就行。只要把格式和推理链条展示清楚,立刻打住。
四、 动手把Few-shot塞进我们的代码里
接下来,我们要把这套样例逻辑,用代码实现出来。
4.1 改造Prompt拼接函数
在OpenAI兼容的API规范里,Few-shot不是直接塞在同一个User消息里的。最佳实践是,把它伪装成历史对话。
也就是说,我们在 messages 列表里,先塞一条虚拟的 user 消息(里面放样例输入),再塞一条虚拟的 assistant 消息(里面放样例输出)。然后才塞用户真实的 user 消息。
大模型一看前面的对话历史,它就以为之前你们已经成功合作过一次了。它会顺着之前的惯性,继续往下干。
我们写个函数把这些拼起来:
def build_few_shot_prompt(real_data_text):
    # --- 构造样例输入 ---
    example_input = """
2023-09-15 10:00:00, CPU, 25%
2023-09-15 10:01:00, CPU, 26%
2023-09-15 10:02:00, CPU, 88%
2023-09-15 10:03:00, CPU, 91%
2023-09-15 10:04:00, CPU, 27%
"""

    # --- 构造样例输出(你手写的完美报告) ---
    example_output = """
【异常检测报告】
1. 异常时间点:2023-09-15 10:02:00 与 10:03:00
2. 异常指标及数值:CPU使用率分别飙升至88%和91%
3. 关联分析:该时段无其他指标数据,无法做交叉对比。
4. 原因推测:短时突刺一般为后台单次重计算任务触发,建议排查应用日志。
"""

    # --- 拼装Messages列表 ---
    messages = [
        # 第一轮:样例提问
        {
            "role": "user",
            "content": f"请分析以下时序数据:\n{example_input}"
        },
        # 第一轮:样例回答
        {
            "role": "assistant",
            "content": example_output
        },
        # 第二轮:真实的提问
        {
            "role": "user",
            "content": f"请按照刚才的格式,分析以下新的时序数据:\n{real_data_text}"
        }
    ]

    return messages
你看这个 messages 列表。里面有三条记录。前两条就是我们的猫,第三条是我们要画的虎。
在真实的提问里,我特意加了一句“请按照刚才的格式”,这相当于一个强提示,把大模型的注意力拉回到样例上,防止它跑偏。
4.2 完整代码演示与逐行解读
我们把主流程稍微改一下,用这个新的拼装函数。
import requests

# 假设 api_key 和 real_data 都已经准备好了

def ask_with_few_shot(messages_list, api_key):
    url = "https://ai.timecho.com/v1/chat/completions"
    headers = {
        "Content-Type": "application/json",
        "Authorization": f"Bearer {api_key}"
    }
    payload = {
        "model": "timecho-model",
        "messages": messages_list  # 直接把拼好的messages塞进去
    }

    response = requests.post(url, headers=headers, json=payload, timeout=30)
    result = response.json()
    return result['choices'][0]['message']['content']

if __name__ == "__main__":
    # 假设这是我们刚从数据库查出来的真实数据
    my_real_data = """
2023-10-25 10:00:00, CPU, 22%
2023-10-25 10:01:00, CPU, 24%
2023-10-25 10:02:00, CPU, 89%
2023-10-25 10:03:00, CPU, 92%
2023-10-25 10:04:00, CPU, 21%
"""

    # 1. 拼装带Few-shot的Messages
    my_messages = build_few_shot_prompt(my_real_data)

    # 2. 发请求
    print("正在请求大模型(带Few-shot示范)...")
    final_answer = ask_with_few_shot(my_messages, my_key)

    print("\n=== 大模型的分析报告 ===")
    print(final_answer)
这段代码跑起来,你就能看到威力了。大模型不再是随便乱发挥了。它就像一个刚被你手把手教过的实习生,出来的东西规规矩矩,完全符合你的预期。
五、 跑一下看看,格式是不是瞬间规整了
5.1 没给样例时的乱糟糟输出
为了对比,你可以把前面那个 messages 列表里的样例删掉,只留真实的提问,再跑一次。
你会发现,大模型可能给你回这样的东西:
“经过分析,我发现数据在10:02和10:03出现了异常,数值达到了89%和92%。这种情况通常是突发任务导致的,建议去查日志。”
话是没错,但是没条理。老板看着累。如果老板要把这段话贴到周报里,他还得自己重新排版。
5.2 给了样例后的整齐划一
加上Few-shot之后,大模型出来的东西大概率是这样的:
“【异常检测报告】
- 异常时间点:2023-10-25 10:02:00 与 10:03:00
- 异常指标及数值:CPU使用率分别飙升至89%和92%
- 关联分析:该时段无其他指标数据,无法做交叉对比。
- 原因推测:短时突刺一般为后台单次重计算任务触发,建议排查应用日志。”
你看,标题有了,序号有了,逻辑链条跟你的样例一模一样。这就是照猫画虎的成功案例。你拿这个给老板,老板直接复制粘贴进周报,完事。
这省下来的沟通成本和时间,全是你通过写Few-shot换来的。
六、 Few-shot的进阶坑:样例选得不好反而带沟里去
6.1 样例里的逻辑有错误
Few-shot威力大,但它也是把双刃剑。你给的样例如果是有毛病的,大模型会把毛病也学过去。
比如你在样例的推理里写了:“CPU高是因为内存泄漏”。但实际上你给的那段样例数据里,内存根本没数据。这就是一个逻辑硬伤。
大模型看不懂这是硬伤,它只会觉得“哦,你要这么推理”。等它拿到真实数据,就算真实数据里内存是正常的,它可能也会硬扯一句“可能是内存泄漏”。
所以,你手写样例的时候,一定要严谨。推理链条必须闭环,必须经得起推敲。别为了凑格式瞎写一气。你给个烂样例,还不如不给。
6.2 样例和真实问题类型不匹配
还有一种情况。你的样例是CPU突刺的,你让它分析CPU,效果很好。
结果有一天,你把内存的数据丢进去了。内存的数据不是突刺,它是缓慢上涨的。大模型因为被样例框住了,它可能还硬去套那个“找突刺”的逻辑,告诉你“没有发现异常”,或者瞎指个点说那是突刺。
这就是过拟合。样例太死板了。
怎么解决呢?你可以给两个样例。一个样例是突刺型的,一个样例是缓慢上涨型的。大模型见多了,它就知道要灵活处理了。这就是Few-shot(多个样例)比One-shot(单个样例)更稳的地方。当然,Token也会相应增加,这是个权衡。
七、 去官方 playground 和文档里试试水
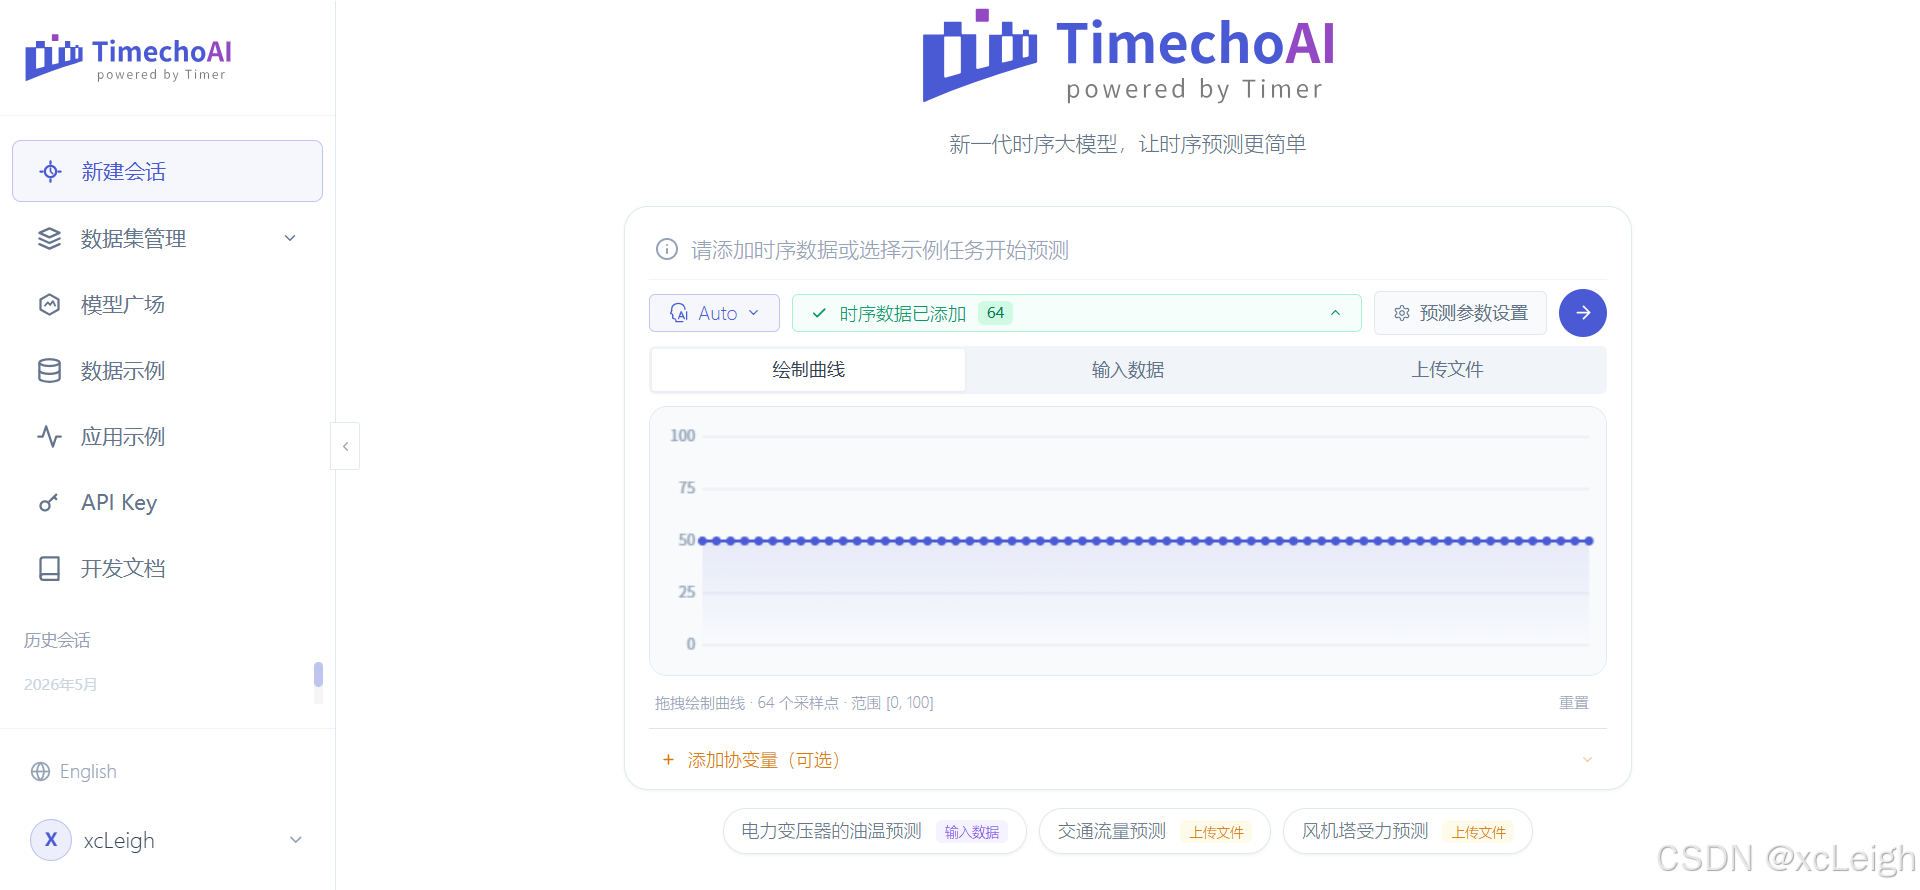
7.1 在网页端手动敲样例测试
调教Few-shot,最方便的地方不是在代码里。代码里改一次跑一次太慢了。最方便的是直接去官方的示例页面:https://ai.timecho.com/realtime
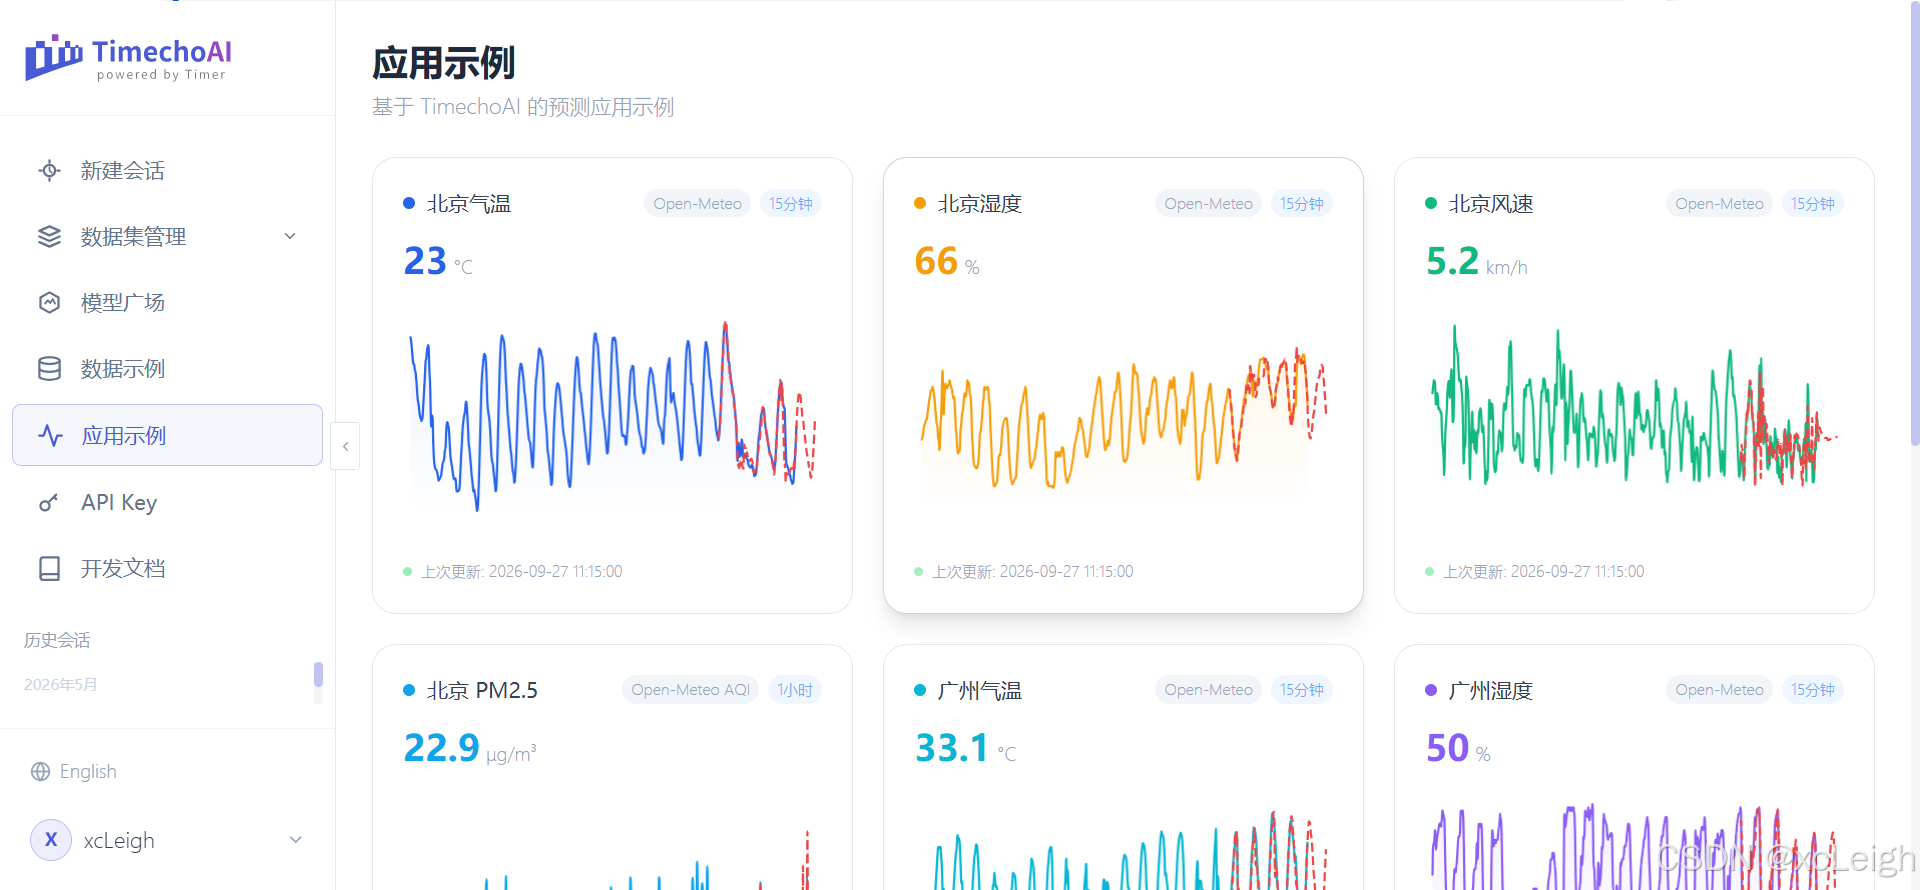
你在那个聊天框里,先输一段样例数据,然后自己扮演助手输一段样例报告(当然网页端可能不支持你假装助手发话,那你只能把样例和真实数据拼在一个大输入框里给过去看效果)。
多试几种写法。看看大模型对哪种格式的模仿度最高。等你在网页上把提示词和样例调得特别稳了,再搬到代码里去。这叫先验证后开发,效率最高。
7.2 查查文档有没有System Prompt的最佳实践
另外,去开发文档 https://ai.timecho.com/docs/ 里翻一翻。
有些模型对System Prompt(系统提示词)特别敏感。你可以把立规矩的话,比如“你是一个严谨的运维工程师,必须按1234列表输出报告”,放在 role: "system" 的消息里。
这种系统级的指令,加上Few-shot的样例,双管齐下,大模型就彻底被你拿捏了。它就像戴了紧箍咒的孙悟空,再怎么折腾,也出不了你画的圈。
八、 总结与下期预告
8.1 提示词工程是门手艺活,得攒家当
今天我们聊了Few-shot。这东西看着简单,就是给个例子嘛。但实际上,这是大模型应用里性价比最高的一招。
很多复杂的问题,你调半天参数,换几个模型,都不如贴一个好样例管用。
这其实也是在告诉我们,做AI应用开发,你手里得攒家当。你平时遇到的好的分析案例,老板表扬过的报告,都得存下来。这些都是你最宝贵的Few-shot样例库。等样例库丰富了,你的Agent就显得特别专业,别人用你的系统,就觉得这AI真聪明。其实聪明的是你藏在提示词里的那些套路。
8.2 下期讲讲:怎么用System Prompt立规矩,让大模型更听话
今天我们把样例塞在了历史对话里。这招管用,但是稍微有点笨。因为每次请求都要带一大段样例,费Token。
其实在API里,还有一种更优雅的方式来做这事。那就是利用System Prompt。系统提示词就像是给大模型设定的底层人设和不可逾越的红线。
下一期,我们就来深挖一下System Prompt的玩法。看看怎么用系统提示词,把大模型的性格和输出风格给死死焊住。我们下篇见。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_43151418/article/details/166734642

