

一、为什么需要统一推理层
1.1 框架与芯片的"排列组合地狱"
设想你手里有 5 种模型格式(TFLite、ONNX、SNPE 的 DLC、QNN 的二进制、RKNN……),又有 2 类主流 NPU 平台(高通、瑞芯微)。如果每种组合都写一套推理代码,你面对的是** 5 × 2 = 10 套**维护成本。更要命的是,每套的 API、内存布局、预处理约定都不一样,换模型或换板就是一次"重写"。这正是端侧 AI 落地最劝退的地方。
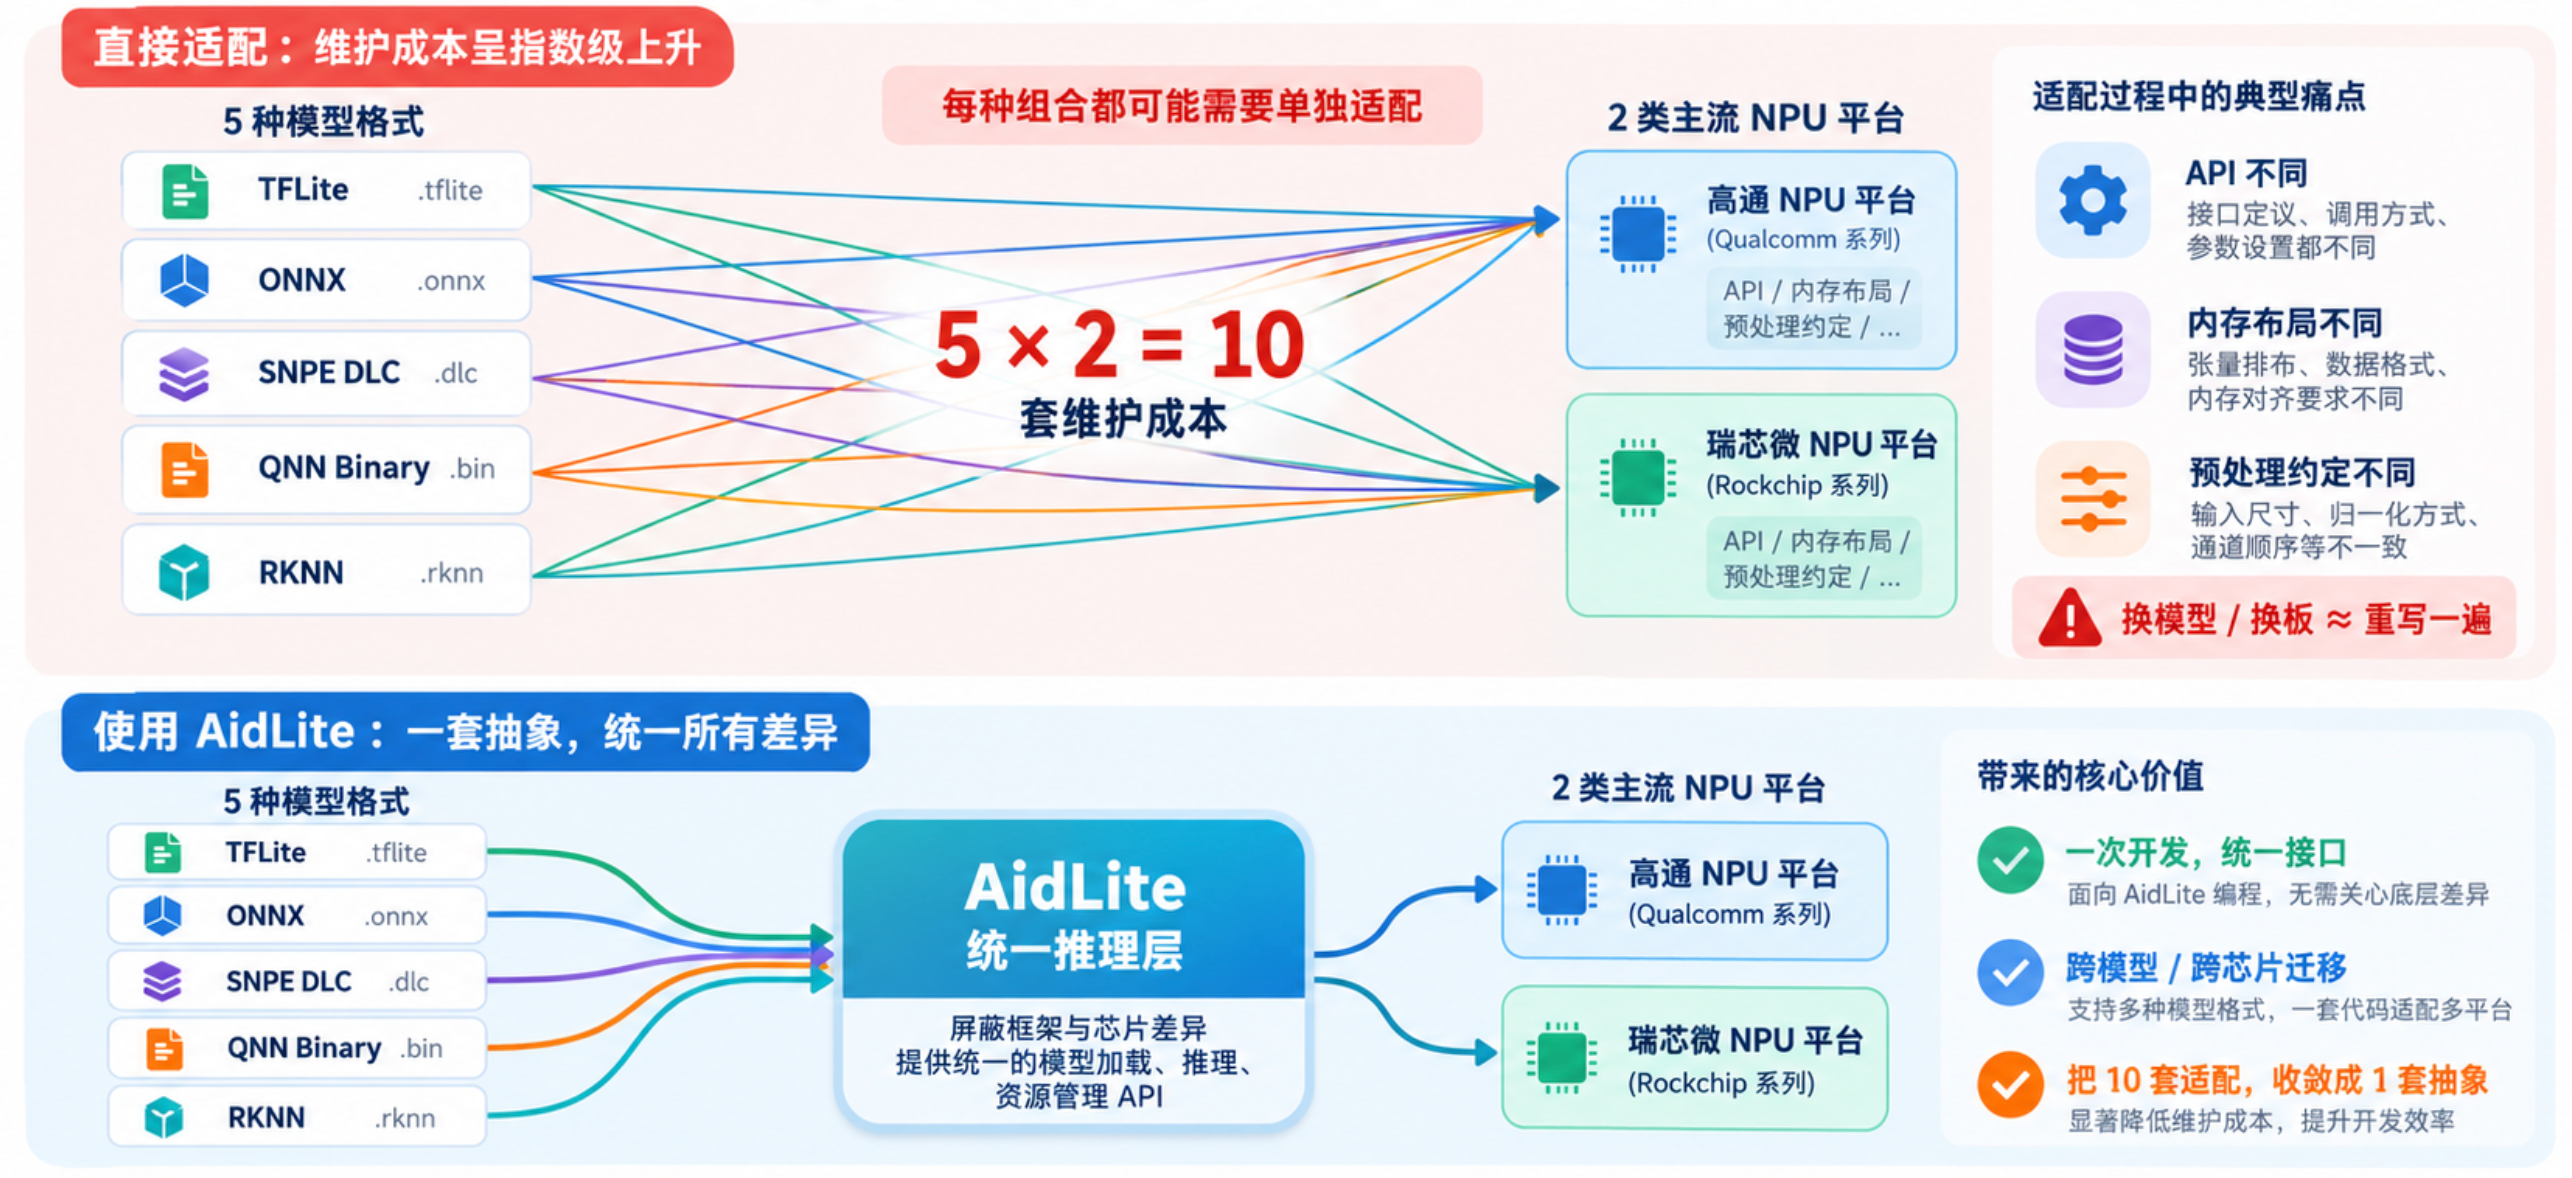
AidLite 解决的就是这道排列组合题。
1.2 AidLite 的解法:一次开发,跨模型/跨芯片
AidLite 是阿加犀推出的 AI 执行框架,目标是充分调度端侧芯片的各计算单元(CPU、GPU、NPU)实现 AI 模型推理加速。它的核心做了两件事:
- 跨平台统一推理:针对不同 AI 框架和不同 AI 芯片的调用进行抽象,形成统一 API,让模型推理与底层技术解耦合。
- 可迁移:开发者只需进行一次开发,即可任意更换不同格式的模型或在不同厂商 AI 芯片上实现迁移,大幅降低学习成本、平台迁移难度和成本。
一句话:写一次,换模型不慌、换芯片也不慌。
1.3 本讲目标与硬件准备
目标:在犀牛派 A1 上,用 AidLite 把官方预置的 YOLOv5 例子跑起来,输出一张带检测框的结果图,并理解背后每个 API 的角色。
硬件准备:完成第 01 讲环境的犀牛派 A1(或 X1),aid-pkg installed 能看到 aidlite,Python 自检脚本通过。本文以入门级的犀牛派 A1 实跑 YOLOv5,进阶级的犀牛派 X1 给出预期差异;代码以 Python 为主,C++ 片段作对照(AidLite 对两者都支持)。
二、AidLite 架构与抽象模型
2.1 它处在工具链的什么位置
AidLite 是整个 AidLux 工具链的"发动机":AidStream(视频)、AidCV(图像)、AidGen(大模型)都直接或间接建立在它的调度能力之上。架构位置如下:
2.2 核心抽象:Model / Config / Interpreter
AidLite 的推理流程围绕三个核心对象展开:
- Model:模型实例,承载模型文件路径与输入/输出 shape、数据类型等属性;
- Config:推理配置,决定用哪个框架、哪个加速后端、是否量化、输出节点名等;
- Interpreter:真正执行推理的解释器,由
InterpreterBuilder根据 Model+Config 构建,负责 init、load、invoke、取输出、销毁。
这三个对象的生命周期,就是 AidLite 的"标准动作序列"。
2.3 支持的框架矩阵
AidLite 在 Linux 与 Android 两端都做了广泛适配(AidLux 官方文档支持矩阵):
| 推理框架 | AidLite for Linux | AidLite for Android |
|---|---|---|
| 高通 SNPE | ✅ | ✅ |
| 高通 QNN | ✅ | ✅ |
| 瑞芯微 RKNN | ✅ | ✅ |
| TFLite | ✅ | ✅ |
| ONNX | ✅ | ✅ |
| Paddle-Lite | ✅ | ✅ |
| MNN | ✅ | ✅ |
| MindSpore | ✅ | ✅ |
2.4 支持的芯片与计算单元
- 芯片厂商 NPU:高通 NPU、瑞芯微 NPU;
- 计算单元:CPU、GPU、NPU,由
AccelerateType选择; - 零拷贝:支持 CPU 与 NPU 之间的数据零拷贝,获得更快的推理速度。这是 AidLite 相比"裸调框架"的隐形红利。
三、核心概念拆解
3.1 FrameworkType 与 AccelerateType
- FrameworkType(用哪个推理框架):
TYPE_SNPE、TYPE_QNN、TYPE_RKNN、TYPE_TFLITE等。 - AccelerateType(用哪个计算单元加速):如
TYPE_CPU、TYPE_DSP(DSP 即高通 NPU 的加速路径)等。
常见组合:
| 你想做的事 | FrameworkType | AccelerateType |
|---|---|---|
| 高通 NPU 跑 QNN 模型 | TYPE_QNN | TYPE_DSP |
| 高通 NPU 跑 SNPE 模型 | TYPE_SNPE | TYPE_DSP |
| 纯 CPU 兜底 | TYPE_TFLITE / TYPE_QNN | TYPE_CPU |
3.2 DataType 与 shape
- DataType:
TYPE_FLOAT32、TYPE_UINT8(量化)等; - shape:输入/输出的维度,例如
[1, 320, 320, 3](NHWC)。必须用set_model_properties显式声明,填错会直接导致推理异常(见坑点)。
3.3 APLUX Model Format(*.amf)
AidLite 支持阿加犀专属模型格式 APLUX Model Format(*.amf)。这是阿加犀在统一框架之上的自有封装,便于在 AidLux 生态内分发与加载。同时 AidLite 也直接兼容上述各框架原生格式。
3.4 零拷贝:CPU↔NPU 的加速秘密
传统流程里,数据从 CPU 内存搬到 NPU 专用内存要一次拷贝,推理完再搬回来,又一次拷贝。AidLite 支持 CPU 与 NPU 之间的数据零拷贝,省掉这两趟搬运,对高分辨率、高帧率场景的端到端时延帮助明显。
3.5 模型属性读取
AidLite 支持读取模型属性信息,如输入格式、输出格式。这在你拿到一个陌生的 .amf/.dlc/.rknn 模型、不确定 shape 时尤其有用——先读属性,再决定怎么填 set_model_properties。
3.6 后端决策:NPU / GPU / CPU 怎么选
新手最常问:“我到底该用哪个 AccelerateType?” 没有一个永远正确的答案,但有清晰的决策逻辑(基于 AidLite 的调度能力与各单元特性):
经验法则:
- 量化模型(INT8/UINT8)优先上 NPU:这是端侧性价比最高的路径,也是 AidLite 主推用法;AIMO 量化正是为此服务(第 04 讲)。
- 浮点模型且要实时:可尝试 GPU 加速;部分算子 NPU 不支持时,GPU 是更稳的落点。
- CPU 兜底:兼容性最好,适合验证流程、跑不支持的算子,或作为 NPU 不可用时的降级。
- 不要让 NPU 空转:一旦决定用 NPU,就尽量把前/后处理以外的重计算都交给它,避免"模型在 NPU、周边在 CPU"的半吊子。
提醒:具体哪个后端最快,以你真机实测为准。上面的决策树是起点,不是结论。
3.7 数据布局:NHWC 还是 NCHW(最容易踩的隐性坑)
最后讲一个看似小事、却能让新手调试半天的坑:数据布局。AidLite 默认使用 NHWC 布局(批次、高、宽、通道),而你从 PyTorch 导出的模型在训练时往往是 NCHW(通道在前)。如果直接把 NCHW 的数组塞进去,形状对得上(因为都是四维),但通道顺序错了,推理结果会完全错乱,而且不会报错——这是最阴险的一类 bug。
正确的做法是前处理时显式转布局,把通道调到最后一维再喂给 set_input_tensor。很多"模型跑通了但精度奇差"的案例,根因就是这一步。建议你在前处理里固定一处做布局转换,并在注释里写清楚,避免后续维护的人再踩一遍。
四、环境调研:安装与版本对齐
4.1 预装验证
犀牛派 A1/X1 预装 AidLux SDK,可跳过安装。先验证:
python3 -c "import aidlite; print(aidlite.get_library_version())"
python3 -c "import aidlite; print(aidlite.get_py_library_version())"
两条都能打印出版本号,说明 Python 绑定就绪。
4.2 安装指定 QNN 版本
如需特定 QNN 版本(这很关键,见 4.3):
sudo aid-pkg update
# 安装最新 QNN 版 AidLite
sudo aid-pkg install aidlite
# 安装指定 QNN 版本,例如 QNN2.31
sudo aid-pkg install aidlite-qnn231
文档示例:sudo aid-pkg install aidlite-{QNN Version},如 aidlite-qnn216。
4.3 版本错配的代价
这是全系列最高频的坑:你用 AIMO 把模型转成了 QNN2.31,但板子上 AidLite 是 QNN2.36,推理就可能加载失败或结果异常。所以每讲实战前,务必 sudo aid-pkg installed 对齐 QNN 版本与转换时一致。
五、操作步骤:YOLOv5 推理五步法
5.1 准备模型与示例
AidLite 在 Linux 环境中预置了 YOLOv5 例子,路径位于 /usr/local/share/aidlite/examples/。复制出来再改,避免污染预置目录:
mkdir -p /home/aidlux/aidlite_demo/
cp -r /usr/local/share/aidlite/examples/ /home/aidlux/aidlite_demo/
cd /home/aidlux/aidlite_demo/aidlite_qnn231/python
注:目录名
aidlite_qnn231表明这是 QNN2.31 版本示例;若你装的是其他 QNN 版本,请对应调整。
5.2 建 Model 实例与属性
model = aidlite.Model.create_instance(model_path)
input_shapes  = [[1, 320, 320, 3]]
output_shapes = [[1, 10, 10, 255], [1, 20, 20, 255], [1, 40, 40, 255]]
model.set_model_properties(
    input_shapes, aidlite.DataType.TYPE_FLOAT32,
    output_shapes, aidlite.DataType.TYPE_FLOAT32
)
5.3 建 Config 选后端
config = aidlite.Config.create_instance()
config.framework_type = aidlite.FrameworkType.TYPE_QNN      # 用 QNN 框架
config.accelerate_type = aidlite.AccelerateType.TYPE_DSP    # 用 NPU(DSP) 加速
config.is_quantify_model = 1                                # 量化模型
# 若用 SNPE,需要指定输出节点名:
# config.framework_type = aidlite.FrameworkType.TYPE_SNPE
# config.snpe_out_names = ["InceptionV3/Predictions/Softmax"]
5.4 建 Interpreter 并 init/load
fast_interpreter = aidlite.InterpreterBuilder.build_interpreter_from_model_and_config(model, config)
fast_interpreter.init()
fast_interpreter.load_model()
5.5 set_input / invoke / get_output
input_tensor_data = preprocess()          # 前处理:resize/归一化/NHWC
fast_interpreter.set_input_tensor(0, input_tensor_data)
fast_interpreter.invoke()
out_data = fast_interpreter.get_output_tensor(0)
result = postprocess(out_data)            # 后处理:NMS/解码框
fast_interpreter.destroy()                # 释放资源
这五步(建 Model → 建 Config → 建 Interpreter → init/load → 输入输出)就是 AidLite 的"标准动作"。
六、关键代码(Python 为主,C++ 对照)
6.1 Python 完整推理骨架
下面给出一个可运行的精简骨架(结构来自官方示例,已补充注释):
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
AidLite YOLOv5 推理骨架(犀牛派 A1 / X1 通用)
"""
import aidlite

def preprocess():
    """前处理:读取图片 -> resize 到 320x320 -> 归一化 -> NHWC float32
    实际项目请用 AidCV/OpenCV 读取,这里仅示意返回占位张量"""
    raise NotImplementedError("请替换为真实前处理")

def postprocess(out):
    """后处理:对 YOLO 输出做解码 + NMS,返回检测框列表"""
    raise NotImplementedError("请替换为真实后处理")

def run_yolov5(model_path: str):
    # 1) 建 Model
    model = aidlite.Model.create_instance(model_path)
    if model is None:
        print("Create model failed !"); return False
    input_shapes  = [[1, 320, 320, 3]]
    output_shapes = [[1, 10, 10, 255], [1, 20, 20, 255], [1, 40, 40, 255]]
    model.set_model_properties(
        input_shapes, aidlite.DataType.TYPE_FLOAT32,
        output_shapes, aidlite.DataType.TYPE_FLOAT32
    )
    # 2) 建 Config(QNN + NPU)
    config = aidlite.Config.create_instance()
    config.framework_type  = aidlite.FrameworkType.TYPE_QNN
    config.accelerate_type = aidlite.AccelerateType.TYPE_DSP
    config.is_quantify_model = 1
    # 3) 建 Interpreter
    interp = aidlite.InterpreterBuilder.build_interpreter_from_model_and_config(model, config)
    if interp is None:
        print("build interpreter failed !"); return False
    if interp.init() != 0:
        print("init failed !"); return False
    if interp.load_model() != 0:
        print("load model failed !"); return False
    # 4) 推理:前处理 + invoke + 后处理
    inp = preprocess()
    if interp.set_input_tensor(0, inp) != 0:
        print("set_input_tensor failed !"); return False
    if interp.invoke() != 0:
        print("invoke failed !"); return False
    out = interp.get_output_tensor(0)
    if out is None:
        print("get_output_tensor failed !"); return False
    detections = postprocess(out)
    # 5) 释放
    interp.destroy()
    return detections

if __name__ == "__main__":
    # 替换为实际模型路径(.amf / .dlc / .rknn 等,需与 QNN 版本一致)
    dets = run_yolov5("/home/aidlux/aidlite_demo/aidlite_qnn231/python/yolov5s.amf")
    print("检测结果:", dets)
6.2 前处理/后处理片段
import cv2
import numpy as np

def preprocess(img_path, size=320):
    img = cv2.imread(img_path)
    img = cv2.resize(img, (size, size))
    img = img.astype("float32") / 255.0          # 归一化到 [0,1]
    return np.expand_dims(img, axis=0)            # 扩成 NHWC: [1,320,320,3]

def postprocess(outputs, conf_th=0.25, iou_th=0.45):
    # YOLO 输出解码 + NMS(示意,具体需按模型 anchor/后处理约定实现)
    boxes = []
    for out in outputs:
        # 解析 255 通道 = 3 anchor * (5 + 80 class)
        pass
    return boxes
提示:官方示例里已经包含完整前后处理,建议直接复用官方 qnn_yolov5_multi.py,再在其上做二次开发,避免重复造轮子。
6.3 C++ 对照(进阶参考)
AidLite 同样提供 C++ 接口,头文件路径 /usr/local/include/aidlux/aidlite/aidlite.hpp,库文件 /usr/local/lib/libaidlite.so。核心对象同名:Model、Config、InterpreterBuilder、Interpreter,调用顺序与 Python 一致。C++ 在延迟与内存控制上更优,适合对性能极致要求的量产场景;本系列以 Python 快速验证,再按需转 C++。
6.4 在犀牛派 A1 上跑 YOLOv5
cd /home/aidlux/aidlite_demo/aidlite_qnn231/python
python qnn_yolov5_multi.py
官方示例运行完成会在当前目录生成结果图片 qnn_yolov5_multi.jpg。用文件浏览器(默认 /home/aidlux)即可查看检测框结果。
6.5 犀牛派 X1 上的差异与预期
在犀牛派 X1(QCS8550)上,同样的 AidLite 代码、同样的 QNN 模型,几乎无需修改即可运行(一次开发、跨芯片迁移)。预期差异:
- 单帧推理时延显著更低(NPU 算力更高);
- 可上更大输入分辨率或更复杂模型;
- 多路并发推理时优势更明显(后面第 06、11 讲会用到)。
这正是"高低搭配"的底气:先 A1 把流程跑通,再 X1 把性能拉满。
6.6 YOLO 后处理实战:解码 + NMS 思路
骨架里 postprocess 是占位,这里把"它到底要做什么"讲清楚,方便你照着官方示例补全(不要从零造轮子,先读懂官方 qnn_yolov5_multi.py 的后处理)。
YOLO 系列的输出是"网格 + 多 anchor"的预测,解码步骤(通用 YOLO 范式):
- 解析输出张量:以
output_shapes = [[1,10,10,255],[1,20,20,255],[1,40,40,255]]为例,255 = 3 个 anchor × (5 个框参数 + 80 类)。三个尺度分别解码。 - 还原框坐标:把网格偏移、anchor 先验、sigmoid 还原成相对于原图的
(x,y,w,h)。 - 置信度过滤:框置信度 × 类别概率低于阈值(如 0.25)的丢弃。
- 非极大值抑制(NMS):同类别重叠框按 IoU(如 0.45)去重,保留得分最高的。
伪代码:
def decode_and_nms(raw_outputs, anchors, conf_th=0.25, iou_th=0.45):
    candidates = []                      # 收集所有合格框
    for scale, out in zip(anchors, raw_outputs):
        # out: [1, H, W, 3*(5+80)]
        # 1) 拆 anchor,sigmoid 还原
        # 2) 网格 + anchor 还原到原图坐标
        # 3) 按 conf_th 过滤,并入 candidates
        pass                            # 详见官方示例实现
    # NMS:按类别分组,IoU 抑制
    return nms(candidates, iou_th)
关键提醒:不同 YOLO 版本(v5/v8)的 anchor 约定、输出排序不同,必须对齐你所用模型的约定,否则框会错位。这也是为什么反复强调"先复用官方示例"。
6.7 三种推理范式:单图 / 视频流 / 批量
AidLite 的同一套 API 能覆盖三种典型用法:
- 单图推理:本讲示例,适合验证与离线处理;
- 视频流推理:在循环里反复
set_input/invoke/get_output,配合 AidCV(第 05 讲)取帧、AidStream(第 06 讲)取 RTSP 帧; - 批量推理:若模型支持 batch>1,一次喂多张图提升吞吐(注意 shape 第一维改 batch)。
理解这三者的关系,你就能把"跑通一个"平滑升级为"跑通一条流水线"。
6.8 推理结果的常见异常与排查
写完推理代码,最常遇到的几类"诡异现象"及根因:
- 结果全 0 或全相同:九成是 shape 填错、数据未归一化、或布局不对(见 3.7);
- 结果随机漂移:多半是前处理每次不一致,或输入数据没拷贝进 tensor;
- 偶发崩溃:常因
destroy没调用导致资源泄漏,或多线程共享同一个 interpreter; - 精度明显低于云端:量化损失 + 前处理差异叠加,需要回到 AIMO 校准数据和预处理一致性上查。
排查的顺序建议是:先用官方示例验证环境(排除板子问题)→ 再打印你的输入张量统计(均值/方差是否正常)→ 再核对 shape 与布局 → 最后看后处理。从环境到输入到输出逐段隔离,比盲目改代码高效得多。
七、坑点
7.1 QNN 版本必须一致(最高频)
转换模型时的 QNN 版本(如 2.31)必须等于板载 AidLite 的 QNN 版本。用 sudo aid-pkg installed 核对,不一致就 sudo aid-pkg install aidlite-qnn231 对齐。
7.2 input/output shape 填错
set_model_properties 的 shape 必须与模型真实输入输出一致(NHWC)。填错会推理报错或输出全 0。不确定时先用 AidLite 的模型属性读取接口确认。
7.3 NPU 权限与占用
NPU 可能被其他进程占用(如前一个没 destroy 的 interpreter)。确保资源释放,必要时重启相关服务。多进程抢 NPU 是后面综合实战要专门处理的课题。
7.4 snpe_out_names 漏配
用 SNPE 框架时,若不指定 snpe_out_names(输出节点名),可能取到错误/多余的张量。QNN 路径一般无需此项,但切换到 SNPE 时务必补上。
八、验证:结果图与耗时
8.1 结果图比对
运行示例后,打开 qnn_yolov5_multi.jpg,应能看到目标被框出并标注类别。若图为空或框错,回到第 7 节逐条排查。
8.2 端到端耗时测量
在骨架里加计时:
import time
t0 = time.time()
interp.invoke()
print(f"invoke 耗时: {(time.time()-t0)*1000:.1f} ms")
记录 A1 上的单帧耗时作为基线,第 12 讲性能调优时会回头对比。
8.3 A1 vs X1 预期差异
| 指标 | 犀牛派 A1(QCS6490) | 犀牛派 X1(QCS8550) |
|---|---|---|
| NPU 算力(INT8) | 约 12 TOPS | 显著更高 |
| 同模型单帧时延 | 基线 | 更优(以实测为准) |
| 多路并发 | 受限 | 从容(以实测为准) |
精确数字请在你自己的真机上实测;表中量级参考高通公开资料。
8.4 写一个标准基准测试循环
为了拿到可靠的"单帧时延"基线,不要只测一次,而要跑 N 次取统计。下面给出一个可直接套用的基准循环(结构示意,需接入你真实的 interp 与前/后处理):
import time
import numpy as np

def benchmark(interp, prep_fn, post_fn, img_paths, warmup=10, repeat=100):
    # 1) 预热:让 NPU 完成初始化与首次编译开销
    for i in range(warmup):
        inp = prep_fn(img_paths[i % len(img_paths)])
        interp.set_input_tensor(0, inp)
        interp.invoke()
        post_fn(interp.get_output_tensor(0))
    # 2) 正式计时
    lat = []
    for i in range(repeat):
        inp = prep_fn(img_paths[i % len(img_paths)])
        t0 = time.perf_counter()
        interp.set_input_tensor(0, inp)
        interp.invoke()
        out = interp.get_output_tensor(0)
        post_fn(out)
        lat.append((time.perf_counter() - t0) * 1000.0)
    arr = np.array(lat)
    print(f"预热 {warmup} 次, 正式 {repeat} 次")
    print(f"均值: {arr.mean():.2f} ms | P50: {np.percentile(arr,50):.2f} ms | "
          f"P95: {np.percentile(arr,95):.2f} ms | 最大: {arr.max():.2f} ms")
    print(f"等效吞吐: {1000.0/arr.mean():.1f} FPS")
    return arr

# 用法(伪):benchmark(interp, preprocess, postprocess, image_list)
要点:
- 必须预热:首次
invoke含 NPU 图编译/缓存,时延会虚高;warmup 10~20 次后再计时才准。 - 看 P95 而非只盯均值:真实应用的卡顿往往由长尾决定。
- 前/后处理计入吗? 若要端到端时延,应把
prep_fn/post_fn一并计时;若只想看 NPU 推理,则只计invoke。两者分开测,心里更有数。
这份基线会在第 12 讲"性能调优"时作为对照,用来量化你优化手段的真实收益。
九、FAQ
Q1:AidLite 和直接用 SNPE/QNN 有什么区别?
AidLite 在 SNPE/QNN/RKNN/TFLite 之上做了统一抽象,让你换框架/换芯片时不重写业务代码;直接用厂商框架则耦合更深。
Q2:Python 和 C++ 选哪个?
快速验证、教学用 Python;量产追求极致延迟/内存用 C++。本系列以 Python 为主。
Q3:*.amf 和 .dlc/.rknn 能混用吗?
AidLite 统一加载,但前提是 FrameworkType 选对,且 QNN 版本与转换时一致。
Q4:零拷贝怎么用?
AidLite 已内置 CPU↔NPU 零拷贝能力,正常流程即可受益,无需额外调用。
Q5:为什么我的 invoke 很慢,是不是没上 NPU?
先确认 accelerate_type 确实是 TYPE_DSP(NPU)而非 TYPE_CPU;再用 aid-pkg installed 核对 QNN 版本;最后用计时看 invoke 与 set_input_tensor 各自占比,定位是搬运还是计算慢。
Q6:同一份代码在 X1 上跑报错怎么办?
多为 QNN 版本不一致或模型未对应 X1 的 NPU backend。AIMO 转换时选对目标平台(QCS8550),并在 X1 上装对应 aidlite-qnn{ver}。
Q7:输出张量取出来是 None 是什么原因?
常见三种:shape 填错导致推理异常、输出索引取错(多输出模型要用正确的 get_output_tensor(i))、或 invoke 返回非 0。逐条排查即可。
Q8:能不能同时跑两个模型抢 NPU?
可以,但 NPU 算力会被分摊,且需注意资源释放。多模型/多路场景建议用 AidStream 的插件式管线或自己做好调度,第 11、12 讲会展开。
十、结论
本讲我们钻进了工具链的发动机 AidLite:理解了它如何用 Model/Config/Interpreter 三件套把"框架 × 芯片"的复杂度收拢成一套 API,跑通了犀牛派 A1 上的第一个 YOLOv5 检测,并埋下了"高低搭配"的伏笔——同一份代码,X1 上几乎免改即可获得更高算力。
下一讲,我们深入 AidLite 的"可迁移性":同一份骨架如何切换 SNPE/QNN/RKNN/TFLite 后端,以及如何对接 Model Farm 现成模型。那是把"能跑一个"升级为"能跑一片"的关键一跃。
本文 AidLite API 名称、支持矩阵、示例路径、零拷贝、*.amf 等均来自 AidLux 官方文档;板级算力与跨板时延参考高通公开资料,精确值以官方规格书与真机实测为准。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/HuiMinHuang2001/article/details/167036584

