

💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
网站实战项目
安卓/小程序实战项目
大数据实战项目
深度学校实战项目
计算机毕业设计选题推荐
目录
基于大数据的酒店数据分析与可视化介绍
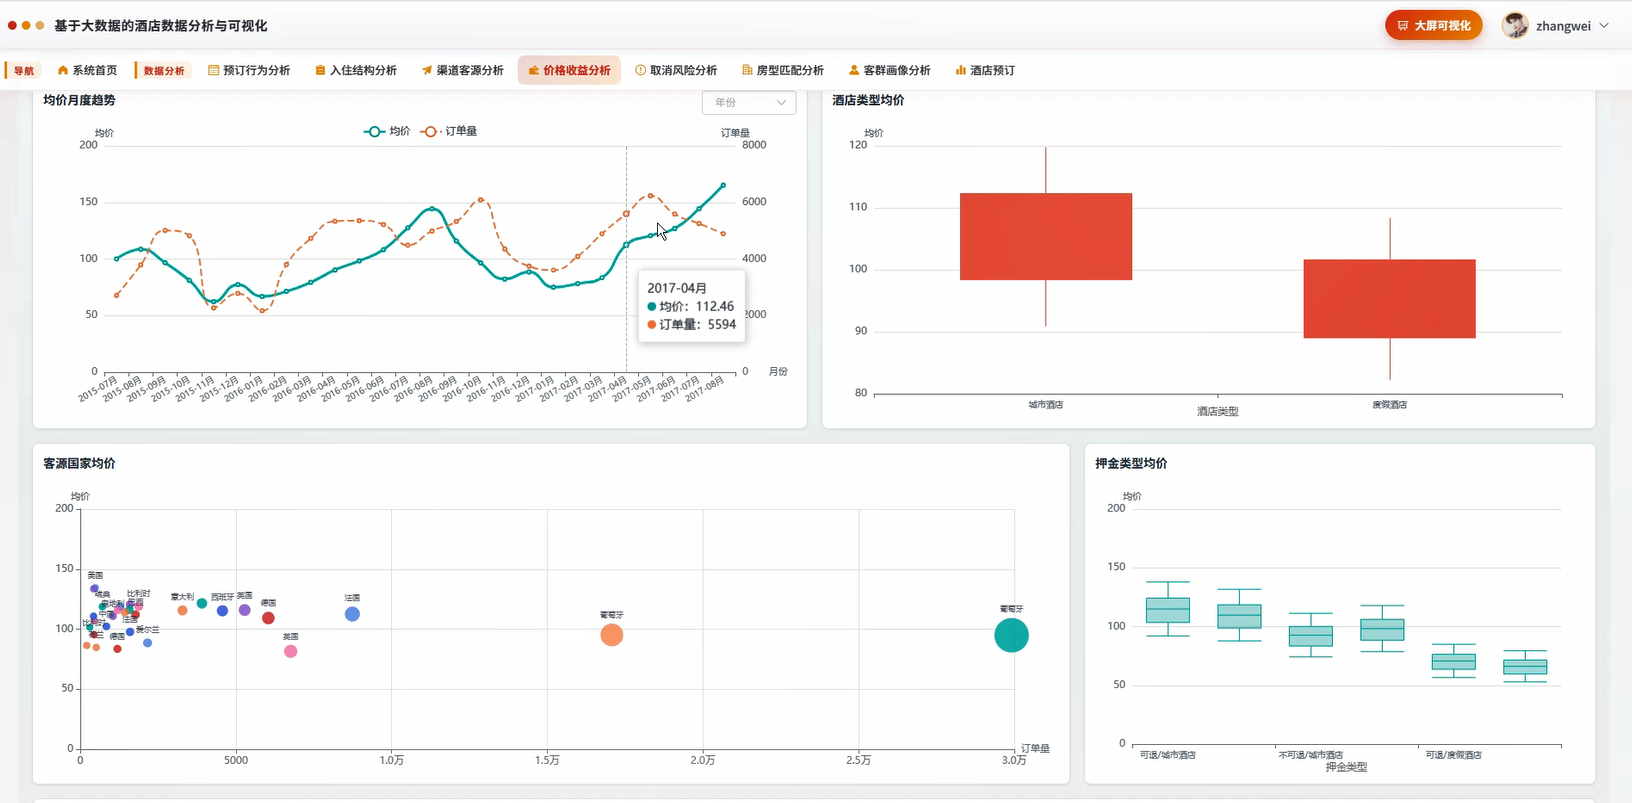
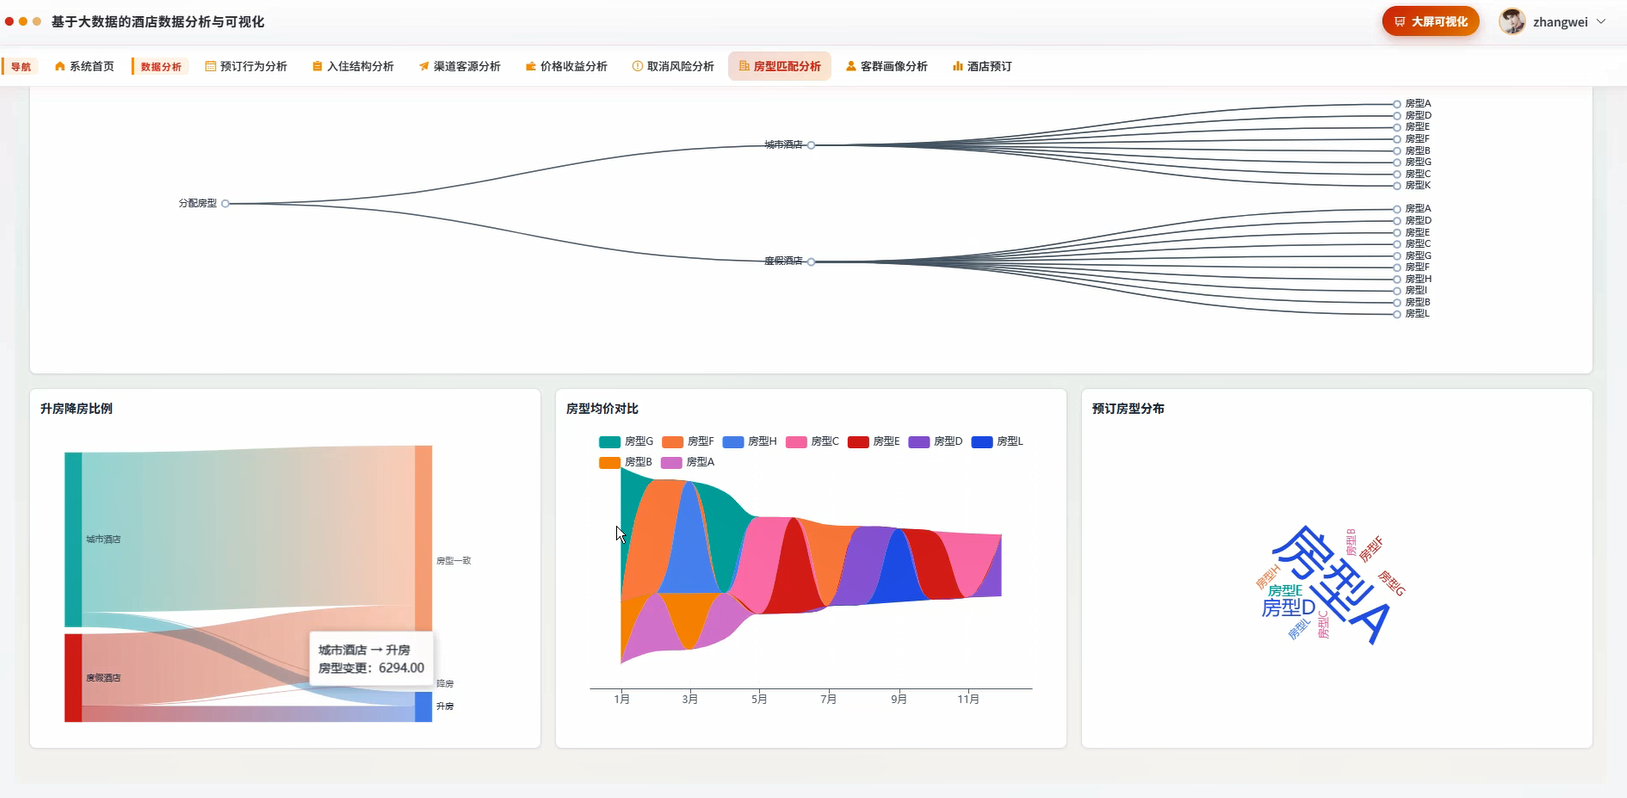
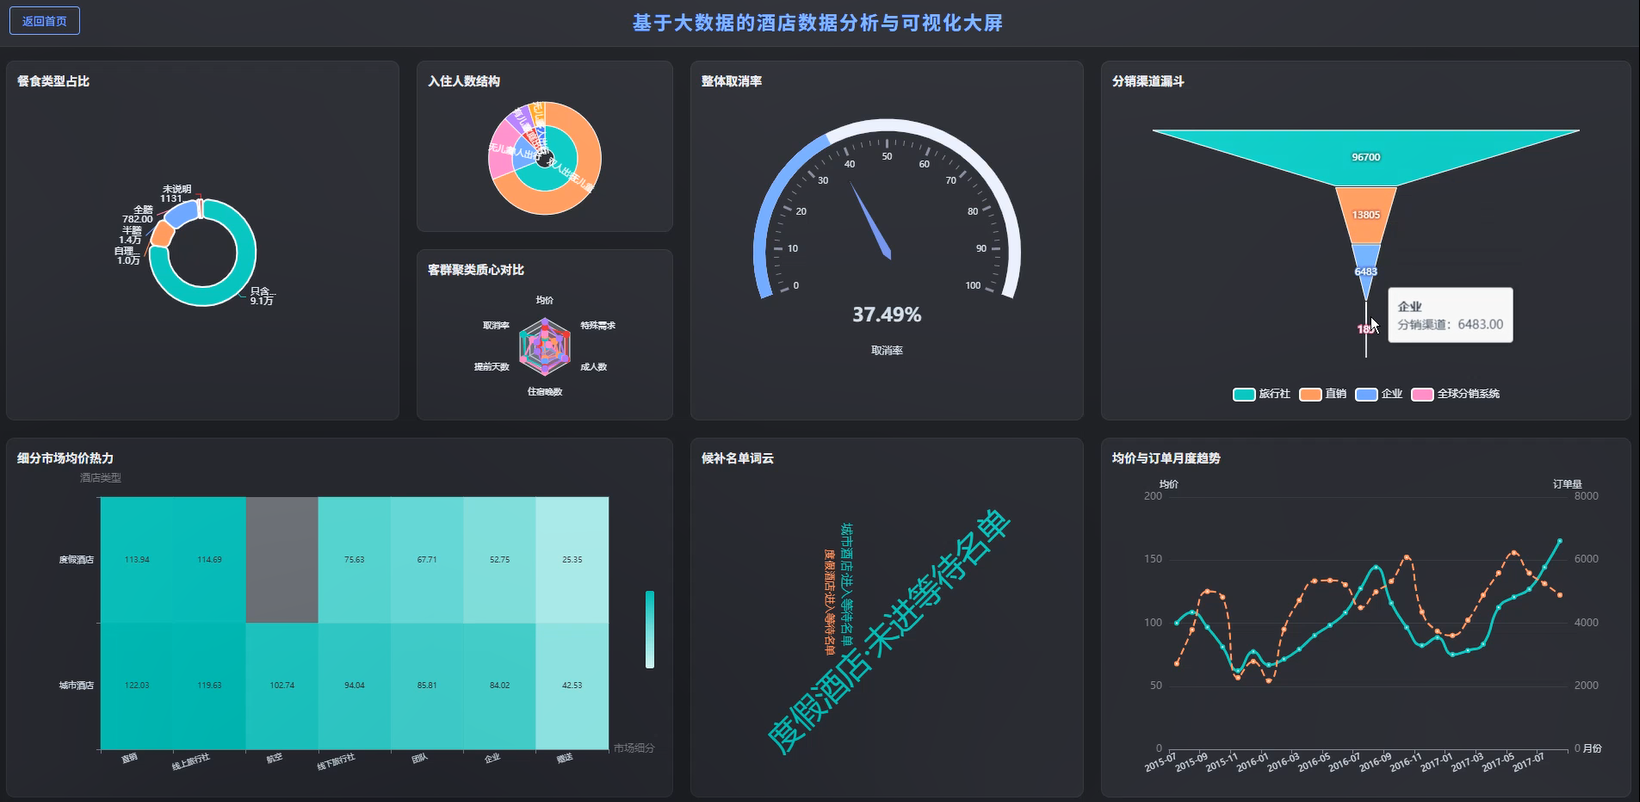
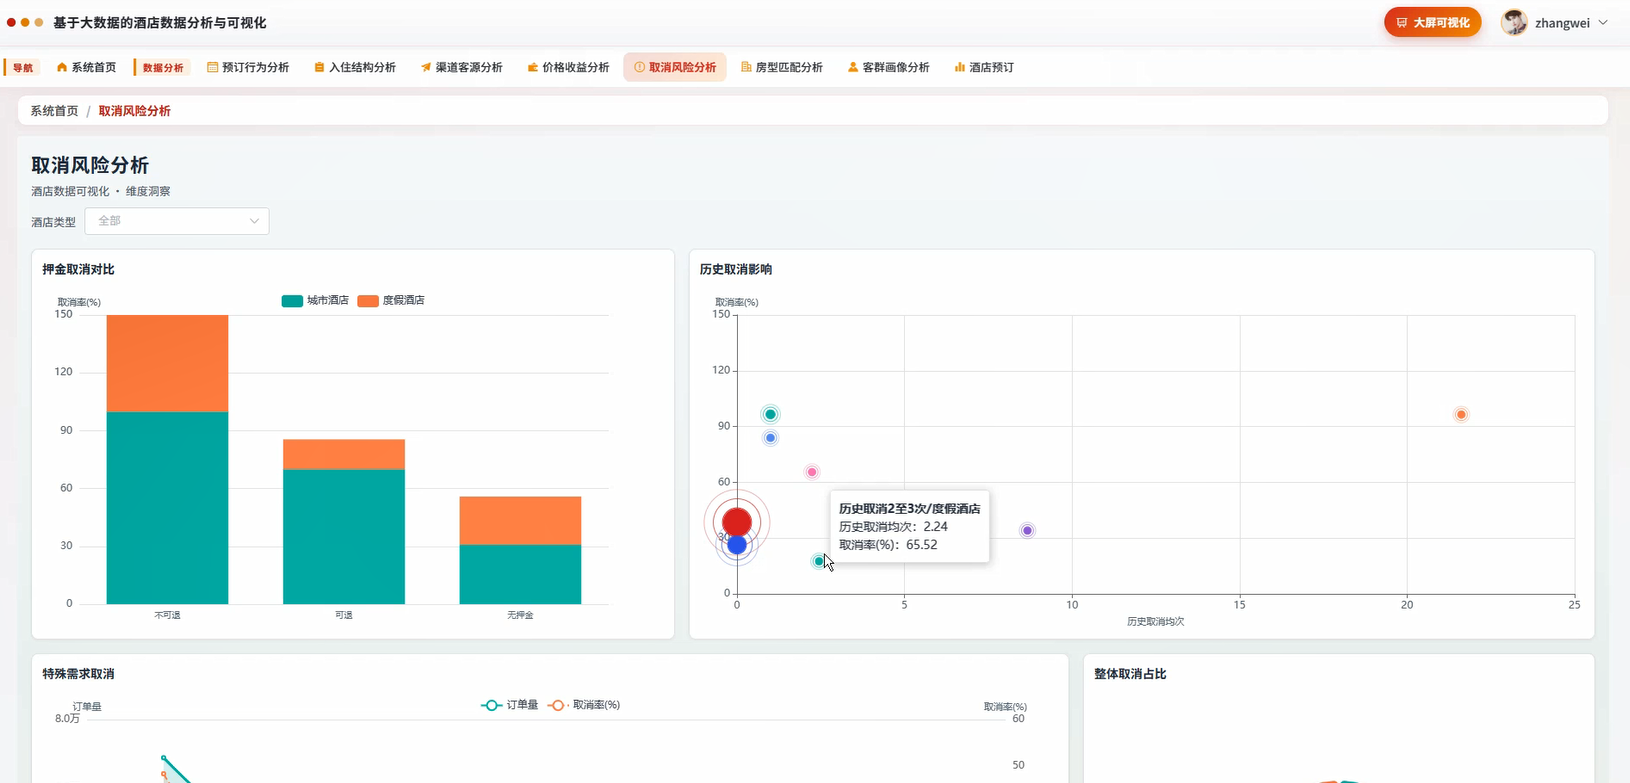
本系统名为《基于大数据的酒店数据分析与可视化》,整体围绕酒店预订与运营数据展开,采用Hadoop与Spark作为大数据处理核心,配合HDFS完成数据存储,通过Spark SQL与Pandas、NumPy完成数据清洗、统计与指标计算,后端提供Django与Spring Boot两个版本,前端使用Vue、ElementUI、Echarts、HTML、CSS、JavaScript与jQuery构建可视化界面,数据库采用MySQL。系统功能涵盖系统首页、数据分析、预订行为分析、入住结构分析、渠道客源分析、价格收益分析、取消风险分析、房型匹配分析、客群画像分析以及酒店预订等模块,能够从预订、入住、渠道、价格、风险、房型与客群等多个维度对酒店经营数据进行整理、分析与展示,帮助使用者更直观地了解酒店业务运行情况,同时也能作为计算机专业毕业设计中大数据方向的一个完整实践案例。
基于大数据的酒店数据分析与可视化演示视频
基于大数据的酒店数据分析与可视化演示图片
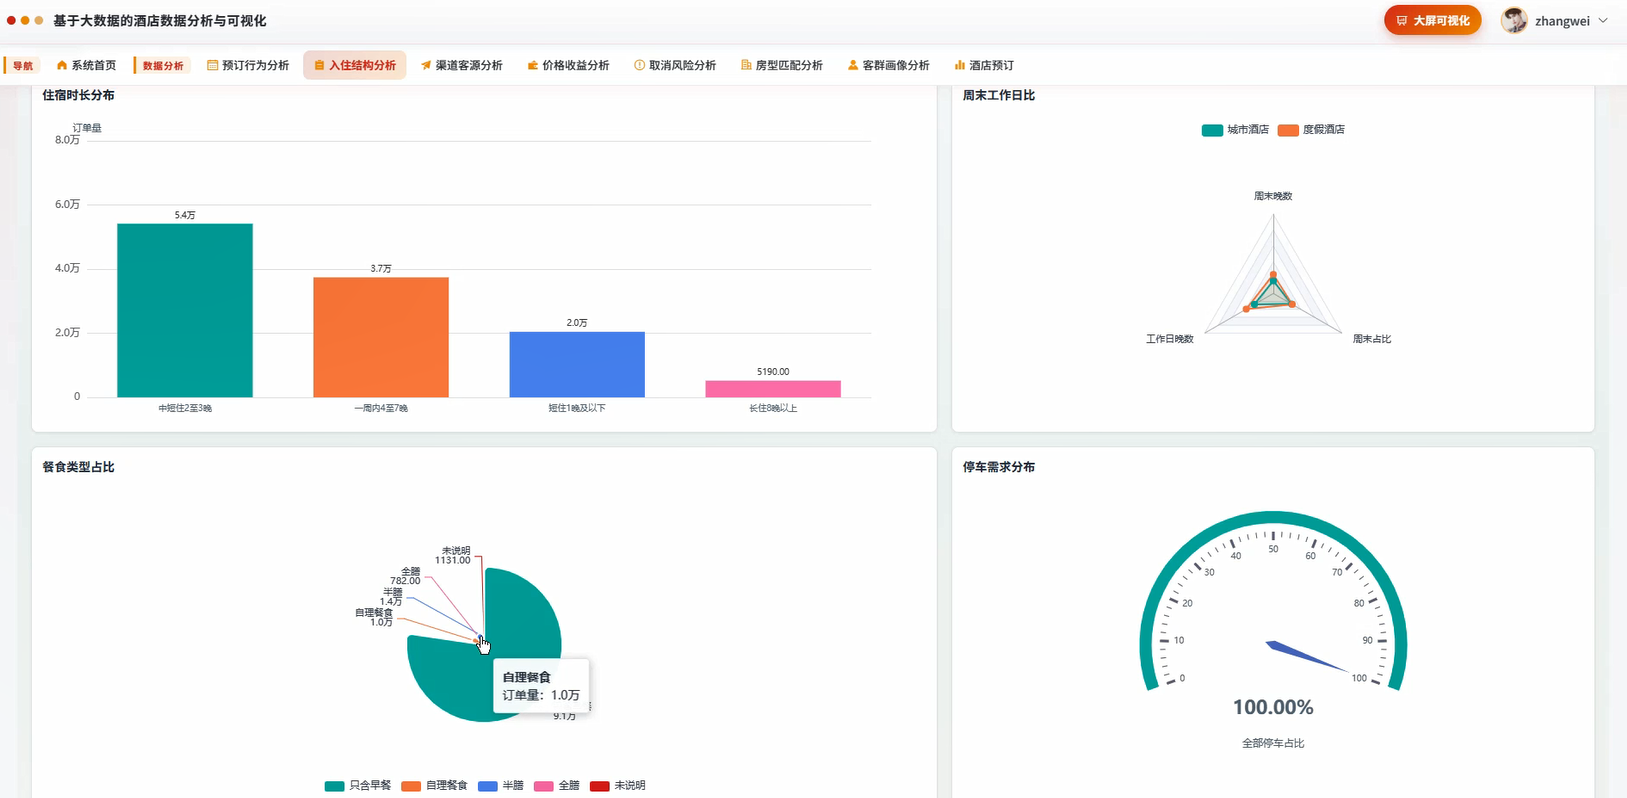
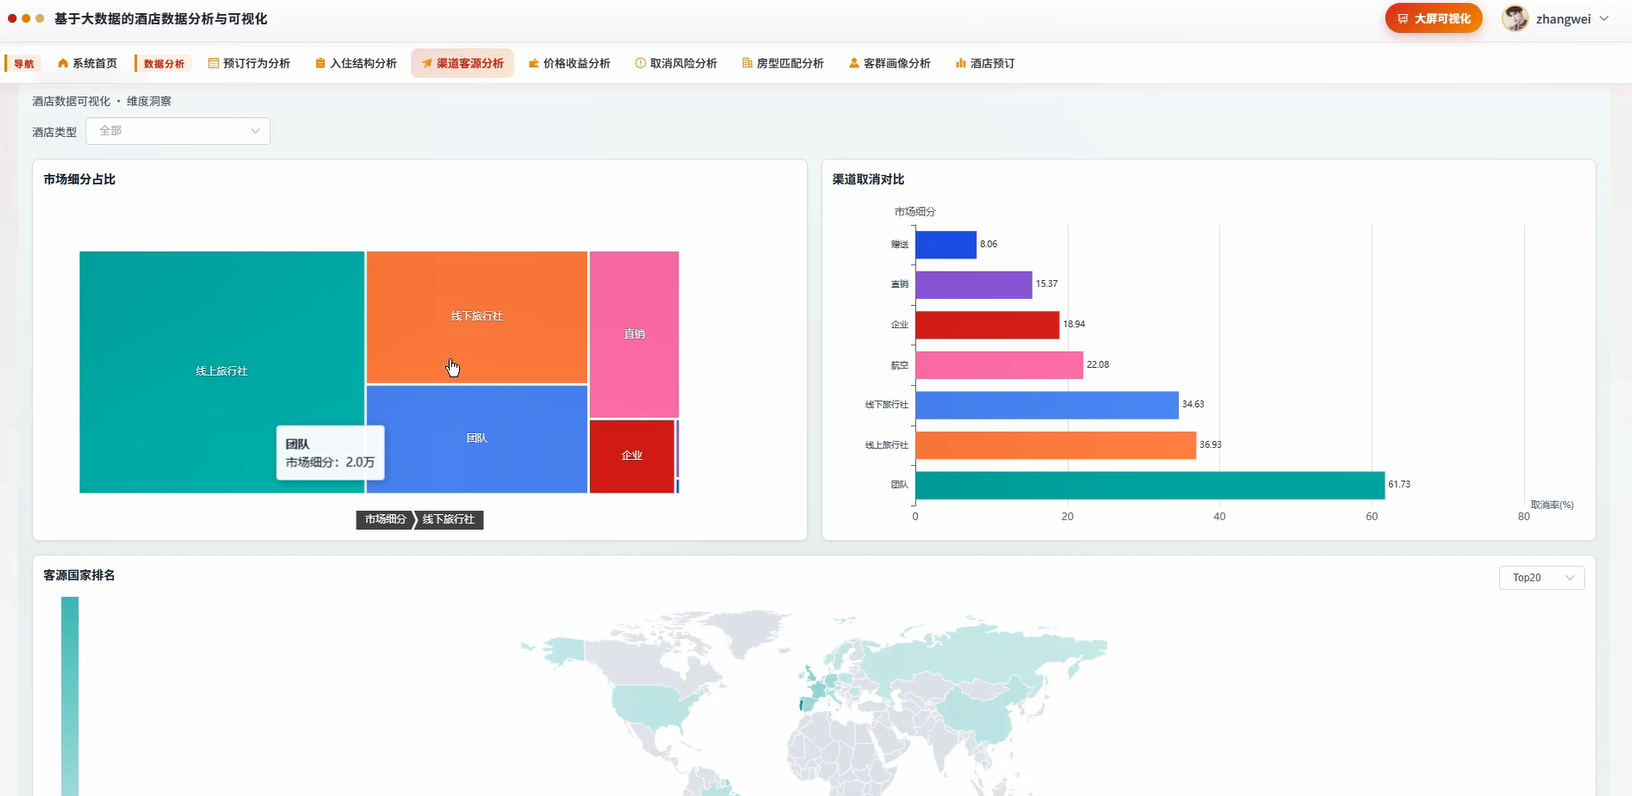
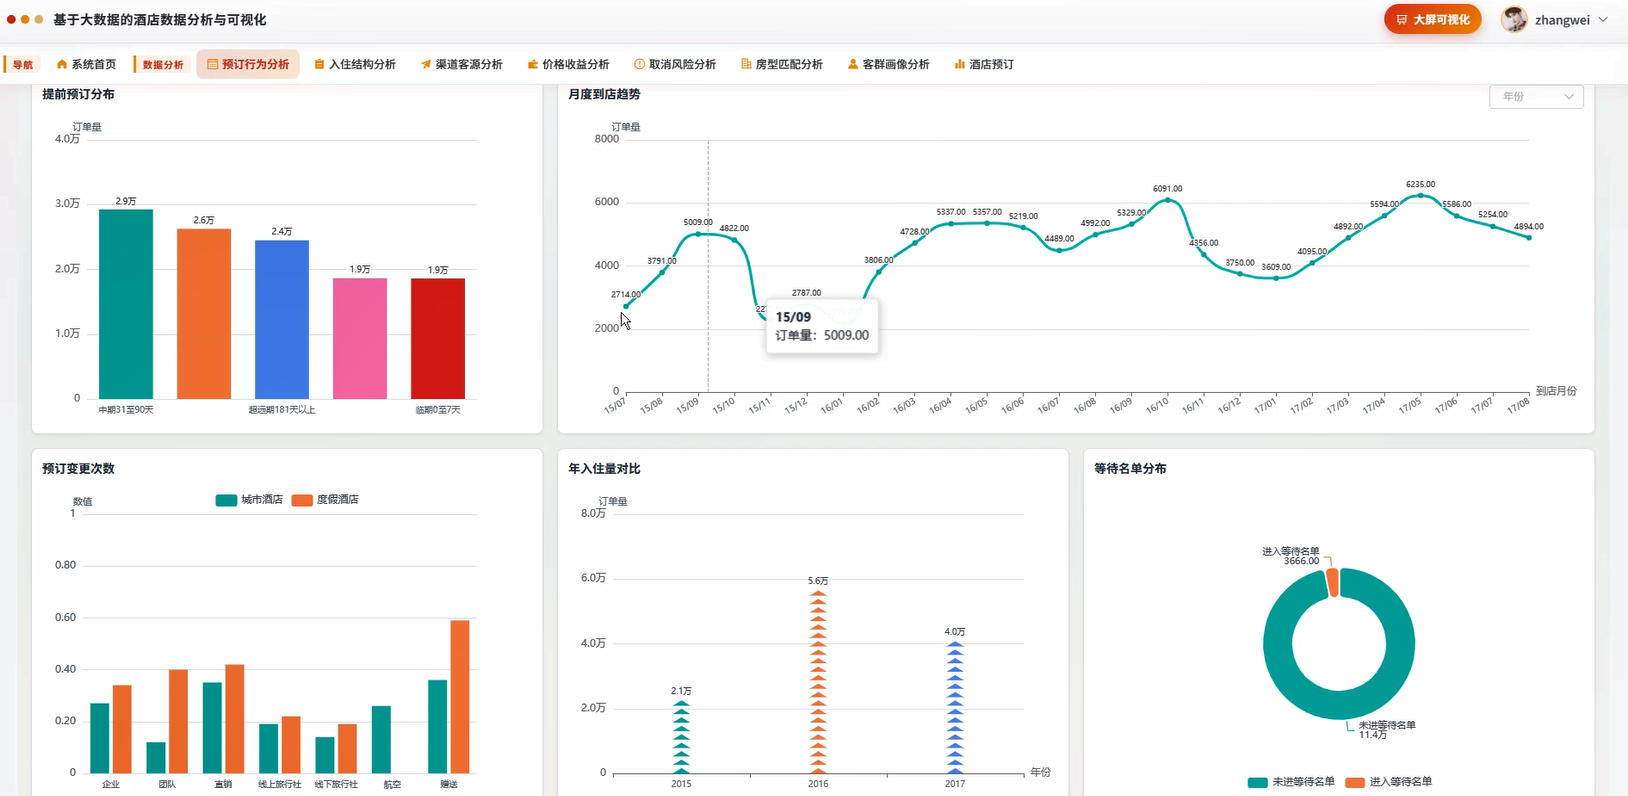
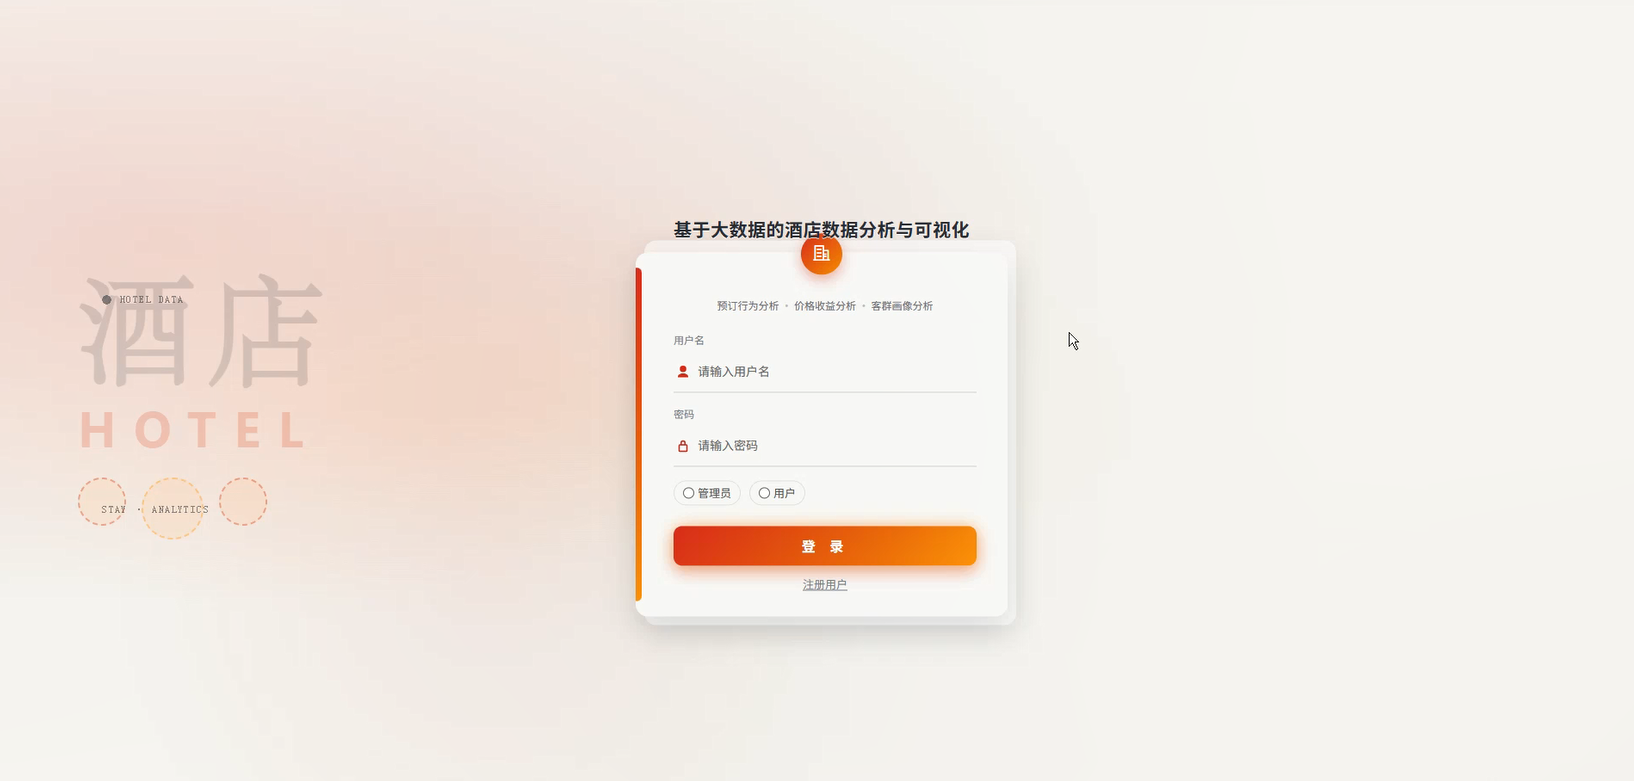
基于大数据的酒店数据分析与可视化代码展示
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, sum as _sum, avg, when, desc, round as _round
spark = SparkSession.builder.appName("HotelDataAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
def booking_behavior_analysis():
    df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/hotel/booking.csv")
    clean_df = df.dropna(subset=["hotel", "is_canceled", "lead_time", "arrival_date", "adr"]).filter(col("adr") > 0)
    clean_df = clean_df.withColumn("cancel_flag", when(col("is_canceled") == 1, 1).otherwise(0))
    behavior_df = clean_df.groupBy("hotel", "arrival_date").agg(count("lead_time").alias("booking_count"), _round(avg("lead_time"), 2).alias("avg_lead_time"), _round(avg("adr"), 2).alias("avg_price"), _sum("cancel_flag").alias("cancel_count"))
    behavior_df = behavior_df.withColumn("cancel_rate", _round(col("cancel_count") / col("booking_count"), 4))
    result_df = behavior_df.orderBy(desc("booking_count"))
    result_df.write.mode("overwrite").option("header", "true").csv("hdfs://localhost:9000/hotel/result/booking_behavior")
    return result_df
def channel_source_analysis():
    df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/hotel/booking.csv")
    clean_df = df.dropna(subset=["market_segment", "distribution_channel", "is_canceled", "adr"]).filter(col("adr") > 0)
    clean_df = clean_df.withColumn("cancel_flag", when(col("is_canceled") == 1, 1).otherwise(0))
    channel_df = clean_df.groupBy("market_segment", "distribution_channel").agg(count("adr").alias("order_count"), _round(avg("adr"), 2).alias("avg_price"), _sum("cancel_flag").alias("cancel_count"))
    channel_df = channel_df.withColumn("cancel_rate", _round(col("cancel_count") / col("order_count"), 4))
    channel_df = channel_df.withColumn("order_ratio", _round(col("order_count") / clean_df.count(), 4))
    result_df = channel_df.orderBy(desc("order_count"))
    result_df.write.mode("overwrite").option("header", "true").csv("hdfs://localhost:9000/hotel/result/channel_source")
    return result_df
def price_revenue_analysis():
    df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/hotel/booking.csv")
    clean_df = df.dropna(subset=["adr", "stays_in_week_nights", "stays_in_weekend_nights", "is_canceled"]).filter(col("adr") > 0)
    clean_df = clean_df.withColumn("total_nights", col("stays_in_week_nights") + col("stays_in_weekend_nights"))
    clean_df = clean_df.withColumn("revenue", col("adr") * col("total_nights"))
    clean_df = clean_df.withColumn("cancel_flag", when(col("is_canceled") == 1, 1).otherwise(0))
    price_df = clean_df.groupBy("hotel", "arrival_date").agg(_round(avg("adr"), 2).alias("avg_adr"), _round(_sum("revenue"), 2).alias("total_revenue"), _sum("total_nights").alias("total_nights"), _sum("cancel_flag").alias("cancel_count"))
    price_df = price_df.withColumn("revpar", _round(col("total_revenue") / col("total_nights"), 2))
    result_df = price_df.orderBy(desc("total_revenue"))
    result_df.write.mode("overwrite").option("header", "true").csv("hdfs://localhost:9000/hotel/result/price_revenue")
    return result_df
基于大数据的酒店数据分析与可视化文档展示
💖💖作者:计算机毕业设计杰瑞
💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我!
💛💛想说的话:感谢大家的关注与支持!
💜💜
网站实战项目
安卓/小程序实战项目
大数据实战项目
深度学校实战项目
计算机毕业设计选题推荐
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2501_92994129/article/details/165313342

