

一、引言
你花了 3 天搭好一个爬虫,跑了一个星期,然后目标网站改版了。是不是很熟悉的感觉?
无论你是用 Scrapy、Selenium 还是 Playwright,网页爬虫的维护成本始终居高不下。网站改版修改了 CSS 选择器、添加了新的反爬层、更新了 JavaScript 框架——每一次变化都意味着你需要停下手头的工作,重新调试代码、测试逻辑、部署上线。更不用说那些时不时出现的 CAPTCHA、IP 封禁、动态加载内容等技术障碍。
如果有一个工具,能让你用自然语言描述需求,AI 自动生成生产就绪的爬虫,网站改版时一键自动修复,而且完全不需要管理任何服务器——这正是 Bright Data Scraper Studio 要解决的问题。
本文将通过真实的 Amazon 商品数据抓取案例,手把手演示如何使用 Scraper Studio 构建、运行、维护一个企业级数据管道。无论你是后端开发者、数据工程师,还是正在评估爬虫解决方案的技术负责人,这篇文章都会为你提供完整的实战指南。
免费试用 Scraper Studio,每月就有 5000 次页面加载额度,无需信用卡,永久循环。
二、Bright Data Scraper Studio 是什么?
2.1 产品定位
Bright Data Scraper Studio 是一个 AI 驱动的网页数据管道构建平台。它将传统爬虫开发中最耗时的三大环节——代码编写、基础设施管理、日常维护——全部自动化。
通俗来说,它让你用描述需求的方式构建爬虫,而不是从头写代码。你只需要:
-
输入目标网站 URL
-
用自然语言描述需要提取的数据(比如"商品名称、价格、评分、库存状态")
-
AI 自动生成爬虫代码,包含完整的选择器、解析逻辑和数据结构
生成的爬虫运行在 Bright Data 的全托管基础设施上,内置了 400M+ 住宅 IP 代理池、自动 CAPTCHA 解决、JavaScript 渲染、反封禁机制——这些都是开箱即用的,不需要你单独配置。
2.2 适合人群
| 角色 | 使用场景 |
|---|---|
| Python/JavaScript 开发者 | 构建的爬虫隔三差五因网站改版而崩溃,需要一个能自动维护的解决方案 |
| 数据工程师 | 需要可扩展、可定时调度的数据管道,但不想自己搭建和维护 Kubernetes 集群 |
| 电商/业务分析师 | 需要竞品价格、商品信息等结构化数据,但没有编程背景 |
| 技术负责人/CTO | 正在评估托管爬虫方案 vs. 自建系统的成本效益 |
| AI 工程师 | 需要为 LLM Agent 提供实时网页数据,不想维护复杂的数据采集基础设施 |
2.3 四大核心支柱
1. AI 代码生成
基于大语言模型的代码生成引擎,能理解自然语言需求并自动生成生产级爬虫代码。支持复杂的分页、滚动加载、多级导航等场景。
2. 自愈引擎(Self-Healing)
这是 Scraper Studio 最核心的差异化功能。当目标网站改版导致爬虫失效时,AI 会自动检测失败原因(比如选择器失效、Schema 变化),并生成修复方案供你审核。一键批准后,爬虫立即恢复正常运行。
3. 全托管基础设施
-
400M+ 住宅代理 IP(覆盖 195 个国家)
-
自动 CAPTCHA 识别与解决
-
真实浏览器环境(支持 JavaScript 渲染)
-
自动重试与错误处理
-
无限并发能力
4. 定时调度 + 多端交付
支持按日、按周或自定义时间间隔运行爬虫,数据可自动交付至:
-
云存储:Amazon S3、Google Cloud Storage、Azure Blob Storage
-
数据仓库:Google BigQuery、Snowflake、Databricks
-
实时推送:Webhook、Kafka
-
本地下载:JSON、CSV、Parquet
2.4 免费额度
每个新注册账户自动获得:
-
每月 5,000 次页面加载额度(价值约 $7.5)
-
无需绑定信用卡
-
无需输入促销码
-
永久循环使用(不会过期)
此外,首次充值时 Bright Data 会 1:1 匹配你的充值金额,最高匹配 $500。也就是说,如果你充值 $500,账户中会有 $1,000 可用余额。
👉** 想亲自体验 Scraper Studio吗?**
新用户可免费获得每月 5,000 次页面加载额度,无需绑定信用卡即可创建第一个 AI 爬虫。
三、三步工作流详解
Step 1:定义数据需求
登录 Scraper Studio 后,你会看到一个简洁的界面。点击"Create New Scraper",输入目标网站 URL,然后用自然语言描述你需要的数据。
Scraper Studio 支持中文、英文、西班牙语、日语等多种语言输入。
Step 2:AI 生成爬虫
点击"Generate"后,AI 会在 30-60 秒内完成以下工作:
-
分析目标网站结构:自动识别数据所在的 DOM 结构、CSS 类名、XPath 路径
-
生成 Output Schema:定义数据字段类型(字符串、数字、布尔值、数组等)
-
编写爬虫代码:生成完整的 JavaScript 代码,包含导航逻辑、数据提取、分页处理
-
配置代理和浏览器:自动选择最适合目标网站的代理类型(住宅 IP / 数据中心 IP)和浏览器配置
生成的代码会在一个云端 IDE 中打开,你可以:
-
直接查看源代码:所有逻辑完全透明,没有黑盒
-
手动调整优化:如果 AI 生成的选择器不够精准,你可以随时修改
-
添加自定义逻辑:比如登录流程、表单填写、条件判断等
Step 3:运行与数据交付
爬虫生成后,你有三种运行方式:
方式 1:在控制台手动运行
点击"Run"按钮,输入起始 URL(可以是单个 URL 或 URL 列表),立即开始抓取。实时查看运行日志、成功率、数据预览。
方式 2:设置定时调度
配置 Cron 表达式或选择预设时间间隔(每小时 / 每天 / 每周),系统会自动按计划执行爬虫。
方式 3:通过 API 或 CLI 触发
将爬虫集成到你的现有系统中,通过 REST API 或 Bright Data CLI 触发运行(后文会详细介绍)。
数据交付方面,你可以配置:
-
输出格式:JSON(默认)、CSV、Parquet
-
交付目标:直接下载、发送到 S3 桶、推送到 Webhook、写入 BigQuery 表
-
交付频率:每次运行后立即交付,或累积到一定数量后批量交付
四、实战演示:为 Amazon 商品列表构建爬虫
接下来,我们通过一个真实案例,从零开始构建一个 Amazon 奥迪Q7商品数据抓取管道。
4.1 需求定义
目标网站:Amazon奥迪Q7
数据需求:
车型名称
价格
年款
配置版本
里程数
车辆所在地
经销商/卖家名称
评分
评论数量
详情页链接
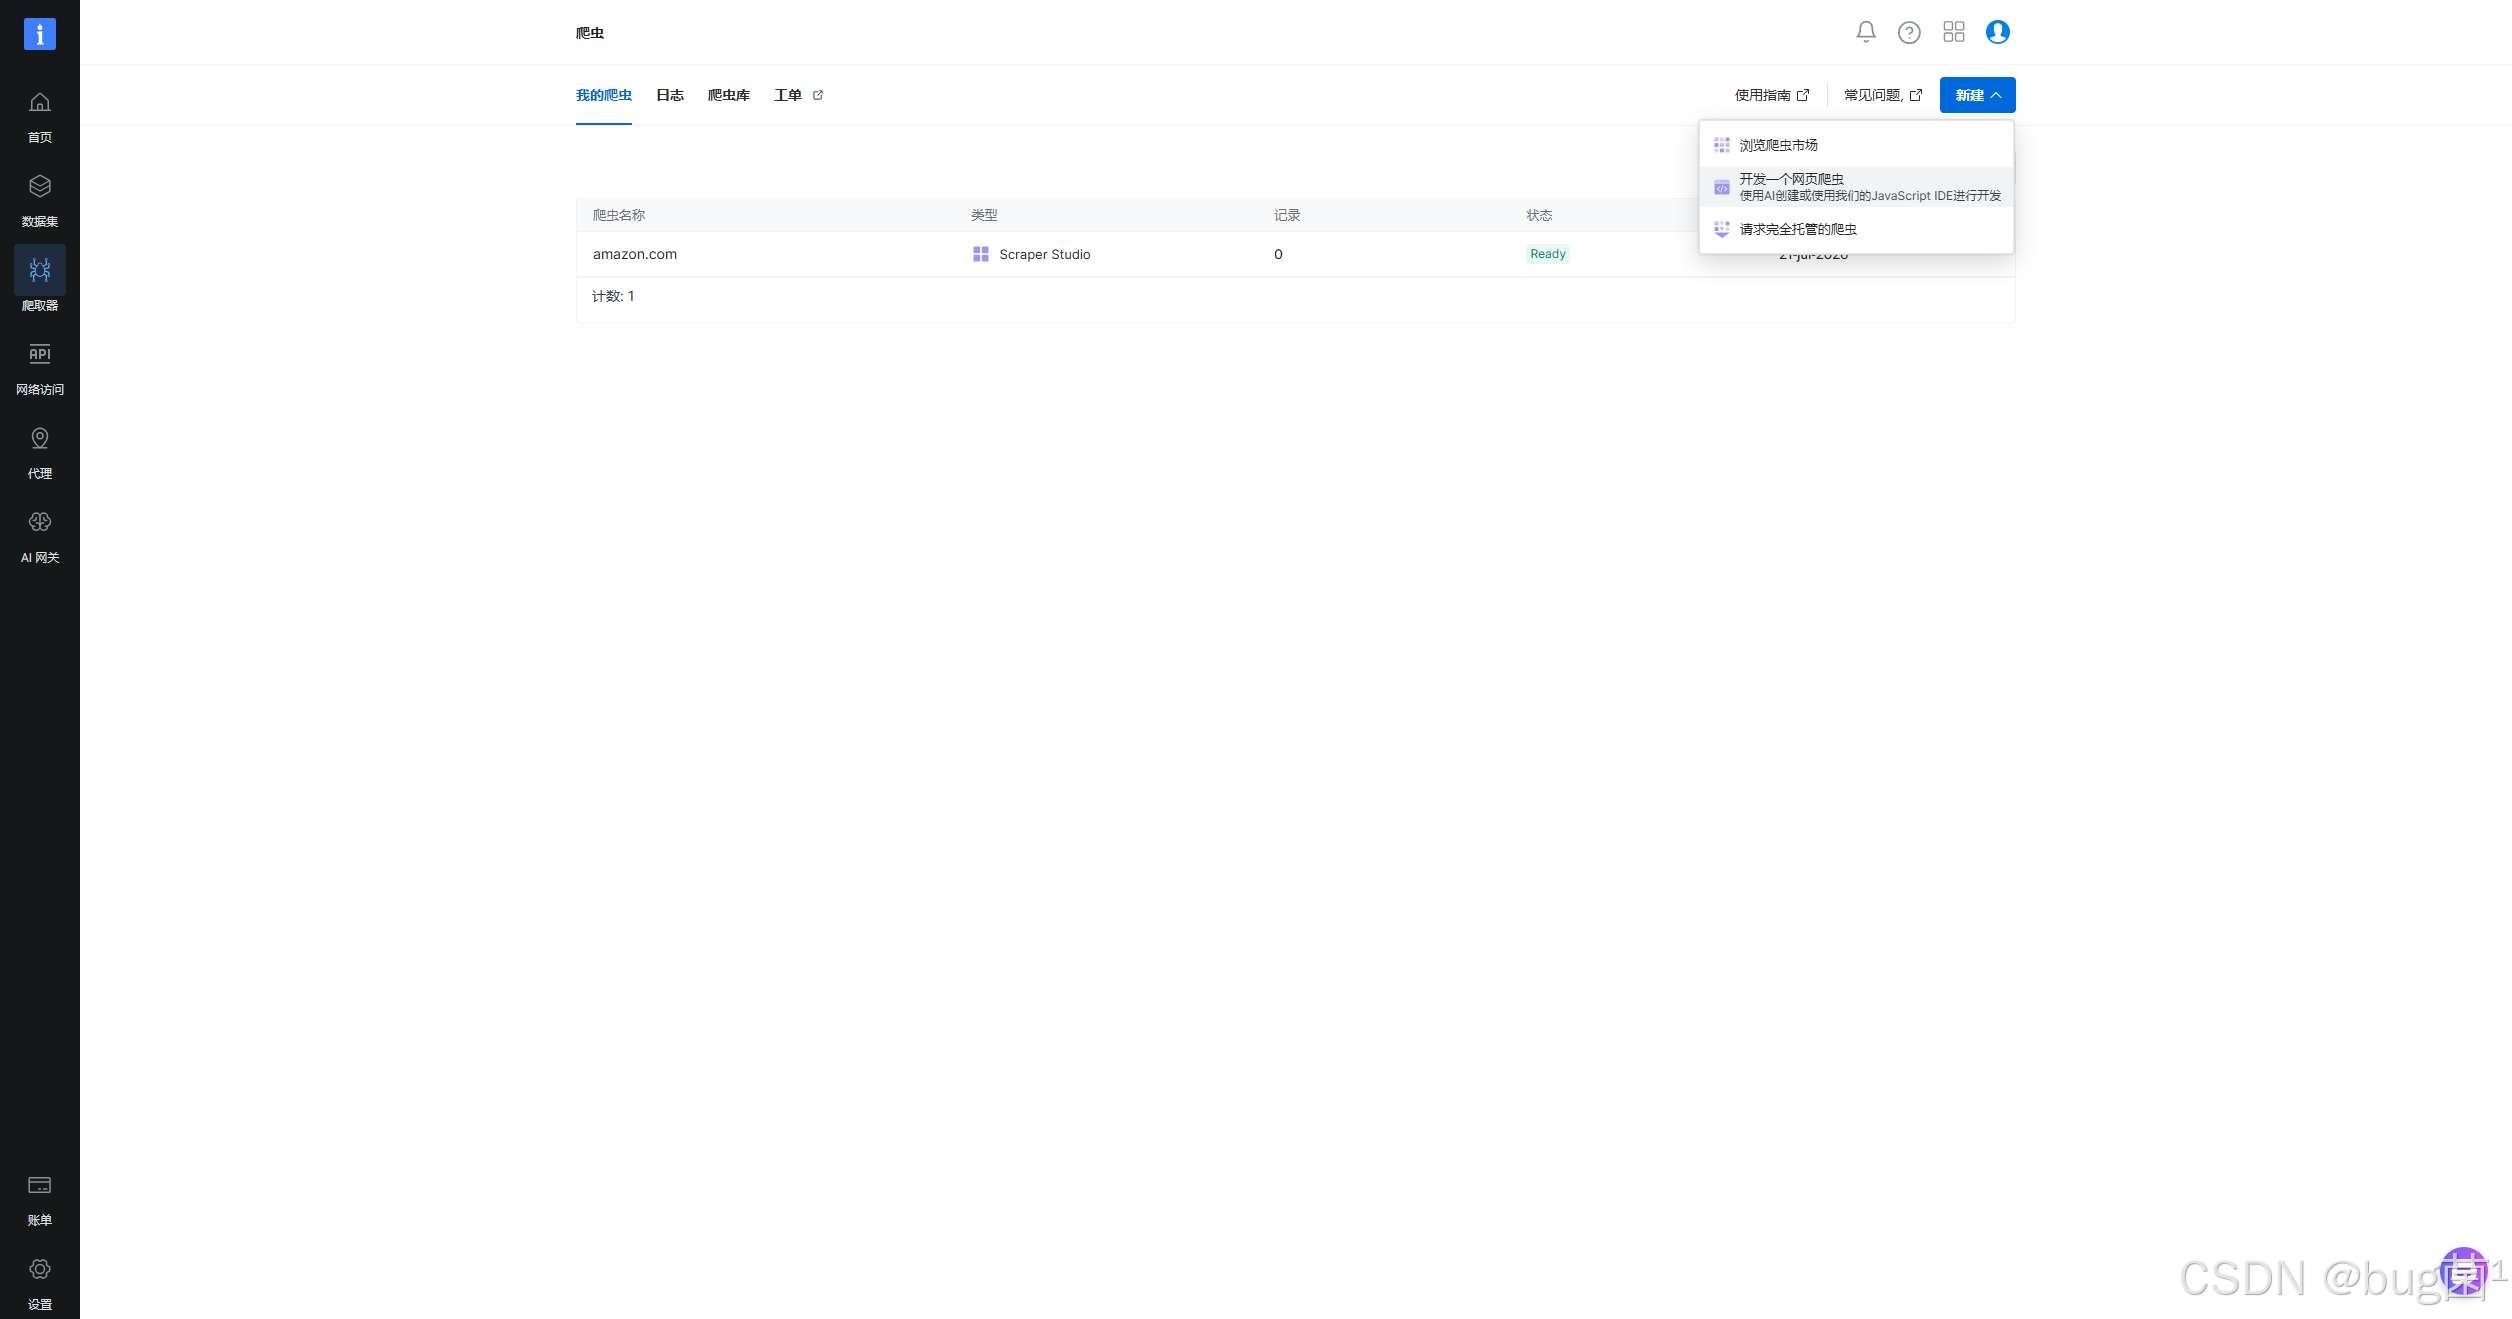
4.2 创建爬虫
-
登录 Scraper Studio,点击"Create Scraper"
-
选择"AI Agent"模式
-
输入目标 URL:https://www.amazon.com/s?k=%E5%A5%A5%E8%BF%AAq7&crid=19XJQNXRFRJIH&sprefix=%E5%A5%A5%E8%BF%AA%2Caps%2C430&ref=nb_sb_ss_fb_1_2_p13n-expert-pd-ops-ranker
-
在提示框中输入:
抓取当前页面中与奥迪Q7(Audi Q7)相关的商品/车辆信息,

提取以下字段:
- 车型名称
- 价格
- 年款
- 配置版本
- 里程数
- 车辆所在地
- 经销商/卖家名称
- 评分
- 评论数量
- 详情页链接

筛选规则:
- 仅保留奥迪Q7整车相关信息;
- 排除汽车配件、改装件、脚垫、车膜、车载充电器、模型车、周边商品等非整车商品;
- 排除其他奥迪车型(如Q5、Q8、A6等);
- 页面未展示的字段返回null;
- 不要自行推测、补充或生成页面未提供的数据;
- 保留原始页面中的商品/车辆标题和链接。
- 点击"Approve"
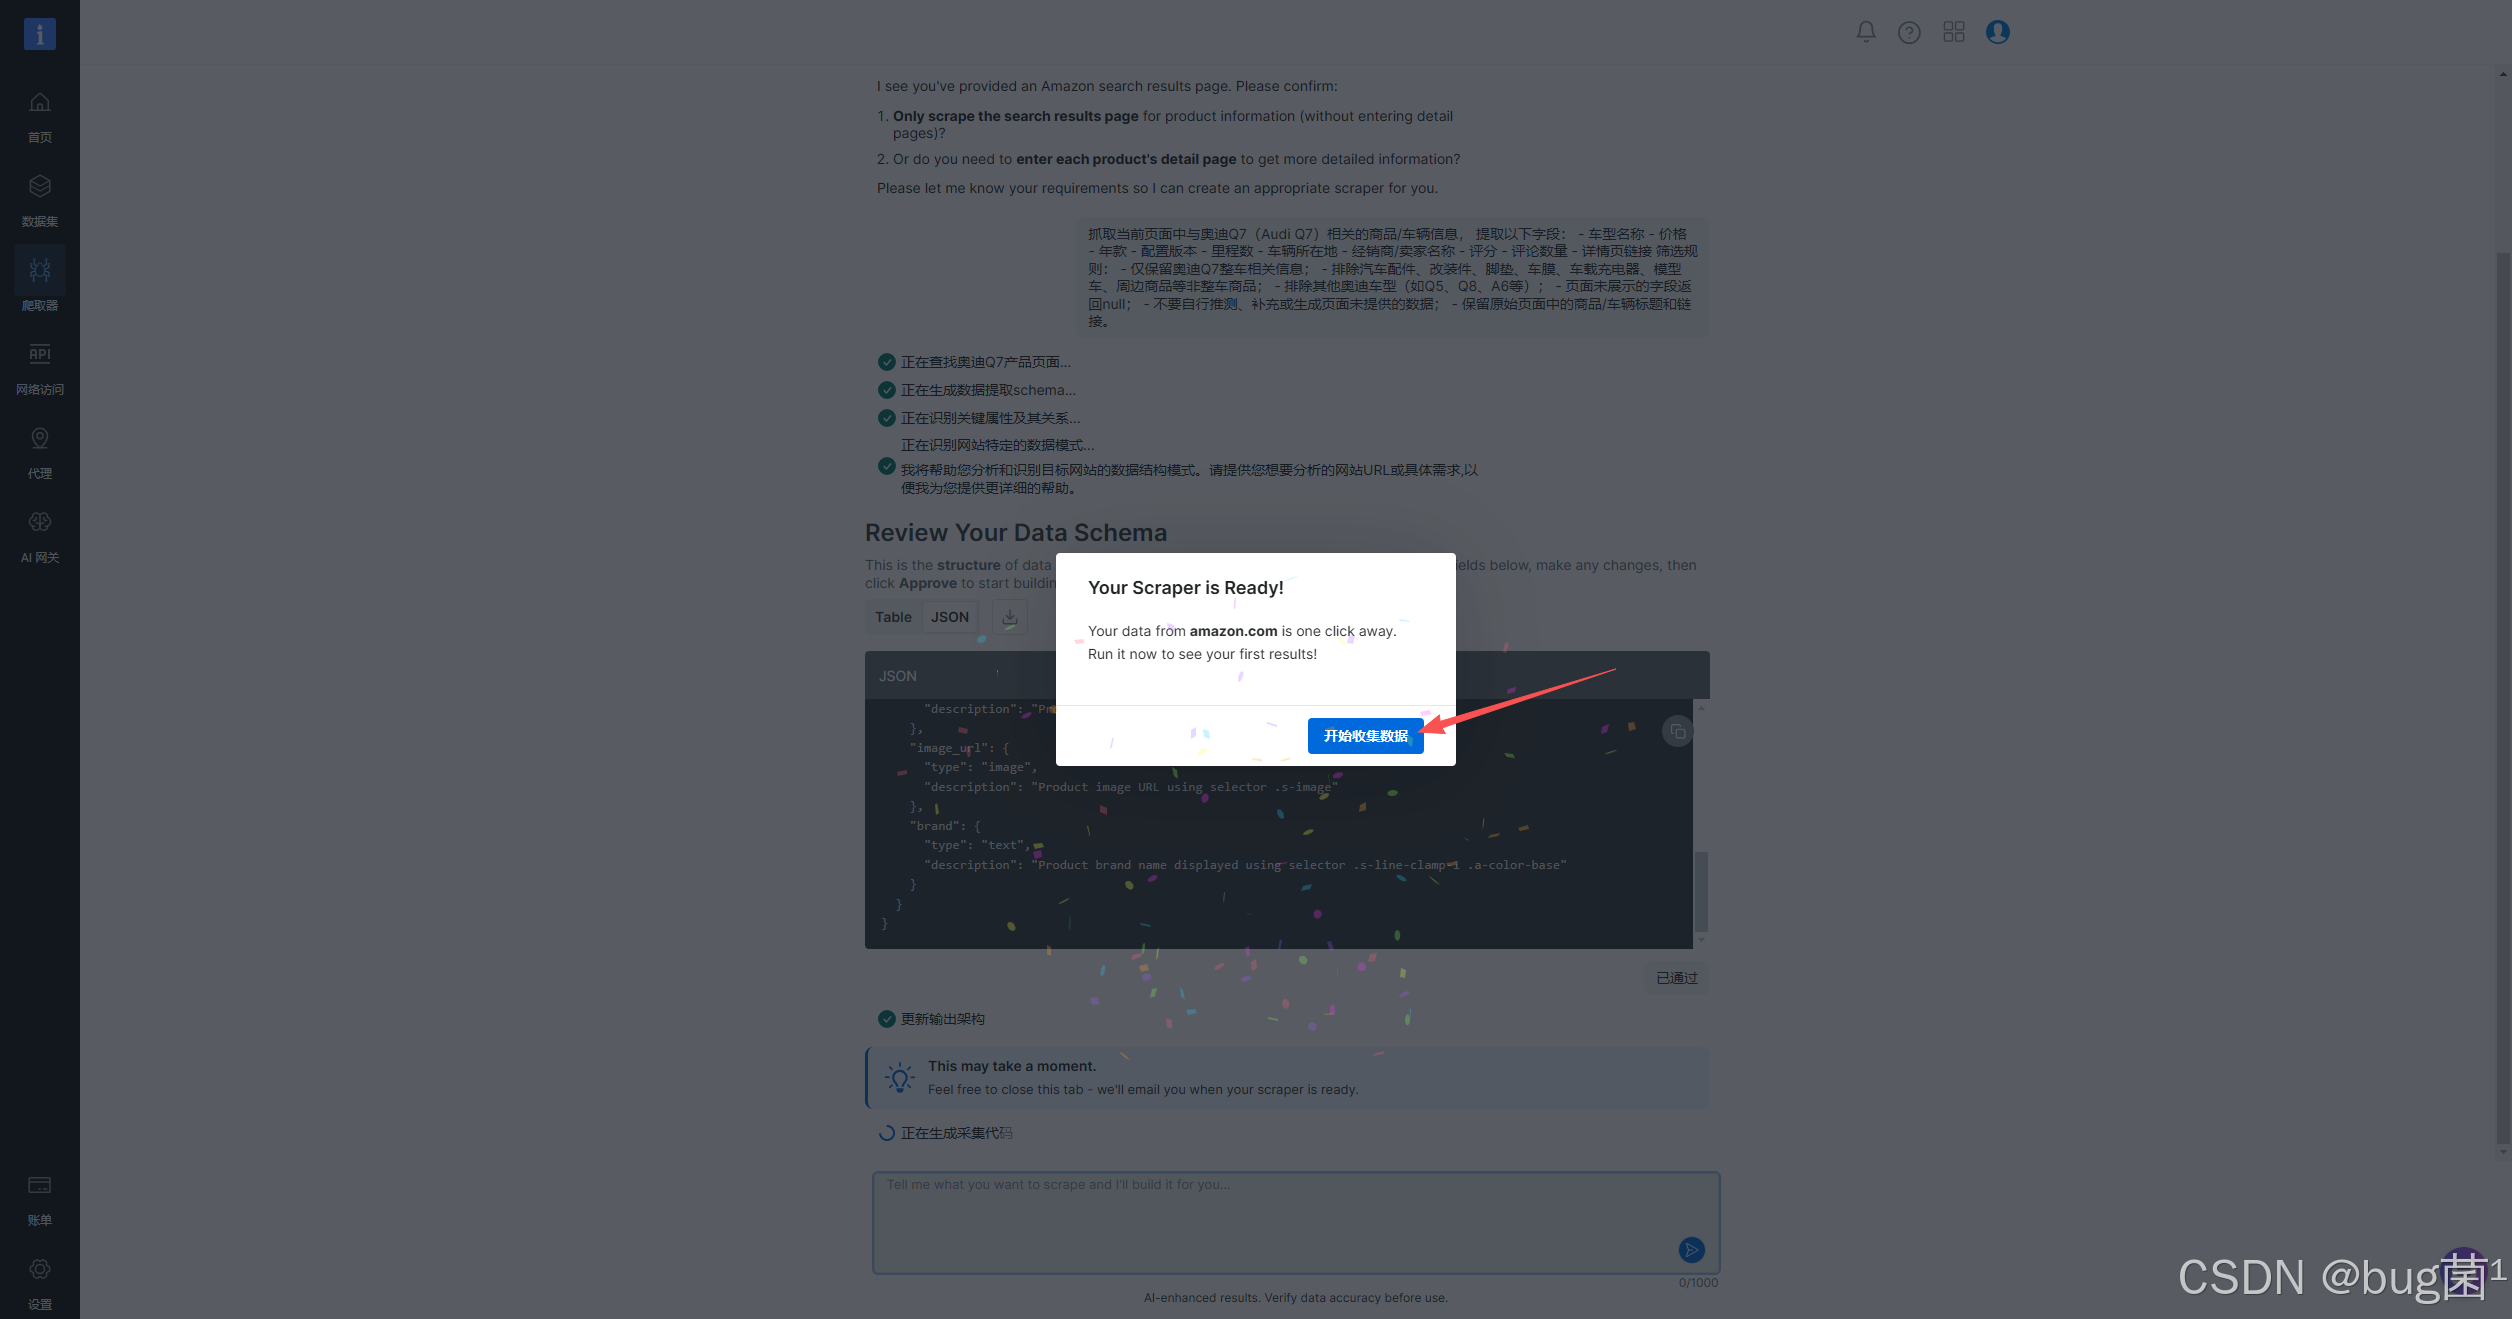
表示我们可以直接去采集数据了。
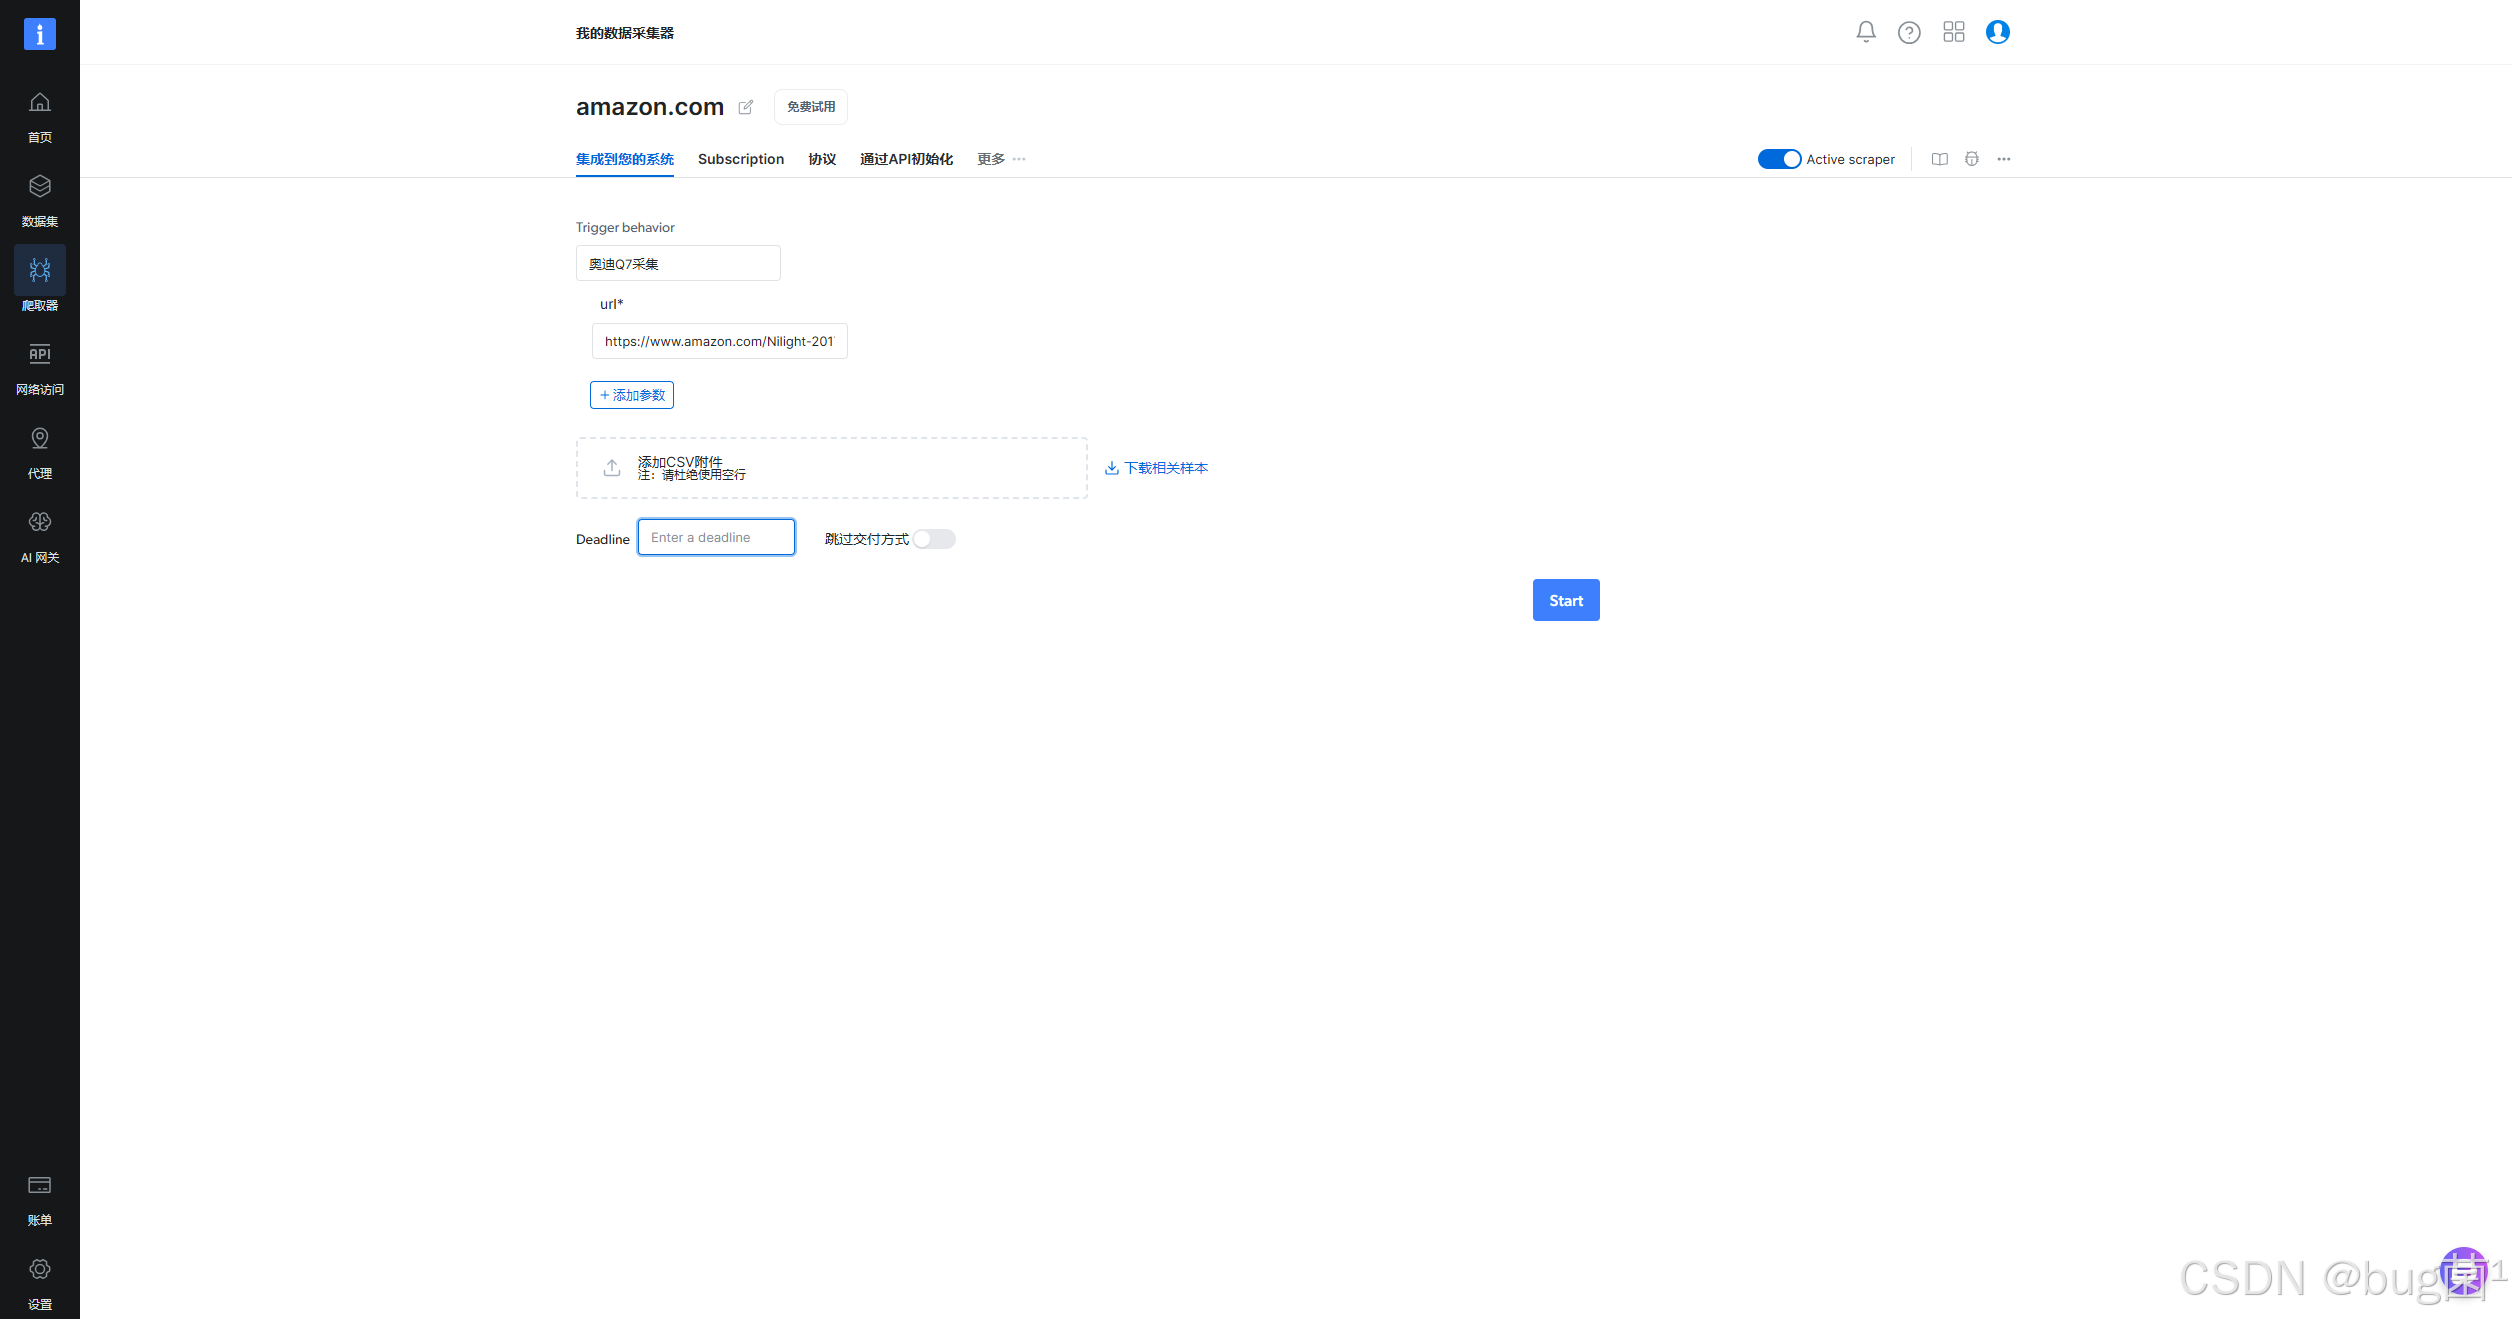
接着,我们可以设置采集周期:
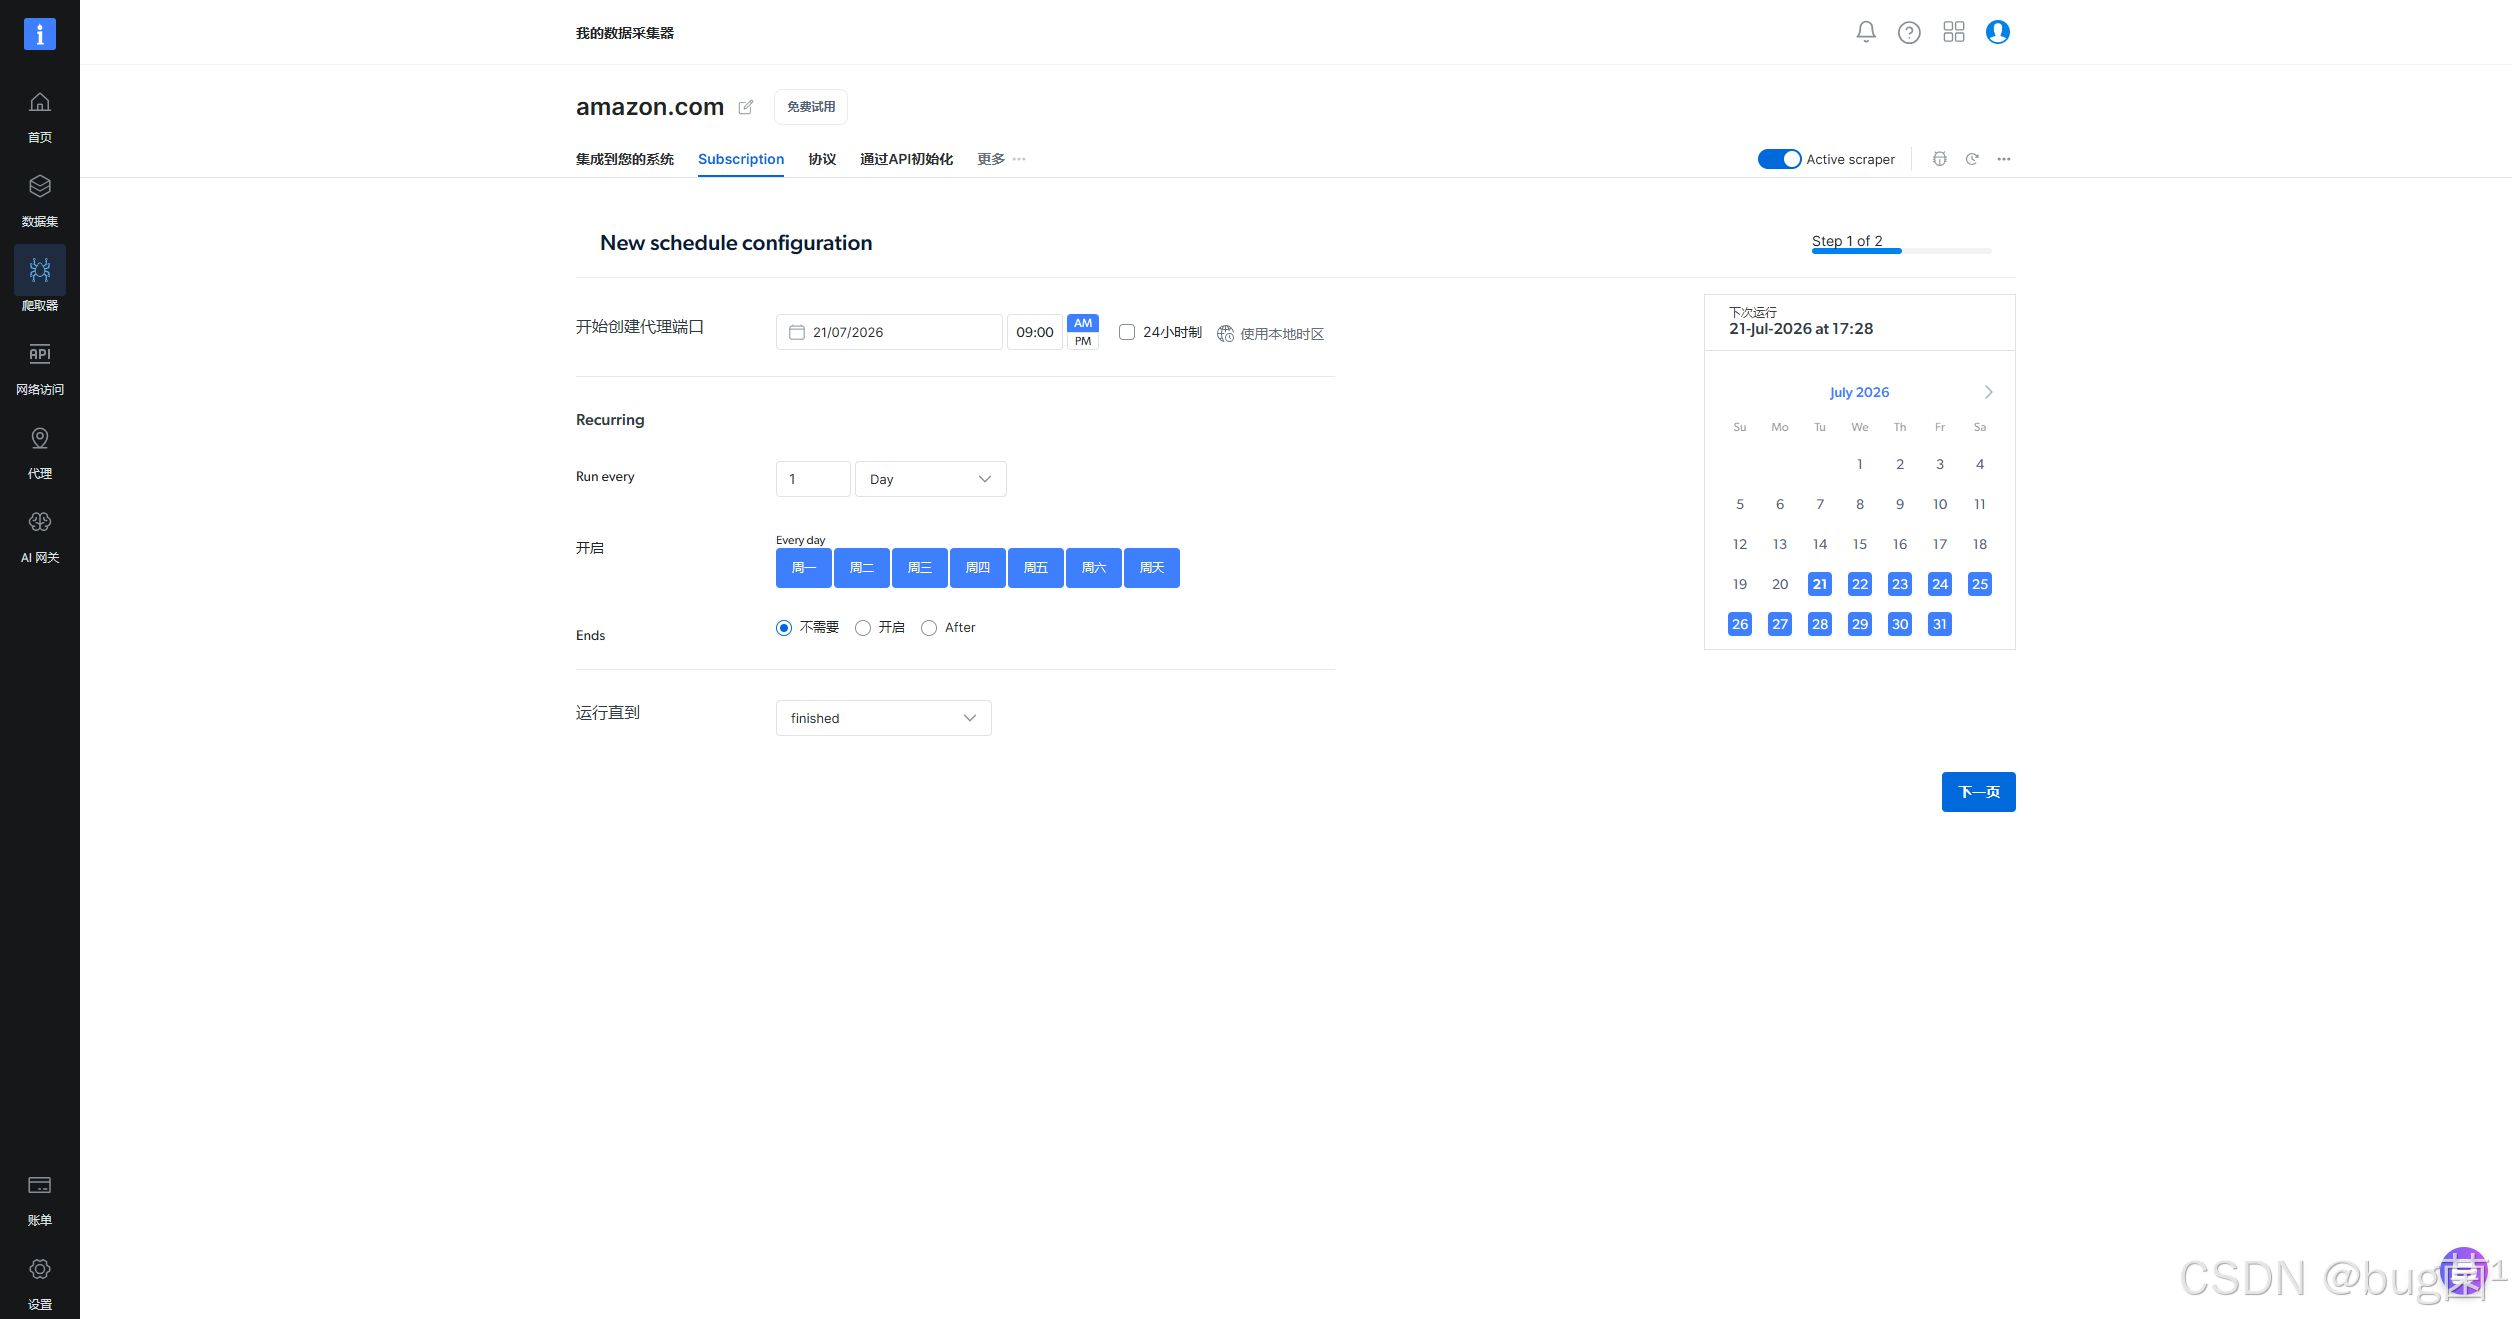
预览
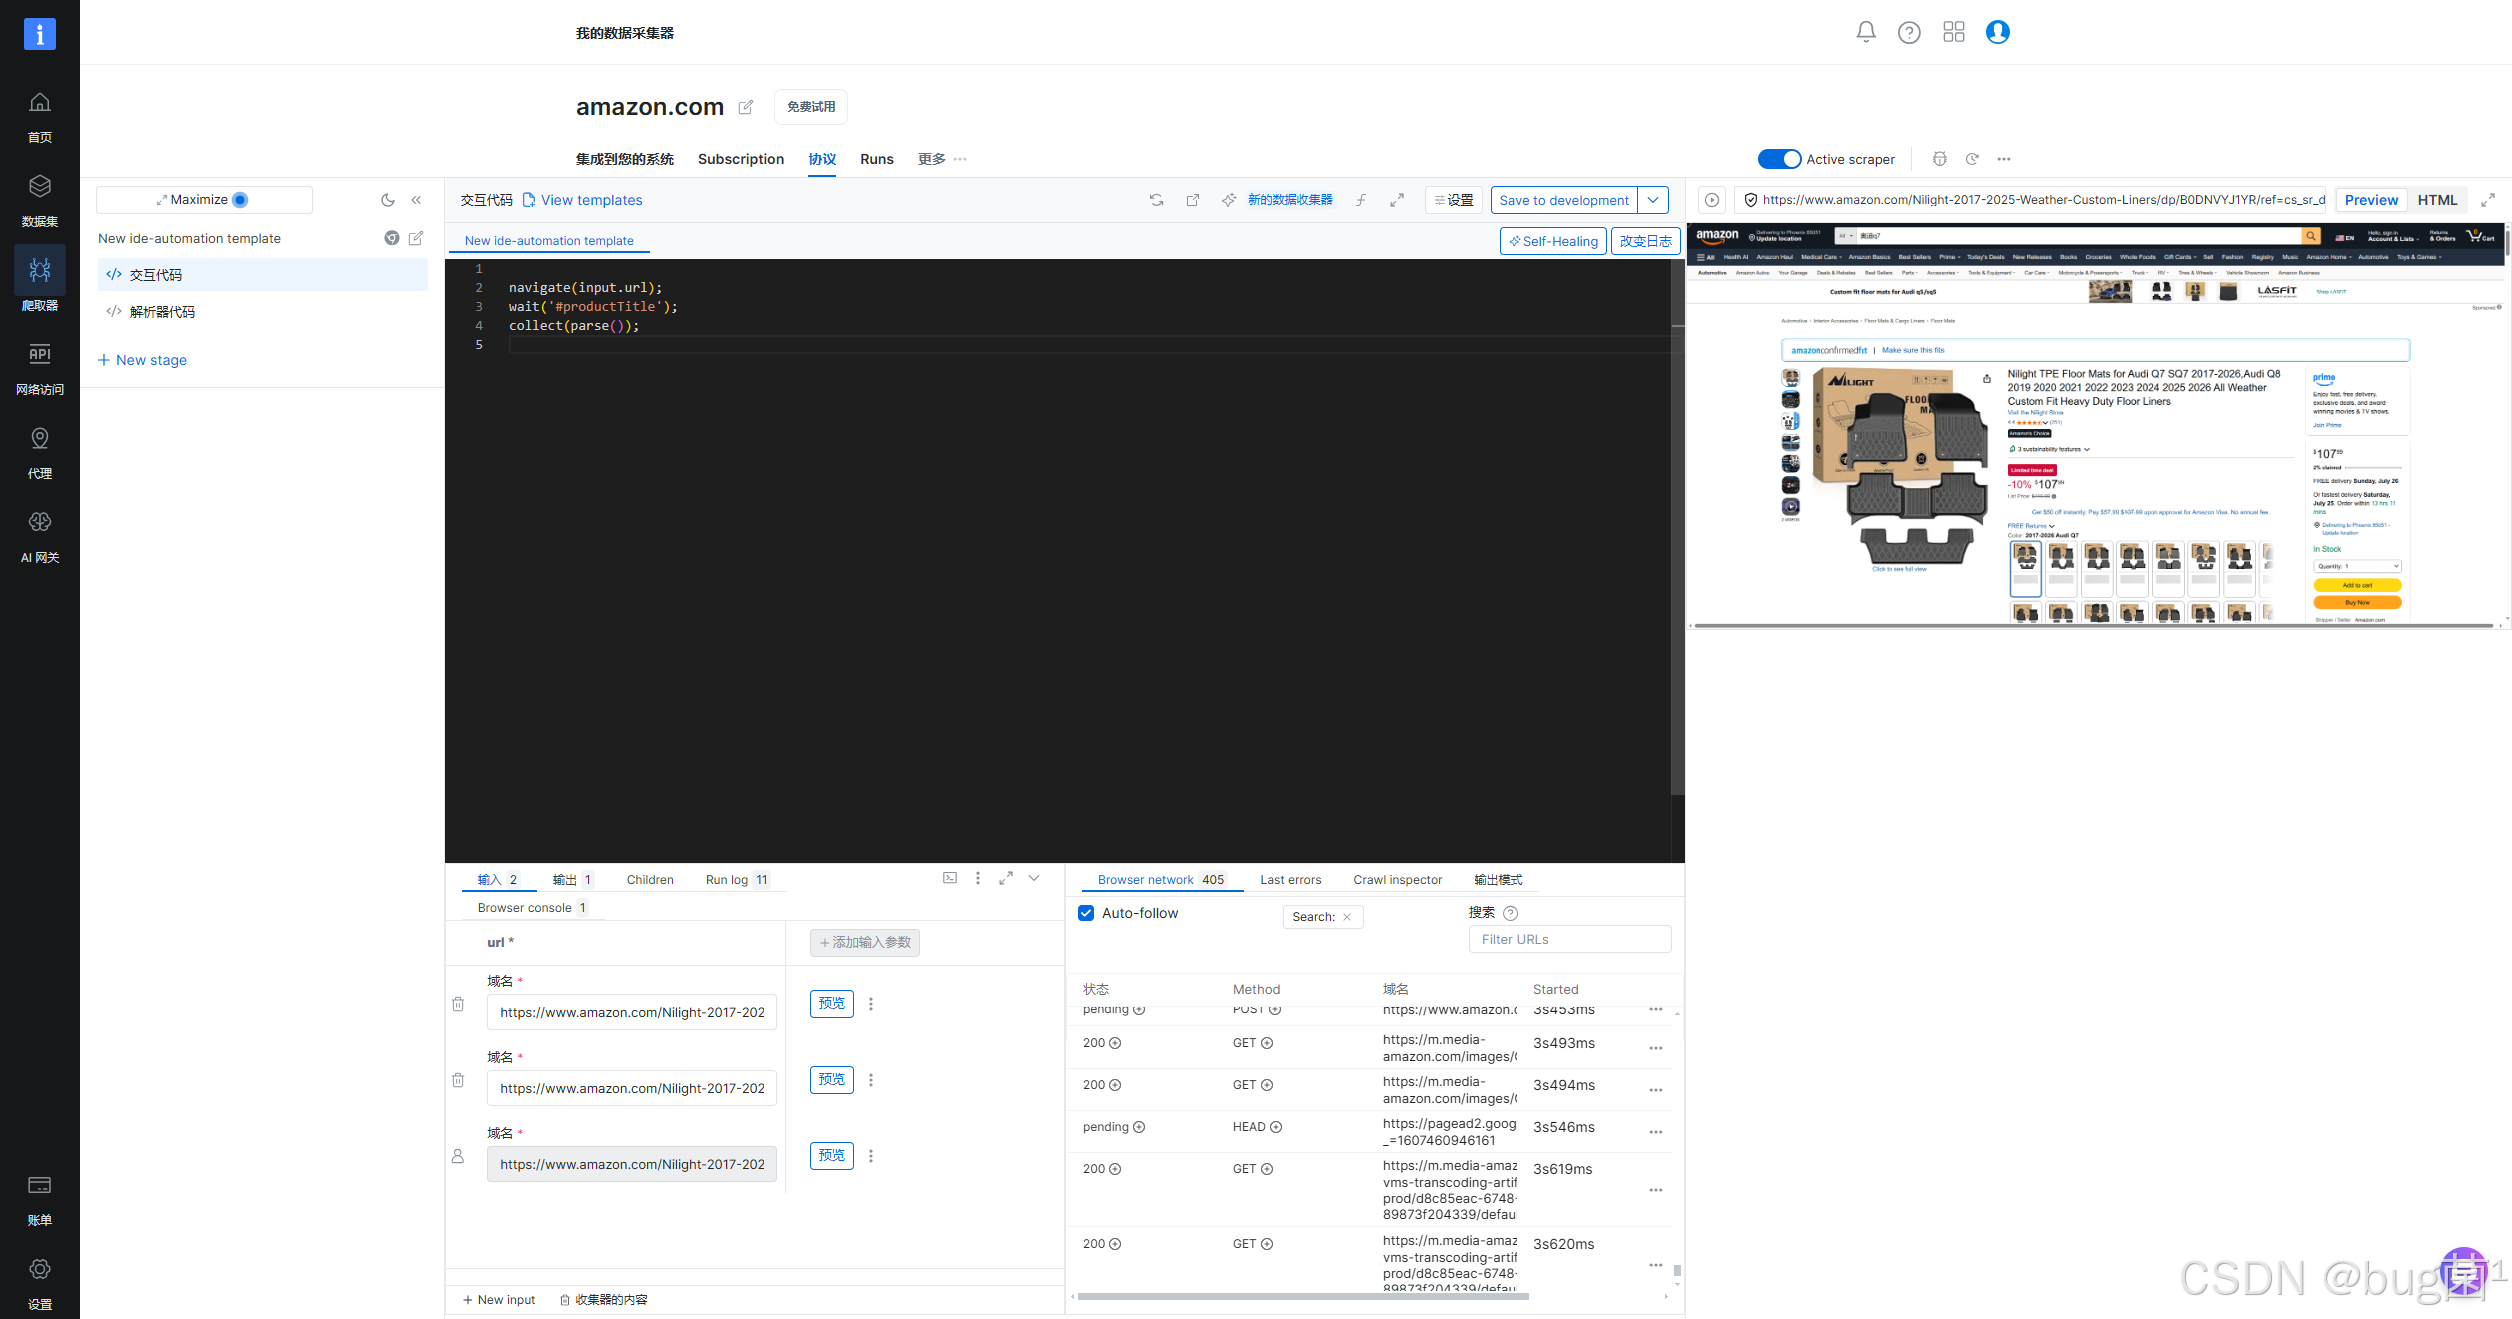
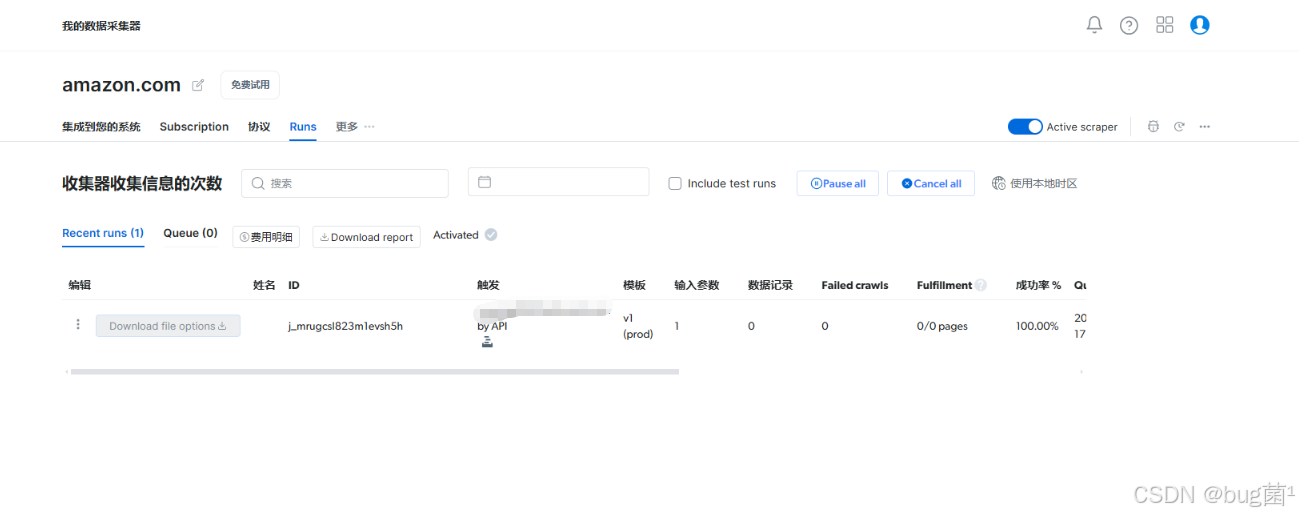
4.3 运行爬虫并查看结果
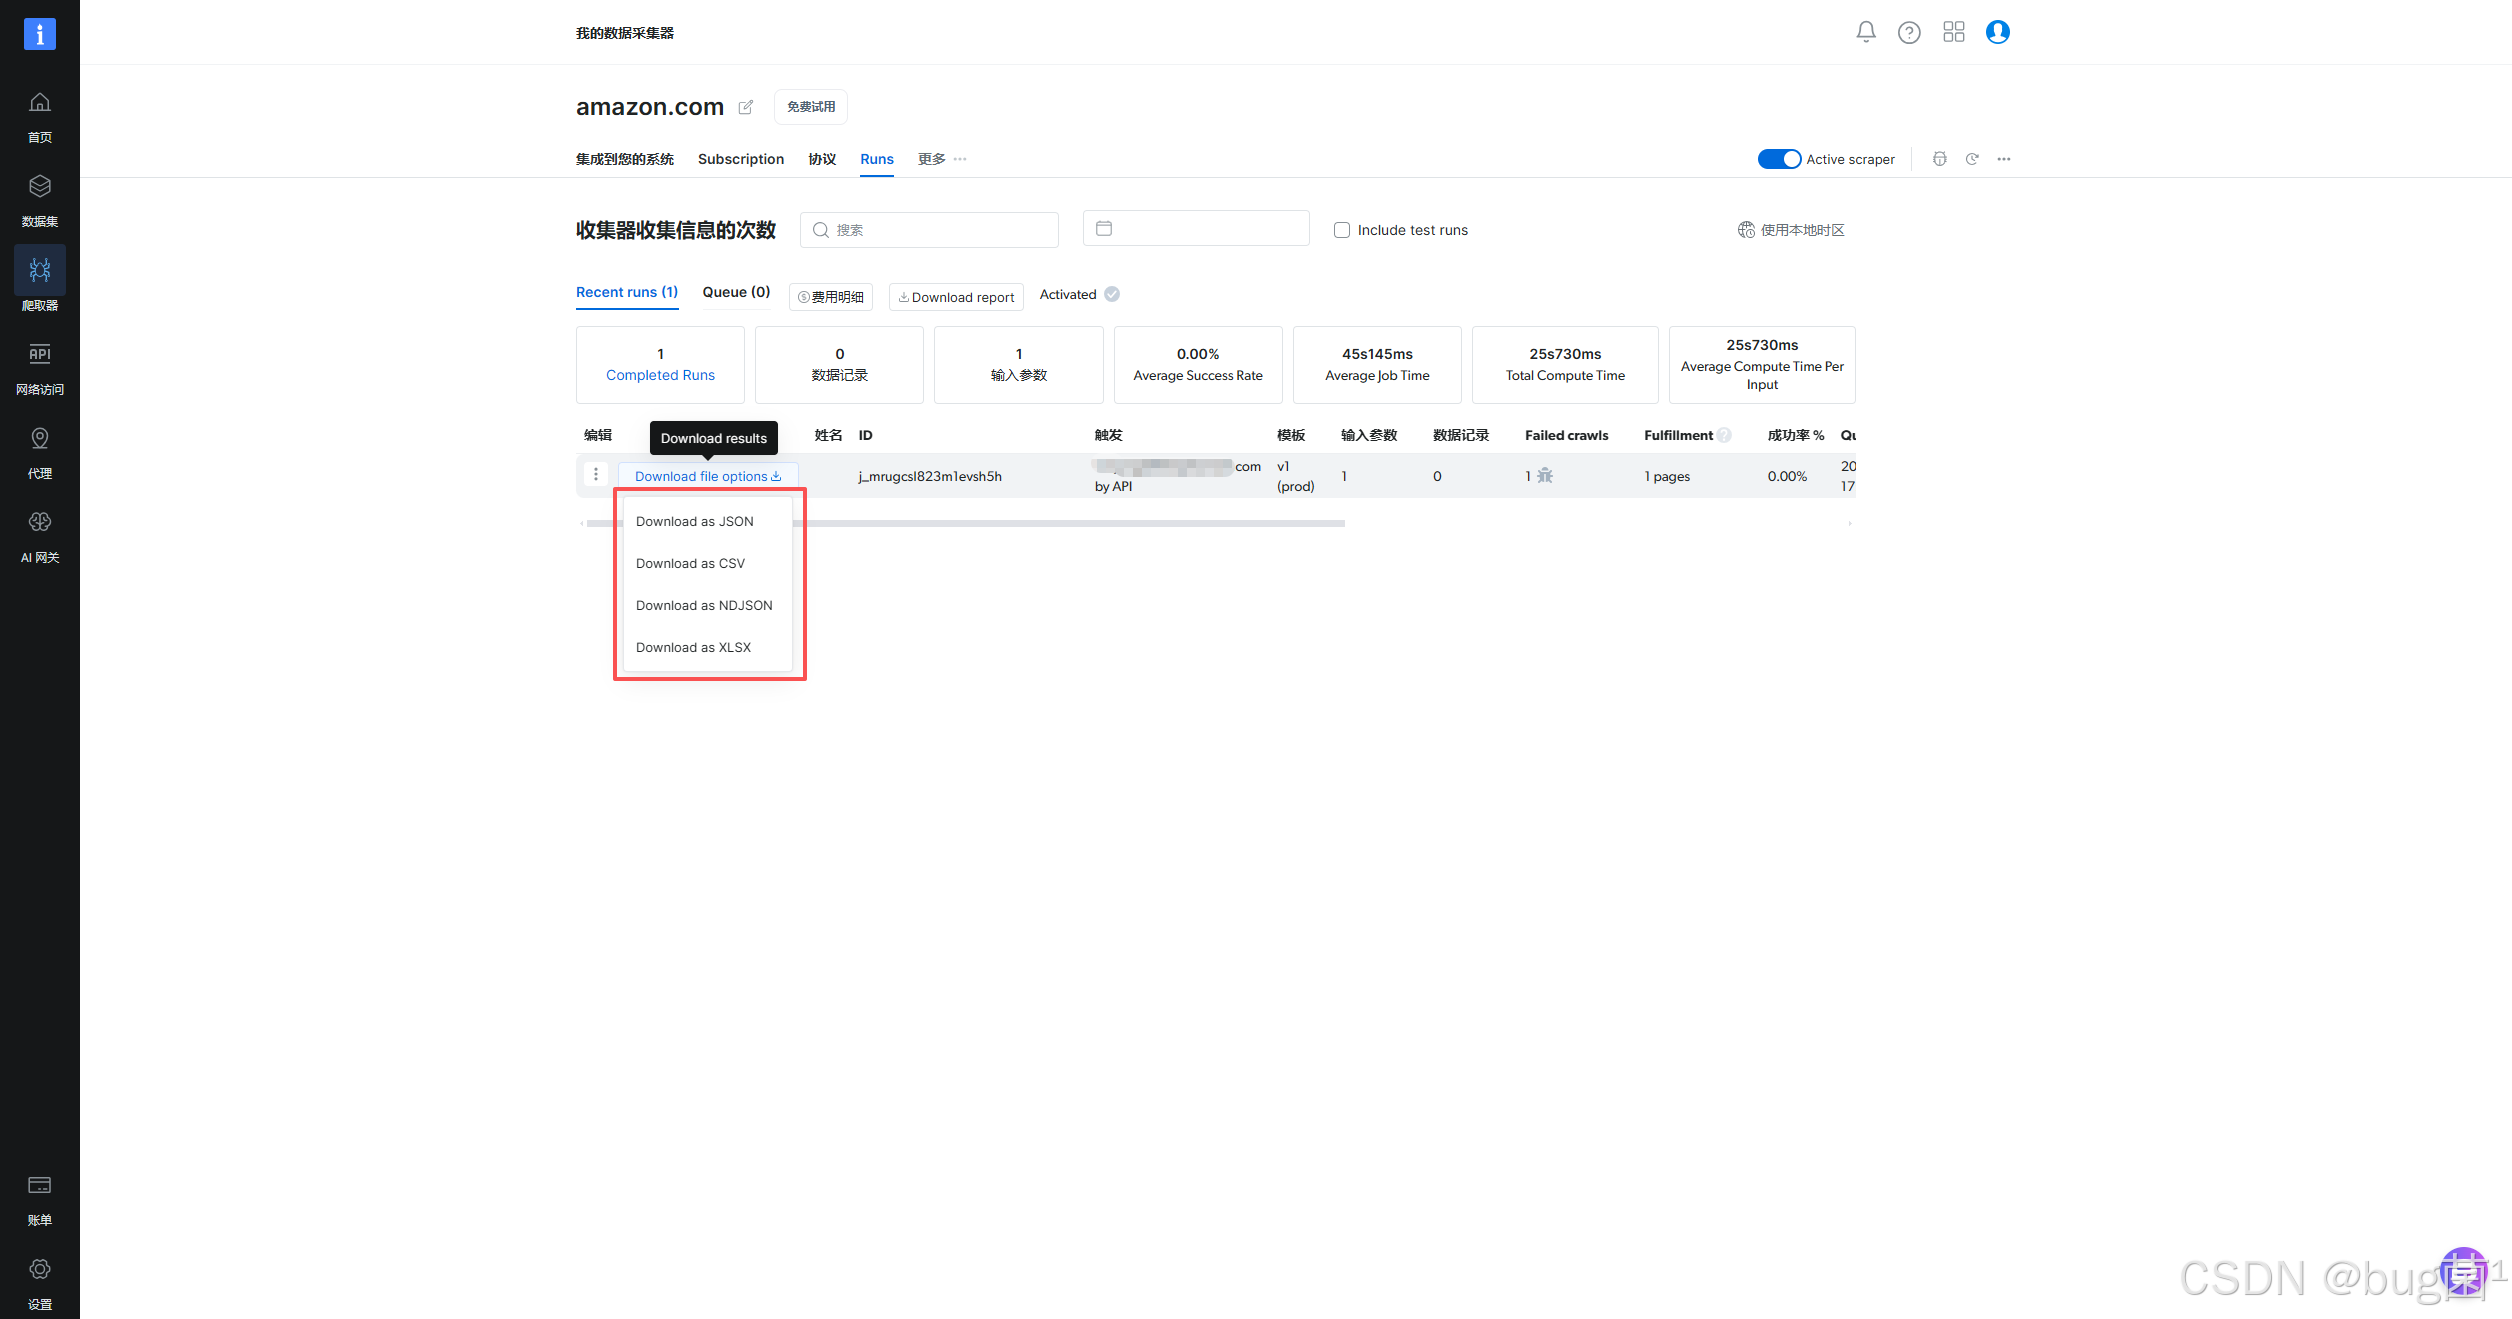
设置完基础设置后,我们最终点击"Start"按钮,脚本即将启动,我们可以在Runs界面查看采集结果及结果导出,可以爬虫状态是 Active,可以直接跑。跑完之后会自动切到 Runs 页,具体演示图如下:
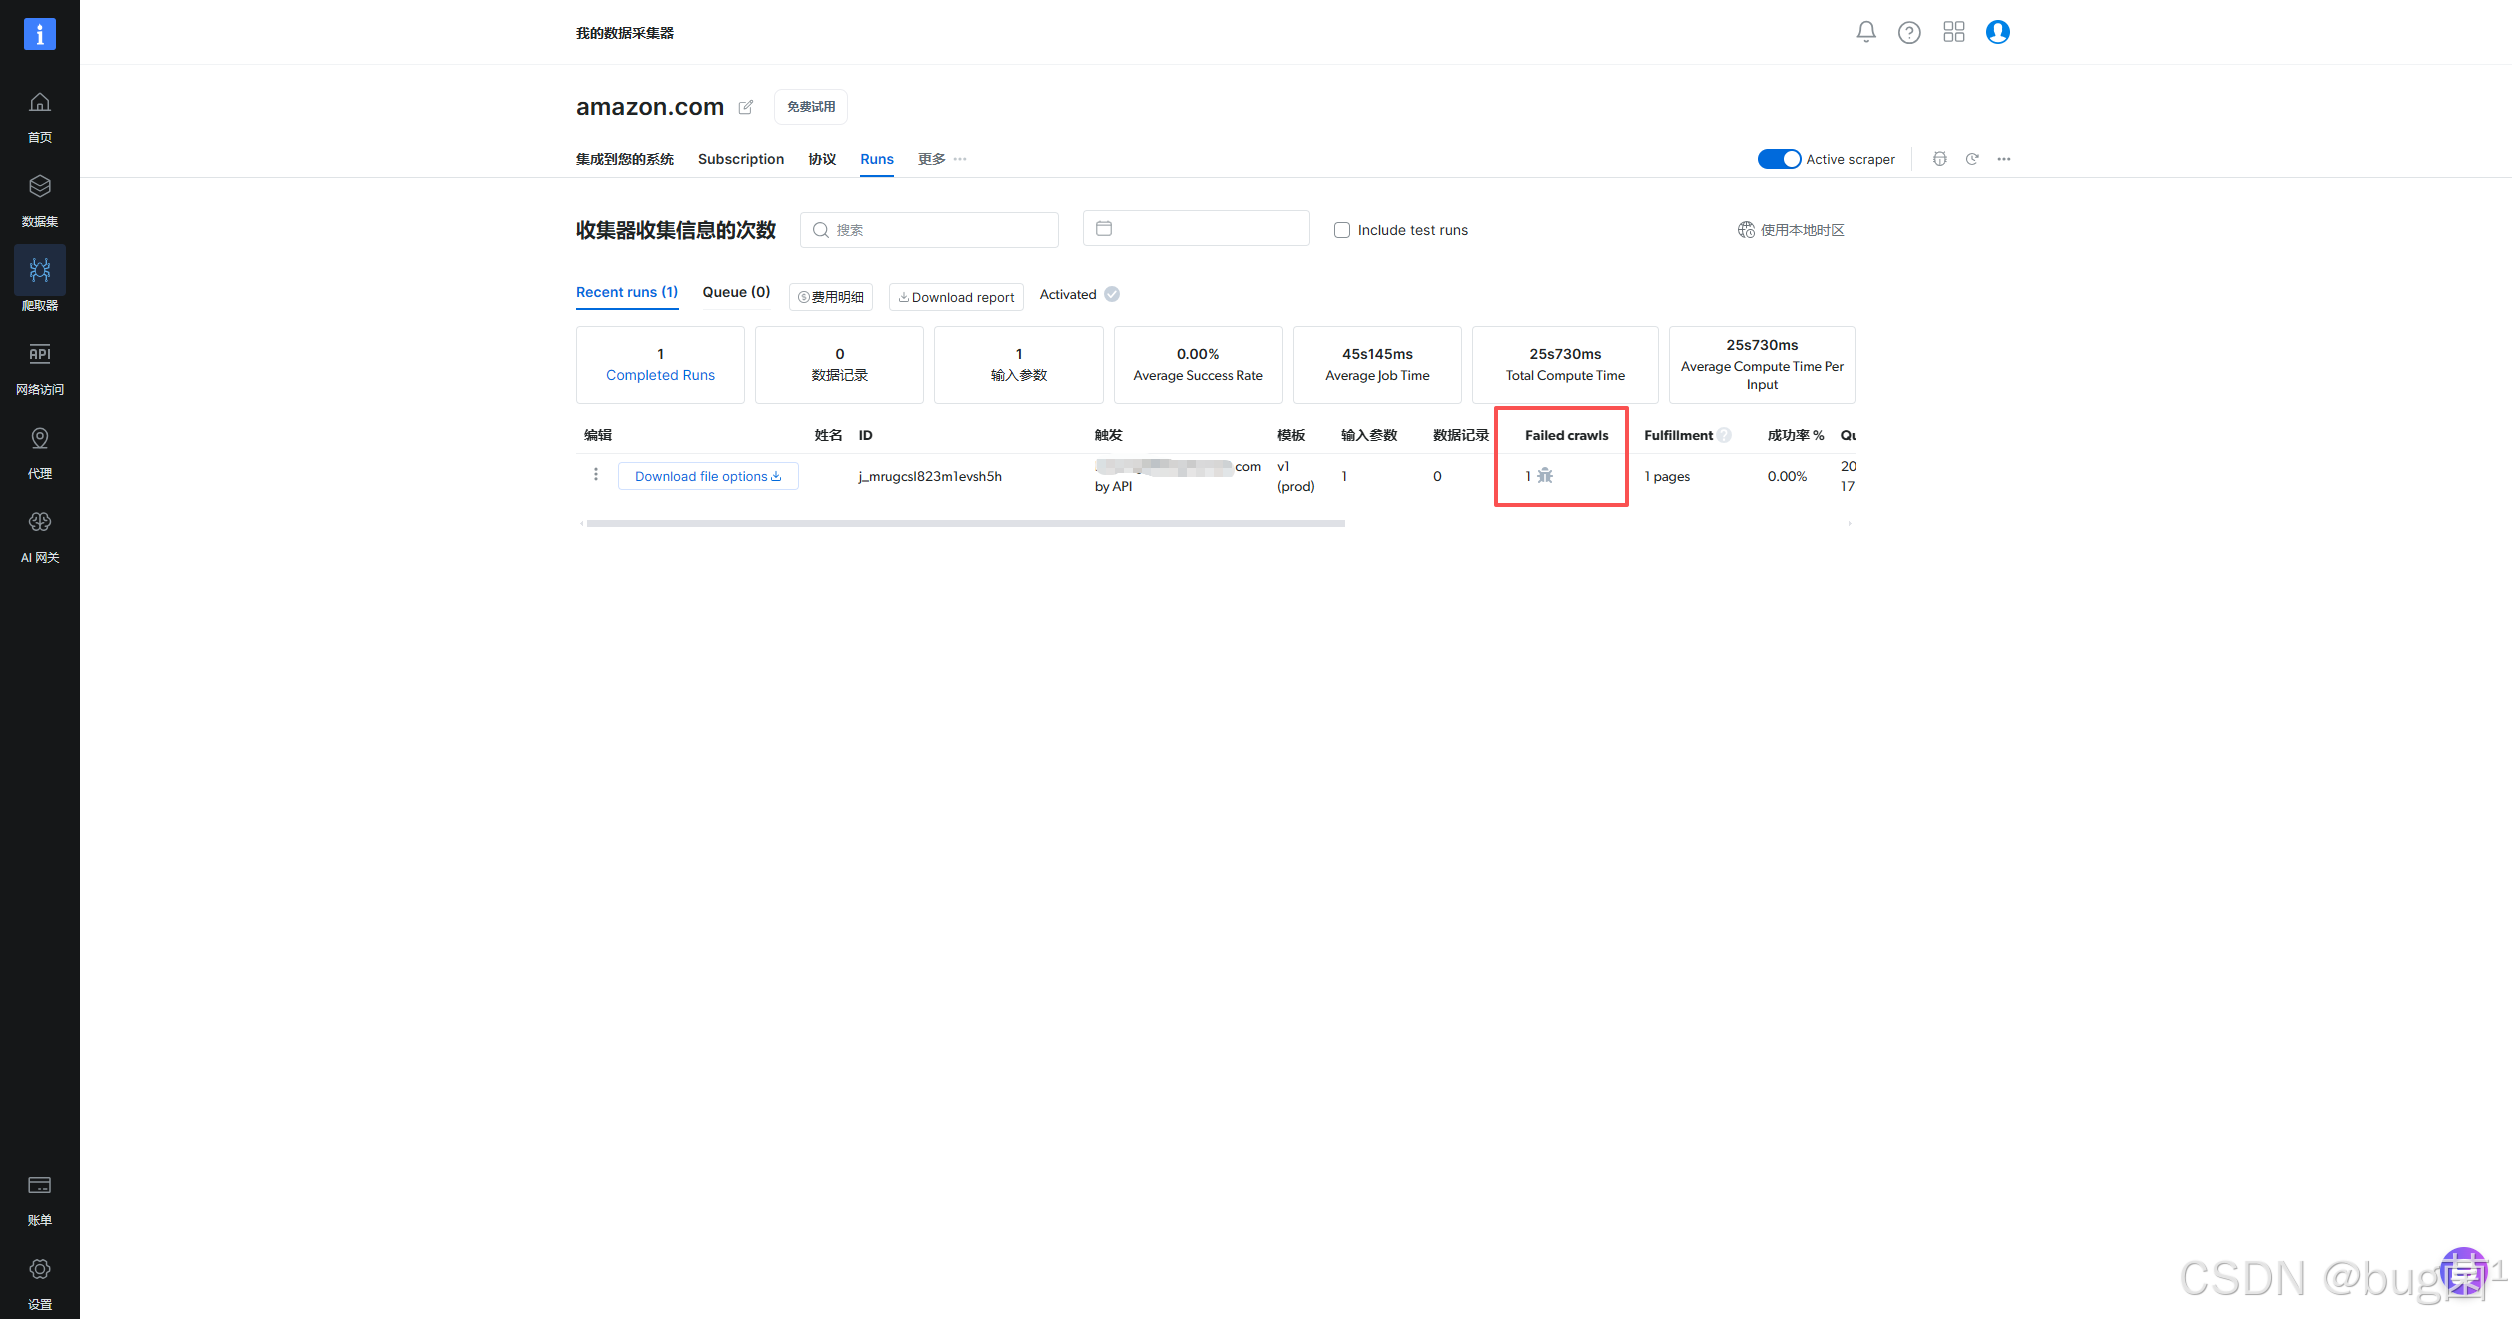
如果采集失败,则会提示Failed crawls为1,你也可以直接导出采集结果
4.4 数据输出示例
运行完成后,点击选择 CSV 格式导出。我们在设置交付偏好的时候,就可以直接选择文档格式。
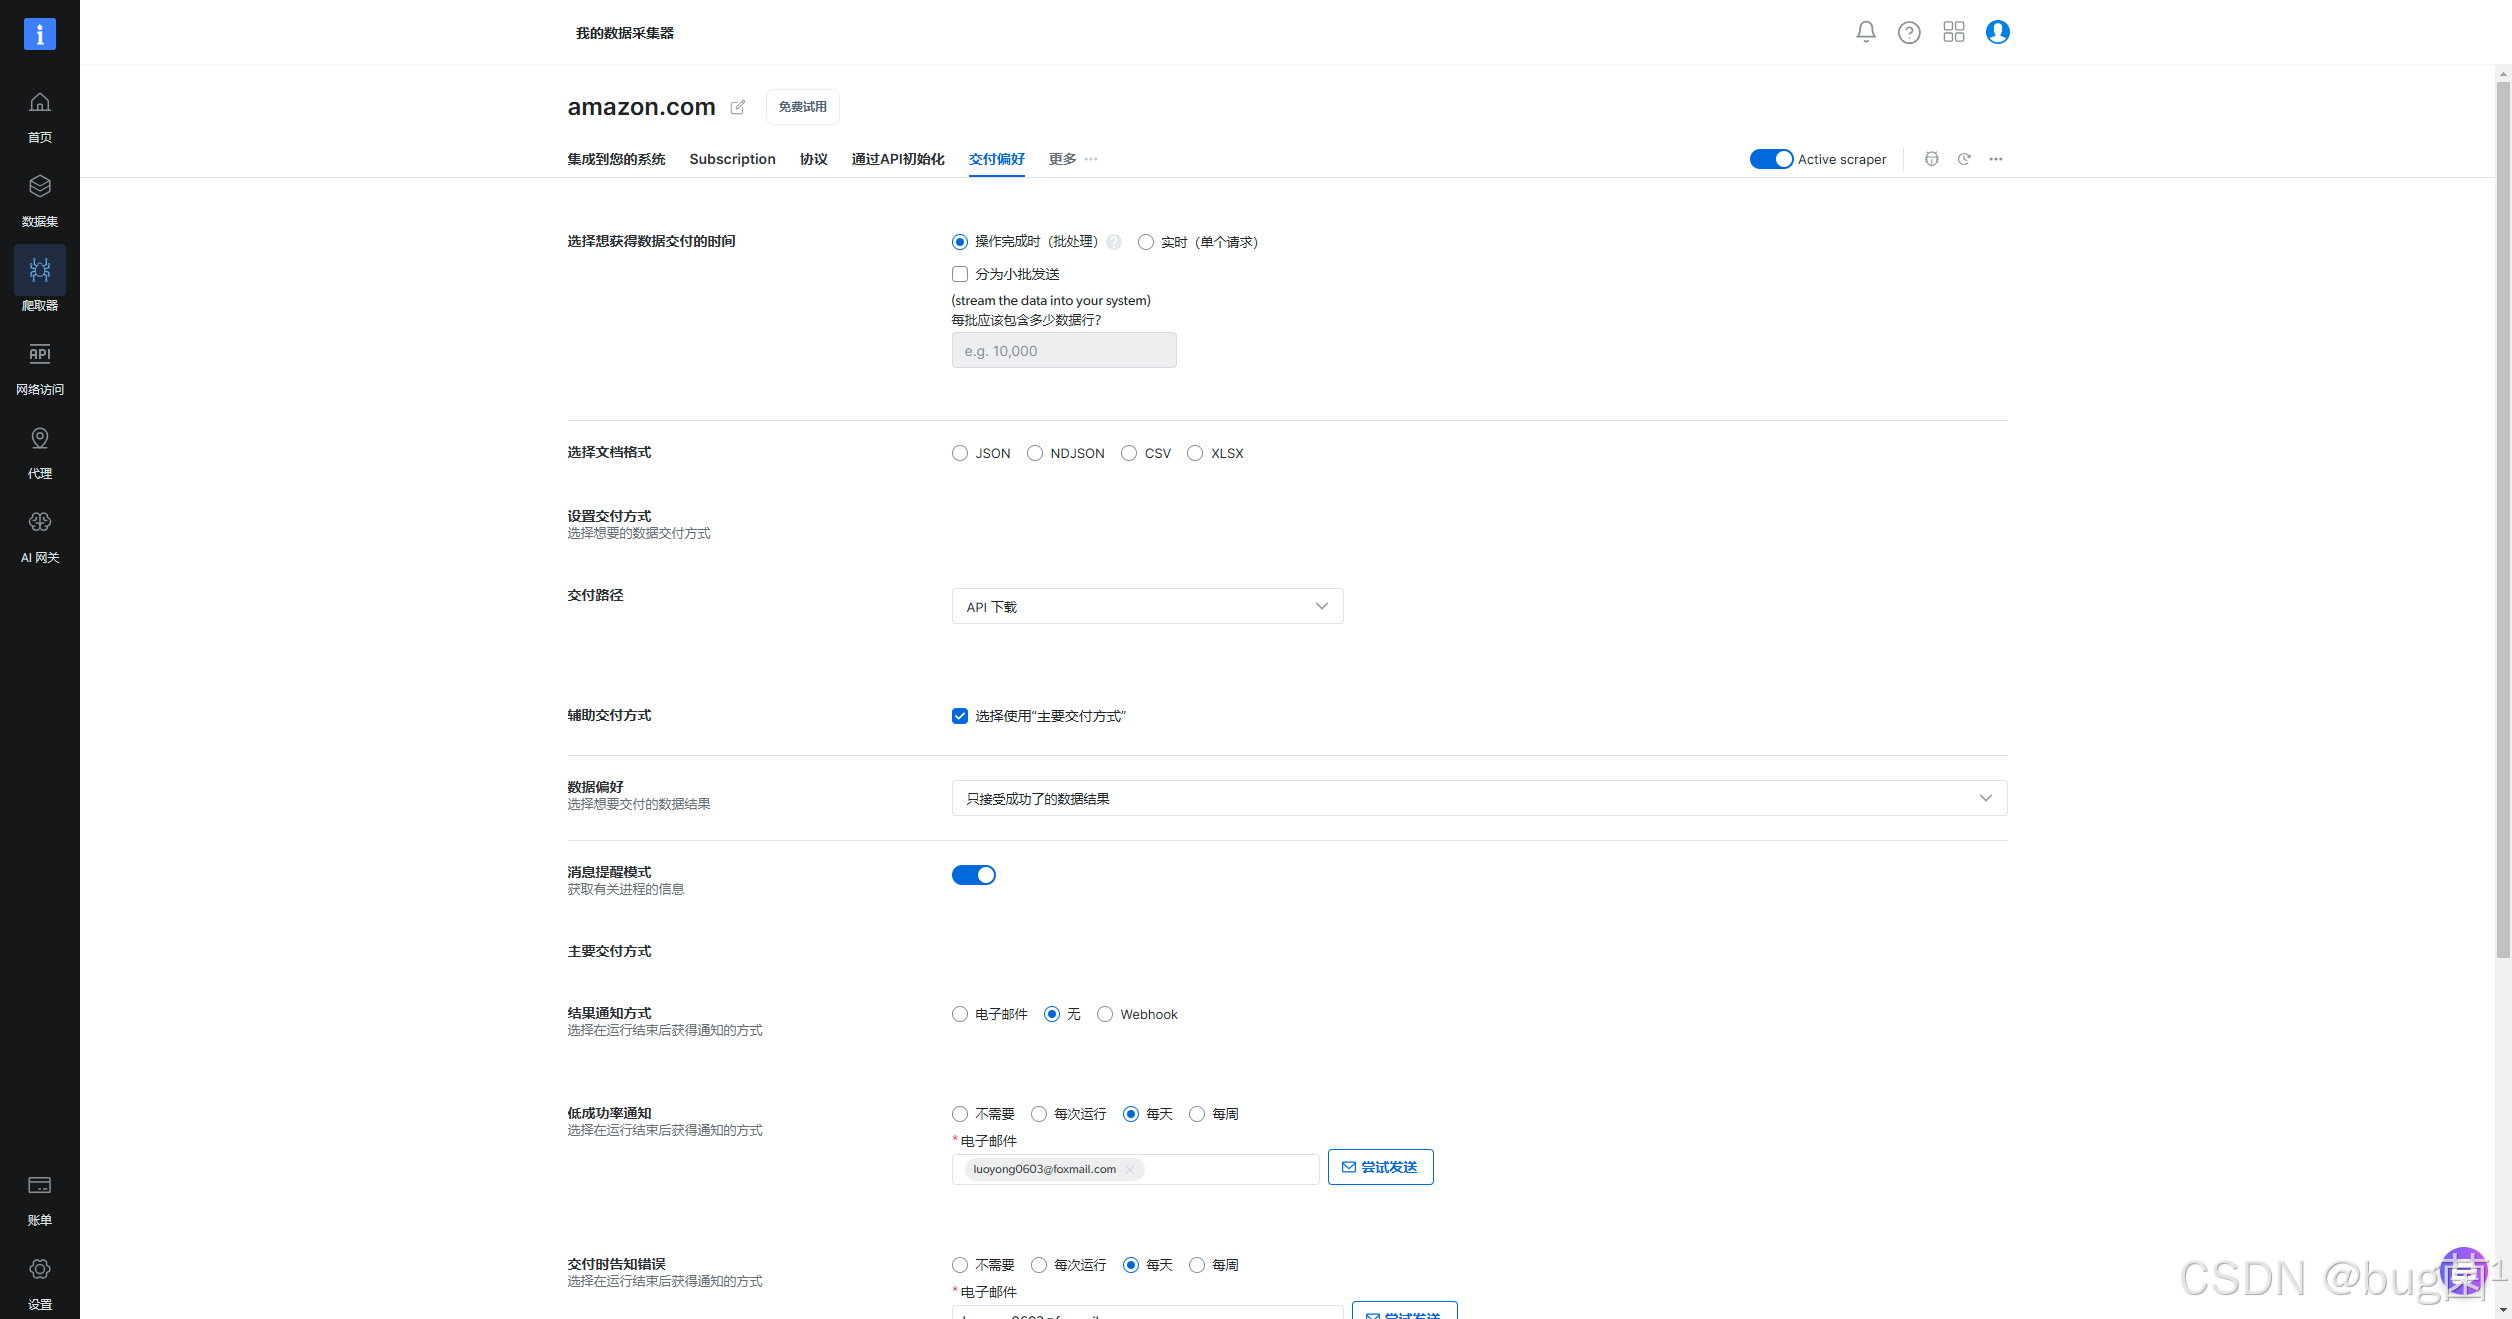
这里,我们直接选择以CSV格式导出。
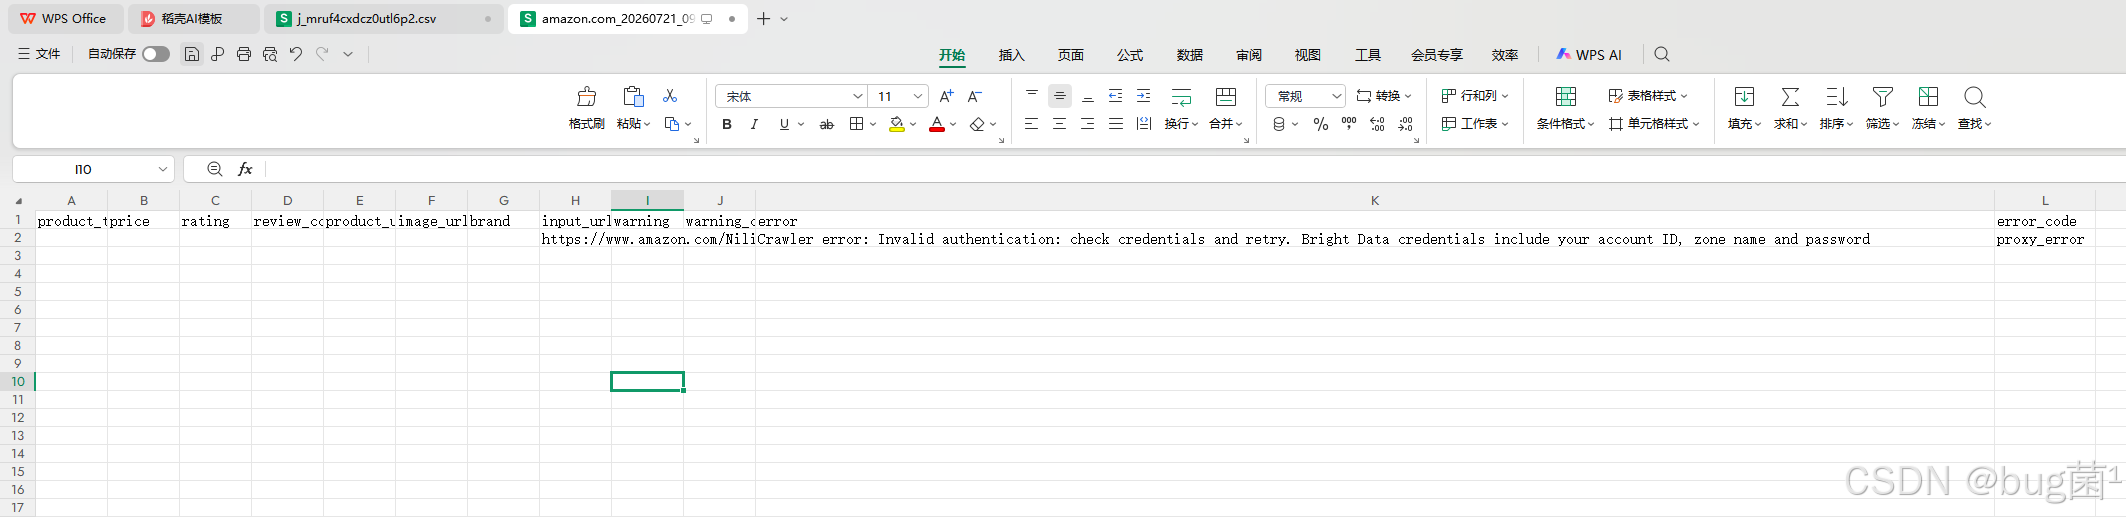
如下为具体的采集数据CSV格式文档截图展示:
如果你也希望把自己的网站采集流程自动化,可以直接复制本文思路,在 Scraper Studio 中创建自己的第一个数据管道。
五、自愈功能:维护成本的终结者
5.1 自愈是什么?
传统爬虫最大的痛点是维护成本。网站每次改版,你都需要:
-
发现爬虫失败(可能是几天后通过数据断流才注意到)
-
重新分析网站结构
-
修改选择器和解析逻辑
-
测试验证
-
重新部署
整个过程可能需要几小时到几天。如果你同时维护 10 个爬虫,这意味着大量的时间被浪费在"救火"上。
Scraper Studio 的 Self-Healing(自愈) 功能彻底改变了这一流程。当爬虫运行失败时,AI 会:
-
自动检测失败原因:是选择器失效?Schema 变化?还是反爬机制升级?
-
分析最新的页面结构:重新抓取目标页面,对比变化点
-
生成修复方案:自动重写失效的代码部分
-
提交给你审核:展示修改前后的代码对比,由你决定是否应用
整个过程从几小时压缩到几分钟,而且大部分工作由 AI 完成。
5.2 自愈功能实战
假设 Amazon 改版了商品价格的 HTML 结构,原来的选择器 .a-price .a-offscreen 失效了。
你会在控制台收到一条警告:
[Warning] Scraper "Amazon Laptop Search" failed on 15 requests
Error: Price field extraction returned null for 78% of items
Possible cause: DOM structure changed
点击"Fix with Self-Healing",进入修复流程:
Step 1:AI 分析问题
Analyzing 15 failed requests...
Found: Price selector '.a-price .a-offscreen' no longer exists
New structure detected: <span class="a-price-whole">449</span><span class="a-price-fraction">99</span>
Step 2:生成修复方案
AI 会展示代码对比:
- const priceEl = item.querySelector('.a-price .a-offscreen');
- current_price: parseFloat(priceEl?.textContent.replace(/[^0-9.]/g, '')),

+ const wholeEl = item.querySelector('.a-price-whole');
+ const fractionEl = item.querySelector('.a-price-fraction');
+ current_price: wholeEl && fractionEl ?
+   parseFloat(`${wholeEl.textContent}.${fractionEl.textContent}`) : null,
Step 3:审核并应用
你可以:
-
直接点击"Apply Fix"应用修复
-
点击"Edit Code"手动调整后再应用
-
点击"Reject"拒绝修复,自己重新编写
应用后,爬虫会自动用失败的 URL 重新运行一次验证,确保修复生效。
5.3 CLI 方式触发自愈
如果你在本地使用 Bright Data CLI,可以通过命令行触发自愈:
# 检测爬虫健康状态
brightdata scraper health <collector_id>

# 输出示例:
# Collector: amazon_laptop_search (ID: abc123)
# Status: DEGRADED
# Success rate: 22% (last 100 runs)
# Issue detected: Price field extraction failing
# Self-healing available: Yes

# 触发自愈
brightdata scraper heal <collector_id>

# 输出示例:
# Analyzing failed requests...
# Fix generated: Updated price selector logic
# Preview changes at: https://studio.brightdata.com/scraper/abc123/heal/xyz789

# 审核通过后,应用修复
brightdata scraper heal approve <collector_id> <fix_id>
5.4 业务价值
根据 Bright Data 官方数据,启用自愈功能的爬虫,平均维护成本降低 83%。对于需要长期运行、监控多个网站的场景(如价格监控、竞品分析、市场情报),这意味着:
-
减少人工干预:从每周修复 3-5 次,降低到每月 1 次
-
缩短故障时间:从平均 4 小时恢复,缩短到 15 分钟
-
提高数据连续性:避免因爬虫失效导致的数据断流
固,你的网站结构经常改版?
Scraper Studio 的 Self-Healing 能自动检测采集失败并生成修复建议,大幅减少后续维护工作。
六、定时调度与数据交付
6.1 设置定时调度
在 Scraper Studio 中,点击"Schedule"标签,配置运行计划:
预设选项:
-
每小时运行一次
-
每天运行一次(可指定具体时间,如每天凌晨 2:00)
-
每周运行一次(可指定星期几)
-
每月运行一次
自定义 Cron 表达式:
如果需要更灵活的调度策略,可以使用 Cron 表达式。例如:
0 */6 * * * - 每 6 小时运行一次
0 9 * * 1-5 - 工作日每天早上 9 点运行
0 0 1 * * - 每月 1 号午夜运行
你还可以设置:
-
起始 URL 列表:每次运行时自动抓取多个 URL
-
输入参数:动态传递搜索关键词、分类 ID 等参数
-
停止条件:达到指定数据量后自动停止(避免过度抓取)
6.2 数据格式与交付
支持的输出格式:
-
JSON(默认):适合直接对接 API 或数据库
-
CSV:适合导入 Excel、Google Sheets 或 BI 工具
-
Parquet:适合大数据场景,压缩率高、查询性能好
交付集成:
Scraper Studio 原生支持以下交付目标:
| 目标类型 | 具体服务 | 配置说明 |
|---|---|---|
| 云存储 | Amazon S3、Google Cloud Storage、Azure Blob | 提供 Bucket 名称和访问密钥 |
| 数据仓库 | Google BigQuery、Snowflake、Databricks | 配置项目 ID、数据集、表名 |
| 实时推送 | Webhook | 提供 HTTP POST 端点 |
| 消息队列 | Kafka | 配置 Broker 地址和 Topic |
| 本地下载 | 控制台手动下载 | 支持按日期、运行 ID 筛选 |
配置示例:交付到 S3
{
  "delivery": {
    "type": "s3",
    "bucket": "my-data-pipeline",
    "path": "amazon/laptops/{date}/{run_id}.json",
    "region": "us-east-1",
    "access_key": "AKIAIOSFODNN7EXAMPLE",
    "secret_key": "wJalrXUtnFEMI/K7MDENG/bPxRfiCYEXAMPLEKEY"
  }
}
每次运行完成后,数据会自动上传到 S3,路径类似:
s3://my-data-pipeline/amazon/laptops/2026-01-15/run_20260115_102400.json
6.3 实际使用场景
场景 1:每日价格监控
配置:
-
调度:每天凌晨 2:00 运行
-
目标:抓取 Amazon 竞品列表(100 个 ASIN)
-
交付:CSV 格式发送到 Google Sheets(通过 Webhook 触发 Apps Script)
-
告警:如果检测到价格变动超过 10%,发送 Slack 通知
场景 2:市场情报周报
配置:
-
调度:每周一早上 9:00 运行
-
目标:抓取 10 个竞品的产品列表、新品上架、促销活动
-
交付:Parquet 格式写入 BigQuery
-
自动化:BigQuery 中的 SQL 脚本自动生成周报,发送给业务团队
场景 3:AI Agent 数据源
配置:
-
调度:按需触发(通过 API)
-
目标:根据用户查询动态抓取商品数据
-
交付:JSON 格式实时返回(同步模式)
-
集成:与 LangChain / LlamaIndex 集成,为 AI Agent 提供最新数据
七、进阶:通过 CLI 或 API 触发
对于需要将爬虫集成到现有系统的开发者,Scraper Studio 提供了完整的 CLI 和 REST API 支持。
7.1 安装 Bright Data CLI
# 通过 npm 安装
npm install -g @brightdata/cli

# 或通过 yarn 安装
yarn global add @brightdata/cli

# 验证安装
brightdata --version
首次使用需要登录:
brightdata login
# 输入你的 Bright Data 账号邮箱和密码
# 登录成功后,CLI 会自动保存 API Token
7.2 CLI 基本操作
查看所有爬虫列表:
brightdata scraper list

# 输出示例:
# ID            Name                      Status    Last Run
# abc123        amazon_laptop_search      Active    2026-01-15 10:24:00
# def456        ebay_watch_monitor        Active    2026-01-14 22:00:00
# ghi789        walmart_price_tracker     Paused    2026-01-13 08:30:00
获取爬虫详情:
brightdata scraper get <collector_id>

# 输出 JSON 格式的完整配置
手动触发运行:
brightdata scraper run <collector_id> \
  --input '{"url": "https://www.amazon.com/s?k=laptop"}' \
  --format json \
  --output ./results.json
查看运行历史:
brightdata scraper runs <collector_id> --limit 10

# 输出示例:
# Run ID        Start Time           Status     Records  Duration
# run_001       2026-01-15 10:23:45  Success    108      2m 15s
# run_002       2026-01-14 10:23:30  Success    105      2m 08s
# run_003       2026-01-13 10:23:15  Failed     0        0m 32s
下载运行结果:
brightdata scraper download <collector_id> <run_id> \
  --format csv \
  --output ./amazon_laptops_20260115.csv
7.3 CLI 爬虫触发脚本示例
创建一个名为 scraper-run.sh 的脚本,用于自动化触发爬虫并处理结果:
#!/bin/bash

# scraper-run.sh - 自动触发 Scraper Studio 爬虫并处理结果
# 使用方法:./scraper-run.sh <collector_id> <search_keyword>

set -e

# 参数检查
if [ $# -lt 2 ]; then
  echo "用法: $0 <collector_id> <search_keyword>"
  echo "示例: $0 abc123 laptop"
  exit 1
fi

COLLECTOR_ID=$1
KEYWORD=$2
TIMESTAMP=$(date +%Y%m%d_%H%M%S)
OUTPUT_DIR="./scraper_results"
OUTPUT_FILE="${OUTPUT_DIR}/${KEYWORD}_${TIMESTAMP}.json"

# 创建输出目录
mkdir -p "$OUTPUT_DIR"

echo "========================================="
echo "Bright Data Scraper 自动运行脚本"
echo "========================================="
echo "爬虫 ID: $COLLECTOR_ID"
echo "关键词: $KEYWORD"
echo "时间戳: $TIMESTAMP"
echo ""

# 构建输入参数
INPUT_JSON=$(cat <<EOF
{
  "url": "https://www.amazon.com/s?k=${KEYWORD}",
  "max_results": 100
}
EOF
)

echo "正在触发爬虫运行..."
RUN_ID=$(brightdata scraper run "$COLLECTOR_ID" \
  --input "$INPUT_JSON" \
  --format json \
  --wait \
  --output "$OUTPUT_FILE" | grep -oP 'Run ID: \K[a-zA-Z0-9_]+')

echo "运行 ID: $RUN_ID"
echo ""

# 等待运行完成(如果没有使用 --wait 参数)
echo "等待爬虫完成..."
while true; do
  STATUS=$(brightdata scraper status "$COLLECTOR_ID" "$RUN_ID" --json | jq -r '.status')

  if [ "$STATUS" == "completed" ]; then
    echo "✓ 爬虫运行完成"
    break
  elif [ "$STATUS" == "failed" ]; then
    echo "✗ 爬虫运行失败"
    exit 1
  else
    echo "  状态: $STATUS (等待中...)"
    sleep 10
  fi
done

# 获取运行统计
echo ""
echo "========================================="
echo "运行统计"
echo "========================================="
brightdata scraper stats "$COLLECTOR_ID" "$RUN_ID"

# 下载结果
echo ""
echo "正在下载结果到: $OUTPUT_FILE"
brightdata scraper download "$COLLECTOR_ID" "$RUN_ID" \
  --format json \
  --output "$OUTPUT_FILE"

# 数据质量检查
echo ""
echo "========================================="
echo "数据质量检查"
echo "========================================="
RECORD_COUNT=$(jq '. | length' "$OUTPUT_FILE")
NULL_PRICE_COUNT=$(jq '[.[] | select(.current_price == null)] | length' "$OUTPUT_FILE")
NULL_TITLE_COUNT=$(jq '[.[] | select(.title == null or .title == "")] | length' "$OUTPUT_FILE")

echo "总记录数: $RECORD_COUNT"
echo "缺失价格: $NULL_PRICE_COUNT"
echo "缺失标题: $NULL_TITLE_COUNT"

if [ "$NULL_PRICE_COUNT" -gt $((RECORD_COUNT / 10)) ]; then
  echo "⚠ 警告: 超过 10% 的记录缺失价格数据"
fi

# 生成 CSV 版本
CSV_FILE="${OUTPUT_DIR}/${KEYWORD}_${TIMESTAMP}.csv"
echo ""
echo "生成 CSV 格式: $CSV_FILE"
jq -r '(.[0] | keys_unsorted) as $keys | $keys, map([.[ $keys[] ]])[] | @csv' "$OUTPUT_FILE" > "$CSV_FILE"

echo ""
echo "========================================="
echo "✓ 完成!结果已保存到:"
echo "  JSON: $OUTPUT_FILE"
echo "  CSV:  $CSV_FILE"
echo "========================================="
使用示例:
chmod +x scraper-run.sh

# 抓取笔记本电脑数据
./scraper-run.sh abc123 laptop

# 抓取耳机数据
./scraper-run.sh abc123 headphones
八、定价与成本分析
8.1 计费模型
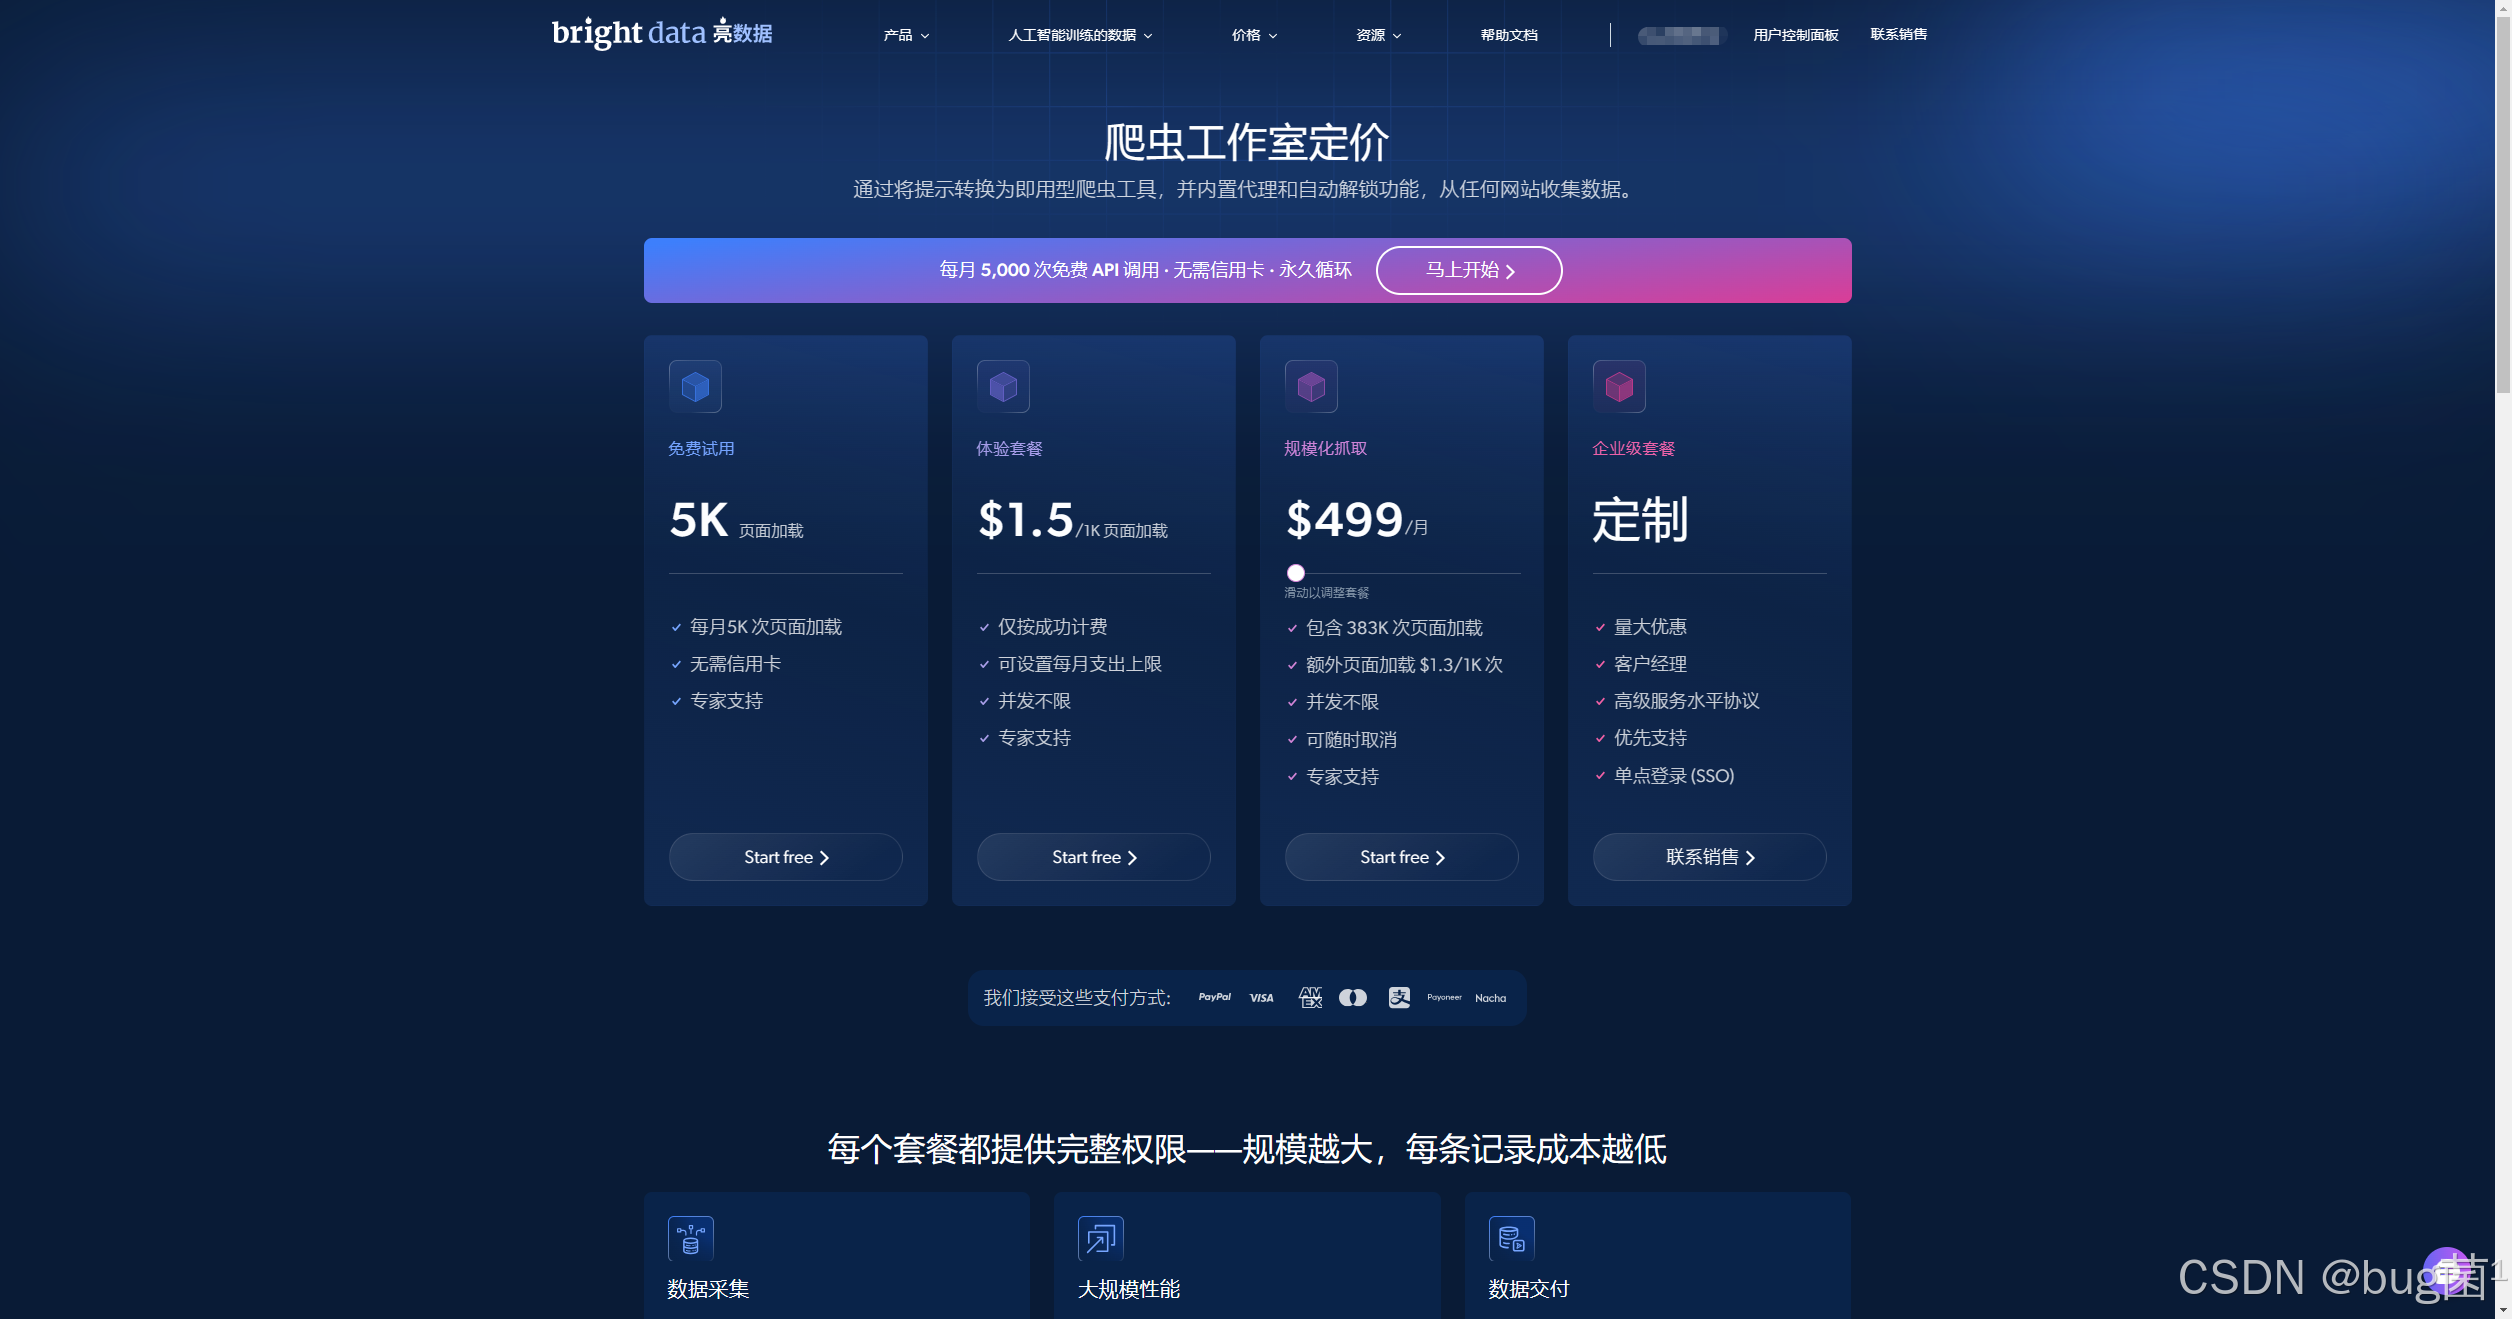
Bright Data Scraper Studio 采用按量计费模式,基于 页面加载次数(Page Loads) 收费。
定价标准(2026 年 1 月):
-
基础价格:$1.50 / 1,000 页面加载
-
使用量越大,单价越低(阶梯定价)
| 月度使用量 | 单价(每 1,000 次) | 折扣 |
|---|---|---|
| 0 - 100K | $1.50 | - |
| 100K - 1M | $1.20 | 20% |
| 1M - 10M | $0.90 | 40% |
| 10M+ | 定制报价 | 最高 60% |
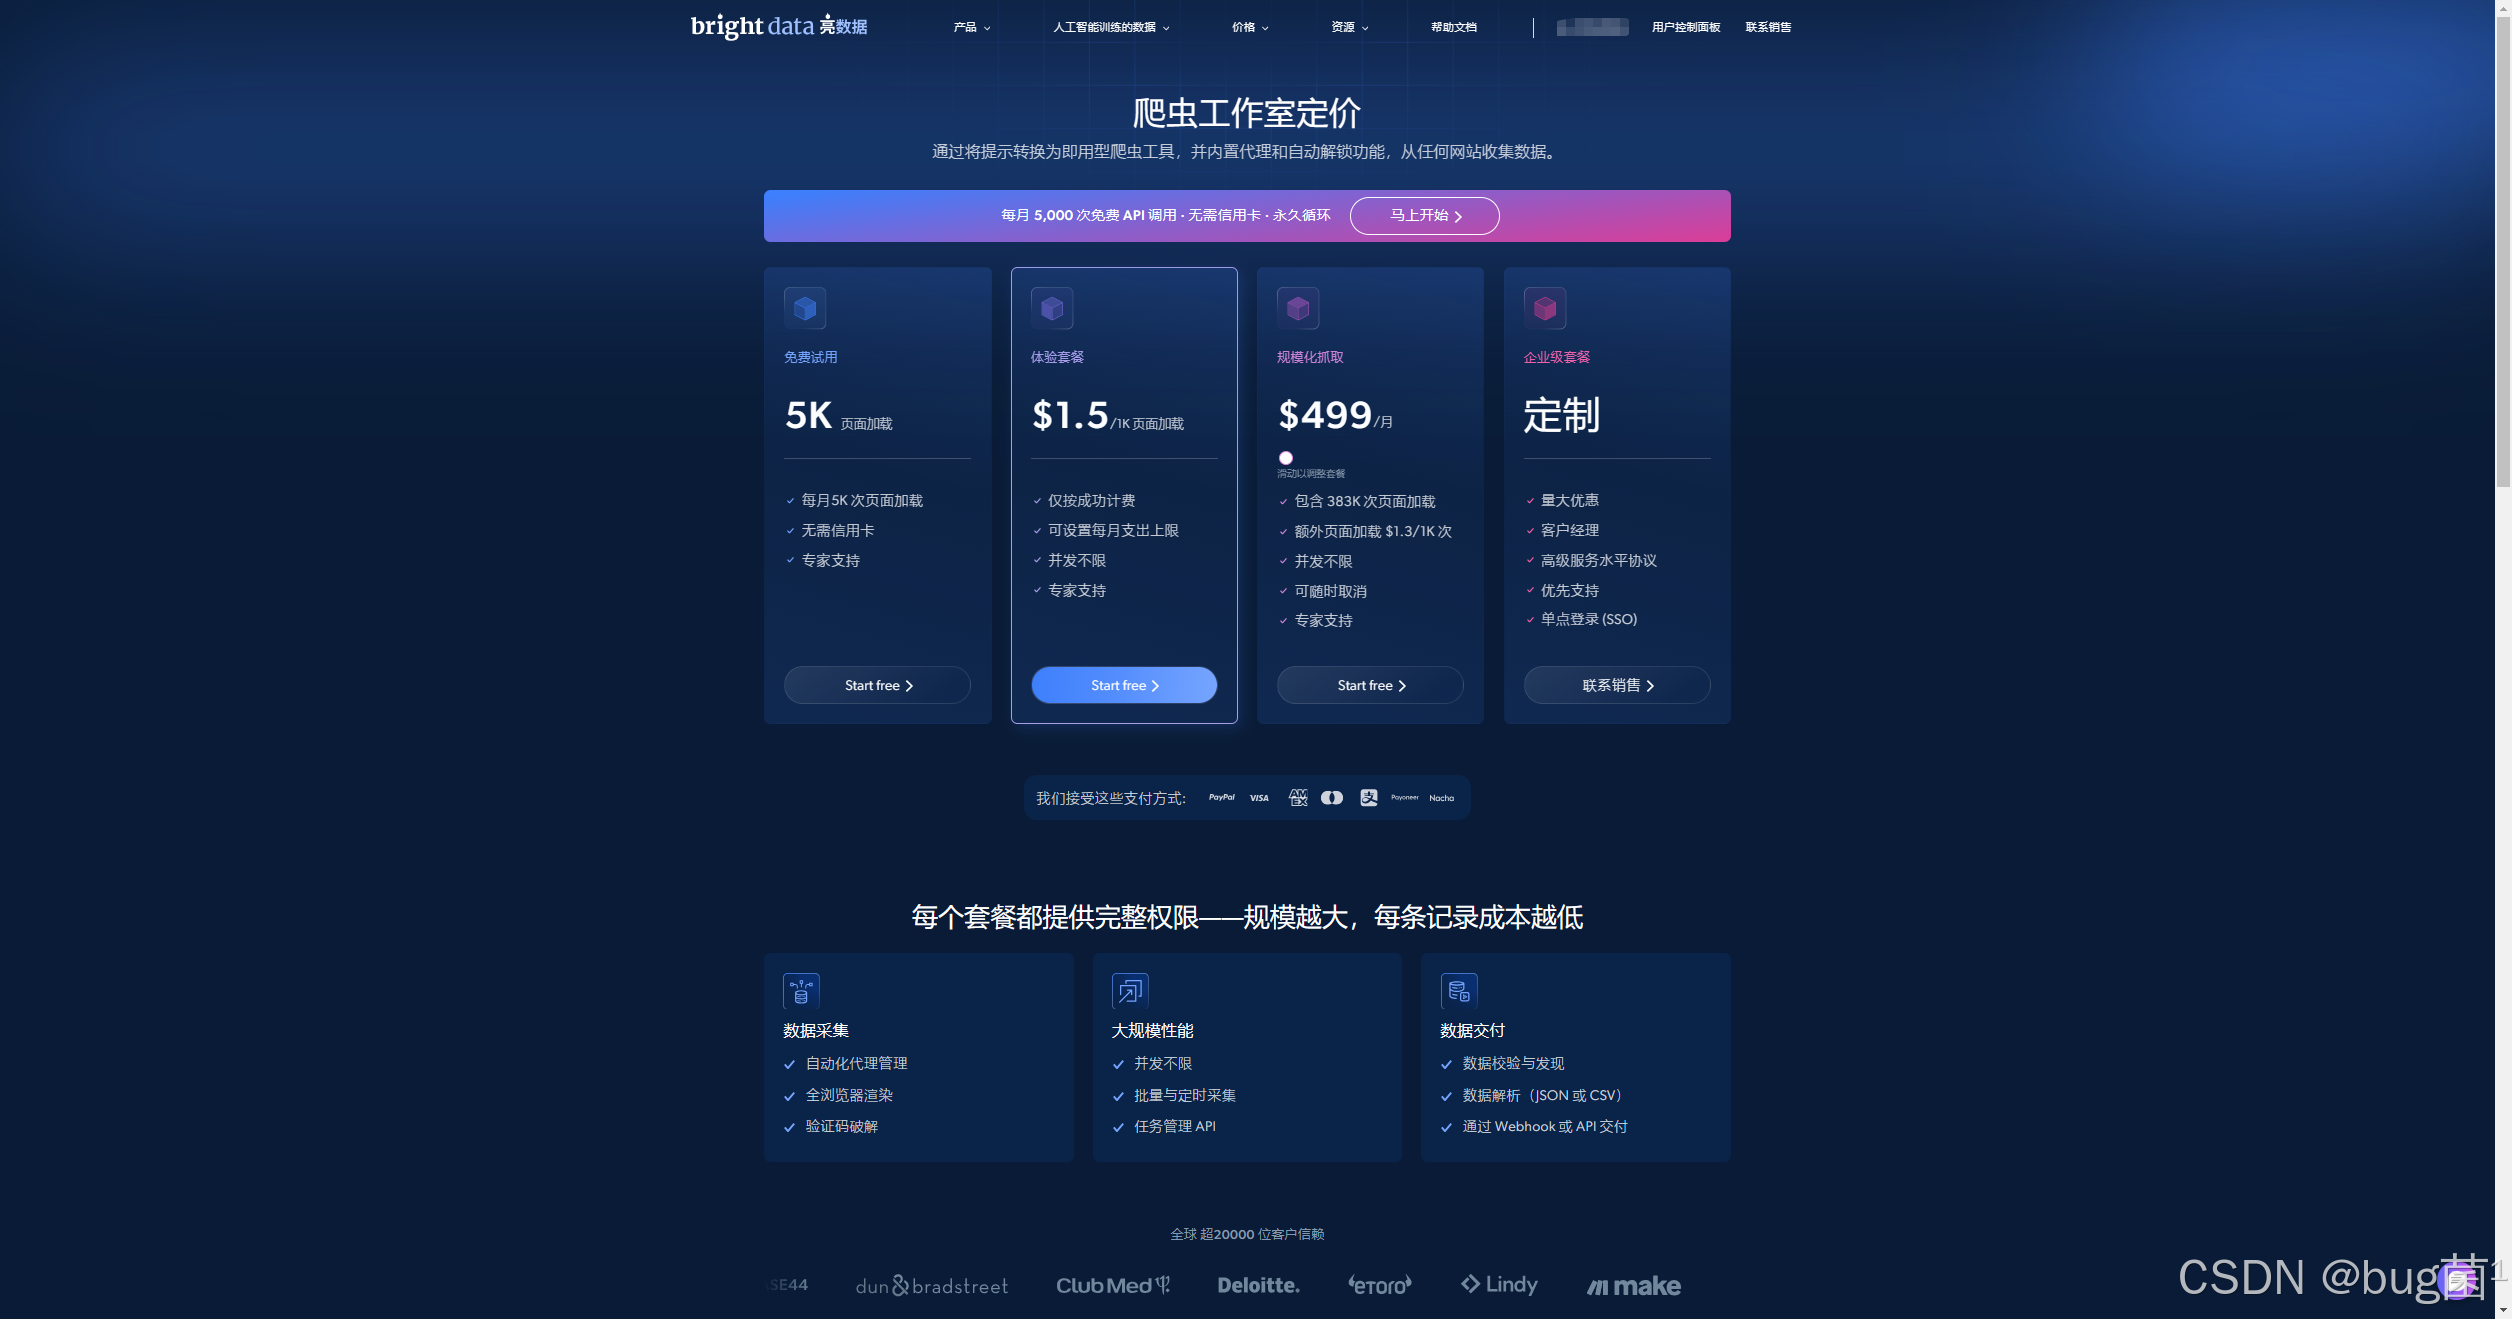
具体可以参考官网主页价格列表:
什么算一次页面加载?
-
访问一个 URL 并成功加载页面 = 1 次
-
翻页到下一页 = 1 次
-
如果页面加载失败并自动重试,只计费成功的那次
代理费用:
-
住宅 IP 代理:包含在页面加载费用中
-
数据中心 IP:免费(但成功率较低)
8.2 成本估算示例
案例 1:每日价格监控(100 个 SKU)
-
每天抓取 100 个商品页面
-
每月运行 30 天
-
月度页面加载:100 × 30 = 3,000 次
-
月度成本:3,000 / 1,000 × $1.50 = $4.50
案例 2:竞品分析(10 个竞品网站)
-
每个网站每周抓取 500 个页面(需翻页)
-
每周运行 1 次
-
月度页面加载:10 × 500 × 4 = 20,000 次
-
月度成本:20,000 / 1,000 × $1.50 = $30
案例 3:大规模数据采集(电商全量库存)
-
每天抓取 50,000 个商品页面
-
每月运行 30 天
-
月度页面加载:50,000 × 30 = 1,500,000 次
-
月度成本:1,500,000 / 1,000 × $1.20 = $1,800(享受 20% 折扣)
8.3 与自建方案的成本对比
假设你需要维护一个中等规模的爬虫系统(月度 100 万次页面加载):
自建方案成本:
| 项目 | 月度成本 |
|---|---|
| 云服务器(4 核 16G,3 台用于负载均衡) | $300 |
| 住宅代理(10M 带宽) | $500 |
| CAPTCHA 解决服务 | $200 |
| 运维人力(0.5 人月) | $3,000 |
| 监控告警系统 | $50 |
| 总计 | $4,050 |
Scraper Studio 成本:
| 项目 | 月度成本 |
|---|---|
| 页面加载费用(1M 次 × $1.20) | $1,200 |
| 无需额外服务器 | $0 |
| 代理、CAPTCHA 已包含 | $0 |
| 无需专职运维 | $0 |
| 总计 | $1,200 |
节省 70% 成本,同时获得更高的稳定性和自动化能力。
8.4 优惠与折扣
1. 新用户优惠
-
免费 5,000 次页面加载/月(永久循环)
-
首次充值 1:1 匹配(最高 $500)
2. 专属折扣码
通过联盟链接注册,可获得额外折扣:使用该折扣码,可在标准价格基础上再享受 15% 优惠(适用于前 3 个月)。
3. 年度订阅折扣
一次性预付年费,可享受 25% 折扣。例如:
-
月度计划:$1,200/月 × 12 = $14,400
-
年度计划:$14,400 × 0.75 = $10,800(节省 $3,600)
如果你正在比较自建爬虫和托管方案,可以先使用免费额度评估真实成本,再决定是否升级到生产环境。
九、与竞品对比
市面上主流的爬虫解决方案可分为三类:
-
自建方案:Scrapy + Selenium + 代理池
-
托管框架:Apify、ScrapingBee、Zyte(原 Scrapy Cloud)
-
AI 驱动平台:Bright Data Scraper Studio、Browse AI
9.1 功能对比表
| 功能 | Scraper Studio | Apify | ScrapingBee | 自建 Scrapy |
|---|---|---|---|---|
| AI 代码生成 | ✅ 完全自动 | ❌ 需手动编写 | ❌ 需手动编写 | ❌ 完全手动 |
| 自愈功能 | ✅ AI 自动修复 | ❌ 需手动维护 | ❌ 需手动维护 | ❌ 完全手动 |
| 内置代理池 | ✅ 400M+ 住宅 IP | ✅ 需单独购买 | ✅ 包含 | ❌ 需自行采购 |
| CAPTCHA 解决 | ✅ 自动处理 | ✅ 需单独付费 | ✅ 包含 | ❌ 需第三方服务 |
| JavaScript 渲染 | ✅ 真实浏览器 | ✅ Playwright | ✅ Headless Chrome | ⚠️ 需自行集成 |
| 定时调度 | ✅ 可视化配置 | ✅ Cron + UI | ⚠️ 仅 API 触发 | ❌ 需自建 |
| 数据交付集成 | ✅ S3/BigQuery/Webhook | ✅ 类似支持 | ⚠️ 仅 Webhook | ❌ 需自行开发 |
| 学习曲线 | ⭐ 低(自然语言) | ⭐⭐⭐ 中等(JS/Python) | ⭐⭐ 较低(API) | ⭐⭐⭐⭐⭐ 高 |
| 维护成本 | ⭐ 极低(自动化) | ⭐⭐⭐ 中等 | ⭐⭐ 较低 | ⭐⭐⭐⭐⭐ 极高 |
9.2 适用场景推荐
选择 Scraper Studio,如果你:
-
需要快速构建爬虫(小时级上线)
-
网站经常改版,维护成本高
-
团队缺少专职爬虫工程师
-
需要企业级稳定性和合规性
选择 Apify,如果你:
-
需要高度定制化的爬虫逻辑
-
团队有熟练的 JavaScript/Python 开发者
-
需要复杂的数据处理流程
-
预算充足,愿意投入开发时间
选择 ScrapingBee,如果你:
-
只需要简单的 API 调用(单次抓取)
-
不需要定时调度或复杂流程
-
预算有限,优先考虑成本
选择自建 Scrapy,如果你:
-
有专职的爬虫团队
-
数据敏感,必须完全自主控制
-
有充足的基础设施和运维资源
-
需要极致的性能优化
但话说回来,最终还是要清楚自己的需求,不同产品适用于不同业务场景,以上对比主要针对企业级网页数据采集流程。
十、最佳实践与常见问题
10.1 性能优化建议
1. 合理设置并发数
不同网站的抗压能力不同,建议:
-
电商网站(Amazon、eBay):5-10 并发
-
新闻资讯站:10-20 并发
-
小型网站:1-3 并发(避免压垮目标服务器)
2. 使用会话保持
对于需要保持登录状态或避免频繁切换 IP 的场景,启用"Session"模式:
// 在爬虫代码中配置
module.exports = {
  proxy: {
    type: 'residential',
    session_duration: 600  // 10 分钟内使用同一 IP
  }
};
3. 智能重试策略
module.exports = {
  retry: {
    max_attempts: 3,
    backoff: 'exponential',  // 2s, 4s, 8s
    retry_on: ['timeout', 'rate_limit', '5xx']
  }
};
4. 数据去重
如果目标网站存在重复数据,在爬虫代码中添加去重逻辑:
const seen = new Set();

module.exports = async function parse(page) {
  const items = await page.evaluate(() => {
    // 提取数据...
  });

  return items.filter(item => {
    if (seen.has(item.asin)) return false;
    seen.add(item.asin);
    return true;
  });
};
10.2 常见问题解答
Q1:爬虫生成后,如何验证数据准确性?
A:建议先用少量 URL 测试运行,检查:
-
必填字段是否有空值
-
数据格式是否正确(价格是数字而非字符串)
-
是否有重复记录
-
选择器是否稳定(同一页面多次运行结果一致)
Q2:网站使用了高级反爬技术,Scraper Studio 能应对吗?
A:Scraper Studio 内置了多层反反爬机制:
-
指纹随机化:浏览器指纹、User-Agent、Canvas 指纹
-
行为模拟:鼠标移动、滚动、点击延迟
-
IP 轮换:每次请求自动切换住宅 IP
-
CAPTCHA 自动识别:支持 reCAPTCHA v2/v3、hCaptcha
如果仍然遇到封禁,可以在设置中调整:
-
降低并发数
-
增加请求间隔
-
启用更高级的浏览器指纹伪装
Q3:自愈功能会自动修改我的代码吗?
A:不会。自愈功能只会生成修复建议,需要你手动审核并批准。流程是:
-
系统检测到失败并分析原因
-
AI 生成修复方案并展示代码对比
-
你审核后决定是否应用
-
应用后系统自动验证修复效果
Q4:如何处理需要登录的网站?
A:在爬虫代码的 navigate.js 中添加登录逻辑:
module.exports = async function navigate(page, input) {
  // 访问登录页
  await page.goto('https://example.com/login');

  // 填写表单
  await page.type('#username', 'your_username');
  await page.type('#password', 'your_password');
  await page.click('#login-button');

  // 等待登录完成
  await page.waitForNavigation();

  // 跳转到目标页面
  await page.goto(input.url);
};
更安全的做法是使用 Cookies 或 Session Token,避免在代码中硬编码密码。
Q5:数据量很大时,如何避免超时?
A:可以设置分批运行:
// 在调度配置中设置
{
  "batch_size": 1000,  // 每批处理 1000 个 URL
  "batch_interval": 3600  // 批次间隔 1 小时
}
或使用 CLI 分批触发:
# 将 10,000 个 URL 分成 10 批运行
split -l 1000 urls.txt batch_
for file in batch_*; do
  brightdata scraper run <collector_id> --input-file "$file"
  sleep 3600  # 等待 1 小时
done
10.3 安全与合规
1. 遵守 robots.txt
Scraper Studio 默认会检查目标网站的 robots.txt,如果被禁止抓取,系统会发出警告。你可以选择:
-
尊重规则,停止抓取
-
评估风险后继续(自行承担责任)
2. 数据隐私合规
如果抓取的数据涉及个人信息(如用户评论、联系方式),需确保:
-
仅用于合法用途(市场研究、竞品分析)
-
不公开传播或销售数据
-
遵守 GDPR、CCPA 等数据保护法规
3. 速率限制
避免对目标网站造成过大压力,建议:
-
设置合理的请求间隔(2-5 秒)
-
避免高峰时段大规模抓取
-
监控目标网站的响应时间,如明显变慢则降低并发
十一、总结:谁应该使用 Scraper Studio?
经过完整的实战演示和功能解析,我们可以得出以下结论:
11.1 核心优势
-
极低的上手门槛:用自然语言描述需求,AI 自动生成生产级代码,非技术人员也能快速上手
-
自动化维护:自愈功能将网站改版的修复时间从数小时压缩到数分钟,维护成本降低 83%
-
全托管基础设施:无需自建代理池、部署服务器、配置监控,开箱即用
-
企业级可靠性:内置 400M+ 住宅 IP、自动 CAPTCHA 解决、无限并发能力
-
灵活的集成能力:支持 CLI、REST API、Webhook、云存储等多种集成方式
11.2 适合的用户画像
| 用户类型 | 核心痛点 | Scraper Studio 解决方案 |
|---|---|---|
| 初创公司 | 缺少专职爬虫工程师,预算有限 | AI 生成 + 全托管,快速上线,按需付费 |
| 数据团队 | 维护多个爬虫,网站改版导致频繁失效 | 自愈功能自动修复,减少人工干预 |
| 产品经理 | 需要竞品数据支持决策,但不懂代码 | 自然语言描述需求,无需编程 |
| 开发者 | 自建爬虫频繁因网站改版而崩溃 | 自愈引擎自动检测并修复,代码透明可控 |
| 企业 CTO | 评估 ROI,权衡自建 vs. 外包成本 | 节省 70% 成本,无需运维团队 |
11.3 不适合的场景
虽然 Scraper Studio 功能强大,但以下场景可能不是最佳选择:
-
极致性能要求:如果你需要每秒处理数万个请求,自建分布式系统可能更合适
-
数据完全自主控制:如果数据绝对不能经过第三方服务器,需要完全内网部署
-
超低预算场景:如果月度抓取量低于 5,000 次,免费额度足够;但如果需要更高量级且预算极其有限,自建可能更经济(需考虑人力成本)
-
高度定制化的复杂逻辑:如果爬虫需要多步交互、复杂的状态机、实时决策树等,纯代码方案可能更灵活
11.4 最终建议
立即尝试 Scraper Studio,如果你:
-
正在为爬虫维护成本头疼
-
需要在 1 天内上线一个数据采集项目
-
团队中没有专职爬虫工程师
-
希望将时间投入在数据分析而非基础设施搭建上
从免费额度开始,用真实业务场景测试 1-2 周,评估以下指标:
-
数据准确率是否达到 95% 以上
-
自愈功能能否有效减少维护工作量
-
成本是否低于自建方案
-
与现有系统的集成是否顺畅
如果这四项都满足,那么 Scraper Studio 就是你的正确选择。
十二、快速上手检查清单
为了帮助你快速启动第一个项目,这里提供一个完整的检查清单:
阶段 1:准备工作(10 分钟)
-
通过联盟链接注册账号
-
验证邮箱并登录控制台
-
确认免费额度已到账(5,000 次页面加载/月)
阶段 2:创建第一个爬虫(20 分钟)
-
点击"Create New Scraper",选择 AI Agent 模式
-
输入目标网站 URL(建议先用简单网站测试,如 Amazon 商品列表)
-
用自然语言描述数据需求(参考本文第四章示例)
-
点击"Generate",等待 AI 生成爬虫
-
在 IDE 中查看生成的代码,理解其逻辑
-
配置代理类型(住宅 IP)和并发数(5-10)
阶段 3:测试运行(15 分钟)
-
点击"Run",输入 1-3 个测试 URL
-
观察实时日志,确认页面加载成功
-
查看数据预览,检查字段是否完整
-
下载结果(JSON 或 CSV),验证数据质量
-
如发现问题,调整选择器或解析逻辑
阶段 4:生产部署(30 分钟)
-
设置定时调度(每日/每周/自定义 Cron)
-
配置数据交付目标(S3/BigQuery/Webhook)
-
设置告警规则(失败率超过阈值时邮件通知)
-
启用自愈功能(自动修复网站改版问题)
-
运行 3-5 次,确认稳定性达到 95% 以上
阶段 5:系统集成(1 小时)
-
安装 Bright Data CLI:
npm install -g @brightdata/cli -
获取 API Token(在控制台"Settings" → “API Access”)
-
测试 CLI 触发:
brightdata scraper run <collector_id> -
编写自动化脚本(参考本文 7.3 节的
scraper-run.sh) -
集成到现有系统(Airflow/Cron/API Gateway)
阶段 6:监控与优化(持续进行)
-
每周检查运行日志,关注失败率和数据质量
-
如收到自愈通知,及时审核并应用修复
-
根据业务需求调整抓取频率和数据范围
-
定期评估成本,优化并发数和代理策略
-
将成功经验复制到更多爬虫项目
结语
从手动编写 Scrapy 代码到 AI 自动生成爬虫,从频繁维护到一键自愈修复,Bright Data Scraper Studio 代表了网页数据采集领域的一次范式转变。
它不仅仅是一个工具,更是一套完整的数据管道解决方案。无论你是希望快速验证商业想法的创业者,还是需要稳定数据源的数据团队,Scraper Studio 都能帮你将时间和精力聚焦将更多时间投入到数据分析和业务开发,而不是持续维护爬虫代码和基础设施。
准备开始你的第一个 AI Web Scraper?
使用 Bright Data Scraper Studio,你可以在几分钟内完成从网页到结构化数据的完整流程,而无需搭建代理、浏览器或服务器。
✔ 每月免费页面加载额度
✔ AI 自动生成 Scraper
✔ 内置浏览器、代理与 CAPTCHA 处理
✔ 网站改版支持 Self-Healing 自动修复
-End-
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_43970743/article/details/163101219

