

✨作者主页:IT毕设梦工厂✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、PHP、.NET、Node.js、GO、微信小程序、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
精彩专栏推荐⬇⬇⬇
Java项目
Python项目
安卓项目
微信小程序项目
一、前言
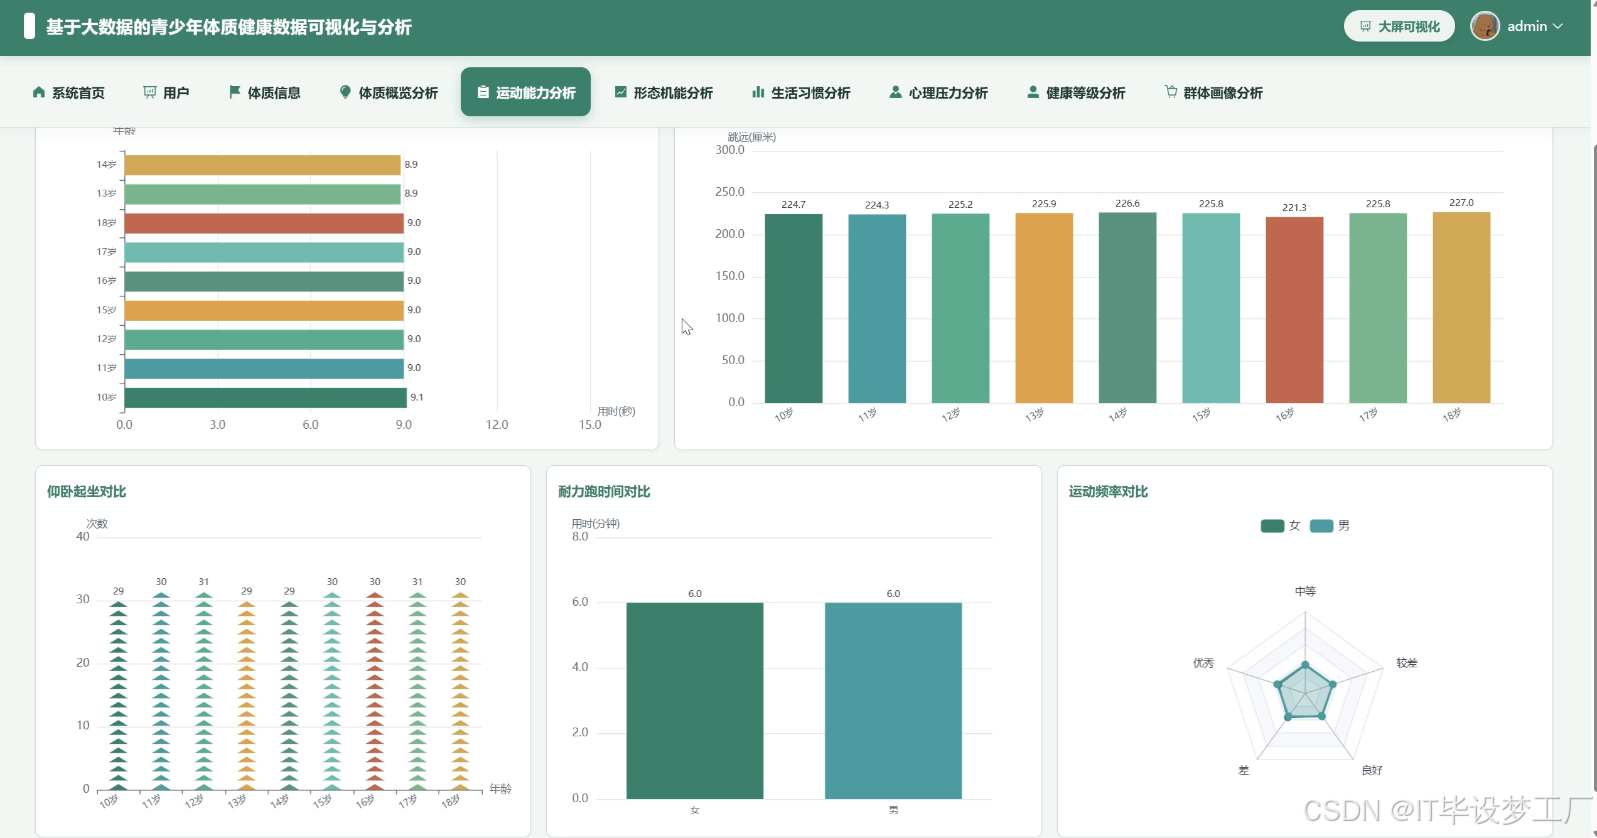
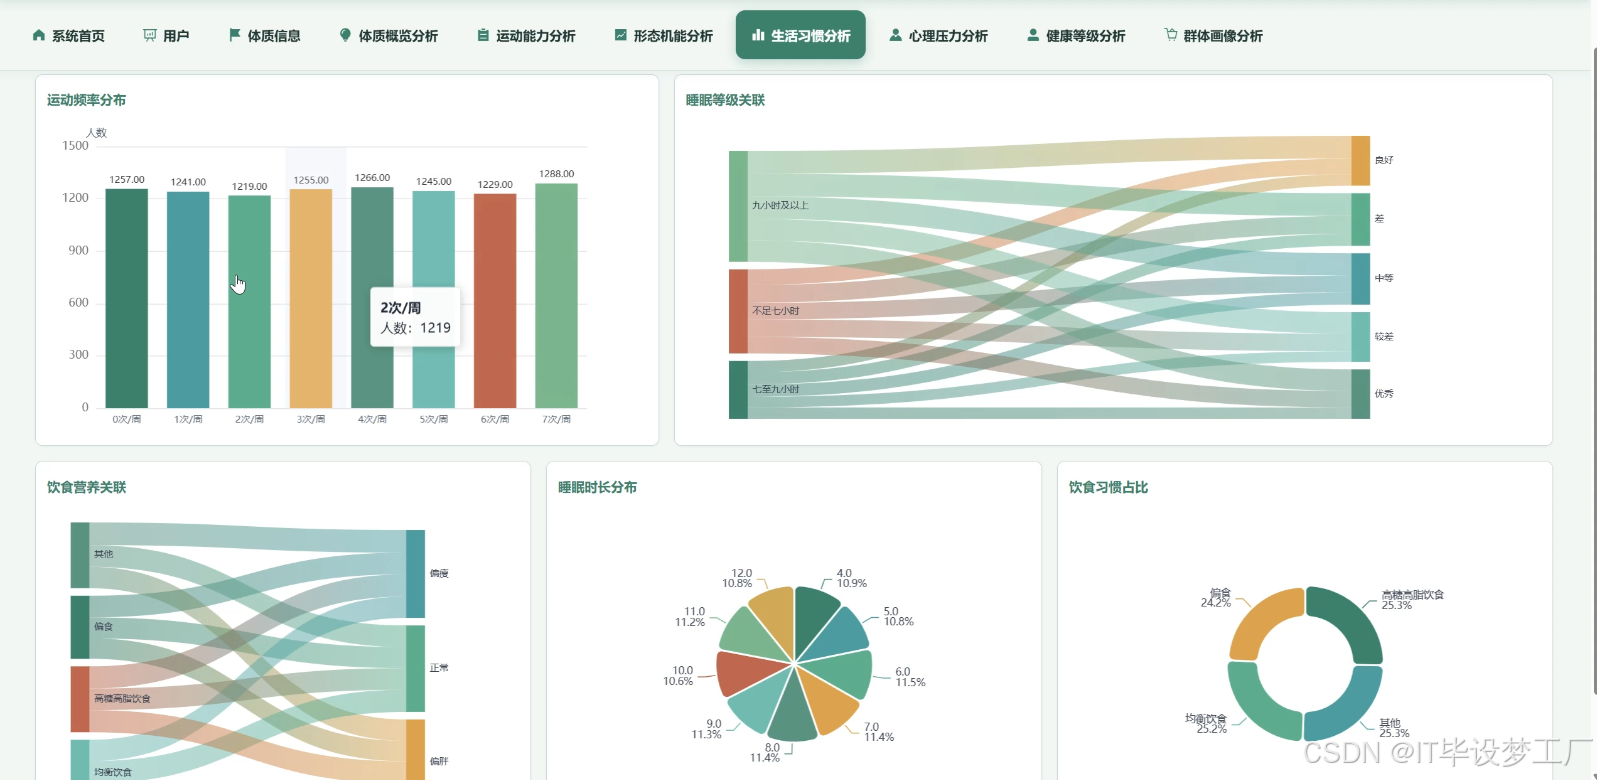
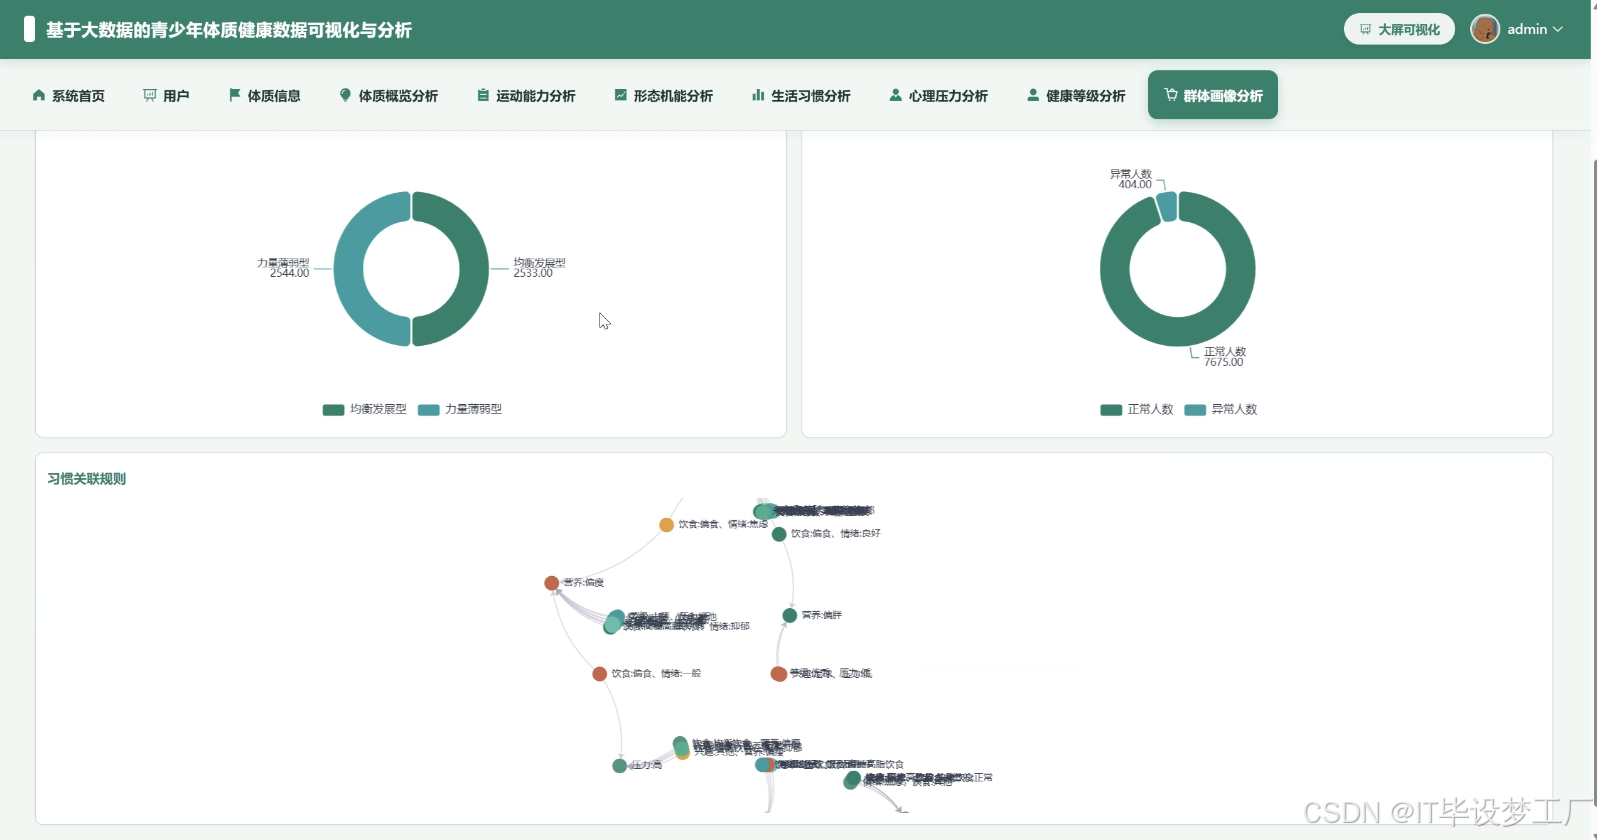
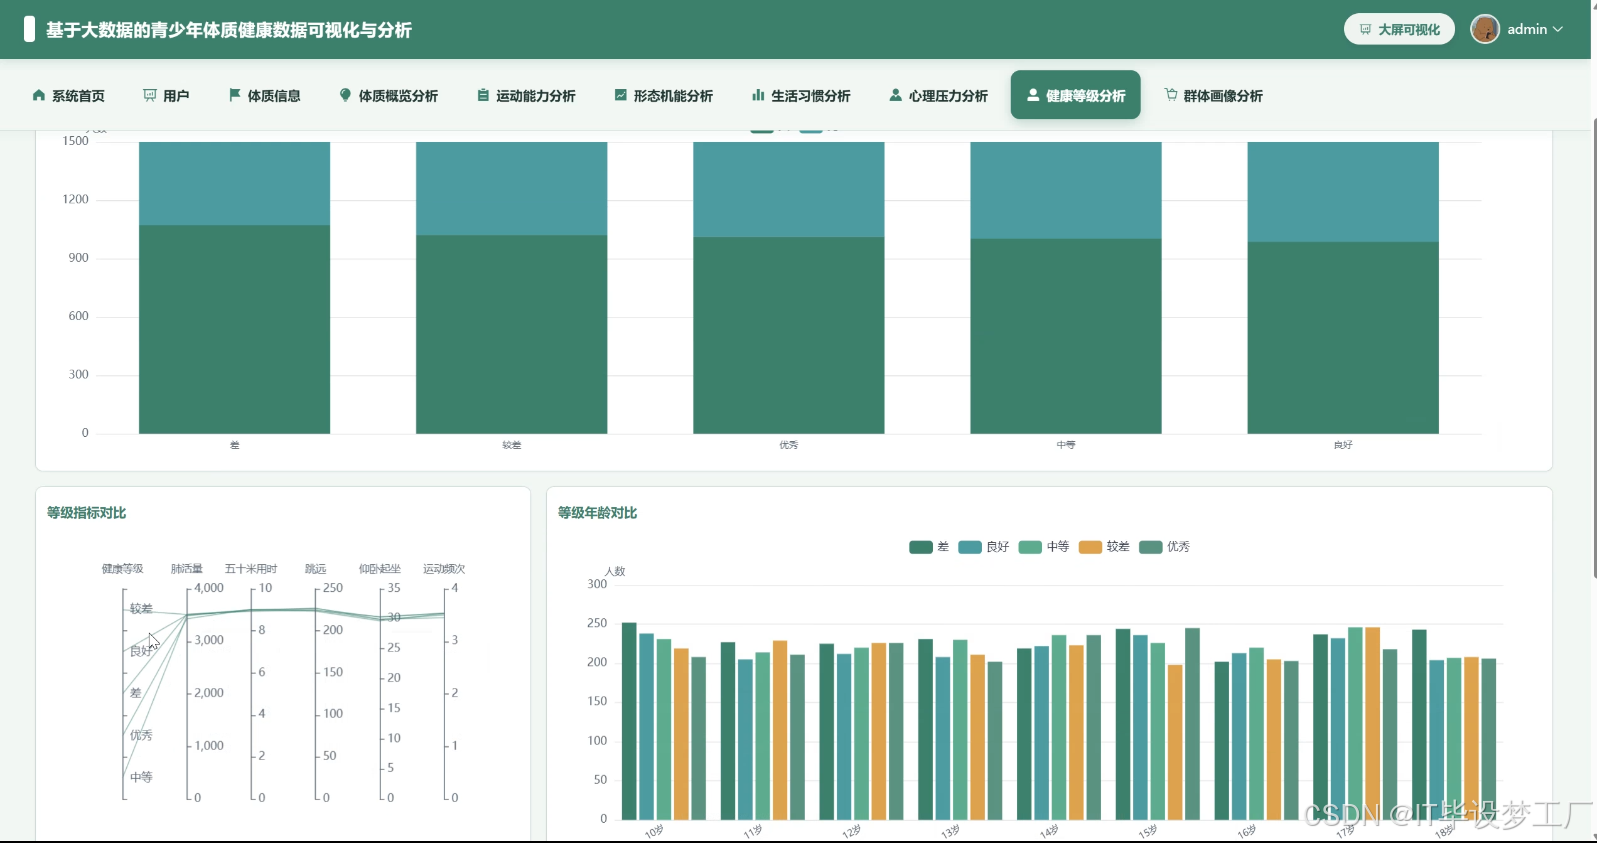
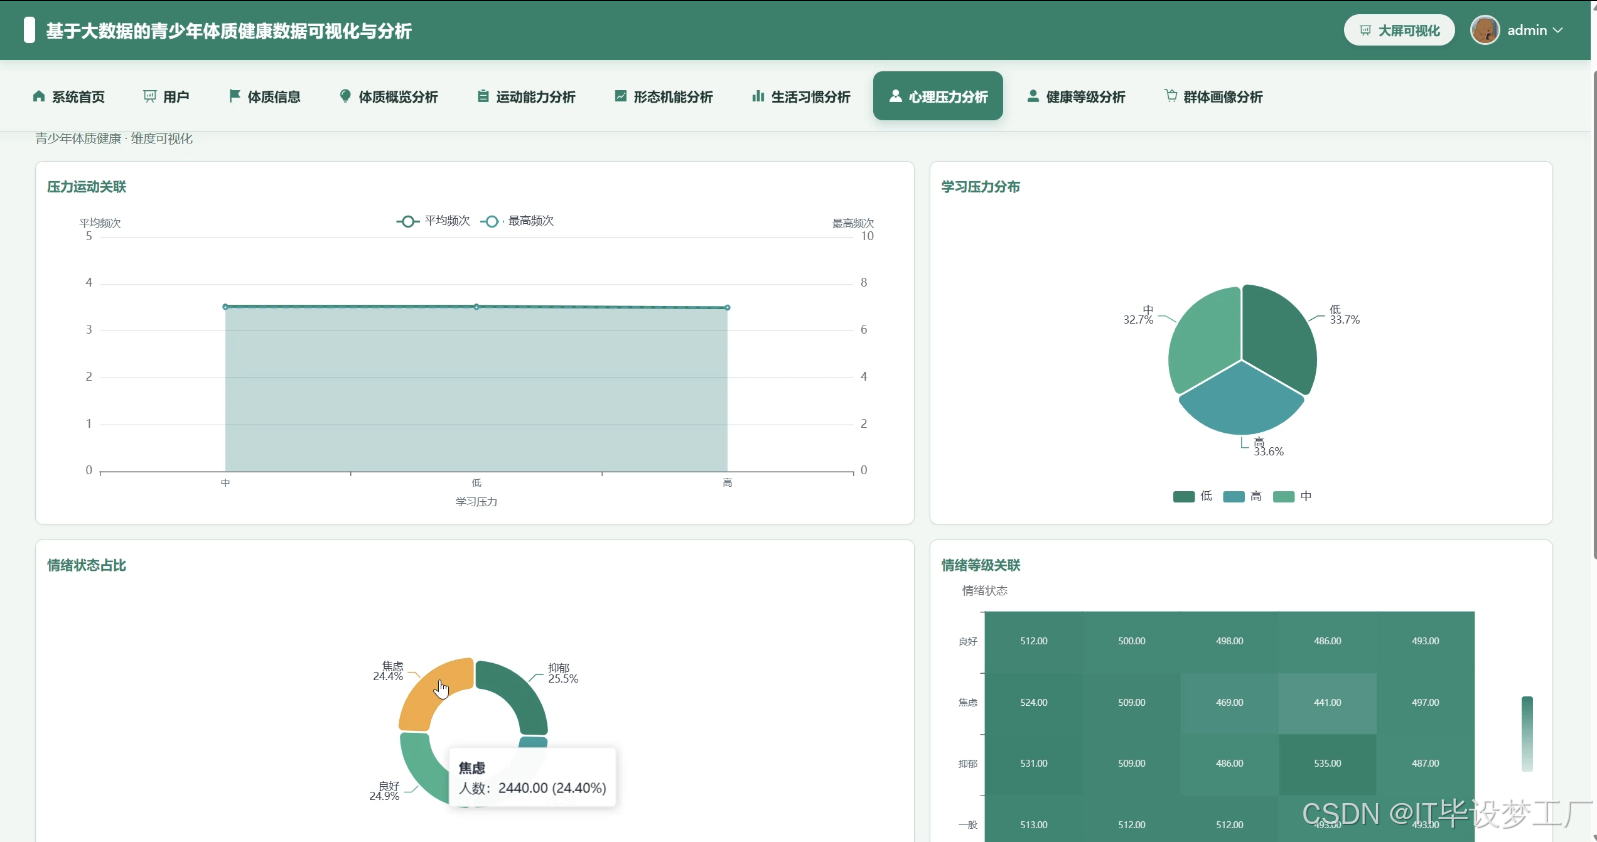
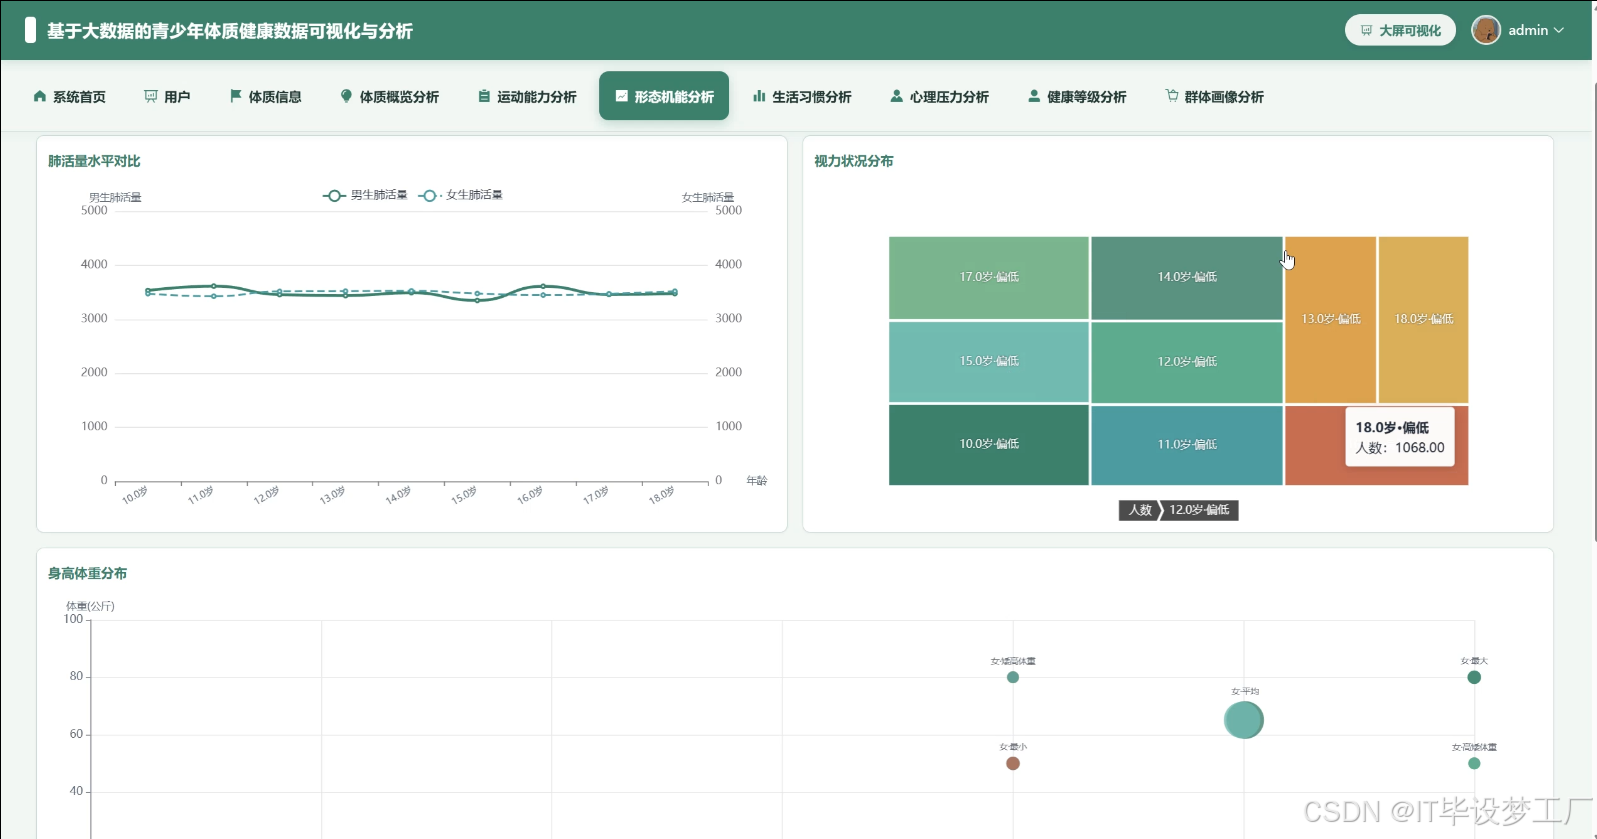
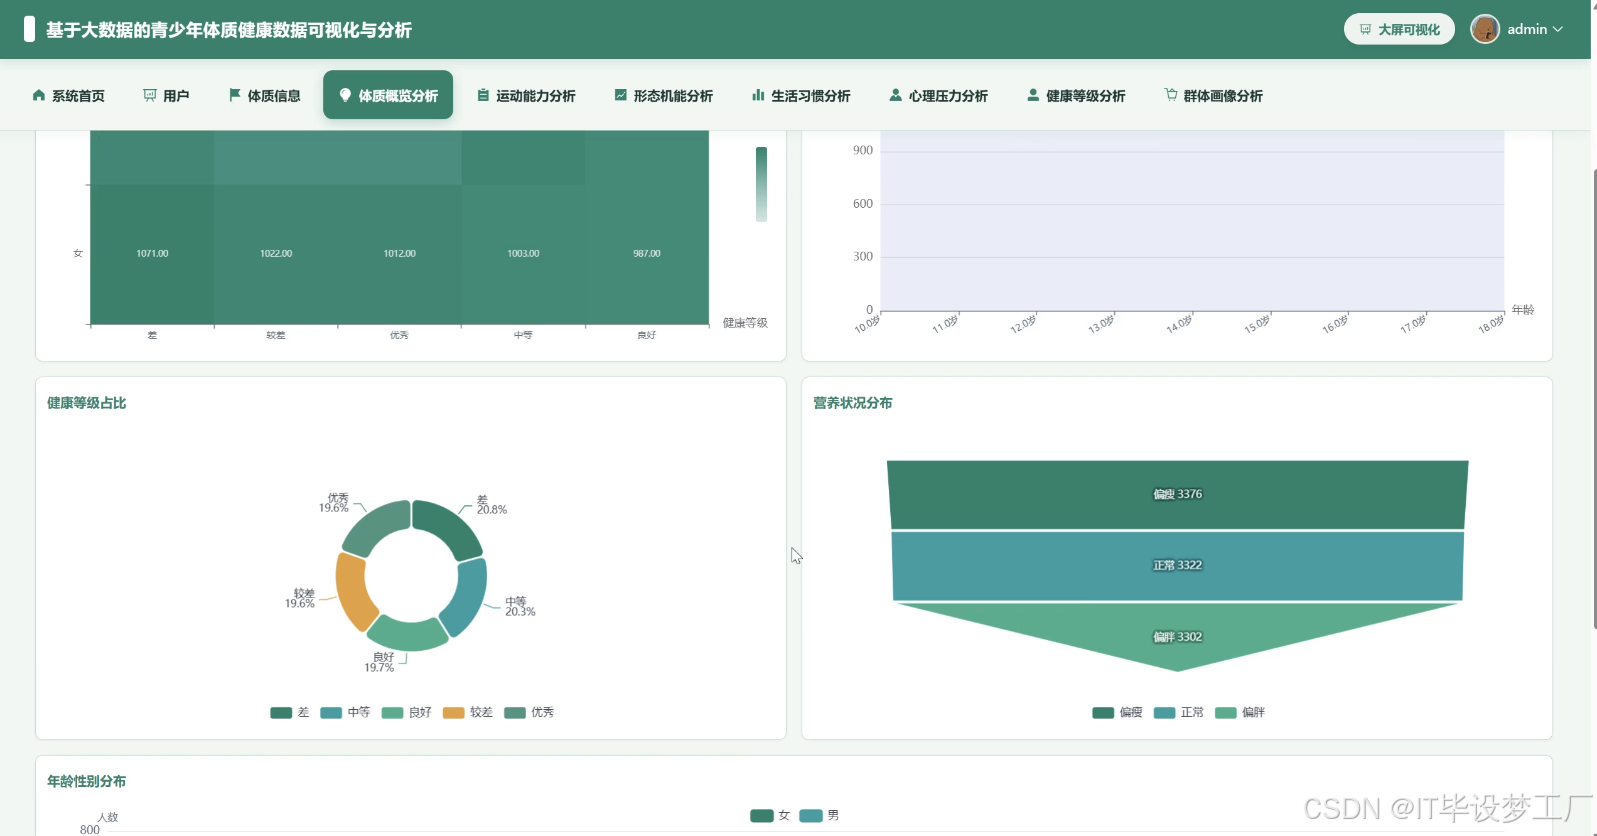
本系统叫《基于大数据的青少年体质健康数据可视化与分析》,主要是把青少年体质健康相关的数据用大数据思路做清洗、统计、分析和可视化展示。系统底层用 Hadoop 和 HDFS 做数据存储,计算部分用 Spark、Spark SQL,配合 Pandas、NumPy 做一些指标计算和统计处理,业务数据放在 MySQL 里。我这边按 Python 版本说明,后端用 Django 提供接口,前端用 Vue、ElementUI、Echarts、HTML、CSS、JavaScript、jQuery 做页面和图表展示。功能上包括系统首页、用户管理、体质信息、体质概览分析、运动能力分析、形态机能分析、生活习惯分析、心理压力分析、健康等级分析、群体画像分析、个人信息和修改密码。用户录入或导入体质信息后,系统会围绕 BMI、肺活量、运动能力、形态机能、生活习惯、心理压力、健康等级等维度做汇总,再用柱状图、折线图、饼图、雷达图等方式展示出来。体质概览分析看整体分布,运动能力分析看不同年级和性别的差异,形态机能分析关注身体发育相关指标,生活习惯和心理压力分析帮助观察可能影响健康的因素,健康等级分析和群体画像分析则把学生分成不同群体,方便老师从整体上了解情况。整个系统不算复杂,但把大数据处理、后端接口、数据库存储和前端可视化串了起来,适合作为计算机专业毕设来一步步实现和讲解。
二、开发环境
- 开发语言:Java/Python
- 数据库:MySQL
- 系统架构:B/S
- 后端:SpringBoot/SSM/Django/Flask
- 前端:Vue
三、系统界面展示
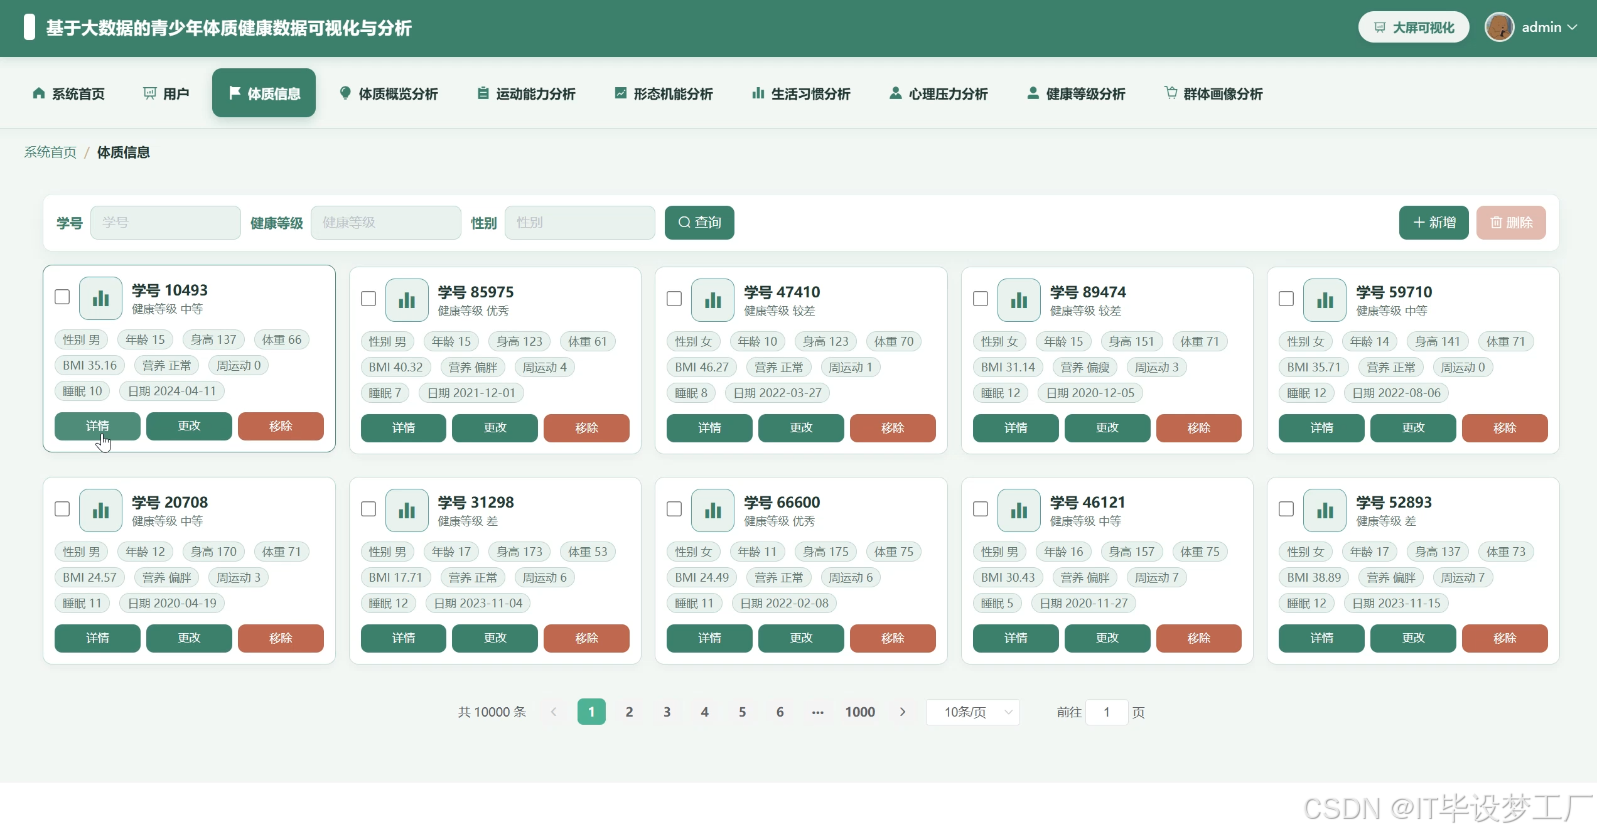
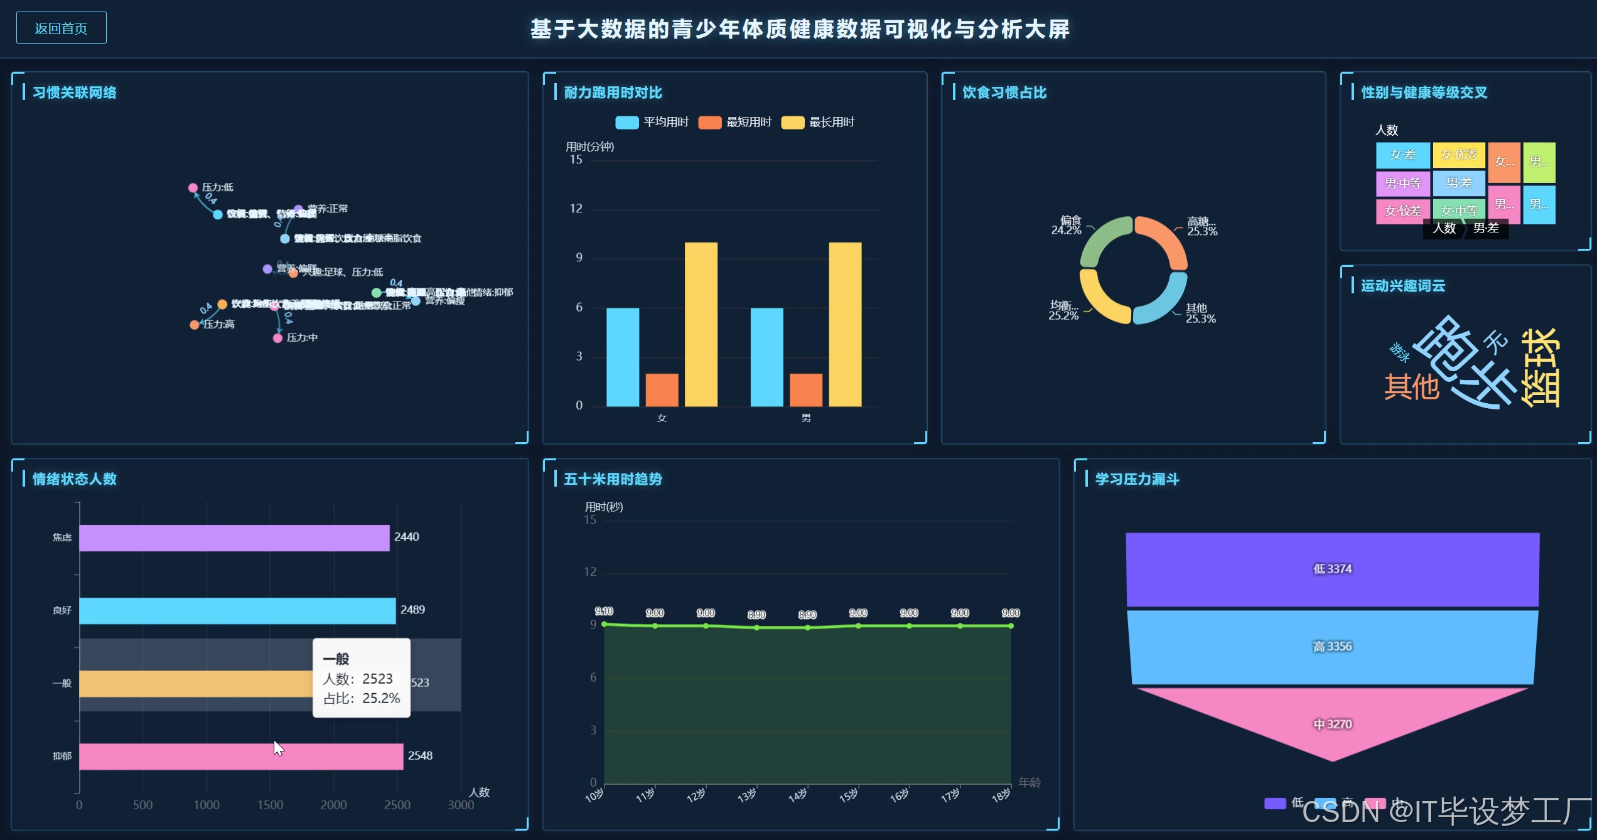
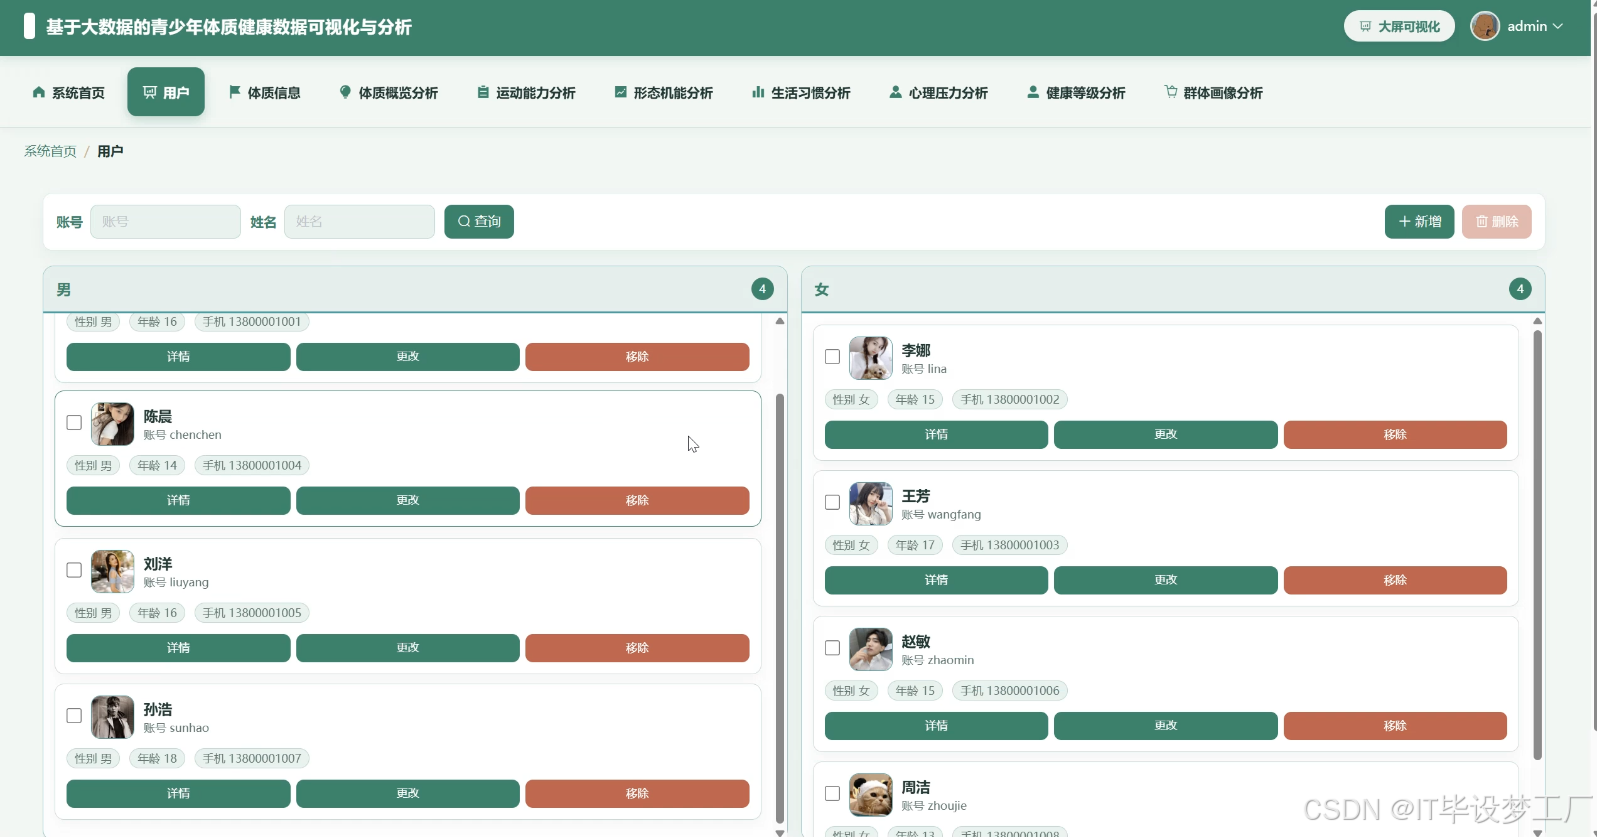
- 基于大数据的青少年体质健康数据可视化与分析系统界面展示:
四、部分代码设计
- 项目实战-代码参考:
spark = SparkSession.builder.appName("YouthHealthBigData").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
def health_overview(request):
    jdbc_url = "jdbc:mysql://localhost:3306/youth_health"
    props = {"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"}
    df = spark.read.jdbc(url=jdbc_url, table="physical_info", properties=props)
    df.createOrReplaceTempView("physical_info")
    result = spark.sql("""
        SELECT grade, gender, COUNT(*) AS total,
        ROUND(AVG(bmi),2) AS avg_bmi,
        ROUND(AVG(vital_capacity),2) AS avg_vital,
        ROUND(AVG(total_score),2) AS avg_score,
        SUM(CASE WHEN total_score>=90 THEN 1 ELSE 0 END) AS excellent_num
        FROM physical_info GROUP BY grade, gender
    """)
    data = result.toPandas()
    data["excellent_rate"] = (data["excellent_num"] / data["total"] * 100).round(2)
    charts = data.to_dict(orient="records")
    return JsonResponse({"code": 200, "charts": charts})
def sport_ability_analysis(request):
    jdbc_url = "jdbc:mysql://localhost:3306/youth_health"
    props = {"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"}
    df = spark.read.jdbc(url=jdbc_url, table="sport_ability", properties=props)
    df.createOrReplaceTempView("sport_ability")
    result = spark.sql("""
        SELECT grade, gender,
        ROUND(AVG(run_50m),2) AS avg_run_50m,
        ROUND(AVG(standing_long_jump),2) AS avg_jump,
        ROUND(AVG(endurance_run),2) AS avg_endurance,
        ROUND(AVG(rope_skipping),2) AS avg_rope,
        COUNT(*) AS student_count
        FROM sport_ability GROUP BY grade, gender
    """)
    pdf = result.toPandas()
    pdf["jump_score"] = np.clip((pdf["avg_jump"] - 150) / 100 * 100, 0, 100).round(2)
    pdf["run_score"] = np.clip((10 - pdf["avg_run_50m"]) / 2 * 100, 0, 100).round(2)
    rank = pdf.sort_values("jump_score", ascending=False).head(10)
    return JsonResponse({"code": 200, "sport": pdf.to_dict("records"), "rank": rank.to_dict("records")})
def health_level_analysis(request):
    jdbc_url = "jdbc:mysql://localhost:3306/youth_health"
    props = {"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"}
    df = spark.read.jdbc(url=jdbc_url, table="health_level", properties=props)
    df.createOrReplaceTempView("health_level")
    stat = spark.sql("""
        SELECT grade, health_level, COUNT(*) AS num,
        ROUND(AVG(total_score),2) AS avg_score,
        ROUND(AVG(psychological_pressure),2) AS avg_pressure
        FROM health_level GROUP BY grade, health_level
    """)
    pdf = stat.toPandas()
    bins = [0, 60, 75, 85, 100]
    labels = ["待提升", "合格", "良好", "优秀"]
    pdf["level_label"] = pd.cut(pdf["avg_score"], bins=bins, labels=labels, include_lowest=True)
    total = pdf.groupby("grade")["num"].transform("sum")
    pdf["ratio"] = (pdf["num"] / total * 100).round(2)
    portrait = pdf.groupby("level_label")["ratio"].mean().reset_index()
    return JsonResponse({"code": 200, "level": pdf.to_dict("records"), "portrait": portrait.to_dict("records")})
五、论文参考
- 计算机毕业设计选题推荐-基于大数据的青少年体质健康数据可视化与分析系统-论文参考:
六、系统视频
- 基于大数据的青少年体质健康数据可视化与分析系统-项目视频:
项目演示视频
结语
计算机毕业设计选题推荐:基于大数据的青少年体质健康数据可视化与分析|毕业设计选题|计算机毕设|选题推荐|毕设指导|项目定制|源码|高质量项目
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2301_79526727/article/details/167040001

