

💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询
💕💕Java项目
💕💕微信小程序项目
💕💕Android项目
💕💕Python项目
💕💕PHP项目
💕💕ASP.NET项目
💕💕Node.js项目
💕💕大数据项目
💕💕选题推荐
基于大数据的北京美食店铺数据可视化分析系统
1、研究背景
随着移动互联网和餐饮O2O平台的迅猛发展,北京作为超大型城市,积累了海量的美食店铺数据。这些数据涵盖了店铺基本信息、顾客点评、消费水平、地理位置及菜系归属等多个维度,呈现出典型的大数据特征。传统的数据库和统计工具难以高效处理如此庞大且非结构化的文本数据。大数据技术Hadoop与Spark以及机器学习算法的成熟为解决这一问题提供了技术支撑。基于Python、Vue、Echarts及MySQL构建的可视化分析系统能够将复杂的餐饮数据转化为直观图表,满足行业对数据深度挖掘的需求。本项目基于北京美食店铺大数据,从菜系结构、消费水平、评论文本、区域分布、店铺成长与评价口碑等多个维度展开分析,通过菜系×区热力图、TF-IDF关键词、LDA主题分布、K-Means聚类画像等具体形式,直观呈现了北京餐饮市场的复杂生态与潜在规律。
2、研究目的和意义
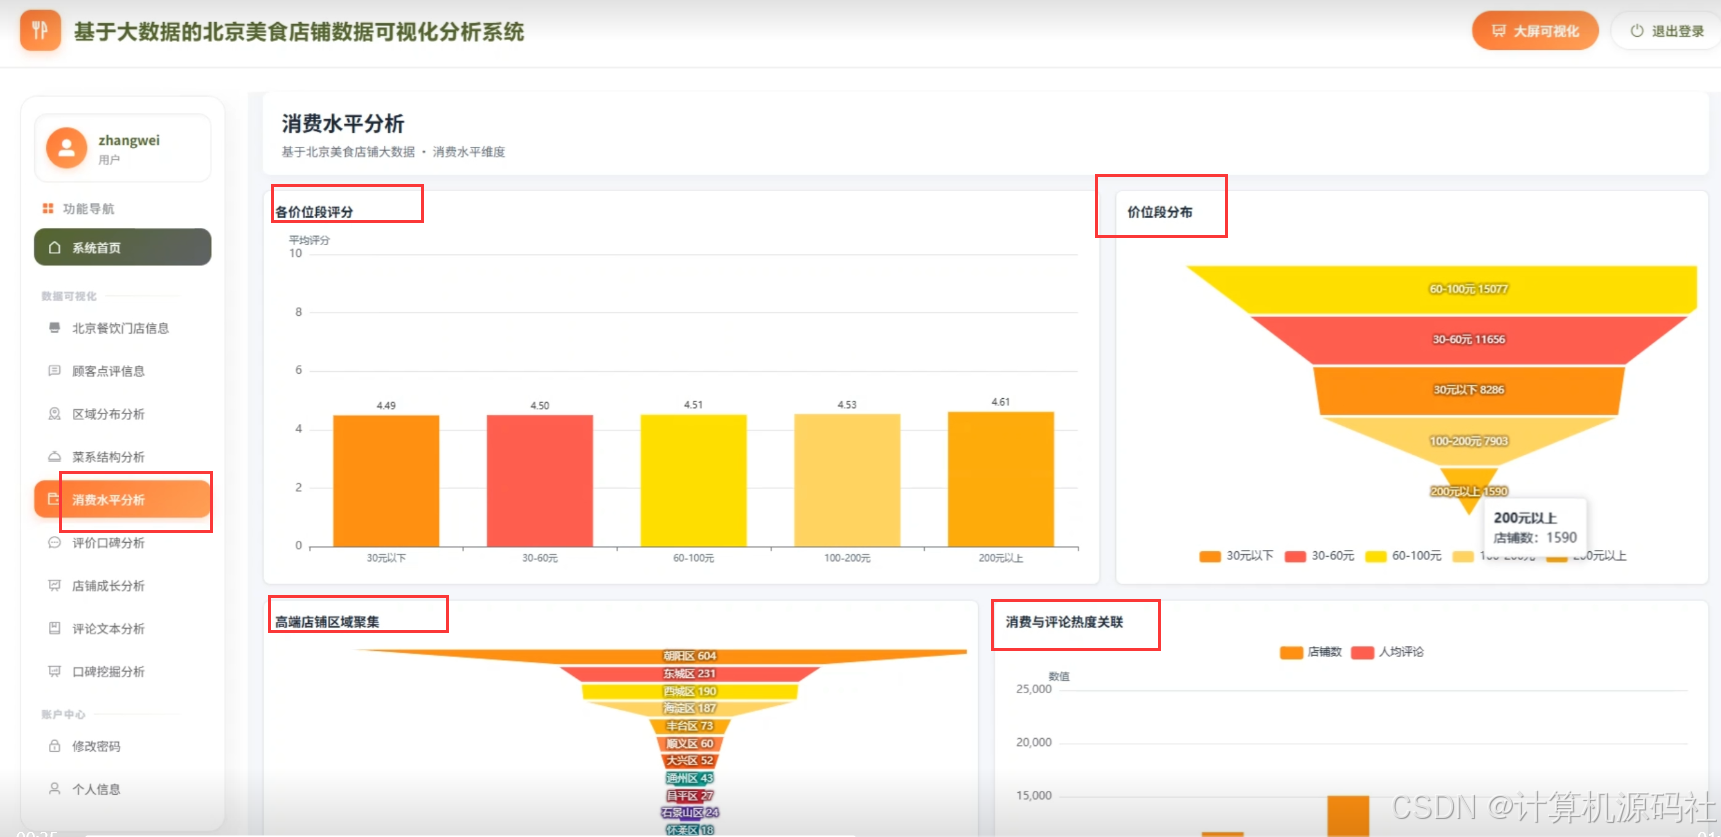
本系统的核心目标是利用大数据和机器学习技术,深度挖掘北京美食店铺数据中蕴含的商业价值。通过对海量评论数据进行文本挖掘,提取TF-IDF关键词和LDA主题,明确顾客关注的口味、服务、环境等核心要素。利用K-Means算法对店铺进行聚类画像,细分中档类等不同消费层级和活跃度群体。系统旨在打破数据孤岛,将复杂的统计结果通过Echarts和Vue转化为交互式图表,如价位段分布漏斗图、各区菜系丰富度条形图、热门商圈TOP分析等。这有助于商家精准定位自身市场位置,优化经营策略;同时为消费者提供直观的消费指引。系统通过大屏可视化技术集中展示核心指标,为管理者提供全局视角的数据支撑。最终实现数据驱动的精细化运营与行业洞察,提升整个北京餐饮市场的数字化管理和决策效率。
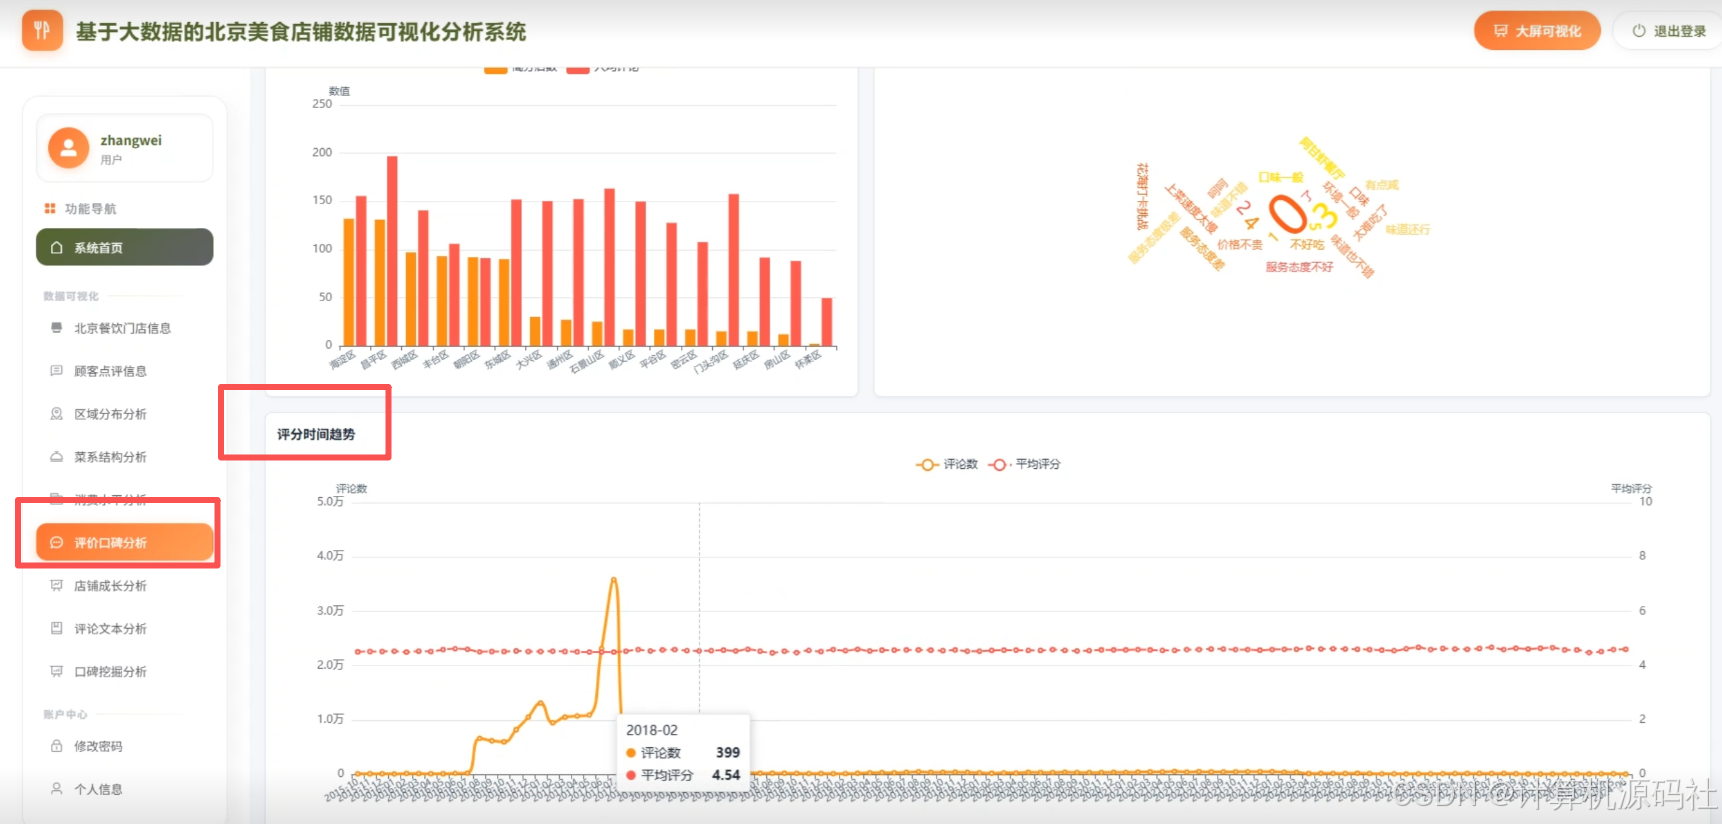
本系统的开发具有显著的行业应用价值和学术实践意义。在理论层面,将Spark、Hadoop等大数据组件与K-Means、LDA等机器学习算法相结合应用于餐饮垂直领域,验证了大数据技术在非结构化文本和复杂业务场景下的有效性。在实践层面,系统通过各区人均消费TOP15、米其林菜系分布、评分时间趋势等可视化模块,客观反映了北京各区域的餐饮经济差异和消费偏好,为政府部门制定商业规划、优化商圈布局提供了数据参考。对于餐饮商家,异常口碑店铺分布、负面评论关键词分析能够帮助其及时发现经营短板,提升服务质量。系统集成的区域分布分析、菜系结构分析、消费水平分析与评价口碑分析等功能,不仅为餐饮O2O平台提供了精准营销的底层逻辑,也为广大消费者提供了饮食选择的数字化指南。通过大屏可视化展示,进一步拓展了大数据分析在商业智能领域的应用边界,推动了传统餐饮行业向数据驱动型产业的转型升级。
3、系统研究内容
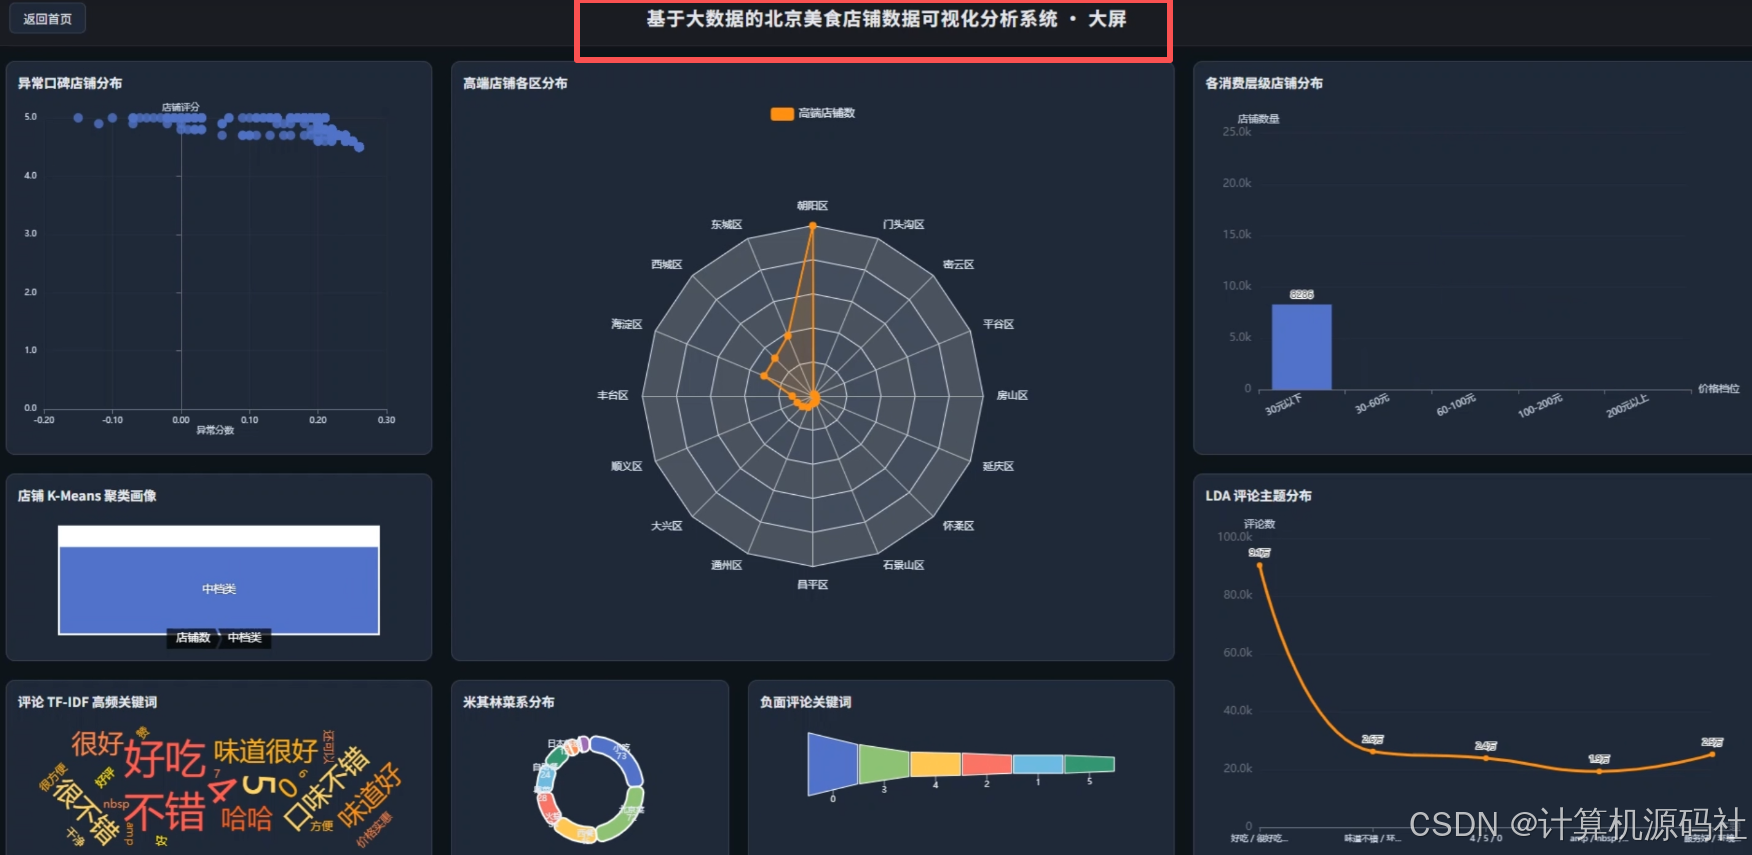
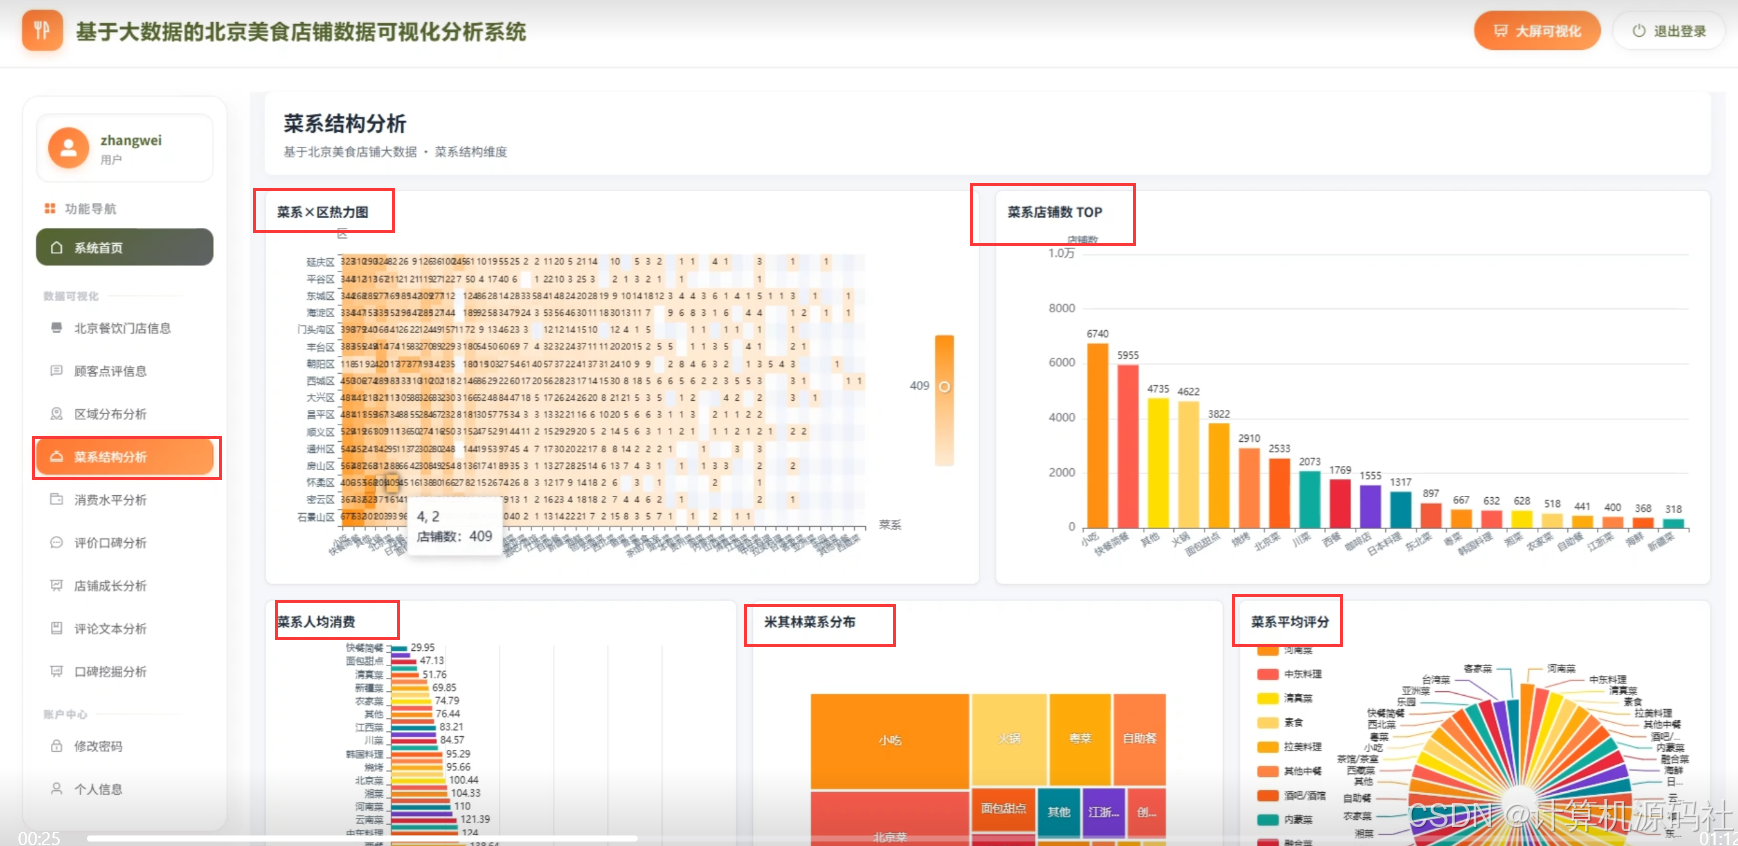
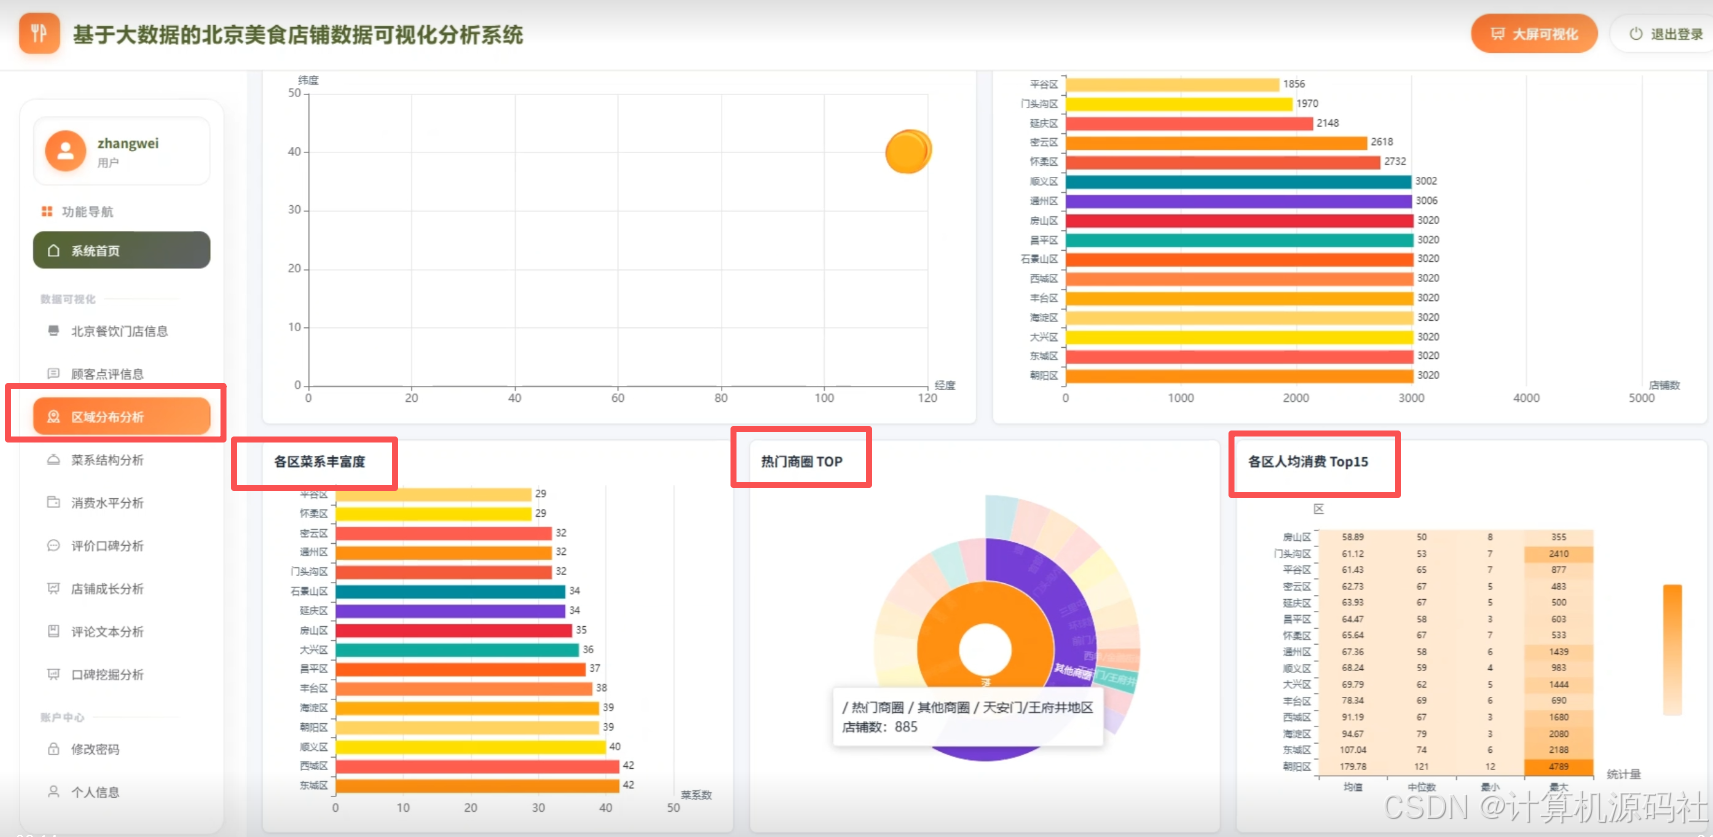
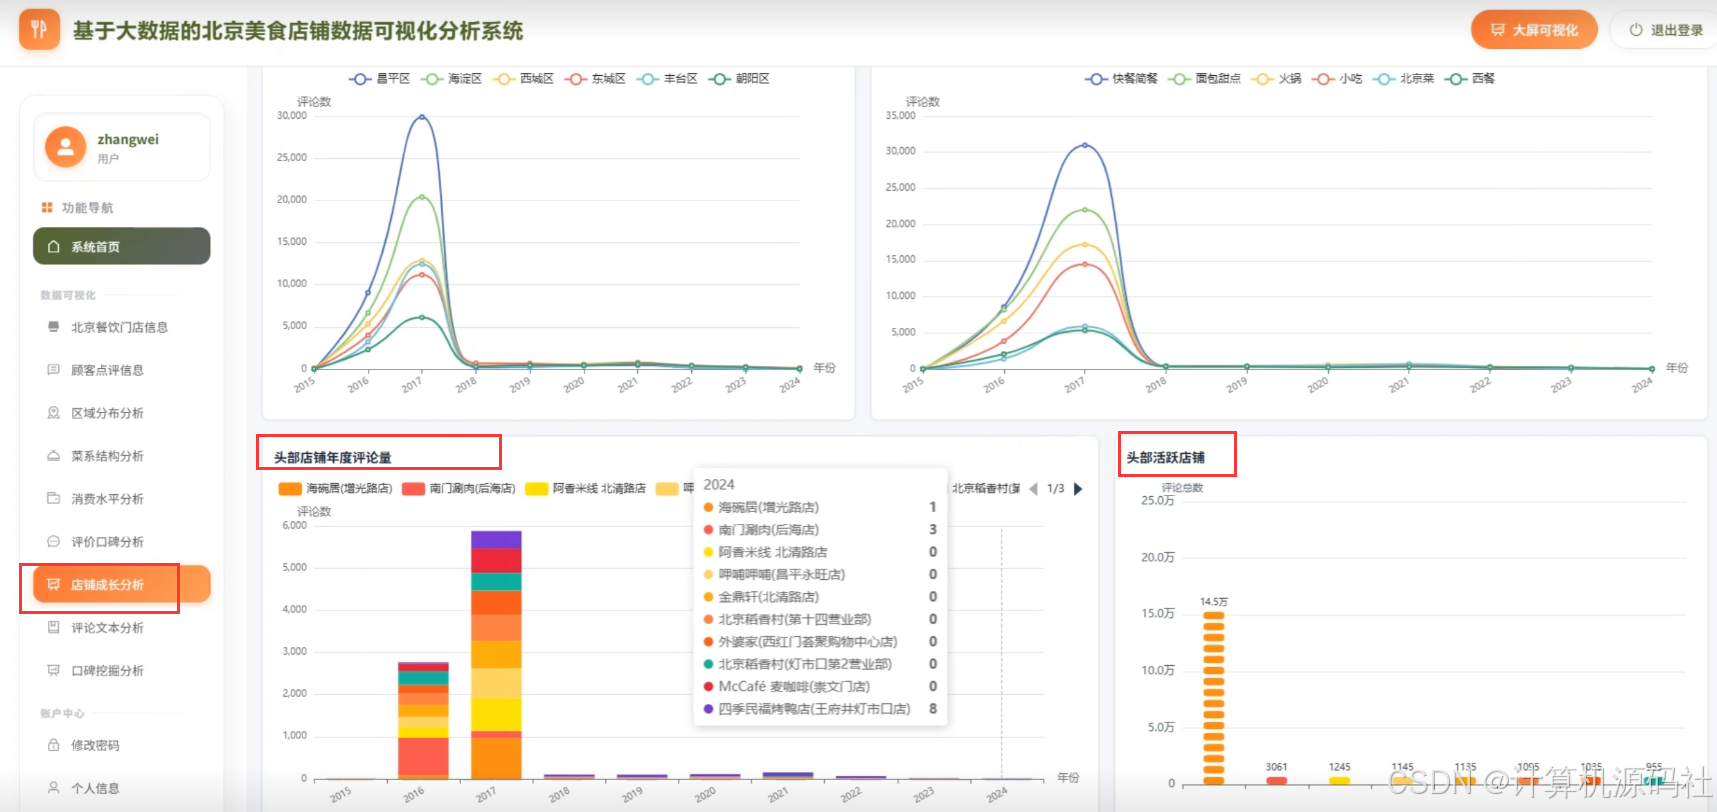
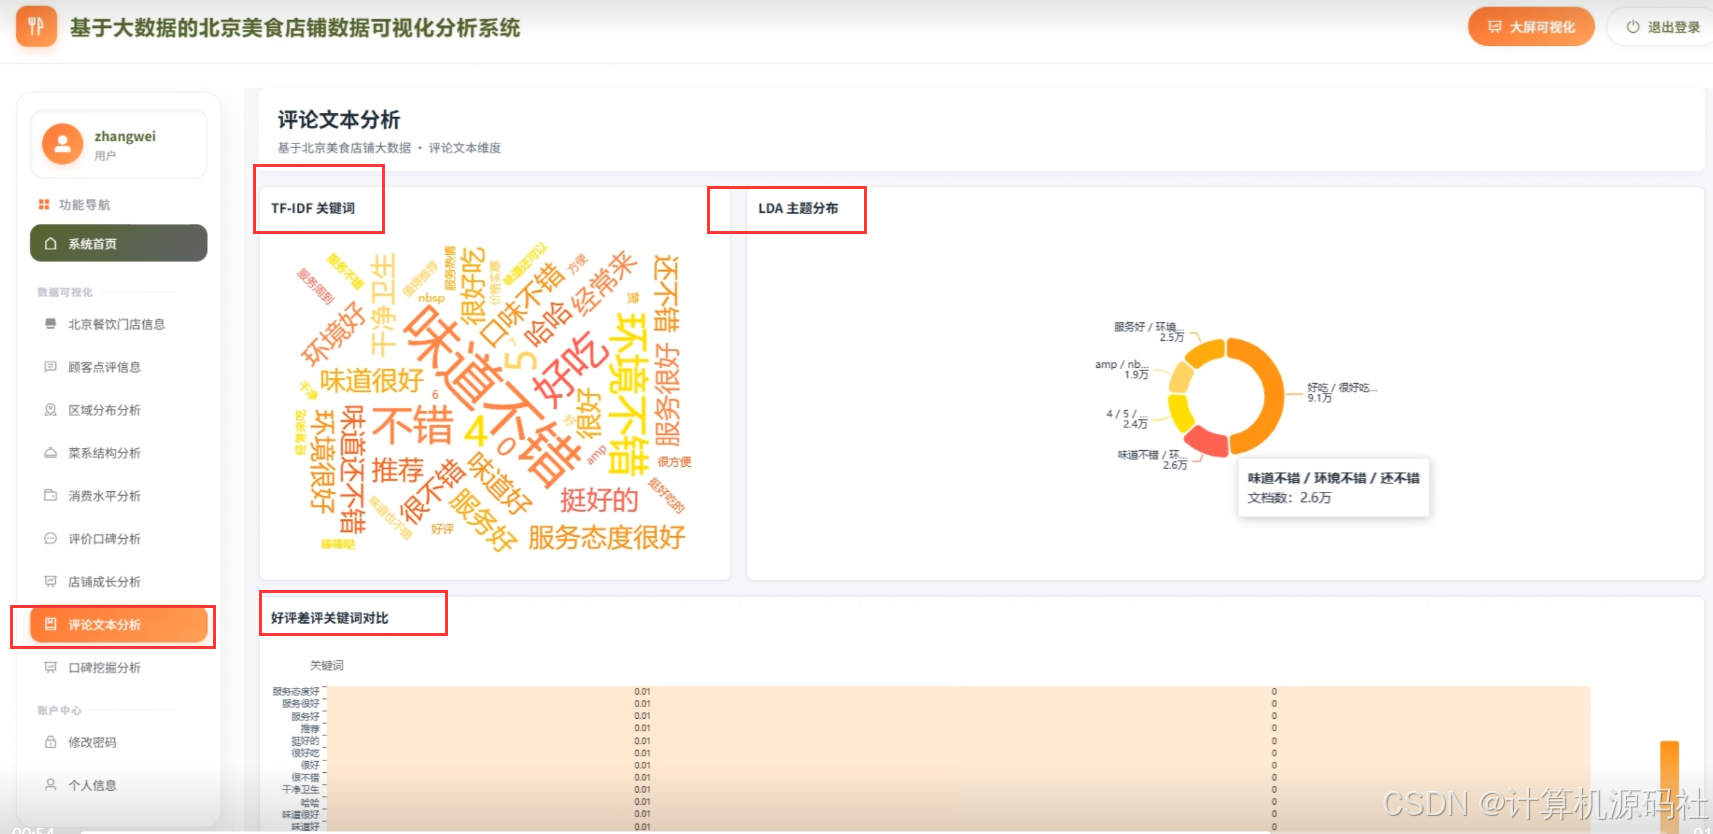
系统基于Python语言结合Spark和Hadoop大数据生态进行数据预处理与计算,采用MySQL存储清洗后的数据,后端结合数据挖掘与机器学习算法,前端采用Vue和Echarts进行可视化呈现。系统开发了菜系结构分析模块,涵盖菜系×区热力图、菜系店铺数TOP及菜系人均消费,并利用环形图展示米其林菜系分布。针对评论文本,系统实现了TF-IDF关键词提取、LDA主题分布计算以及好评差评关键词对比,生成了词云和主题环形图。消费水平分析模块通过柱状图展示各价位段评分,利用漏斗图呈现价位段分布,并分析高端店铺区域聚集情况。区域分布分析模块通过条形图展示各区菜系丰富度、热门商圈TOP,结合地图散点图展示经纬度分布,并给出各区人均消费TOP15表格。店铺成长分析模块实现了头部店铺年度评论量柱状图、头部活跃店铺排名以及各区与各菜系评论数折线图。评价口碑分析模块展示了各区评论数、评分时间趋势折线图及负面评价词云。系统还开发了整体的大屏可视化模块,集成了异常口碑店铺分布、K-Means聚类画像、LDA主题分布等功能,实现了多维数据的集中展示与交互分析。
4、系统页面设计
如需要源码,可以扫取文章下方二维码联系咨询
5、参考文献
[1]谢思语,王鑫龙,杨永均,等. 基于POI数据挖掘的京沪沿线城市美食资源空间分异及竞争对策分析[J].测绘与空间地理信息,2025,48(6):9-12.
[2]周含质.旅游美食地方性感知与地方认同:基于两种视角的整合[D].山东大学,2025.DOI:10.27272/d.cnki.gshdu.2025.002507.
[3]杨苑菲.徐州美食游客感知形象与官方投射形象比较研究[D].桂林理工大学,2025.DOI:10.27050/d.cnki.gglgc.2025.001289.
[4]单颖.文旅融合背景下《姑苏美食》云旅游漫游系统设计研究[D].苏州科技大学,2024.DOI:10.27748/d.cnki.gszkj.2024.000215.
[5]董仕玮.济南城市文化在移动端交互广告中的互动设计研究[D].山东建筑大学,2023.DOI:10.27273/d.cnki.gsajc.2023.000678.
[6]郭凌波.数字经济时代游客在场行为与影响因素研究[D].四川大学,2023.DOI:10.27342/d.cnki.gscdu.2023.002272.
[7]马锦,柳诗怡,戴进进,等. 流媒体大环境下的传统美食店铺——基于大数据“捧杀”传统美食店铺现状的分析调查[J].老字号品牌营销,2022,(16):6-8.
[8]胡蕊.西安美食旅游游客期望与感知差异分析与研究[D].陕西师范大学,2021.DOI:10.27292/d.cnki.gsxfu.2021.000900.
[9]常雪松.基于游客感知大数据的全域旅游评价研究: 以常熟市为例[D].南开大学,2021.DOI:10.27254/d.cnki.gnkau.2021.000154.
[10]宋文杰.基于游客在线游记分析的厦门美食旅游感知研究[D].厦门大学,2020.DOI:10.27424/d.cnki.gxmdu.2020.003116.
[11]杨胜燕.贵州都匀旅游资源信息管理系统的研究与分析[D].云南大学,2018.
[12]王宁.基于NFC的智能点餐系统设计与实现[D].杭州电子科技大学,2016.DOI:10.27075/d.cnki.ghzdc.2016.000010.
[13]孙文心.社会化美食推荐系统研究与设计[D].大连海事大学,2013.
6、核心代码
spark = SparkSession.builder \
    .appName("BeijingFoodReviewAnalysis") \
    .config("spark.sql.warehouse.dir", "/user/hive/warehouse") \
    .enableHiveSupport() \
    .getOrCreate()

# 从MySQL中读取顾客点评数据
review_df = spark.read.format("jdbc") \
    .option("url", "jdbc:mysql://localhost:3306/food_db") \
    .option("dbtable", "customer_reviews") \
    .option("user", "root").option("password", "123456").load()

# 自定义UDF:使用jieba进行中文分词,去除停用词
def chinese_word_seg(text):
    if not text: return []
    words = jieba.lcut(text)
    # 过滤停用词、标点符号和单字
    stop_words = set(['的', '了', '是', '在', '我', '有', '和', '就', '不', '人', '都', '一', '一个', '上', '也', '很', '到', '说', '去', '你', '会', '着', '没有', '看', '好', '自己', '这'])
    return [w for w in words if len(w) > 1 and w not in stop_words]

# 注册UDF并处理原始文本
segment_udf = udf(chinese_word_seg, ArrayType(StringType()))
word_df = review_df.withColumn("words", segment_udf(col("review_text")))

# --- TF-IDF 关键词提取 ---
# 计算词频(TF)
hashingTF = HashingTF(inputCol="words", outputCol="rawFeatures", numFeatures=2000)
tf_df = hashingTF.transform(word_df)
# 计算逆文档频率(IDF)
idf = IDF(inputCol="rawFeatures", outputCol="features")
idf_model = idf.fit(tf_df)
tfidf_df = idf_model.transform(tf_df)

# 提取TF-IDF TOP关键词,用于前端Echarts词云展示
vocab = tfidf_df.select("words").rdd.flatMap(lambda x: x[0]).countByValue()
top_keywords = sorted(vocab.items(), key=lambda x: x[1], reverse=True)[:50]

# --- LDA 主题分布 ---
# 使用CountVectorizer构建词袋模型
cv = CountVectorizer(inputCol="words", outputCol="features_lda", vocabSize=1000, minDF=2.0)
cv_model = cv.fit(word_df)
cv_df = cv_model.transform(word_df)
# 训练LDA模型,设定主题数为5(根据图像中的环形图主题分布)
lda = LDA(k=5, maxIter=10, featuresCol="features_lda")
lda_model = lda.fit(cv_df)
# 输出主题分布结果
topics = lda_model.describeTopics(10)
topics.show(truncate=False)
💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/m0_72599287/article/details/166740694

