

让机器人拥有“五感”:从感知到想象的多模态神经网络
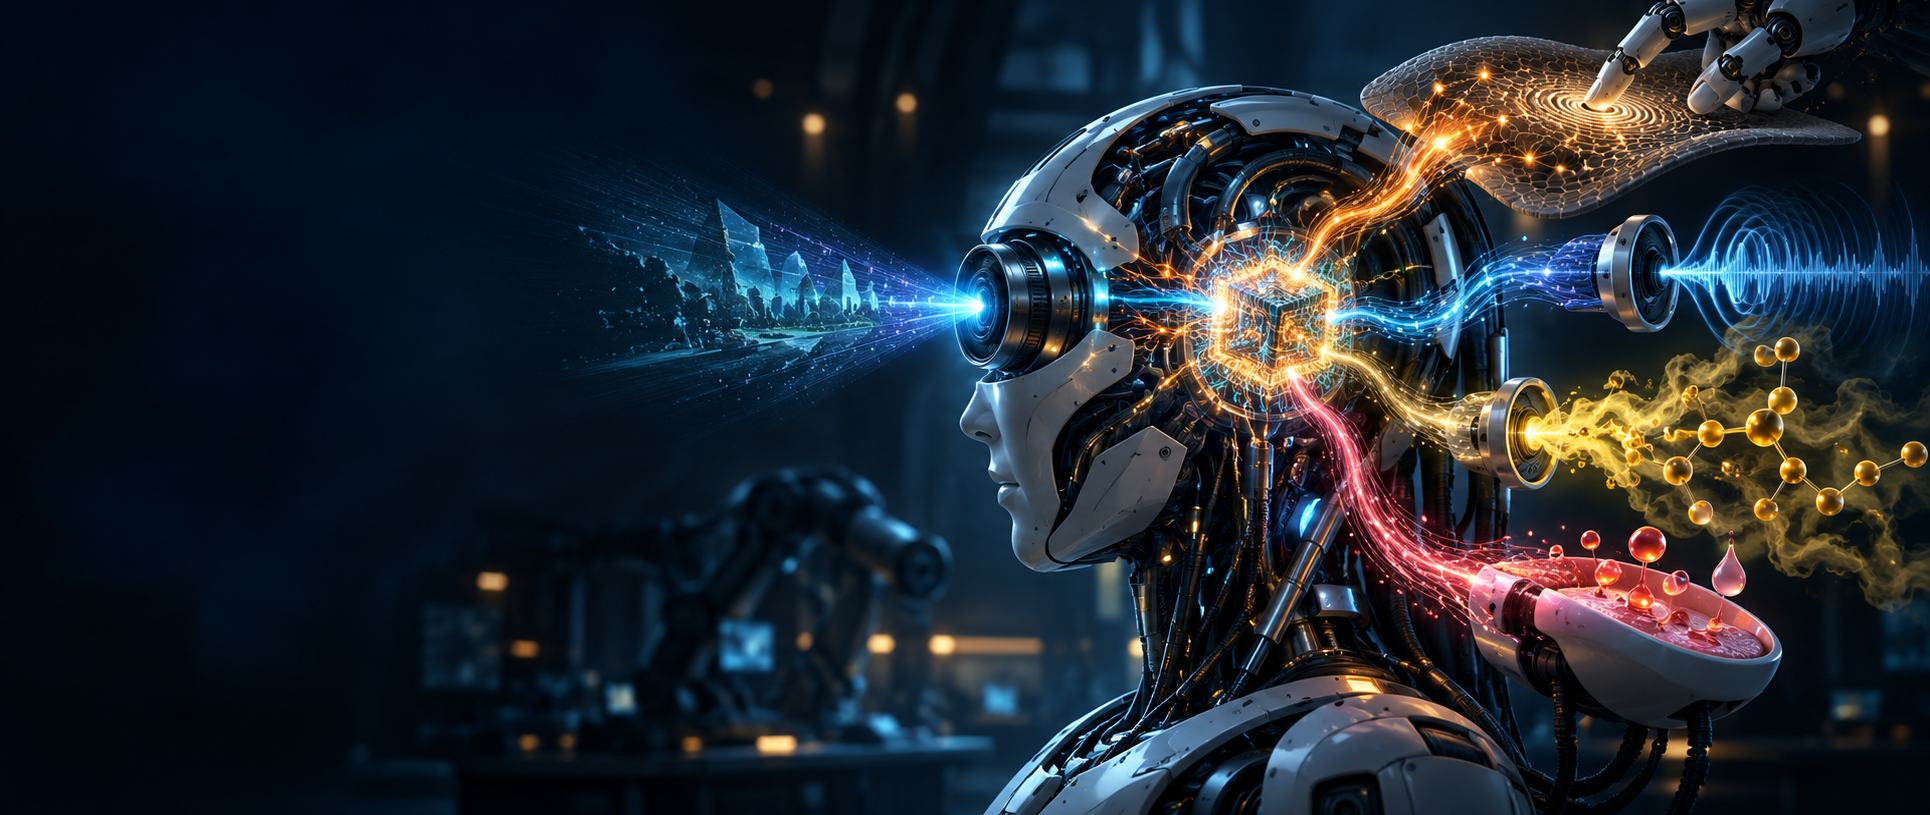
我越来越相信,机器人真正缺少的不是又一个更大的分类器,而是一套能把不同感觉放在同一张“经验地图”上的感知系统。人类看到一只苹果时,不会只得到一组像素:颜色、形状、触感、气味、味道和别人说出的“苹果”这个词,会在大脑里汇合成一个可以记忆、识别、联想甚至想象的对象。我们之所以能在没有见过“蓝色的苹果”时,仍然想象出它,大部分原因不是某一个感官特别强,而是感官之间会互相翻译。
传统机器学习往往把视觉、听觉、触觉拆成几条独立流水线:相机送进视觉网络,麦克风送进语音网络,压力阵列再接一个触觉模型。这样做当然有效,却很难回答一个更接近真实世界的问题:如果机器人只听到一句话,它能否联想到物体的外观和气味?如果它摸到一个字,它能否“看见”这个字?如果视觉和声音同时出现,能否更早发现危险?
我从这套仿生多感知系统中看到的核心,不是把五种传感器简单堆在一起,而是把“感知、编码、记忆、融合、联想”连成一个层级结构。它把人工视觉、触觉、听觉,以及模拟的嗅觉和味觉接到同一套脉冲通信和神经网络框架中,再用交叉模态学习,把一种感觉转换成另一种感觉的表征。
一,先理解人脑式的分工:不是集中处理,而是分布式协同
人类感知系统有一个很值得工程师学习的特点:感受器、神经通路和皮层并不是一个中央处理器的不同接口。视网膜、皮肤、耳蜗、嗅觉受体和味觉受体先在局部完成编码,再把带有时间结构的脉冲传给更高层网络。局部神经回路会做过滤、增益调节、记忆和门控,最后才形成统一的知觉。
这种分布式结构带来的好处,是每个感官可以按照自己的物理规律工作,同时又能在更高层共享信息。视觉擅长空间结构,听觉擅长时间模式,触觉擅长接触与压力,嗅觉和味觉则更像一组化学属性。若一开始就把它们强行压成同一种原始数据,模型可能失去各自最有价值的特征;若永远不融合,又无法形成跨模态理解。
因此,我更愿意把多模态感知看成一座分层的桥:底层尊重不同传感器的物理差异,中层把信息转换成可通信、可记忆的脉冲,上层再通过关联学习建立“这个声音、这个触感和这个视觉对象属于同一件事”的关系。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2402_84593233/article/details/167075477

